Почему я не подписал письмо лауреатов медали Филдса
[Этот пост перекрёстно опубликован в блоге Теренса Тао.]
Когда мне было около одиннадцати лет, я впервые узнал о Великой теореме Ферма. Меня сразу очаровала формулировка задачи и сопутствующая история, и я предпринял довольно серьёзную попытку доказать её. Хотя, разумеется, я не преуспел, я многому научился в процессе попытки. Не зная того, что случай  был доказан Эйлером более двухсот лет назад, я решил начать именно с этого: разобравшись с ним, я был оптимистичен, что буду готов к общему случаю.
Поскольку я по-прежнему не знал, с чего начать, я решил упростить задачу дальше и сосредоточиться на последовательных разностях кубов, пытаясь показать, что такая разность сама не может быть кубом. Тогда я не умел выражать то, что делал, на алгебраическом языке, поэтому не пытался явно доказать, что диофантово уравнение 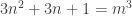 не имеет решений. Вместо этого я просто вычислил несколько последовательных разностей и стал их разглядывать, пытаясь понять, почему ни одна из них не была полным кубом. (Следует уточнить, что эта история — реконструкция того, что, по моему мнению, вероятно произошло, судя по нескольким смутным воспоминаниям, оставшимся спустя полвека, а не полностью достоверный рассказ.) В какой-то момент пришла идея взять разностную последовательность разностной последовательности и обнаружил, что она образует арифметическую прогрессию. Это казалось прогрессом, поэтому я углубился в исследование разностных последовательностей и чисто эмпирически открыл правило: если начать с
 -х степеней и продолжать брать последовательные разности, то в итоге придёшь к постоянной последовательности
 .
Каким-то образом мне так и не удалось превратить это наблюдение в доказательство Великой теоремы Ферма, а позже моя мечта её решить уступила место другим математическим мечтам. Однако когда я дошёл в образовании до темы разностных последовательностей и того, что происходит с полиномами, я понимал эти темы намного лучше, чем я бы понимал, если бы самостоятельно не открыл разностные последовательности и не провёл счастливые часы, играя с ними. Я упоминаю эту историю просто как иллюстрацию феномена, на который сильно акцентировано внимание в письме, подписанном 25 лауреатами медали Филдса: много учишься, думая о задаче, независимо от того, решишь ли её.
В итоге, однако, я почувствовал, что не могу подписать письмо, несмотря на согласие с большей частью его содержания. Вместо этого казалось лучше поступить так, как я поступил с Лейденской декларацией, и изложить свою позицию в блог-посте. Но следует понимать, что, поступая так, я не представляю себя членом какого-то противостоящего лагеря: действительно, одна из моих нынешних забот в том, что математическое сообщество может расколоться горько, а я очень хотел бы этого избежать. Кроме того, я согласен на фундаментальном уровне, что мы сталкиваемся с кризисом: просто хочу предложить несколько иной анализ того, в чём этот кризис состоит. Я не претендую на полную оригинальность этого анализа, так как знаю, что несколько других математиков уже высказали мысли, похожие на мои, хотя (если что) я в основном пришёл к этим выводам независимо.
По поводу независимости, возможно, поможет уточнить: хотя у меня есть контакты в группе математиков в OpenAI и мне дан ранний доступ к некоторым их моделям (обычно лишь за несколько дней до публичного выпуска), и мне предоставлен бесплатный доступ к их Pro моделям после выпуска, я никогда не получал оплату от OpenAI. Упоминаю это в надежде, может быть наивной, что то, что я пишу, не будет отклонено по соображениям ad hominem. Ещё одна возможная причина восприятия меня как «про-AI» в том, что я несколько раз публично заявлял о наличии группы в Кембридже, занимающейся автоматическим доказательством теорем. Однако это на самом деле скорее повод быть против AI, поскольку наша группа пыталась подойти к проблеме заставить компьютеры доказывать интересные теоремы через понимание того, как можно лучше доказывают интересные теоремы люди, и теперь, когда LLM явно это делают без помощи наших идей, одна из главных мотиваций нашей работы исчезла. По-другому говоря, нам пришлось проглотить горький урок (о котором мы, конечно, всегда знали как о вероятности, хотя скорость его наступления застала нас врасплох). На самом деле я думаю, что стремление к этому пониманию остаётся очень интересным и ценным интеллектуальным упражнением, даже если мы можем использовать LLM как чёрные ящики, но это тема для отдельного поста.
Итак, почему я не подписал письмо? Позвольте выделить несколько предложений, которые, на мой взгляд, выражают главный аргумент, выдвигаемый в письме.
Но решение задач — только инструмент и суррогат основной цели достижения концептуального понимания и озарения. Забыть об этом в мире AI означает обернуть инструмент против основной цели. Действительно, массовое производство в ускоряющемся темпе утверждений «истинно/ложно» может уничтожить плодородную почву вместо того, чтобы дышать жизнью в новые идеи.
Возможно, главная причина, по которой я не подписал, в том, что я не полностью согласен с этим взглядом. Вместо этого у меня более сложный взгляд, который я фактически выразил в своём эссе «Две культуры математики» четверть века назад, и который можно суммировать следующим образом: в математике существует спектр позиций относительно связи между решением задач и концептуальным пониманием. На одном конце спектра — математики, мотивированные прежде всего желанием решать задачи и видящие концептуальное понимание как очень важное средство к этой цели. На другом конце — математики, мотивированные прежде всего желанием достичь концептуального понимания и видящие решение задач как очень важное средство к этой цели. Я беспокоюсь, что письмо о серьёзном misalignment могут воспринять как утверждение, что «правильная» позиция — сосредоточиться на концептуальном понимании как главном приоритете — действительно, приведённые выше предложения говорят это более или менее напрямую. Но я думаю, что математики расположены по всему спектру, и это хорошо (или, может быть, я должен сказать, что это было хорошо до сих пор — будущее намного менее определено), и я не хочу внушить большой доле математиков, включая себя, что их математический темперамент каким-то образом «неправилен».
Моя собственная математическая позиция очень схожа с позицией, прекрасно выраженной в посте Джейкоба Цимермана в Twitter (ещё один не подписавший письмо), который, как я вижу сейчас, говорит многое из того, что я буду говорить здесь. И этот пост в свою очередь — ответ Даниэлю Литту, который, на мой взгляд, один из мудрейших комментаторов по вопросу математики и AI. Его взгляды выражены в посте здесь, который я намеренно не читал до завершения этого, а затем, как я и ожидал, обнаружил значительное перекрытие. Хочу также использовать возможность рекомендовать отличный пост Ноа Смита под названием «Конец эпохи героев», если вы его ещё не читали.
До сих пор я говорил об индивидуальном математическом понимании, но подозреваю, что волнует большинство подписавших не столько это, сколько коллективное понимание, возникающее, по крайней мере отчасти, из человеческой деятельности по решению задач. Моё предположение, что они утверждали бы, совершенно последовательно, что даже если коллективное понимание — основная цель, то если многие люди мотивированы прежде всего желанием решать задачи, это совершенно нормально и способствует коллективному пониманию.
С этой интерпретацией вопрос становится немного иным: важнее ли, чтобы коллективное понимание математического сообщества было как можно продвинутее, или чтобы было столько же ответов на задачи, насколько это возможно? Или эти две цели ценны по-разному, так что нет смысла объявлять одну более важной? Или они настолько неразрывно связаны, что нет смысла утверждать, что одна важнее другой? И когда мы говорим «важно», для кого оно важно: для математиков или для общества в целом?
Я считаю эти сложные вопросы, поэтому не хочу просто объявить ответ. (Видите, что я сделал?) Вместо этого хочу попытаться предложить хотя бы некоторый аргумент для любых выводов, к которым я прихожу, даже если они предварительные. Итак, давайте сравним два сценария. В первом, который я считаю более вероятным на самом деле, становятся общественно доступны модели, лучше решающие задачи, чем практически все математики. Если остаются немногие математики, способные делать то, что модели не могут, даже они работают намного быстрее, если активно используют модели. Благодаря этому в короткий срок получаем ответы на множество вопросов, которые нас волновали, но темп получения ответов намного превышает темп, в котором математическое сообщество может их усвоить. В частности, большинство ответов получены нулевыми усилиями человеческих математиков — просто подсказками вроде «спасибо — продолжай».
Во втором сценарии заключено международное соглашение, совершенно по другим причинам, о блокировании публичного выпуска моделей значительно более мощных, чем те, что мы имеем сейчас, и математики из технологических компаний согласились не выпускать свои внутренние модели на решение крупных задач. Вместо этого они берут указания от математического сообщества, решая задачи только по просьбе какого-то надлежащим образом репрезентативного органа, решающего, что выгода получения решения определённой задачи перевешивает выгоду от того, что люди мучаются с её решением намного дольше.
Хотелось бы рассмотреть, в чём различие между этими двумя сценариями как для индивидуального, так и коллективного понимания. Начну с индивидуального понимания.
Можно возразить, что для индивидуального понимания много не изменится, если мы вдруг затопим большим числом больших новых результатов. Там уже намного больше математики, чем я когда-либо смогу понять (например, несмотря на то, что я был в восторге, когда была доказана Великая теорема Ферма, я не предпринимал попыток понять это доказательство), и даже среди частей, которые я понимаю, те части, которые я понимаю, потому что сам их открыл, составляют очень маленькую долю, хотя долю, которую я понимаю глубже, чем что-либо ещё (по крайней мере, временно — спустя время я забываю вещи и теряю большую часть понимания, которое построил). Однако одно изменение, которое кажется положительным с точки зрения накопления индивидуального понимания, заключалось бы в том, что мы имели бы намного больший выбор результатов, которые могли бы выбрать для изучения. Кроме того, если бы мы застряли на каком-то моменте, AI мог бы нам помочь. Главное вероятное негативное изменение в том, что мы, вероятно, перестали бы упражнять ту часть нашего мозга, которую используем, когда месяцы или годы мучаемся со сложной исследовательской задачей, что может быть чрезвычайно полезно для развития понимания.
Я говорю «вероятно», потому что в принципе ничто не помешало бы нам думать о очень сложных задачах, не консультируясь с LLM, но на практике кажется маловероятным, что люди прилагали бы тот же уровень усилий, что и сейчас. Ситуация могла бы быть немного похожа на то, что произошло с навигаторами GPS, где можно было бы всегда решить их не использовать, чтобы держать активной ту часть мозга, которая может смотреть на карту, выучить маршрут и следовать ему, но на практике большинство людей поддаются искушению использовать навигатор. (На самом деле я сам пытаюсь держать эту часть мозга активной и был довольно горд, недавно найдя дорогу куда-то, когда я кратко посмотрел маршрут на телефоне, но потом забыл взять телефон с собой, когда туда пошёл.) Но даже если бы мы просто читали выходные данные AI, я думаю, что мышцы решения задач в мозгу не атрофировались бы полностью. Когда студенты читают математические статьи, я сильно рекомендую им (и я думаю, что это довольно стандартный совет) читать «активно», а не «пассивно», делая такие вещи, как попытка доказать результат самостоятельно, обращение к статье только, когда застрянешь и нужна подсказка, и даже тогда просто пытаясь получить подсказку и минимум дополнительного. Если читать статью таким образом, то постоянно решаешь задачи, некоторые просто упражнения, некоторые довольно сложные. Кажется вероятным, что LLM мог бы узнать наш математический фон и подавать нам ровно те подсказки, которые позволили бы нам работать через математическую статью активным образом. Да, мы потеряли бы особенно глубокий уровень понимания и владения, что приходит с решением сложной задачи самостоятельно, но мне не ясно, что прогресс в математике будет страдать в результате. Был бы очень заинтересован услышать контраргументы именно к этому пункту. То есть был бы заинтересован знать, какой смысл в этом уровне глубокого погружения в доказательство в мире, где AI намного лучше нас в нахождении доказательств.
А что с коллективным пониманием? Позвольте привести ещё немного из письма.
Действительно, массовое производство в ускоряющемся темпе утверждений «истинно/ложно» может уничтожить плодородную почву вместо того, чтобы дышать жизнью в новые идеи.
Часто эти решения объявляют торопливо, оставляя время только на небрежное оформление, выделение новых методов и идей, цитирование релевантных работ других авторов. Как во всех творческих профессиях, это вызывает серьёзные вопросы об атрибуции и плагиате. Более того, без математиков, готовых позаботиться об их развитии и интеграции в математический канон, идеи, рождённые AI, никогда не оживут полностью, и будет потеряна решающая цепь передачи между математиками.
Вернусь к вопросам о надлежащем цитировании и сосредоточусь на том, что я вижу как основную беспокойство здесь: если результаты доказаны слишком быстро, то процесс их усвоения станет невозможным. Я определённо беспокоюсь, что результаты не будут надлежащим образом усвоены, но по другим причинам.
Прежде всего, то, что производит AI, — это не просто утверждения истинно/ложно: мы теперь знаем не только то, что уравнение Навье-Стокса с гладкой внешней силой допускает конечновременный взрыв, но у нас есть доказательство этого, которое опирается на много замечательной работы, сделанной человеческими математиками. Многие люди привыкли выражать беспокойство, что AI решит наши любимые задачи с совершенно непрозрачными доказательствами, но это не произошло, даже если их оформление часто оставляет желать лучшего. (Кстати, я вижу эти неадекватные оформления почти определённо как временное раздражение, а не как фундаментальную угрозу математической практике или будущему математическому пониманию.)
Во-вторых, даже если объём новых результатов велик, математика — это весьма специализированная дисциплина, так что математики могут работать параллельно. Если бы, например, нам пришлось усвоить 1000 важных результатов в год, более или менее равномерно распределённых по математике, то большинство субсообществ математиков, вероятно, захотели бы разобраться примерно в 30 из них, и для каждой отдельной задачи, вероятно, было бы только несколько специалистов, которые были бы очевидными кандидатами, чтобы возглавить достижение этого понимания, причём этот набор варьировался бы от задачи к задаче. Итак, это была бы большая задача, но не обязательно невыполнимая.
В этом контексте стоит подумать об огромном объёме выхода человеческих математиков, который, похоже, недавно растёт, даже до AI. Хотя я иногда слышал жалобы по этому поводу, я уж точно не слышал предложений, чтобы человеческие математики замедлили темп доказывания интересных теорем. Это может быть отчасти потому, что авторы этих теорем берут на себя труд писать свои статьи хорошо и дают хорошие доклады. Но как быть с большим количеством статей, включая важные, которые написаны плохо и чьи авторы дают непонятные доклады? Это может раздражать, но это знакомое раздражение, а не то, что мы рассматриваем как кризис.
Третий момент в том, что даже если объём выхода AI слишком велик, чтобы мы могли его надлежащим образом усвоить, это не обязательно плохо. Чтобы привести несовершенную аналогию, в сервисах потоковой трансляции теперь доступно больше контента, чем кто-либо когда-либо мог бы посмотреть, в результате чего почти определённо есть очень хороший контент, который едва ли смотрят. Но это не очевидно худший сценарий, чем если бы контента было намного меньше и все он получал бы внимание, которого он заслуживал. Возвращаясь к математике, если бы AI-сгенерированного контента было слишком много, чтобы мы могли его надлежащим образом усвоить, мы могли бы выбрать, какие части его усваивать.
Для этого нам пришлось бы иметь какое-то представление о том, что там есть (ситуация немного похожа на то, как человеческие математики обычно узнают довольно много о том, какие результаты известны в их области, даже когда они не понимают их доказательства в каких-либо деталях). Один способ попытаться достичь этого — создать хорошо спроектированную базу данных, вероятно, с помощью AI. Но, возможно, это не потребуется, и вместо этого можно было бы просто поговорить с LLM и попросить её дать птичий взгляд на любую область математики, которую захотелось бы понимать таким образом.
Опасение, похоже, в том, что некоторые очень интересные и важные части математики будут открыты AI и затем упущены, когда, если бы их открыли человеческие математики, они не были бы упущены. И это даже может быть так, но что имеет значение, так это то, превышает ли количество интересной и важной математики, открытой AI, которая не упущена, количество интересной и важной математики, которая была бы открыта и надлежащим образом усвоена людьми с AI, играющим более скромную роль.
Коротко говоря, мне кажется, что хотя поток больших результатов AI, вероятно, увеличил бы количество важной математики, которая не была бы надлежащим образом усвоена, это также, вероятно, увеличило бы количество, которое было бы надлежащим образом усвоено, что кажется довольно хорошей сделкой.
Позвольте кратко обсудить проблему неправильного приписывания AI авторства человеческим математикам. Я согласен, что это серьёзная проблема прямо сейчас, но это другая проблема, которую я вижу как временную. Вскоре вся система «кредита» несомненно рухнет, поскольку нахождение удивительного доказательства будет не более интеллектуальным достижением, чем когда учёный-любитель замечает в свой телескоп объект, который оказывается новой кометой. До этого момента важно давать людям кредит, которого они заслуживают, поскольку карьеры могут от этого зависеть, но это скоро перестанет быть верным. Должен сказать, я озадачен тем, что эта проблема вообще существует, так как я подумал бы, что если попросишь LLM посмотреть на доказательство и рассказать, какие идеи в нём близки к идеям, которые уже в литературе, это будет чрезвычайно хорошо для этой задачи. Надеюсь, ответ на эту загадку не в том, что люди были в такой спешке, что просто не потрудились это сделать, но боюсь, что, возможно, это так, по крайней мере в некоторых случаях. Если так, то те, кто был небрежен, заслуживают критики, но это незначительный вопрос по сравнению с выживанием математики, особенно если отсутствие ссылок быстро исправляется.
Означает ли всё это, что я оптимистичен, что математики в конечном счёте будут усваивать по крайней мере столько же математики в постоянном мире AI, сколько было бы, если бы AI не могла доказывать крупные теоремы? Не совсем. Но моя забота не в том, что мы не могли бы это делать, а в том, что социальные структуры, которые в настоящий момент поддерживают этот процесс усвоения, будут разрушены и не адекватно заменены.
Один способ, которым это может произойти, в том, что AI так сильно нарушит общество, или даже убьёт множество из нас, что сохранение чего-то вроде текущей математической традиции перестанет быть любым беспокойством: всё, что будет иметь значение, это выживание человеческого рода. Но это снова тема для другого блог-поста (который я, на самом деле, писал в середине).
Предположим вместо этого, что нам повезёт и AI остаётся более или менее под контролем. Моя забота тогда в том, что мы не сумеем передать то, что мы знаем, новому поколению математиков. Говоря о себе, моей главной мотивацией для становления математиком была мечта, что я решу нерешённые задачи — чем более знамениты, тем лучше. Я также всегда намного предпочитал непосредственно думать о задаче чтению книг и статей и вообще обучению математике других людей. (Я не говорю, что это хорошо, а просто констатирую факт о себе.) Если мечта о решении знаменитой задачи исчезнет, я не уверен, стал бы я математиком. Я не полностью исключаю это: может быть, что меня действительно мотивировал небольшой набор способностей к предмету и что решение задач было способом получения уважения от маленькой группы коллег. И может быть, я мог бы попытаться получить это уважение другим способом, например, думая очень глубоко об области математики, пока я не был бы в состоянии продемонстрировать другим, насколько хорошо я это понимал. Но я не уверен, насколько это было бы мотивирующим для меня. Я очень надеюсь, что есть пул молодых людей, для кого это будет сильной мотивацией, потому что я думаю, что выживание человеческой математической традиции может хорошо от этого зависеть.
Таким образом, основной риск, как я его вижу, в том, что множество людей, которые могли бы сделать PhD по математике и пойти дальше, чтобы стать хранителями математической традиции, больше не захотят этого делать. Те из нас, у кого есть аспиранты, включая меня, должны попытаться как можно усерднее придумать творческие способы, чтобы они использовали своё время продуктивно (в консультации с самими студентами, очевидно). Насколько хорошо мы это сделаем, может сделать огромную разницу для будущего математики. Связанный риск в том, что восприятие среди политиков будет, что математики больше не нужны, и финансирование станет намного сложнее получить: нам срочно нужно придумать хорошие способы объяснения ценности наличия большого пула человеческих экспертов по математике, даже если более не является частью их роли находить новые доказательства теорем.
Последняя причина, по которой я не подписал письмо, в том, что я не совсем уверен, на что оно требовало, что уже не происходит. Кажется вероятным, что в течение не слишком многих месяцев будут выпущены LLM, способные решать крупные математические задачи, и они, вероятно, не будут иметь никаких трудностей с более обыденными задачами. Как бы мы это ни сожалели, нет никакого шанса, что влияние таких моделей на математику убедит компании AI остановить их выпуск, хотя, возможно, забота о безопасности приведёт к некоторой задержке и даст нам немного больше времени, чтобы разобраться, как адаптироваться. Предполагая, что они выпущены, будет поток новых результатов, нравится нам это или нет, и больше это не будут компании AI их производить, хотя, возможно, образец продолжится, что компании AI имеют доступ к более мощным моделям и поэтому получают больше, чем справедливая доля результатов-новостей. Поэтому я чувствовал, что нечего выиграть от критики компаний AI за создание слишком много решений слишком быстро. На самом деле, это может хорошо быть, что всё это делает, ускоряет на пару месяцев то, что всё равно было произойти, и, возможно, это даже позволит результатам быть выпущенными более контролируемым образом, чем они были бы, если бы они были открыты случайными людьми, как только модели были бы общественно доступны. При данных обстоятельствах я думаю, что лучшее, что мы можем сделать, это признать изменения, которые идут, и попытаться разобраться наименее неудовлетворительный способ их обработки.