Проблема в интеграции
Распознавание речи и синтез голоса прошли долгий путь развития, но построение полноценных голосовых агентов, способных слушать, анализировать, взаимодействовать и обрабатывать сложные рабочие процессы, остаётся сложной задачей.
Надёжный голосовой агент должен хорошо справляться с четырьмя задачами одновременно:
Точное распознавание речи на разных языках, с учётом акцентов, характеристик говорящего и перебиваний,
Глубокий анализ смысла высказывания в конкретном контексте,
Естественный синтез с эмоциональной окраской и выразительностью,
Выполнение действий на нескольких этапах через интегрированные системы.
Обеспечение всех четырёх параметров в реальном времени остаётся вызовом.
Для решения этой проблемы компания представляет Voxtral 3 — новое семейство моделей для распознавания речи и синтеза голоса наряду с SDK голосовых агентов, которые объединяют распознавание, анализ, вызов инструментов и синтез в единый потоковый конвейер обработки в реальном времени.
Voxtral 3 создана для естественного голосового взаимодействия — от контакт-центров и service desk до виртуальных помощников и рук-свободных копилотов. С поддержкой десятков языков, выразительного синтеза, сложного анализа и глубокой интеграцией с собственными инструментами и данными, агенты на базе Voxtral могут понимать тонкие намерения, анализировать сложные запросы и выполнять многошаговые действия в связанных системах.
Как и другие модели Mistral, семейство Voxtral 3 разработано для суверенного развёртывания. Доступно сейчас через облачный API Mistral, размещённый в Европе, или для развёртывания на собственной инфраструктуре, что позволяет организациям контролировать обработку аудио, управление данными и сохранение записей беседы.
Основные возможности
Точное распознавание на 50+ языках. Модель распознавания речи Voxtral Small Transcribe 3 достигает лучших показателей в многоязычной транскрипции, определяет говорящего (диаризация), использует ключевые фразы для повышения точности (context-biasing). Обнаруживает конец реплики, позволяя агенту ответить без задержки (end-of-turn detection).
Естественный синтез, адаптирующийся к беседе. Модель синтеза голоса Voxtral Mini TTS 3 предлагает новые голоса, которые изменяют эмоциональную окраску, темп и интонацию в зависимости от контекста разговора, с поддержкой 35+ языков и 50+ диалектов.
Человекоподобный интеллект по голосовой команде. Новый SDK голосовых агентов объединяет распознавание, анализ, вызов инструментов и синтез в реальное взаимодействие. Агенты могут получать информацию, взаимодействовать с системами бизнеса и выполнять задачи во время живых телефонных или веб-вызовов.
Pro Voice для точной адаптации голоса. Для профессиональных применений, где базовое клонирование голоса недостаточно, функция Pro Voice воспроизводит уникальный характер говорящего, диапазон эмоций и стиль речи на разных языках, используя всего 30 минут аудио.
Ваш голосовой AI на вашей инфраструктуре. Используйте облачный API Mistral в Европе или развёртывайте Voxtral 3 на собственной инфраструктуре. Конфиденциальные разговоры остаются в вашей среде, вы контролируете, сохраняется ли аудио.
Распознавание 50+ языков с лучшей в классе точностью
Voxtral Transcribe 3 — значительный прорыв в распознавании речи, диаризации (кто говорил) и context biasing. Список поддерживаемых языков расширился до 50, включая 24 официальных языка ЕС и множество редких азиатских и индийских языков.
Версия Small достигает лучших результатов по диаризации и многоязычной транскрипции, включая английский, французский и испанский. Превосходит Whisper, Scribe v2 и Gemini 3.5 Transcribe. Мини-версия с 4 млрд параметров обеспечивает быструю и точную транскрипцию по цене $0,0035/мин.
Обе модели поддерживают context biasing — можно предоставить ключевые термины и свободный текст для повышения точности распознавания технических терминов. Это позволяет использовать их в production с доменной лексикой без дополнительного обучения.
Ответы с эмоциями на языке бренда и местном диалекте
Voxtral Mini TTS 3.0, доступная как в режиме пакетной обработки, так и в реальном времени, достигает лучших показателей выразительности и следования инструкциям для 35+ языков и 50+ диалектов. При стоимости $13 за 1 млн символов Voxtral Speech 3 дешевле аналогов от OpenAI TTS-1, Deepgram, ElevenLabs Flash и Gemini Flash.
Модель синтеза лучше интерпретирует семантический смысл контекста, создавая естественную речь с разнообразием эмоций и языков. Новые и улучшенные возможности включают клонирование голоса из 30+ минут аудио, следование пользовательским инструкциям (IF), контекстный TTS и библиотеку лексики — всё для надёжности синтеза при развёртывании. Переменные для явного IF включают emotion, pacing и emphasis.
Любой естественный синтез опирается на эмоциональную окраску, которая определяет просодию, ритм, темп, интонацию и переходы. Voxtral TTS изначально интерпретирует текстовый контекст подсказки для определения эмоции и стиля голоса, что делает модель по природе лучше в воспроизведении естественной речи без дополнительных инструкций или голосовых подсказок.
Синтез на 35 языках и 50+ диалектах
Voxtral TTS поддерживает более 35 языков и региональные диалекты. Оценки многоязычности учитывают различия в произношении, формальность речи, орфографию, многословность и локальные условности (время, даты, температура, адреса, валюты).
Голосовые пресеты доступны на 18 языках: арабском (эмиратском, литературном стандарте), португальском (бразильском), каталанском, китайском (мандарин), нидерландском, английском (американском, британском), французском (Франция), немецком, греческом, хинди, итальянском, корейском, норвежском, русском, испанском (Испания) и вьетнамском.
Голосовой агент управляет всей беседой
Voxtral 3 включает SDK голосовых агентов, построенный на LiveKit, которой запускает распознавание, анализ и синтез как единый потоковый конвейер. Voxtral Mini Transcribe Realtime 3 слушает и обнаруживает, когда собеседник закончил говорить, общая модель — например Mistral Small — анализирует и вызывает инструменты, а Voxtral Speech 3 отвечает тоном, соответствующим беседе. Ни один этап не ожидает предыдущего, поэтому каждый ход завершается за секунду, и агент замолкает, если собеседник его перебивает.
Во время вызова агент может проверить личность собеседника, посмотреть счёт или забронировать встречу, используя function calling, веб-поиск и retrieval по собственным системам. Может принимать и совершать вызовы через SIP, работать в браузерах и приложениях через WebRTC, интегрироваться с телефонией, IVR и контакт-центр ПО, которое вы уже используете.
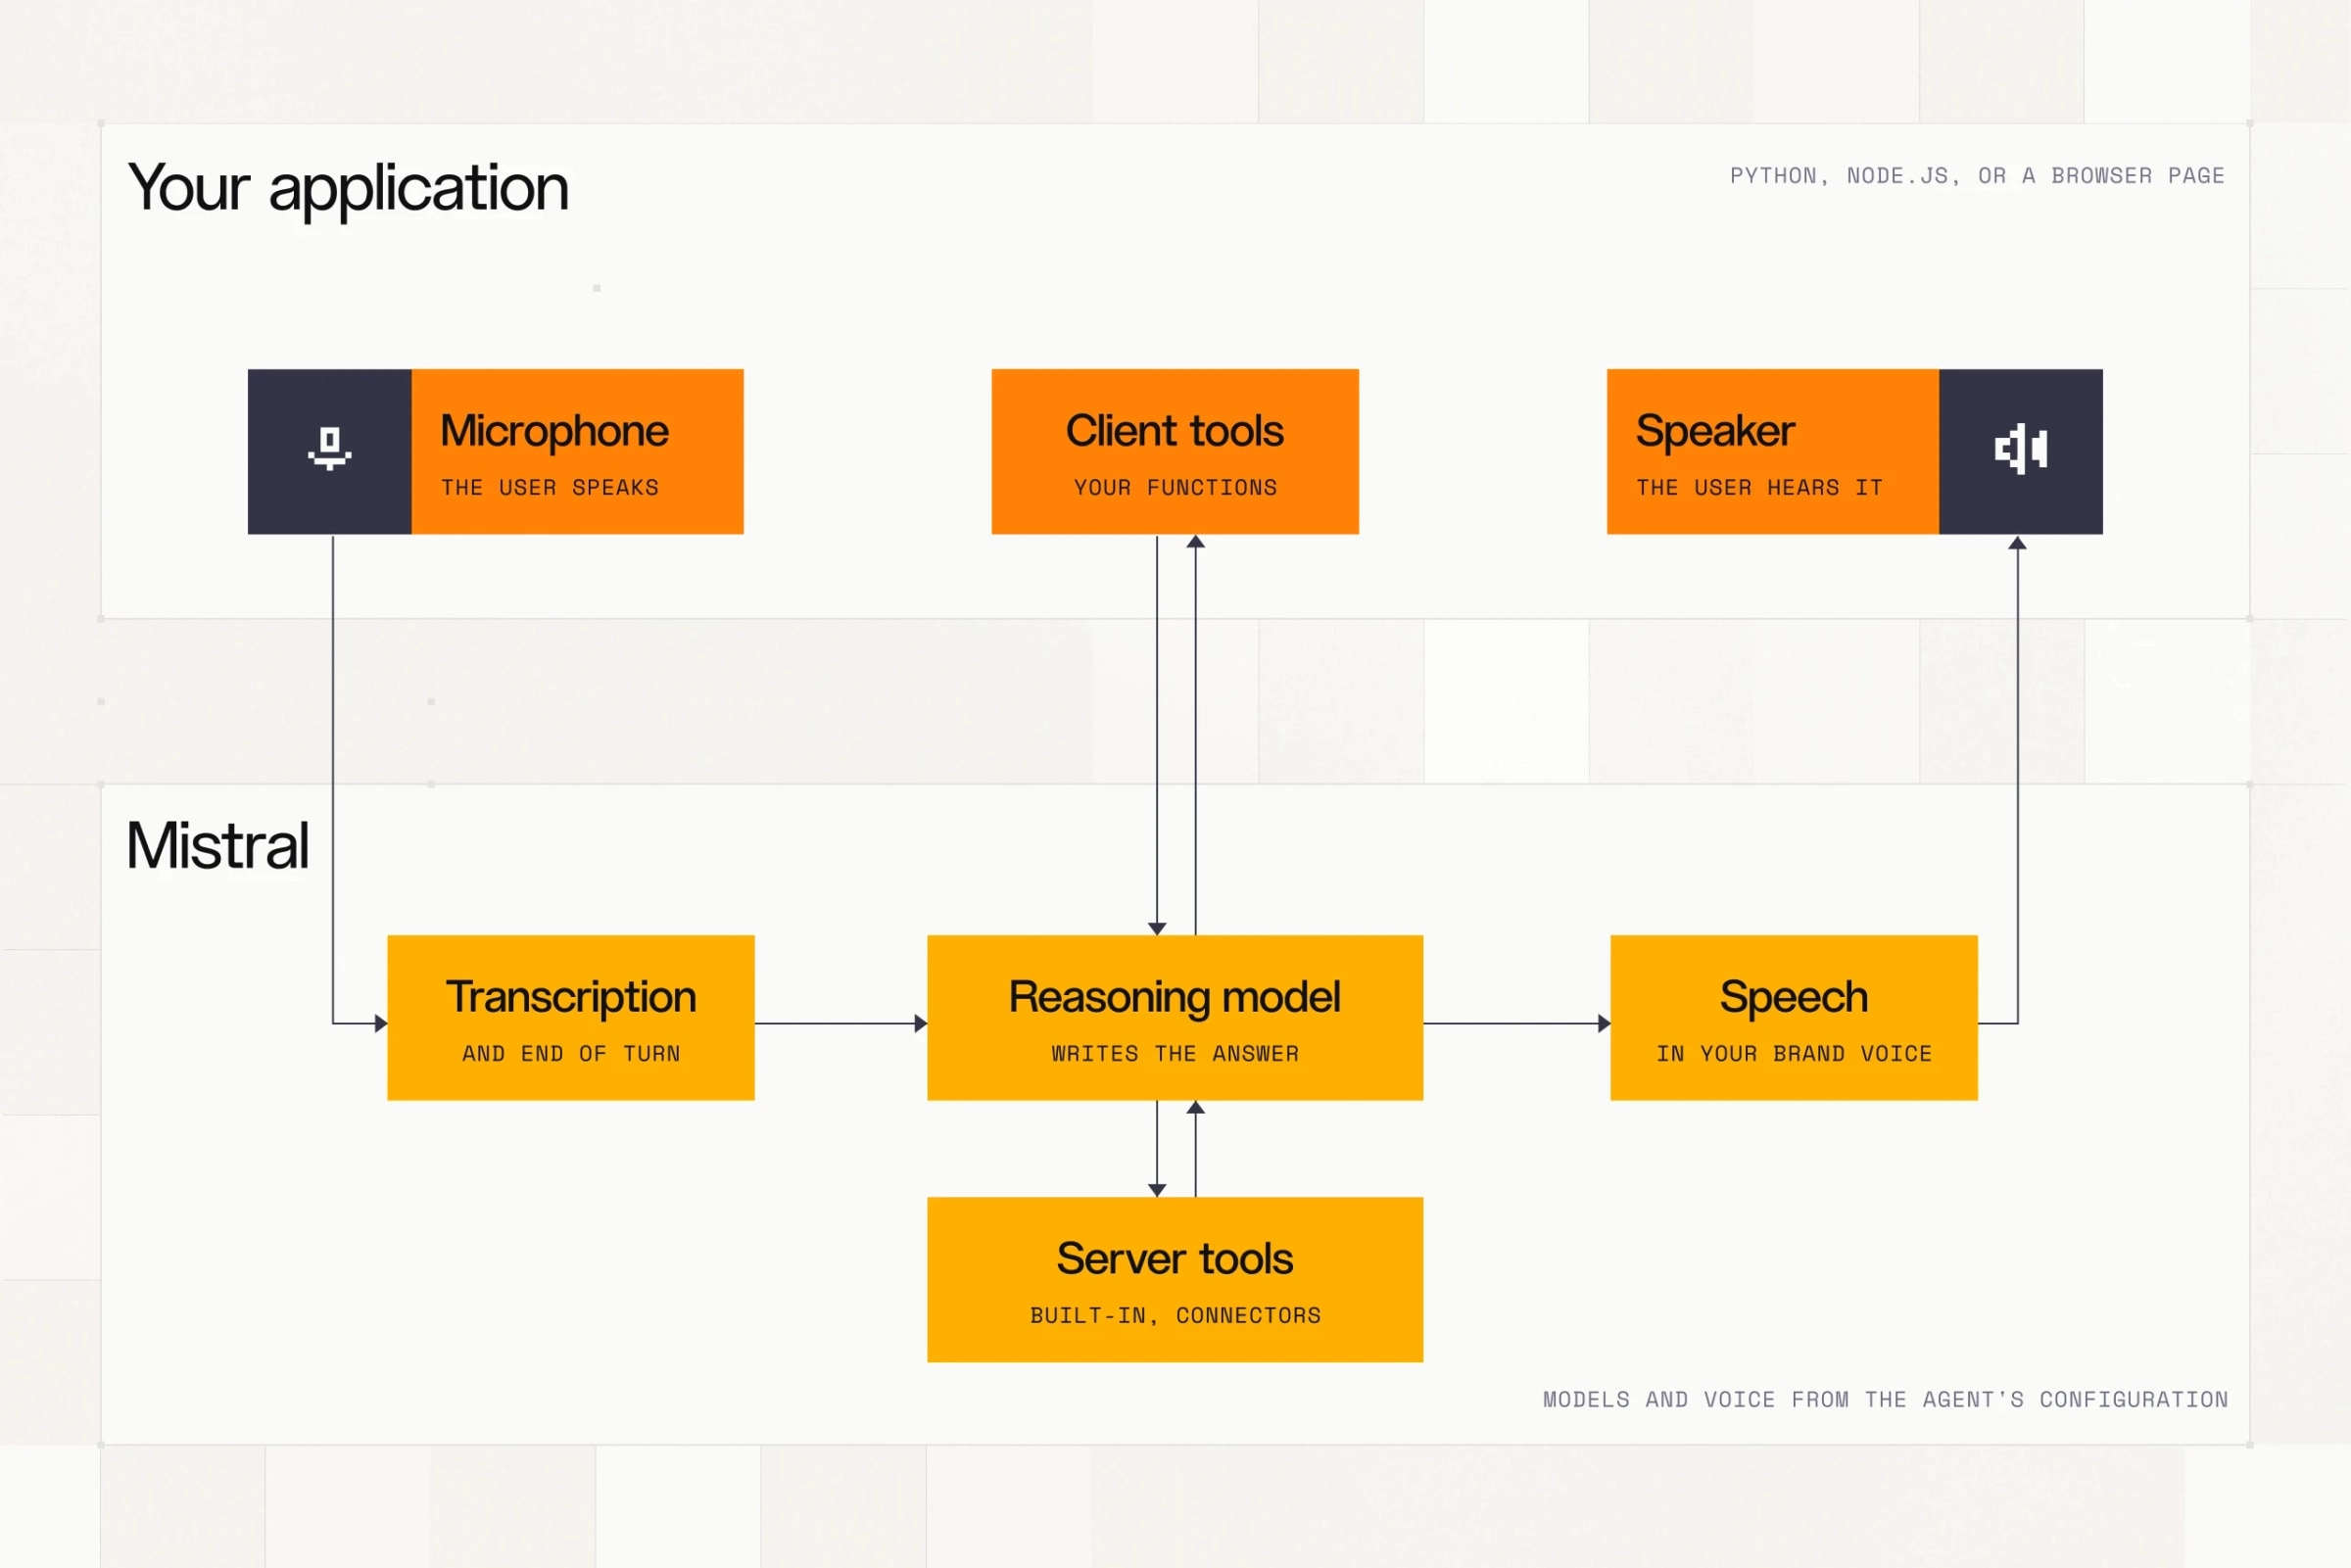
Каждый этап — это отдельная модель, поэтому можно менять LLM, голос или язык без переписывания агента и запускать весь стек через API Mistral в Европе или на собственной инфраструктуре.
Начните работу
Voxtral 3 доступна сейчас через API Mistral с европейскими, американскими и глобальными точками входа.
Можно тестировать голосовых агентов, транскрипцию аудио, синтез речи и клонирование голоса в studio playgrounds.
Модель |
Цена |
|---|---|
Voxtral Mini Transcribe 3 (пакетная обработка) |
$0,0035/мин |
Voxtral Mini Transcribe Realtime 3 |
$0,008/мин |
Voxtral Small Transcribe 3 |
$0,0040/мин |
Voxtral Speech 3 (пакетная обработка и реальное время, один API) |
$13/1M символов |
Для запуска полного стека на собственной инфраструктуре или в приватном облаке свяжитесь с командой.