От идеи к реализации
За последний месяц велась работа над расширением функциональности z486_MiSTer, главным образом игры из первой половины 1990-х годов. Взглянув на несколько лет вперёд, обнаружился ещё один интересный период: появление 3D-графических ускорителей.
Первый из них, который произвел сильное впечатление, был Voodoo. Игра была Need for Speed II SE. Гладкие текстуры, туман и скорость в целом создавали ощущение нового поколения PC-игр. Получится ли воссоздать это на FPGA, теперь когда существует z486 CPU?
Результат этого отступления — zSST, реализация на SystemVerilog графического ускорителя 3dfx Voodoo Graphics, или SST-1. В сочетании с CPU z486 и окружающей PC-аппаратурой это формирует z486 XL: DOS-компьютер с графикой Voodoo, работающий в программируемой логике платы Xilinx KV260. Tomb Raider теперь работает с его оригинальным 3dfx-рендерером.
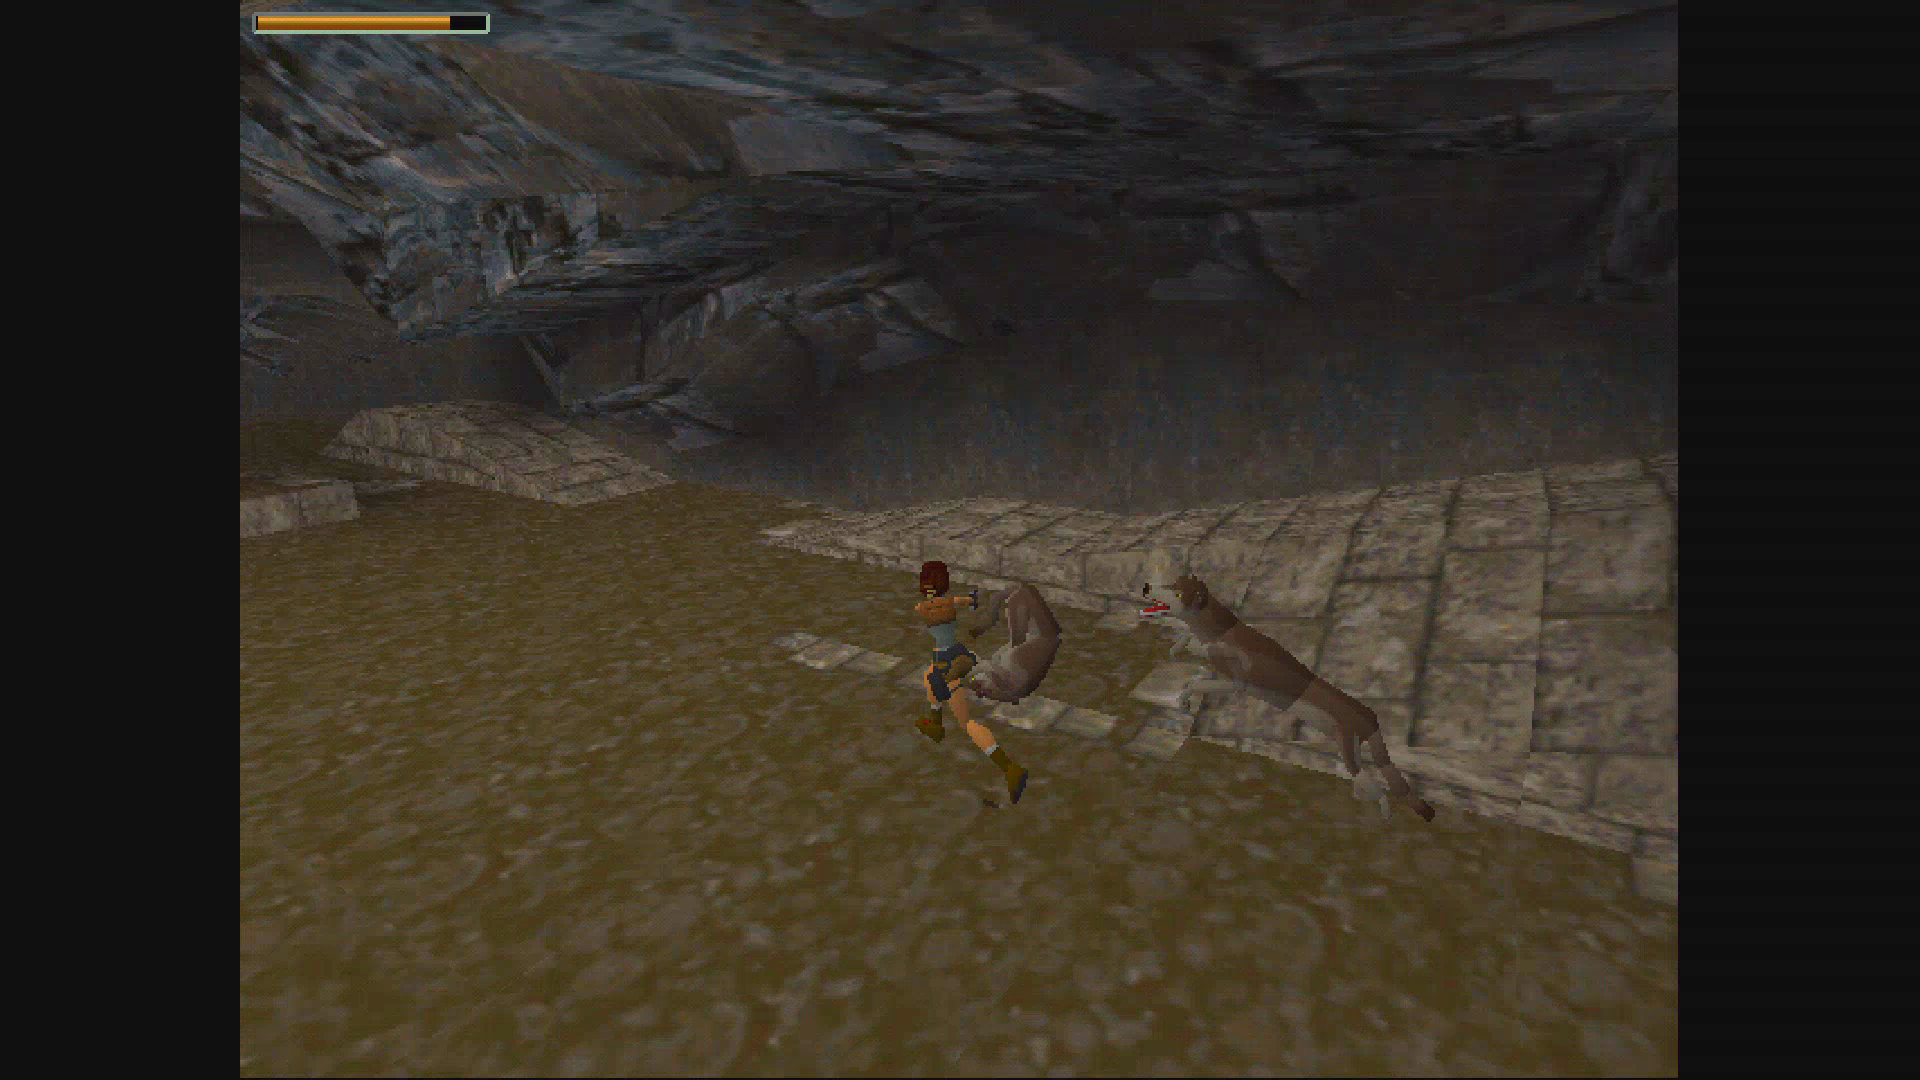
zSST реализует большинство центральных возможностей Voodoo: подготовленные треугольники, фильтрацию текстур и миппинг, тесты глубины и альфа-канала, туман, блендинг, дизеринг, доступ к буферу кадров и переключение буферов. Поддерживает оба интерфейса настройки — с фиксированной и плавающей точкой. Тестирование на реальном оборудовании пока сосредоточено на Tomb Raider; более широкая совместимость и поздние поколения Voodoo — дело другого дня.
CPU и рендерер работают на 100 МГц на KV260. На этой плате достаточно логики, DSP-блоков, встроенной памяти и полосы пропускания DDR для объединённого проекта. Плата DE10-Nano не имеет места для этого графического дополнения. KV260 использует встроенную DDR; нет никакого внешнего модуля SDRAM для добавления.
Начиная с модели программирования
К счастью, есть достаточно материалов для работы. 3dfx выпустила исходный код Glide в 1999 году, перед тем как NVIDIA приобрела её основные графические активы в декабре 2000 года. Сохранившийся исходный код Glide и спецификация SST-1 объясняют, как программное обеспечение подготавливает треугольники, настраивает конвейер пиксель-обработки и управляет текстурами и буферами кадров.
Спецификация — это цель поведения, а не принципиальная схема. Она говорит, что должно произойти, когда ПО записывает регистр, но оставляет многие решения реализации открытыми. 86Box предоставляет полезные ссылки для сложного поведения рендеринга. Более ранняя работа над Voodoo в MAME — ещё одна часть этой истории сохранения. SpinalVoodoo предоставила особенно полезные трассировки Glide и эталонные снимки экрана для тестирования.
От треугольников к 3D: один пиксель за такт
Voodoo Graphics преобразует треугольники в пиксели, оставляя большую часть 3D-работы хост-CPU. Его интерфейс команд удивительно компактен: пять основных регистров команд управляют ускорителем.
| Регистр | Действие |
|---|---|
triangleCMD |
Начать рендеринг подготовленного треугольника. |
ftriangleCMD |
Начать треугольник через интерфейс настройки с плавающей точкой. |
nopCMD |
Очистить конвейер; опционально сбросить счётчики статистики. |
fastfillCMD |
Очистить обрезанный прямоугольник данных цвета и/или глубины. |
swapbufferCMD |
Переключить отображаемый буфер, немедленно или синхронизированно с вертикальной разверткой. |
Обе команды треугольника запускают один и тот же конвейер рендеринга. Другие регистры содержат координаты, градиенты и состояние рендеринга, а области, отображённые в памяти, предоставляют загрузку текстур и прямой доступ к буферу кадров. Основным примитивом рисования является просто подготовленный треугольник.
Для разработчиков игр Glide представляет более дружественный интерфейс:
void grDrawTriangle(const GrVertex *a, const GrVertex *b, const GrVertex *c);Перед этим вызовом хост-CPU преобразует 3D-геометрию, вычисляет освещение вершин, обрезает её и проецирует на экран. Затем Glide подготавливает треугольник в пространстве экрана и его градиенты параметров — приращения, используемые для интерполяции значений по его поверхности — и записывает команду треугольника для начала рендеринга. В отличие от более поздних GPU, таких как GeForce 256, SST-1 не имеет аппаратного модуля трансформации и освещения.
Тем не менее ускоритель всё ещё имеет много работы. Растеризатор находит, какие центры пикселей лежат внутри треугольника, и интерполирует их цвет, глубину и координаты текстуры. Модуль текстур выбирает и фильтрует текселы; модуль буфера кадров объединяет цвета, применяет тесты видимости и туман, смешивает с существующим изображением и записывает результат.
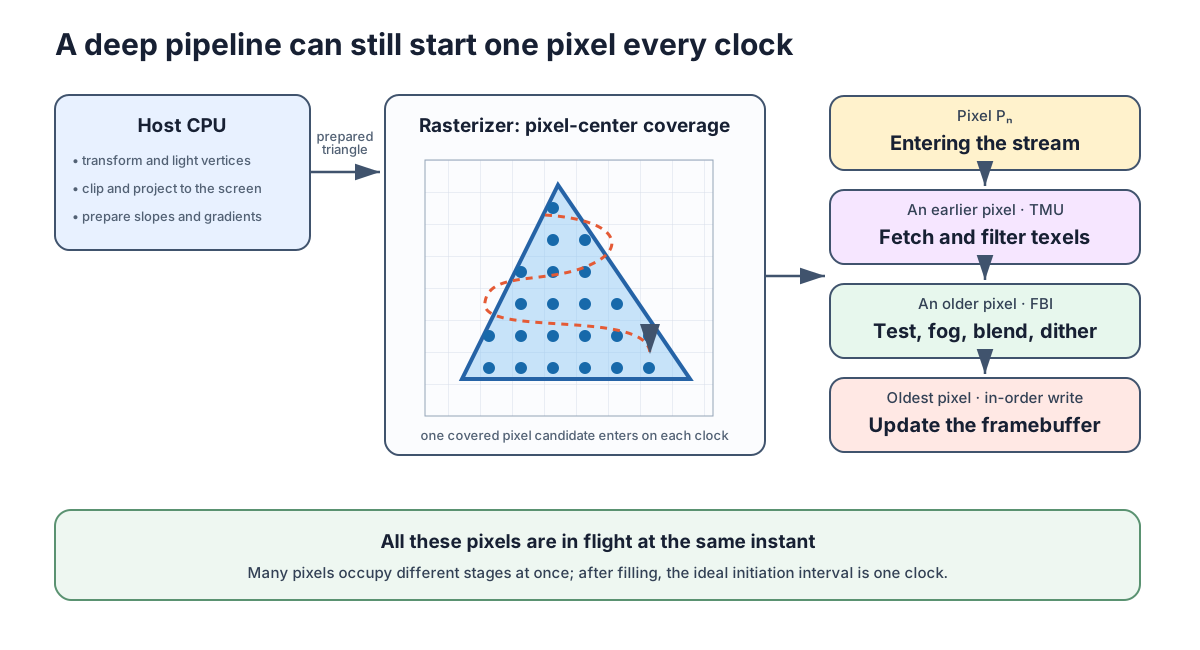
Оригинальная карта разделяет эту работу между двумя ASIC: FBI (Frame Buffer Interface) и TREX (модуль текстурной выборки), обычно называемый TMU. На графической частоте 50 МГц заявленный пик — один текстурированный, протестированный по глубине выходной пиксель за такт: 50 миллионов пиксель в секунду.
Один пиксель за такт не означает, что пиксель завершается за один такт. Это означает, что разные стадии могут одновременно работать над разными пикселями: пока один пиксель текстурируется, более ранний может смешиваться, а другой записываться. Как только конвейер полон, он может в идеале принять и завершить пиксель каждый такт, при условии, что память держит ритм.
В этом привлекательность фиксированного конвейера. Программный рендерер выполняет много инструкций для каждого пикселя; выделенное оборудование перекрывает эту работу через стабильный поток пиксель. Voodoo привнесла богато текстурированные 3D-игры на экраны с частотой 30 FPS и более — большая часть того, что сделало её такой популярной.
Построение конвейера пиксель
По сравнению с x86 CPU, арифметический путь приятно регулярен. Проследим пиксель от его интерполированных параметров через текстурирование и цветовые операции к буферу кадров, начиная с того, как числа представлены.
Фиксированная точка за интерфейсом плавающей точки
Арифметика с плавающей точкой центральна для современного программирования GPU. SST-1 находится в интересном переходе: программное обеспечение может отправлять значения с плавающей точкой, но машина рендеринга в основном работает с фиксированной точкой — целыми числами с неявным масштабным коэффициентом.
| Установочное значение | Формат регистра с фиксированной точкой |
|---|---|
| Экран X и Y | 12.4 |
| Красный, зелёный, синий, альфа | 12.12 |
| Глубина Z | 20.12 |
| Текстура S/W и T/W | 14.18 |
| Обратное W | 2.30 |
Здесь 12.4 означает двенадцать битов перед двоичной точкой, включая знак, и четыре дробных бита. Координата экрана 10.5 поэтому хранится как целое число 168: умножьте на 16 для кодирования, разделите на 16 для восстановления значения. Эти дробные биты позволяют растеризатору обрабатывать вершины между центрами пиксель.
Регистры fvertex, fstart и градиента с плавающей точкой принимают значения одинарной точности IEEE. SST-1 преобразует их во внутреннее представление с фиксированной точкой, и zSST следует этому контракту. Как только треугольник подготовлен, продвижение вдоль строки развёртки в основном означает добавление предварительно вычисленного приращения к каждому интерполированному параметру. Большая часть работы «пиксель за пиксель» становится простым целочисленным сложением.
Четыре текселя для одного пикселя
Для перспективно-корректного текстурирования TMU интерполирует S/W, T/W и 1/W, затем делит первые два на третье, чтобы восстановить координаты текстуры. Это держит текстуру пола или стены в перспективе по мере отступления поверхности. TMU также выбирает уровень мип: меньшую версию текстуры для пиксель, которые охватывают большую площадь её поверхности. Это уменьшает алиасинг и мерцание на расстоянии.
Билинейная фильтрация затем объединяет четыре соседних текселя — пиксель текстуры — вокруг позиции выборки. Сначала смешайте верхнюю пару горизонтально, затем нижнюю пару, и, наконец, смешайте вертикально между этими двумя результатами. Дробная позиция определяет веса, создавая плавный переход между цветами тексель вместо резкого скачка с одного на другой.
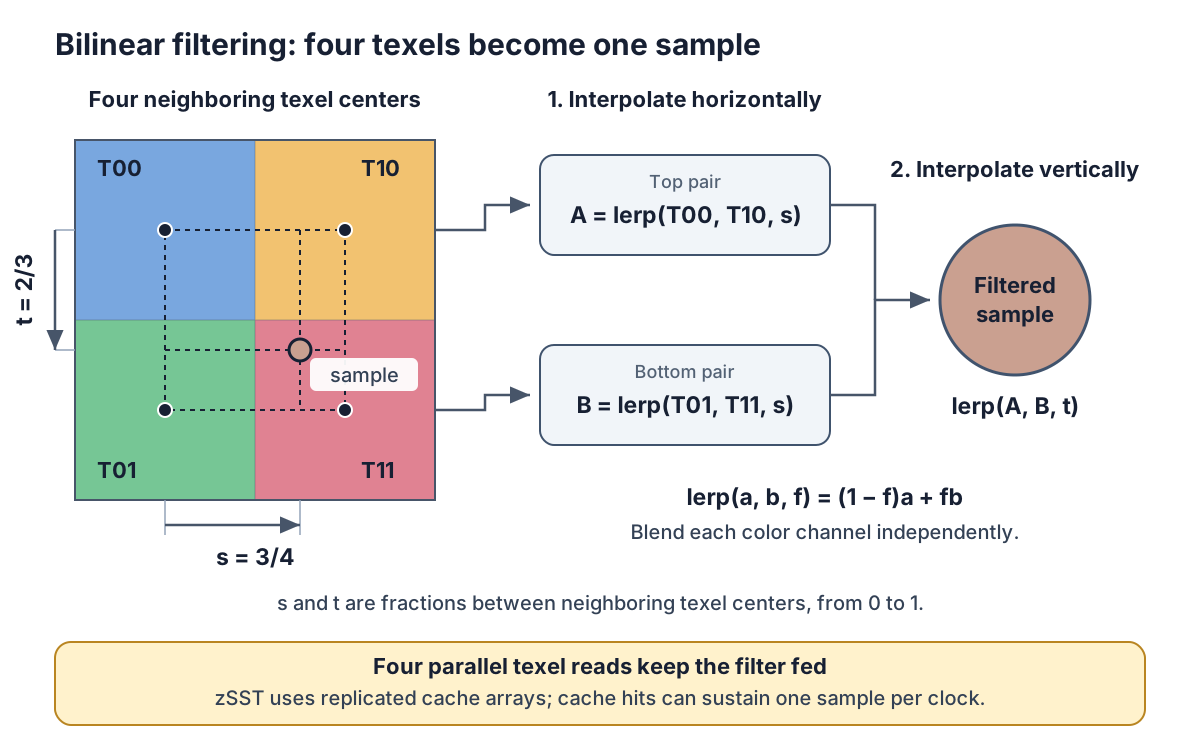
В zSST четырёхстадийная передняя часть конвейеризует расчёты перспективы и уровня детализации. Генерация адреса и поиск в кэше предоставляют текселы, и две зарегистрированные стадии декодирования преобразуют их сохранённые форматы в цвета для фильтрации и объединения текстур. Текстуры на основе палитры и закодированные NCC требуют различных правил декодирования, но в конечном итоге питают один поток пиксель.
Цвет, тесты, туман и блендинг
Когда данные текстуры и буфера кадров доступны, путь пиксель FBI в zSST использует шесть зарегистрированных стадий:
| Стадия | Основная работа |
|---|---|
| F0 | Выбрать источники, проверить ключ цвета (chroma key), подготовить значения глубины Z/W. |
| F1 | Применить функции цветового и альфа-комбинирования. |
| F2a | Протестировать альфа/глубину и найти коэффициент тумана. |
| F2b | Применить туман. |
| F3 | Восстановить цвет назначения и выполнить альфа-блендинг. |
| F4 | Преобразовать в точность буфера кадров, применить дизеринг и маски записи. |
Эти границы стадии выбраны для достижения цели частоты FPGA. Спецификация SST-1 описывает операции, но не раскрывает точные регистры конвейера оригинального ASIC. Разделение поиска тумана от применения тумана, например, держит длинный арифметический путь вне одного такта, сохраняя при этом возможность принять один пиксель за такт.
Результат записывается в задний буфер. Синхронизированная со строчной развёрткой перестановка буфера затем выводит готовое изображение без переключения буферов во время считывания. Оригинальный Voodoo был 3D-ускорителем-дополнением, пропускающим выход обычной VGA-карты через себя при неактивности. z486 XL делает аналогичный выбор между выходом PC VGA и выходом дисплея zSST внутри системы FPGA.
Сложная часть: питание данными из памяти
Конвейер пиксель zSST оказался относительно простым для реализации, по крайней мере по сравнению с конвейерами CPU z486. Поддерживать его в работе оказалось намного сложнее. Билинейная выборка требует четырёх текселей из отдельных адресов. Протестированный по глубине, смешанный пиксель также требует существующих глубины и цвета, а затем записи новых значений. Выполнение этих операций доступа одна за другой быстро разрушает пропускную способность. Потратил больше времени на проектирование, настройку и отладку системы памяти, чем на арифметический конвейер.
Как оригинальная карта питала пиксель
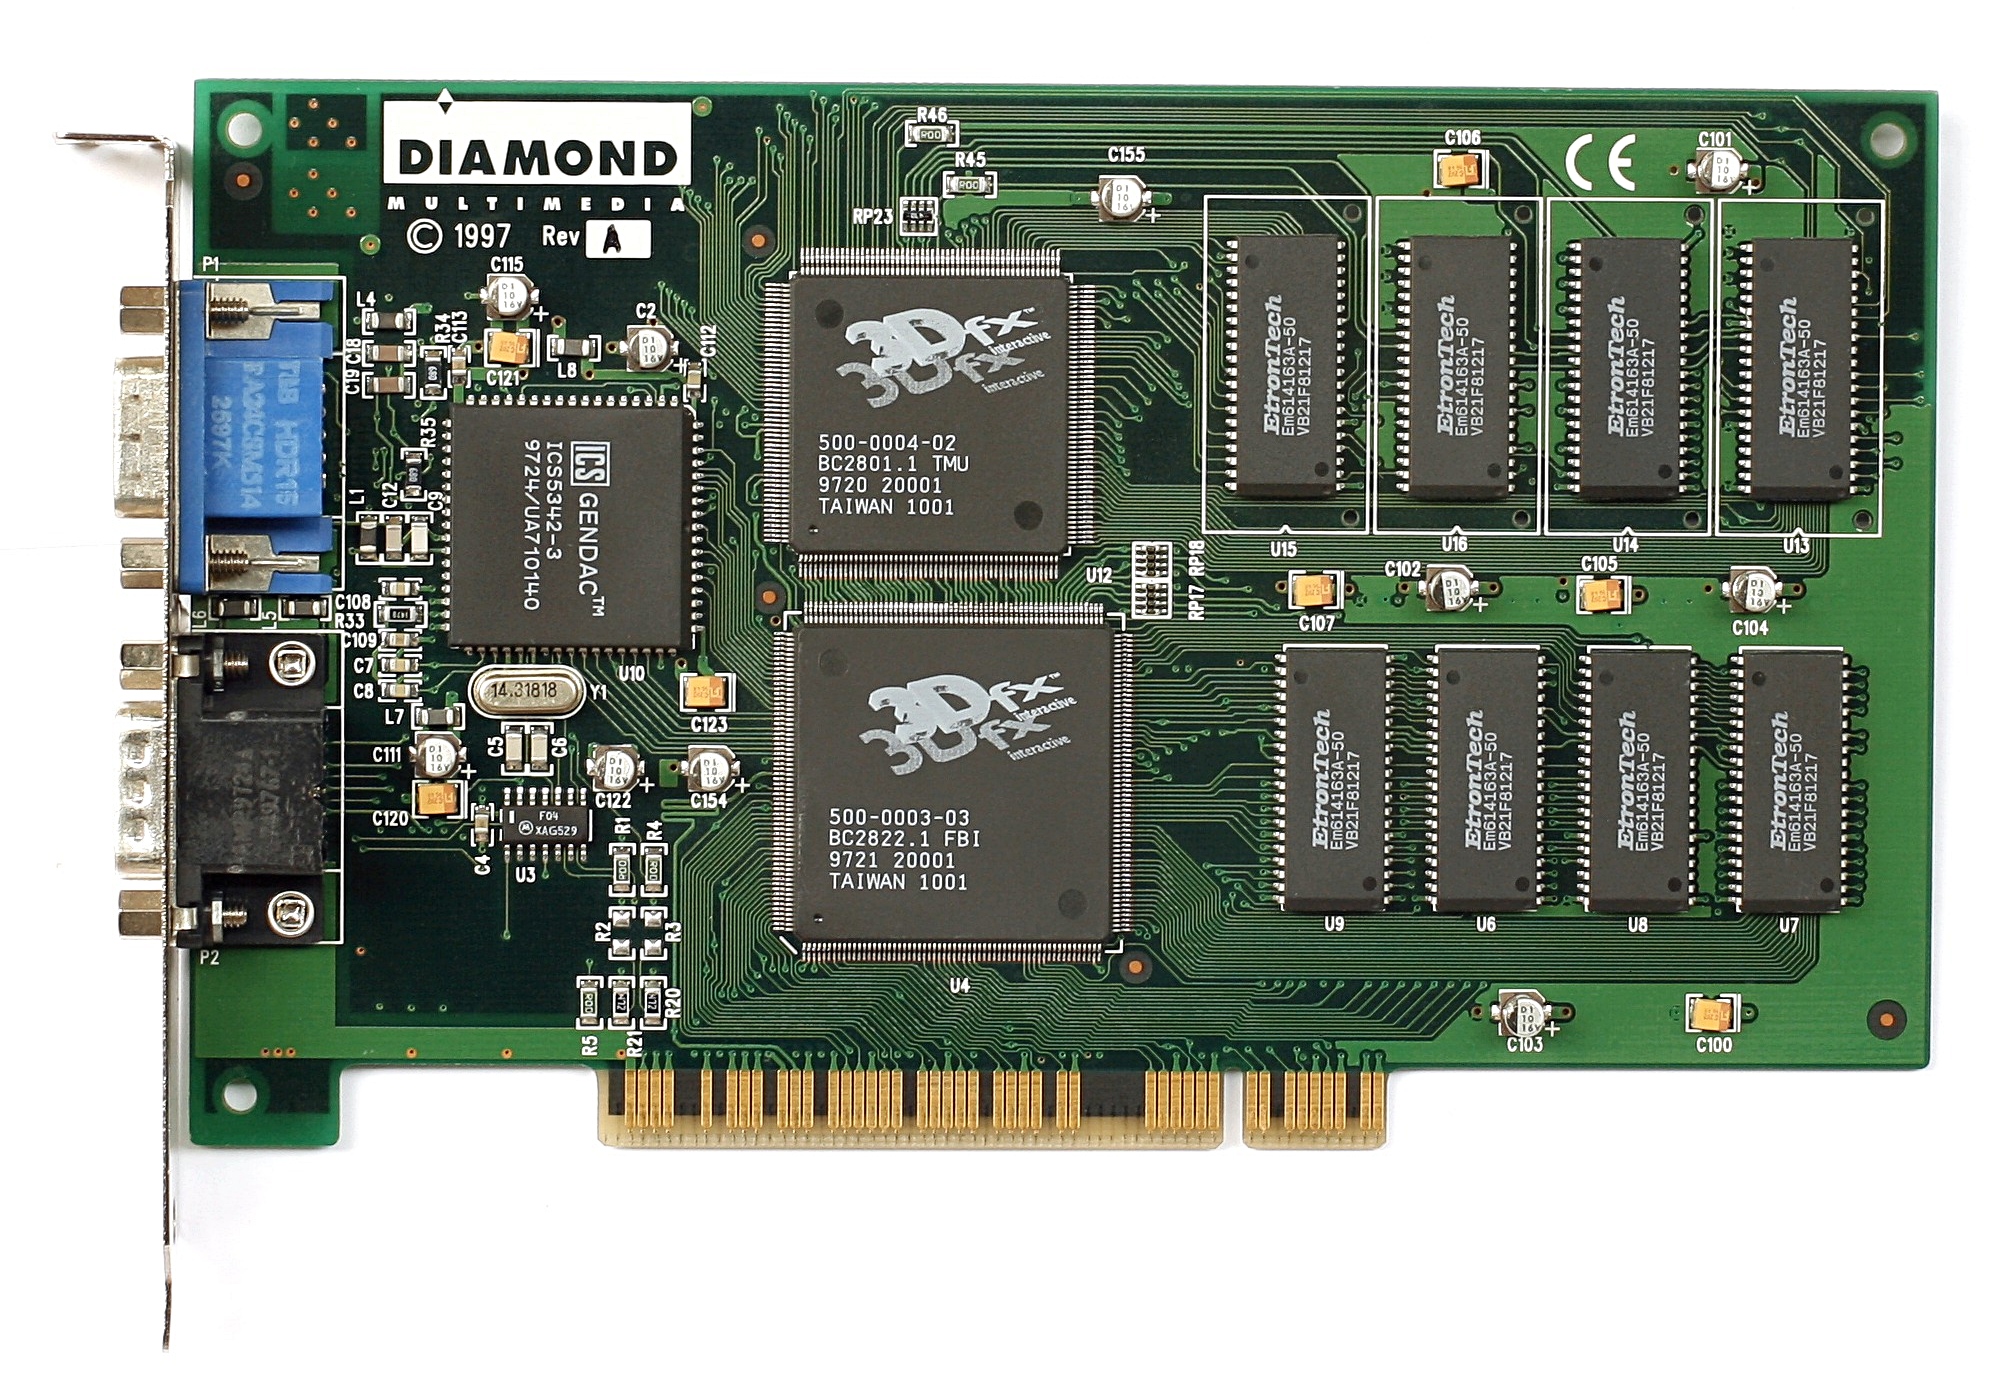
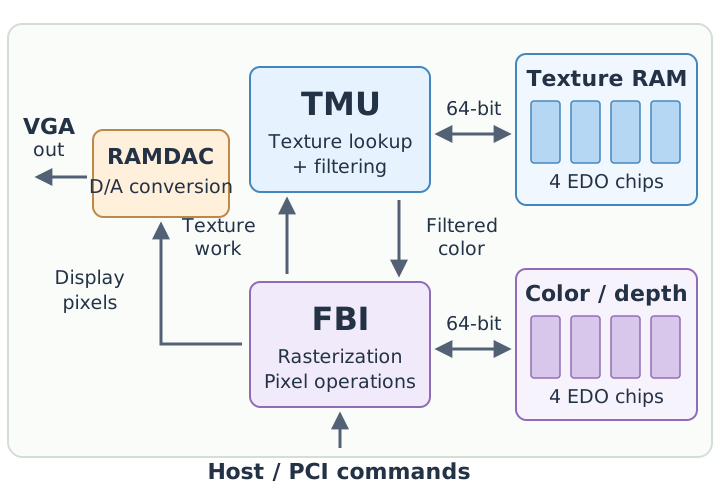
Фото: Konstantin Lanzet; обрезка: Pittigrilli, Wikimedia Commons. Лицензия фото: GFDL 1.2 или позже. Принципиальная схема: nand2mario.

Разделение труда видно на этой Diamond Monster 3D. Верхний чип 3dfx это TMU, нижний это FBI, каждый с четырьмя чипами EDO RAM справа. Верхняя группа держит текстуры; нижняя группа держит буфер цвета и глубины/альфа.
FBI и TMU имеют каждый выделенный 64-битный путь памяти. На текстурной стороне, четырёхсторонняя перемежаемость позволяет банкам читать независимые адреса, снабжая четырёх соседей для билинейной фильтрации параллельно. Спецификация (стр. 13) обещает ту же пропускную способность, что и точечная выборка, без хранения дублирующихся текселей.
Но что если два соседних текселя приземляются в один чип? Трюк в том, чтобы распределять текселы в повторяющемся двумерном паттерне, а не разбивать изображение на четыре больших региона. Назначьте банк каждой комбинации чётной или нечётной колонны и строки, и причина становится понятна:
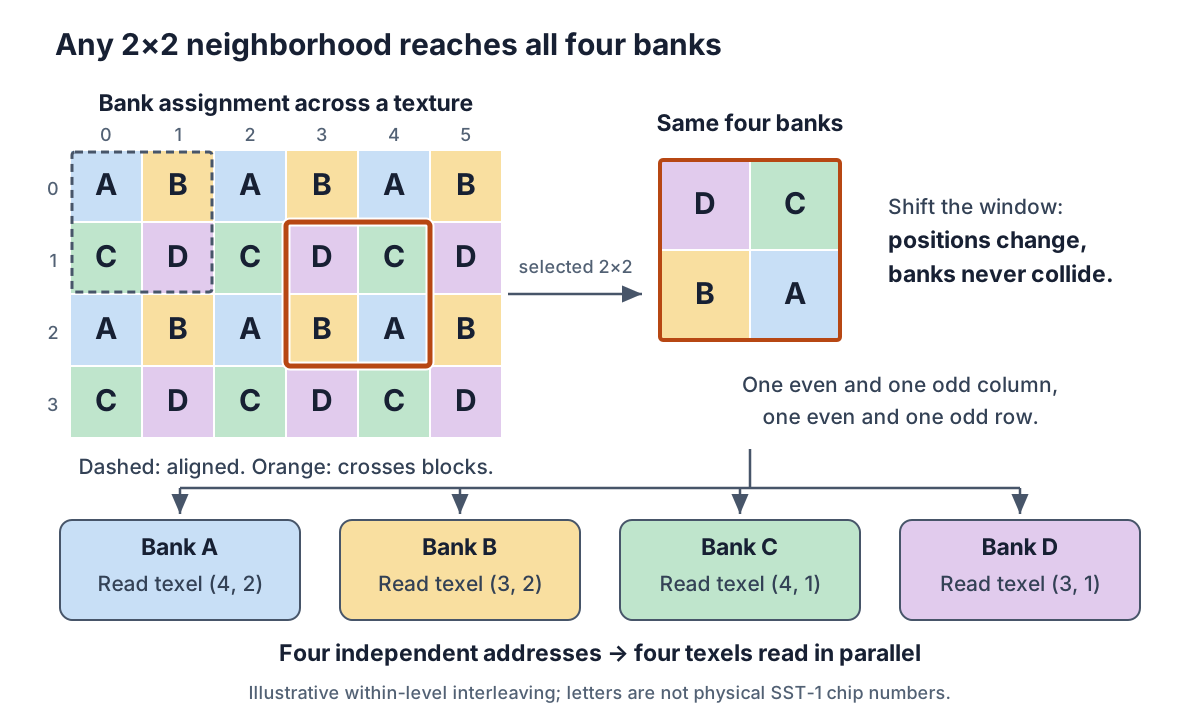
Каждое окно 2×2 содержит A, B, C и D — даже оранжевое окно, пересекающее как горизонтальные, так и вертикальные границы блоков. Два последовательных столбца имеют противоположную чётность, как и две последовательные строки. Все четыре комбинации встречаются ровно один раз, поэтому каждый банк поставляет один тексель без конфликта.
Края текстуры и малые уровни мип требуют немного больше заботы. SST-1 использует размеры текстур, являющиеся степенями двойки, поэтому оборачивание сохраняет чередующийся паттерн для размеров двух или более. На зажатых краях или в уровнях мип только один тексель в ширину или высоту, некоторые выборки повторно используют один и тот же тексель. Центральное понимание остаётся: быстрая билинейная фильтрация зависит от расположения памяти так, чтобы арифметика получала все свои входы вместе.
FBI применяет аналогичную идею к памяти цвета и глубины/альфа. Его перемежаемый путь поддерживает пик в один отрендеренный пиксель за такт, или два пикселя за такт для очисток. Работа над соседними пикселями вместе распределяет стоимость чтения/записи по строке развёртки. Объяснение двух пиксель Fabien Sanglard предлагает полезное восстановление этого поведения, хотя точное расписание банков ASIC не документировано в руководстве программирования.
На 50 МГц каждый 64-битный путь имеет теоретическую пропускную способность 400 МБ/с: 800 МБ/с в целом, но зарезервировано для разных работ. TMU не может занять неиспользуемую полосу пропускания FBI, или наоборот. Эти выделенные шины и тщательно расположенные банки напоминают мне проекты из эпохи NES- и SNES, которые я изучал в проектах, таких как SNESTang: получение максимума из памяти означает проектирование вокруг точно когда и где нужно каждое значение.
Что изменяется на FPGA SoC
Макет памяти Voodoo объясняет, как оно держало конвейер активным, но не могу просто пересадить этот проект на KV260. Плата имеет намного больше полосы пропускания памяти, но нет выделённой памяти EDO, присоединённой к какому-либо модулю рендеринга. Вместо этого FPGA получает доступ к общей DDR через порты AXI обработочной системы Zynq. Linux, FPGA PC и вывод дисплея все конкурируют за эту память. Цель та же — держать конвейер пиксель активным — но способ её достижения должен измениться.
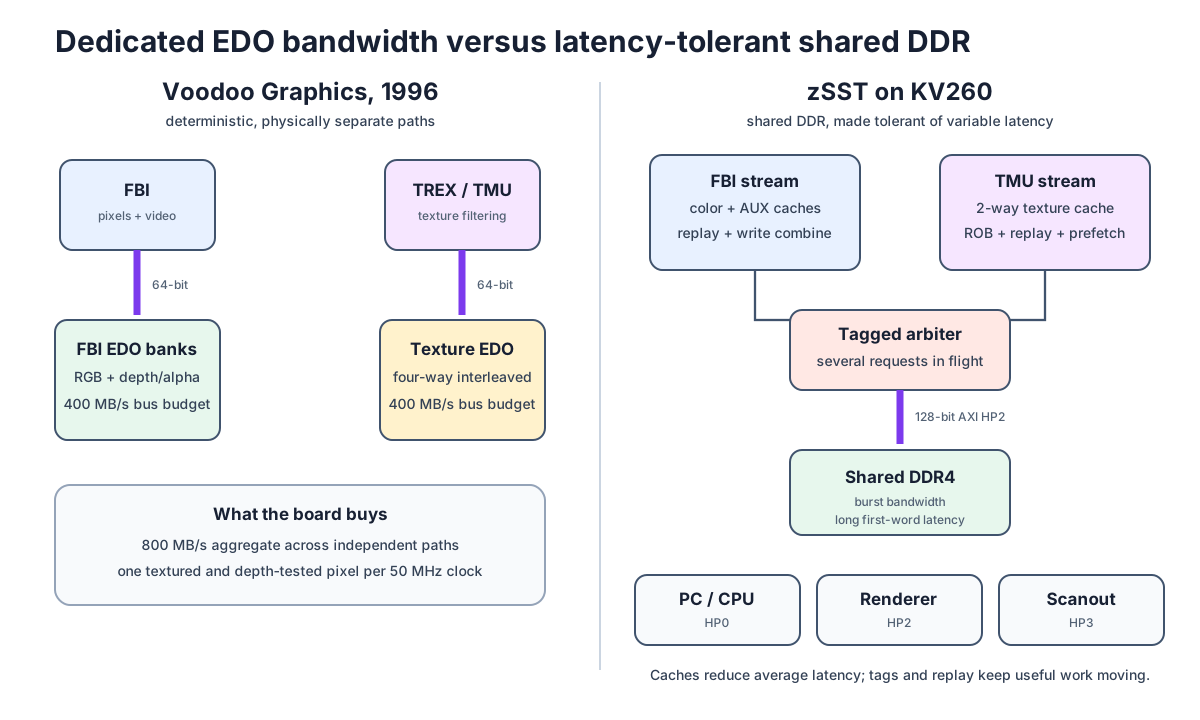
Наши измерения KV260 показывают почему полосы пропускания недостаточно. 128-битный порт на 100 МГц имеет теоретическую пропускную способность 1.6 ГБ/с. С одним выдающимся запросом, 4 КиБ чтение достигает 1 370 МиБ/с, но 64-байтовое чтение достигает только 189 МиБ/с. Первые данные обычно приходят примерно через 280 нс — примерно 28 тактов на 100 МГц — с иногда намного более длинными ожиданиями.
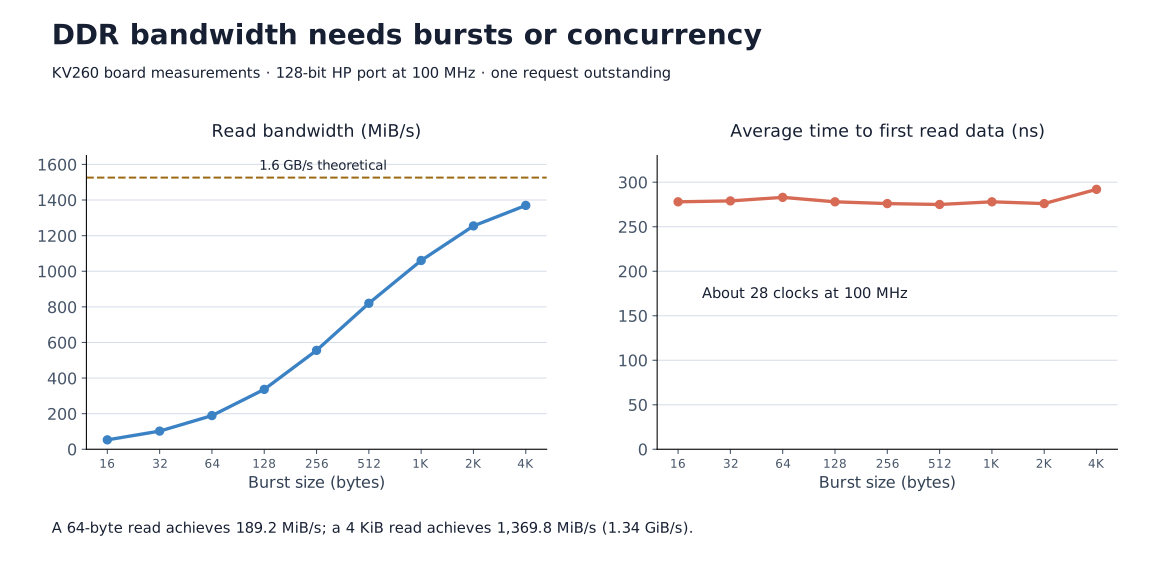
Рендерер, который ждёт каждое малое чтение перед выдачей следующего, потратит большую часть времени в режиме ожидания. zSST требует достаточно независимой работы в полёте, чтобы охватить эти ожидания.
Кэши, перепроверка и буфер переупорядочивания
Питание конвейера требует как меньше операций доступа к DDR, так и меньше времени в ожидании них. Первый шаг — кэширование. Соседние пиксель экрана часто выбирают перекрывающиеся части текстуры, поэтому недавно выбранные текселы можно повторно использовать из встроенной RAM. Кэш текстур zSST держит 8 КиБ в 64-байтовых строках; каждая выборка также приносит соседние текселы, которые последующие пиксель, вероятно, нужны.
Промах кэша всё ещё требует много тактов, но независимые выборки текстур не должны ждать этого. zSST держит до восьми выборок строк кэша в полёте, используя очередь перепроверки для припаркивания выборок с отсутствующими данными и повторения их при приходе. Тем временем, выборки, чьи текселы уже закэшированы, могут продолжаться. Предварительная выборка получает фору на будущие чтения.
Теперь более позднее попадание в кэш может закончиться раньше более раннего промаха. Буфер переупорядочивания на 64 записи, или ROB, собирает эти результаты и выпускает их в исходном порядке. Принцип знаком из CPU: выполняй полезную работу во время долгого ожидания, затем восстанови порядок перед передачей результатов дальше.
Сторона буфера кадров использует отдельные кэши чтения цвета и глубины/альфа 4 КиБ, в то время как комбайнеры записи упаковывают соседние 16-битные обновления в 128-битные запросы. Здесь порядок имеет значение: смешивание или тестирование глубины может потребовать значение, которое более ранний пиксель изменил, но ещё не записал в DDR. Пересылка поставляет ожидающее значение напрямую. Обновления буфера кадров вступают в силу по порядку, и изменения состояния, требующие выполненной работы, ждут её слива. Запросы памяти могут перекрываться, но более поздние пиксель всё ещё должны видеть эффекты более ранних.
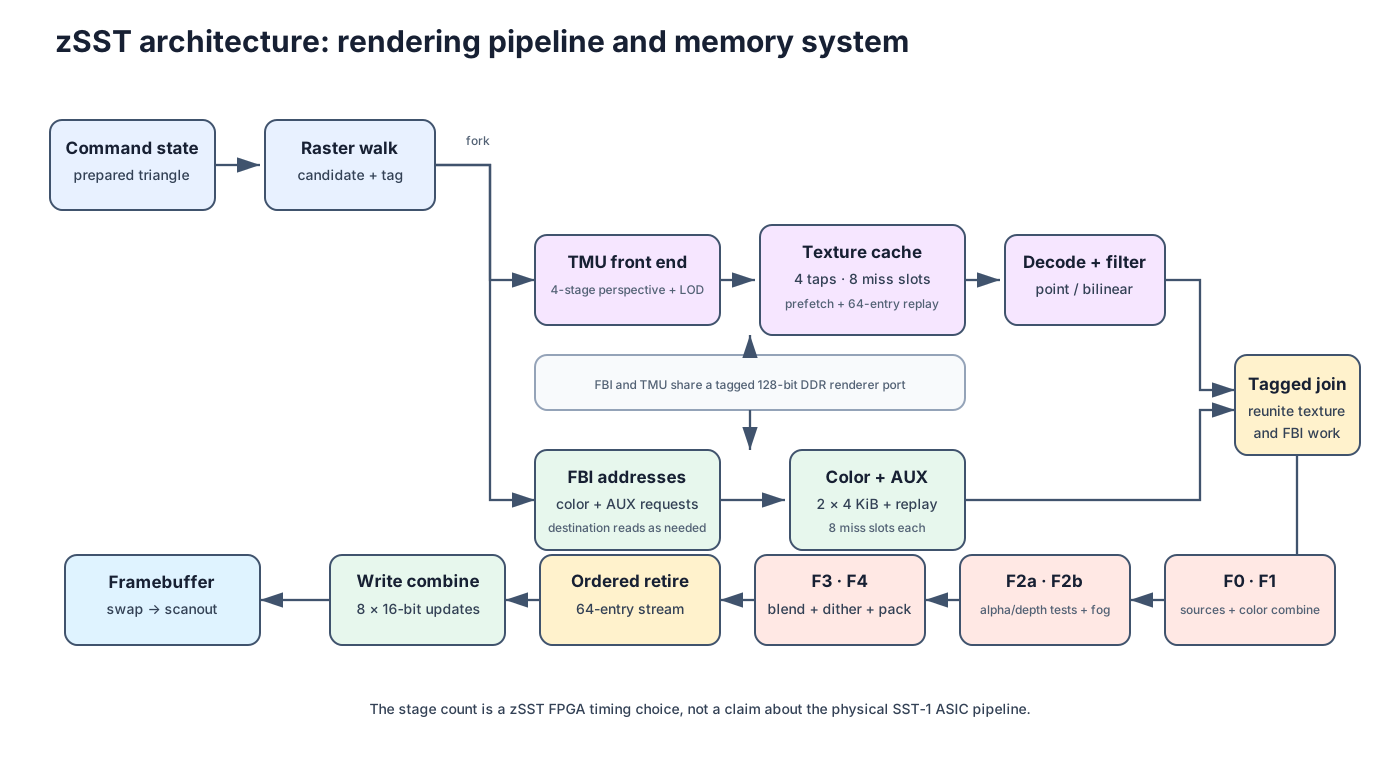
FBI и TMU делят 128-битный порт AXI рендерера, HP2. PC использует HP0 и вывод дисплея использует HP3, держа их очереди запросов отдельными, даже хотя все три в конечном итоге делят DDR.
Результаты оценки
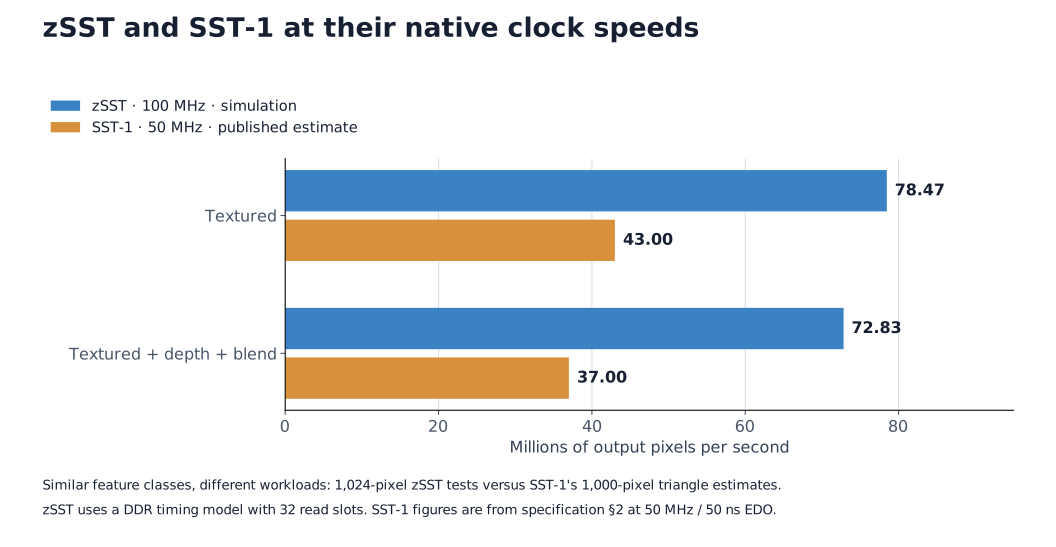
Рендерер измеряется отдельно от полного PC. Бенчмарк симуляции отправляет команды через переднюю часть zSST и нагружает TMU, FBI, общий арбитр и модель времени DDR. Данные для чтения приходят после как минимум 26 тактов, с детерминированной вариацией и иногда более длинными задержками; записи также ограничены по скорости. Тесты полного рендерера позволяют 32 выдающихся чтения.
На 100 МГц zSST достигает 78.5 млн пиксель в секунду (МПикс/с) для текстурированных треугольников, и 72.8 МПикс/с с тестированием глубины и смешиванием. Опубликованные оценки Voodoo 1 на его нативной 50 МГц составляют 43 и 37 МПикс/с для сравнимых наборов возможностей. Это не сравнение «яблоко к яблоку»: нагрузки треугольников отличаются, и исходные оценки также включают туман, миппинг и затенение Gouraud. Нет Voodoo 1 для запуска одного и того же теста на обоих. Сравнение показывает приблизительный диапазон частоты заливки, не измеренный прирост скорости над оригинальной картой.
Высокие частоты заливки не автоматически переводятся в высокие FPS игры. На плате Tomb Raider Level 2 произвёл 237 отображаемых переключений буферов примерно за 20 секунд — примерно 12 в секунду, измеренных по переключениям вместо счётчика FPS движка. Предварительные измерения указывают на узкое место CPU: ему всё ещё нужно запустить игру, подготовить геометрию и отправить команды. Конкуренция за общую DDR также может способствовать. Есть много что оптимизировать в полной машине.
Для игр, не использующих Voodoo, текущая 100 МГц z486 XL запускает Doom с максимальными деталями на 38.5 FPS и Quake 1.06 на 8.1 FPS. Это примерно на 20% быстрее, чем сборка DE10-Nano на 85 МГц — около 23% для Doom и 19% для Quake. 512 КиБ кэш L2 с обратной записью в UltraRAM помогает CPU лучше использовать DDR.
В интегрированной сборке XCK26, zSST занимает около 29 500 LUT, 28 100 флип-флопов, 14 блоков RAMB36, 8 блоков RAMB18 и 97 срезов DSP. Объединённый дизайн PC и графики встречает тайминг на 100 МГц.
Заключение
Полезная часть — видеть, как оригинальное программное обеспечение Glide управляет аппаратурой, которую построил в RTL. Ожидал, что арифметика рендеринга будет сложной частью; эффективное питание данными потребовало больше работы. Функция Voodoo с тщательно перемежаемой памятью EDO и zSST с кэшами и очередями решает одну и ту же проблему под совершенно различными ограничениями: быстрый конвейер пиксель полезен только когда у него есть что-то для работы.
И zSST, и z486 XL доступны с открытым исходным кодом. Если уже есть KV260, образ SD z486 XL предоставляет поддержку Linux и приложения, необходимые для запуска собственных образов дисков DOS.
Благодарности: спасибо SpinalVoodoo за трассировки Glide и эталонные скриншоты, и 86Box за его ссылки реализации. История 3dfx Voodoo1 Fabien Sanglard — это отличное введение в систему памяти оригинальной карты.