Быстрая сортировка с векторными инструкциями
Google поделился открытым исходным кодом реализации Quicksort, способной сортировать массивы чисел примерно в 10 раз быстрее, чем стандартный C++ std::sort, при этом превосходя специализированные архитектурно-зависимые алгоритмы. Реализация портативна для всех современных архитектур процессоров.
Контекст: колонарные базы данных и SIMD
В последние годы растёт интерес к колонарным базам данных, которые хранят все значения одной колонки последовательно, а не построчно. Такой подход ускоряет фильтрацию и сортировку — ключевые операции SQL-запросов. Этот тип расположения данных стал фокусом при разработке новой реализации.
Вопрос логичен: как достичь 10-кратного ускорения в алгоритме, изучаемом десятилетиями? Ответ — в SIMD (Single Instruction Multiple Data) и векторных инструкциях. Они позволяют выполнять одну операцию над несколькими независимыми элементами: например, обрабатывать 16 чисел float32 одновременно с использованием AVX-512, или четыре значения на Arm NEON:
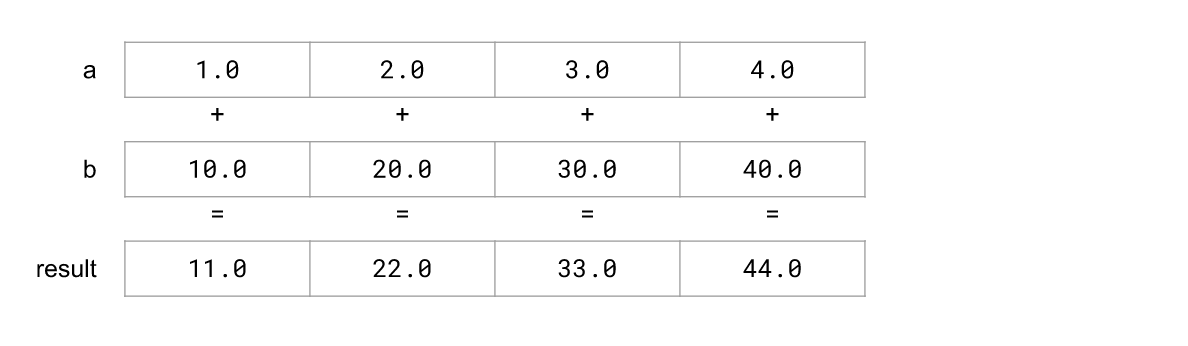
SIMD применяется в суперкомпьютерах, линейной алгебре для машинного обучения, обработке видео и кодеках изображений вроде JPEG XL. Однако традиционно считалось, что SIMD работает только с независимыми элементами. Как тогда сортировать, когда нужно переставлять соседние элементы массива?
Применение SIMD к сортировке
Подход основан на предположении: пусть у нас есть специальный способ сортировать массивы из 256 элементов. Для большего массива применяется алгоритм Quicksort, который разбивает его на две подмассивы — элементы меньше опорного значения (ideally медиана) и остальные. Затем рекурсивно сортирует, пока размер подмассива не станет ≤ 256, применяя специальный метод.
Разбиение (partitioning) занимает большую часть времени ЦПУ. Если ускорить эту операцию SIMD, весь алгоритм станет быстрее.
Современные наборы инструкций (Arm SVE, RISC-V V, x86 AVX-512) включают специализированную инструкцию для разбиения — compress-store. Дав ей на вход массив yes/no значений (меньше ли элемент опорного), она записывает в последовательную память только элементы с "yes". Затем логически инвертируем yes/no и применяем инструкцию снова, чтобы разместить оставшиеся элементы в другой раздел. Этот подход использовалась в специализированном для AVX-512 Quicksort.
Что делать с наборами вроде AVX2, у которых нет compress-store? Ранние исследования показали, как эмулировать такую инструкцию, используя операции перестановки (permute).
Портативная реализация
Google построила первый векторизованный Quicksort, портативный для шести наборов инструкций на трёх архитектурах и одновременно превосходящий предыдущие специализированные реализации. Реализация использует портативные SIMD функции библиотеки Highway, избегая необходимости переписывать около 3000 строк C++ для каждой платформы. Highway автоматически применяет compress-store, где он доступен, и иначе использует эквивалентные операции перестановки.
В отличие от предыдущего лучшего решения, которое работало только с 32-битными целыми числами, новая реализация поддерживает полный диапазон входных данных от 16 до 128 бит.
Результаты производительности
Несмотря на единую портативную реализацию, код достигает рекордных скоростей на AVX2, AVX-512 (Intel Skylake) и Arm NEON (Apple M1). Для одного миллиона чисел размером 32/64/128 бит код на Apple M1 выдаёт сортировку на скорости 499/471/466 МБ/с. На 3 ГГц Skylake с AVX-512 скорости составляют 1123/1119/1120 МБ/с.
Интересно отметить: AVX-512 примерно в 1,4–1,6 раза быстрее AVX2 — достойное ускорение без дополнительных усилий (Highway автоматически определяет доступные инструкции и использует лучшие из них). На AVX2 достигается 798 МБ/с, тогда как предыдущее лучшее решение, оптимизированное только под AVX2, показывало лишь 699 МБ/с. Для сравнения: стандартная библиотека достигает 58/128/117 МБ/с на том же ЦПУ, что дает ускорение в 9–19 раз в зависимости от типа данных.
Будущие возможности
До сих пор сортировка считалась дорогостоящей операцией. Сообщество интересует, какие новые приложения и возможности откроются благодаря способности сортировать на скорости 1 ГБ/с на одном ядре ЦПУ.
Исходный код распространяется под лицензией Apache2 и доступен на GitHub (можно открыть issue с вопросами или замечаниями). Подробное объяснение и оценка реализации, включая специальный случай для 256 элементов, содержатся в опубликованной статье.
Jan Wassenberg, Brain Computer Architecture Research