Что такое трансформер?
Трансформер — это архитектура нейронной сети, которая фундаментально изменила подход к искусственному интеллекту. Она была впервые представлена в семинальной работе «Attention is All You Need» в 2017 году и с тех пор стала стандартной архитектурой для глубокого обучения, питая текстогенеративные модели вроде GPT от OpenAI, Llama от Meta и Gemini от Google. За пределами текста трансформер применяется в генерации аудио, распознавании изображений, предсказании структуры белков и даже игре в игры, что демонстрирует его универсальность во множестве областей.
В основе текстогенеративных моделей на базе трансформера лежит принцип предсказания следующего токена: дан текстовый запрос от пользователя — какой наиболее вероятный следующий токен (слово или часть слова) будет следующим? Основное и мощное новшество трансформеров — использование механизма self-attention, который позволяет им обрабатывать целые последовательности и эффективнее захватывать долгодистанционные зависимости по сравнению с предыдущими архитектурами.
Семейство моделей GPT-2 — яркий пример текстогенеративных трансформеров. Transformer Explainer работает на базе модели GPT-2 (small) с 124 миллионами параметров. Хотя это не самая свежая и мощная модель трансформера, она содержит большинство тех же архитектурных компонентов и принципов, которые встречаются в современных моделях, что делает её идеальной отправной точкой для понимания основ.
Архитектура трансформера
Каждый текстогенеративный трансформер состоит из трёх ключевых компонентов:
- Embedding (представление): текстовый вход разбивается на меньшие единицы, называемые токенами (слова или подслова). Эти токены преобразуются в числовые векторы, называемые embeddings, которые захватывают семантическое значение слов.
- Transformer Block (блок трансформера) — фундаментальный строительный блок модели, обрабатывающий и трансформирующий входные данные. Каждый блок включает:
- Attention Mechanism (механизм внимания) — центральный компонент блока трансформера. Позволяет токенам обмениваться информацией, захватывая контекстную информацию и отношения между словами.
- MLP (Multilayer Perceptron, многослойный перцептрон) — полносвязная сеть, работающая с каждым токеном независимо. Если задача attention-слоя — маршрутизировать информацию между токенами, то задача MLP — уточнить представление каждого токена.
- Output Probabilities (выходные вероятности): финальные линейный слой и softmax преобразуют обработанные представления в вероятности, позволяя модели делать предсказания о следующем токене в последовательности.
Embedding
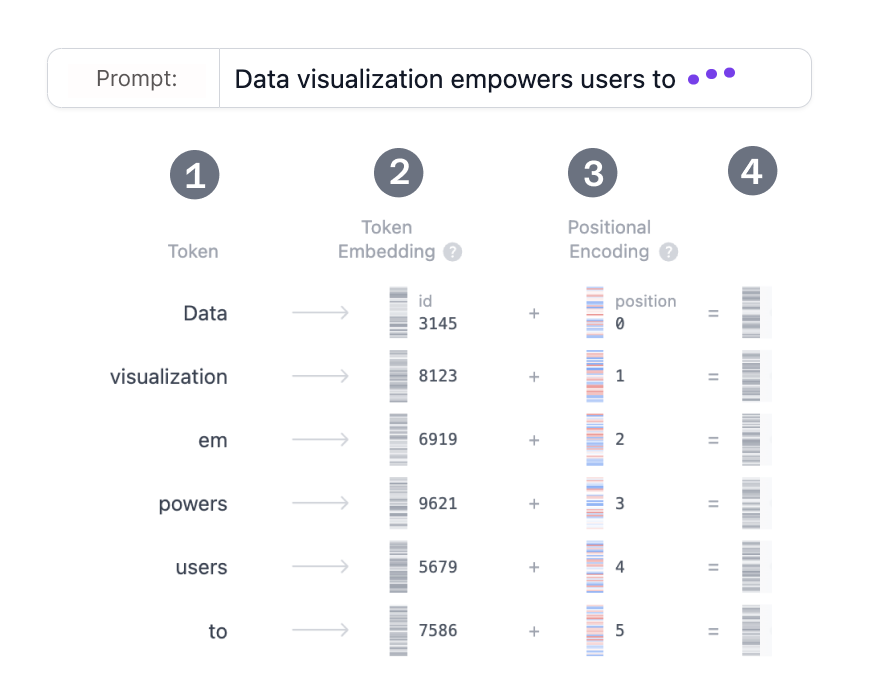
Представим, что нужно генерировать текст с помощью модели трансформера. Вводим prompt вроде этого: "Data visualization empowers users to". Этот вход нужно преобразовать в формат, который модель может понять и обработать. Здесь на помощь приходит embedding: он трансформирует текст в числовое представление, с которым может работать модель. Чтобы преобразовать prompt в embedding, нужно: 1) токенизировать вход, 2) получить token embeddings, 3) добавить позиционную информацию, и наконец 4) сложить token и position encodings для получения финального embedding. Посмотрим, как выполняется каждый из этих шагов.
Шаг 1: Tokenization
Токенизация — это процесс разбиения входного текста на меньшие, более управляемые части, называемые токенами. Эти токены могут быть словом или подсловом. Слова "Data" и "visualization" соответствуют уникальным токенам, тогда как слово "empowers" разбивается на два токена. Полный словарь токенов определяется перед обучением модели: словарь GPT-2 содержит 50,257 уникальных токенов. Теперь, когда мы разбили входной текст на токены с уникальными ID, мы можем получить их векторное представление из embeddings.
Шаг 2. Token Embedding
GPT-2 (small) представляет каждый токен в словаре как 768-мерный вектор; размерность вектора зависит от модели. Эти embedding-векторы хранятся в матрице размера (50,257, 768), содержащей примерно 39 миллионов параметров! Эта обширная матрица позволяет модели присвоить семантическое значение каждому токену в том смысле, что токены с похожим использованием или значением в языке размещаются близко друг к другу в этом высокомерном пространстве, тогда как непохожие токены находятся дальше.
Шаг 3. Positional Encoding
Слой Embedding также кодирует информацию о положении каждого токена в input prompt. Разные модели используют различные методы для позиционного кодирования. GPT-2 обучает свою собственную матрицу позиционного кодирования с нуля, интегрируя её прямо в процесс обучения.
Шаг 4. Final Embedding
Наконец, мы суммируем token и positional encodings для получения финального embedding-представления. Это комбинированное представление захватывает как семантическое значение токенов, так и их положение во входной последовательности.
Transformer Block
Ядро обработки трансформера находится в блоке трансформера, который состоит из multi-head self-attention и слоя Multi-Layer Perceptron. Большинство моделей состоят из нескольких таких блоков, которые складываются последовательно один за другим. Представления токенов эволюционируют через слои, от первого блока к последнему, позволяя модели выстроить тонкое понимание каждого токена. Такой многоуровневый подход приводит к представлениям входа более высокого порядка. Модель GPT-2 (small), которую мы рассматриваем, состоит из 12 таких блоков.
Multi-Head Self-Attention
Механизм self-attention позволяет модели захватить отношения между токенами в последовательности, так что представление каждого токена зависит от остальных. Несколько attention-голов позволяют модели рассматривать эти отношения с разных точек зрения; например, один голос может захватить короткодистанционные синтаксические связи, тогда как другой отслеживает более широкий семантический контекст. В следующем разделе мы пройдёмся по тому, как вычисляется multi-head self-attention шаг за шагом.
Шаг 1: Query, Key и Value матрицы
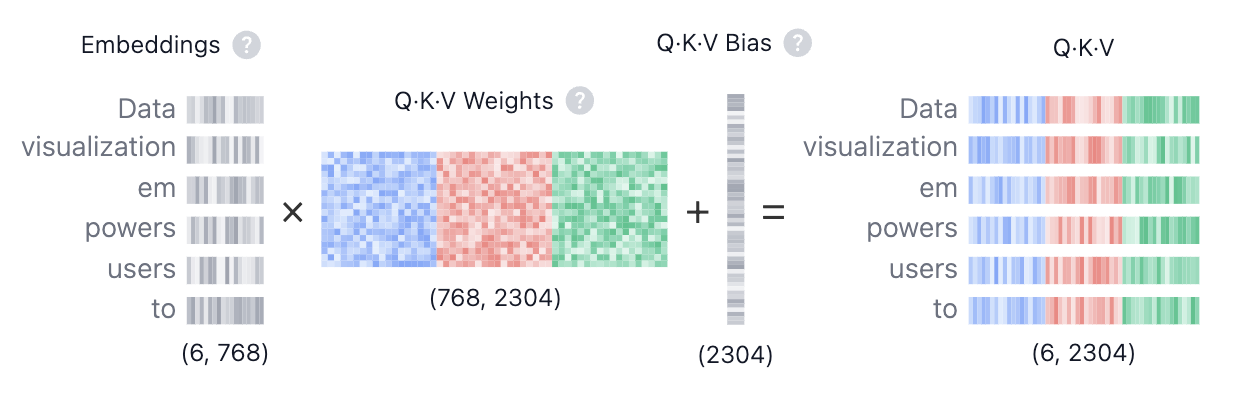
Каждый token embedding преобразуется в три вектора: Query (Q), Key (K) и Value (V). Эти векторы получаются путём умножения матрицы input embedding на обученные весовые матрицы для Q, K и V. Вот аналогия с веб-поиском, которая поможет развить интуицию за этими матрицами:
- Query (Q) — это поисковый текст, который вы вводите в поисковую машину. Это токен, о котором вы хотите «найти больше информации».
- Key (K) — это заголовок каждой веб-страницы в окне результатов поиска. Он представляет возможные токены, на которые может обратить внимание query.
- Value (V) — это фактическое содержание показанных веб-страниц. Когда мы сопоставили подходящий поисковый термин (Query) с релевантными результатами (Key), мы хотим получить содержание (Value) наиболее релевантных страниц.
Используя эти QKV значения, модель может вычислить attention scores, которые определяют, сколько фокуса должен получить каждый токен при генерации предсказаний.
Шаг 2: Multi-Head Splitting
Векторы Query, Key и Value разбиваются на несколько голов — в случае GPT-2 (small) на 12 голов. Каждый голос обрабатывает сегмент embeddings независимо, захватывая различные синтаксические и семантические отношения. Такой дизайн облегчает параллельное обучение разнообразным лингвистическим особенностям, улучшая представительную мощь модели.
Шаг 3: Masked Self-Attention
В каждом голосе мы выполняем вычисления masked self-attention. Этот механизм позволяет модели генерировать последовательности, фокусируясь на релевантных частях входа при одновременном предотвращении доступа к будущим токенам.
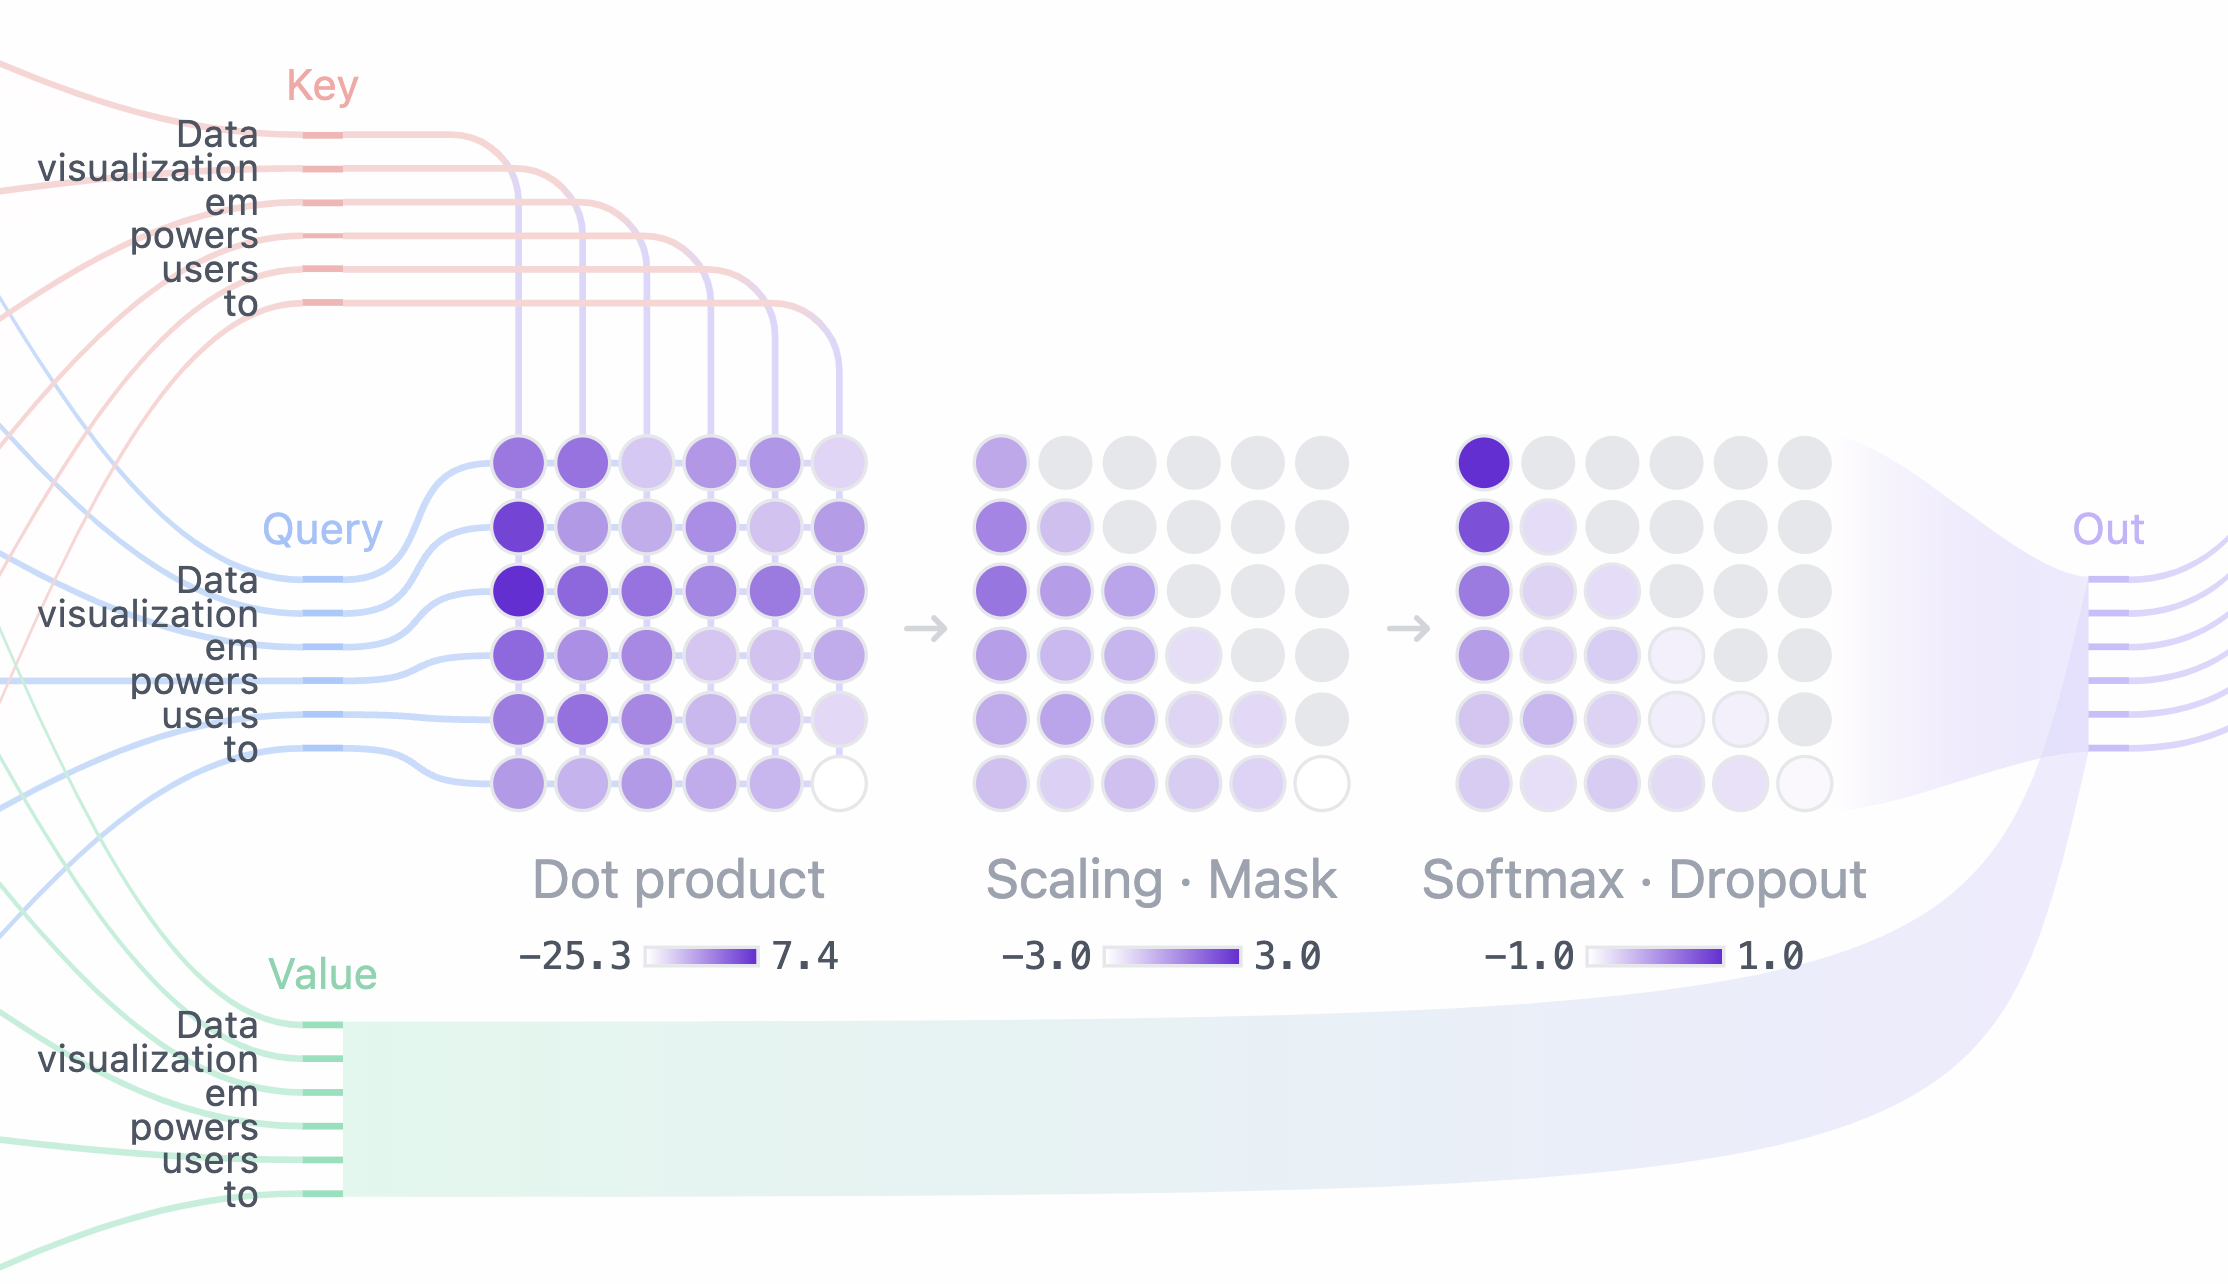
- Dot Product: скалярное произведение матриц Query и Key определяет attention score, производя квадратную матрицу, которая отражает отношение между всеми входными токенами.
- Scaling · Mask: attention scores масштабируются, и к верхнему треугольнику attention матрицы применяется маска для предотвращения доступа модели к будущим токенам, устанавливая эти значения в отрицательную бесконечность. Модель должна научиться предсказывать следующий токен без «подсматривания» в будущее.
- Softmax · Dropout: после маскирования и масштабирования attention scores преобразуются в вероятности операцией softmax, а затем опционально регуляризуются с помощью dropout. Каждая строка матрицы суммируется в единицу и показывает релевантность каждого другого токена слева от неё.
Шаг 4: Output и Concatenation
Модель использует masked self-attention scores и умножает их на матрицу Value для получения финального output механизма self-attention. GPT-2 имеет 12 голов self-attention, каждый захватывает различные отношения между токенами. Outputs этих голов конкатенируются и передаются через линейную проекцию.
MLP: Multi-Layer Perceptron
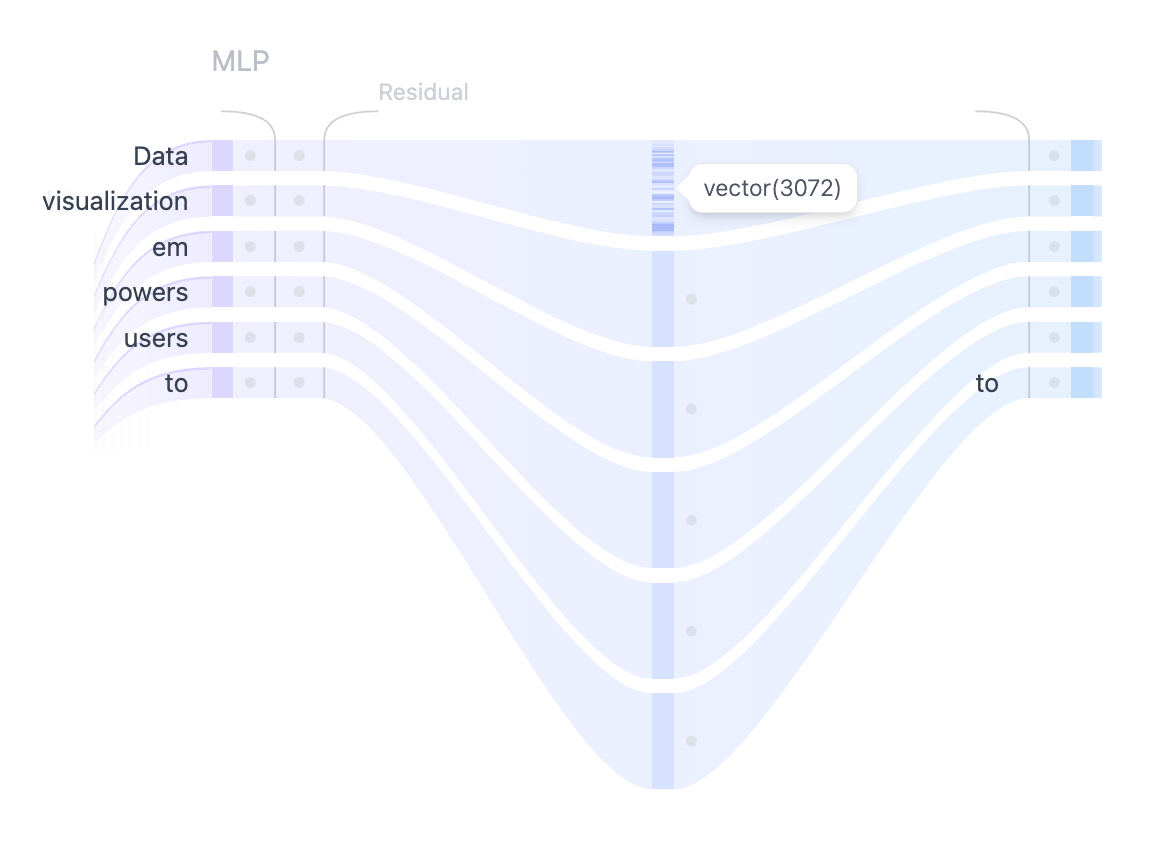
После того как несколько голов self-attention захватили разнообразные отношения между входными токенами, конкатенированные outputs проходят через слой Multilayer Perceptron (MLP) для улучшения представительной ёмкости модели. Блок MLP состоит из двух линейных трансформаций с функцией активации GELU между ними.
Первая линейная трансформация расширяет размерность входа в четыре раза с 768 до 3072. Этот шаг расширения позволяет модели проецировать представления токенов в пространство более высокой размерности, где она может захватить более богатые и сложные паттерны, которые могут быть невидимы в исходной размерности.
Вторая линейная трансформация затем уменьшает размерность обратно до исходного размера 768. Этот шаг сжатия возвращает представления к управляемому размеру, сохраняя при этом полезные нелинейные трансформации, введённые на этапе расширения.
В отличие от механизма self-attention, который интегрирует информацию между токенами, MLP обрабатывает токены независимо и просто отображает каждое представление токена из одного пространства в другое, обогащая общую ёмкость модели.
Output Probabilities
После того как вход был обработан через все блоки трансформера, output передаётся через финальный линейный слой для подготовки к предсказанию токена. Этот слой проецирует финальные представления в пространство размерности 50,257, где каждый токен в словаре имеет соответствующее значение, называемое logit. Любой токен может быть следующим словом, так что этот процесс позволяет нам просто ранжировать эти токены по вероятности того, что они будут тем следующим словом. Затем мы применяем функцию softmax для преобразования logits в распределение вероятностей, которое суммируется в единицу. Это позволит нам выбрать следующий токен на основе его вероятности.
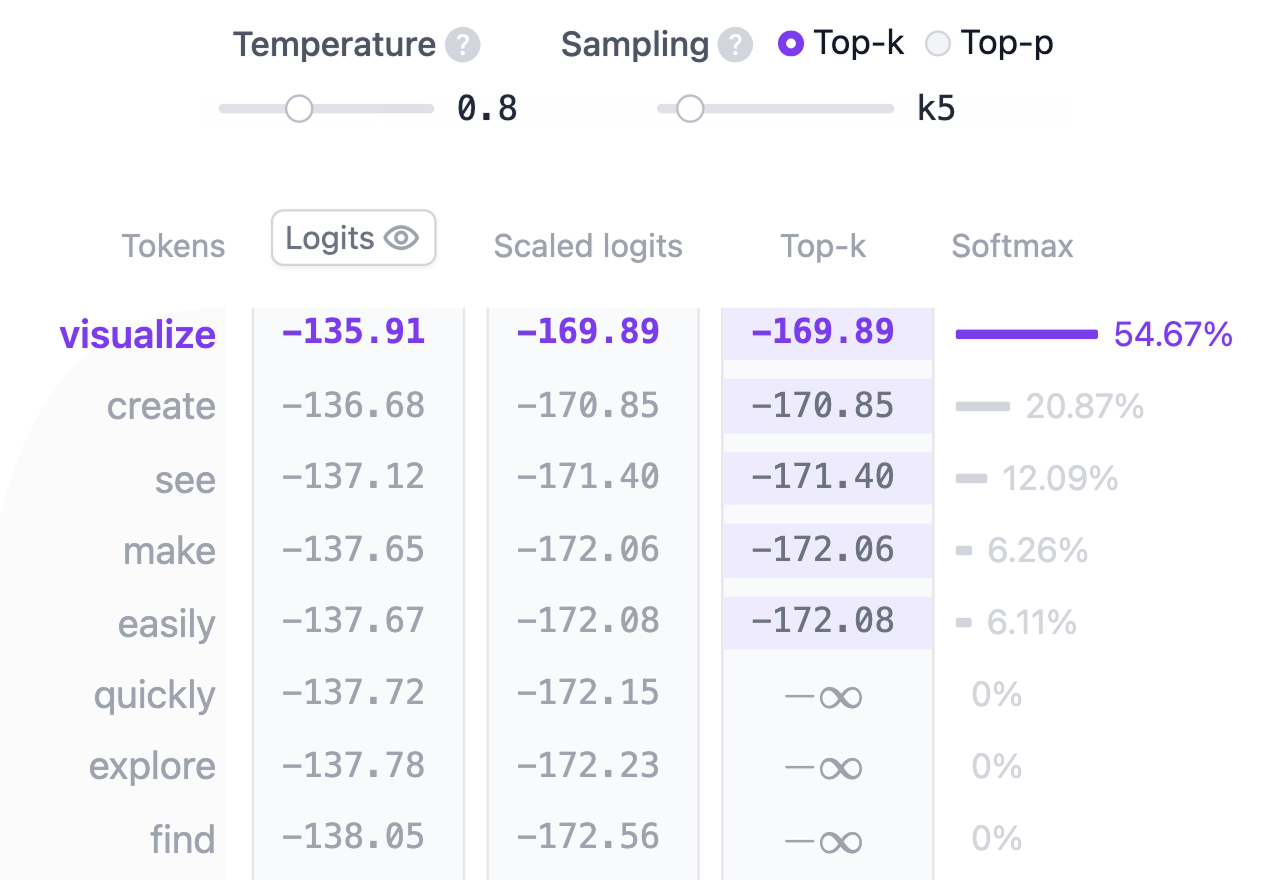
Финальный шаг — генерирование следующего токена путём выборки из этого распределения. Гиперпараметр temperature играет критическую роль в этом процессе. Математически это очень простая операция: output logits модели просто делятся на temperature:
temperature = 1: деление logits на один не влияет на outputs softmax.temperature < 1: более низкая temperature делает модель более уверенной и детерминированной за счёт заострения распределения вероятностей, приводя к более предсказуемым outputs.temperature > 1: более высокая temperature создаёт более мягкое распределение вероятностей, позволяя большей случайности в генерируемом тексте — то, что некоторые называют «креативностью» модели.
Кроме того, процесс выборки может быть дополнительно уточнен с помощью параметров top-k и top-p:
top-k sampling: ограничивает кандидатов токен топ-k токенами с наивысшими вероятностями, отфильтровывая менее вероятные варианты.top-p sampling: рассматривает наименьший набор токенов, чья совокупная вероятность превышает порог p, гарантируя, что только наиболее вероятные токены участвуют, но при этом позволяя разнообразие.
Настраивая temperature, top-k и top-p, вы можете балансировать между детерминированными и разнообразными outputs, адаптируя поведение модели к вашим конкретным потребностям.
Вспомогательные архитектурные особенности
Существует несколько вспомогательных архитектурных особенностей, которые улучшают производительность моделей трансформера. Хотя они важны для общей производительности модели, они не столь важны для понимания основных концепций архитектуры. Layer Normalization, Dropout и Residual Connections — критические компоненты моделей трансформера, особенно на этапе обучения. Layer Normalization стабилизирует обучение и помогает модели сходиться быстрее. Dropout предотвращает переобучение путём случайной деактивации нейронов. Residual Connections позволяют градиентам течь прямо через сеть и помогают предотвратить проблему исчезающих градиентов.
Layer Normalization
Layer Normalization помогает стабилизировать процесс обучения и улучшить сходимость. Работает путём нормализации входов по особенностям, гарантируя, что среднее и дисперсия активаций консистентны. Эта нормализация помогает смягчить проблемы, связанные с внутренним сдвигом ковариат, позволяя модели учиться более эффективно и снижая чувствительность к начальным весам. Layer Normalization применяется дважды в каждом блоке трансформера, один раз перед механизмом self-attention и один раз перед слоем MLP.
Dropout
Dropout — это техника регуляризации, используемая для предотвращения переобучения в нейронных сетях путём случайного обнуления доли весов модели во время обучения. Это побуждает модель учиться более робастным особенностям и снижает зависимость от специфических нейронов, помогая сети лучше обобщаться на новые, невидимые данные. Во время вывода модели dropout деактивируется. Это по сути означает, что мы используем ансамбль обученных подсетей, что приводит к лучшей производительности модели.
Residual Connections
Residual connections были впервые представлены в модели ResNet в 2015 году. Это архитектурное новшество революционизировало глубокое обучение, позволив обучать очень глубокие нейронные сети. По сути, residual connections — это ярлыки, которые обходят один или более слоёв, добавляя вход слоя к его выходу. Это помогает смягчить проблему исчезающих градиентов, облегчая обучение глубоких сетей с несколькими стопками блоков трансформера. В GPT-2 residual connections используются дважды в каждом блоке трансформера: один раз перед MLP и один раз после, гарантируя, что градиенты текут легче, и ранние слои получают достаточно обновлений во время обратного распространения.
Интерактивные возможности
Transformer Explainer построен так, чтобы быть интерактивным и позволяет исследовать внутреннее устройство трансформера. Вот некоторые интерактивные возможности, с которыми вы можете экспериментировать:
- Введите собственную текстовую последовательность для просмотра того, как модель её обрабатывает и предсказывает следующее слово. Исследуйте weights attention, промежуточные вычисления и посмотрите, как вычисляются финальные output probabilities.
- Используйте ползунок temperature для управления случайностью предсказаний модели. Исследуйте, как вы можете сделать output модели более детерминированным или более креативным, изменяя значение temperature.
- Выбирайте методы top-k и top-p sampling для настройки поведения выборки при выводе. Экспериментируйте с различными значениями и смотрите, как распределение вероятностей меняется и влияет на предсказания модели.
- Взаимодействуйте с attention картами для просмотра того, как модель фокусируется на различные токены во входной последовательности. Наведите курсор на токены, чтобы выделить их attention weights и исследуйте, как модель захватывает контекст и отношения между словами.
Видеоуроки
Как реализован Transformer Explainer?
Transformer Explainer содержит живую модель GPT-2 (small), работающую прямо в браузере. Эта модель происходит из реализации GPT на PyTorch проекта nanoGPT Андрея Карпатого и была конвертирована в ONNX Runtime для плавного выполнения в браузере. Интерфейс построен на JavaScript с использованием Svelte как фреймворка front-end и D3.js для создания динамических визуализаций. Числовые значения обновляются в реальном времени после ввода пользователя.
Кто разработал Transformer Explainer?
Transformer Explainer был создан Aeree Cho, Grace C. Kim, Alexander Karpekov, Alec Helbling, Jay Wang, Seongmin Lee, Benjamin Hoover и Polo Chau в Georgia Institute of Technology.