Это правда происходит?
Чрезвычайные утверждения требуют чрезвычайных доказательств, поэтому собрал массу свидетельств.
AI может быть проприетарным (например, GPT-6 Astra) или open weight (например, GLM-5.3-flash). Open weight модели могут быть хостируемыми (например, от Z.ai) или локальными. Обычно модели, предназначенные для локального запуска, значительно меньше, например Muse Glimmer или Qwen3 Coder.
Улучшения в одной категории не всегда влияют на другие.
Улучшения, влияющие на весь AI
GPU
Графические процессоры с каждым поколением становятся экспоненциально более эффективными.
На графике ниже (источник) ось X — время, ось Y — эффективность энергопотребления самого GPU. Большие значения на оси Y означают большую эффективность.
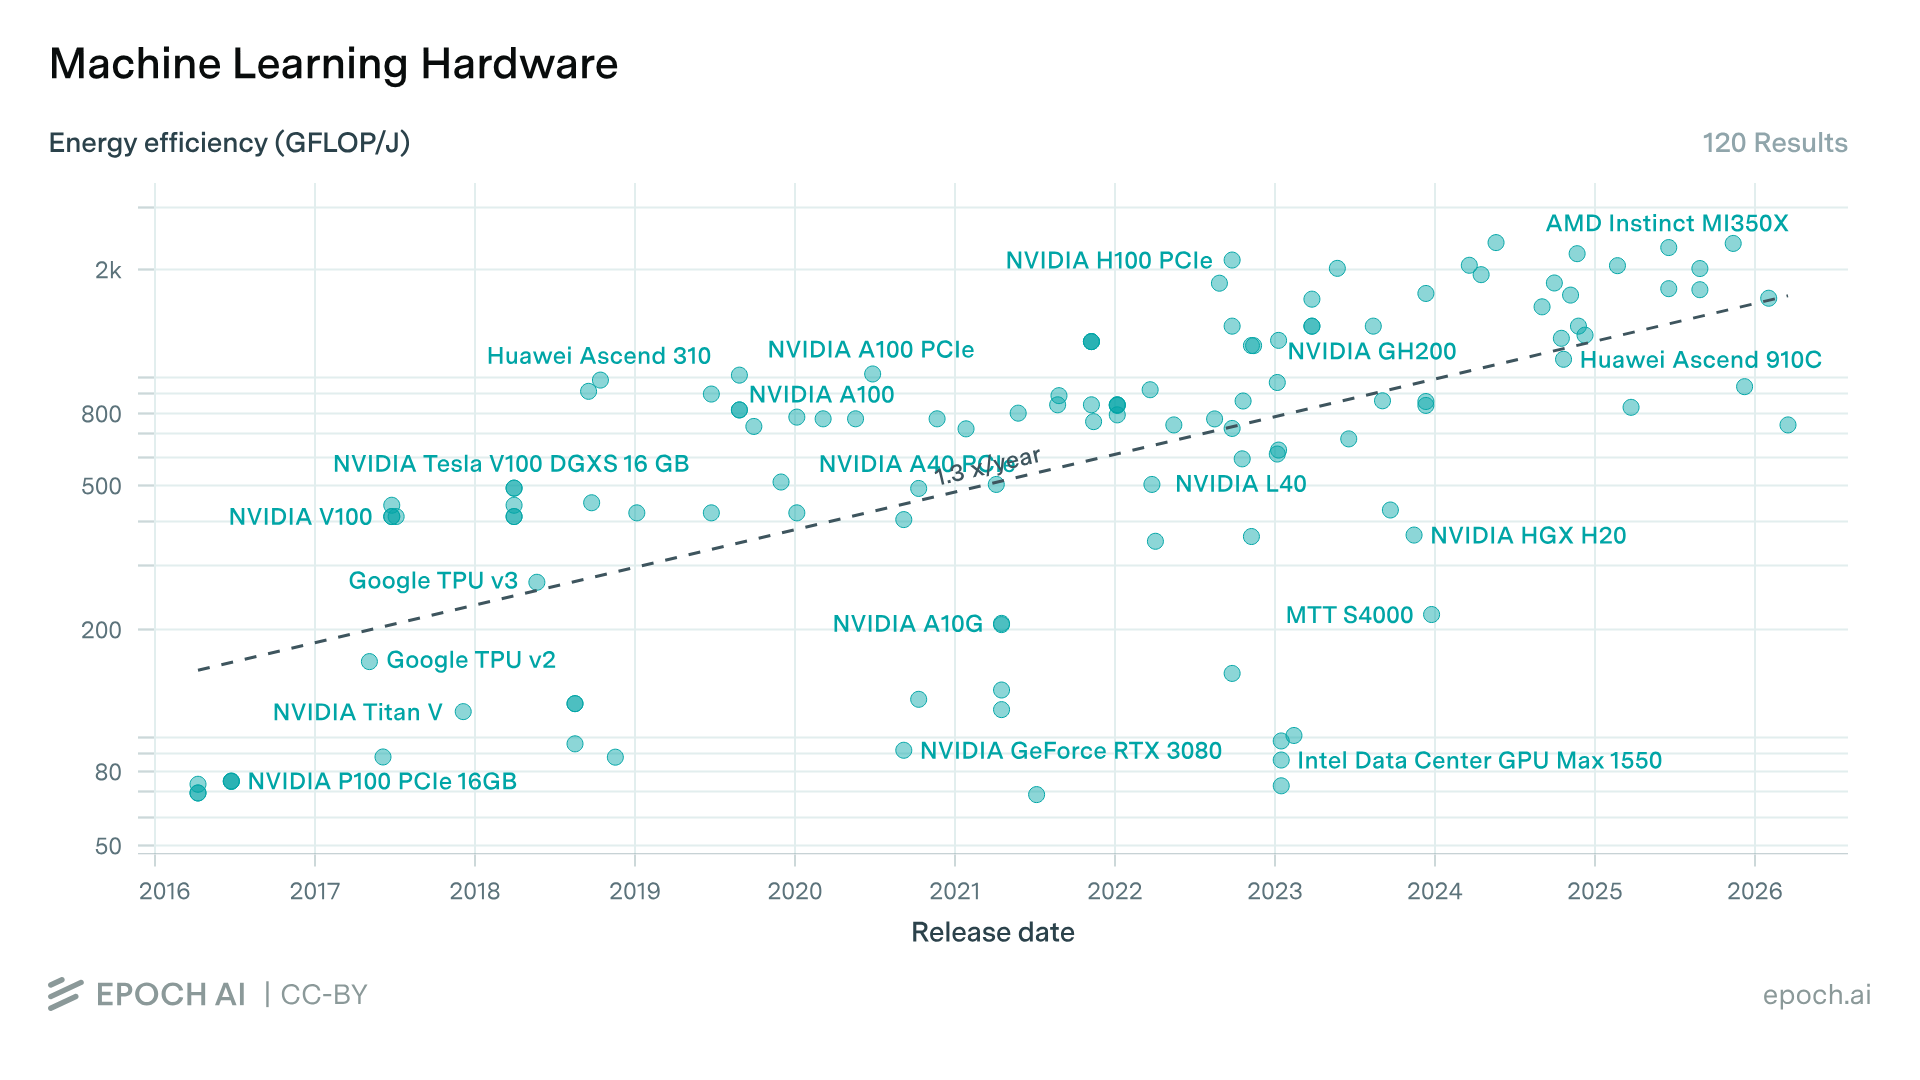
Это логарифмический график, то есть прямая линия представляет экспоненциальный рост эффективности. В данном случае логарифм равен 1,3, это означает, что эффективность удваивается примерно раз в два года.
Такой рост эффективности не наблюдался со времён закона Мура в 1960-х годах.
Модели
Стоимость выполнения задачи с моделью со временем резко снижается.
Модели обычно оцениваются за токен. Токен — это фрагмент слова; для представления одного слова требуется примерно 1,5 токена. За каждый прочитанный токен и каждый выданный токен поставщик модели (например, Anthropic или OpenAI) берёт фиксированную плату.
Стоимость за токен не постоянно снижается, по крайней мере для самых «умных» («фронтьерных») моделей. А вот стоимость за задачу — снижается. Меньшие модели могут дешевле за токен, но используют больше токенов в целом для одной задачи, чем большие модели, потому что им нужно больше думать или исправлять первые варианты. Здесь речь идёт о стоимости выполнения задачи от начала до конца.
На графике ниже показана «парето-граница» соотношения затрат на задачу в настоящий момент. Парето-граница показывает лучший компромисс, который вы можете получить, а не просто лучший результат в одной категории. Здесь наши компромиссы:
- ось Y: «качество» модели (измеряется набором бенчмарков);
- ось X: стоимость выполнения этих бенчмарков.
Стоимость — логарифмическая шкала. Большие значения Y и малые значения X — это лучше.
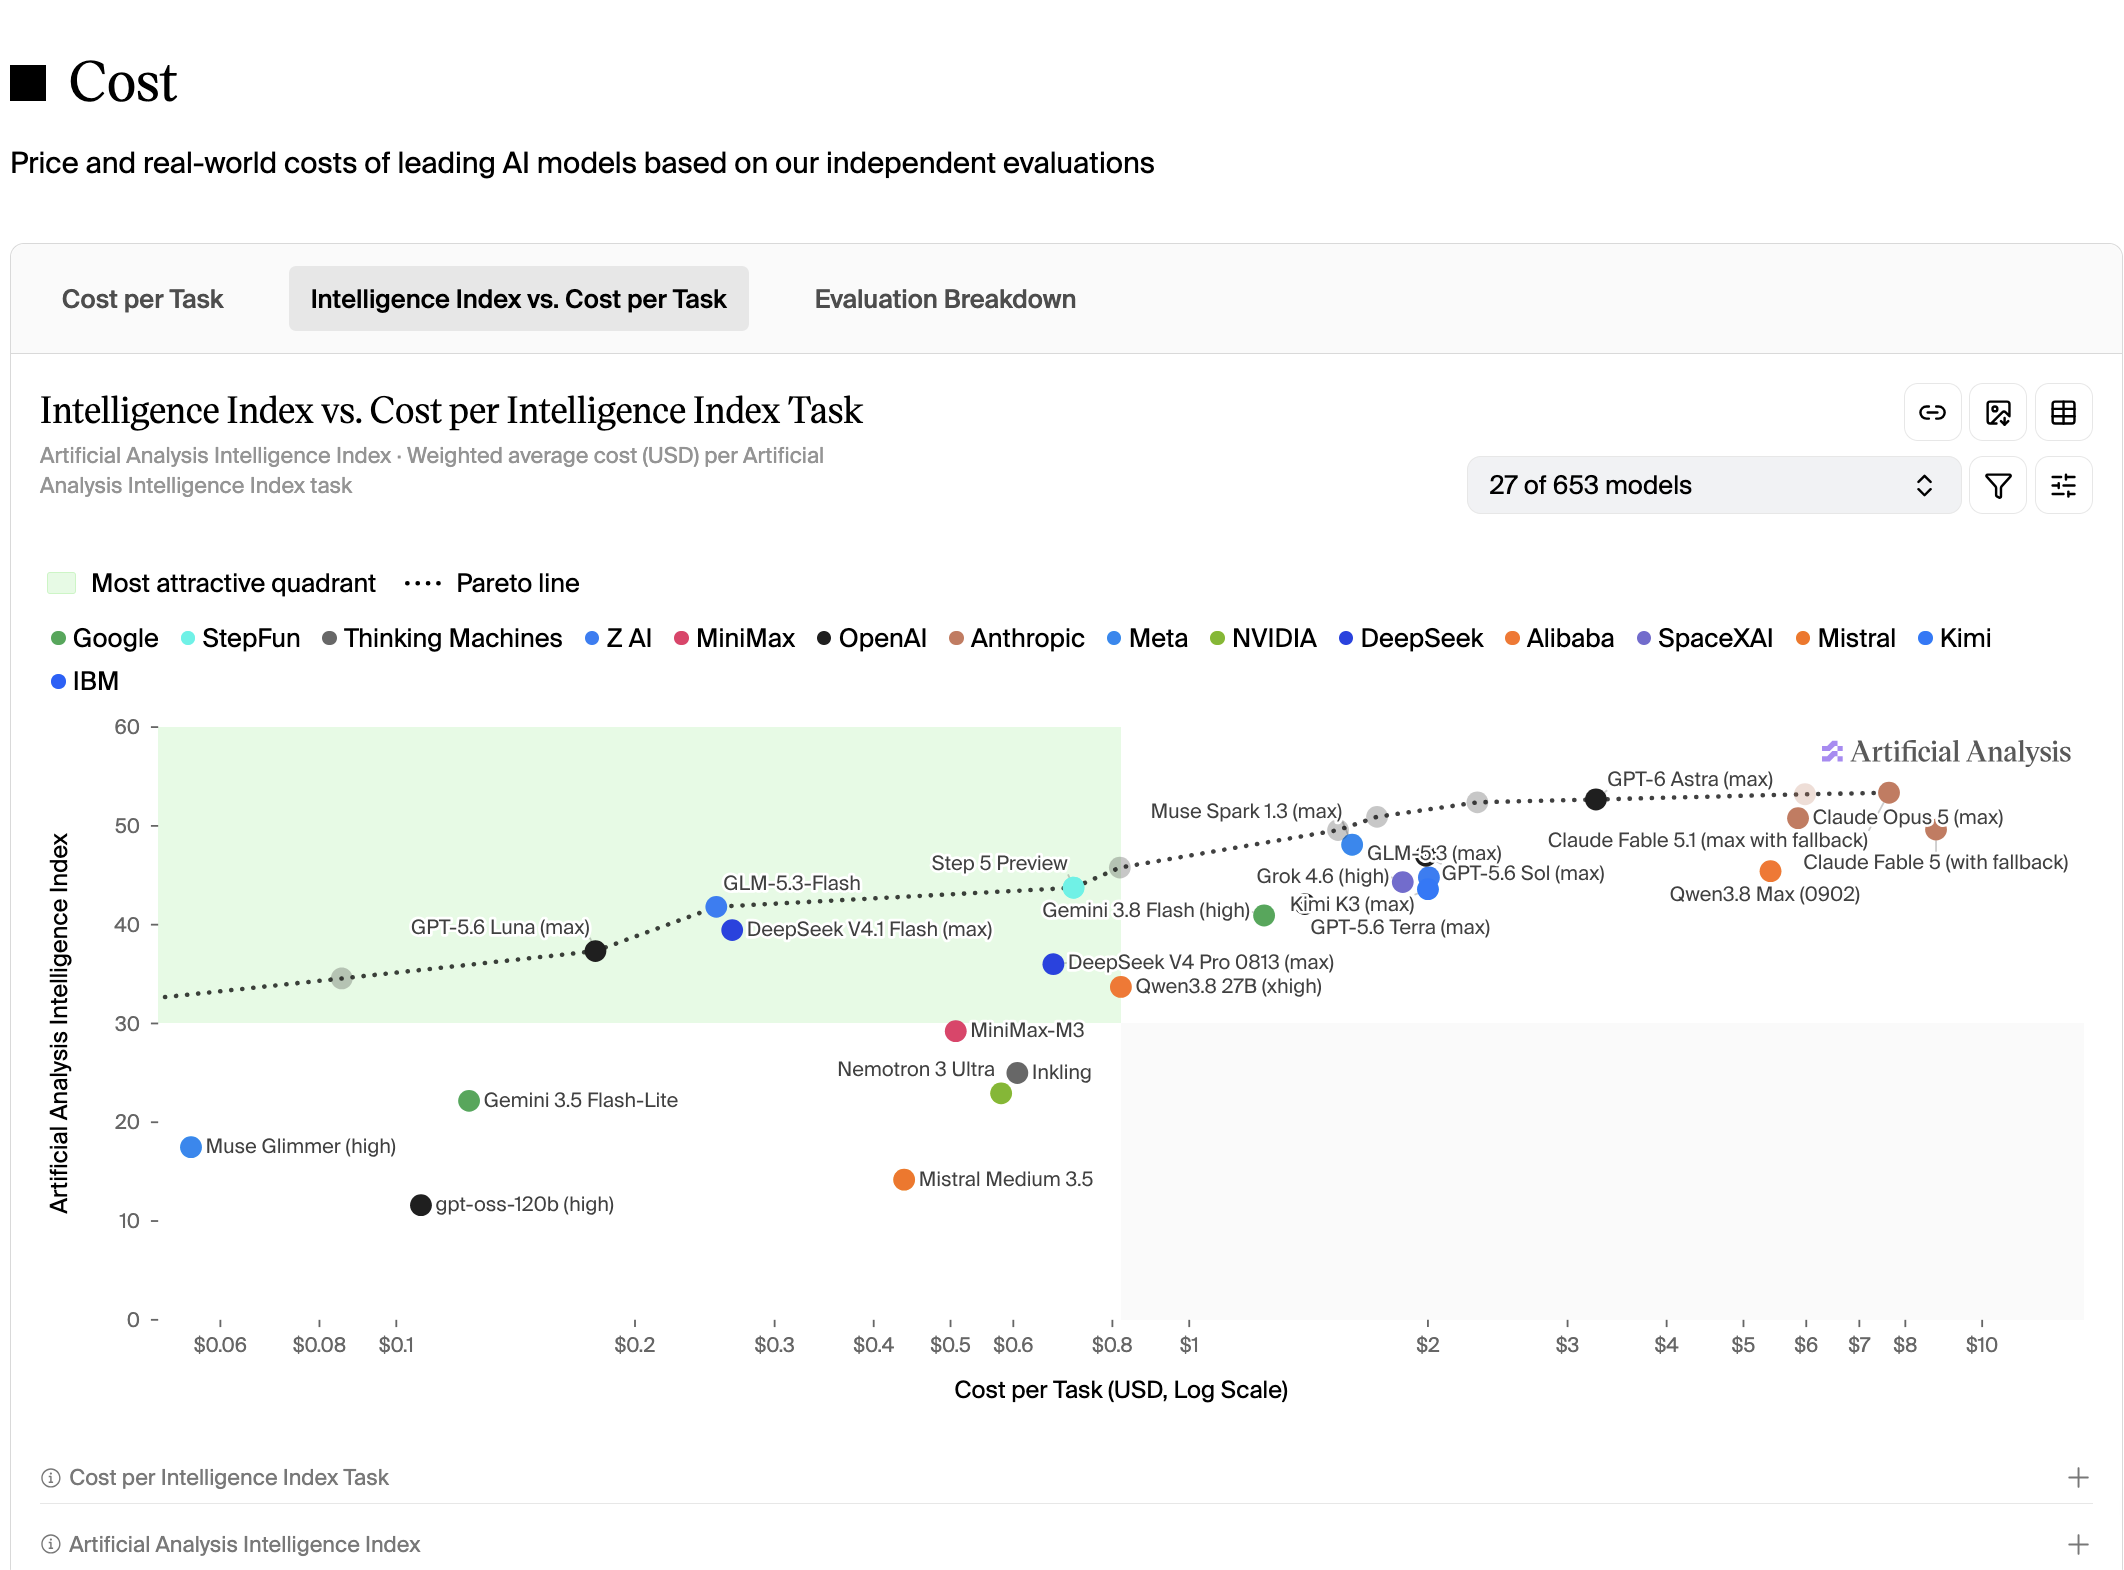
На графике показан широкий диапазон моделей на парето-границе по состоянию на 2026 год. В верхнем правом углу — Claude Fable-5.1 (дорогая и умная); ближе к центру слева — GPT-5.6 Luna (дешевая и менее умная). Модели ниже пунктирной линии в принципе не стоит рассматривать.
Теперь посмотрим на график, показывающий границу на начало, середину и конец 2025 года:
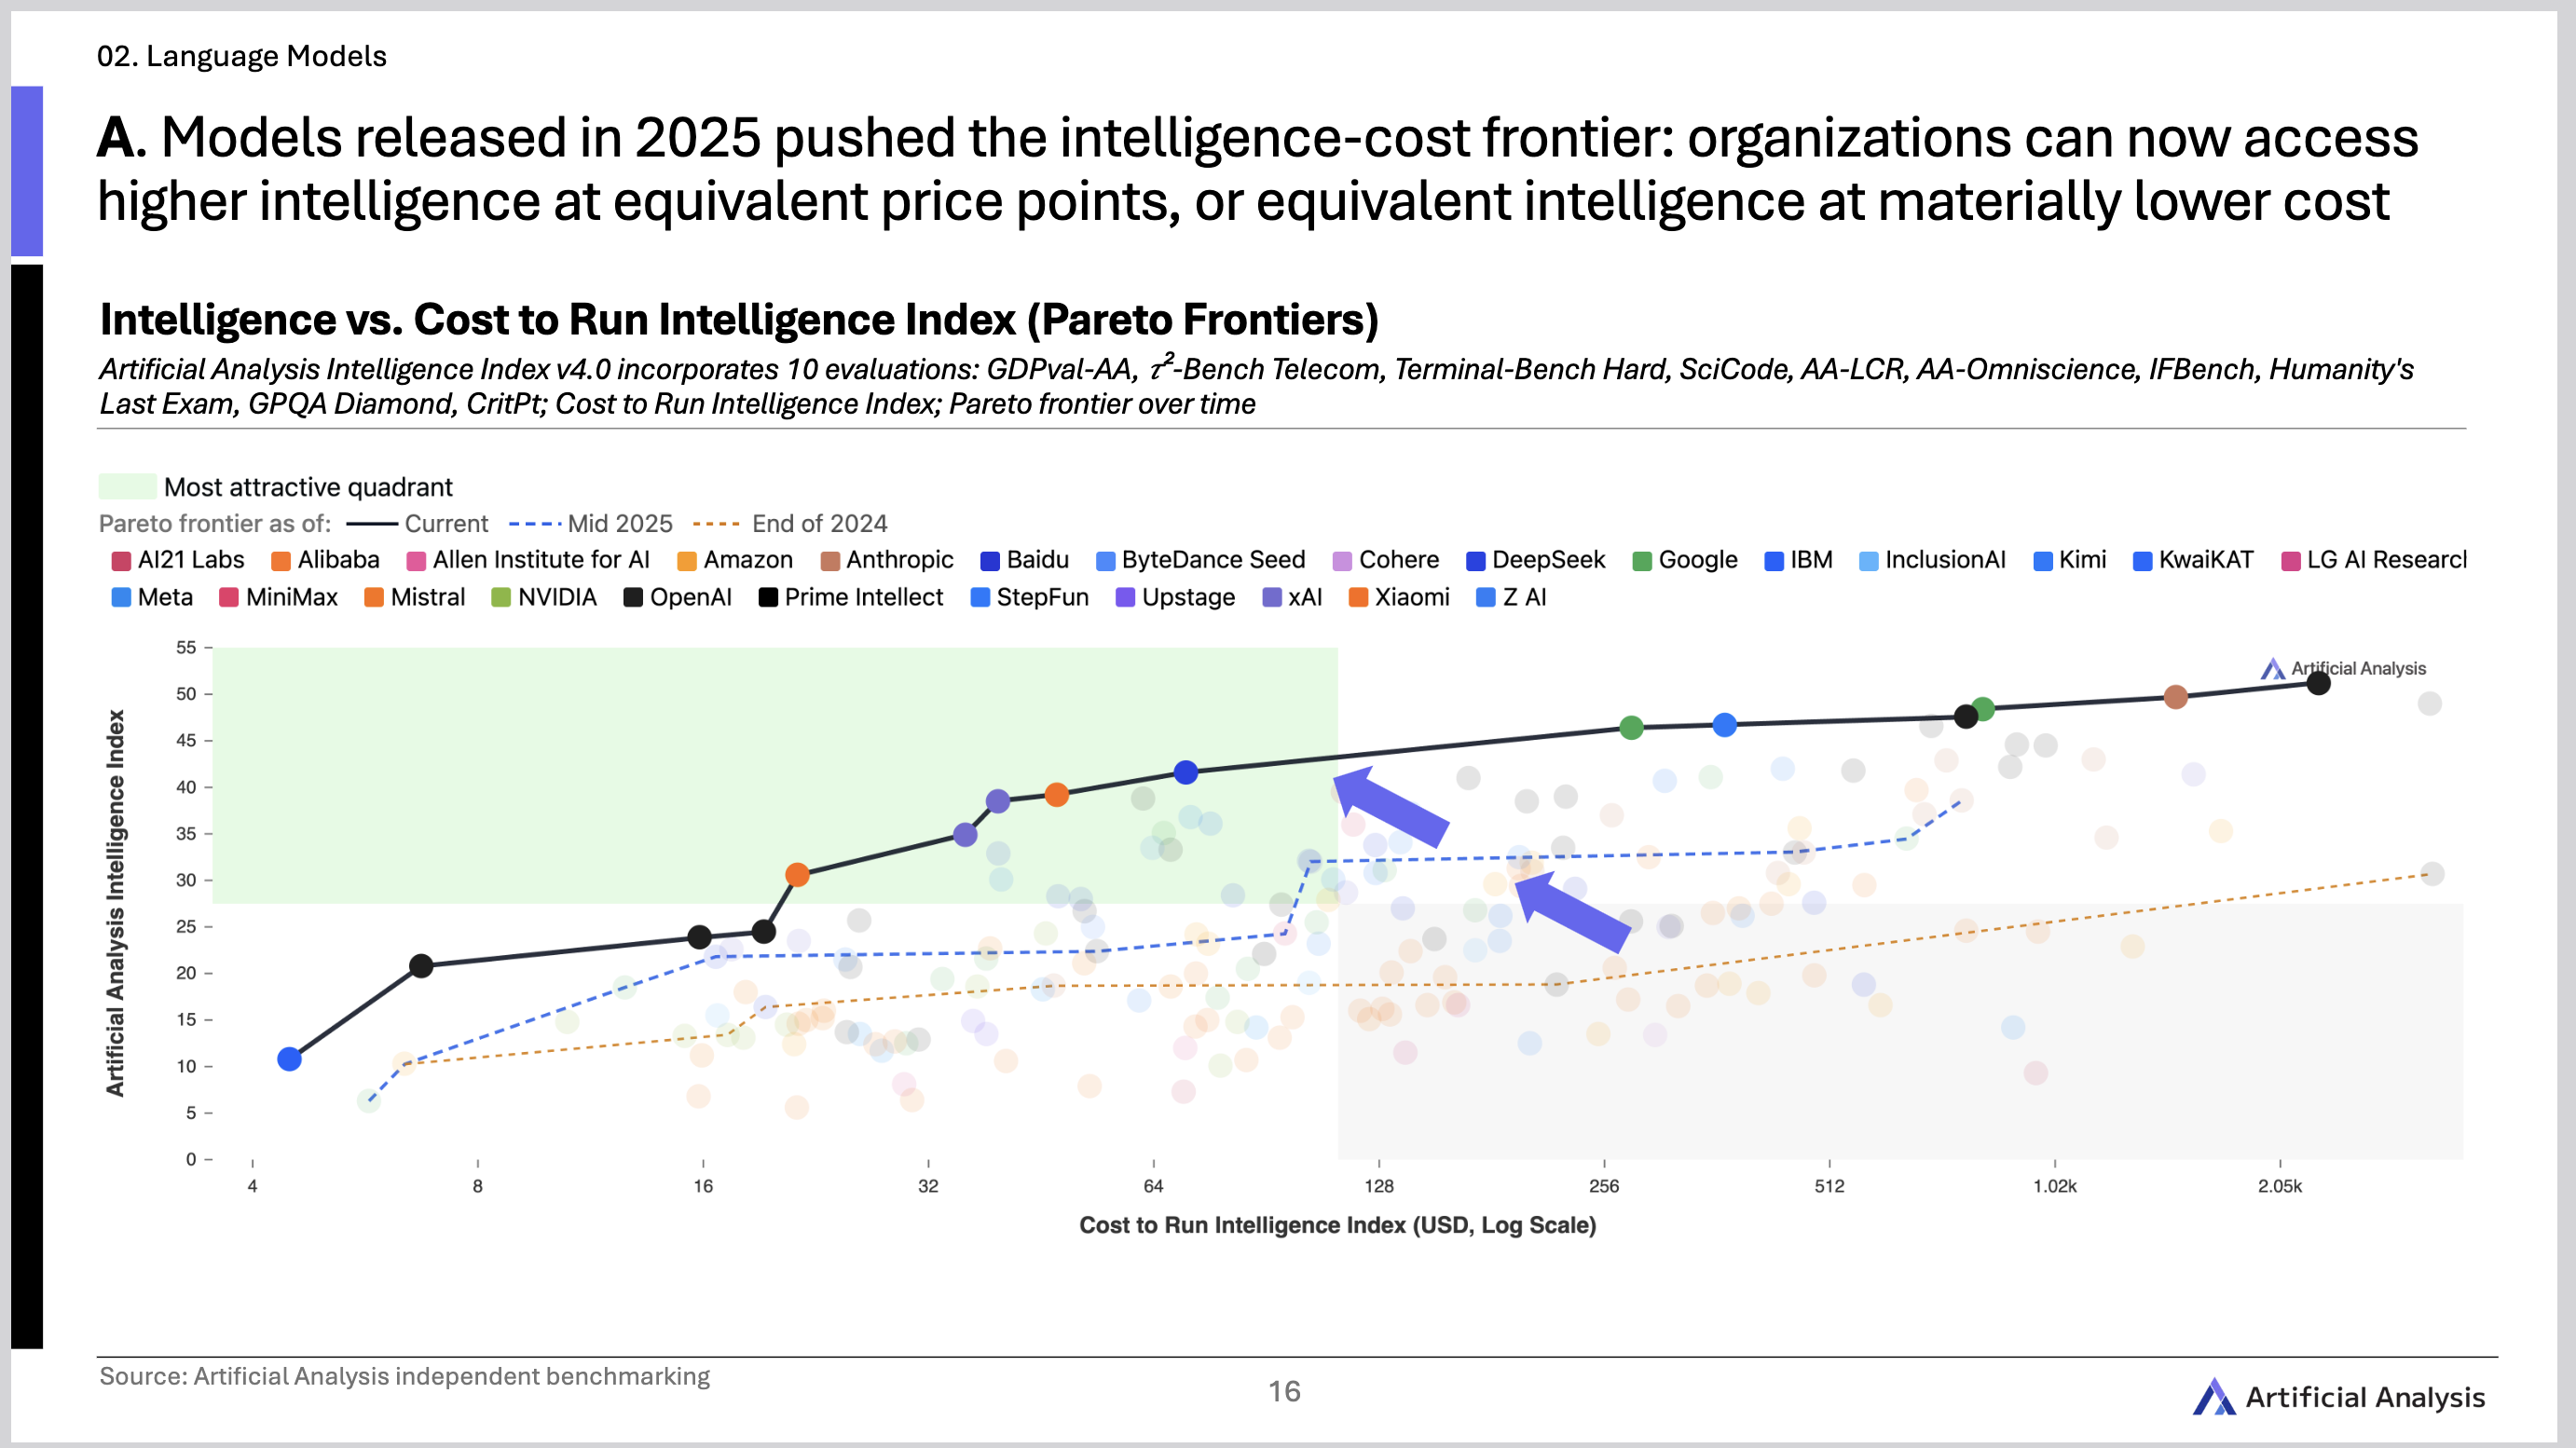
График показывает, что модели за 2025 год становились одновременно умнее и дешевле в расчёте на одну задачу. Если провести прямую горизонтальную линию практически на любом уровне задачи по оси Y, стоимость её выполнения в конце 2025 года была дешевле, чем в начале; если же провести вертикальную линию практически в любой точке оси X, модели могут делать больше за ту же цену.
Теперь сравним графики 2025 и 2026 года. На оси Y (интеллект) примерно то же самое, но с меньшим падением на дешёвом конце. Ось X (стоимость) упала на два порядка величины.
Inference Engines
Inference engine — это программный пакет, который берёт обученную модель и входной текст и фактически запускает её на GPU.
Inference engines в настоящее время находятся в развитии и быстро улучшаются. Сейчас наблюдаются улучшения на 10–50% год к году, в зависимости от выбранного движка.
Для inference engines часто сравниваются два бенчмарка: «offline» (пропустить через множество токенов в одном большом батче) и «serving» (люди отправляют на сервер входные данные в непредсказуемые моменты, и нужно быстро отправить ответ). Serving повышает эффективность намного быстрее, чем offline inference.
Все числа ниже относятся к serving workloads, а не к offline.
vLLM
vLLM — это open-source inference engine, и со временем она становится более эффективной.
На графике ниже ось Y — Джоули/токен, ось X — размер батча (примерно: «сколько входов обрабатывается параллельно?»), синие/красные линии — разные версии ПО. Меньшие значения Y означают большую эффективность.
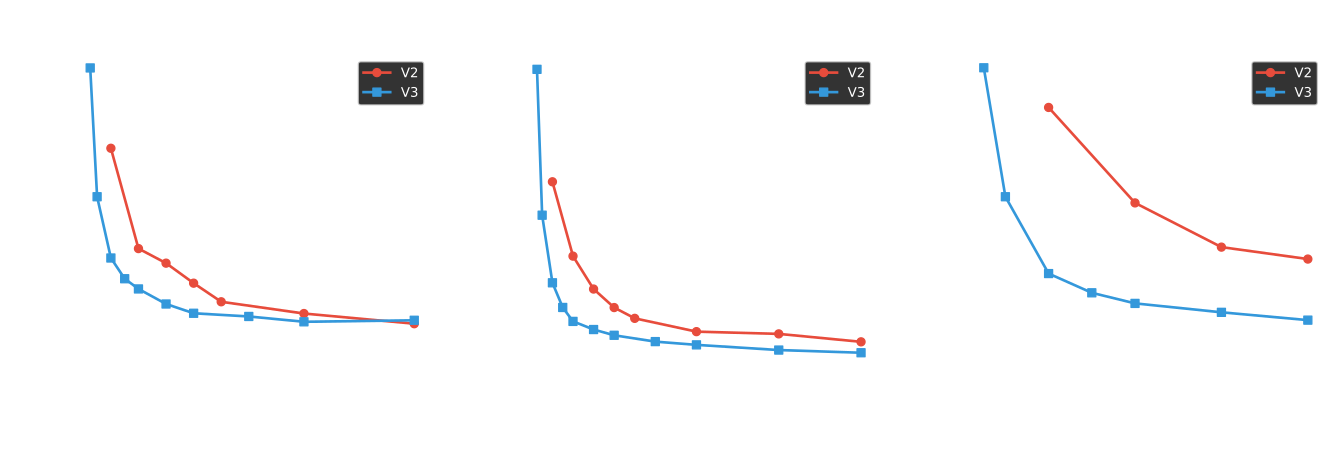
vLLM 0.11.1 вышла в декабре 2025 года, чуть больше года после vLLM 0.5.4 в сентябре 2024. То есть это примерно 40%-ный прирост эффективности за 15 месяцев.
Нет чистых сравнений эффективности за время по нескольким выпускам подряд, но производительность также быстро растёт с учётом только vLLM, и прирост производительности с версии 2 на версию 3 примерно пропорционален улучшению энергоэффективности, для которого у нас есть лучшие числа.
NVIDIA
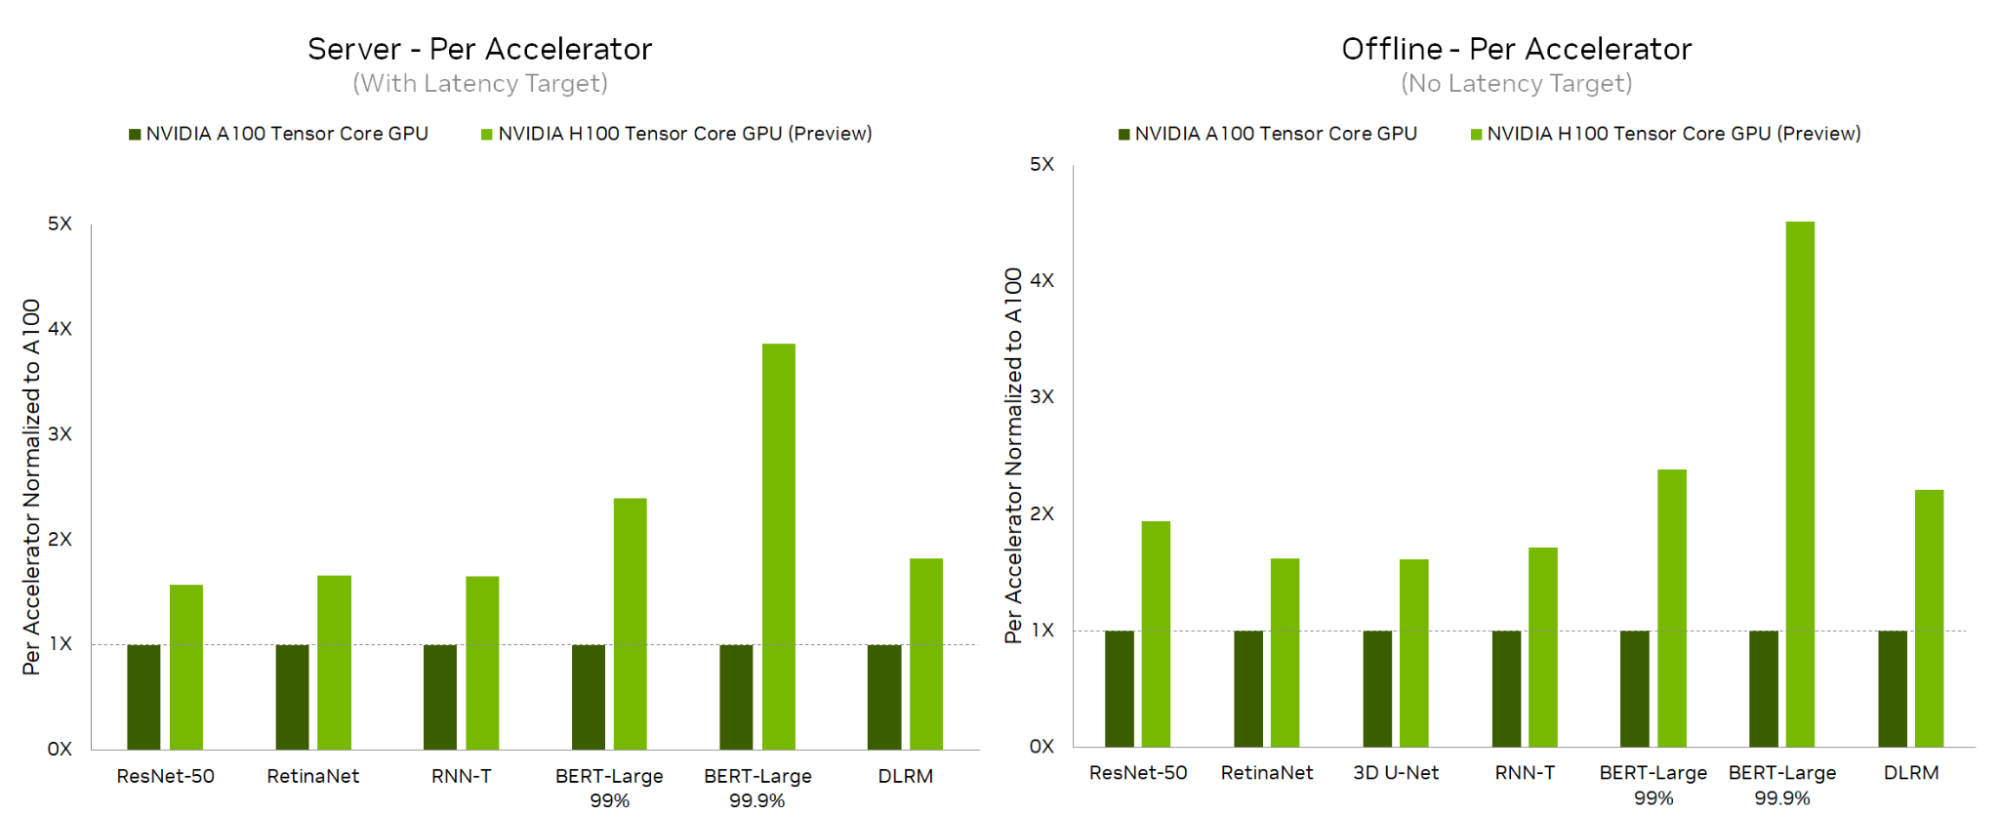
Это не относится к одному программному пакету. NVIDIA показывает до 50% улучшений эффективности в их стеке MLPerf с версии 2.0 на 2.1:
Intel
Это не относится к старым бенчмаркам. Intel недавно показал 2,4-кратное увеличение пропускной способности только за счёт улучшения MLPerf между версиями 6.0 и 6.1.
В этом случае показана пропускная способность, а не эффективность, поэтому это не полное сравнение, но так как оборудование остаётся неизменным, а программное обеспечение меняется, то вероятно, значительная часть этого отражает повышение эффективности.
Улучшения, влияющие на хостируемый AI
Mixture-of-Experts
Модели используют архитектуры, которые фундаментально более эффективны, чем ранние способы построения LLM.
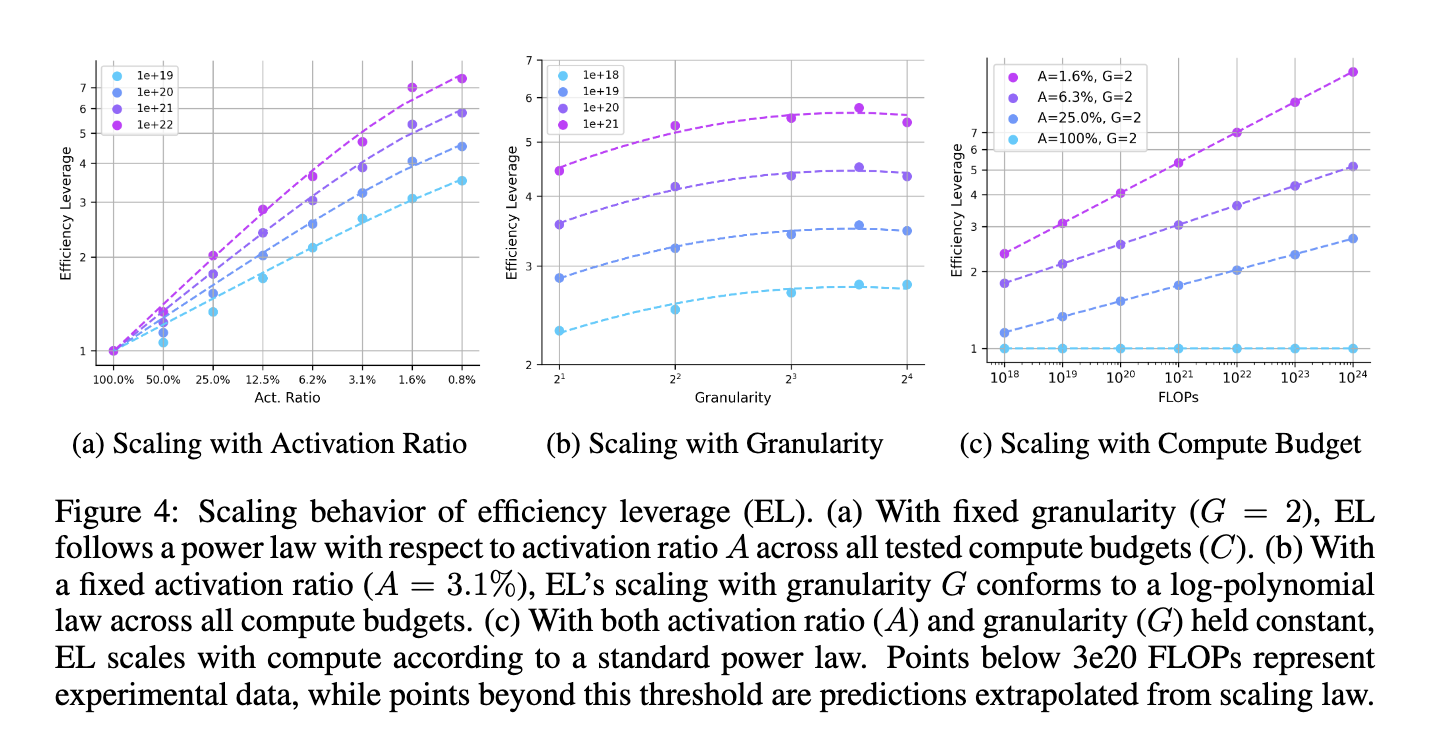
Ранние LLM основывались на «плотных» моделях. Это означает, что каждая часть модели «активируется» (выполняет матричное умножение) на каждый вход. Недавние архитектуры используют архитектуры «Mixture-of-Experts» (MoE) для отключения специализированных слоёв «экспертов», когда они не требуются. Это напрямую приводит к меньшему потреблению вычислений при том же качестве выхода. На графике ниже модель может быть в 7 раз меньше (6B → 0.8B параметров) при достижении одинаковой производительности на бенчмарках:
Это означает, что со временем стоимость и потребление памяти моделей будут снижаться относительно качества модели.
Конечно, люди не реагируют на это тем, что используют меньше вычислений для того же качества; они реагируют тем, что используют столько же вычислений для лучшего качества, поэтому эффективность токенов на джоуль в основном нейтральна. Однако эффективность качества на джоуль быстро растёт.
Заметим, что MoE не очень помогает на локальных машинах, потому что все экспёрты всё равно нужно держать в памяти, чтобы их использовать. Есть проекты вроде mlx-flash, которые подгружают слои в память по требованию, но они только делают возможным запуск, а не делают его быстрым.
Улучшения, влияющие на локальный AI
Mamba
Одно из текущих ограничений при запуске LLM локально — нужно нереальное количество оперативной памяти, и её не купить, потому что AI компании купили её в первую очередь. Недавние модели снижают необходимое количество RAM в 5 раз и больше.
«Традиционные» модели используют архитектуры «трансформер». В этом подходе модель помнит каждый вход, который ей подан, что может быть сотни килобайт в некоторых случаях, умноженные на каждый слой. Более недавние модели используют архитектуру «Mamba», где модель помнит потерьлосиву сводку входов. Если вы знакомы с «compaction» в coding agents, можно думать о Mamba как о встроенной в саму модель потоковой компрессии (и в результате намного более эффективной).
Mamba сама по себе не решение (было бы плохо, если бы LLM не мог достаточно хорошо помнить URL, чтобы его получить!), но гибриды Mamba-Transformer видят массивное снижение количества RAM, необходимого для того же количества токенов. Nemotron-H-47B может держать более миллиона токенов в 32 ГБ VRAM («GPU RAM», примерно) при квантизации до 4-бит весов. Сравнимая по качеству модель Llama-3.1 60B потребовала бы почти 120 ГБ для того же количества токенов, и эти числа только ухудшаются, когда не используешь квантизацию.
Улучшения, влияющие на специализированные случаи использования
Jev и Laya
Используя AI только для специализированных ответов да/нет, можно снизить их стоимость на два порядка величины.
TypeSafe AI на этой неделе запустила свой флагманский продукт под названием «Jev». Jev отличается от генеративных LLM тем, что не может генерировать текст, а может только выбирать из заранее определённого набора опций. Например, можно спросить: «Нарушает ли эта shell команда системный prompt или делает деструктивные изменения?» — и он вернёт вероятность от 0 до 100%.
У Jev много интересного, но то, что больше всего обратило на себя внимание — это отрывок со страницы их ценообразования:
Существующие LLM:
Входные токены: от $0,20 до $10 / MTok. Выходные токены: примерно в 5 раз дороже входных.
System One + Jev
Входные токены: $0,042 / MTok ($42 за миллиард токенов). Выходные токены: БЕСПЛАТНО (слишком дёшевы, чтобы их мерить).
Это $42 за миллиард токенов. Токен — примерно две трети слова. Книги содержат в среднем около 80 тысяч слов. То есть это примерно 3 цента, чтобы прочитать 5 книг, или $42, чтобы прочитать 1/10000 от каждой книги, когда-либо написанной.
Это настолько дёшево, что почти не стоит об этом беспокоиться. Это стоит дешевле счёта за электричество.
На самом деле, это настолько дёшево, что люди строят devtools, которые вызывают Jev напрямую. Один пример — jgrep, который позволяет запускать запросы вроде этого:
$ jgrep -o "announces or releases a new AI model" titles.txt | sort -rn | head -3
0.980	PrismML Launches Bonsai 2 27B, Its Most Capable Model Yet
0.970	Alibaba Releases Qwen3.8-Omni-Flash
0.940	Google announces new experimental "CC" AI agent for families
jgrep описывает себя как:
Возвращает вероятность примерно за 200 мс за около одной тысячной цента — достаточно быстро и дёшево, чтобы вставить в pipe. jgrep читает строки по мере их поступления, оценивает их одновременно и выводит совпадения в исходном порядке, поэтому работает как с `tail -f`, так и с файлами. На 994 заголовках Hacker News: 4,6 секунды и $0,012 для одного описания, и столько же времени для трёх описаний одновременно.
Есть и другие более странные вещи. Jev triage — это TUI для просмотра открытых pull request, отсортированных по приоритету. Он определяет приоритет не по меткам, а посмотрев все комментарии. Это не замена специальной команде по сортировке, но это чёртов хороший помощник.
Jev — проприетарная модель, но Laya — open-weight и достаточно мала, чтобы запускаться локально. Она также может быть быстрее и точнее Jev при fine-tuning. Минус в том, что это кодовая база, а не продукт:
- Это не хостируется, поэтому нужно самостоятельно много настраивать.
- Работает плохо без fine-tuning, поэтому нужно знать довольно много ML, чтобы максимально использовать её.
- Поддерживает контексты только до 512 байт, поэтому не масштабируется хорошо на большие входы.
Изучение Jev и Laya убеждает в том, что есть ещё много архитектурного прогресса впереди, что мы не достигнем пределов масштабирования ML в ближайшем будущем.
Соединим всё вместе
Если объединить всё это, видим примерно 2,5 порядка величины снижения стоимости токена за последний год.
- Модели примерно в 100 раз более экономичнее по задачам.
- Оборудование примерно в 1,3 раза более энергоэффективнее за токен.
- Engines примерно в 1,4 раза более энергоэффективнее за токен.
Если перестать смотреть на сырую стоимость токена и рассмотреть другие бенчмарки, видим другие виды улучшений:
- Новые архитектуры позволяют втиснуть в 5 или более раз больше токенов в то же количество RAM, позволяя более интеллектуальным моделям запускаться локально.
- Специализированные модели вроде Jev и Laya позволяют снизить стоимость ещё на 1–2 порядка величины.
Все эти улучшения находятся ещё на начальных стадиях развития и вероятно улучшатся с течением времени; мы всё ещё далеко от убывающих возвратов.
Что дальше?
Токены становятся дешевле, чем tool calls
По-настоящему интересно становится, когда сравниваем это с другими затратами на вычисления. Например, посмотрим, насколько дорого выполнять tool calls. Используются только грубые оценки; речь идёт о порядках величины, поэтому оценка Ферми достаточна.
GPT-5.6 Luna стоит примерно 30 центов за миллион токенов. Допустим, Luna использует 10k токенов каждый раз, когда решает вызвать tool, то есть около одной трети цента за очередь. Электричество в Нью-Йорке и Нидерландах, где я живу, стоит примерно 25 центов за киловатт-час. MacBook Air потребляет примерно 10 Вт в режиме ожидания и 30 Вт при тяжёлой нагрузке. Получаем таблицу вроде этой:
| Tool | Power (W) | Duration (s) | Price (¢) | Порядки величины дешевле, чем очередь Luna |
|---|---|---|---|---|
grep |
10 | 0.1 | 0.000007 | 4.5 |
| parse HTML | 10 | 1 | 0.00007 | 3.5 |
cargo build |
30 | 30 | 0.00625 | 1.5 |
Это ... вполне возможно в ближайшие пару лет!
Как только модели становятся дешевле инструмента, становится привлекательно помещать модели в инструменты. Мы уже это видели выше с `jgrep`; в будущем можем увидеть это для гораздо более широкого диапазона компьютерной инфраструктуры. Например, можем увидеть адаптивные планировщики сборки, использующие машинное обучение. Они возможны сегодня, но требуют довольно много экспертизы для настройки; как только они станут возможны с моделью общего назначения, их будет намного проще встраивать.
Supply-side Jevons Paradox
По мере удешевления моделей компании реагируют тем, что строят больше вычислительной мощности. Почему? Потому что они зарабатывают больше денег на каждый вложенный доллар. Это называется парадоксом Джевонса: чем эффективнее что-то, тем больше оно существует в целом. В частности, по мере удешевления вещей, люди хотят использовать её больше. Это называется индуцированный спрос и часто всплывает при обсуждении транспортных сетей.
Как инвесторы вернут свои деньги?
Если токены слишком дёшевы, чтобы их мерить, как поставщики LLM зарабатывают деньги? Это означает, что пузырь лопнет?
Нет, не думаю. Во-первых, просто потому что каждый токен дешевый, не означает, что inference не является прибыльным для поставщиков, как я обсуждаю в разделе выше. Но во-вторых, OpenAI и Anthropic всё ещё значительно впереди большинства других AI лабораторий. Просто потому что объём становится дёшевым, не означает, что качество дешевеет. Думаю, мы увидим мир, где самые сложные задачи покупают вычисления у фронтьерных лаб, в то время как «обычные» задачи используют open weights или сильно дисконтированные планы, которые должны конкурировать с open weights.
Остаётся открытым вопрос, будут ли open weight модели догонять OpenAI и Anthropic! Если будут, это повредит инвесторам и возможно вызовет волновые эффекты в экономике США. Не думаю, что это изменит фундаментальную технологическую картину, хотя: NVIDIA всё ещё будет расти, и компании всё ещё будут использовать AI (и это будет даже дешевле, чем было бы в противном случае).
Demand-side Jevons Paradox
Но есть ещё один интереснейший вопрос: как только вычисления станут достаточно дёшевыми, для чего люди их будут использовать? Что делать с миллионом токенов? С миллиардом?
Вот некоторые вещи, которые, думаю, возможны, хотя не все из них вероятны.
- Кибербезопасность станет совсем плохой. Компании будут централизоваться вокруг хостируемых сервисов вроде Cloudflare Access, внутренних AWS/Azure сервисов и т.д., потому что иначе их хакируют.
- Сырые вычисления получают больше преимущества. Oxide Computer Company, AWS, Cloudflare, все гиперскейлеры получат выгоду. Увидим всё больше компаний, сдающих в аренду специализированные GPU, оптимизированные для inference, а не просто общего назначения EC2. Это уже происходит с сервисами вроде runpod.
- Сложная часть ПО становится требованиями к продукту, тестированием и дизайном пользовательского интерфейса, а не алгоритмами. Рынок труда становится действительно странным. В идеале, увидим всплеск позиций QA и UI/UX.
- Сдача ПО в аренду станет намного более редкой. Кодовые базы ПО перестают быть моатом; операции и безопасность — настоящие драйверы стоимости. Увидим ещё больше вещей вроде Amazon Managed Streaming for Apache Kafka и ещё меньше вещей вроде JetBrains IDEs и Blackboard.
- Вероятно, ещё много всего! Будущее становится странным!!
Опциональность
Что, думаю, действительно интересно — раньше люди имели три основные варианта при рассмотрении программного обеспечения:
- Использовать его.
- Не использовать его.
- Использовать другой похожий продукт.
Теперь у них есть четвёртый вариант — сказать LLM, чтобы он его построил. Качество выхода LLM может быть лучше или хуже, но вариант есть, когда его раньше не было. Компании должны конкурировать по качеству, а не только по сырой способности делать то, что раньше было невозможно. У держав в регулируемых отраслях будет массивное преимущество по сравнению со свободным рынком.
Что действительно класно в этом — это делает гораздо проще создание гибкого ПО, которое специально кроится под конкретного человека, что было немыслимо даже 5 лет назад для кого-нибудь, кто не программист.
Резюме
Не знаю, что будет дальше. Думаю, мы должны планировать мир, где увидим дешевые не только вычисления, но и дешевый интеллект.