Time Series Foundation Models (TSFM)
Временные ряды — один из самых распространённых типов данных в корпоративной среде: от телеметрии датчиков до метрик мониторинга. Прогнозы на их основе определяют решения по планированию ёмкостей, энергоснабжению, управлению цепями поставок, рискам и техническому обслуживанию.
Промышленные предприятия прогнозируют показатели датчиков процесса в зависимости от графика производства, выявляют дрейф оборудования до его отказа, планируют ёмкость и запасные части для тысяч активов. Финансовые команды прогнозируют потоки, объёмы и волатильность для принятия решений по позициям, хеджированию и казначейству на тысячах счетов.
Классические модели — ARIMA и линейная регрессия — остаются хорошо зарекомендовавшимися инструментами. Их обычно подгоняют к одному ряду и учат только историю этого ряда.
Глубокие нейросети, такие как PatchTST, добавляют способность выучивать нелинейные паттерны на основе множества связанных рядов, но их всё ещё обычно обучают с нуля на каждом датасете, поэтому полученные знания не переносятся на новые домены.
Foundation-модели для временных рядов применяют подход предварительного обучения к временным рядам. Обученная на большом и разнообразном корпусе, модель выучивает паттерны, которые переносятся между рядами и позволяют делать нулевые прогнозы на данных, которых модель никогда не видела — даже в доменах, где данных мало.
Результаты на бенчмарках
Timestral оценивали на трёх основных публичных бенчмарках прогнозирования: GIFT-Eval, TIME и fev-bench. Среди предварительно обученных моделей с нулевым прогнозом она заняла первое место по всем пяти метрикам. Эти результаты получены с одного чекпоинта без ансамблирования.
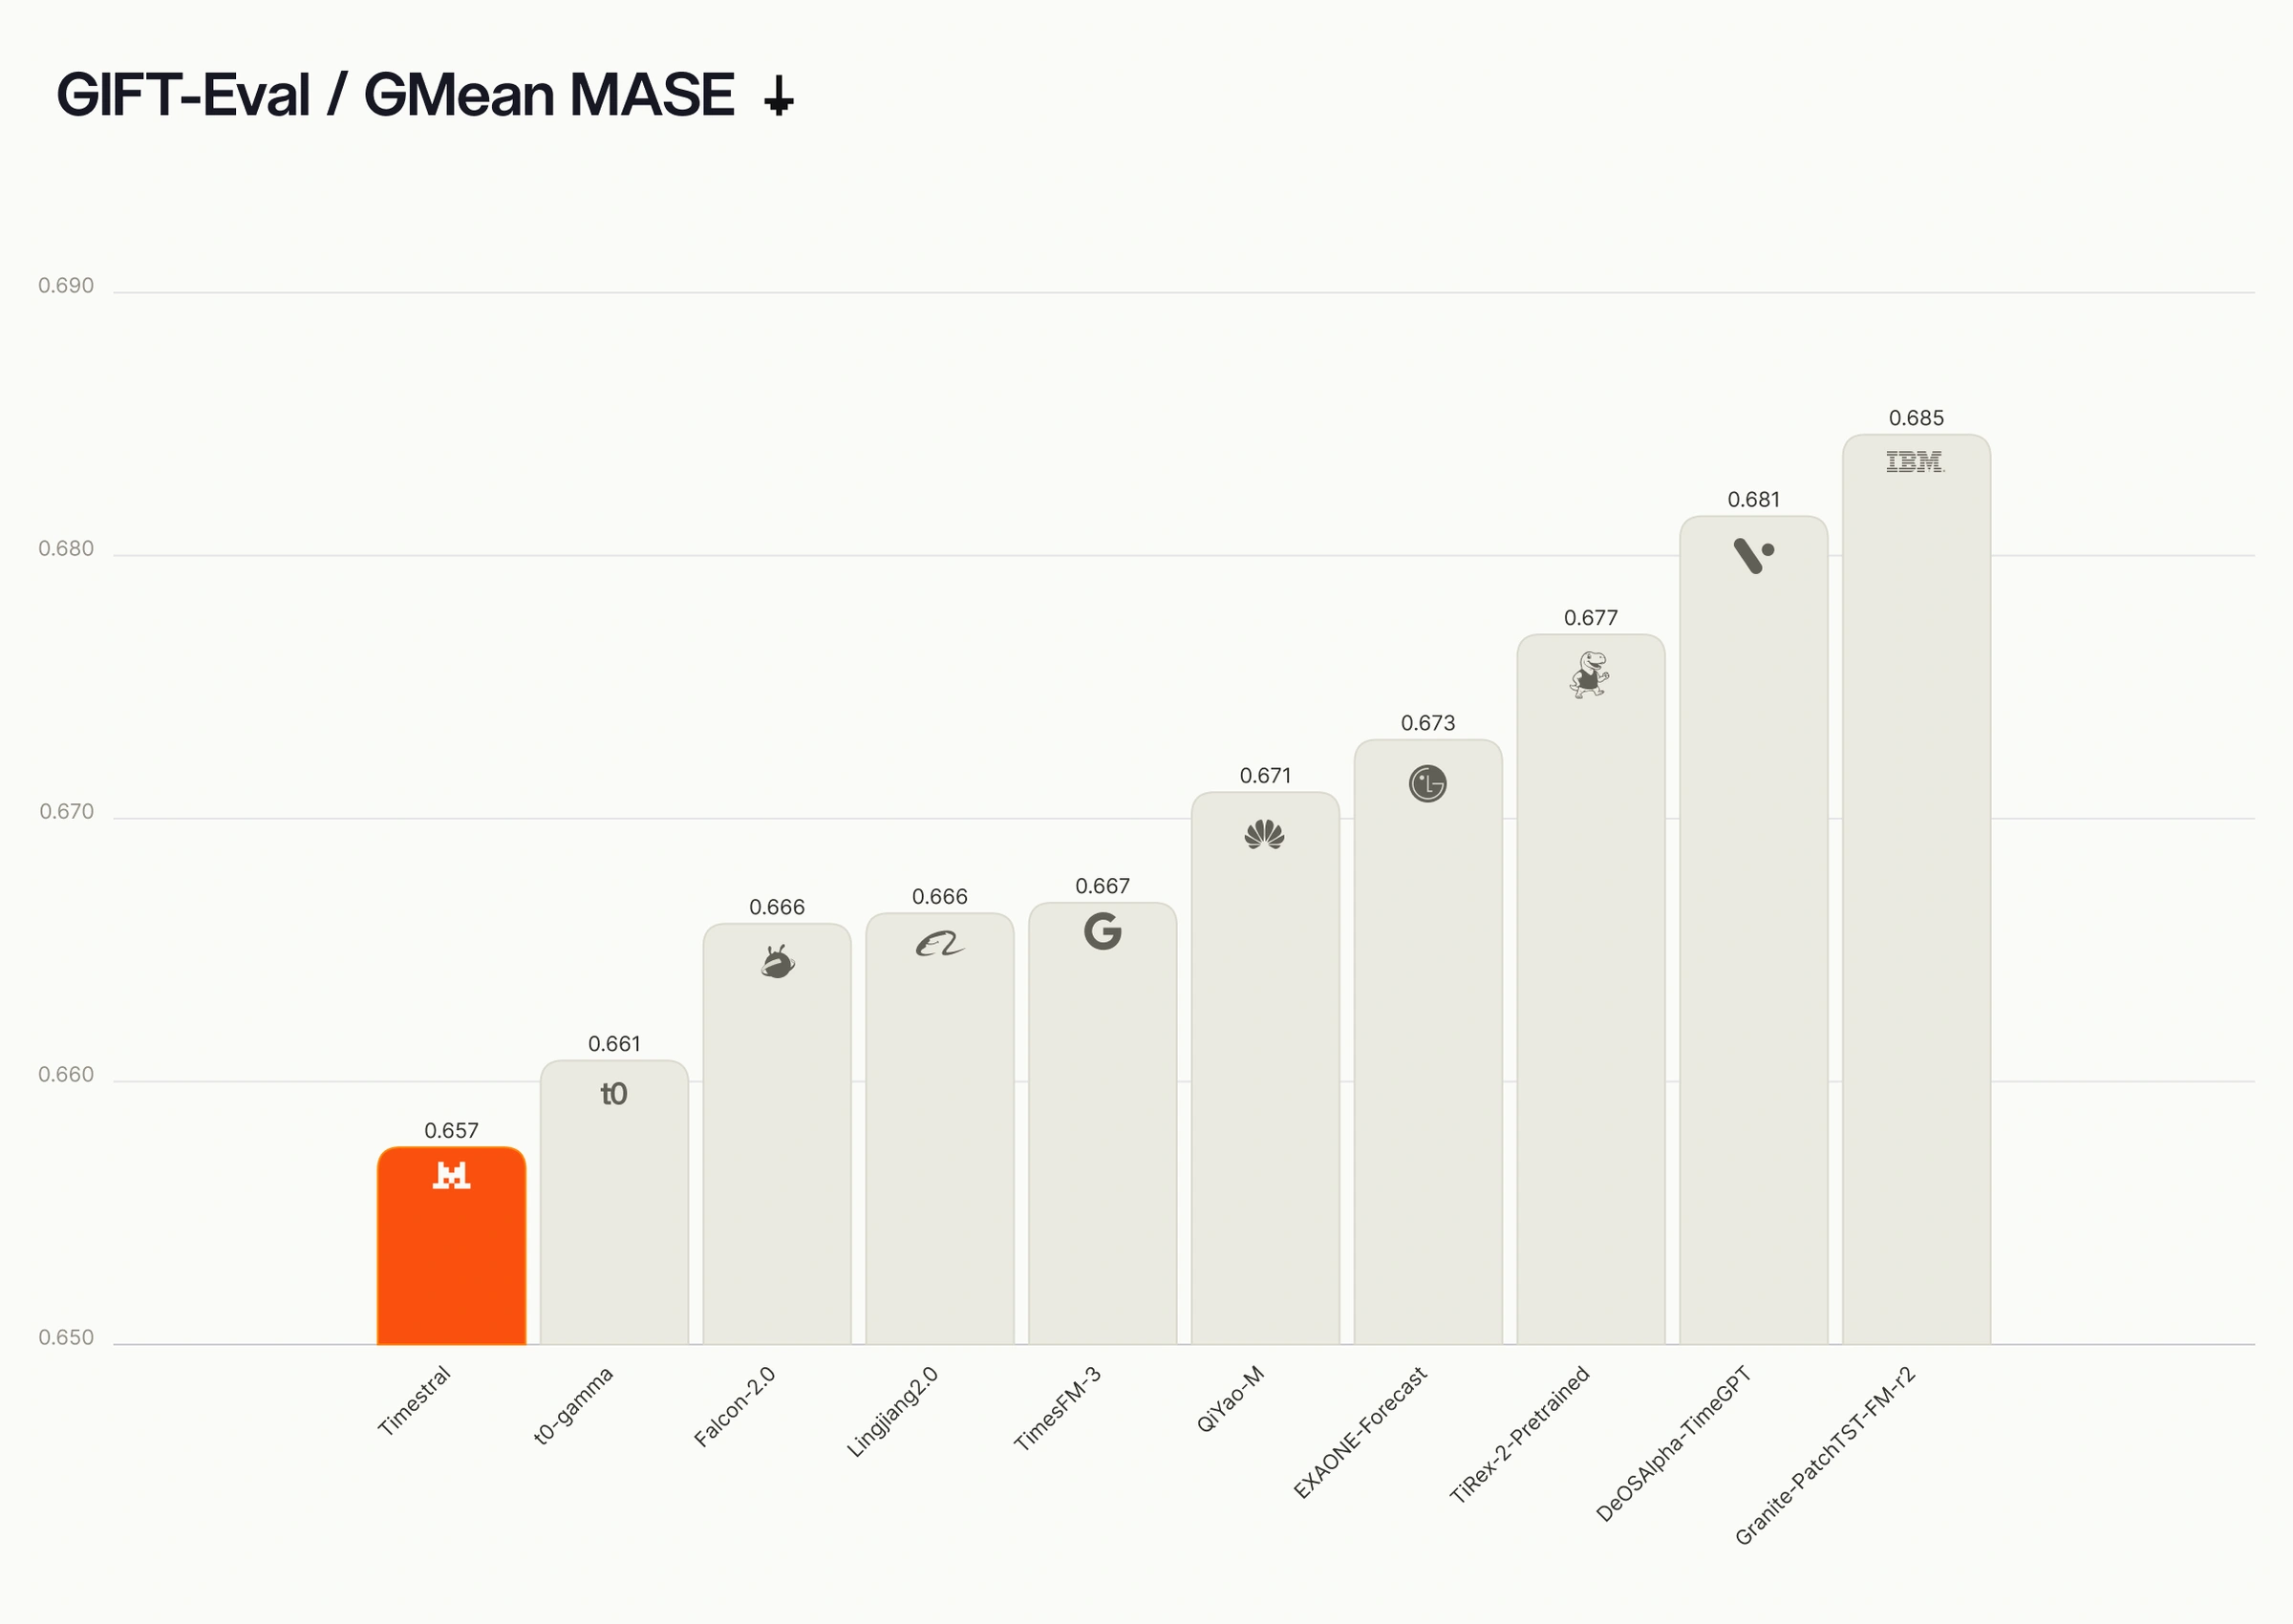
GIFT-Eval, топ-10 из 83 сравнимых предварительно обученных и нулевых прогнозов. Ниже — лучше.
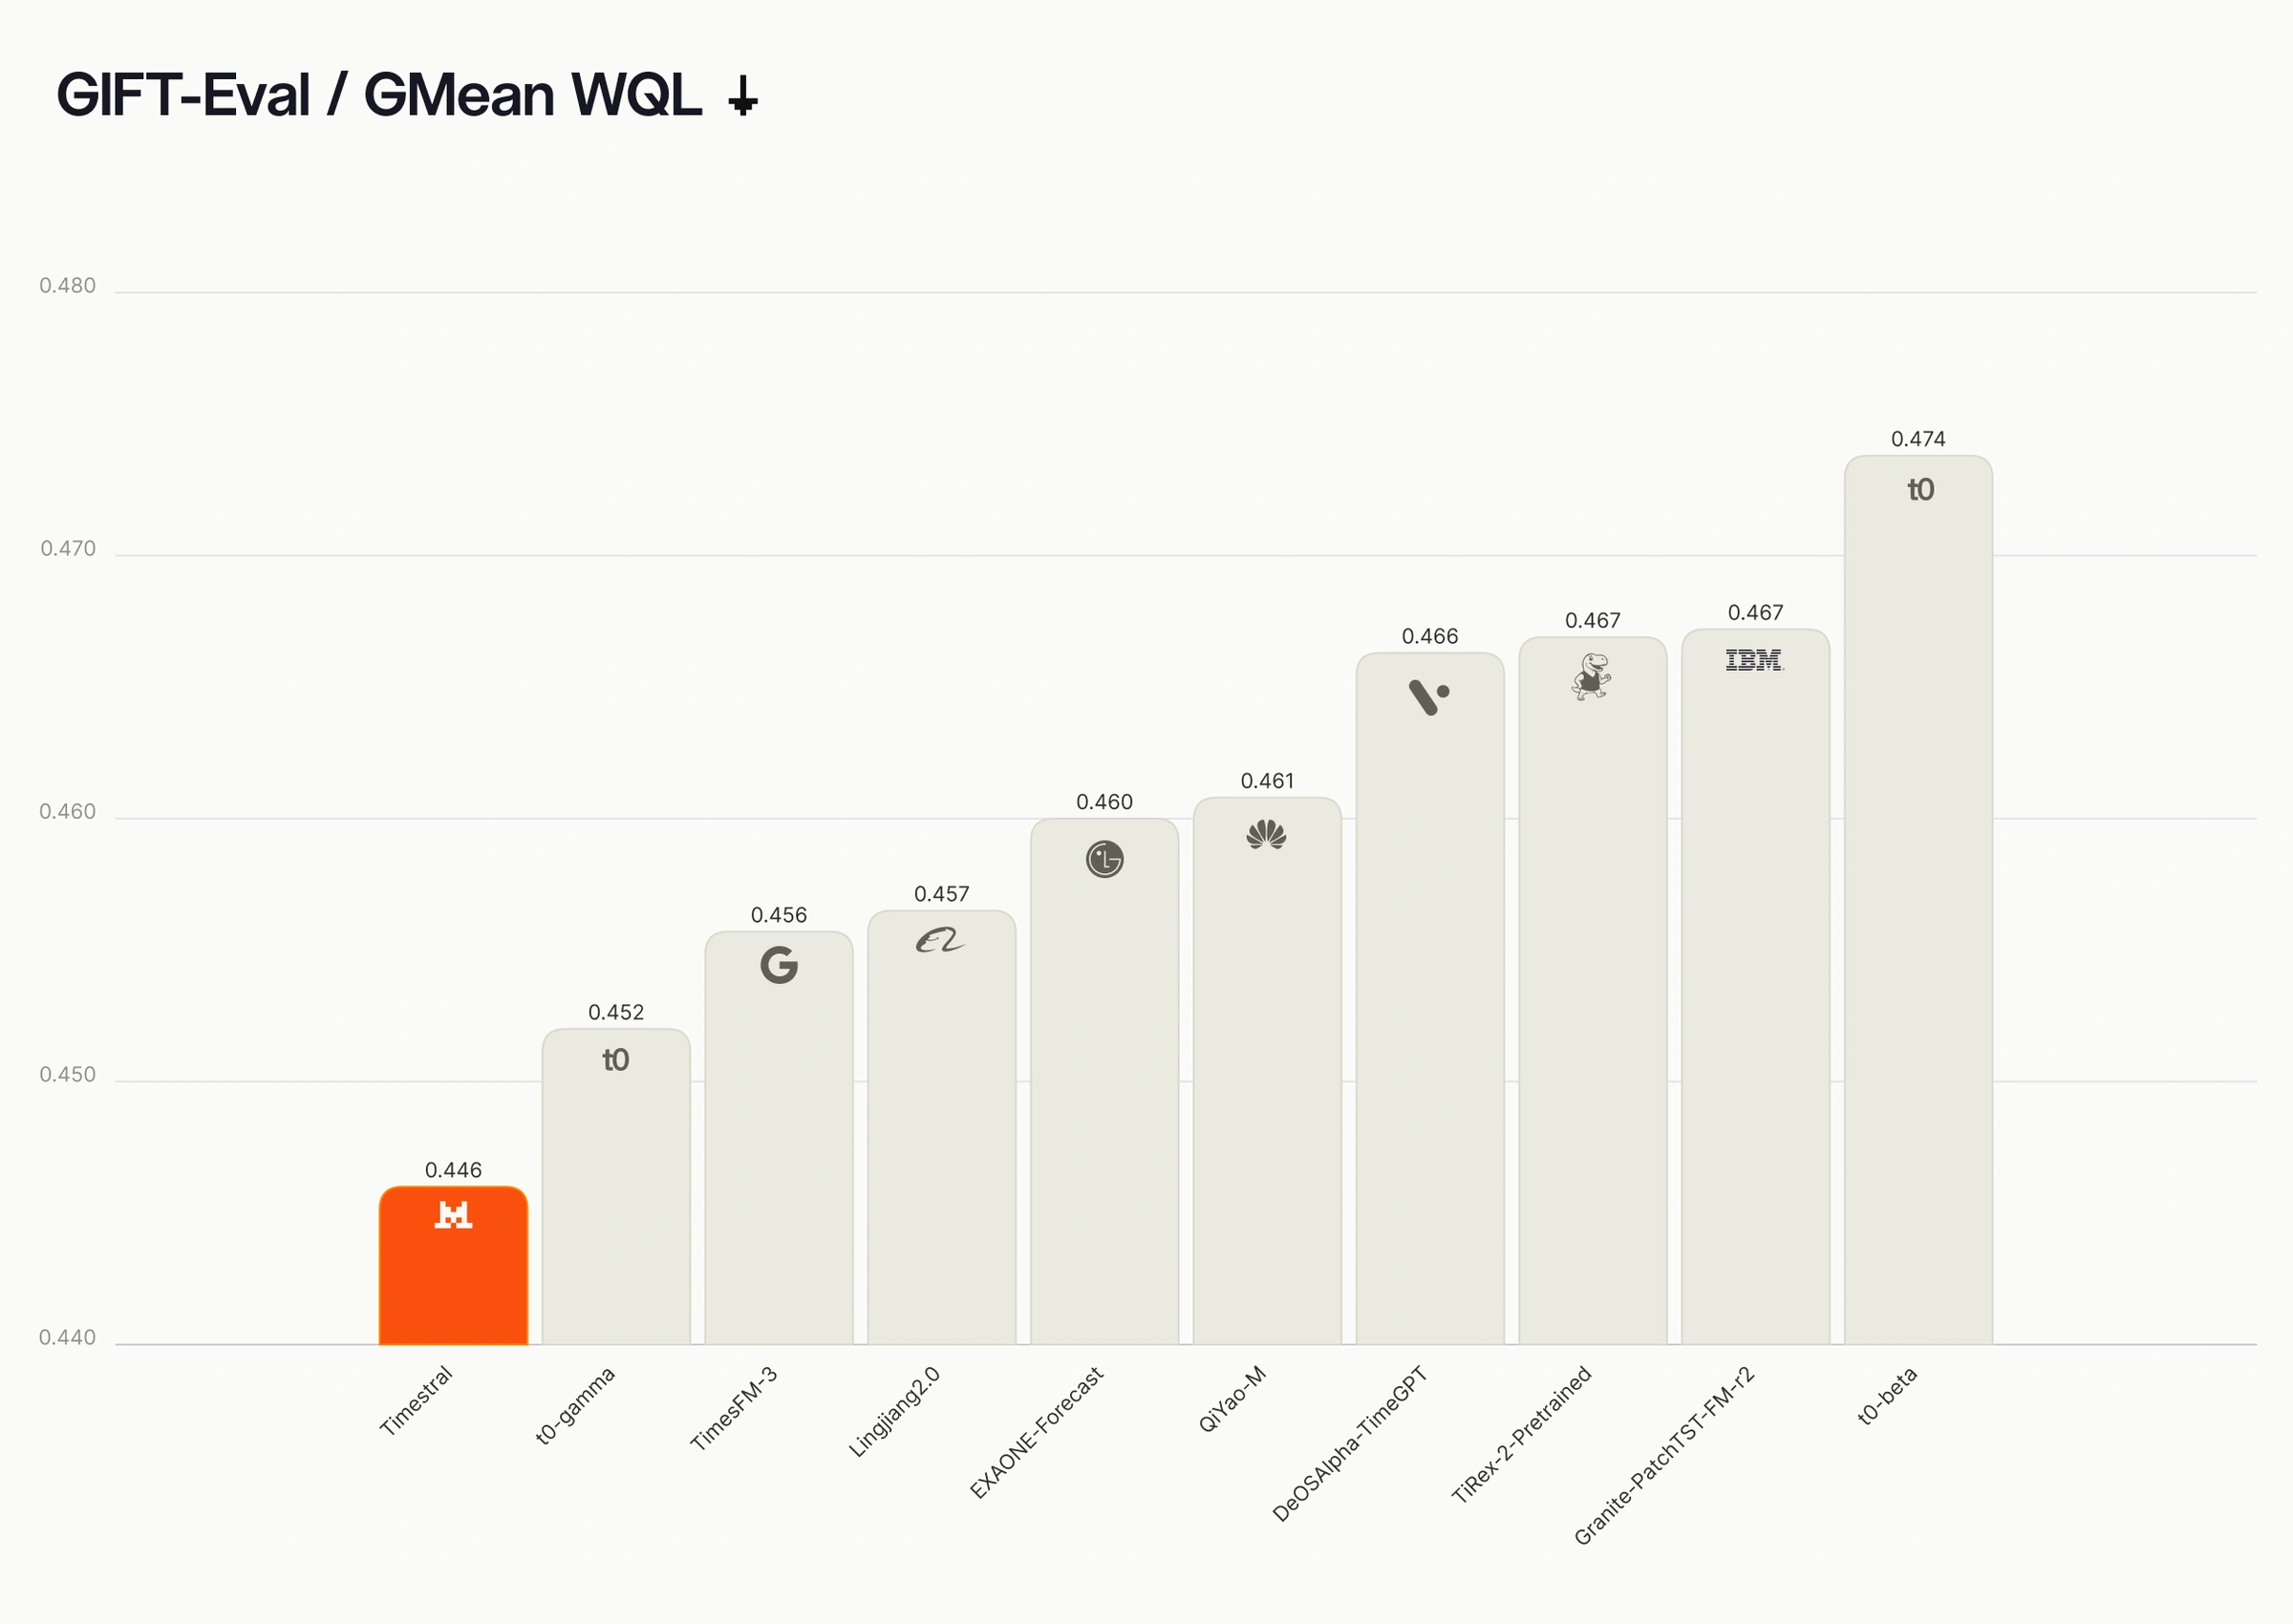
GIFT-Eval WQL, метрика потерь с весами. Ниже — лучше.
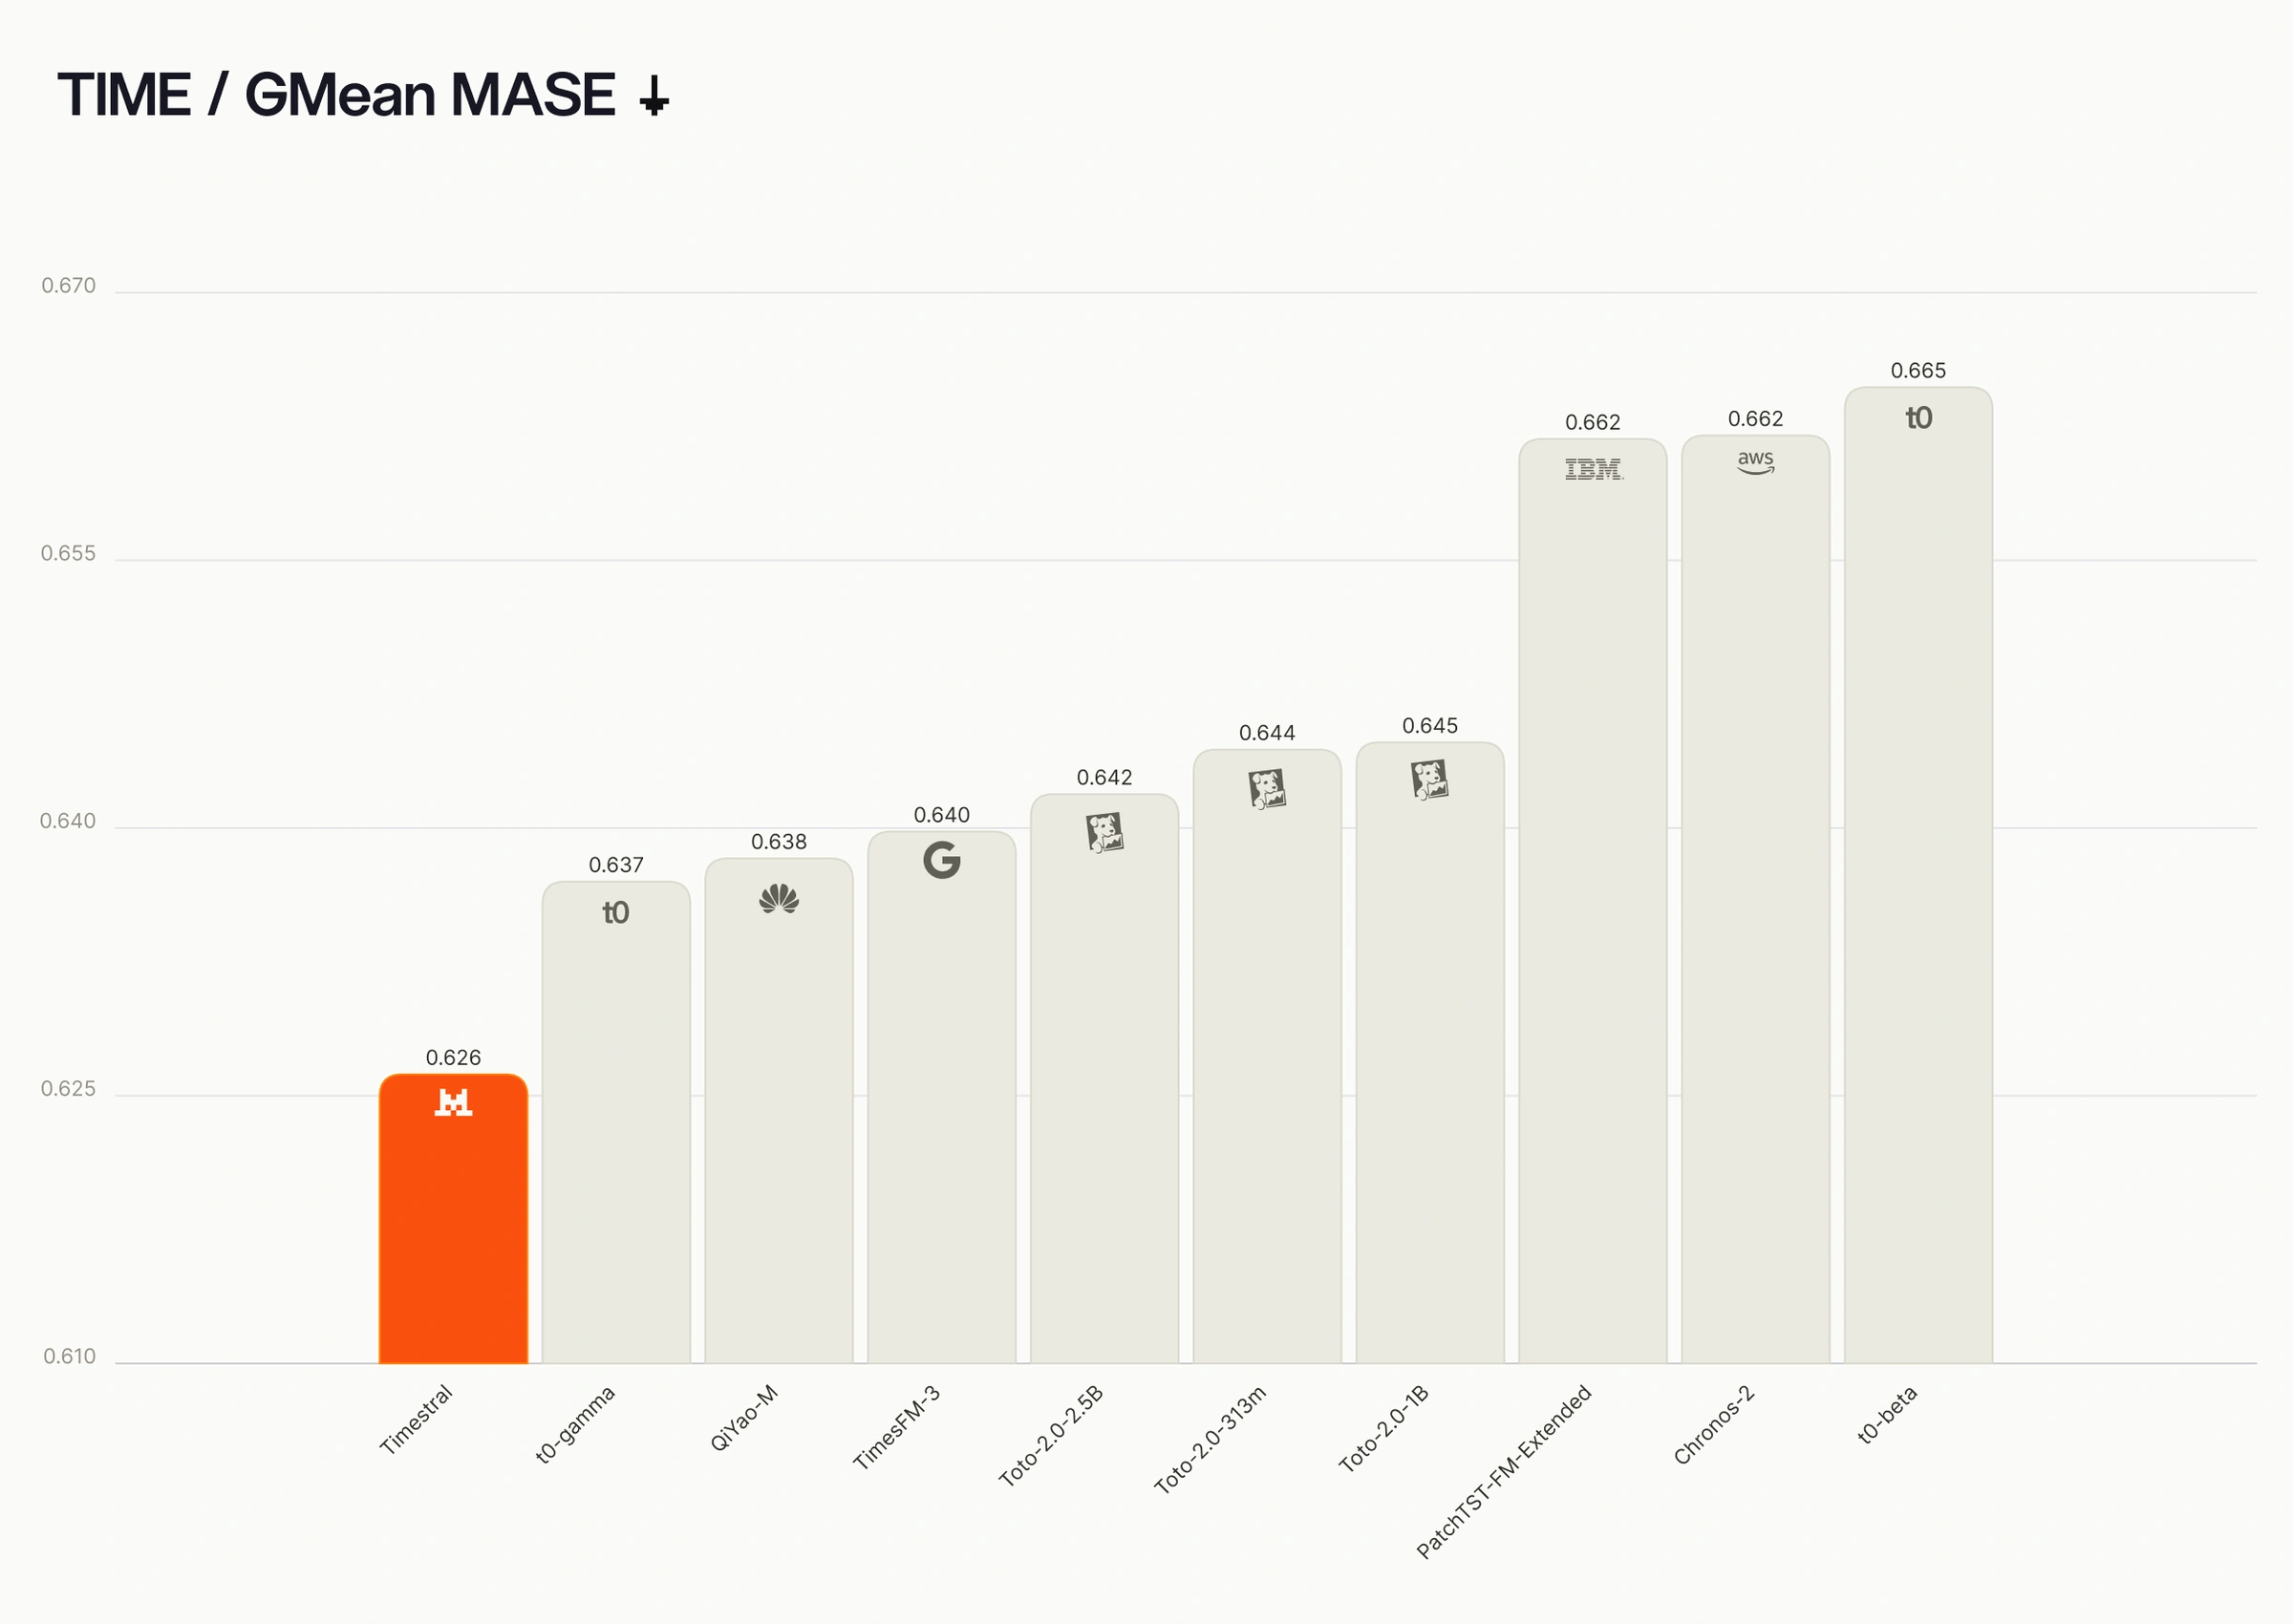
TIME, топ-10 из 35 записей рейтинга. По обеим метрикам ниже — лучше.
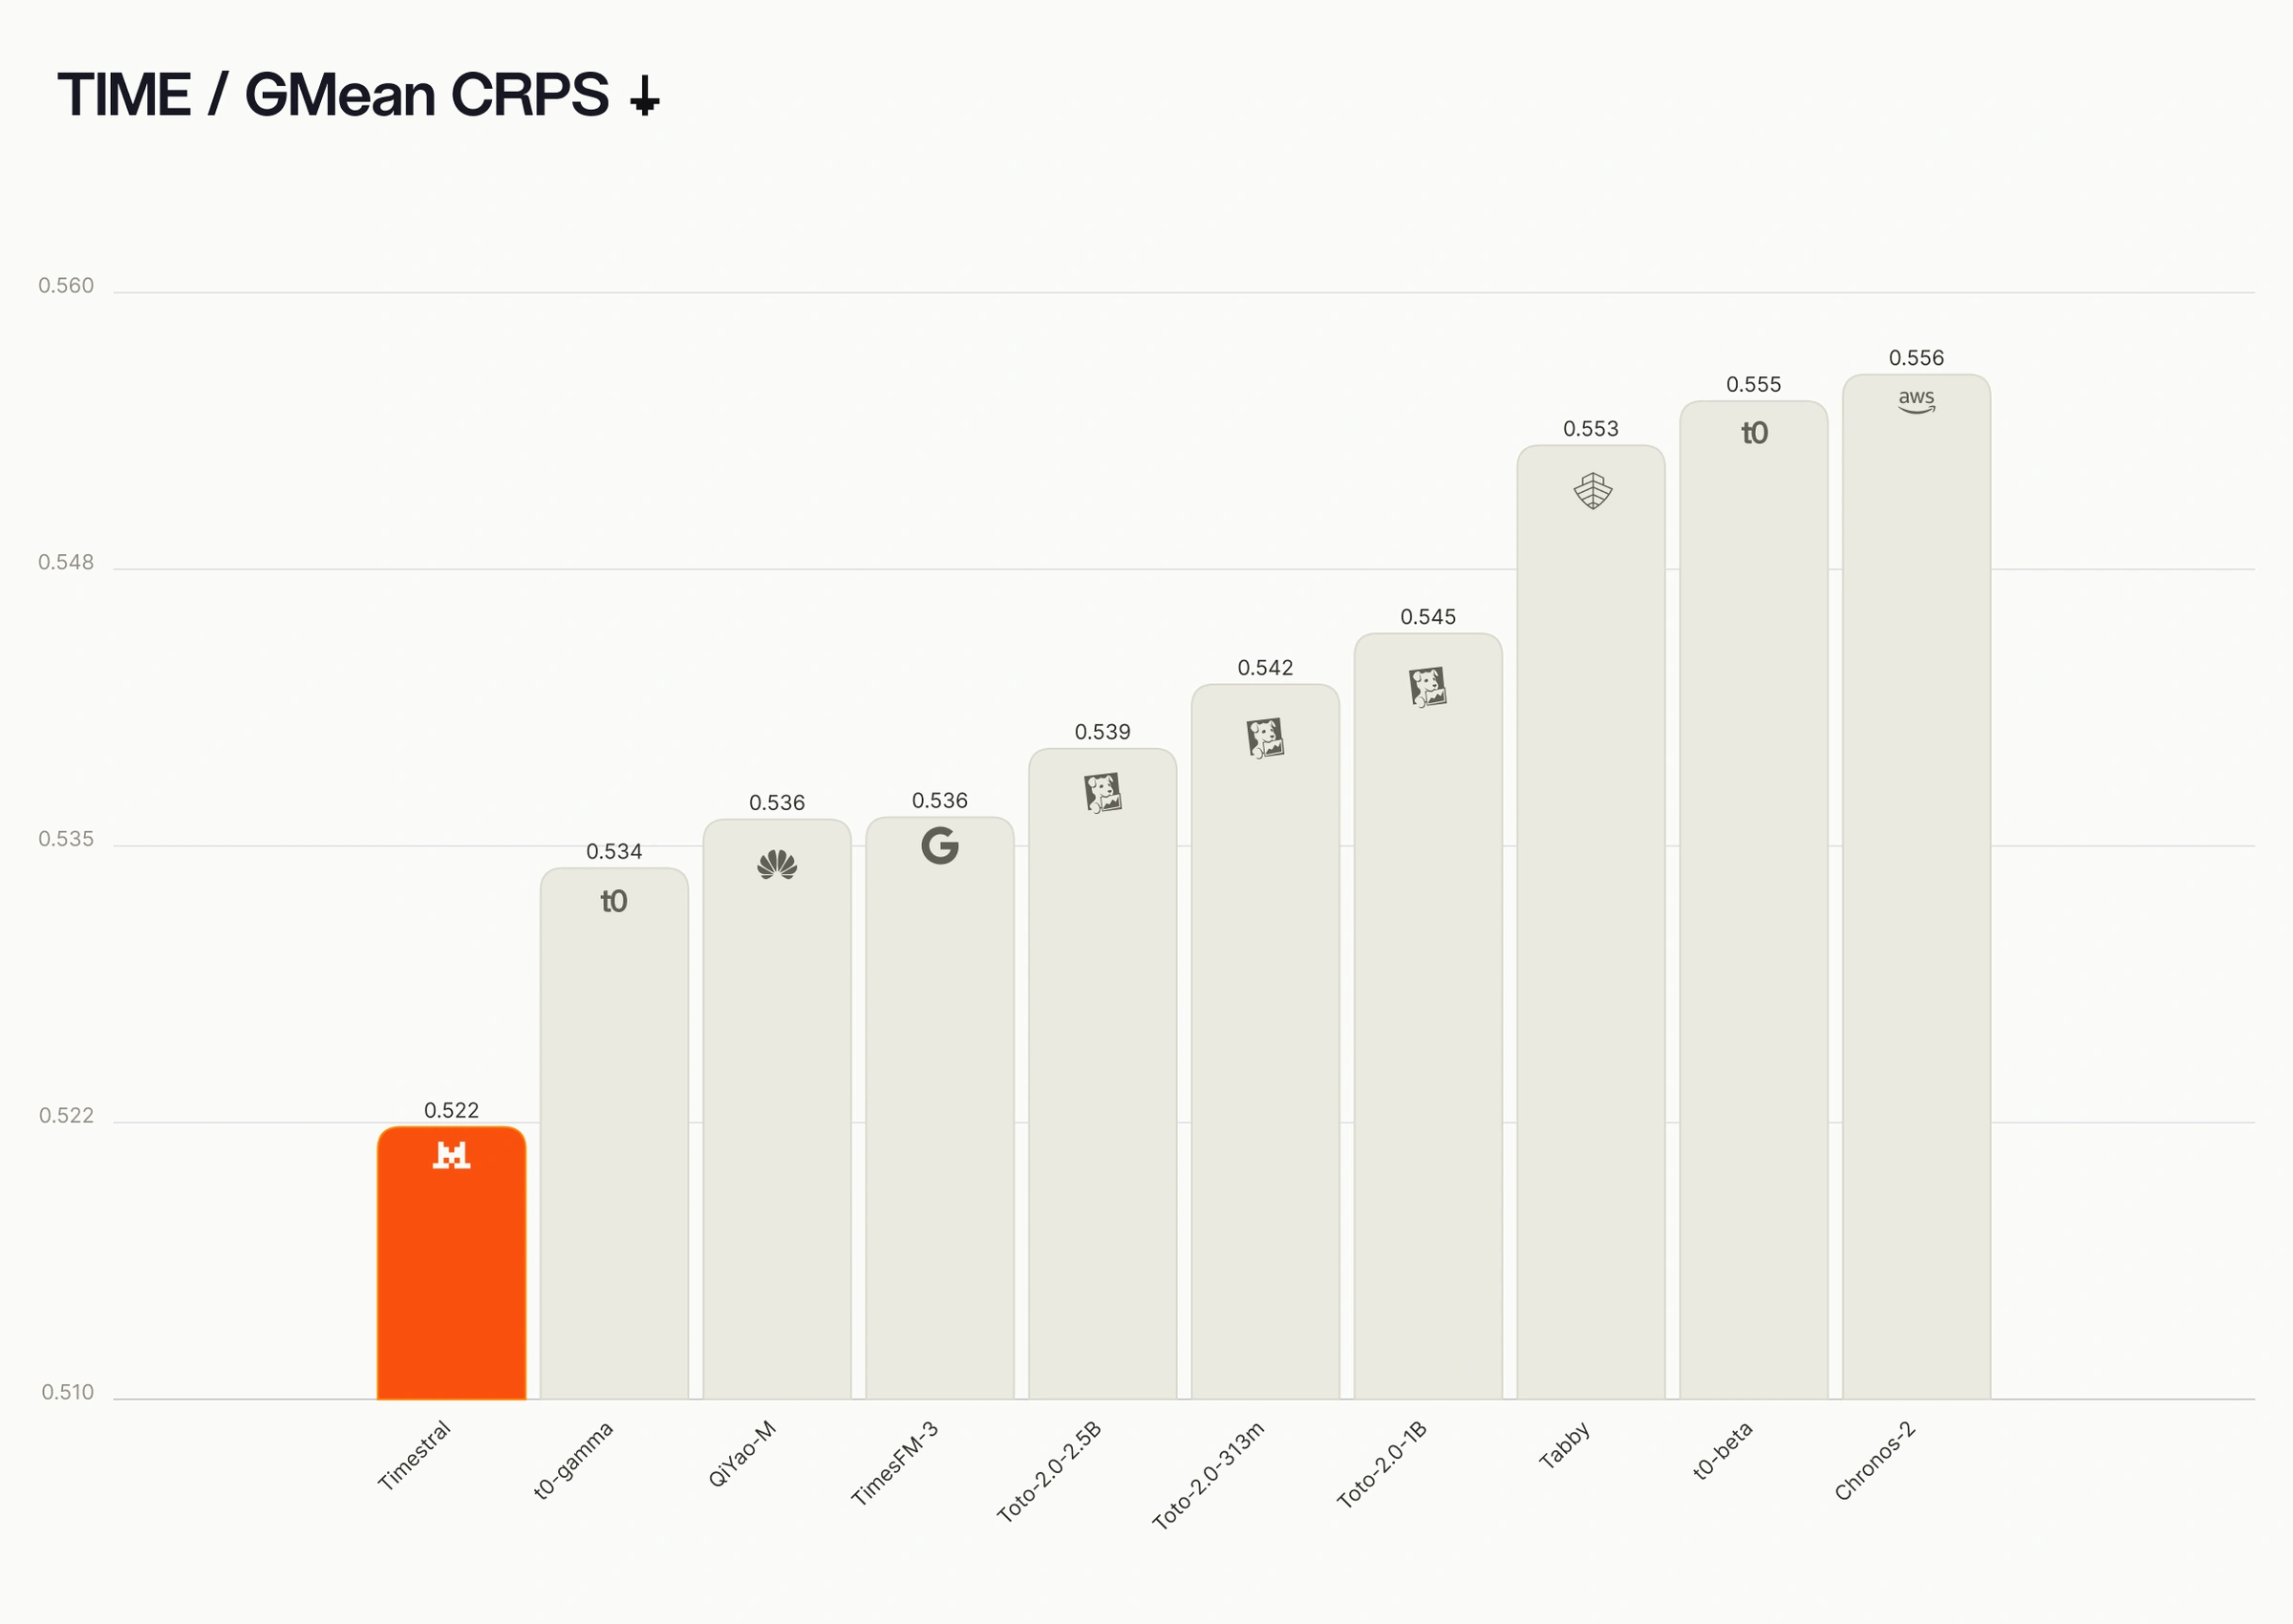
TIME, метрика CRPS (Continuous Ranked Probability Score). Ниже — лучше.
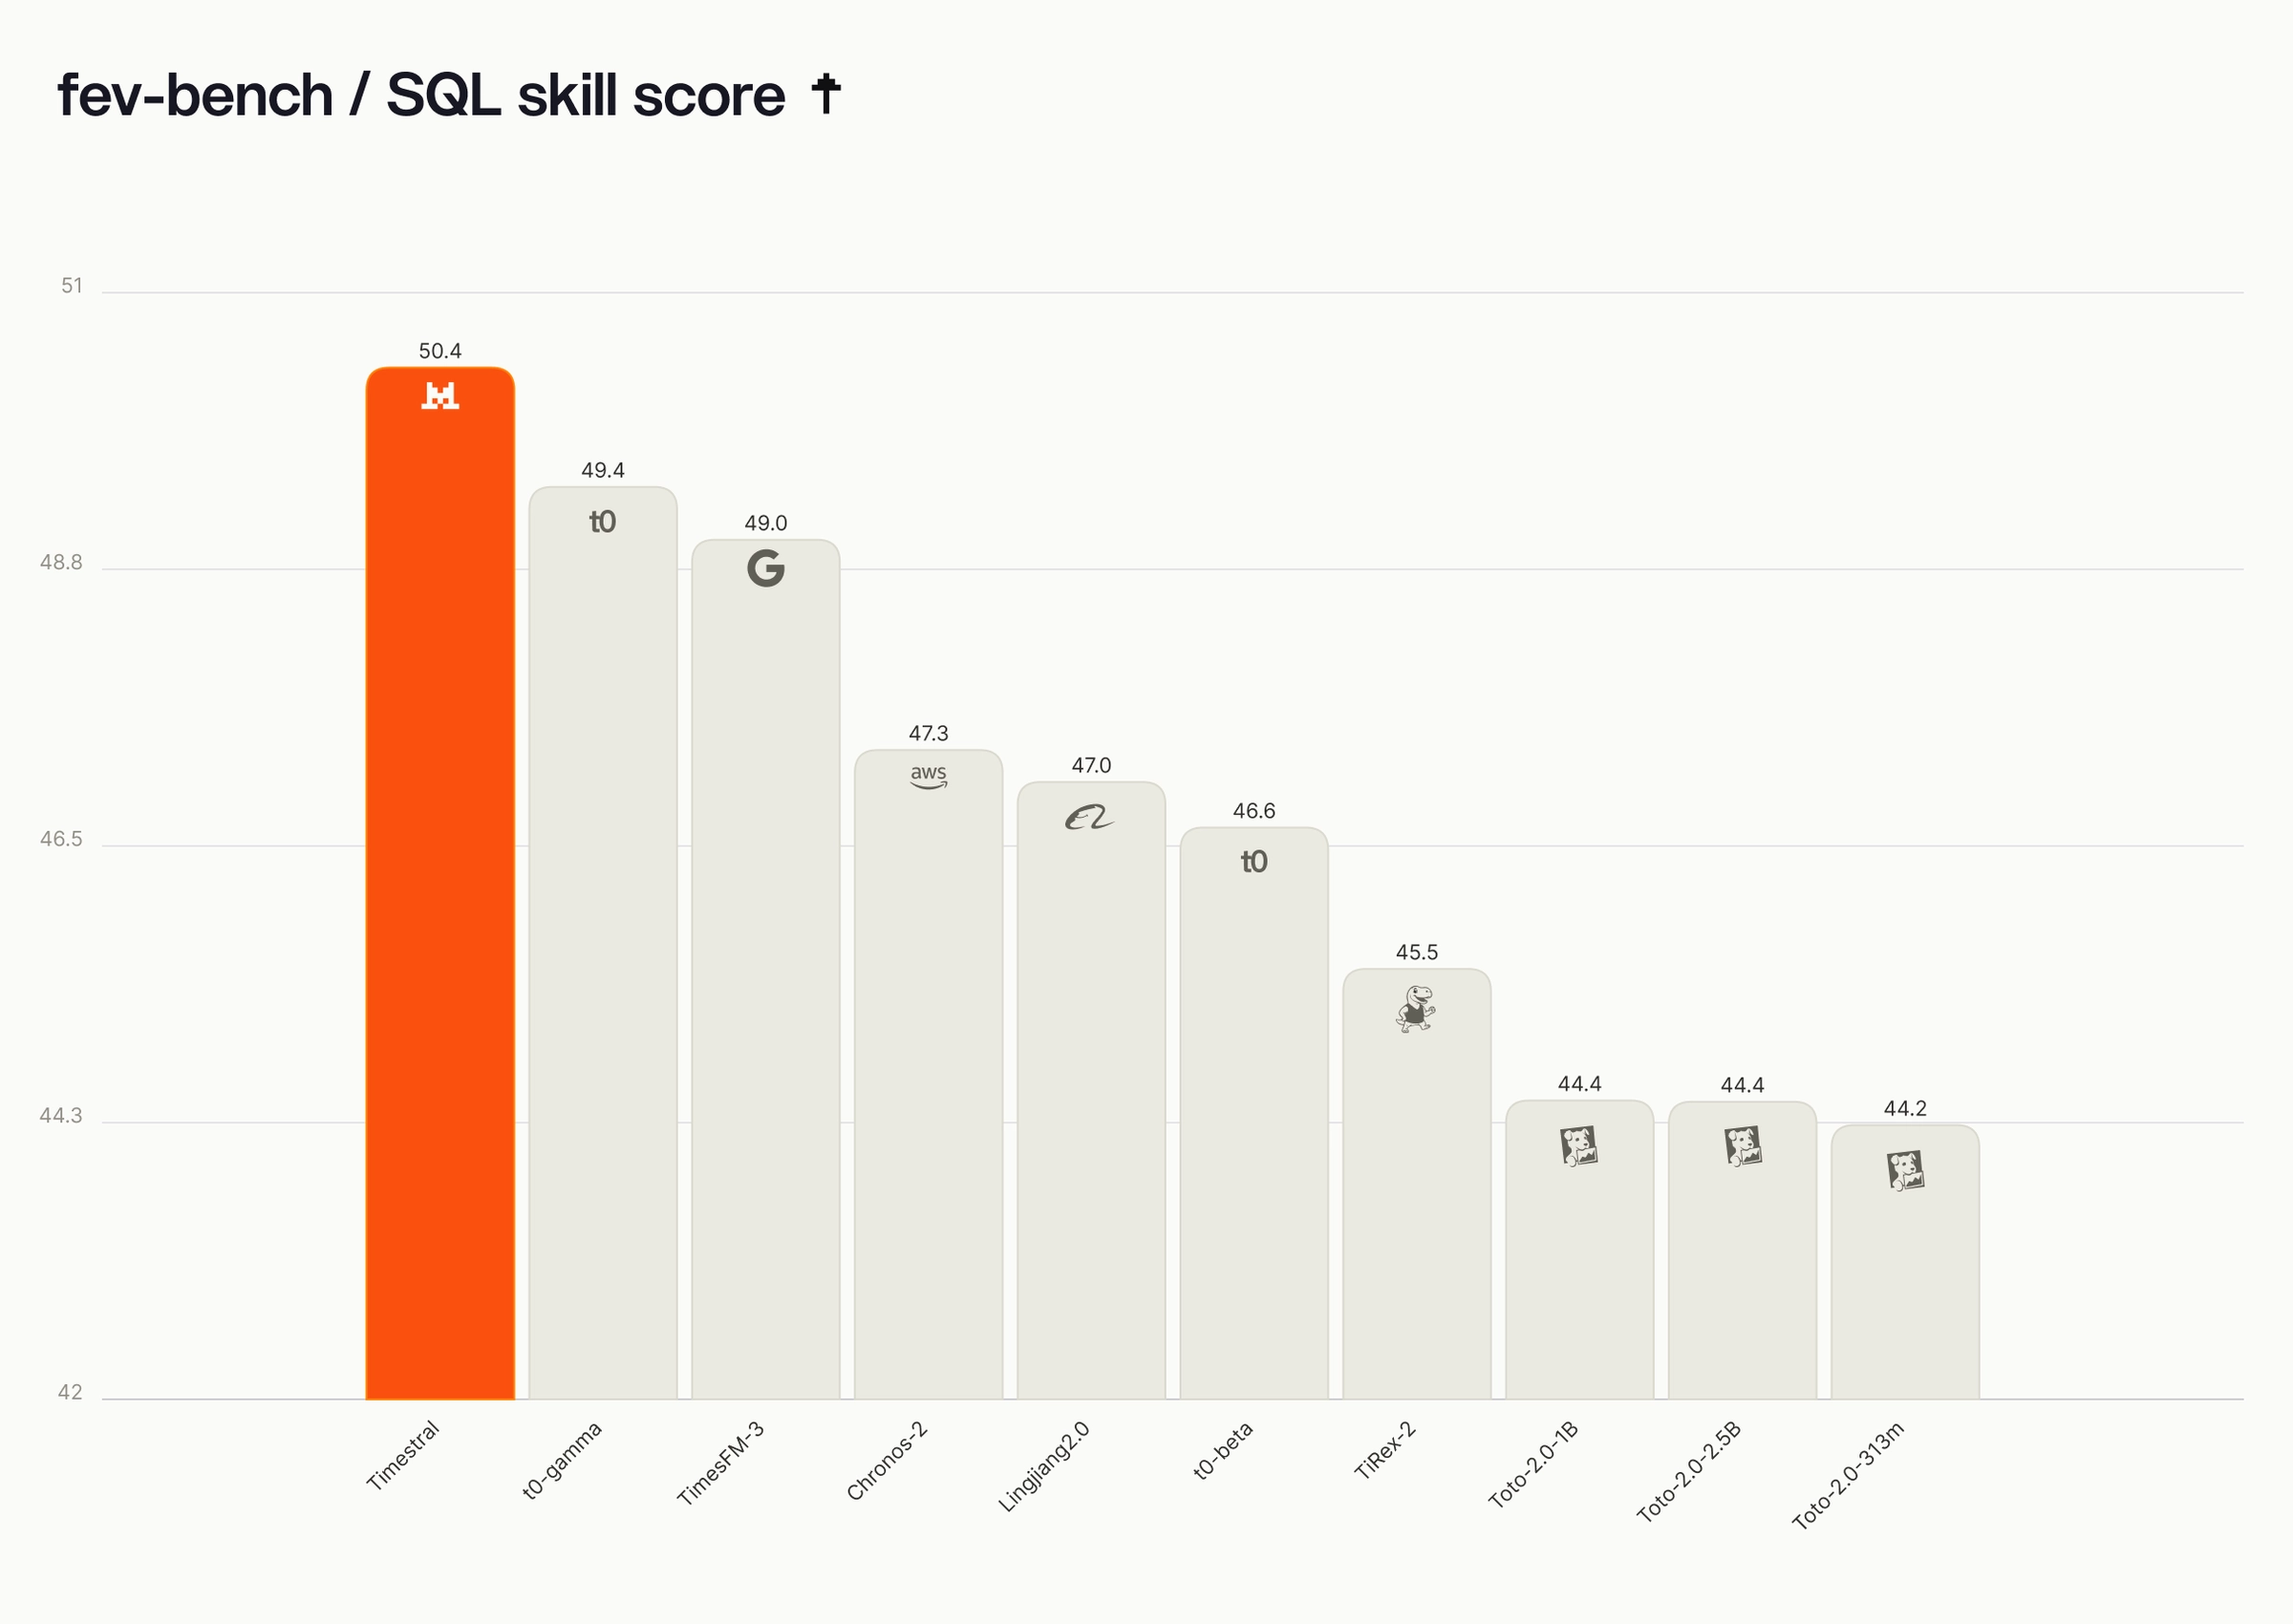
fev-bench, топ-10 из 37 записей рейтинга по SQL skill score. Выше — лучше.
Семейство моделей для всех требований
Timestral оптимизирована как семейство из четырёх моделей: 5M, 28M, 123M и 209M параметров. Более крупные модели дают лучшие прогнозы, а меньшие — быстрее и дешевле. Все четыре разделяют одну архитектуру и рецепт обучения. Каждый размер находится на Pareto front точности против размера модели: для каждого размера нет публичной модели, которая прогнозировала бы лучше.
Score против размера модели на GIFT-Eval, TIME и fev-bench (показано как 1 − skill score). Ниже — лучше. Модель 28M обыгрывает Chronos-2, примерно в четыре раза больше, на GIFT-Eval и TIME. Модель 209M обыгрывает TimesFM-3 и Falcon-2.0 с меньшим числом параметров.
Timestral не требует GPU при инференсе. На обычном серверном CPU с 8 потоками прогноз на один день вперёд по трём неделям истории с интервалом 15 минут занимает 10 мс для модели 5M и 140 мс для 209M. Меньшие модели жертвуют некоторой точностью ради скорости: модель 28M в пять раз быстрее 209M, а 123M достигает 0,2% отScore 209M при трёх четвертях её задержки.
Пример из промышленности
Рассмотрим промышленное предприятие с тысячами датчиков на всём оборудовании. Timestral может улучшить прогнозы на этих данных несколькими способами.
Мультивариантное прогнозирование. Вибрация, температура и давление насоса движутся не независимо. Рост одного часто объясняет или вызывает изменение другого. Timestral моделирует связанные ряды совместно, так что может использовать эти зависимости вместо прогнозирования каждого датчика в изоляции.
Вероятностное прогнозирование. Одно предсказанное значение может не показать полную картину. Timestral предсказывает полный набор квантилей, так что команды видят, насколько велика неопределённость, устанавливают пороги срабатывания алертов, которые это отражают, и планируют обслуживание вокруг риска, а не одного числа.
Категориальные ковариаты. Некоторые ковариаты принимают значения из набора категорий, а не непрерывные числа, например день недели или состояние машины (работает, ждёт, на обслуживании). Кодирование их как чисел навязывает порядок или масштаб, которого они не имеют. Timestral берёт их как категориальные входы напрямую, чтобы улучшить прогнозы.
Известные будущие ковариаты. Некоторые драйверы поведения датчиков известны заранее — расписание производства, плановые остановки, прогнозы погоды. Timestral может обуславливаться на них для улучшения качества прогноза, так что запланированный рост нагрузки ожидается, а не флагируется как сюрприз.
От модели к системе
Timestral — численная модель, которая может работать внутри существующих pipeline мониторинга или быть объединена с языковыми моделями в мультимодальных агентских рабочих процессах.
На заводе это может выглядеть так:
Timestral работает непрерывно на потоках датчиков завода, обнаруживая аномалии по мере их возникновения.
Когда она флагирует аномалию на насосе, агент встраивает сигналы и сравнивает их с эмбеддингами прошлых данных датчиков, чтобы найти похожие исторические отказы.
Затем агент запускает под-агентов для анализа первопричины, используя контекст этого завода — записи обслуживания, бортовые журналы операторов, руководства оборудования, прошлые рабочие заказы и показания связанного оборудования.
Агент составляет предложенный диагноз на основе выводов с подтверждающими доказательствами и возможными следующими шагами.
Руководитель завода получает диагноз и план, подкреплённый данными датчиков, вместо просто алерта.
Ключевые технические вклады
Несколько идей были объединены для получения этих результатов. Каждая будет описана подробно в техническом отчёте.
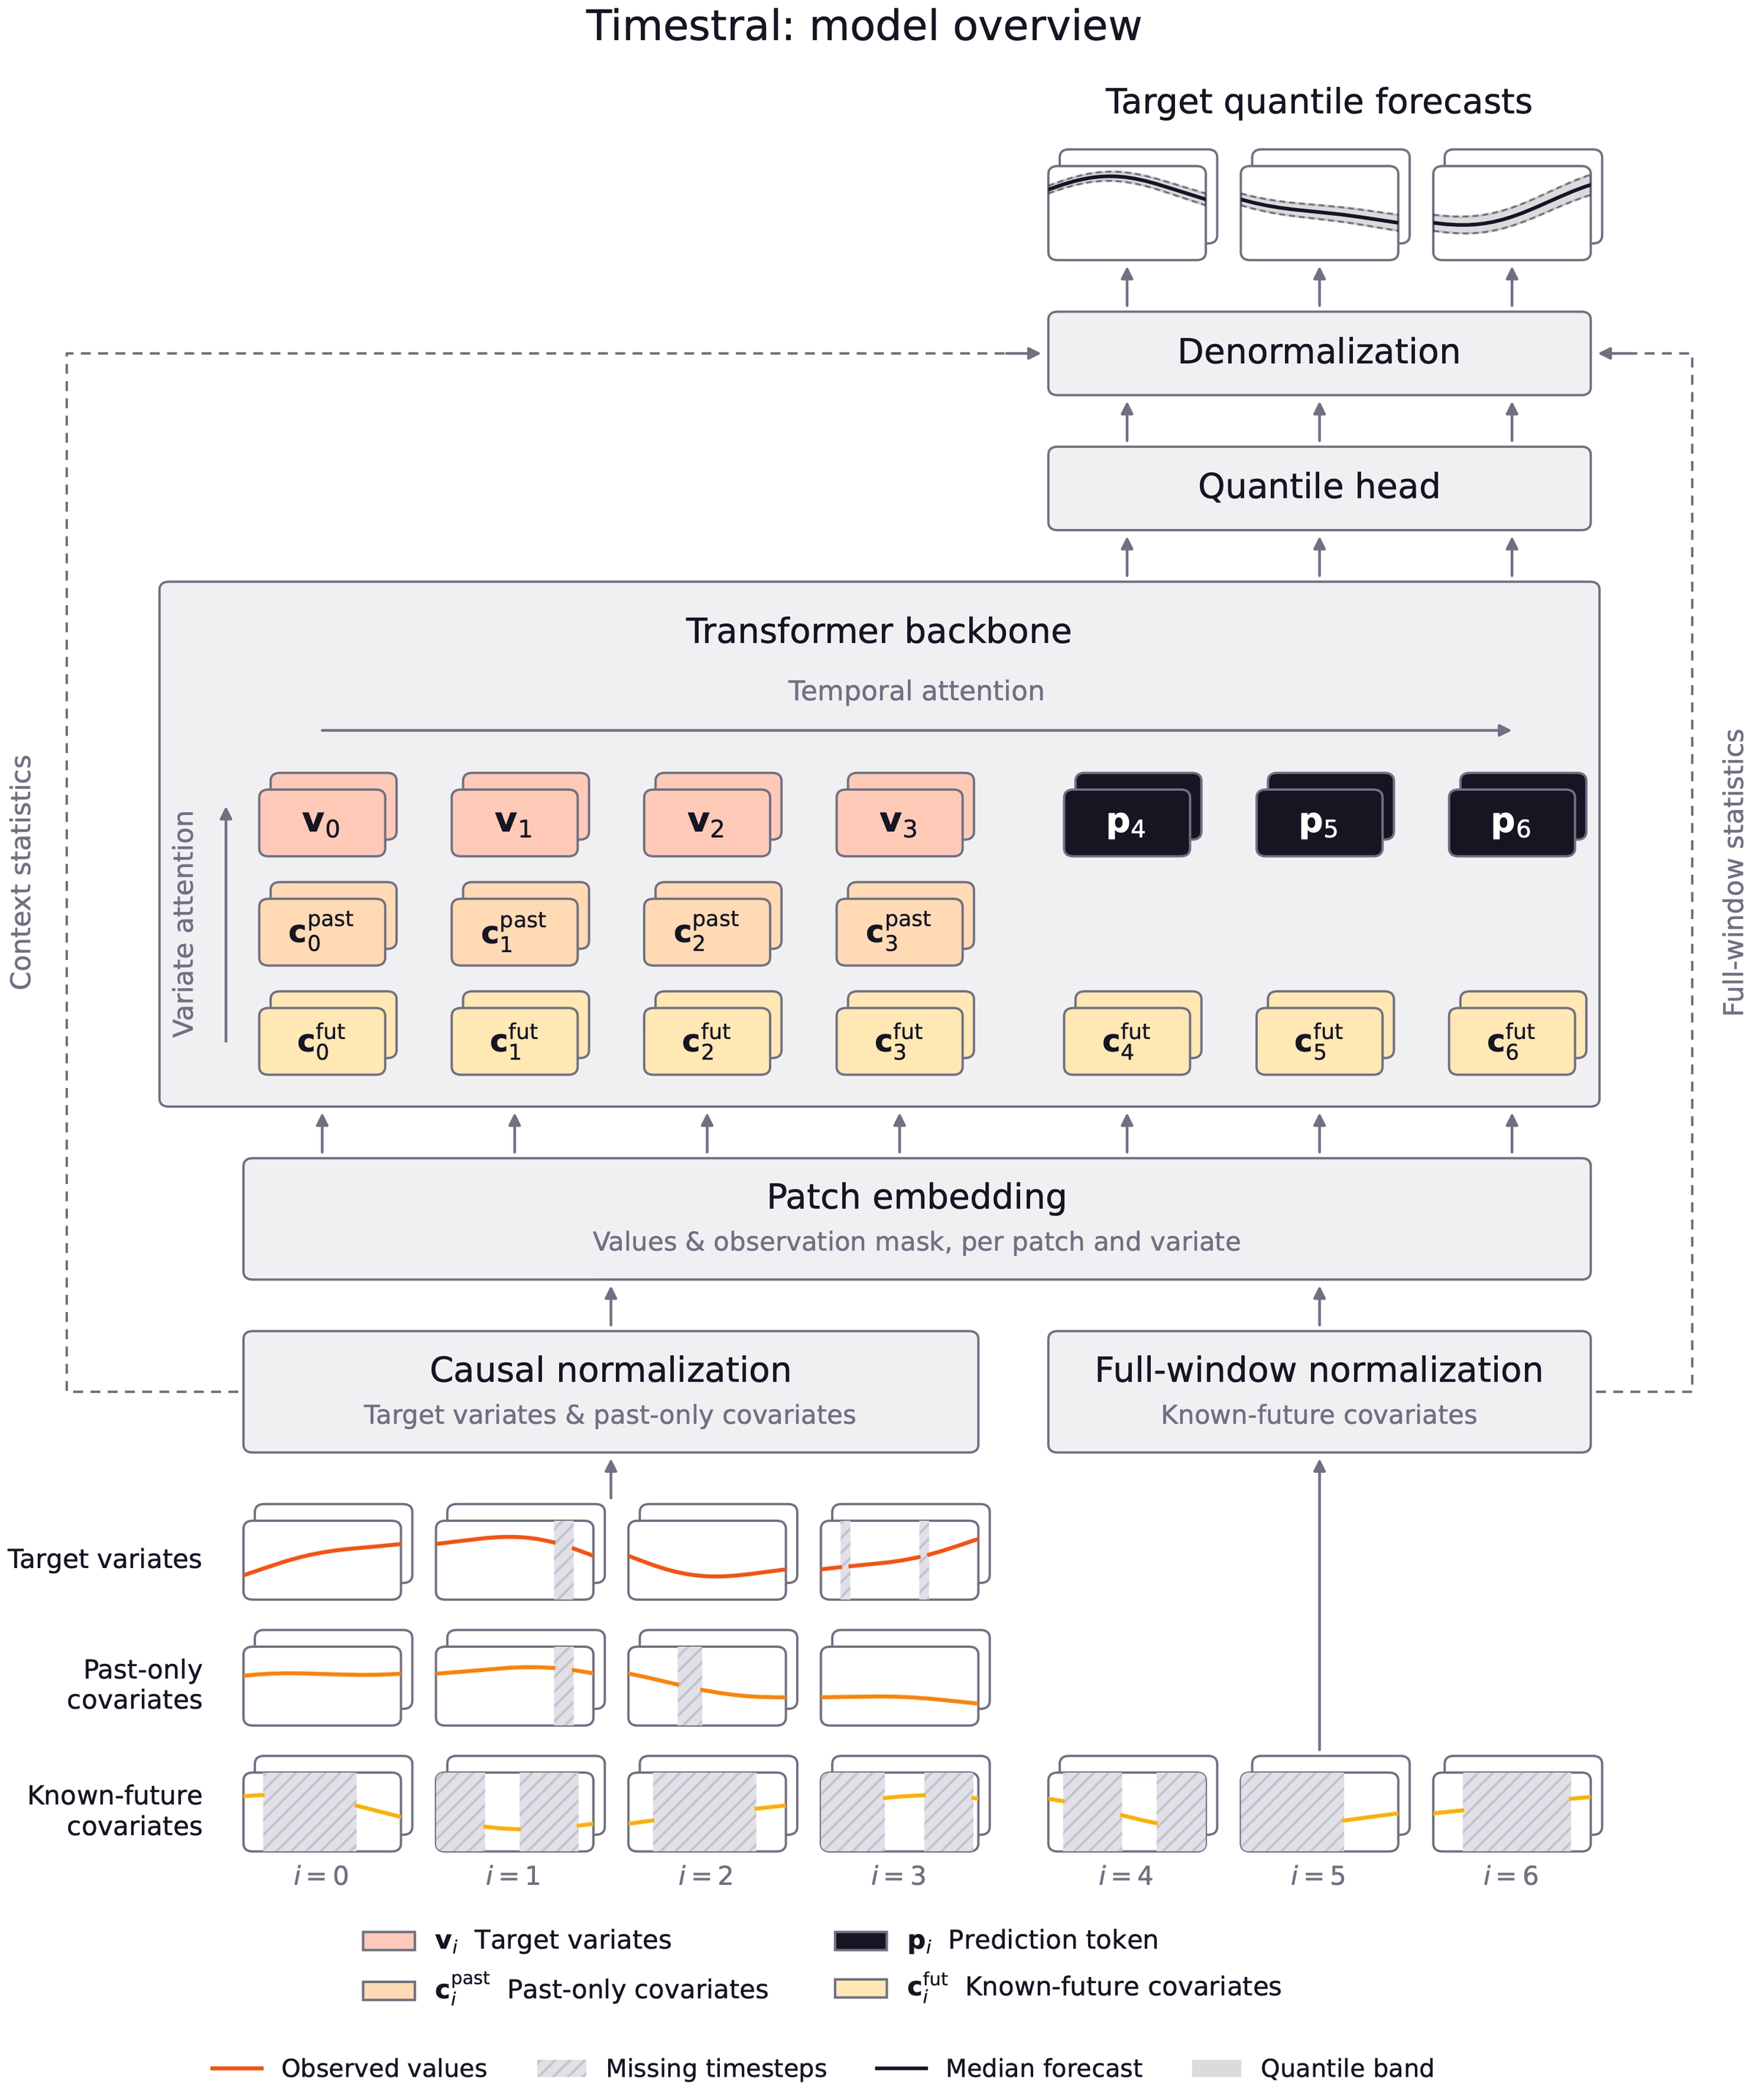
Decoupled Horizon Forecasting. Причинные декодеры, обученные с маскированием контигуозных патчей, как в Toto 2.0 и TimesFM-3, маскируют значения для прогноза, так что они выглядят как пропущенные значения и также теряются как контекст для более поздних прогнозов. Подход DHF разделяет их: полная история остаётся в последовательности, а выученные токены прогноза читают историю перед ними. Каждое наблюдаемое значение служит как целевым, так и контекстом, истинные пропуски остаются помеченными как пропущенные, и длины горизонта обучения и аугментация недостающих данных могут быть настроены независимо друг от друга.
Covariate-aware attention. Каждому входному ряду назначена роль: целевая вариата, коваригата только прошлого или известная будущая коваригата. Известные будущие ковариаты видны по всему окну, пока цели остаются причинными, и информация течёт только от ковариат к целям. Timestral может использовать праздничный календарь или прогноз погоды без утечки собственного будущего цели в её прогноз.
Synthetic-first data. Большинство обучающих данных были синтетическими. Сначала генерировались одномерные процессы с согласованной временной динамикой, включая тренды, сезонность и разнообразные паттерны шума. Затем многомерный синтезатор использовался для конструирования многомерных рядов путём введения нелинейных зависимостей между этими процессами.
Two-stage training. Timestral сначала предварительно обучается в масштабе чисто на синтетических данных с размером контекста 8192, затем пост-обучается на смеси реальных и синтетических данных с контекстом в 4 раза дольше. Целевая функция — pinball loss для 21 квантиля, дискретная аппроксимация CRPS.
Модель, которая может быть адаптирована
Публичные бенчмарки измеряют общую производительность, но production-данные могут значительно отличаться по поведению и структуре. Они также могут дрейфовать со временем, когда рынки меняют режимы, оборудование деградирует и паттерны спроса смещаются. Длительная ценность заключается в способности адаптировать модель к in-domain-данным и продолжать переобучать её по мере смещения распределения.
Для организаций, которые хотят пойти дальше, Timestral доступна через Mistral Forge — тот же pipeline обучения, который используется для языковых моделей. Он поддерживает:
Нулевой прогноз из коробки.
Архитектурные расширения, такие как специфичные для домена ковариаты.
Fine-tuning на proprietary-данных, специализация на домене при сохранении общей производительности.
Контроль над обучающими данными, включая коррекцию обучающей смеси, переигрывание данных предварительного обучения и генерирование синтетических выборок данных для отражения целевого домена. Полный контроль над данными гарантирует, что ничего из того, что мы тестировали, не было видно во время предварительного обучения.
Полный pipeline может быть развёрнут на hardware клиентов, включая air-gapped окружения.
Что дальше
Опубликован GitHub-репозиторий, так что можно запустить Timestral на собственных данных. Технический отчёт с полными результатами последует позже. Для более специализированных задач прогнозирования или сотрудничества в исследованиях можно связаться с командой.
Timestral |
|
|---|---|
Тип |
Foundation-модель временных рядов (TSFM) |
Параметры |
5M, 28M, 123M и 209M |
Длина контекста |
32 768 временных шагов |
Выход |
Вероятностные прогнозы, 21 квантиль |
Входы |
Мультивариантные целевые переменные, ковариаты только прошлого и известные будущие ковариаты |
Развёртывание |
On-prem, VPC или air-gapped |
Лицензия |
Modified MIT |