Что такое модели решений
Strands Decider относится к новому классу моделей принятия решений (decision models), также известных как система-один модели. Этот тип моделей, получивший значительное внимание после запуска TypeSafe AI Jev, отличается от традиционных LLM принципиально иным подходом.
Вместо генерации произвольного текста, модели решений выбирают между предложенными вариантами ответов — например, отвечают на вопрос вроде «Фраза 'включить свет' относится к кофемашине? Да или нет» или определяют язык («Какой язык: английский, зулу или голландский?»). Они также могут присваивать простые числовые оценки — скажем, оценить тональность фразы по шкале от 0 до 1.
Такая специализация имеет преимущества: модели решений работают быстрее, более способны при одинаковом размере, всегда выдают ответ из доступных вариантов и требуют минимальные задержки при выполнении.
Цена такого подхода — параллельная обработка всех вариантов делает модели хуже на сложных задачах, требующих рассуждений. Невозможность генерировать текст исключает использование для программирования, чатботов, суммирования документов и других типичных LLM задач.
Зато модели решений предоставляют высококачественные оценки надёжности каждого решения — метрику доверия, недоступную через API frontier LLM. Они позволяют эффективно задавать множество вопросов об одном и том же контексте. Это делает их идеальными для агентных воркфлоу, которые разработчики строят с использованием SDK Strands Harness и недавно запущенного Strands harness.
Архитектура модели
Основная идея проста: берётся предварительно обученное LLM ядро (Qwen3.5-2B), затем удаляется LM head, отрезая возможность генерировать текст. На его место устанавливается pointer head, который оценивает скрытое состояние на каждой позиции варианта ответа относительно скрытого состояния в позиции <answer>. Это ядро всего более миллиона параметров. Основная модель дообучается с помощью LoRA адаптера ранга 16.
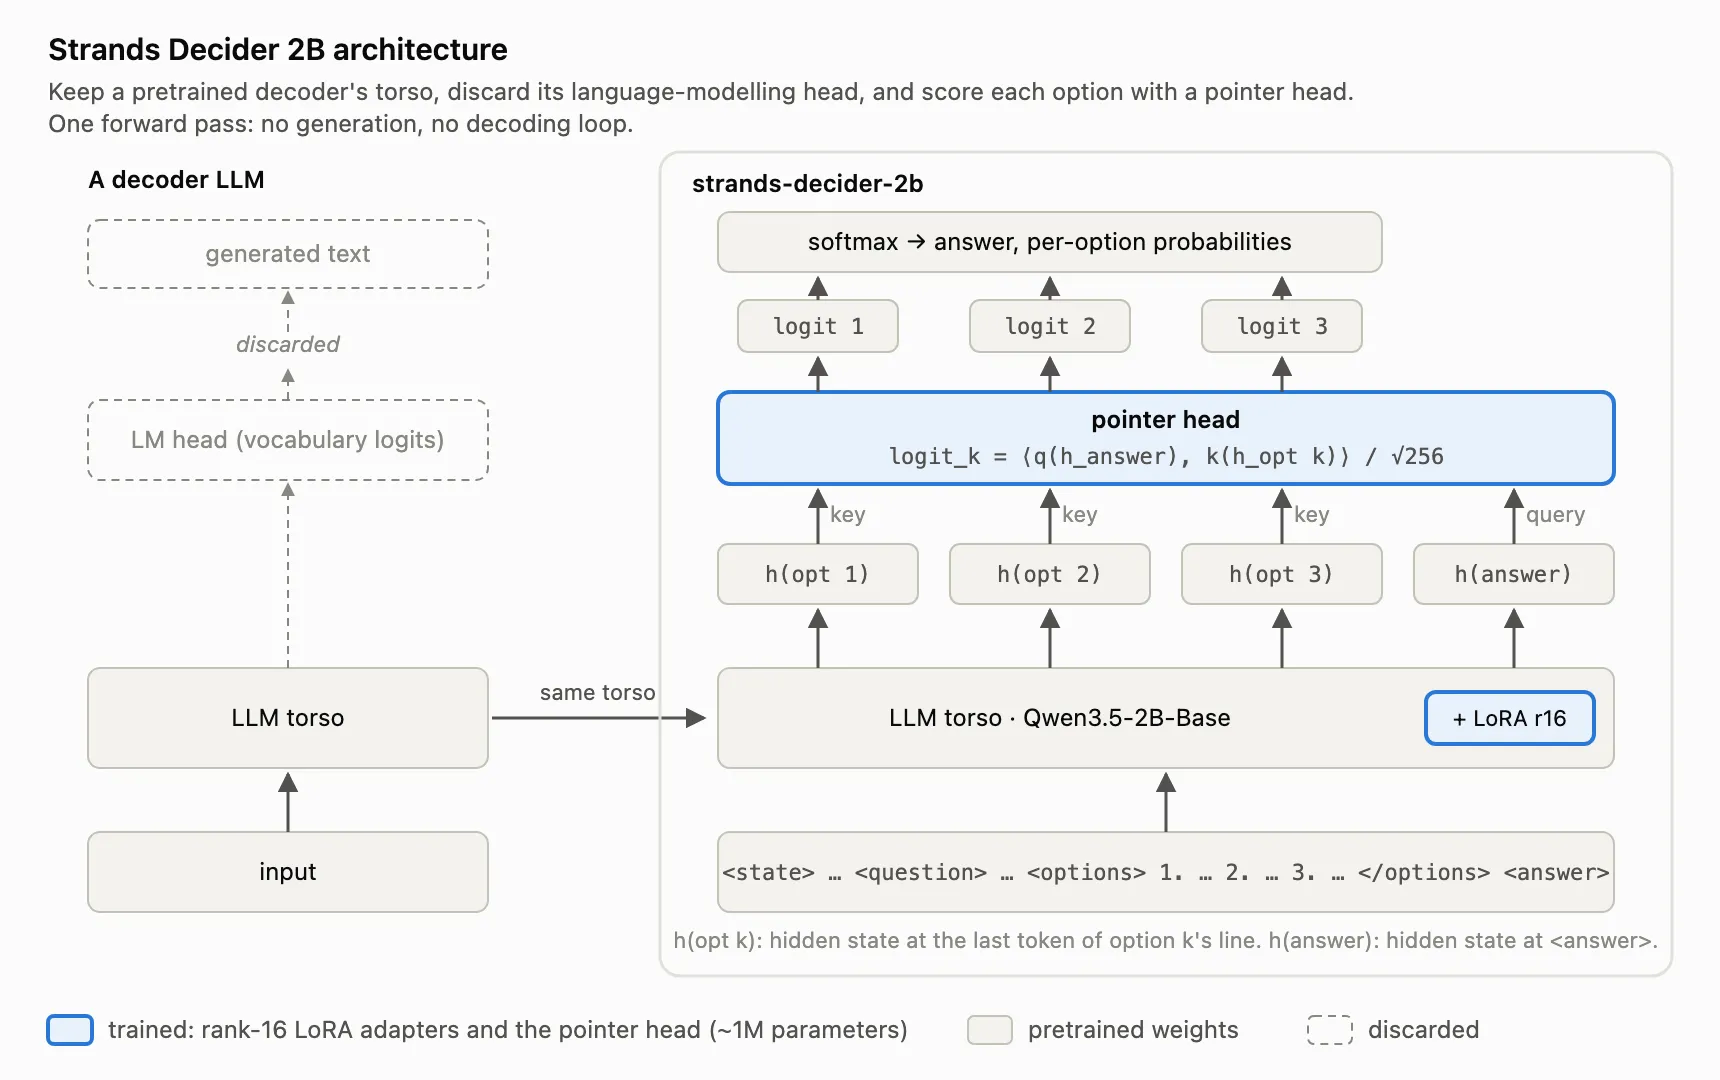
Рис. 1: Архитектура Strands Decider 2B
В репозитории видно, что это вторая крупная итерация архитектуры. Первая была похожа, но использовала slot head, который показал значительно худшие результаты. Выпускаемая сейчас модель — это версия 19, результат множества итераций под капотом. Каждое изменение между версиями задокументировано в репозитории, можно проследить всю проделанную работу.
Как работает производительность
Для моделей этого класса интересуют три метрики: точность (как хорошо модель отвечает на вопросы), калибровка (насколько надёжны её оценки уверенности) и задержка (как быстро принимаются решения). Первые две измеряются совместно: точность на публичном наборе JevBench и калибровка через Brier score на том же наборе. strands-decider-2b показывает хорошие результаты в обоих метриках — 3-е место из 33 в классе 2B, и 1-е из 30 исключая модели чуть больше 2B. По мере совершенствования архитектуры оценки улучшаются, и есть множество идей для будущих улучшений.
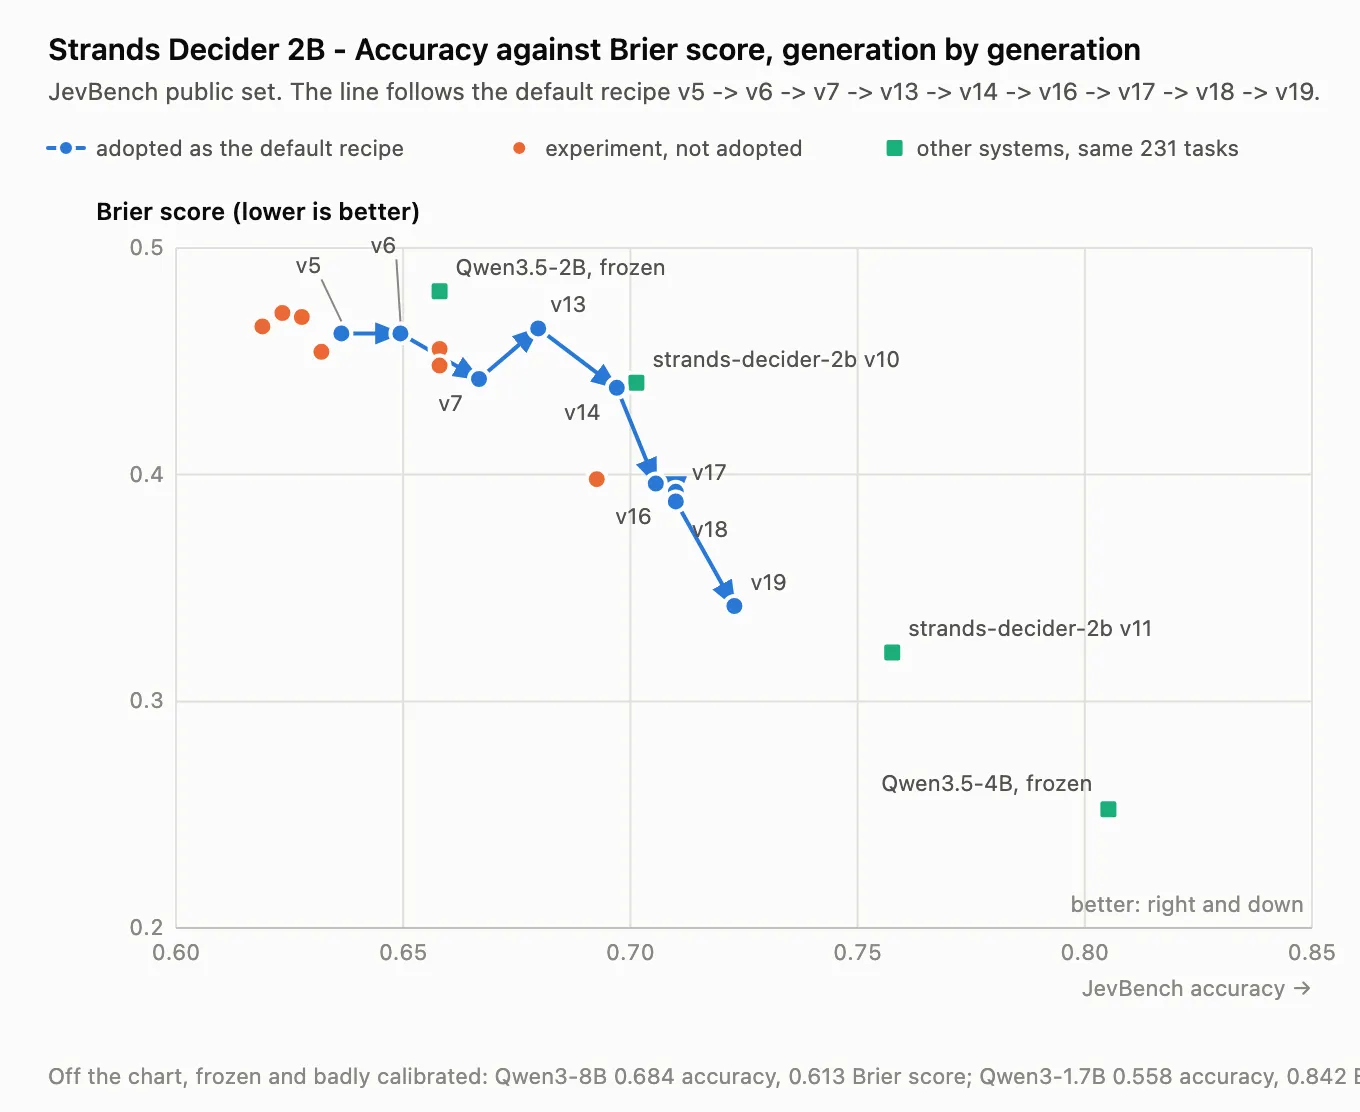
Рис. 2: Точность и калибровка (Brier score) на траектории обучения. По мере эволюции архитектуры через версии оба показателя улучшались на публичном наборе JevBench
По задержкам strands-decider-2b принимает локальные решения с медианой около 115 мс на широко доступном оборудовании. Время зависит от размера задачи, приблизительно линейно растёт с увеличением размера. Результаты на графике получены на локальном Nvidia RTX3090, но на MacBook M3 производительность ненамного хуже — медианная задержка для малых задач около 153 мс. Как и в точности с калибровкой, есть множество идей для улучшений, особенно в снижении базовой задержки.
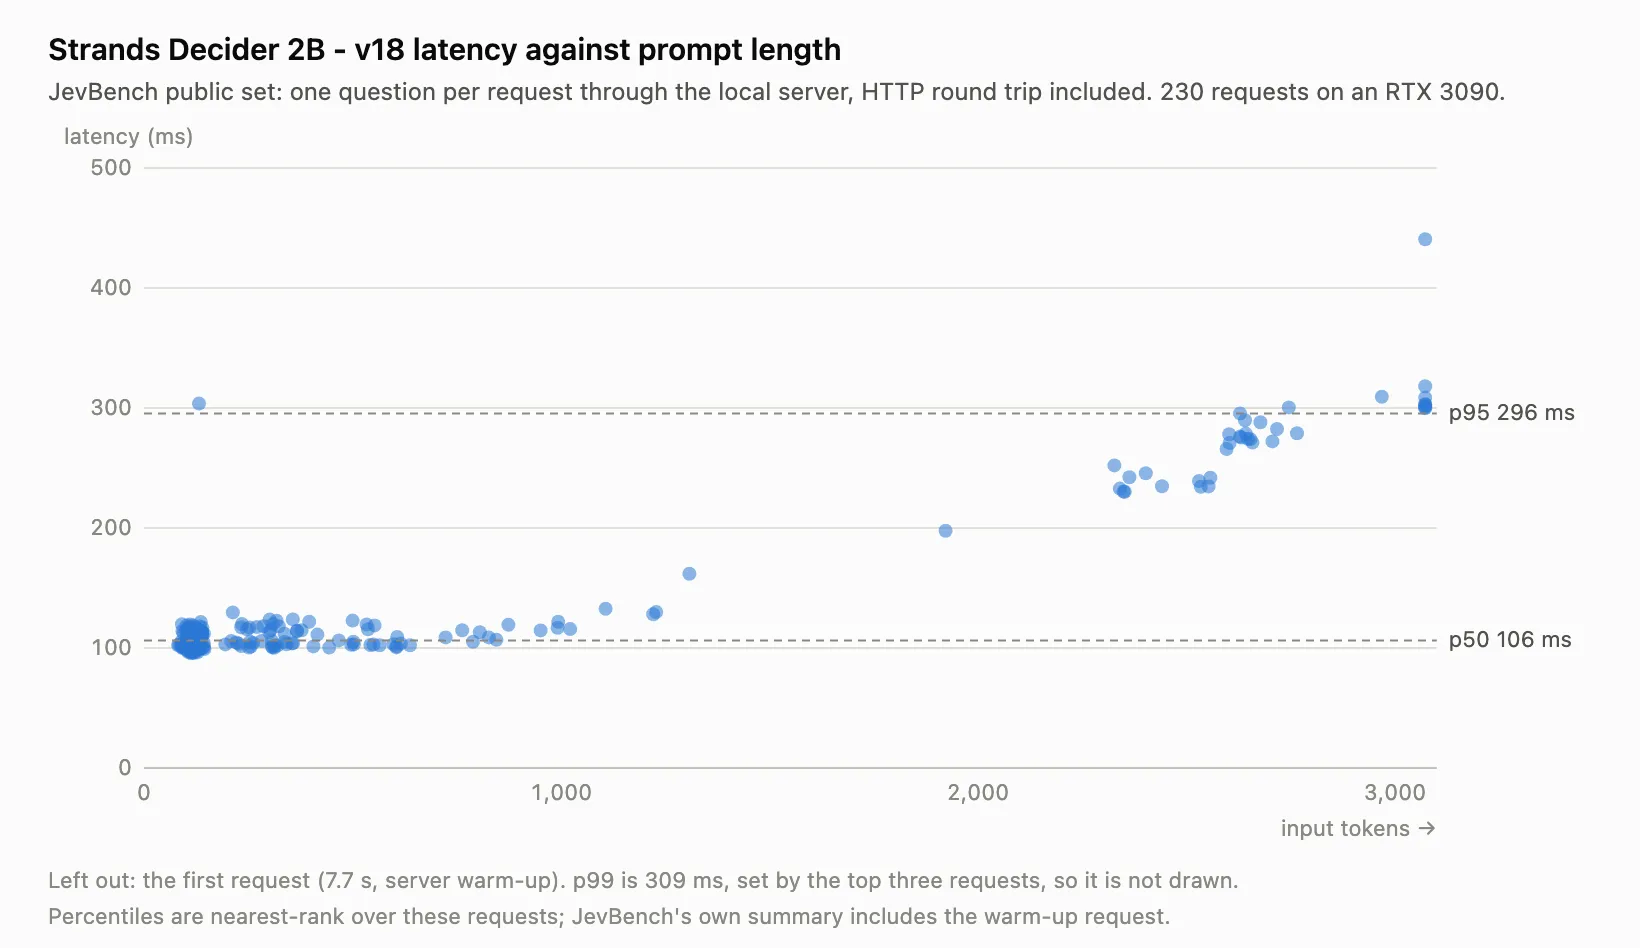
Рис. 3: Задержка решения как функция размера задачи (в токенах), измеренная на локальном Nvidia RTX 3090 на версии 18 модели. Задержка растёт приблизительно линейно с размером задачи
Почему именно 2B
Выбор именно такого размера обусловлен двумя причинами. Первая — это побуждение к экспериментам. Возможно использовать и даже переобучать strands-decider-2b на уже имеющемся оборудовании. Это делает попытки лёгкими, быстрыми и малорискованными. Вторая причина — два миллиарда параметров оказываются золотой серединой: достаточно мало для экспериментов, но достаточно для выполнения значимой работы. Strands decider правильно решает 100% простых задач на JevBench, и этот тип проблем хорошо коррелирует с лёгкими задачами, с которыми разработчики работают в агентах.
Для чего можно использовать Strands Decider
Практически для всего. Серьёзно, уже видны ранние успехи применения этого класса моделей для маршрутизации между моделями, выбора инструментов, оценок, защитных механизмов, управления памятью, контекстом и классификации политик. Тоже видна интересная инновация в построении гибридных агентов — используются LLM для самых сложных решений и модели decider для более простых рутинных решений, снижая стоимость и задержку. Есть эксперименты по комбинированию моделей decider с фиксированными языками воркфлоу для построения другого вида гибридного воркфлоу. Люди используют такие модели для игр, автоматизации задач, навигации в лабиринтах и многого другого. Скорость инноваций в этом пространстве поражает.
Первые шаги
Самый простой способ начать — через CLI strands-decider:
pip install strands-deciderВопрос с выбором
Модели можно задать вопрос, чтобы она выбрала вариант на основе состояния и вопроса:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail"
Пример результата:
choice_0 -> billing (confidence 0.768)
  billing                  0.845
  retail                   0.091
  sales                    0.064
В этом результате видно, что модель предсказывает billing как ответ с наивысшей вероятностью.
Репозиторий также содержит примеры использования strands-decider-2b внутри агента Strands в папке examples/strands/. Сам агент работает локально, подключается к локальной версии Strands decider и использует LLM по умолчанию из Amazon Bedrock.
Это умышленно небольшой сценарий. Агент имеет (обязательный в демо) инструмент get_weather и системный промпт, который делает его намеренно активным, так что когда пользователь спрашивает «Какая погода?» без указания места, агент угадывает город и всё равно вызывает инструмент. Но перед этим вызовом strands-decider-2b читает разговор и предложенный вызов инструмента, отвечая на два вопроса да/нет: основаны ли значения аргументов на чём-то, что пользователь на самом деле сказал (спойлер: нет!), и не слишком ли рано вызывать этот инструмент сейчас? Несколько строк Python превращают предсказания в решение, и агент возвращается, чтобы спросить, какой город имелось в виду, вместо того чтобы уверенно сообщать погоду в никому не нужном месте.
QUESTIONS = {
    "args_grounded": Decider.noul(
        "Are the tool's argument values grounded in facts the user actually provided?",
        {
            "true": "every argument value traces back to something the user said",
            "false": "an argument value was guessed or invented, not stated by the user",
        },
    ),
    "premature": Decider.noul(
        "Is it premature to call this tool now, before clarifying with the user?",
        {
            "true": "the assistant should ask a clarifying question before calling the tool",
            "false": "there is nothing left to clarify; calling now is appropriate",
        },
    ),
}
Этот паттерн — система интервенций Strands. Используется InterventionHandler с методом before_tool_call, передаётся в Agent(interventions=[...]), и он работает перед любым выполнением инструмента. Возвращаемое действие типизировано: Proceed, Deny, Confirm (остановить и спросить человека) или Guide, который возвращает модели её очередь с обратной связью вместо полной блокировки вызова. Этот существующий обработчик — класс Python, и Strands не навязывает мнение о том, что внутри него, так что один и тот же паттерн работает, вызываем ли модель решений, Cedar политику или другого агента. (Есть эквивалентные хуки вокруг вызова модели и всего вызова целиком.) Этот пример — иллюстрация, а не рекомендация, так что вопросы, порог и политика выбирались вручную. Суть в том, что решение такой дешевой цены может находиться в пути, где LLM вызов никогда не мог бы.
Команда Strands работает над библиотеками для интеграции моделей решений, следите за обновлениями в репозитории.
Заключение
Можно скачать, использовать или дорабатывать strands-decider-2b уже сегодня. Все данные доступны, как и всё необходимое для начала работы. Код можно взять на GitHub, а последние снимки на Hugging Face. Пора начинать экспериментировать!