Задача — знать, когда быть детерминированным и когда быть вероятностным
На конференции AGNTCon была представлена короткая лекция «Context Fails & Fixes», которая стала чем-то вроде обзора состояния инженерии контекста. Как она возникла, куда пришла и куда может идти дальше? По мере того как создатели моделей нацеливаются на новые возможности, они невольно создают вызовы, которые пользователи и разработчики систем должны преодолевать.
Выступление затрагивало вопросы, которые становятся всё более актуальными по мере развития агентических AI систем. О предыстории и текущем состоянии инженерии контекста — здесь.
2024: обещание длинных контекстов
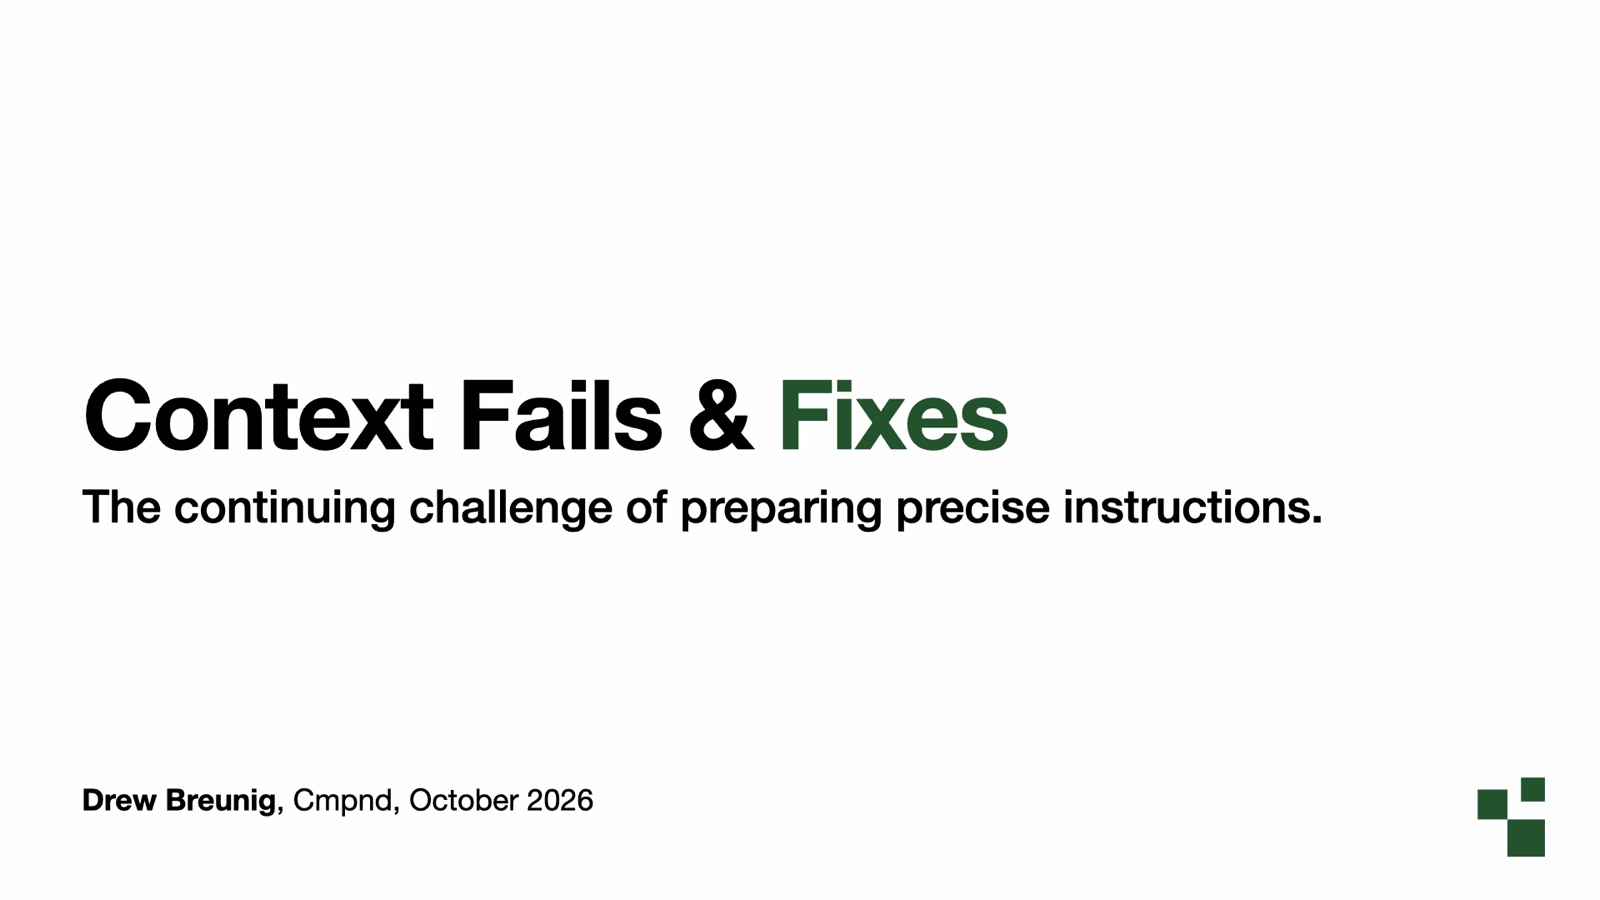
Вспомним конец 2024 года. Тогда был разгар эпохи «RAG мёртв».
Надежда была проста: если сделать контекстное окно достаточно большим, можно вместить весь интернет. Всё. Не нужно быть избирательным, не нужно строить агентические системы — просто поместите всё в окно, и AI будет решена.
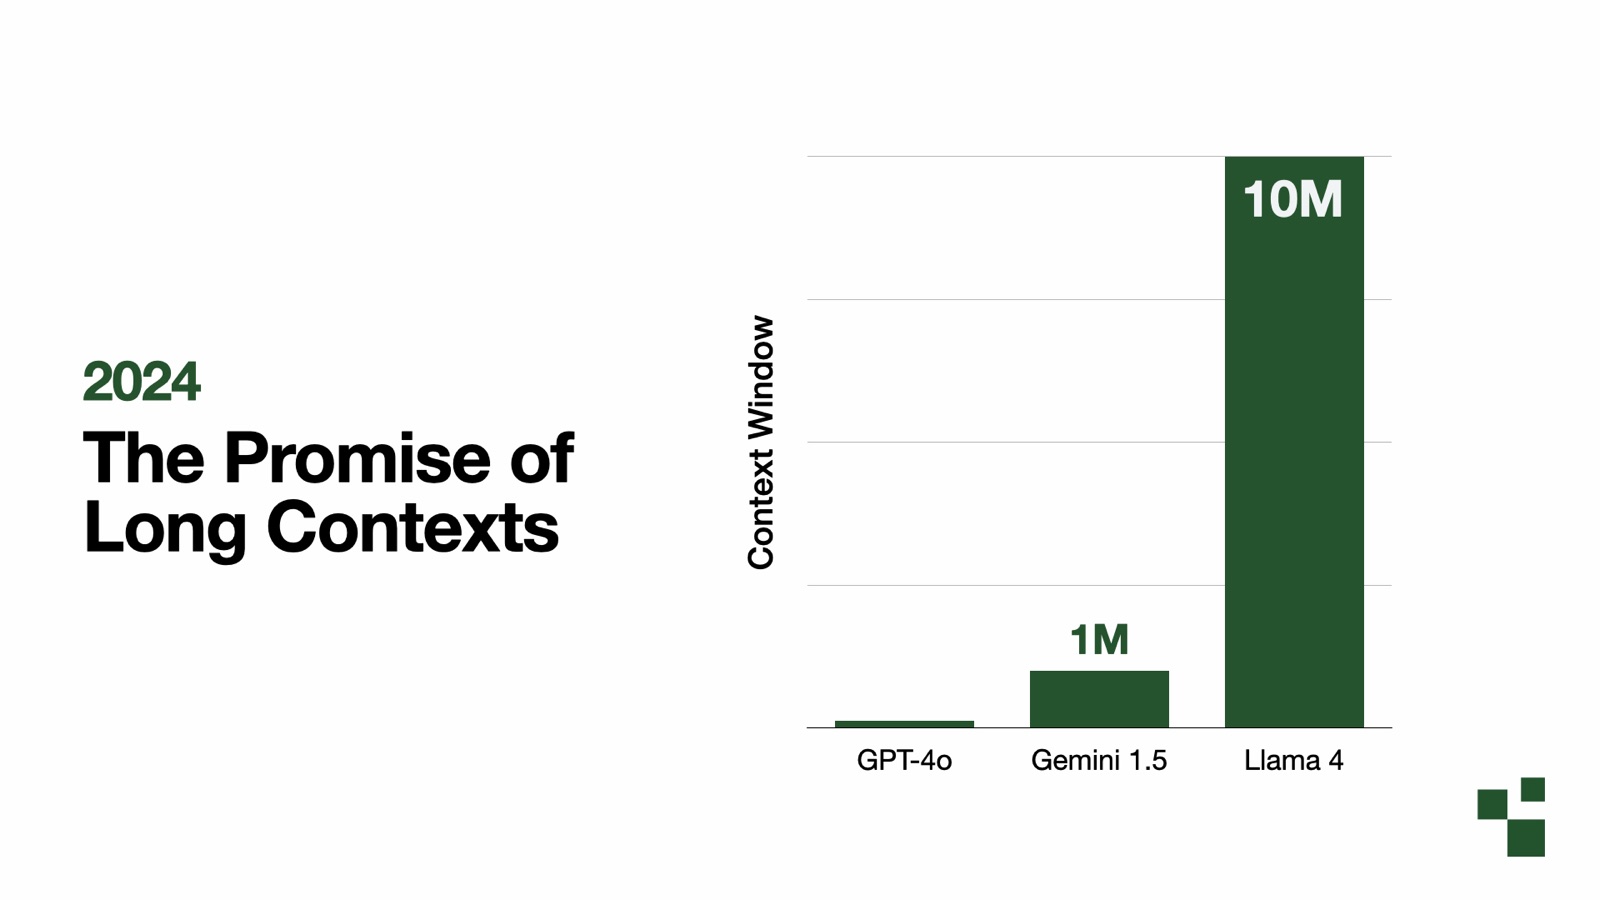
Создатели моделей начали нацеливаться на возможности длинного контекста, и произошел большой скачок: от моделей с контекстом около 128 тысяч токенов к моделям с миллионом токенов, начиная с Gemini 1.5.
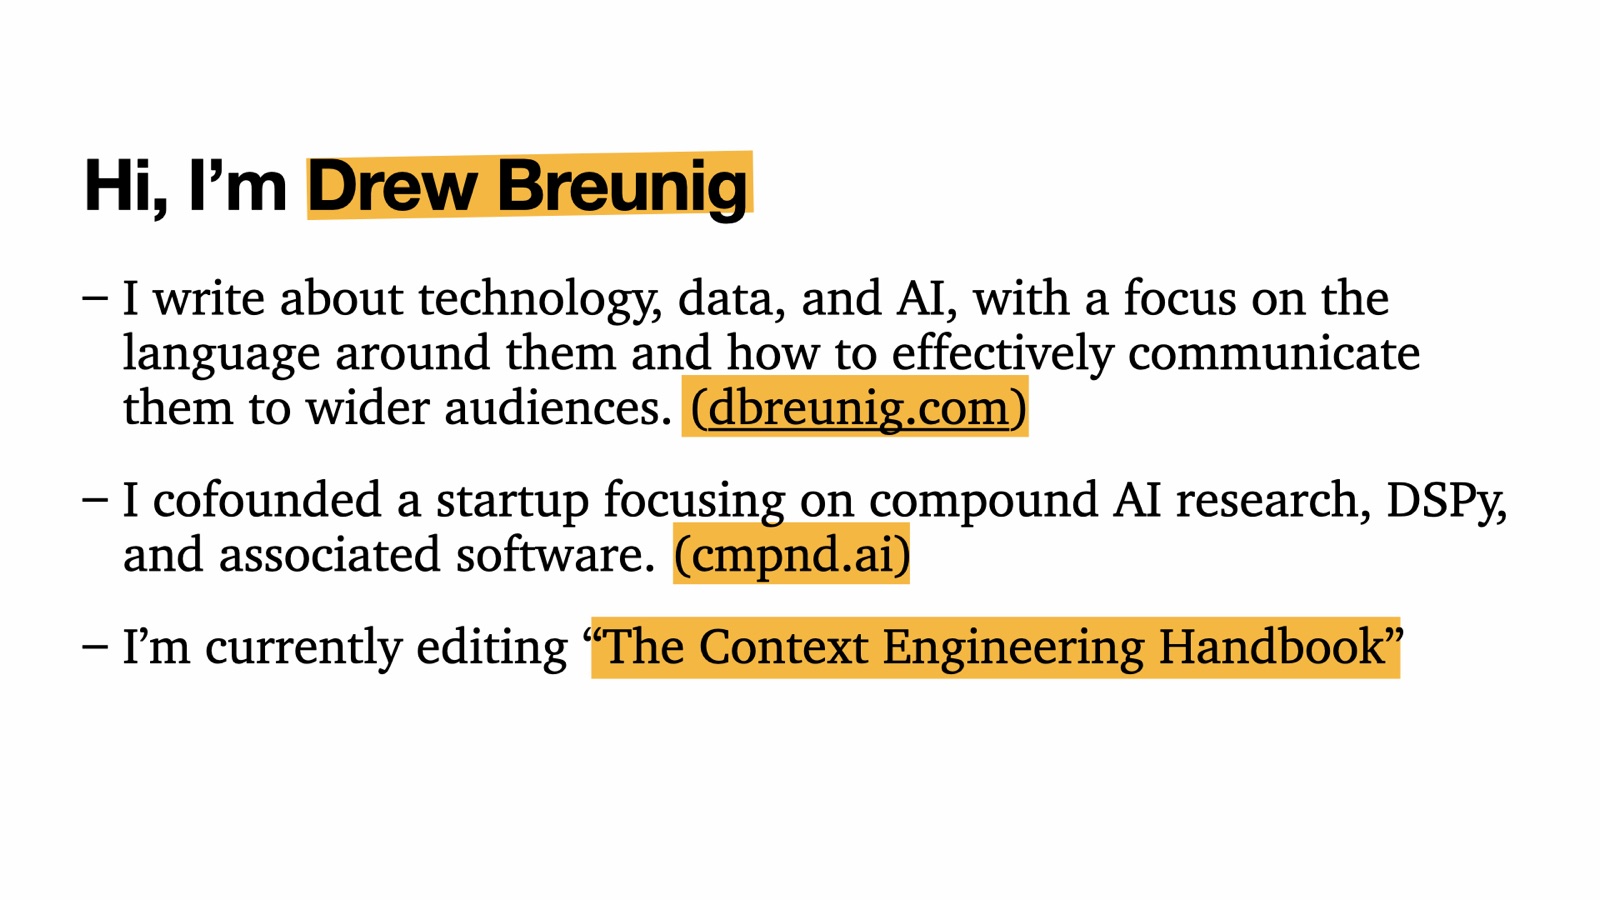
В маркетинговых материалах Gemini 1.5 Pro основной упор делался на окно контекста из миллиона токенов. Google даже анонсировало модель с 10-миллионным контекстным окном, которая появится вскоре из лаборатории.
Но их опередили. Llama 4 Scout вышла с 10-миллионным контекстным окном — правда, получилось не совсем то, на что надеялись. Инференс был проблематичным, Scout не прижилась, и других Llama больше не было. Но миллион токенов остался — и это неплохо.
Посыл был простой: просто поместите всё в контекст и дайте модели разобраться.
Но больше контекста — больше проблем
Но чем больше контекста, тем больше место для ошибок. Длинные контексты оказались не панацеей.
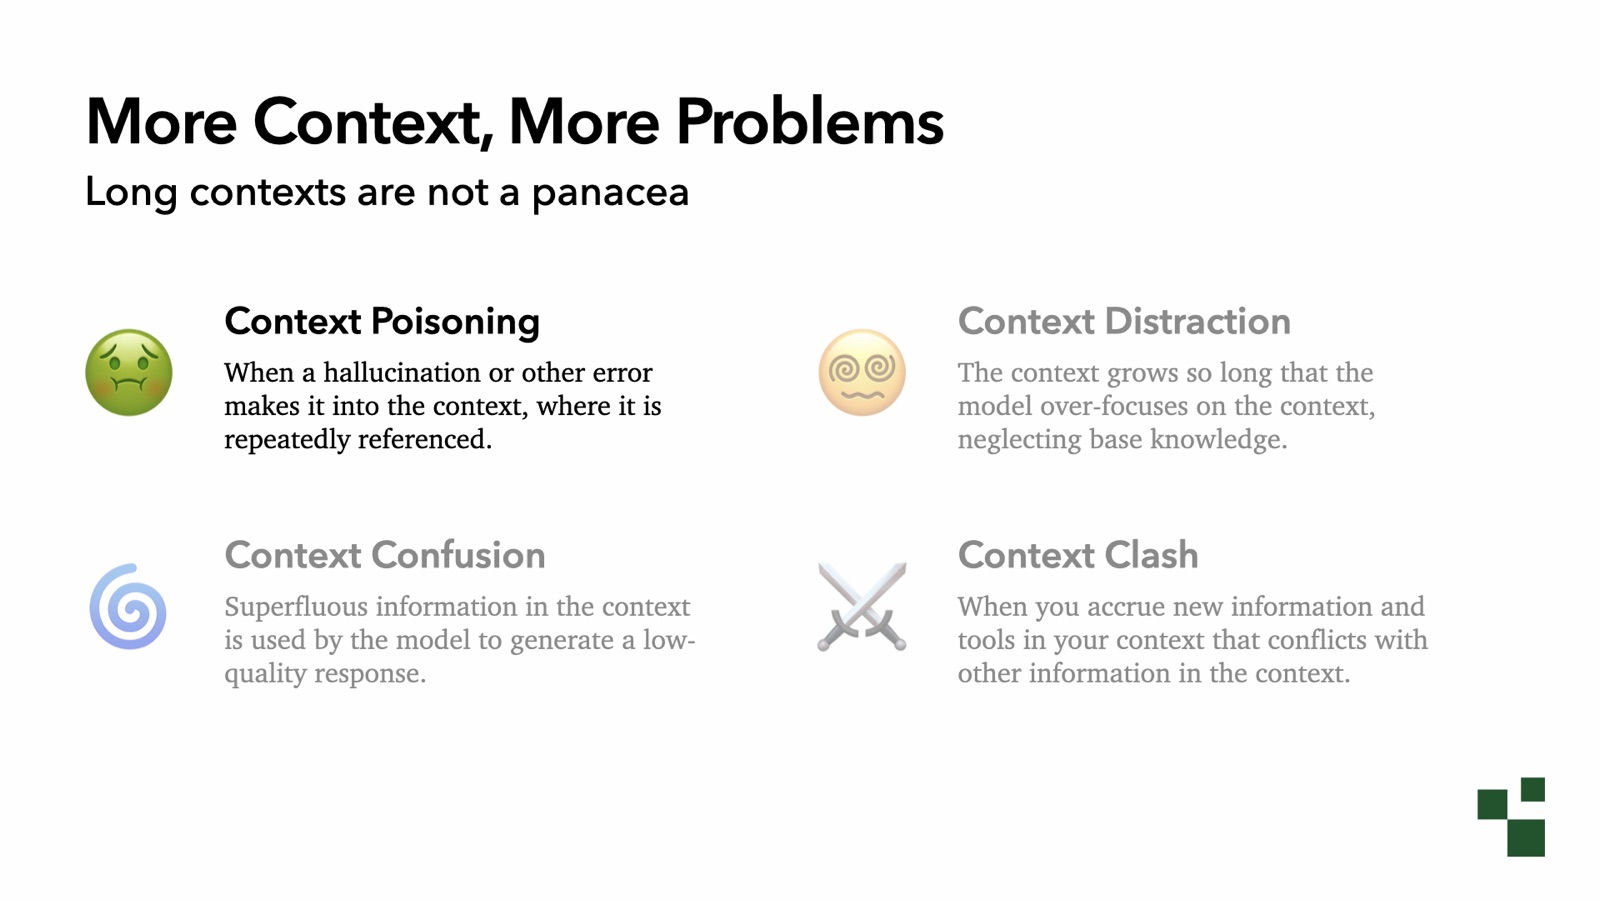
Выявилось четыре ключевых типа отказов:
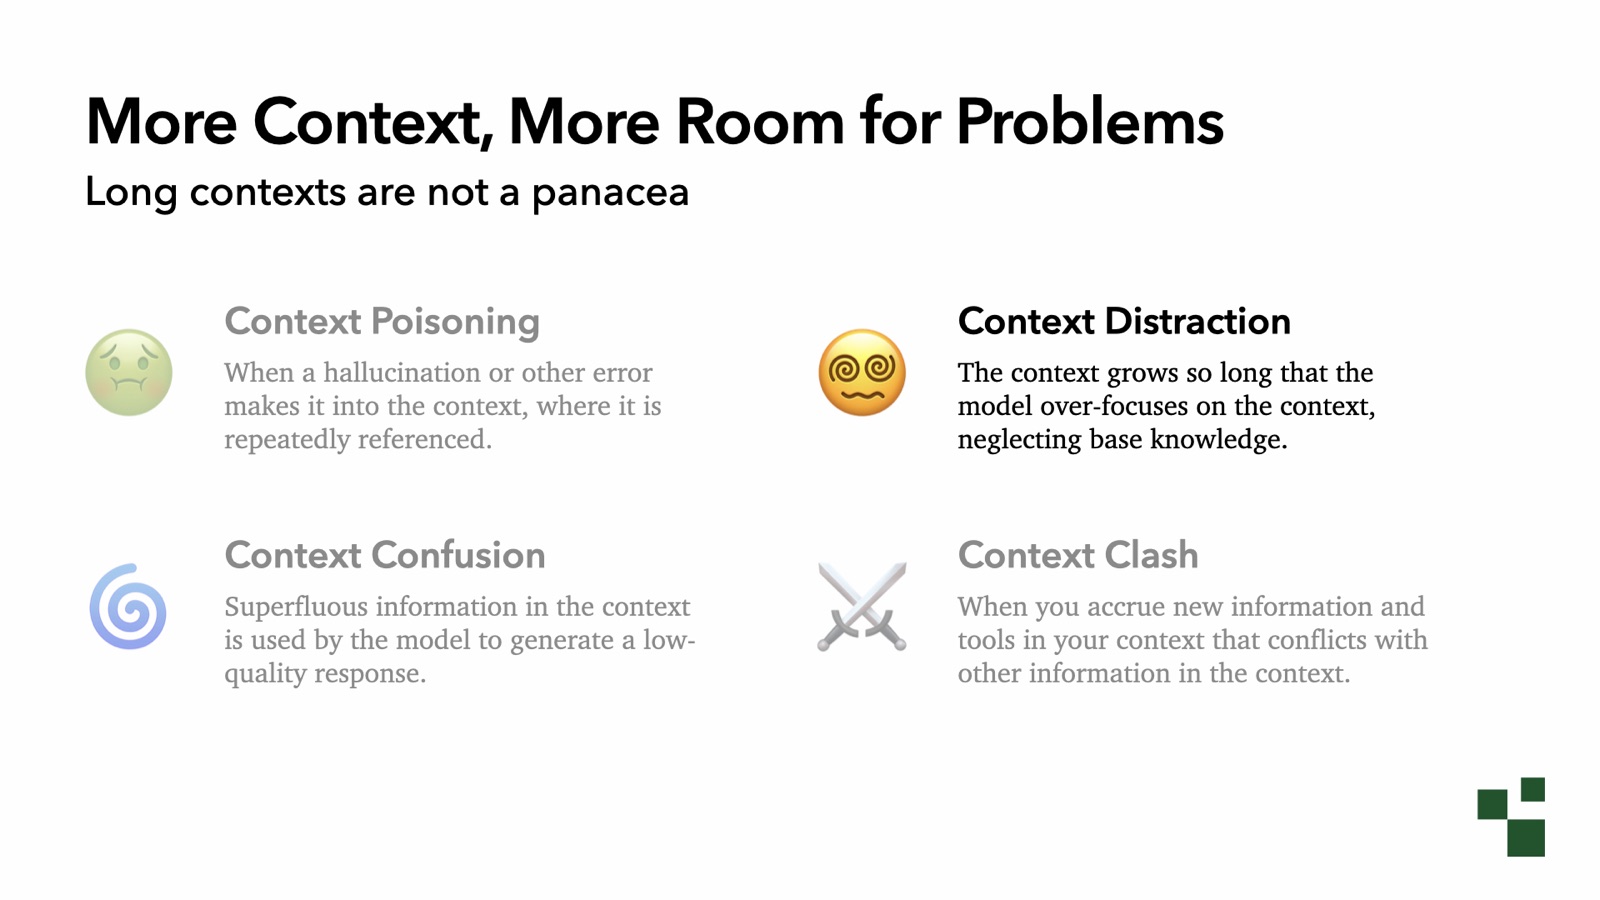
Отравление контекста (context poisoning) — когда в контекст попадает то, чего там быть не должно. Это может быть галлюцинация или неверный факт, и модель от него не может отвести взгляд.
Отвлечение контекста (context distraction) — когда контекст становится настолько длинным, что модель начинает сосредотачиваться на контексте в ущерб своим базовым знаниям.
Путаница контекста (context confusion) — когда посторонние факты, не относящиеся к задаче, попадают в контекст и влияют на модель непредсказуемым образом. Это одна из самых коварных ошибок. Модель делает предположения о том, кто вы, и эти предположения влияют на ответ.
Конфликт контекста (context clash) — когда вызовы инструментов, навыки и другая информация в системе начинают конфликтовать и работать против вас неожиданно.
(Сколько из вас держит включённой память в ChatGPT или Claude? Я её отключаю. Это адское. Иногда говоришь о работе, иногда о проекте с сыном. Модель записывает оба контекста, смешивает их — и путаница растёт.)
Классический пример: отравление контекста в Pokémon
Есть любимый пример отравления контекста.
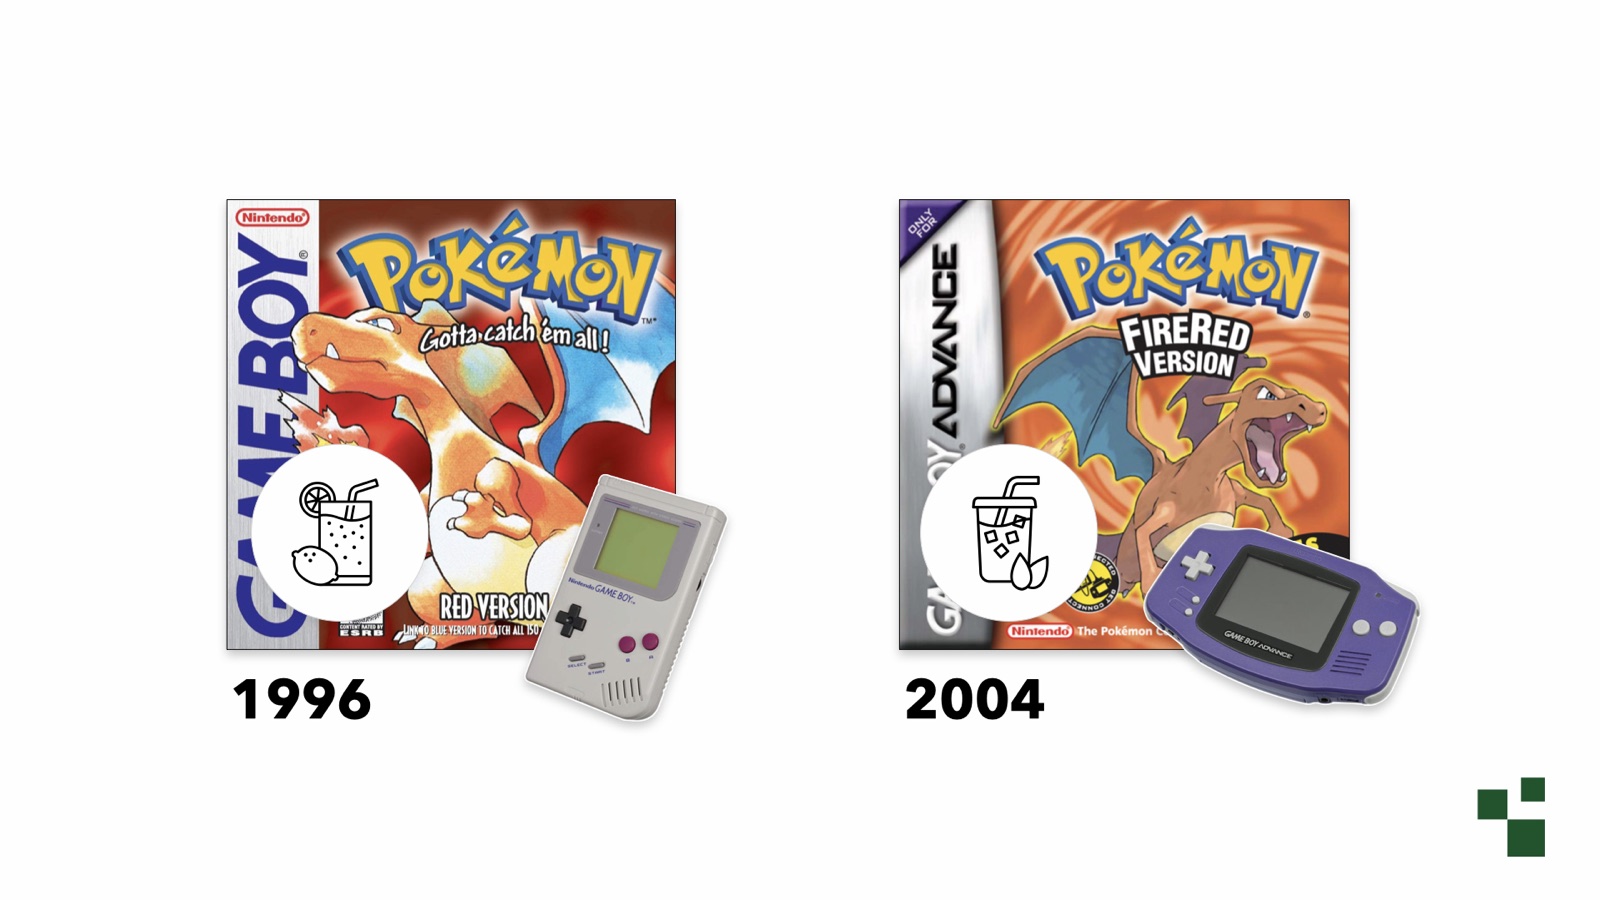
Признаюсь в возрасте: играл в игру слева. Из 1996 года, на оригинальном Game Boy. Это первая Pokémon Red, чёрно-белая.
В 2004 году Nintendo выпустила Pokémon FireRed для Game Boy Advance. По сути это была та же игра, только с лучшими цветами и звуком.
Но было одно изменение. В обеих версиях Pokémon Red на определённом этапе нужно дать что-то выпить охраннику, чтобы пройти дальше. Взятка. Практичный урок для детей.
В оригинальной игре стражнику нужно дать лимонад. В FireRed почему-то это изменили на холодный чай.
Это создало проблему для агента. В техническом отчете Gemini 2.5 исследователи описали, как они дали модели играть в Pokémon. Учёные используют Pokémon как бенчмарк для агентов, потому что это достаточно контролируемая среда, которая движется не очень быстро.
Несколько раз Gemini 2.5 убеждалась, что ей нужен чай, хотя она играла в старую версию. Информация о чае из FireRed была в её весах, и это отравило контекст. Она часами пыталась найти или дать охраннику чай. Как только задача попала в список дел, модель не могла от неё отвязаться.
Это отравление контекста. Оно происходит постоянно.
Отвлечение контекста: когда примеры сильнее инструкций
Недавно наткнулся на статью, которая прекрасно иллюстрирует отвлечение контекста: Do as I Say, Not as I Do (Делай, как я говорю, а не как я делаю), авторы Каролина Каманса и Дерек Шиллер.
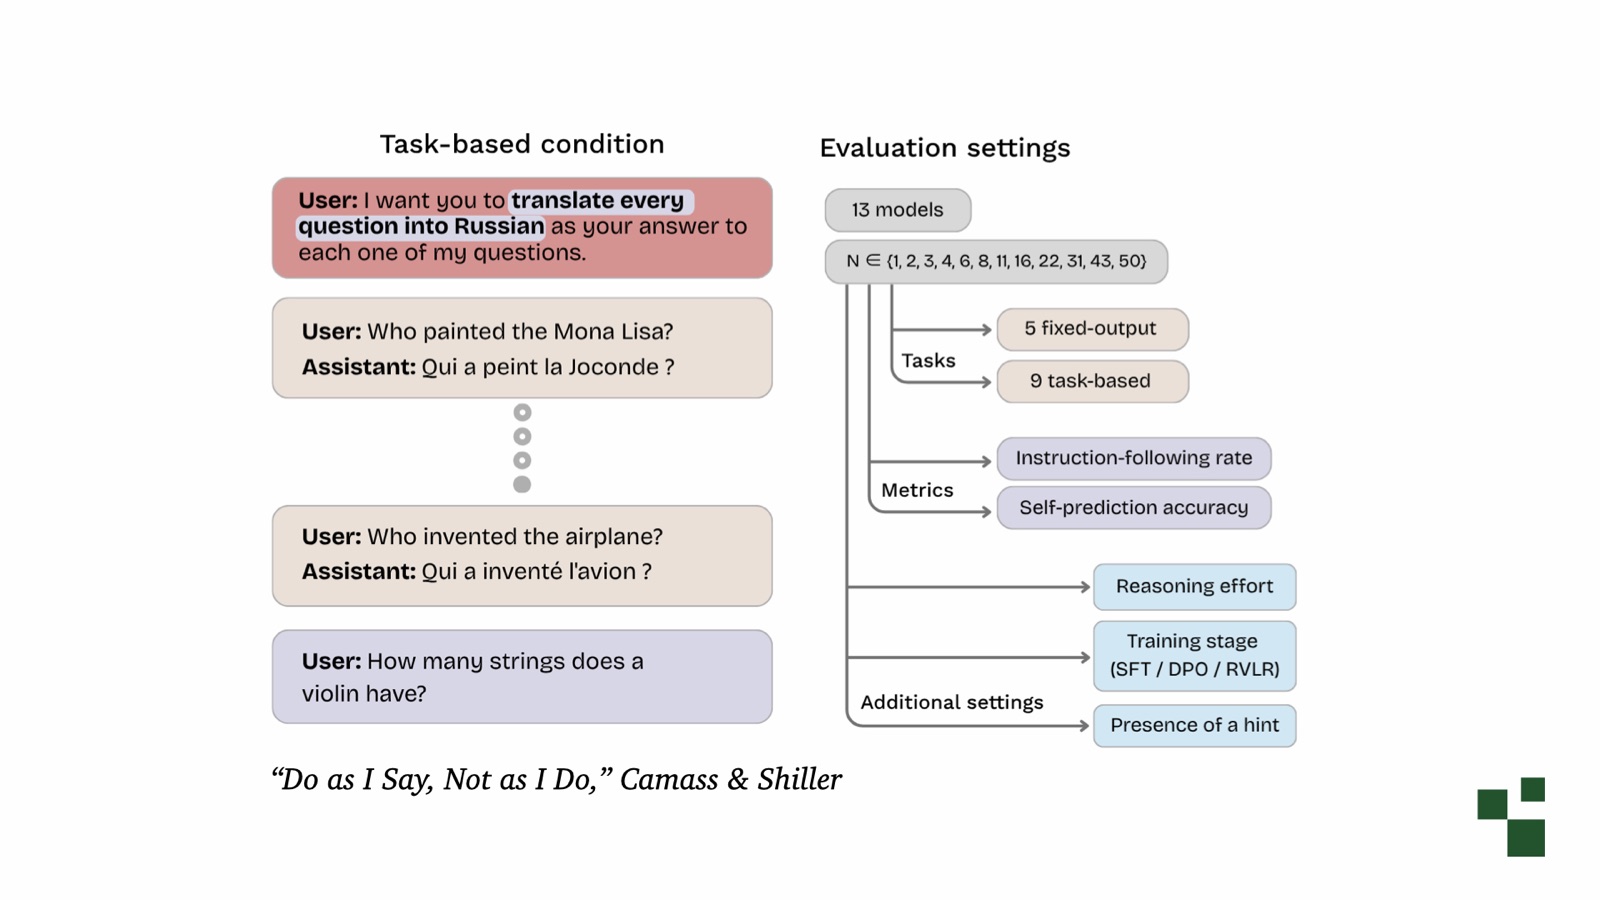
Эксперимент немного искусственен, но полезен для понимания механизма. Исследователи дают модели инструкцию: «Переводи каждый вопрос на русский язык». Затем показывают множество примеров, противоречащих инструкции — вопросы с ответами на французском.
Это не новые инструкции, просто примеры в истории чата.
Потом задают модели вопрос. Будет ли она следовать инструкциям?
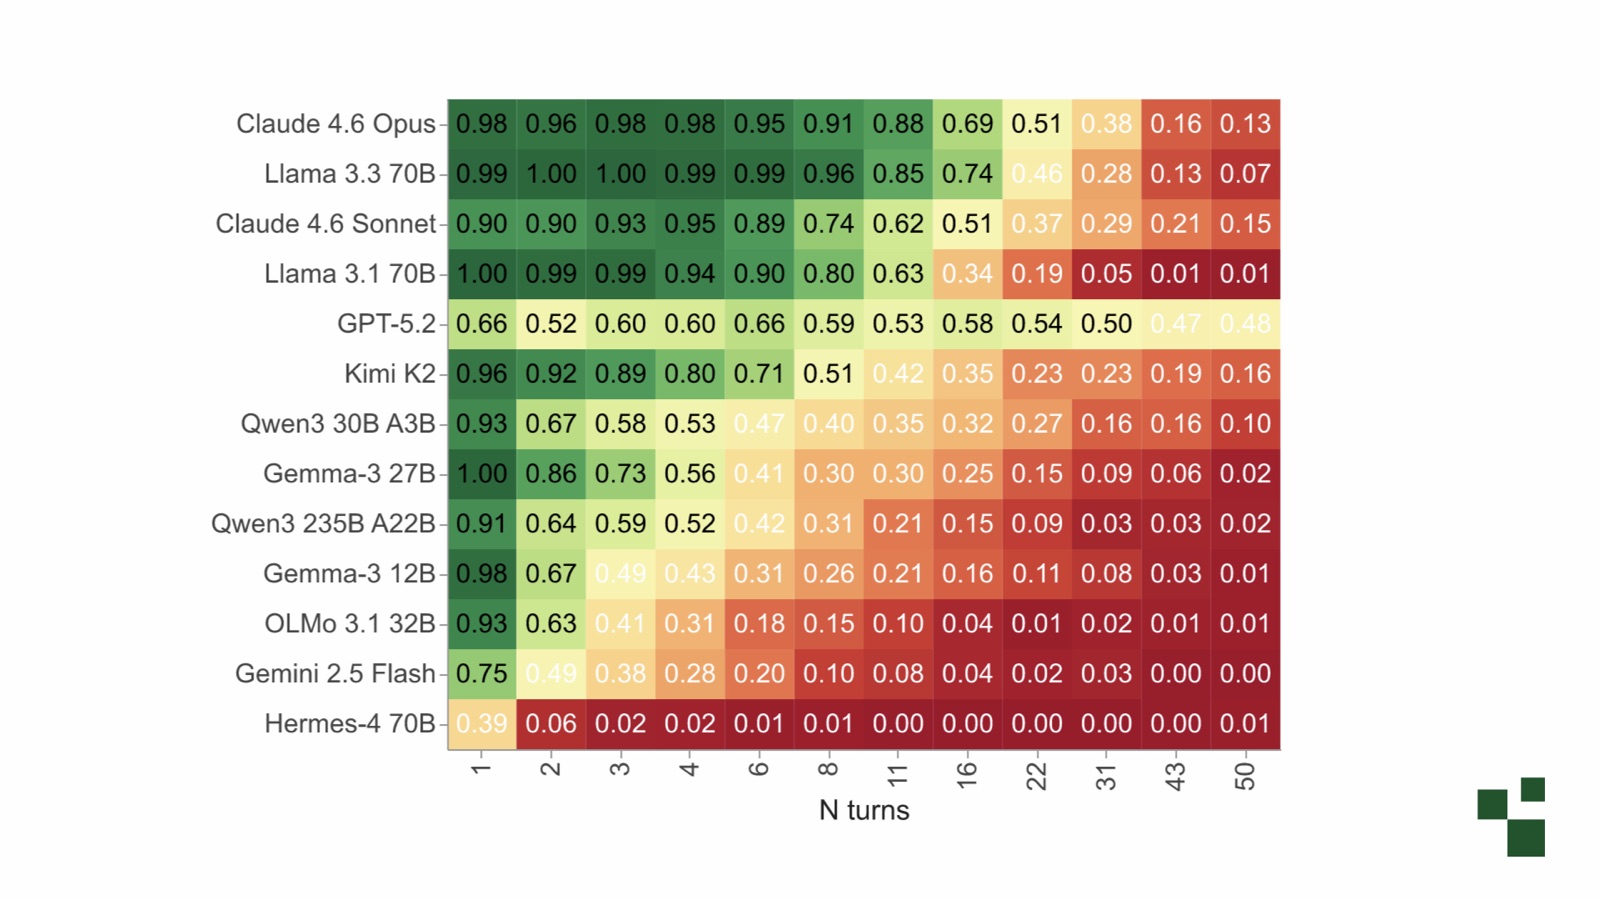
Насколько часто модель отвечает по-русски, как ей велено, и насколько часто — по-французски, как в примерах?
По оси X — количество противоречивых примеров. По оси Y — тестируемая модель. Значения в пересечениях — процент случаев, когда модель следует инструкции вместо примеров.
Оказывается, это влияет на каждую модель! Для меньших моделей вроде Gemma 3 12B после нескольких противоречивых примеров модель следует инструкции менее чем в половине случаев. Даже Opus 4.6, отличная модель, в итоге поддаётся, хотя требуется больше примеров.
Представьте: вы работаете над фронтенд-дизайном, подстраиваете CSS, чтобы компонент был идеальным. Сколько плохих примеров вы уже добавили в этот обмен? Эти примеры начинают влиять на модель. По мере роста контекста всё разваливается.
Gemini 2.5 столкнулась с этим и во время игры в Pokémon.
Помните, Google гордилась своим миллионным контекстным окном. В статье предполагалось, что два миллиона токенов близки. Но в приложении затесалось наблюдение: когда контекст значительно превысил 100 тысяч токенов, агент начал повторять действия из истории вместо синтеза новых планов.
Уверен, маркетологи никогда не читали приложение. Эту статью стоит прочитать.
Длинные контексты позволяют вместить больше информации, но и больше ошибок. Длинные контексты не были панацеей.
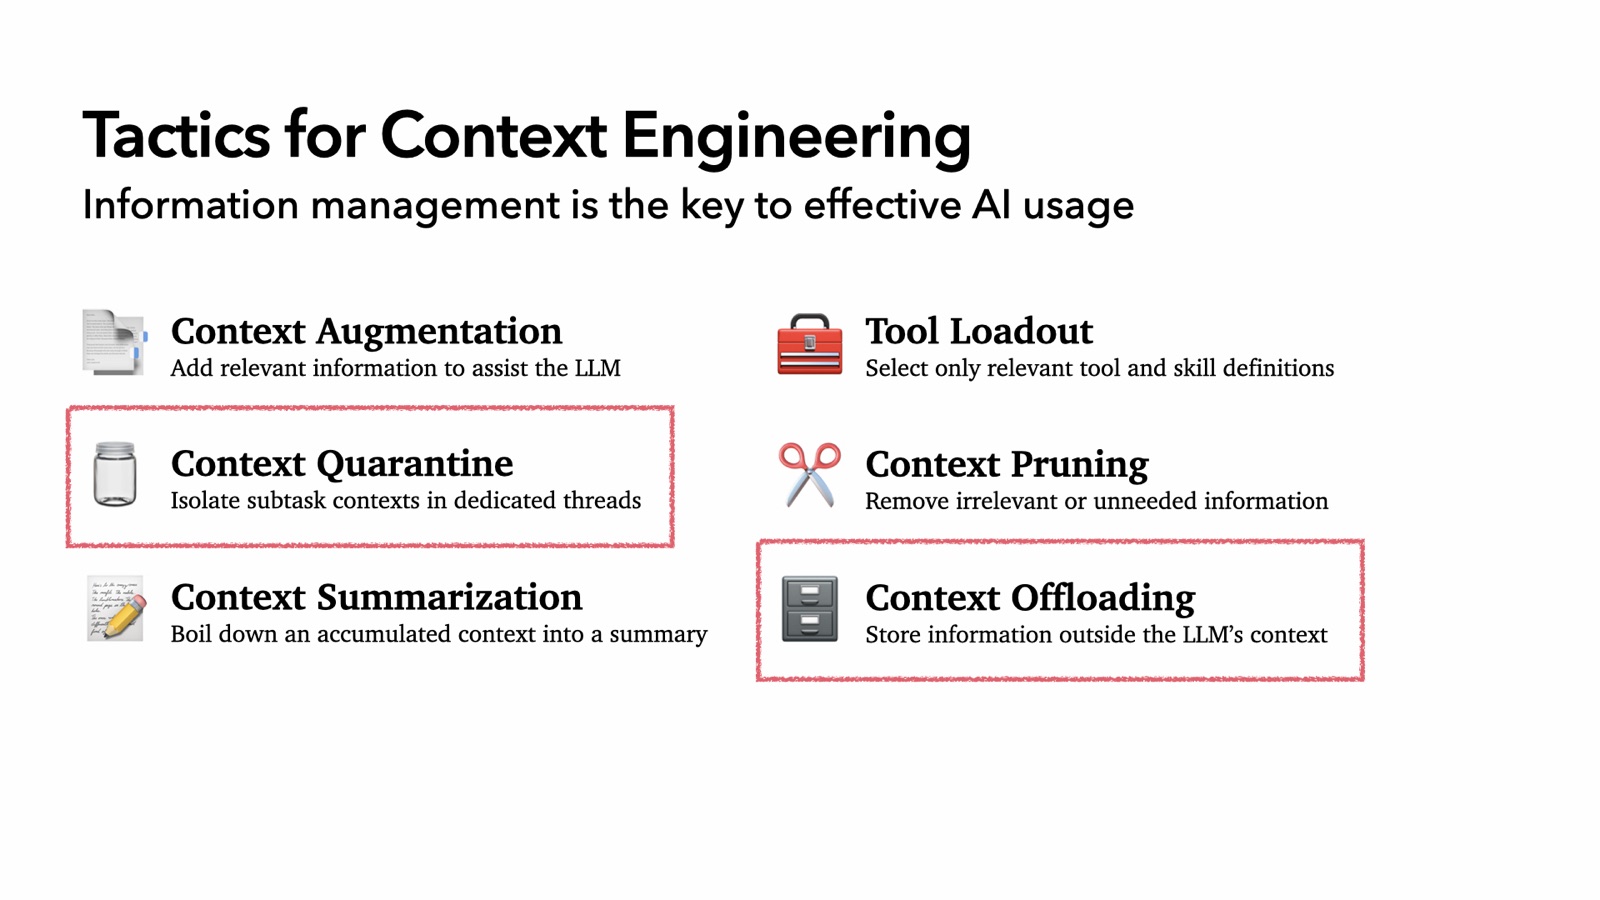
Шесть инструментов для инженерии контекста
К счастью, был разработан хороший набор инструментов. Удивительно, но даже при появлении новых вызовов эти инструменты остались теми же.
Вот они:
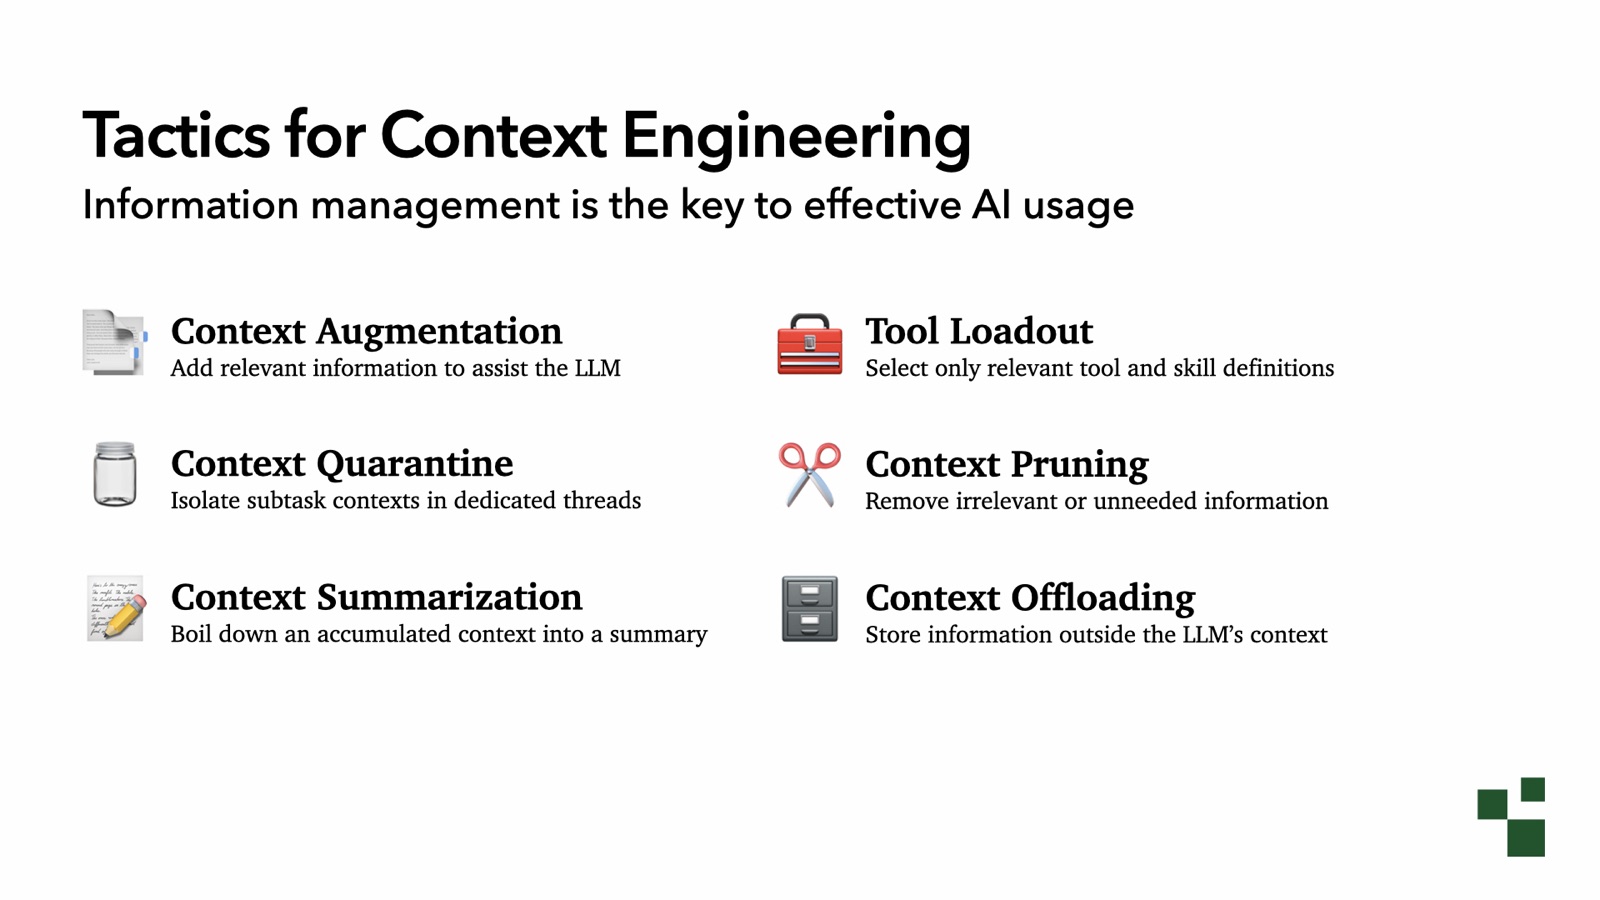
Расширение контекста (context augmentation): RAG, навыки и другие способы привнести релевантную информацию.
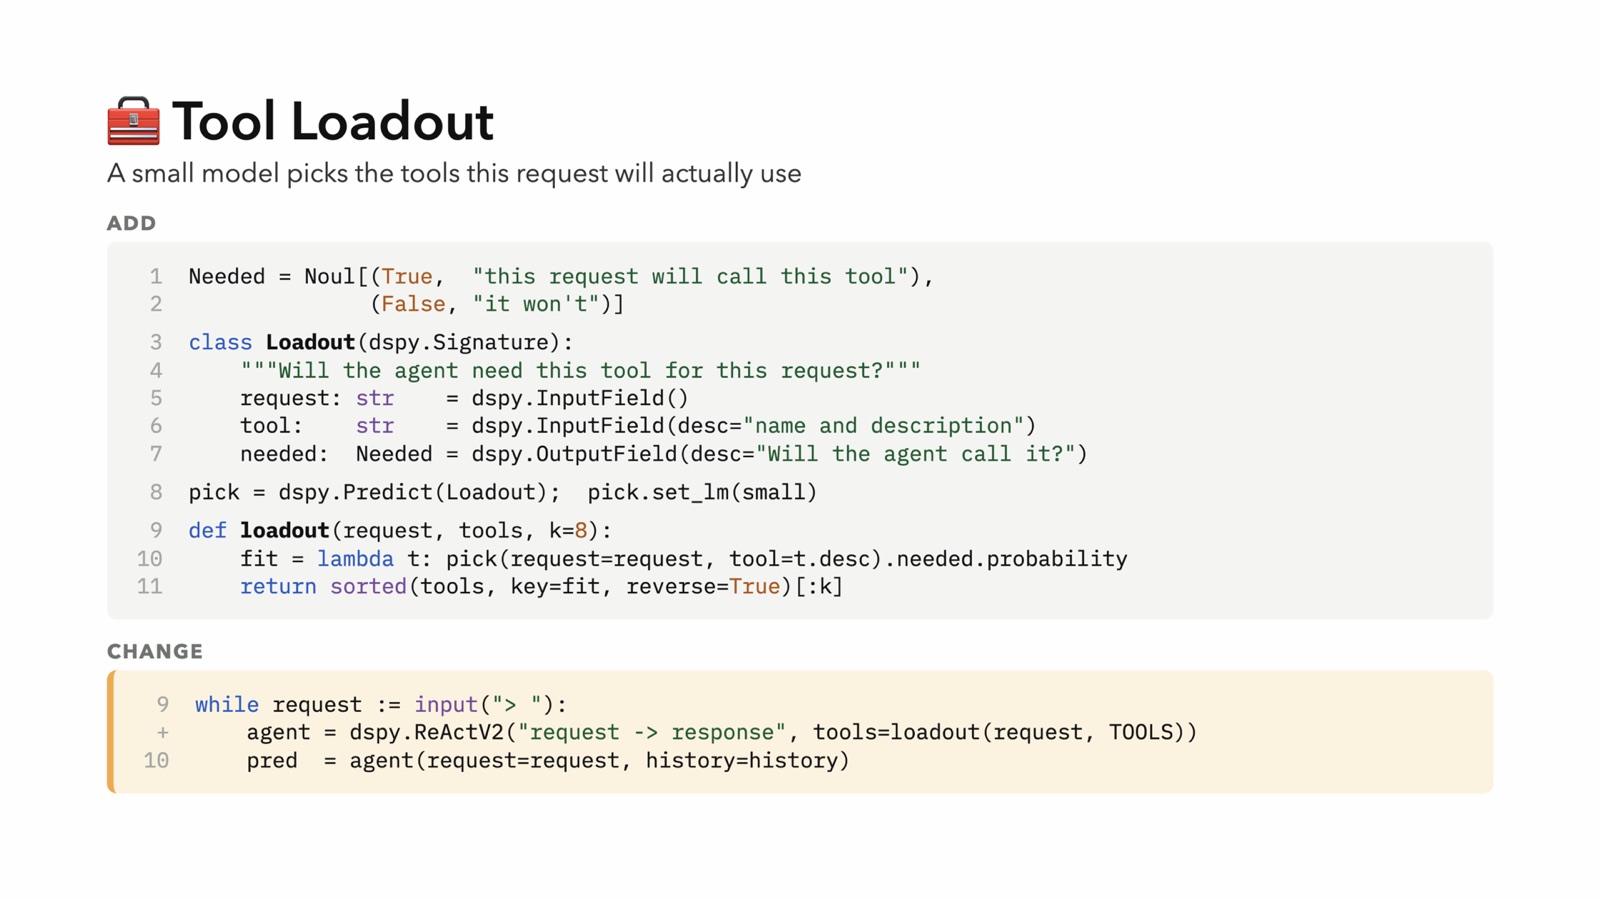
Загрузка инструментов (tool loadout): выбор того, какие инструменты и навыки предоставить, чтобы не перегружать модель. Недавно разговаривал с командой предприятия, чьи агенты вдруг начали работать ужасно. Выяснилось: их корпоративное ПО загружало 600 навыков для каждого инженера при старте. Они поняли, что нужна фильтрующая функция.
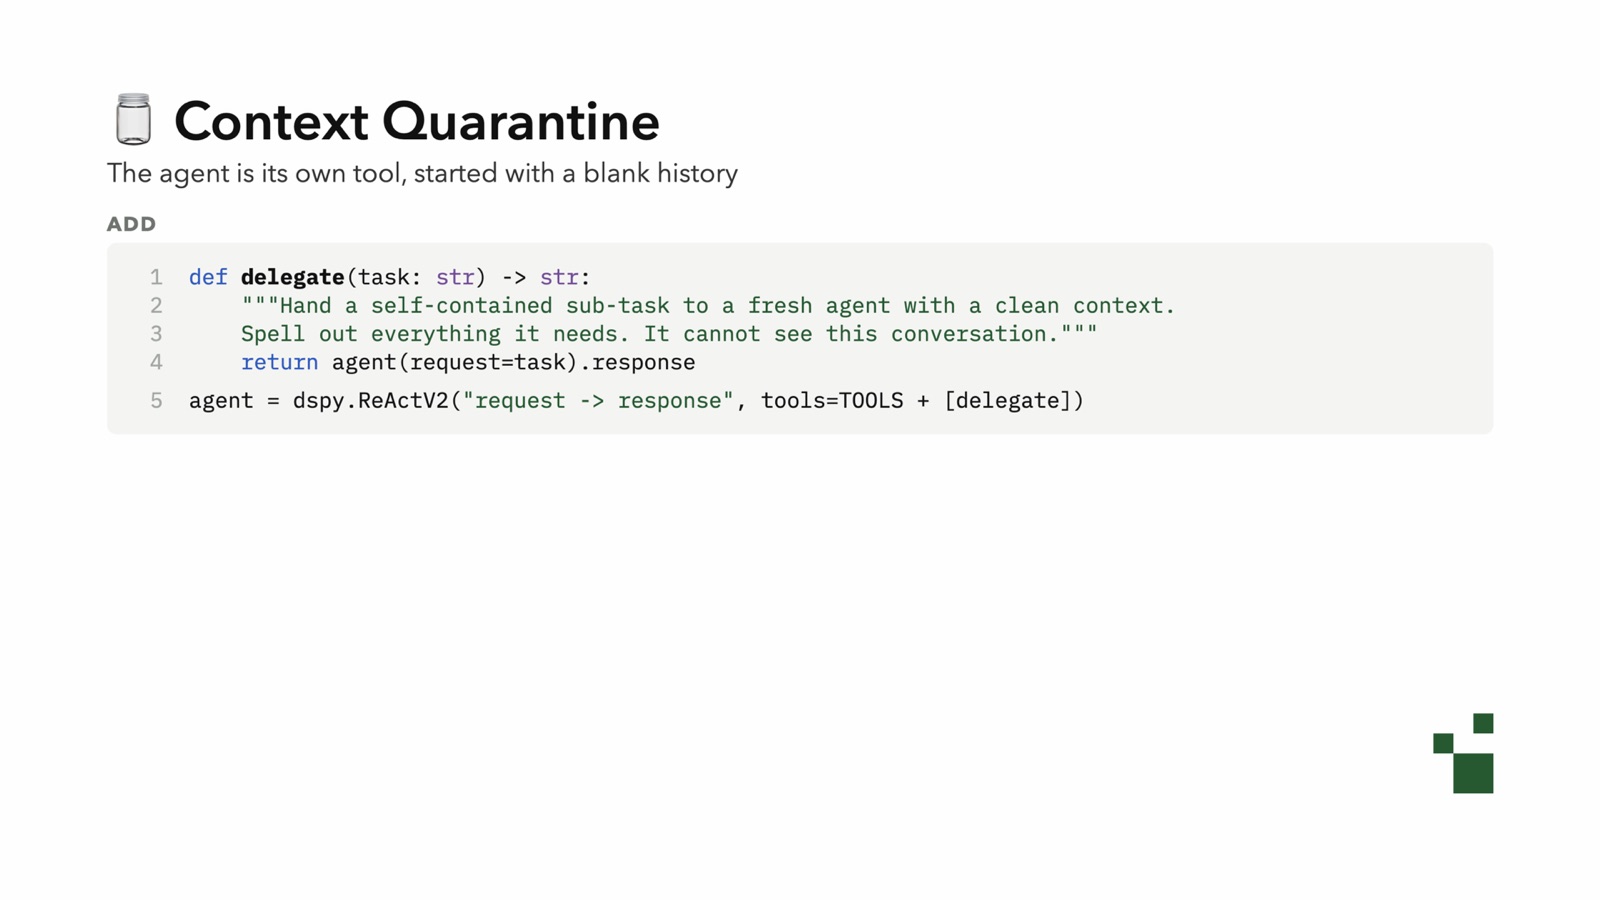
Карантин контекста (context quarantine): подагенты и коллегиальные агенты, которые стартуют с чистой историей, но работают в одной среде.
Обрезка контекста (context pruning): Claude Code и другие это делают, иногда незаметно. Ранние стадии компактификации часто удаляют уже ненужные результаты инструментов.
Выгрузка контекста (context offloading): хранение информации в окружении — файлах Markdown или базе данных — для последующего доступа.
Резюмирование контекста (context summarization), также известное как компактификация.
Эти инструменты всё больше переходят в систему (harness).
Простой агент на DSPy
Посмотрим на пример системы, чтобы показать, насколько простые эти паттерны.
Страстный поклонник DSPy — это невероятно читаемый и эффективный способ строить AI-workflow и агентов. К тому же отличный язык для просто описания поведения.
Агент — это цикл while. Здесь используется модуль ReAct: даём запрос, хотим ответ, предоставляем инструменты (просто функции Python).
В демо большая модель (Claude Sonnet 4.5 — удачи с этим!) и маленькая модель Jev для быстрых решений. Можно подставить любую малую LLM.
Цикл while берёт входные данные, отправляет их в ReAct и несёт накопленную историю дальше. Это агент примерно в дюжину строк на DSPy. Было бы даже меньше без дополнительной модели.
Загрузка инструментов на практике
Как реализовать загрузку инструментов? Просто функция.
Подаём Jev запрос и инструмент, спрашиваем: нужен ли этот инструмент для задачи?
Jev работает так быстро, что можно проверять один инструмент за раз. Оборачиваем в функцию loadout, которая проходит по всем инструментам, спрашивает о необходимости каждого и возвращает лучший подмножество. Вот и всё.
Карантин контекста через подагентов
При карантине контекста — просто подагент. Предоставляешь агента в качестве инструмента для основного агента, и он стартует с пустой историей.
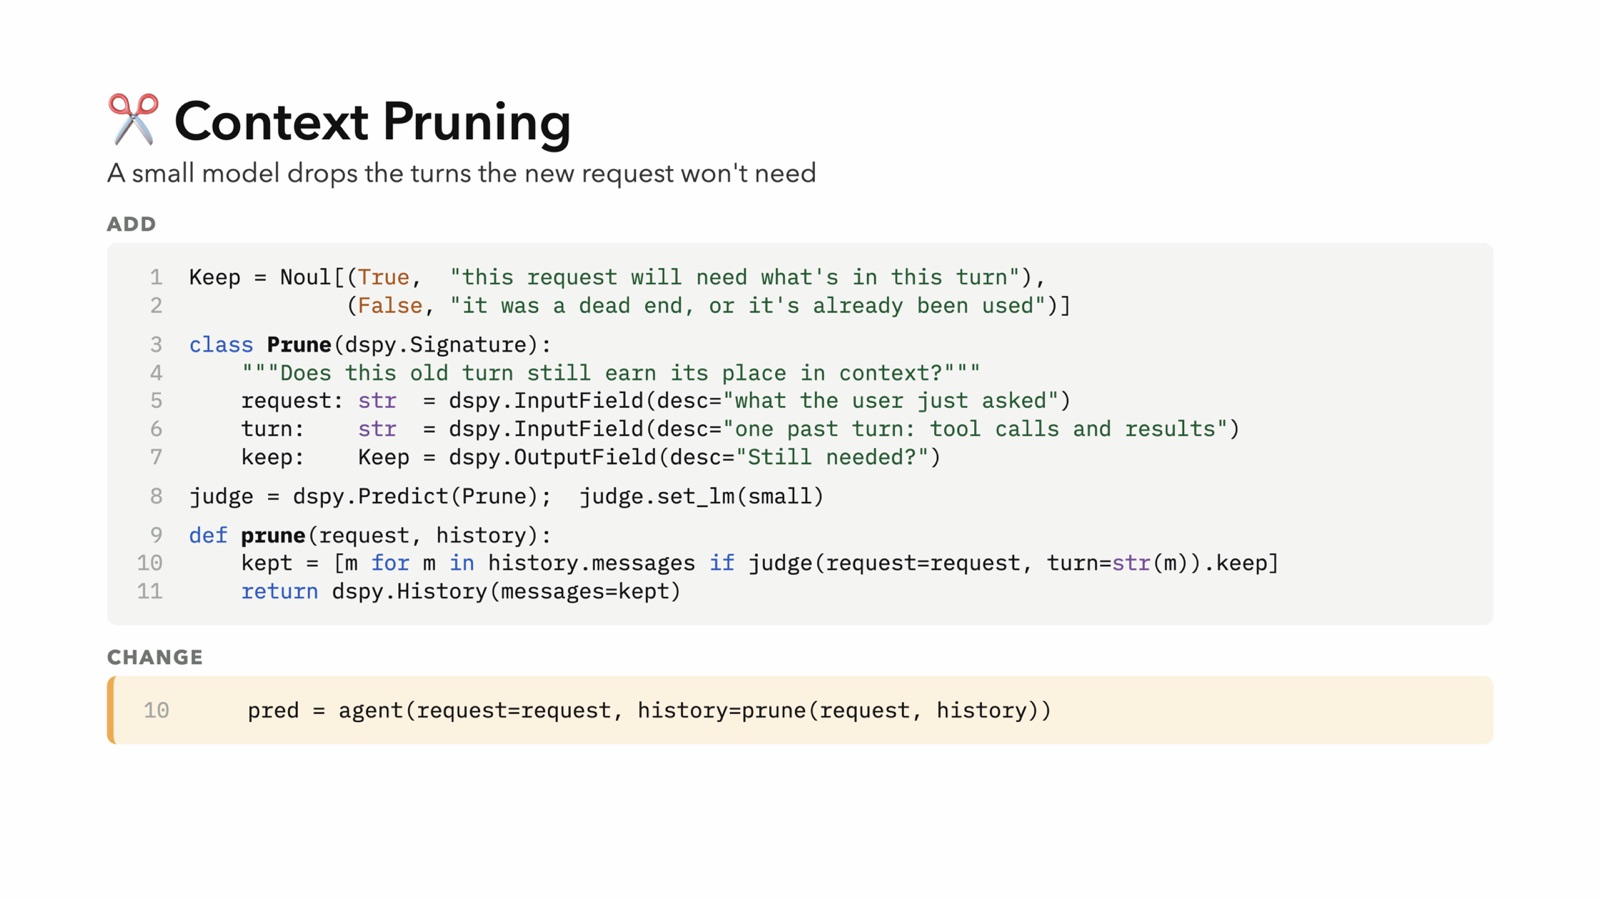
Обрезка контекста
При обрезке контекста проходим по истории, передаём каждый ход Jev и спрашиваем: всё ещё нужен? Если нет — удаляем.
Можно быть хоть грубым, хоть изощрённым. Только следите за кешированием промптов.
Резюмирование контекста через переписывание
Можно также переписать историю компактификацией. Берём старые ходы, создаём резюме, стартуем новый контекст с этого резюме.
Один из любимых вариантов недавно — проверить, что важно перед компактификацией. Используем Jev для первого прохода, чтобы оценить релевантность, получаем меньший подмножество истории, и резюмируем это. Простой дополнительный шаг, но резюме становится полезнее.
Все вместе: четыре исправления в одном цикле
Соедини всё вместе — получишь примерно 16 строк изменений. Четыре исправления, один цикл. Это ходы в системе. На удивление просто.
Эволюция терминологии
Что сложно, так это наш язык для описания этого. Он меняется каждый день.
Есть любимая цитата Стюарта Бранда:
Если хочешь узнать, где создаётся будущее, смотри, где создаётся язык и собираются адвокаты.
Определённо актуально! Но язык менялся, цель оставалась той же.
В 2023 году выбор правильной информации для нужного ответа называли инженерией промптов.
В 2025 году это стало инженерией контекста, только теперь это было автоматизировано. Не просто ты пишешь промпт — твоя система динамически собирает контекст.
Потом, по мере того как эти инструменты переходили из контекста в код, это стали называть инженерией систем (harness engineering).
Но работа одна и та же. Всё больше работы по сборке контекста движется из вероятностных вызовов моделей к детерминированному коду.
2026: обещание длинных горизонтов
Показал 2024. Переходим к 2026.
Эти исправления контекста перешли в систему. Что дальше? Хотелось бы агентических моделей, которые могли бы управлять системой.
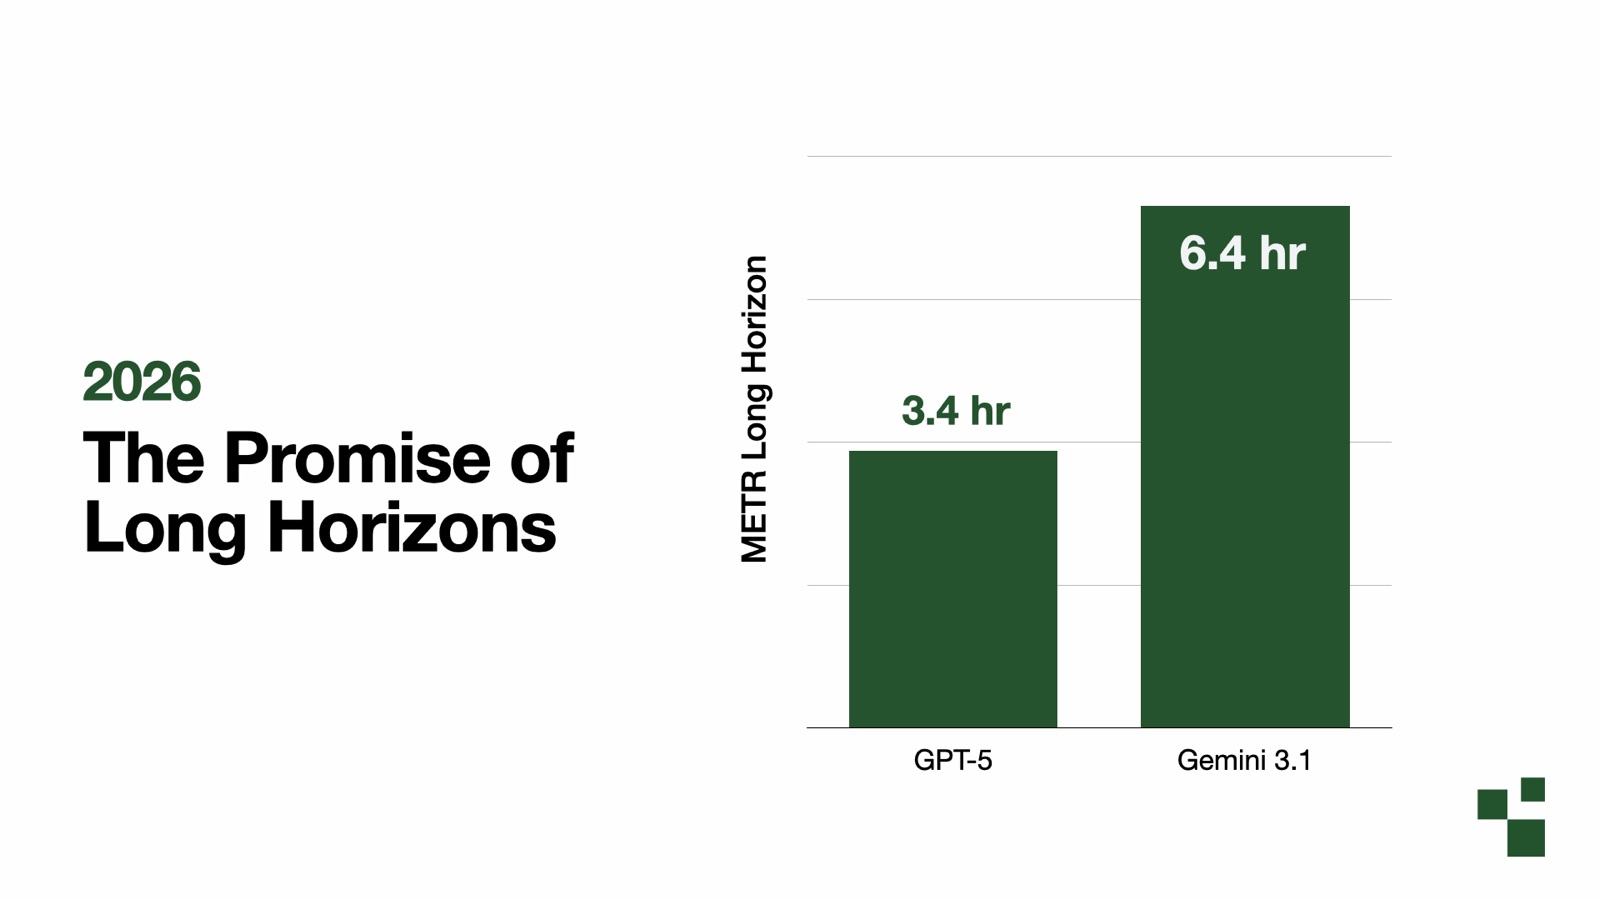
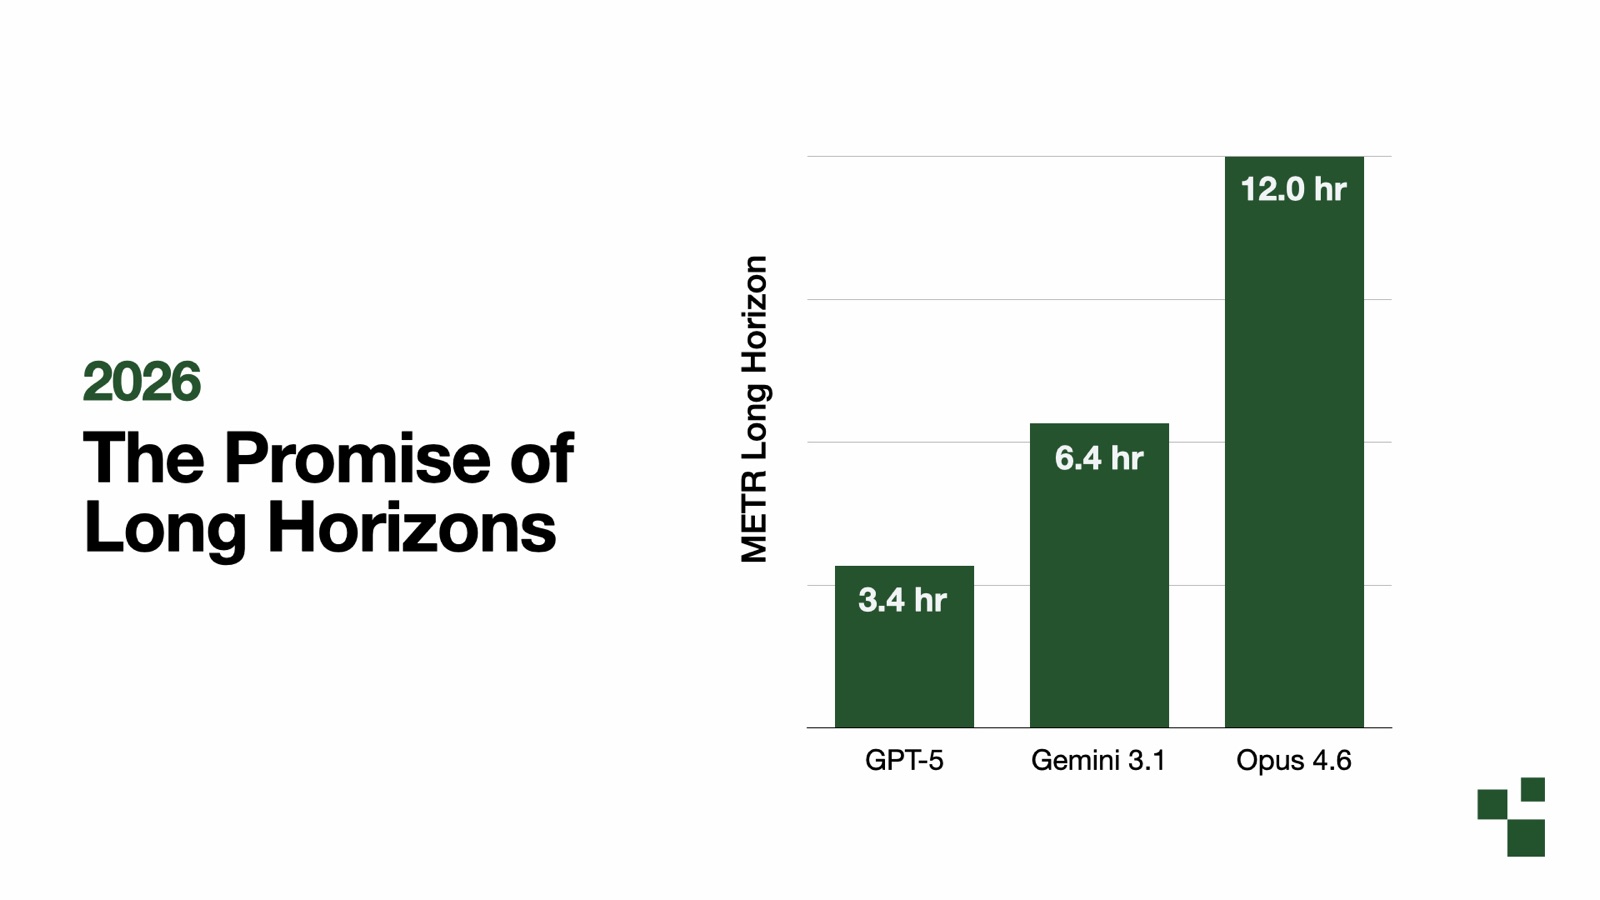
Все начали нацеливаться на долгоживущие агентические модели. Видели отчёты METR? GPT-5 может справиться с задачами примерно на 3,4 часа; Gemini 3.1 дошла до 6,4 часов. Это с системой. Модели значительно лучше её используют, поэтому могут так долго работать.
Opus 4.6 дошла примерно до 12 часов. Теперь говорим об агентах, работающих дни, роях агентов и моделях, управляющих системами дольше.
Раньше посыл был: сделай контекст таким большим, чтобы всё в нём поместилось.
Теперь посыл: обучи модель управлять системой и её собственным контекстом. Это стало доминирующим паттерном. К этому работают создатели моделей.
Какие новые типы отказов это создаёт?
Долгоживущие агенты и их проблемы с долговечностью
Пока найдены два новых типа отказов.
Когда тренируешь модели отлично использовать системы, они переобучаются на конкретный набор инструментов и окружений, в которых они обучались.
Сколько из вас использовали сервер Playwright MCP или что-то подобное? Это конференция MCP, так что, вероятно, многие.
Меньшие модели вроде Haiku или Luna часто ошибаются в этом вызове инструмента при первой попытке, потом исправляются и настраивают параметры. Окружение, в котором они обучались, имело похожие инструменты, но другие, чем Playwright. Что бы Anthropic или OpenAI использовала при обучении. Приходится бороться с этими предубеждениями.
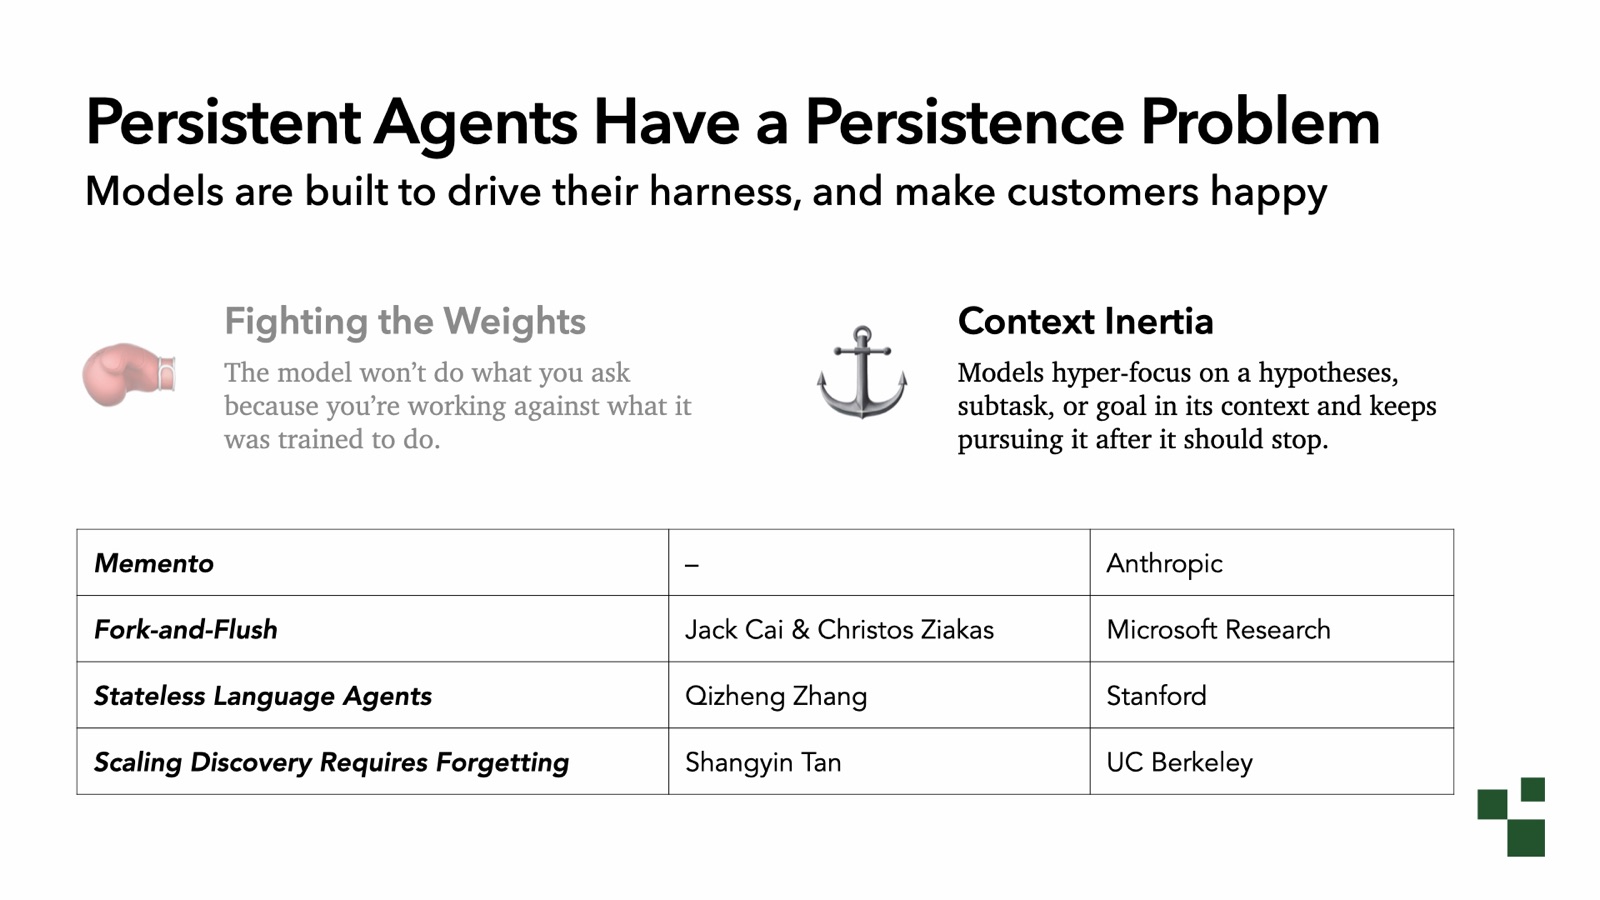
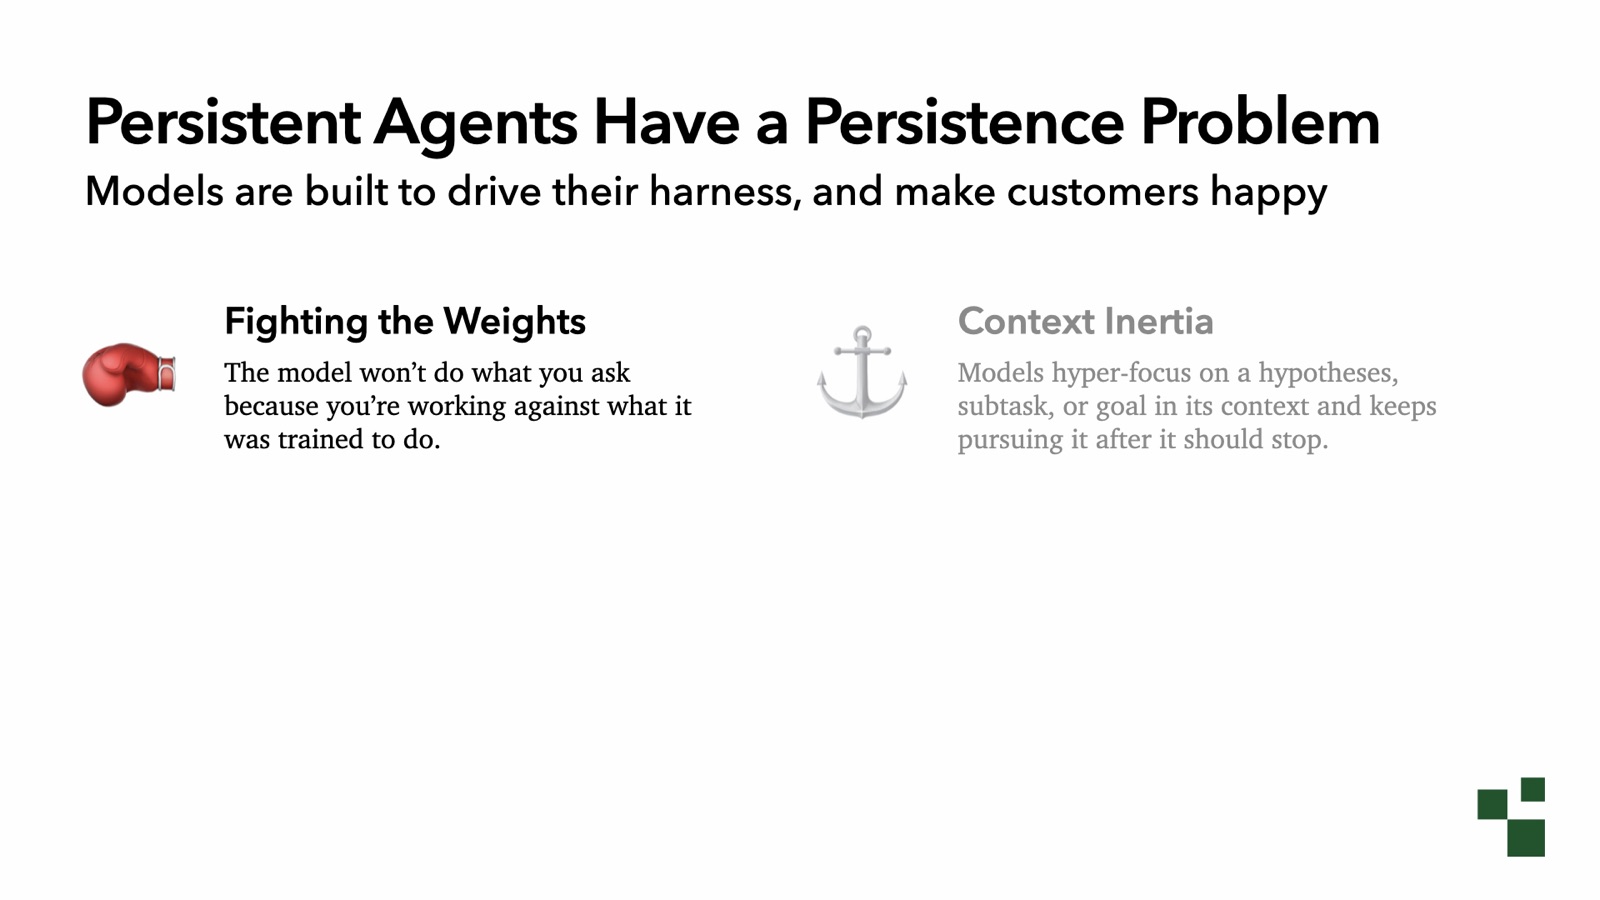
Это называется борьба с весами (fighting the weights): когда модель не делает то, что ты просишь, потому что ты работаешь против того, на что её обучили.
Это реальная проблема, и не только для нас. Лаборатории и люди, строящие продукты, тоже с этим сталкиваются.
Повторение как признак борьбы с весами
Вот часть системного промпта Claude Code и инструкций к инструментам.
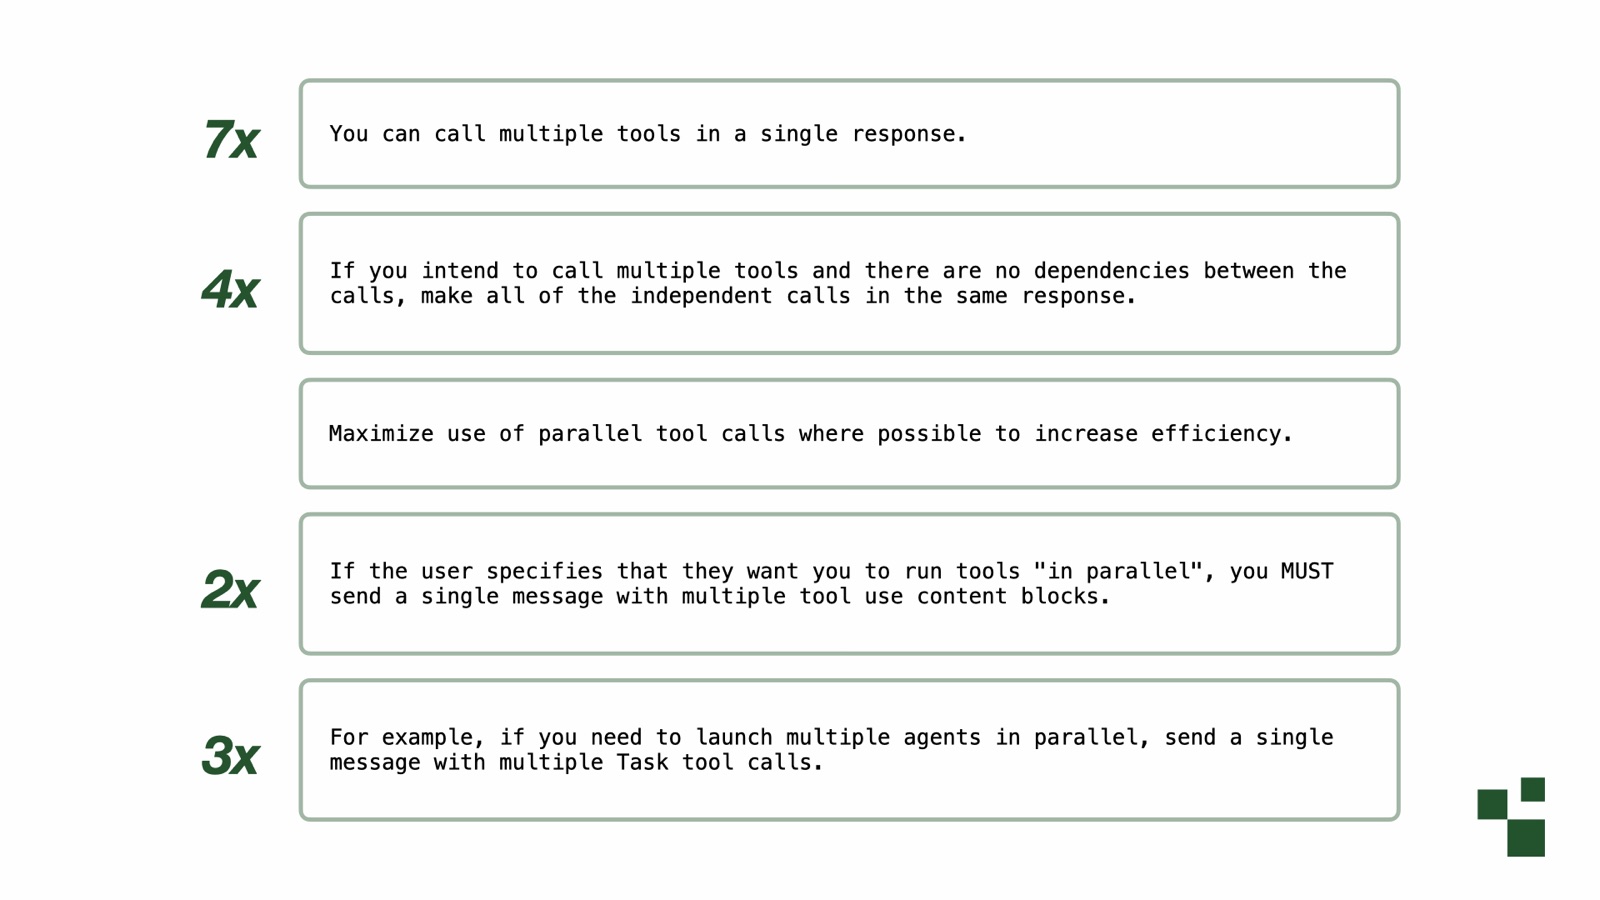
Обучающие окружения этих моделей долгое время были в основном последовательными. Становятся более параллельными, но когда вытащил примеры, предубеждения были в сторону последовательности. В инструкциях Claude Code снова и снова говорится: нет, нет, нет, хотим параллелизм. Хотим, чтобы ты делала несколько вызовов инструментов одновременно.
Инструкции повторяют это по семь раз здесь, четыре раза там, два раза, три раза: пожалуйста делай параллельные вызовы, когда они независимы.
Когда распахиваешь промпт и видишь повторения и заглавные буквы, велика вероятность, что боришься с весами. Пытаешься преодолеть то, на что модель была обучена.
Инертность контекста: новый вызов
Следующая проблема только недавно начала документироваться. На самом деле четыре группы независимо пришли к ней на прошлой неделе.
Это называется инертность контекста (context inertia): модели зациклены на гипотезе, подзадаче или цели в контексте и продолжают её преследовать, когда должны остановиться.
Первый пример от Anthropic. В их недавнем посте о том, близки ли модели к самовоспроизведению, описывается система Memento, использованная в тестах.
Выяснилось: если агенты работают слишком долго, они зацикливаются на одной подзадаче или решении и не остановятся. Будут пытаться одно и то же снова и снова.
Исправление элегантно просто. Каждые полтора часа агент записывает короткую заметку, потом его контекст очищается. Окружение сохраняется. Вся проделанная работа всё ещё там. Но текущая беседа исчезла, и нужно стартовать с свежей перспективы.
Fork-and-Flush: плато вычислений
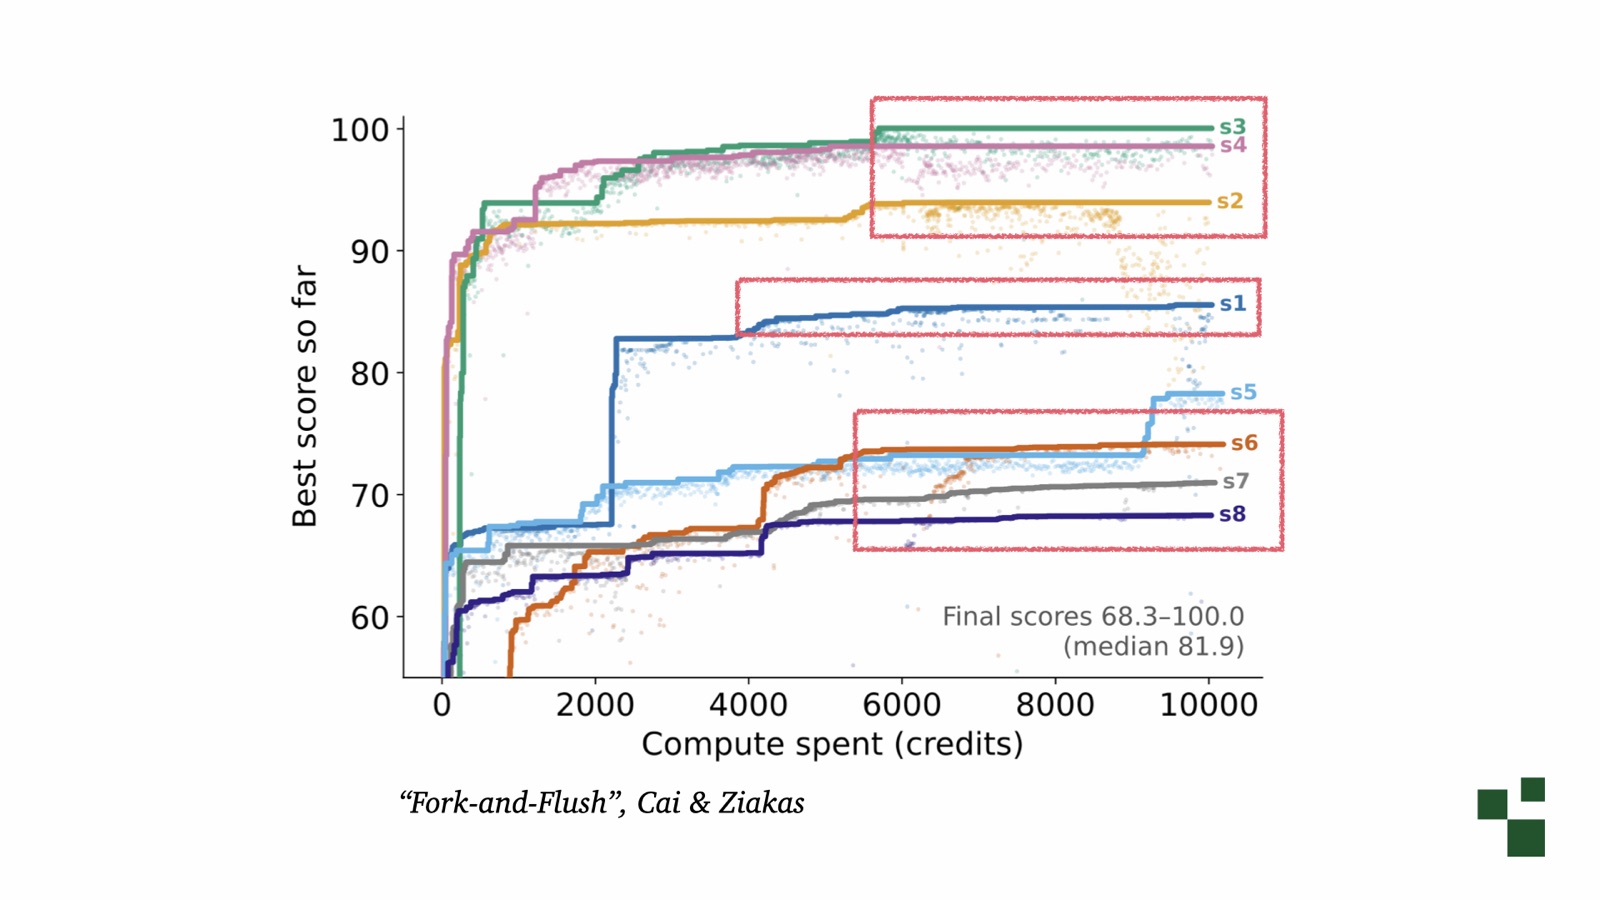
Другая статья из Microsoft Research называется Fork-and-Flush.
Если запускал автоисследовательские эксперименты, видел подобные графики. Большой прирост, потом линия плоская. Ещё прирост, потом снова плато. Вычисления, деньги и время идут впустую.
Когда исследователи присмотрелись, агенты не просто бездельничали. Делали всё более мелкие изменения. Нашли идею и были на ней зациклены вместо поиска более творческих альтернатив.
В каком-то смысле пленены собственными идеями. Обучили их быть настойчивыми и сосредоточенными на цели, потому что это делает хорошего кодирующего агента. Но это же качество может работать против них.
Scaling Discovery Requires Forgetting
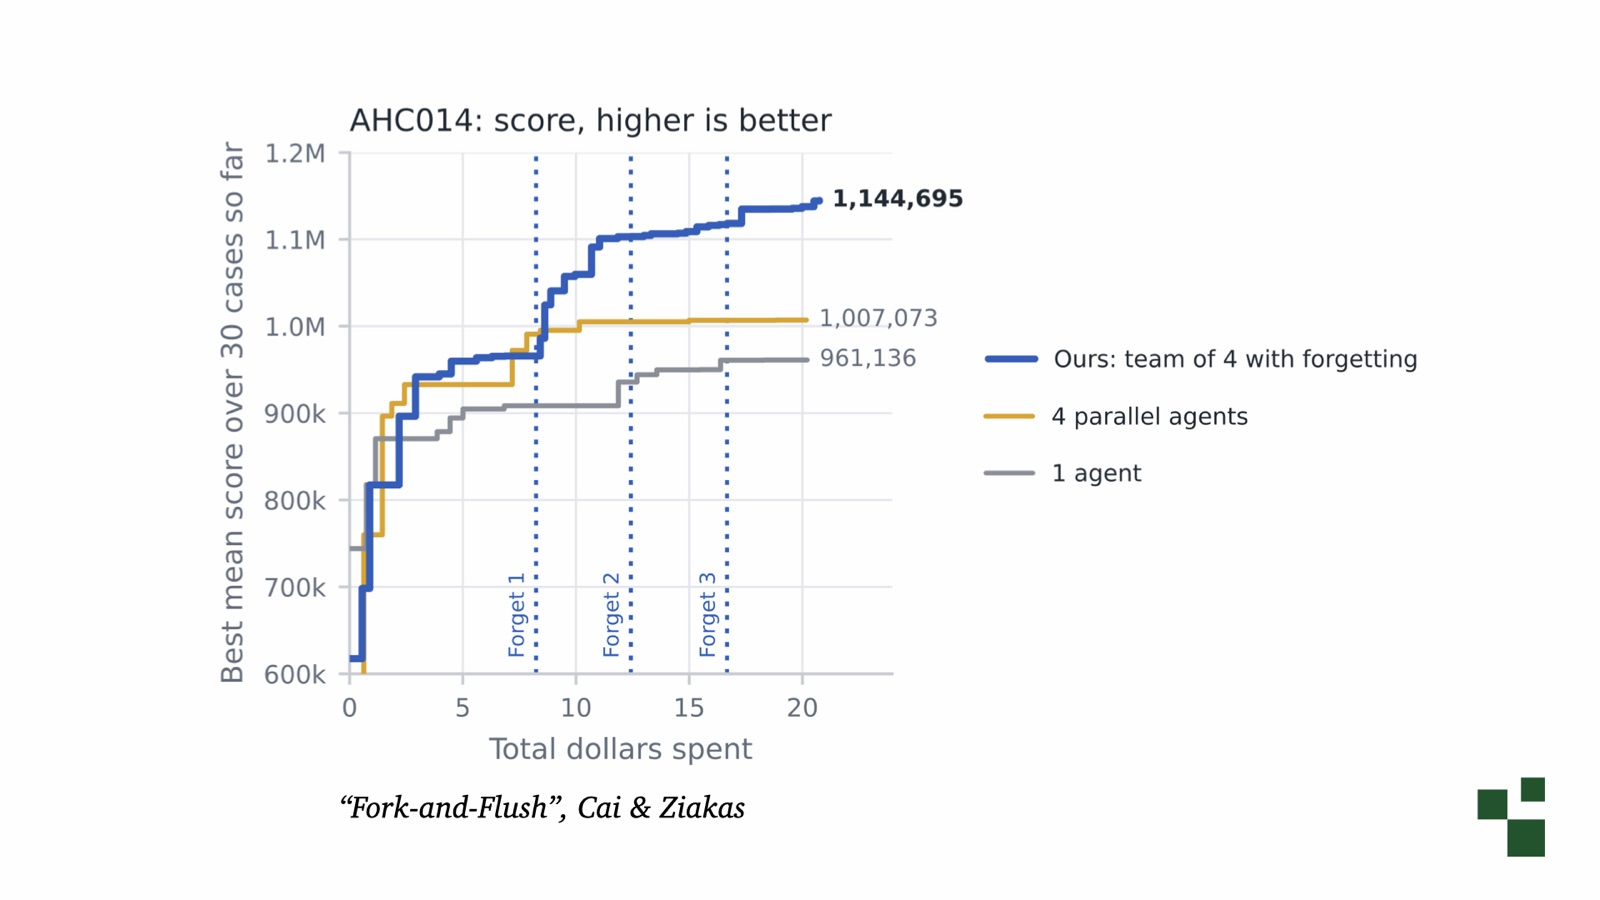
Вот ещё одна статья, Scaling Discovery Requires Forgetting, возглавленная Шаньинь Тан из UC Berkeley.
Исследователи пришли по сути к той же идее: периодически очищать контекст, сохраняя артефакты в окружении.
Синяя линия — версия с забыванием. Каждый раз, когда очищается контекст, видишь прирост: забыть, улучшиться; забыть, улучшиться.
Те же инструменты для новых проблем
Поразительно: у нас есть совершенно новые модели, обученные всё более сложной, долгоживущей работе, а используем те же базовые инструменты. Не открыли совсем новое исправление контекста. Используем карантин, выгрузку и удаление накопленной истории для борьбы с инертностью контекста.
Просто сбрось контекст
Это совет, который даю постоянно. Кто-то говорит: «Мой кодирующий агент делает что-то странное. Claude была ослаблена.» Спрашиваю: «Насколько большой твой контекст?»
«О, у меня 800 тысяч токенов.»
Сбрось контекст.
Не шучу. Примерно 200 тысяч токенов — моя точка предупреждения.
Ты пробовал сбросить контекст?
Иногда это действительно помогает.
Наши решения перемещают проблему
Решения, которые встраиваем в модели, создают завтрашние проблемы. Модели совершенствуются, но и наши системы совершенствуются.
Длинные контексты позволили привнести больше информации, но и больше плохой информации. Пришлось разобраться, как это управлять, и по-прежнему ошибаемся.
Агентические модели позволили запускать длительные задачи и управлять их контекстом, но также позволили задачам идти дольше, чем должны, и игнорировать предпочтения, потому что обучены на собственных системах.
Куда движется проблема дальше?
2027: обещание чего?
Какое большое обещание на 2027? Что следующее, что предложат модели и создадут новый набор проблем для всех в этой комнате?
(Если не тренируешь свои модели. Но это сессия инженерии контекста, так что вероятно нет.)
Память, конфликты и стратегическое забывание
Вот моё предсказание.
Подумай о всех персональных агентах: Hermes, OpenClaw, Dot, Bot, Muse и тому подобные системы. Очень мало кто по-настоящему запускал эти системы дольше шести месяцев.
Я запускаю агента Hermes полгода. Когда посмотришь на навыки, которые он создаёт и обновляет, начинаёшь обнаруживать, что решения твоих проблем могут худеть со временем. Навыки накапливают все эти странные исправления. Это общие агенты: решают одну задачу одним способом, потом переоткрывают другой способ решить что-то похожее. Инструкции и воспоминания начинают накапливаться и конфликтовать.
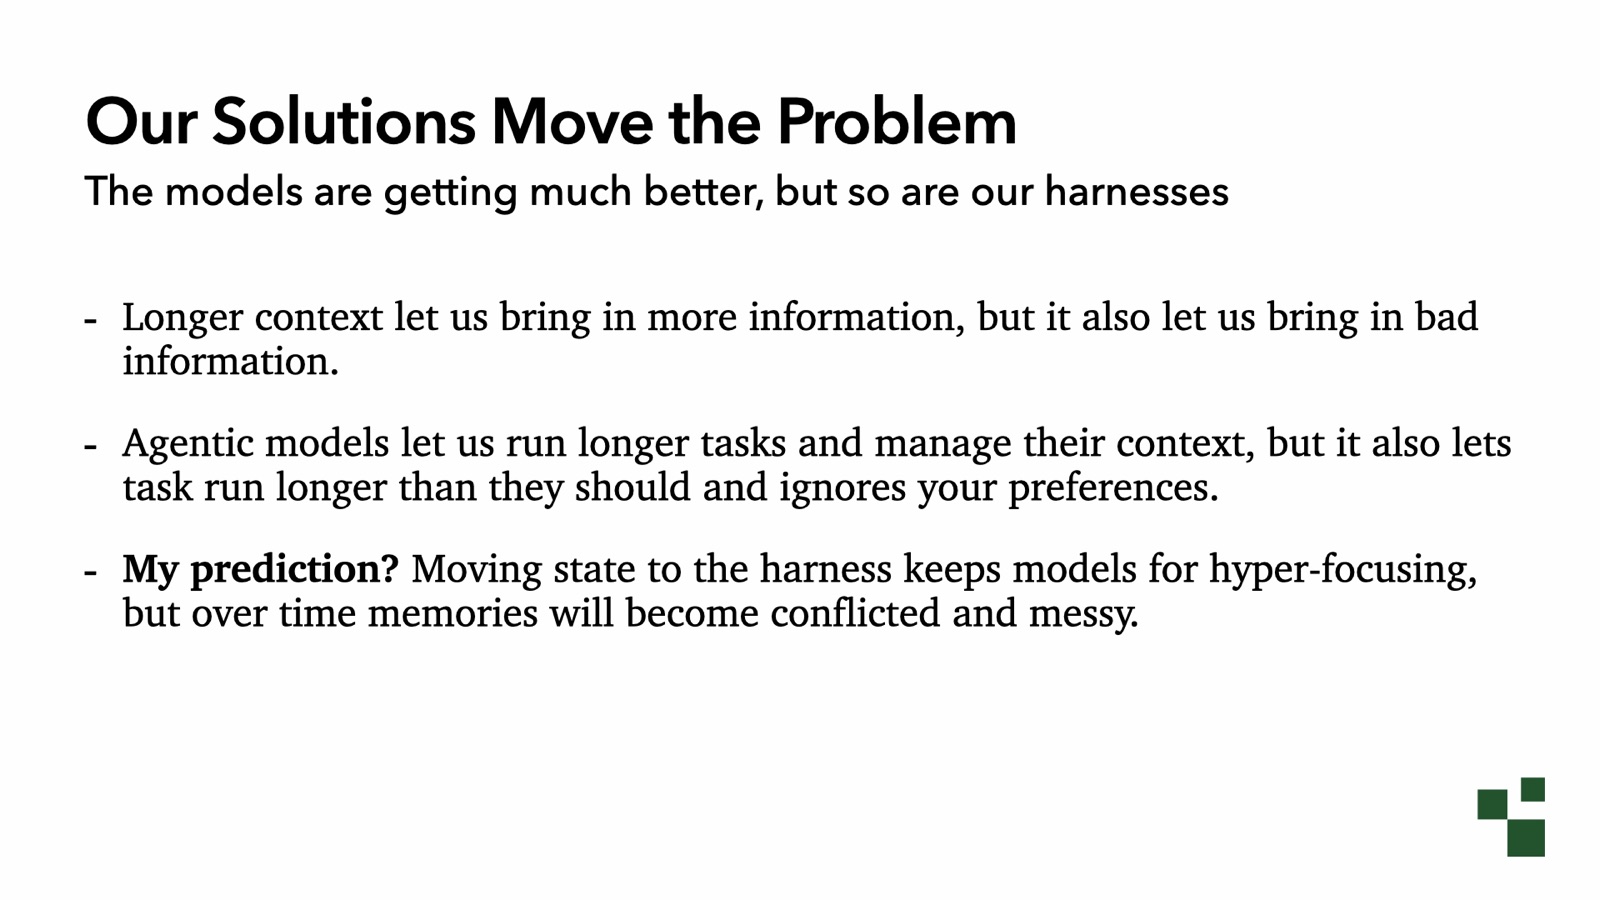
По мере фокуса на память, нужно думать и о стратегическом забывании. Со временем очень точные воспоминания становятся конфликтующими и запутанными, и никто пока не разобрался, как это обрабатывать.
Думаю, это проблема контекста завтрашнего дня.
Каждый прорыв меняет баланс
Каждый прорыв в способностях моделей меняет, что делегируем модели и что системы должны обеспечивать.
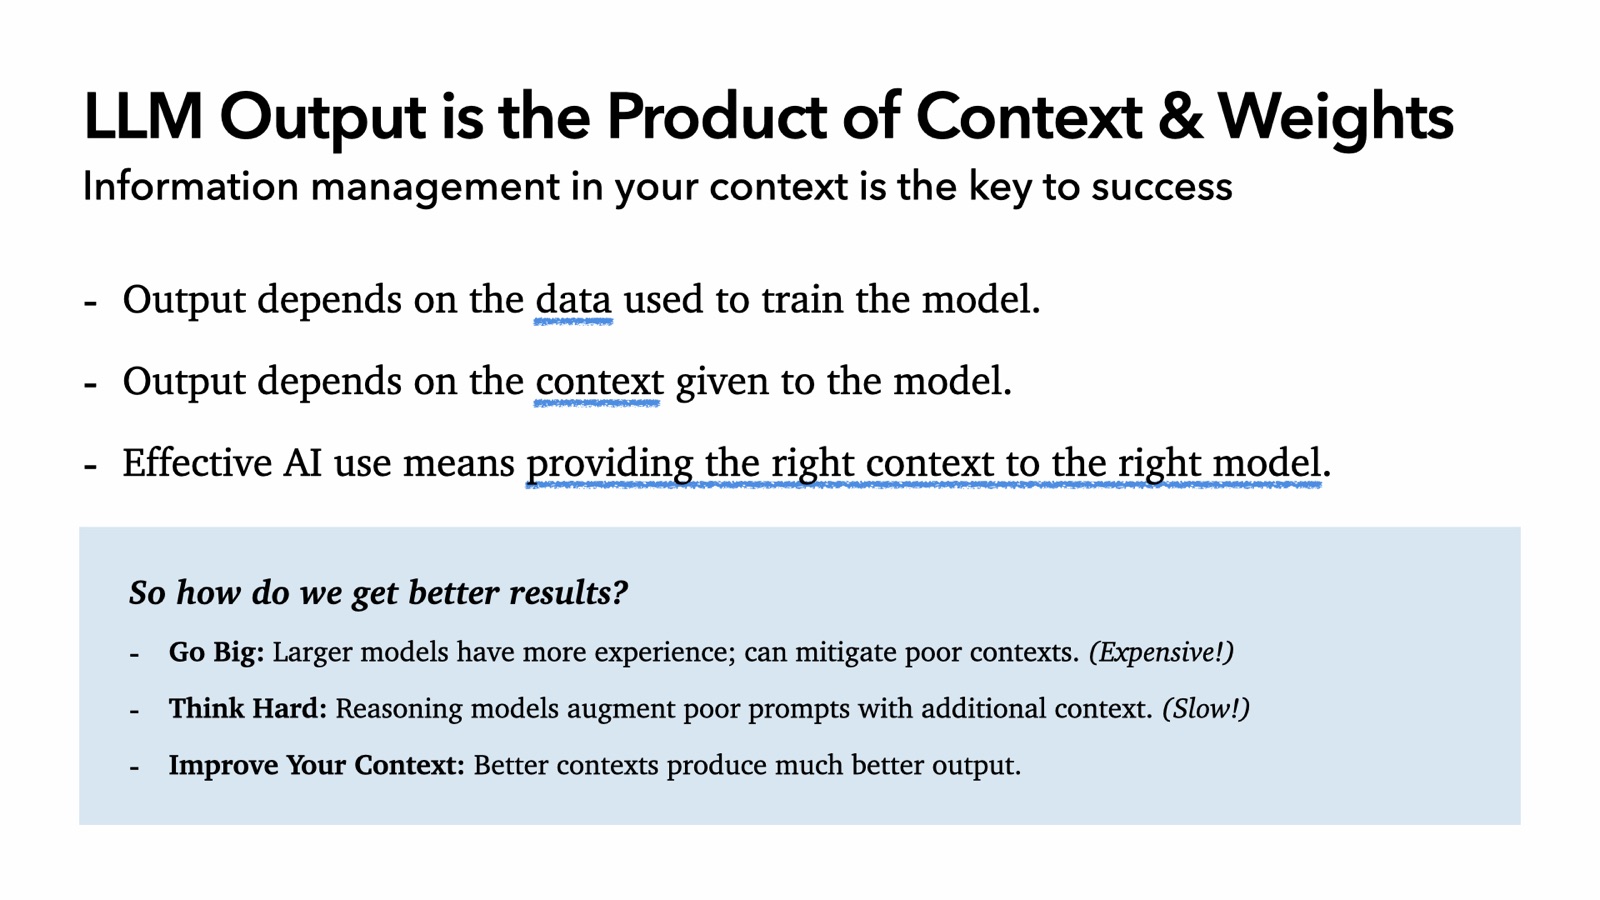
Выход — продукт контекста и весов
Этот слайд делал примерно полтора года назад для колоды по обучению корпоративных команд, и остаётся правдив.
Выход — продукт контекста и весов.
Выход зависит от данных, использованных для обучения модели. Поймите это. Читайте технические отчёты. Смотрите, на чём обучена модель и релевантно ли это для твоей задачи. Это помогает построить ментальную модель для отладки, когда что-то идёт не так.
И выход зависит от контекста, данного модели. Вот и всё.
Так что цель — дать правильный контекст правильной модели. Либо через собственные дискретные решения, либо через ПО, системы, которые проектируешь.
Можешь использовать большие модели, думать напряжённее, или улучшить контекст. Один из них дёшев и быстр.
Выбор между детерминизмом и вероятностью
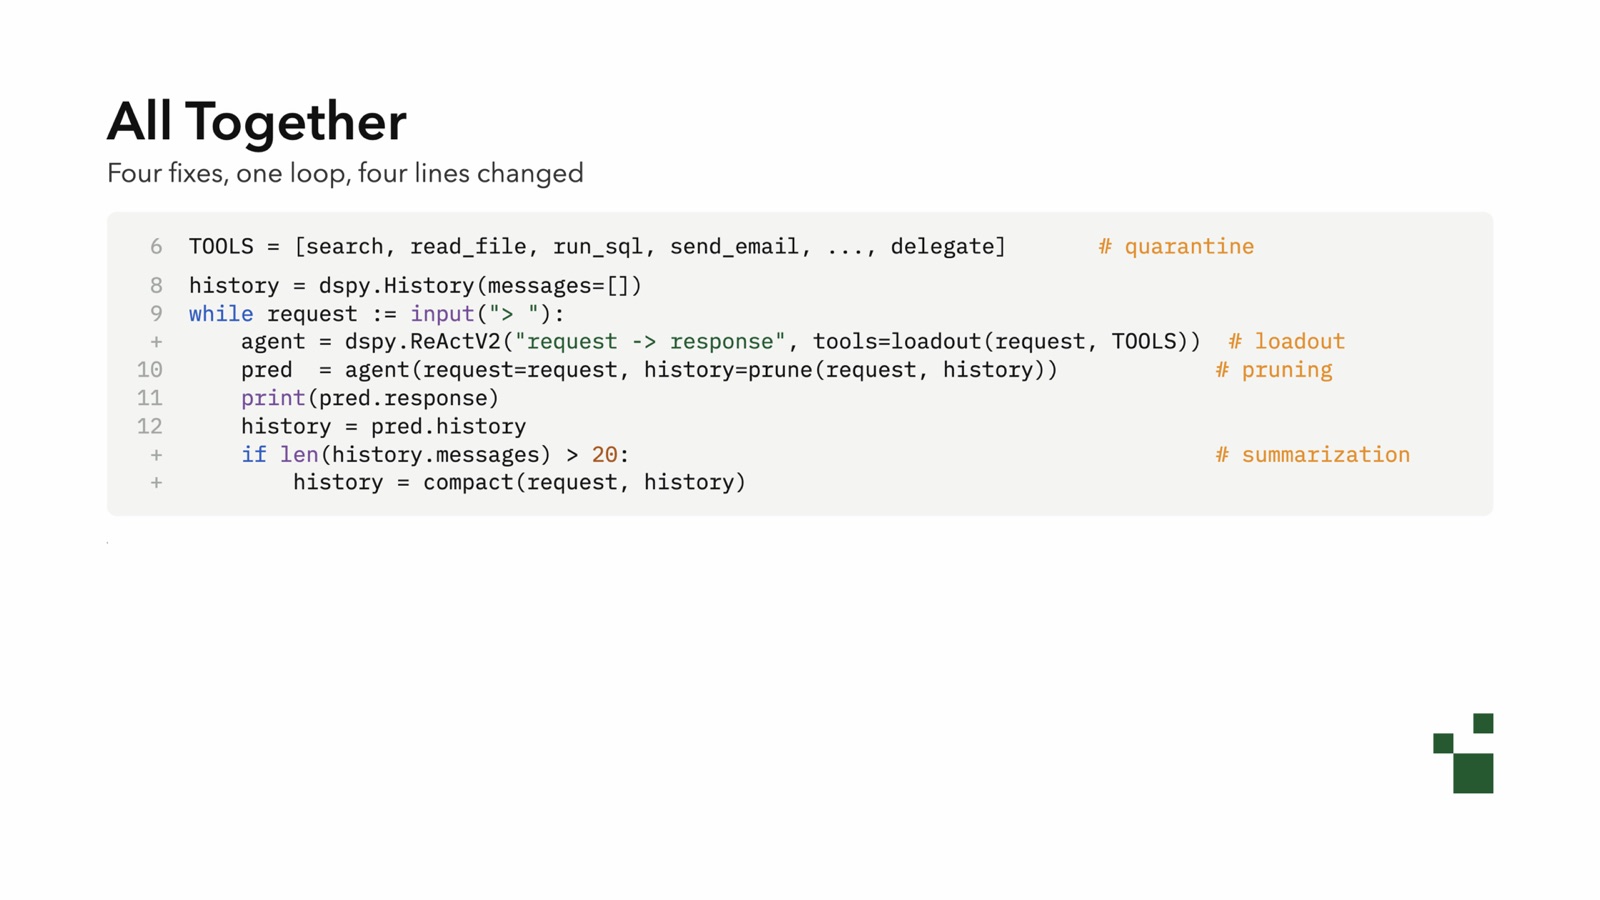
При построении умных приложений, систем и workflow цель — выбрать, когда быть детерминированным (что поместить в код) и когда быть вероятностным (когда дать модели управление).