Что такое x86-TSO?
Перед тем как разобраться в том, как обойти проблемы с моделью памяти x86, нужно сначала понять, что это такое. Модель памяти — это набор правил, определяющих, как операции доступа к памяти в системе взаимодействуют друг с другом. Эти правила указывают на то, как загрузки и сохранения работают в однопоточной или многопоточной среде. Существует несколько популярных моделей памяти, реализованных в различных формах аппаратуры, но две из них сегодня нас интересуют: расслабленная (или слабая) модель согласованности ARM и вариант x86 модели Total-Store-Ordering (TSO). Эти две модели находятся на противоположных концах спектра: ARM наиболее расслаблена, позволяя значительные аппаратные оптимизации; x86 — самая строгая, требуя очень сильной модели согласованности, которая не предоставляет большого места для оптимизации. Один момент, о котором нужно помнить при обсуждении моделей памяти — разница между согласованностью и атомарностью. Хотя они связаны, это не одно и то же и не гарантируется во всех случаях.
Лучший способ объяснить различия в моделях памяти — начать с того, как это работает на x86. Так как TSO очень строгая в своём поведении, программист может предположить, что когда происходит сохранение в памяти, это будет видно согласованно всем остальным процессорам в системе. Это также означает, что когда происходит загрузка из памяти, все сохранения до неё «логически» завершены или, по крайней мере, видны. Это соответствует ожиданиям программиста: вы пишете в память, это становится видно в момент записи, так как это интуитивно при программировании. Сохранения фактически упорядочивают видимость загрузок, откуда и берётся название модели. Есть некоторые нюансы в том, как это работает, но они не обязательны для понимания.
Слабая модель памяти ARM работает менее интуитивно. По умолчанию обычные загрузки и сохранения в памяти ARM не строго согласованы между процессорами в системе, позволяя CPU работать более эффективно большую часть времени. Когда выполняется инструкция сохранения, этот фрагмент памяти (кэшлиния) не сразу становится видным другим процессорам в системе. Это экономит драгоценную мощность и эффективность, потому что в аппаратуре дорого инвалидировать кэшлинии других ядер или позволить им снимать кэши другого процессора. Также, если один процессор загружает данные из памяти, которую записал другой процессор, нет гарантии, что эта загрузка даже увидит обновленную память. Звучит так, как будто это вызовет значительные проблемы в многопоточном приложении, верно? Старые версии ARM (ARMv7 и старше) использовали инструкцию барьера памяти для обеспечения упорядочения, что имело значительные последствия для производительности.
Чтобы обойти это ограничение согласованности, ARM также представил load-acquire и store-release инструкции доступа к памяти. На языке C++ это соответствует std::atomic memory_order_acquire и memory_order_release соответственно. В терминологии ARM эти инструкции технически не считаются атомарными операциями, но программисты их путают. FEX использовал термины atomic-load и atomic-store для обозначения одного и того же! Различие обычно не имеет значения, но при обсуждении этих тем может быть лучше быть педантичным.
Основной вариант использования этих инструкций — принудить упорядочение памяти между этим классом инструкций. ARM называет это моделью "Release Consistency sequentially consistent (RCsc)". Не углубляясь слишком в детали того, как работает эта модель, суть в том, что инструкции load-acquire должны быть наблюдаемы последовательно без переупорядочивания, и инструкции store-release тоже, при этом обеспечивая семантику "barrier-ordered-before". Это убирает дорогостоящую инструкцию барьера памяти, необходимую в старых версиях архитектуры ARM.
Скромные начала ARMv8.0-a
Здесь начинается наша отправная точка в ARMv8.0-a, когда эмулируем модель памяти x86-TSO. Мы превращаем все x86 загрузки из памяти в ARM инструкции load-acquire, а x86 сохранения в памяти — в инструкции store-release. Это даёт FEX фактически ту же семантику памяти, что и x86, хотя на самом деле мы более строгие, чем необходимо. Это потому, что у нас не было золотой середины, которая точно соответствует поведению. Как можно подумать, эмулировать TSO этими инструкциями чрезвычайно дорого, и у нас есть микробенчмарки, которые это показывают. ARM CPU не были спроектированы с расчётом на то, что эти относительно редкие инструкции acquire/release вдруг станут подавляющим большинством выполняемых инструкций.
Начнём с чего-то простого и используем микробенчмарк, который довольно дружелюбен к аппаратуре. Нет хитрых граничных случаев, просто доступ к памяти в обычном случае. Это дает нам некоторые базовые цифры для того, чего должна достичь аппаратура.
Давайте разберём этот график, так как он рассказывает нам несколько интересных историй. Колонки Load и Store для каждой машины представляют базовый показатель производительности, который аппаратура должна пытаться достичь. Они не пытаются максимизировать пропускную способность памяти каждой системы, но выполняют одно и то же количество работы для каждого типа операции. Если обратить внимание на результаты acquire-load, видно, что из пяти протестированных CPU три из них испытывают значительное снижение производительности при использовании acquire-load! Кроме того, видно, что CPU AmpereOne имеет инструкции release-store, которые поразительно низкие по сравнению с другими результатами, а загрузки M1 Acquire/LRCPC заметно ниже базовых.
Результаты AmpereOne в частности демонстрируют, насколько плохим может быть этот устаревший путь. Эти инструкции никогда не предназначались для использования таким образом. Использование семантики acquire-release для каждой загрузки при эмуляции x86 фактически налагает действительно строгие ограничения на ARM CPU в том, что инструкции загрузки больше не могут быть переупорядочены вообще. Таким образом, когда у вас миллионы их в полёте в секунду, производительность не очень хороша. Но поскольку это были единственные инструкции, которые у нас были с ARMv8.0-a, это было то, что мы должны были использовать. Хотя Cortex-X4 и Cortex-X925 имеют отличную производительность для этих инструкций, видно, как Oryon-3 уменьшил их приоритетность.
Куда дальше?
Давайте подробнее посмотрим на инструкции LRCPC-load, которые обязательны с ARMv8.3. Это расширение добавляет множество новых инструкций загрузки в ARM ISA и добавляет новую модель памяти поверх ARM RCsc модели из раньше. Эта новая модель памяти "Release Consistency processor consistent (RCpc)" — это то, чего мы хотели! Это расширение разработано с учётом требований, которые требует эмуляция x86, и ожидается, что оно будет активно использоваться на аппаратуре, которая его реализует. Как видно из графика, почти все платформы имеют свои LRCPC-load, соответствующие обычным загрузкам по производительности.
С этим новым расширением, которое обязательно в новых версиях ARM, мы фактически получаем решённую производительность памяти. По крайней мере, согласно этому микробенчмарку это так. Когда FEX обнаруживает это расширение, мы полностью прекращаем использовать инструкции Acquire-Load и переходим к LRCPC-Load вместо этого. Но что происходит с результатом Apple M1..?
Здесь нужно похвалить путь Apple к решению этой проблемы. Со своими процессорами Apple Silicon они напрямую добавили поддержку модели памяти x86-TSO. Когда функция CPU включена, их обычные инструкции загрузки/сохранения ARM меняют поведение, чтобы соответствовать тому, что требует x86. Они пошли по этому пути, зная, что им потребуется высокопроизводительное решение для их аппаратуры при переходе на экосистему ARM исключительно. Вот почему на их аппаратуре инструкции LRCPC-load фактически являются псевдонимами их инструкций acquire-load, потому что их эмулятор x86 даже не использует эти инструкции! Поскольку они реализуют модель памяти x86, они просто используют обычные инструкции load/store, что видно в результатах нашего микробенча как неразличимые накладные расходы на производительность. Справедливости ради других платформ, этот переключатель режима TSO на уровне потока имеет некоторое влияние на производительность, мы просто не видим это здесь. Когда FEX обнаруживает эту функцию CPU из Asahi Linux, мы также это включим и получим «бесплатное» улучшение производительности. Потенциальная проблема заключается в том, что при переключении между эмуляцией x86 и кодом ARM, код ARM будет нести ненужные накладные расходы из-за того, что все его доступы теперь TSO. Хотя это разумная проблема, количество нативного кода ARM, выполняемого под эмуляцией, близко к 0%. Как разработчик, вы не беспокоитесь о том, что 1% доступов к памяти становится на 10% медленнее, вас волнует, что 99% доступов становятся 15% от «идеального» (как показано в результатах AmpereOne).
Заметим, что мы считаем режим TSO лучшим путём вперёд для обеспечения высокопроизводительной эмуляции x86 на платформе. Потому что это гарантирует, что каждая инструкция доступа к памяти ведёт себя так, как мы хотим или ожидаем. Это видно официальным расширением FEAT_LRCPC, которое фактически имеет три версии, применяющие пластыри к реализации каждый раз.
- FEAT_LRCPC — добавляет базовые GPR TSO инструкции загрузки
- FEAT_LRCPC2 — добавляет небольшое смещение immediate к TSO инструкциям загрузки
- FEAT_LRCPC3 — добавляет базовые вектор и стек-ориентированные TSO инструкции загрузки и сохранения
Даже с этими тремя расширениями есть граничное поведение, которое не может быть эмулировано так красиво, как если бы у нас был переключатель аппаратуры TSO. Мы ожидаем, что в будущем будут дополнительные версии расширений, пытающиеся исправить некоторые из дополнительных проблем, которые мы обсудим позже в статье.
Я думал, доступ к памяти — это просто?
В предыдущем разделе мы были добры к аппаратуре ARM и играли по её подразумеваемым требованиям выравнивания, чтобы получить базовое представление о том, какой должна быть производительность. Однако при эмуляции x86, мы сразу же натыкаемся на очевидную проблему. Ваши любимые приложения x86 не заботятся о выравнивании! Они будут обращаться к памяти как им угодно, пересекая границы кэшлиний, выполняя атомарные операции, которые не выровнены. Если вы думаете о проблемах выравнивания, эти игры их делают. Проблема настолько серьёзна, что у нас есть термин для неё — split-lock. Это настолько важно, что даже ядро Linux захватывает, когда это происходит, и замедляет игры! Заставляя многих геймеров возиться с параметрами ядра, чтобы избежать замедления!
Но мы не будем говорить о полных split-lock пока, давайте начнём просто с инструкций load-store в окружении, которое не заботится о выравнивании. x86 делает определённые гарантии программисту; если вы делаете load-store и это находится внутри кэшлинии, то этот load-store будет и атомарным и всё ещё соответствует модели согласованности, как описано раньше. Однако, чтобы быть немного добрее к разработчикам аппаратуры, если load-store пересекает кэшлинию, данные не атомарны и другие потоки могут и будут видеть разрыв. Так что программисту нужно быть осторожным, так как базовый load-store не является split-lock.
Проблема эмуляции этих базовых доступов с load-acquire/store-release в том, что ARMv8.0 требует так называемого естественного выравнивания. Это означает, что для любого размера доступа к данным смещение в памяти должно соответствовать размеру. Итак, для 8-байтового доступа, он должен быть на смещениях; 0, 8, 16, 24 и т.д. Это хорошо работает для нативных приложений ARM, но что происходит, когда мы не соблюдаем требования естественного выравнивания? Для ARM это означает, что инструкция вызовет ошибку выравнивания. Аппаратура проверяет, что требования выравнивания соблюдены, и если нет, то CPU вызовет ошибку. Это обычно приводит к краху, но FEX делает специальную обработку.
Внутри механизма JIT FEX отслеживаются инструкции load-store памяти, которые эмулируют x86 load-store. Когда мы знаем, что load-store может вызвать ошибку выравнивания, у нас есть то, что известно как patchpoint в коде. Для инструкций load-store это выглядит как инструкция NOP либо до, либо после load-store. Когда ошибка выравнивания происходит в одной из этих точек, FEX захватит ошибку, пропатчит код с инструкции load-acquire/store-release на базовый эквивалент load-store, и обёрнет инструкцию в барьер памяти данных. Затем продолжит выполнение!
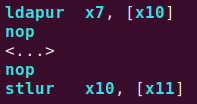
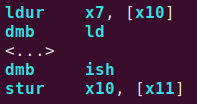
До и после патчирования
Всё это обсуждение от раньше о том, как ARMv8.0-a добавил эти новые модные инструкции load-acquire, store-release? Мы сразу же откатываемся к классической инструкции барьера памяти вместо этого, когда поведение выравнивания не совпадает. Наш предыдущий график не показал этот плохой случай, поэтому давайте принесём свежие данные.
О, это много данных для разбора. Хорошо видеть, как далеко аппаратура от «оптимального» пути при эмуляции TSO, но это не то, что нас интересует здесь. Интересно заметить, что этот микробенч не показывает большой разницы между выровненным и невыровненным для обычного load/store, поэтому мы просто рассчитали среднее между ними. Мы будем убирать x86 CPU и обычные данные load-store из колонок ARM, так как это не обычные пути FEX. Таким образом, у нас будет более целевой взгляд на то, как плохо невыровненные доступы к памяти влияют на производительность под эмуляцией.
Теперь, когда у нас есть более разумный график данных, давайте пройдёмся слева направо и обсудим, что происходит.
AmpereOne
Это очень интересно, как выровненные, так и невыровненные инструкции загрузки примерно эквивалентны и находятся в пределах шума. Это означает, что хотя невыровненные загрузки получают штраф барьера памяти данных, CPU просто с этим справляется. Это может быть случай, когда бенчмарк ограничен другими вещами, учитывая, насколько намного ниже производительность по сравнению с другими платформами.
Тем временем сторона сохранения не выглядит хорошо даже без невыровненности. Это почти невидимо на графике! При попадании на невыровненные сохранения мы смотрим на ~8.5% падения производительности, но так как мы уже начинаем настолько низко, это трудно заметить. Это также в резком контрасте с обычными инструкциями сохранения, получающими ~28GB/s в этом тесте.
Единственный вывод, который мы можем сделать, это то, что Ampere оптимизирует для некоторой серверной рабочей нагрузки и не совпадает с поведением потребительского оборудования. Это интересная точка данных, но наши пользователи обычно не запускают игры на этом классе оборудования.
Cortex-X4
Это очень популярное ядро CPU, которое находится внутри Qualcomm Snapdragon 8 Gen 3. Мы тестировали только это одно ядро из SoC, чтобы не перегружать график данными. Довольно большое количество портативных консолей поставляются с этим, поэтому это интересная цель. Это CPU фактически работает удивительно хорошо, учитывая, что это единственная сотовая SoC в этом списке. В целом это ядро соответствует тому, что мы ожидали от него, и тенденции графика следуют с готовящейся к выпуску Cortex в этом графике.
Основные темы для этого CPU в том, что её выровненные загрузки и сохранения достаточно мощные, получая примерно 11.5GB/s и 6.7GB/s соответственно. Интересно то, что падение производительности, когда ей нужно иметь дело с невыровненным loadstore, попадает на инструкции DMB, штрафует ядро примерно одинаково между загрузками и сохранениями примерно на 50% в этом бенчмарке.
Это似ave подразумевает, что CPU может держать приличное количество LRCPC-release loadstore в полёте, поэтому инструкции DMB больше больно, когда они встречаются, но это не вызывает апокалипсис производительности. Просто то, что 50% падение производительности из-за выравнивания — не потрясающий результат.
Cortex-X925
Следуя за X4, давайте остановимся в DGX Spark и его ядрах X925. Это не только новое ядро CPU от ARM, оно работает на системе с драматически большей пропускной способностью памяти. 273GB/s на платформе против предыдущих 76.8GB/s. Это означает, что мы получаем довольно похожие результаты на X4, только график масштабируется немного выше. Интересно достаточно, штраф за производительность для невыровненных доступов примерно совпадает с X4. Хотя выглядит, что сохранения могут восстановиться немного быстрее, вероятно из-за более быстрой памяти. Никаких сюрпризов, просто последовательно совпадающая производительность по поколениям.
Oryon-3
Этот дизайн ядра CPU только что вышел из пресса Qualcomm. Поддержка Linux всё ещё находится в процессе приготовления, но уже хороший показ. Наиболее интересный результат из этого фактически исходит из того факта, что выровненные LRCPC-load инструкции совпадают с производительностью обычных загрузок! Это означает, что в случае хорошо себя ведущего приложения, мы можем обычно ожидать полную производительность. Это продолжается к инструкциям release-store, будучи достаточно способными, хотя это не совсем совпадает с обычным сохранением с только 68% пропускной способности. Не плохой показ вообще.
Это CPU также не может избежать штрафа за невыровненные LRCPC-release loadstore. Сторона загрузки примерно совпадает с штрафом Cortex-X925 ~70% производительности, вероятно потому, что Snapdragon X2 Elite также имеет тонны пропускной способности. Но сторона сохранения фактически переносит немного хуже на ~43% производительности. Даже с этими штрафами производительности за невыровненные доступы, эта платформа фактически быстрее, чем выровненные доступы из предложений Cortex.
Одна из странных вещей об этой платформе в том, что она была рекламирована как имеющая "Fully coherent 96KB 6-way L1 cache with 64B coherency granules." Что к нашему чтению подразумевало, что невыровненные доступы должны иметь драматически меньше влияния на производительность. Интересно… помните это.
Apple M1
Это большой, о котором нужно поговорить. Это то, что было изменением игры, это был «момент Apple». Это показало всем, что ARM был не только осуществим, это мог быть быстрее. Эти цифры на этом графике удивительны и это результат Apple, вставляющей модель памяти TSO напрямую в их аппаратуру. Вместо использования LRCPC-release доступов для этого, мы просто включили их функцию TSO и выровненные версии фактически совпадают с невыровненной версией. Может быть 5% падение производительности на сохранениях? По сравнению с каждым другим устройством на этом графике, это фактически ничего. Это в основном исходит из того, что невыровненные доступы больше не требуют инструкций DMB для обратного патчирования в код, так как аппаратура просто это обрабатывает напрямую.
Для нас это то, что означает отнестись к эмуляции x86 серьёзно на ARM и это действительно показывает, что Apple заботилась, чтобы её клиенты имели хороший опыт запуска ПО как нативно, так и эмулированно. Они увидели проблему и просто её решили, сделав её исчезнуть. При этом, когда режим TSO включен, вы получаете падение производительности. Сравнивая с предыдущим графиком, это только получает 76% обычной производительности сохранения, и производительность загрузки фактически совпадает; это намного более допустимо выносить, когда всё настолько быстрее.
Подведение итогов невыровненных LRCPC/release доступов
Подводя итоги этого раздела, нужно поговорить об одном из улучшений производительности, которое все эти поставщики фактически поддерживают. Это расширение, которое ARM создал, называемое FEAT_LSE2, которое все протестированные платформы реализуют. Мы ранее говорили о том, как acquire/LRCPC/release доступы памяти требуют естественного выравнивания, чтобы не навлечь гнев CPU, поднимающей ошибки выравнивания. ARM фактически подумал об этой проблеме и реализовал это расширение, которое помогает эмуляции x86 (и вероятно другим рабочим нагрузкам). Это расширение ослабляет требования выравнивания не только acquire/LRCPC/release инструкций load store, оно также ослабляет требование для read-modify-write атомарных операций!
Звучит всё хорошо и хорошо, но вот укус в зубы: это означает, что это обеспечивает только маргинальные улучшения производительности для эмуляции x86. Это расширение только ослабляет требования выравнивания, чтобы позволить невыровненные доступы внутри 16-байтовой гранулы. Любой доступ, который пересекает эту 16-байтовую гранулу, всё ещё получает ошибку выравнивания. Приложения x86 действительно не заботятся о выравнивании их доступов к памяти, поэтому мы получаем невыровненные доступы по всей кэшлинии. Только read-modify-write атомарные операции пытаются избежать пересечения кэшлинии на x86!
Итак, спасибо за попытку, приятно видеть, но это действительно не двигает иглу. Так как мы уже говорим об этом, давайте погрузимся в эти RMW атомарные, верно?
О нет, что это за атомарные инструкции?
Как большинство современных наборов инструкций, x86 поддерживает атомарные операции памяти. Это инструкции, которые выполняют ALU операцию на данных в памяти атомарно, не позволяя никакому промежуточному состоянию быть видимым. В терминах x86 это работает на памяти, которая одновременно атомарна и согласована, в то время как ARM позволяет вам выбирать быть только атомарным или одновременно атомарным и согласованным. Мы коротко касались этого раньше, но фактически есть разница между работой с данными атомарно и согласованностью этих данных. Какая разница это делает?
Для всех предыдущих x86 дискуссий модели памяти мы говорили о последствиях согласованности загрузок и сохранений, видимых другим процессорам в системе. Что мы полностью пропустили — это требования атомарности этих доступов памяти. В мире x86, загрузка или сохранение обычно завершается атомарно даже когда невыровнено. Это означает, что если вы сохраняете 8-байт данных, и другой поток загружает эти 8-байт в условиях гонки, он никогда внезапно не увидит смешивание данных от раньше сохранения и после сохранения. В ARM эти гарантии атомарности значительно слабее, означая, что если вы выполняете невыровненную инструкцию сохранения, спецификация ISA имеет нулевые гарантии о чтении разрыва в данных. К счастью для естественно выровненных инструкций load-store, ARM имеет спецификацию, называемую "single-copy atomicity", которая гарантирует, что вы не получите разрыв для этих доступов. Также хорошие новости; что эта FEAT_LSE2 расширение из раньше? Это фактически расширяет гарантии single-copy atomicity на любой невыровненный доступ внутри 16-байтовой гранулы! Минус в том, что x86 имеет гарантии single-copy atomicity по всей кэшлинии, поэтому в очередной раз расширение всё ещё не решило что-либо полностью, просто уменьшило количество случаев.
Достаточно о разницах в атомарности и согласованности. Где фактические атомарные инструкции? Что они делают? Начиная с ARMv8.1-a, наша ISA приобрела инструкции, которые в основном совпадают с поведением атомарных инструкций x86. Давайте просто дадим полный список, чтобы показать, как они прямо соответствуют в нашем JIT.
| x86 | ARMv8.1-a |
|---|---|
| LOCK DEC | ldaddal |
| LOCK INC | ldaddal |
| LOCK NEG | ??? |
| LOCK NOT | ldeoral |
| LOCK ADC | ldaddal |
| LOCK ADD | ldaddal |
| LOCK AND | ldclral |
| LOCK OR | ldsetal |
| LOCK SBB | ldaddal |
| LOCK SUB | ldaddal |
| LOCK XADD | ldaddal |
| LOCK XOR | ldeoral |
| LOCK BTC | ldclralb |
| LOCK BTR | ldeoralb |
| LOCK BTS | ldsetalb |
| LOCK CMPXCHG | casal |
| CMPXCHG8B | caspal |
| CMPXCHG16B | caspal |
Ну посмотрите на это, у нас есть полный список 18 атомарных RMW операций и они фактически прямо соответствуют некоторым ARM инструкциям. Игнорируйте сомнительную, так как она не используется в реальных рабочих нагрузках и мы заходили бы слишком далеко в детали, говоря о ней. У нас есть довольно чистое соответствие 1:1 между архитектурами, работа сделана, верно? Вот смешная вещь об эмуляции x86, просто потому что у нас есть эти инструкции, не означает, что мы можем их подключить без проблем. Мы потратили всё это время, говоря о том, как невыровненные доступы могут действительно навредить производительности обычных загрузок и сохранений, эта же проблема также применяется к RMW атомарным операциям!
С этим графиком, мы смотрим на одну атомарную инструкцию с её адресом памяти, приземляющимся где-то внутри кэшлинии. Если бы мы включили все данные для всех 18 атомарных операций, то эти данные были бы даже более ошеломляющими, чем они уже. Все эти атомарные операции ведут себя примерно эквивалентно, поэтому это было бы избыточно и не имело бы значения для того, что мы обсуждаем здесь. Это также первый график в этом посте, который фактически использует логарифмическое масштабирование, так что при чтении убедитесь, что вы понимаете, что разница производительности от самого быстрого к самому медленному результату находится на масштабе примерно 1000x.
Начиная с процессора x86 Zen на этом графике; это результаты, которые наша эмуляция должна стремиться достичь. Как видно, если доступ полностью содержится в кэшлинии, то задержка инструкции одинакова в 1.44ns. Это может быть объяснено x86, имеющей "atomic cachelines" или "coherent cachelines", где, пока невыровненная атомарная операция остаётся в кэшлинии, она примерно стоит одинаково. Это действительно мощная функция x86, которая поддерживается десятилетиями, поэтому игры в итоге на неё полагаются, даже не осознавая этого. Выдающийся результат для x86 — это последний результат, пересекающий 64-байтовую гранулу и занимающий ~660ns! Это удивительно медленный результат на ~458x медленнее по сравнению с другими результатами, потому что это наконец-то аппаратура, использующая split-lock.
Нам нужно выкрикнуть статью, которую Chips and Cheese написали, пока мы готовили писать нашу статью. Они делают глубокий разбор в то, почему эти split-lock настолько драматично медленнее и стоит чтения, если вы не знаете, как они работают. Конкретно, нам нужно упомянуть, что x86 split-lock сохраняют требования атомарности и согласованности x86-TSO и никогда не разорвут данные даже при пересечении кэшлинии. Это какой-то сумасшедший и мы объясним это более подробно позже.
Теперь для наших процессоров ARM, давайте начнём с числа задержки естественного выравнивания. Как видно, все наши платформы работают достаточно хорошо, но даже самые последние ядра не приближаются к x86. Даже наша самая быстрая платформа ARM составляет ~3x задержка по сравнению с x86; это напрямую влияет на производительность игр, но обычно не является прямым узким местом, поэтому трудно измерить точно, насколько. Продолжая к следующей точке данных, мы фактически можем объединить результаты для 16-байтовой гранулы и пересечения 64-байтовой гранулы с большинством наших платформ ARM. Из-за того, как спецификация ARM определяет работу невыровненных атомарных операций, оба этих результата примерно эквивалентны и FEX их обрабатывает так же, как проблему x86 split-lock.
Мы постоянно вспоминаем эту проблему split-lock, но как точно FEX их эмулирует и что делает это так медленным? "Я думал, Apple M1 добавил поддержку x86-TSO в аппаратуру, почему это всё ещё медленно?" Если вы вспомните, как мы упомянули раньше, что FEAT_LSE2 введена поддержка невыровненных доступов памяти в пределах 16-байтовой гранулы; эти операции split-lock в итоге попадают на те же проблемы выравнивания, как раньше, но драматично медленнее. FEX не может обратно пропатчить любую из этих инструкций, чтобы просто выполнить операцию DMB, поэтому мы вызываем alignment-fault каждый раз, когда одна из этих операций split-lock выполняется. Это означает, что мы делаем ядро -> пользовательское пространство signal handler -> ядро -> оригинальный код танец. каждый—отдельный—раз одна из этих операций split-lock выполняется. Прыганье между пространством ядра и пользовательским пространством медленно на каждой платформе и когда вы выполняете тысячи их в секунду, это добавляется очень быстро. Вот почему эмуляция этого признака так ужасно медленно на ARM.
Одна платформа ARM сегодня фактически частично решила эту проблему, хотя. Ядра CPU Oryon-3 ввели то, что они рекламировали как "coherent cachelines" и мы можем видеть это в результатах нашего микробенчмарка здесь. Как и с x86, если атомарный доступ памяти находится где-то внутри 64-байтовой кэшлинии, производительность совпадает с версией естественного выравнивания! Это огромное улучшение, которое означает, что CPU совпадает с x86 в поддержке функции до момента, когда это пытается пересечь кэшлинию. Мы должны похвалить Qualcomm за реализацию этой функции, так как она решает крупную проблему производительности и корректности вокруг split-lock для эмуляции x86. Аппаратура всё ещё не поддерживает 64-байт split-lock, поэтому мы всё ещё падаем вниз путь эмуляции FEX в том экземпляре, хотя.
Продолжая результат Apple; даже хотя они добавили доступ памяти x86-TSO в свою аппаратуру по какой-то причине они пренебрегли реализацией полного кэшлинии невыровненных атомарных, как Oryon. Выглядит, как они должны были ожидать, что этот граничный случай появится и реализовать его, но это просто спекуляция. Вот почему вы видите пересечение 16-байтовой гранулы, ведущее себя так же, как другие платформы, даже с переключателем аппаратуры TSO включённым.
Вы могли также заметить другой маленький извращение данных в графике. У нас есть звёздочка на результате Cortex-X4 в этом бенчмарке и производительность невыровненных атомарных драматично быстрее, чем значительно новые CPU. Каким-то образом это управляет иметь только ~209ns задержку, в то время как X925 задержка составляет 1060ns; это 5x улучшение производительности! Как это может быть возможно? Это фактически некая весёлая "special sauce", которая отправляется на платформе, которую мы тестируем, которая конечно же — Valve Steam Frame. Потому что Valve заботится о производительности своего существующего каталога игр, они отправляются с патчем ядра, который один из разработчиков FEX создал. Это позволяет самому ядру Linux обрабатывать невыровненный атомарный без этого медленного танца с FEX и пользовательским пространством, позволяя ему быть драматично быстрее. Если другие платформы хотят отправить этот патч в ядро, то мы рекомендуем его подобрать, так как FEX автоматически начнёт его использовать.
Говоря об интервенции ядра, нам нужно поговорить о том, как эмуляция split-lock фактически не совсем корректна под FEX из-за ограничений в аппаратуре. Чтобы реализовать эту обязательную функцию x86 корректно, любой раз, когда мы выполняем 16-байт или 64-байт split-lock, единственный способ обработать это — иметь реализацию ядра функцию. Прямо сейчас FEX это реализует как "best-effort" попытку, которая может фактически разорвать данные в некоторых случаях. Вы вспомните, что раньше мы сказали split-lock на x86 никогда не разорвут, верно? Даже Oryon-3 с его "coherent cachelines" не решили эту проблему ещё.
Что вы имеете в виду, split-lock является обязательным?
Реализация эмуляции split-lock с современной аппаратурой ARM в исполнительном вопросе фактически действительно трудна. Наивная реализация — это использовать глобальный мьютекс и когда возникает split-lock, мы убедимся, что захватываем мьютекс перед выполнением операции. Это означает, что любая операция split-lock участвующая будет проходить через этот мьютекс. Это корректно кроме проблемы, что любая выровненная атомарная операция не является split-lock и не будет участвовать. Из-за кода эмуляции split-lock, необходимого быть реализованным как два 64-битные операции compare-exchange, каждая половина переходящая границу гранулы, мы можем получить разрыв с не-участвующей атомарной всё ещё. Тривиальный пример — один поток постоянно изменяющий атомарное в середине кэшлинии, и затем другой поток изменяющий только целое число на одной половине. Это может звучать как надуманный пример изначально, но есть lock-less реализации связанного списка, которые ведут себя точно вот так! В зависимости от того, какую половину изменяет выровненный поток, либо первый, либо второй CAS в коде split-lock потерпит неудачу. Если первый CAS потерпит неудачу, то это безопасно и код может повторить попытку, если второй CAS потерпит неудачу, это означает, что данные разорваны и мы можем ничего не делать, но надеяться, что это не повредит данные и не упадёт. Это полностью будет зависеть от алгоритма, который приложение-гость использует, поэтому мы не контролируем это.
Альтернативный подход, который полностью неудобен — это иметь отслеживание ядра всех процессов и потоков, которые делятся памятью друг с другом, затем когда поток должен эмулировать split-lock, ядро может остановить каждый процесс, который делится памятью с этим процессом, выполнить split-lock в изоляции, и затем перезагрузить мир. Последствия производительности этого подхода не жизнеспособны. Приложения и игры могут в конечном итоге выполнять тысячи или больше split-lock в секунду и остановка мира будет иметь неуправляемый удар производительности, который драматично хуже, чем даже x86 нативный.
Если мы хотим обеспечить корректность в эмуляции split-lock, FEX требует поддержки аппаратуры в какой-то форме. Хотя мы не говорим, что все атомарные операции теперь должны поддерживать split-lock, как x86, это также не было бы жизнеспособно. Хорошие новости — ARM фактически имеет расширение для этого, которое делает ровно то, что мы хотим. ARM имеет расширение вызовите Transactional Memory Extension, которое могло бы решить нашу проблему. Это расширение позволяет нашему коду выполнять некоторое количество операций внутри трансакционного региона, затем commit эту работу атомарно; если commit операция потерпит неудачу, затем мы можем просто повторить попытку. Минус этого расширения? ARM официально пренебрегло расширением и никто когда-либо это не отправил. Это вероятно для лучшего, так как версия x86 расширения имела избыток проблем, которые привели к отключению его на многих платформах.
Итак, нам требуется что-то другое, чтобы эмулировать split-lock корректно. Для решения, которое мы верим работает для потребностей как FEX, так и поставщиков ARM, мы придумали идею, что 128-битная инструкция CASP может быть дана способность иметь каждую половину CASP совершенно переходить границу атомарной гранулы, 64-биты на нижней половине, и 64-биты на верхней половине. Затем только в этом случае инструкция не поднимает alignment-fault и пытается выполнить операцию CAS. Это работает, потому что x86 имеет только до 64-битной невыровненной атомарной операции, поэтому обе половины операции могут всегда быть полностью закрыты нашей одной операцией.
Но вы можете спросить себя, "как это любой лучше, чем аппаратура просто поддерживающая split-lock?" Это хорошая мысль и нам требуется быть осторожным с тем, как ровно мы описываем эту операцию. Для x86 их атомарные операции должны всегда успешны без разрыва. Для нашего эмулированного подхода, мы можем иметь эту ARM инструкцию CASP потерпеть неудачу безопасно и затем мы можем попробовать снова. Это один из преимуществ CAS, что операция может потерпеть неудачу по любой причине и она должна быть повторена. Инструкция затем также возвращает данные, которые она загрузила из памяти в то время, поэтому программа имеет самые свежие обновлённые данные памяти. Это важное различие, так как это означает, что FEX может повторить операции CAS бесконечное количество раз, пока это неизбежно не преуспеет! Это преимущество архитектуры LL/SC ARM, которая фактически позволяет этому работать. Хитрая вещь в том, что аппаратура действительно требует гарантии прогресса в какой-то момент, но она уже имеет поддержку для этого по другим причинам, поэтому это полностью жизнеспособно! Единственный вновь добавленный режим отказа инструкции CAS чисто, если одна из двух кэшлиний получена другим ядром перед тем, как это мог бы выполнить полную операцию. Даже если аппаратура всё ещё требует до пары тысяч циклов, чтобы гарантировать прогресс, это фактически совпадает с поведением x86.
Мы думаем, это было бы лучший способ вперёд для эмуляции x86 split-lock на платформах ARM, но мы не архитекторы аппаратуры, поэтому всё, что мы можем сделать — это жаловаться и надеяться, что кто-то это решит для нас. Мы оставим дискуссию split-lock там сейчас, поэтому мы можем двигаться дальше к другой интересной проблеме.
Подождите, некэшированная память должна работать?
Перед тем как мы входим в эту тему, мы должны поговорить о термине "uncached" потому что это может означать пару вещей в зависимости от вашей точки зрения мира. Для целей этой статьи, мы используем терминологию Vulkan, потому что мы в основном заботимся об играх. В терминах Vulkan у нас есть VK_MEMORY_HOST_CACHED_BIT, которое означает, что хост CPU кэширует эту память. Отсутствие этого бита — то, о чём мы заботимся здесь, и то, что мы называем "uncached." Относительно того, что это означает для подсистемы памяти, это становится немного более сложным, чем вы бы подумали. В частности, когда память живёт на GPU, потенциально над PCIe, когда память "uncached", она также обычно (но не всегда!) также получит флаг VK_MEMORY_HOST_COHERENT. Это означает, что из-за некэшируемого свойства памяти, CPU и GPU всегда имеют согласованный мир памяти друг с другом.
Для CPU это обычно означает, что память может быть отображена тремя способами. Когда просит "cached" памяти, это обычно имеет тип памяти Write-back, которое также то, что обычный тип отображения памяти. "uncached" отображение может быть либо Write-Combine или "Strong Uncacheable". Реализация "Strong Uncacheable" фактически не существует для приложений пользовательского пространства, поэтому мы можем игнорировать то для сегодняшнего обсуждения. Это ограничивает нас фактически WB (cached) и WC (uncached) типами памяти. Cached — то, что игры обычно используют для промежуточных буферов, и затем uncached — то, что мы используем, когда передаём данные непосредственно GPU.
Это кодифицировано в многих игровых механизмах, которые, если вы не раскрываете поддержку для типов некэшированных буферов, тогда некоторые не работают. Это исходит из деталей поведения вокруг различий UMA систем, как APU и PCIe GPU. UMA системы обычно раскрывают способность выделять память, которая cached, coherent, и GPU видима. Где PCIe GPU не могут гарантировать то поведение, так что разработчикам игры требуется либо использовать промежуточный буфер и асинхронная копия данных вверх к GPU, или использовать "uncached" память, чтобы очень осторожно переместить данные вверх к GPU через PCIe. Из-за того, как вездесущ PCIe находится с PC игры, некоторые механизмы не будут даже выполнять код пути UMA и будут выполнять некэшированный подход независимо!
С тем маленьким введением в путь, что uncached означает для нас. Давайте принесём бенчмарк для того, как быстро cached память находится на некоторых UMA системах Snapdragon. Это позволит нам получить базовую линию для того, какой должна быть производительность обычно.
Для обоих Steam Frame и Snapdragon X2 Elite, это некоторые действительно хорошие результаты. Как мы ожидаем, платформа Oryon-3 имеет большую пропускную способность памяти, поэтому она может масштабироваться выше в графике, но обе попадают на десятки гигабайт в секунду в результатах. Этот график устанавливает хорошую базовую линию для того, что "normal" write-back память может достичь. Давайте теперь покажем uncached результаты, чтобы увидеть различия производительности.
Есть странные вещи, происходящие здесь, поэтому мы должны были использовать логарифмическое снова на этом графике. Давайте поговорим о хорошем первым, что появилось. Из-за uncached буферов памяти, будучи write-combine, мы можем видеть, что обычное сохранение для наших платформ ARM совпадает с результатами cached бенчмарков. Это исходит к write-combine памяти, используя то, что монетизировано как write combine buffer, которые фактически очень временно держат вокруг кэшлинию данных, поэтому, что write-combine может взорвать кэшлинию памяти за раз. Интересно достаточно, это выглядит как WCB Zen 4 не может совсем держать шаг с cached, но учитывая, что это ожидается для перехода через шину PCIe, это вероятно хорошо.
Теперь давайте входим в действительно уродливые результаты, которые мы имеем здесь. Начиная с более легко объяснить — это пропускная способность загрузки из write-combined памяти ужасна на всех платформах протестировано. Если мы используем Zen как нашу базовую производительность, затем наши обычные инструкции загрузки ARM выигрываем, но LRCPC загрузки хуже. Что здесь происходит? Это извращение того, как write-combined память функцион, потому что это uncached наши инструкции загрузки требуются выходить из системной памяти для каждого отдельного доступа, чтобы сохранить семантику. Затем когда мы добавляем LRCPC-загрузки вверху того, это просто соединяет проблему дальше. Но наихудший случай из всего этого — это просто как ужасно плохой показатель сохранения, по сравнению к производительности, которую Zen получает на сохранения, это фактически showstopper. Вверх к 816x хуже пропускная способность! Мы имели игры, как Hollow Knight: Silksong и Subnautica 2, работаемые на менее чем 1FPS из-за этого обрыва производительности.
Как мы говорили выше, когда есть PCIe GPU в смешивании, тогда игры требуются использовать uncached память, чтобы передать данные GPU. Когда эмулируемый x86 игры на платформах с выделенным PCIe GPU, затем мы находимся в невыигрывающей ситуации и мы гарантированы бегать драматично медленнее. Помните, как ARM добавил семейство расширений FEAT_LRCPC1/2/3 из раньше, чтобы улучшить эмуляцию модели памяти x86? Это то, что происходит, когда мы попадаем на граничный случай, который не поддержан. Все эти расширения добавляют новые инструкции, чтобы обработать загрузку памяти, используя семантику модели памяти x86-TSO, но ни один из них не решают проблему сохранения write-combine памяти с семантикой x86-TSO. Всё путём из ARMv8.0-a наши инструкции сохранения используют обычные инструкции store-release независимо от типа поддержки памяти. Единственный способ для FEX, чтобы работать вокруг эту проблему — это выборочно отключить эмуляцию TSO, когда это становится проблемой, поэтому платформы эмуляции x86 с PCIe GPU всегда будут хуже опыт, чем UMA. По крайней мере, пока мы не получим другой FEAT_LRCPC4 или похожее, чтобы решить вопрос.
Для пользователей на системах UMA, затем радуйтесь, есть workaround для игр, которые мы используем, чтобы улучшить производительность. Потому что мы знаем, когда платформа поддерживает cache-coherent CPU и GPU комбинаций, мы можем иметь видеодрайвер всегда использовать cached буферы и никогда не встретить эту проблему. NVIDIA уже это делает на их платформ Tegra, Snapdragon поддерживал это с по крайней мере GPU класса Adreno 600, и есть много платформ Mali, где это также случай. Мы имеем Adreno Turnip патч, который убеждает, когда FEX работает, мы никогда не попадаем на uncached память для платформ, которые это поддерживают. Смешная вещь — это то, что, так как пользователи Asahi имеют аппаратный TSO бит, они просто естественным образом не встречают эту проблему в дикой природе, но получение PCIe GPU на то платформу — это другая история вообще. Есть также весёлый извращение, где Radeon GPU на платформах ARM скрывают всю write-combine память, чтобы вместо этого быть write-back, но мы обсудим то другой раз.
Смотря на светлое будущее
После этого марафона статьи, мы надеемся, вы имеете лучшее понимание некоторых из вызовов, которые эмулирование модели памяти x86-TSO приносит. Где мы начали с ARMv8.0 как минимальной спецификации и где аппаратура обеспечила драматические улучшения на протяжении лет в ничто короче, чем потрясающее. Хотя не все граничные случаи пока решены на уровне архитектуры, это выглядит, как есть подлинная обязанность через экосистему для попытки улучшить наихудшие случаи. Мы имеем различные поставщиков, решающих некоторые части проблемы и перемещающих иглу вперёд для лучшей совместимости. Может быть в другом десятилетии, как мы смотрим назад на этот раз, мы будем смеяться над проблемами, которые мы встречали теперь, в то время как получаем удовольствие от качества игр x86, которые никогда не будут видеть порт к аппаратуре ARM. Сохраняя наследие PC игровой экосистемы жива, независимо от того, где мы можем в конечном итоге её воспроизводить.