Похожесть подходов к "производным данным"
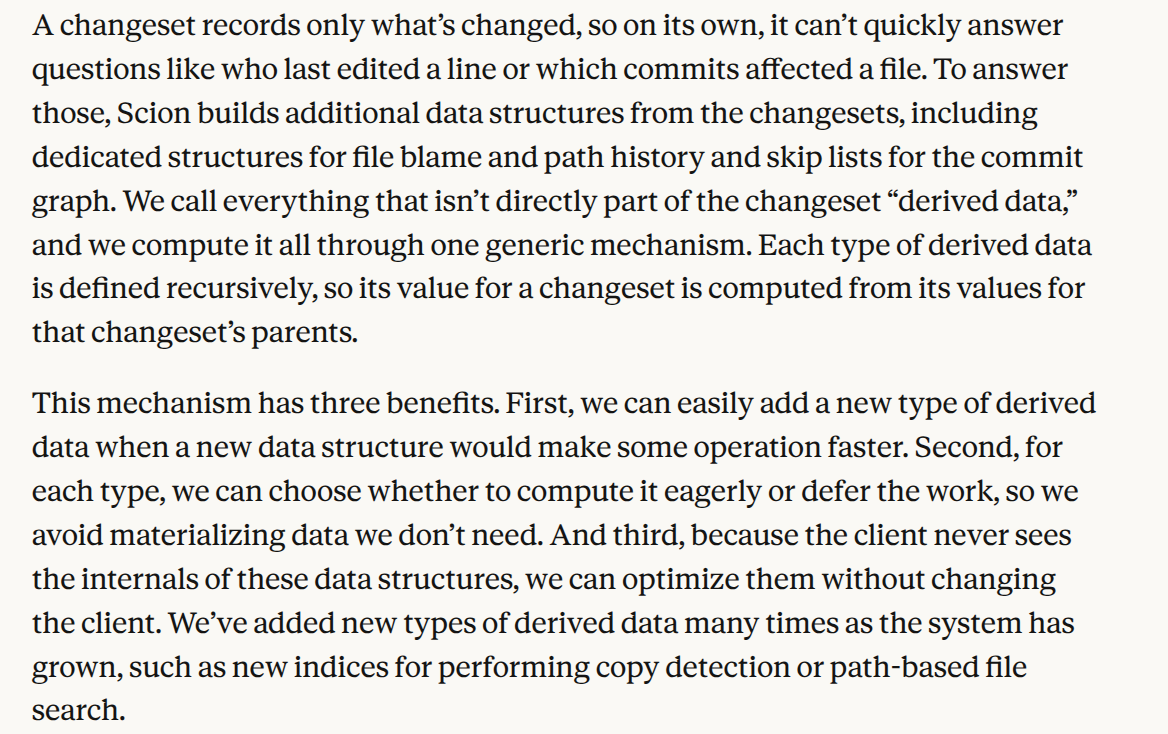
Anthropic описала недавно, как её новая система контроля версий Scion использует концепцию "производных данных" (derived data) для ускорения операций вроде blame и истории изменений файлов:
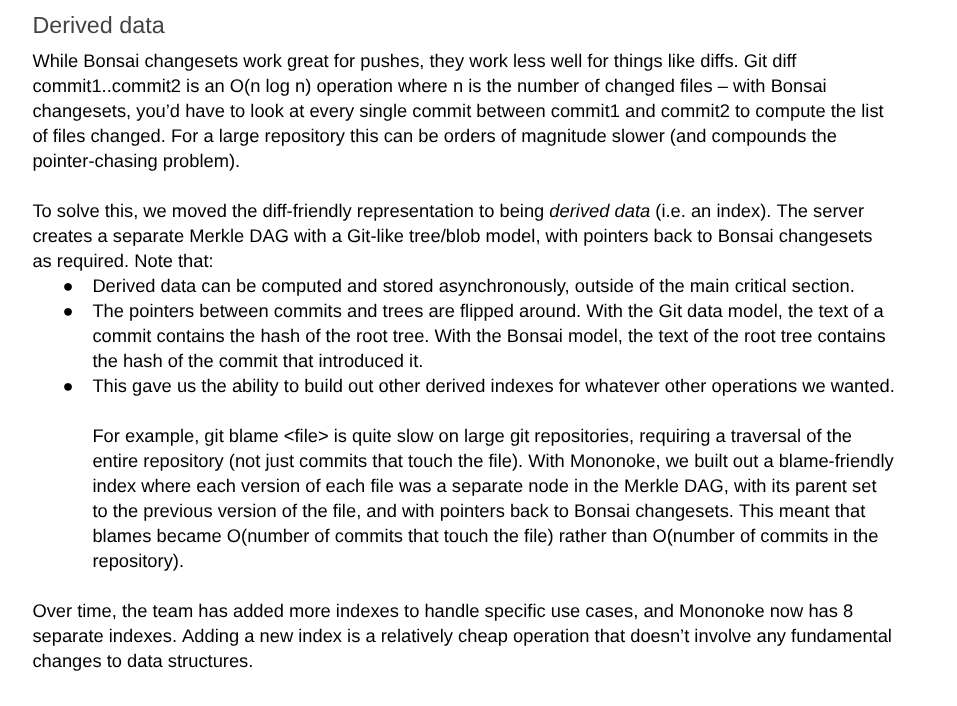
Спустя несколько лет до этого, в 2022 году, разработчик Mononoke — сервера контроля версий, созданного в Meta, — описал аналогичный подход:
Вопрос об атрибуции
Идеи совпадают настолько близко, что это выходит за рамки "похожих инсайтов". Sapling упоминается только как источник "трудно добытых уроков", а Mononoke не упоминается вообще. Это создаёт впечатление, что Claude разработал всю архитектуру самостоятельно — хотя в действительности разработчики Meta пришли к этим решениям на несколько лет раньше.
Концепция производных данных позволяет эффективно хранить индексы для разных операций:
- Каждый тип производных данных определён рекурсивно — его значение для набора изменений вычисляется из значений для родительских наборов
- Система может отложить вычисление производных данных или выполнить его сразу — в зависимости от необходимости
- Поскольку клиент не видит внутреннюю структуру индексов, они могут быть оптимизированы без изменения интерфейса
- В Mononoke со временем появилось 8 отдельных индексов для разных операций — от поиска скопированного кода до поиска по пути файла
LLM и проблема переиспользования идей
Meta открыла Sapling и Mononoke как проекты с открытым исходным кодом, чтобы распространять хорошие идеи. Разработчик не против того, что Anthropic применила архитектуру Mononoke — это естественная эволюция идей. Но есть важный момент: Mononoke есть в обучающих данных каждой LLM.
Когда спросить Claude Opus 5.5 или GPT-6 Astra о предшественниках идеи, обе модели моментально указывают на Mononoke. Это значит, что атрибуция была доступна прямо в контексте разработки.
Вывод простой: сейчас, когда LLM помогают проектировать новые системы и легко проверить исторический контекст, игнорировать предшественников и не давать им кредит — это просто невозможно оправдать технически или этически.