Без потерь
Поддержание справедливого распределения ресурсов между командами — задача не из лёгких, особенно в крупных организациях. Cloudflare обеспечивает баланс благодаря неустанной работе команды Performance.
История началась с заявки, поданной специалистом, который обнаружил: избыточное использование памяти сервисом pingora-ketama в Pingora Backend Router. Оказалось, что внутренний сервис балансировки нагрузки (PBR) потреблял значительно больше памяти, чем ожидалось — особенно в структурах, связанных с pingora-ketama, открытой библиотекой для обработки согласованного хеширования.
Чтобы разобраться с кажущейся избыточностью, нужно понять, что такое согласованное хеширование, почему оно используется в PBR и как оно стало таким памятеёмким. По пути изучим Rust и даже немного математики.
Согласованное хеширование
Согласованное хеширование — широко распространённый метод распределения задач между несколькими серверами таким образом, что добавление или удаление серверов не требует масштабных изменений. Cloudflare использует его для маршрутизации кешируемых запросов на серверы по URL. Это позволяет хранить только одну копию файла в каждом дата-центре и предоставляет стабильный способ определить расположение каждого файла.
Ключевая концепция согласованного хеширования: хеш-функции принимают любой вид входных данных, но их выход ограничен одним целым числом без знака (32, 64 или 128-битное целое число в зависимости от хеш-функции). Это позволяет связать задачи и серверы друг с другом согласованно. Обычно пространство выходных значений представляют как непрерывное круговое кольцо, замыкающееся от максимума к нулю. Такая визуализация удобна, но может сделать простую концепцию целочисленных диапазонов сложнее, чем она есть. Для нашего обсуждения представим выход 32-битной хеш-функции как числовую ось.
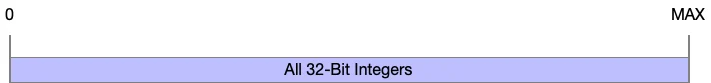
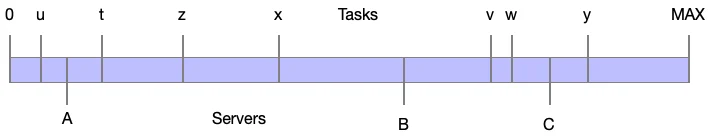
Теперь представим набор серверов A, B и C, и набор задач t–z. Каждый можно разместить на числовой оси на основе хеша их представительных значений — например, IP-адресов серверов и ключей кеша для задач.
Назначение задач серверам — просто нахождение первого сервера слева от каждой задачи. Можно представить это визуально, раскрасив регион хешей, связанный с каждым сервером. Обратите внимание: диапазон сервера C замыкается в начало, откуда и появилась идея о хешах на кольце.
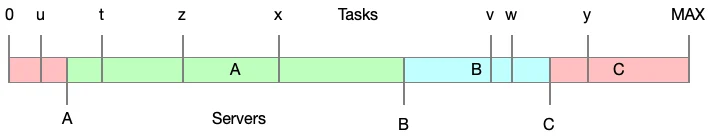
Вот и всё. На базовом уровне согласованное хеширование так просто — но быстро становится ясно, что есть место для улучшений. Заметьте: диапазон сервера A в примере значительно больше, чем у B и C. Это проблема, потому что доля запросов, обрабатываемых сервером, пропорциональна размеру его диапазона на оси. Идеально гарантировать равные размеры для каждого сервера, но поскольку хеши — по сути случайные числа, нужно говорить о размере регионов в терминах статистики.
Математика и последствия
Сначала: не паникуйте. Гарантия — это не обман, и материал останется в пределах базового урока по вероятности. Когда говорим о статистических распределениях, есть два больших фактора для количественной оценки неопределённости полезным способом: математическое ожидание и стандартное отклонение. В упрощённых терминах: математическое ожидание показывает точку, вокруг которой центрируются измерения на основе распределения, а стандартное отклонение говорит, насколько близко к этой центральной точке вероятны большинство измерений.
Для согласованного хеширования можно вычислить эти факторы для доли размера диапазона, связанного с одним из N серверов. (Подробности формулы позже).
В конкретных числах: допустим, 100 серверов. Формулы дают:
Это говорит, что диапазон каждого сервера будет центрирован вокруг 1% от общей длины, и большинство длин будут находиться в пределах 1% от ожидаемого. Это звучит хорошо, пока мы не поймём, что это 1% от общей длины. Нужно масштабировать стандартное отклонение по математическому ожиданию, чтобы увидеть ошибку как долю целевого размера. Это значение называется коэффициентом вариации.
При N=100 получаем CV ≈ 99% — значит, некоторые серверы будут работать в 99% раз интенсивнее, чем должны (обрабатывая вдвое больше запросов), а другие практически ничего не делают! Теперь есть способ предсказать, насколько равномерно нагружены серверы при согласованном хешировании, можно начинать работу над улучшениями.
Что если добавить больше хешей?
Простота согласованного хеширования — палка о двух концах. Легко понимать и реализовывать, потому что всё превращается в легко связанные хеши на одной оси, но любые улучшения системы тоже должны быть связаны с этой осью. Значит, решение любой проблемы согласованного хеширования может быть только больше хешей. Это не золотой молот (инструмент, для которого все проблемы выглядят как гвозди), а скорее золотой гвоздь, превращающий все инструменты в молоты.
Для решения проблемы дисбаланса нагрузки можно добавить несколько хешей для каждого сервера вместо одного. Математику разберём чуть позже, но интуитивно понятно: если каждый отдельный диапазон имеет большое стандартное отклонение, то сумма множества из них должна быть более стабильной. Если взять пример из диаграмм выше с тремя серверами и добавить два случайных хеша для каждого, это помогает выровнять нагрузку на каждый сервер.
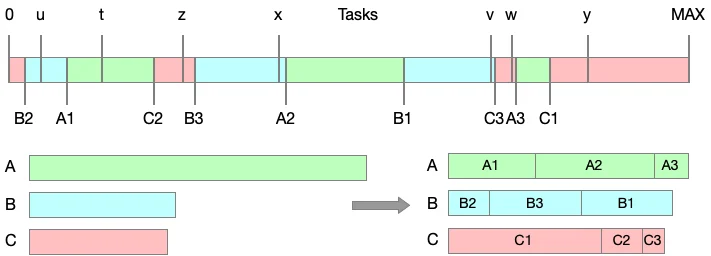
Пример явно упрощён. Случайная природа системы не гарантирует, какое улучшение получится от добавления 2 дополнительных хешей на сервер, но должно быть интуитивно понятно, что объединение большего количества этих сегментов хешей даёт более равномерное распределение. Каждый сегмент в сумме может сбалансировать другой. Один слишком короткий; один слишком длинный. По сути, это то, что говорит нам закон больших чисел. Очевидная проблема: это работает только для больших чисел. В NGINX базовое количество хешей на сервер жёстко закодировано как 160, и Pingora использует то же значение как стандартное. Матчасть пока пропущу, но для примера со 100 серверами: с 160 точками на сервер вместо одной коэффициент вариации (который можно рассматривать как погрешность) падает примерно с 99% до 8% — значительное улучшение.
Что если добавить ещё больше хешей?
Выше мы видели, что увеличение числа хешей на сервер на постоянную величину позволяет улучшить равномерность распределения, но что если мы не хотим распределять работу равномерно? В Cloudflare есть серверы с разным объёмом хранилища, поэтому лучше было бы, чтобы количество запросов, выделенное серверу, было пропорционально объёму его диска. Один способ это сделать — алгоритм ketama. Название звучит смешно, потому что алгоритм назван по библиотеке, где он был впервые реализован, а библиотека названа… ну, можно загуглить.
Весь алгоритм сводится к: для любых двух серверов S₁ и S₂, если нужно, чтобы запросы, обслуживаемые S₁, были в w раз больше, чем обслуживаемые S₂, то количество хешей, связанных с S₁, должно быть H₁ = w × H₂. Это позволяет задать «вес» для каждого сервера, который масштабирует количество хешей, связанных с этим сервером. К сожалению, это не замена постоянному масштабному коэффициенту, добавленному выше. Это масштабирование нужно для установки минимальной погрешности, которая проявится на серверах с минимальными весами.
Для Cloudflare, поскольку нужно масштабировать нагрузку по объёму хранилища, используется дисковое пространство как вес — именно это команда Pingora делала годами. В других местах компании, где нагрузки более вычислительные, веса могут быть на основе числа CPU или GPU.
Что если добавить ещё больше хешей???
Последняя проблема: мы работали под предположением, что любой сервер может обрабатывать любой запрос, но на практике это не так. Требования соответствия или включённые функции кеширования означают, что только подмножество серверов может обрабатывать какой-то конкретный запрос. К сожалению, в отличие от раньше, нельзя решить эту проблему, добавив больше хешей на одно кольцо. Нужно добавить полностью новые кольца, и не только то — каждая комбинация функций потенциально требует собственного конкретного кольца!
Дублирование на основе комбинаций — классический рецепт экспоненциального взрыва. В нашем случае есть несколько разных функций, приводящих к 2^handful = десятков отдельных колец согласованного хеширования. Так что, как вы вероятно уже догадались, «чрезмерное использование памяти» (6 ГБ в некоторых случаях), которое обнаружил специалист, было вызвано огромным количеством хешей для поддержки всей необходимой функциональности, которые хранятся в памяти. Что мы можем сделать?
Улучшения хранения
Большое улучшение пришло от специалиста по оптимизации, который заметил особенность структуры для хранения хешей в PBR. Структура выглядит так:
struct Point {
    hash: u32,
    index: u32,
}
В памяти это представлено восемью байтами: четыре идут на хеш (чего избежать нельзя), и четыре на индекс, указывающий на сервер, хранящийся в другом массиве. Идея была в том, что 32-битное целое число для индекса — пустая трата, потому что PBR вряд ли когда-нибудь координирует более 2^16 ≈ 65k серверов одновременно, так что 16-битного целого будет достаточно. Можно заменить структуру выше на эту:
struct PointV2 {
    hash: u32,
    index: u16,
}
К сожалению, Rust не облегчает это. Изменение размера индекса, как выше, не уменьшает занимаемую память. Это потому, что у Rust есть правила выравнивания, требующие, чтобы размер структуры в памяти был кратен размеру её наибольшего (или наиболее выравненного) поля. В данном случае хеш — наибольший с четырьмя байтами, поэтому Point должна быть размером N × 4 в памяти, минимум восемь байт.
К счастью, есть известные обходные пути. Можно использовать #[repr(packed)], но это спорно по уважительным причинам. Более безопасное, но менее читаемое решение — хранить хеш и индекс как сырой массив байтов и получать к ним доступ через геттеры. Оба метода компилируются в одно и то же.
struct Point([u8; 6]);

impl Point {
   fn hash(&self) -> u32 {
       u32::from_ne_bytes(self.0[0..4].try_into().unwrap())
   }

   fn index(&self) -> u16 {
       u16::from_ne_bytes(self.0[4..6].try_into().unwrap())
   }
}
Это простое (хотя и многословное) изменение сокращает использование памяти для согласованного хеширования на целых 25%! Чтобы сделать лучше, нужно вернуться к математике, так что все держитесь; это финальная прямая.
Что если попробовать меньше хешей?
Вы, возможно, заметили, что мы дали формулу стандартного отклонения для случая с одним хешем на сервер. Вывод формулы для k хешей на сервер — задача не простая, и большинство источников дают только приближение или асимптотический предел, но только не мы. Я, возможно, не статистик, но рос с учителем математики (привет, мам!), и хотел узнать реальное значение. Полный вывод в дополнительном посте, вот результат.
Чтобы увидеть, как увеличение количества хешей улучшает точность, посмотрим снова на коэффициент вариации.
На графике CV_k видно потенциальную проблему с менталитетом «просто добавь больше хешей» (кроме избыточного использования ОЗУ).
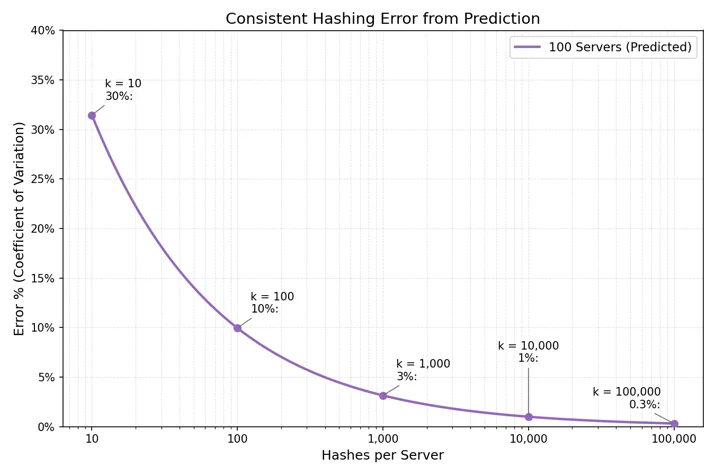
Видно, что каждый шаг вниз в погрешности требует (почти) увеличение на порядок величины в количестве хешей на сервер, так что добавление больше хешей даёт все меньше и меньше улучшений. Напомним: используем базу 160 хешей, масштабированные по размеру хранилища сервера. Для упрощения математики скажем, что коэффициент взвешивания m_w для сервера равен 625, получаем k = 160 × 625 = 100,000. На графике выше видно, что последние 90,000 добавленных хешей дают микроскопическое 0,7% снижение погрешности. К сожалению, дальше всё только хуже.
Мои математические предсказания работают, только если думать о хешах на непрерывном кольце, но на практике используются 32-битные числа для хешей с потенциалом коллизий, и вероятность коллизий растёт удивительно быстро по мере увеличения количества хешей (см. парадокс дня рождения). Коллизии важны, потому что в идеале каждый хеш способствует объёму и распределению запросов, обрабатываемых связанным сервером, но коллизия означает, что некоторые вклады случайно отбрасываются, вводя непредсказуемую ошибку. Если сравнить некоторые смоделированные результаты с 32-битными хешами с предсказанной частотой ошибок, видно, что для дата-центров с 2048 серверами частота ошибок увеличивается между 10,000 и 100,000 хешами на сервер.
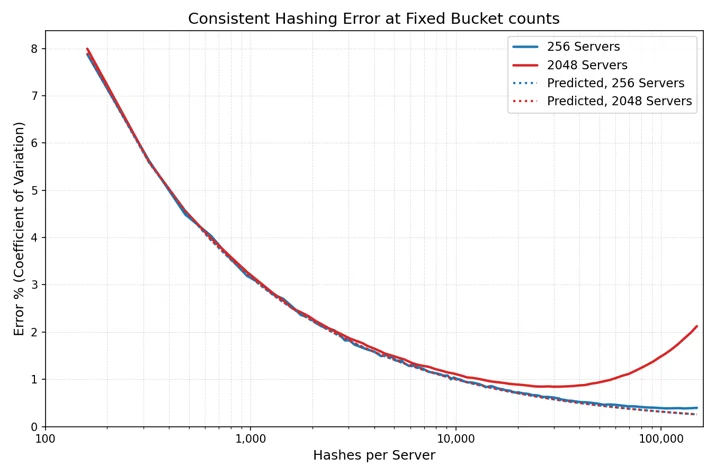
В итоге, хотя это звучит как-то грустно, это отличная новость для плана освободить ОЗУ! Теперь, имея математику в поддержку, определили, что можно уменьшить количество хешей, генерируемых для каждого сервера на 90% без заметной погрешности, и именно это сделали.
Миграция без краха истоков
Была ещё одна проблема: изменение кольца хешей изменяет, куда идут некоторые кешируемые запросы. Даже если новое кольцо лучше, переключение всей сети сразу практически аннулировало бы весь кешированный контент. Это превратило бы оптимизацию памяти в апокалиптический скачок трафика до истоков.
Поэтому не сделали это единовременным глобальным переключением. Какое-то время PBR держал обе версии сбалансировщика нагрузки кешируемого трафика в памяти: старое кольцо ketama и новое меньшее. Каждый запрос использовал обычный фреймворк миграции для выбора, какое кольцо должно выбрать бэкэнд. Это означало, что решение о миграции было стабильным на хеш-запроса, и также давало чистый путь отката. Если бы что-то выглядело неправильно, можно было бы отправить новые запросы обратно через старое кольцо без переразвёртывания PBR.
Затем выкатили миграцию слоями. Начали с малых мест валидации, перешли через прогрессивно увеличивающиеся группы дата-центров и только потом продвинулись к остальному миру.
Важная часть — независимое управление двумя измерениями: сколько трафика использовало новое кольцо и где этот трафик мог двигаться. Простой глобальный процентный rollout разнёс бы чистку кеша везде сразу. Rollout в границах дата-центра держал зону поражения маленькой и сильно облегчил определение, действительно ли изменение безопасно.
Во время миграции отслеживали трассы выбора бэкэнда, счётчики версий кольца, ошибки соединения PBR, память процесса, время запуска, поведение кеша и трафик истоков. Как только миграция достигла 100%, удалили временный путь старого кольца, и готово!
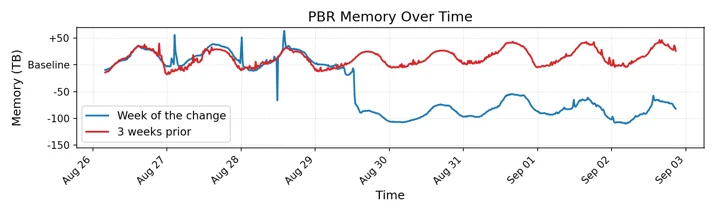
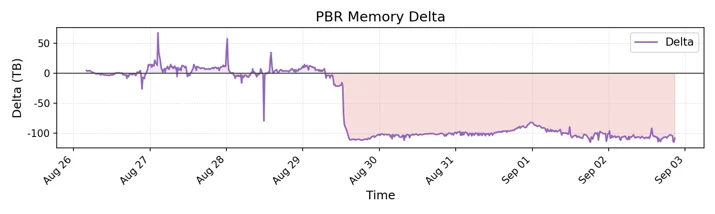
График выше показывает сравнение памяти, используемой PBR неделю изменения, с данными с несколько недель раньше, и результат вычитания одного из другого. Резкое падение — день, когда версия PBR с большими (теперь неиспользуемыми) кольцами хешей была навечно выведена из эксплуатации. Глядя на разницу, получаем удовлетворяющий результат: наши изменения сократили используемую память на 100 ТБ!
Попробуйте сами
Все изменения из этого поста доступны в крейте pingora-ketama в виде (пока что) неафишируемого Cargo-функционала. Кольцо v2 имеет компактный формат хранения, более быстрый метод сортировки и возможность масштабировать базовое количество хешей на ноду. Наш фокус в реализации этих изменений был на стабильности и контроле, поэтому кольцо v1 идентично тому, что всегда использовал pingora ketama, и библиотека позволяет запускать оба одновременно и выбирать на основе запроса, какое использовать и когда.
Помимо простой попытки буквальных изменений согласованного хеширования, хотелось бы, чтобы вы вдохновились копнуть в свои собственные системы и посмотреть, какие «простые» или «очевидные» решения скрывают потенциальные выигрыши, если вы готовы нырнуть в цифры. Может быть, решить все проблемы с помощью Rust не получится, но математика универсальна.