Контроль версий как узкое место
Кодирование больше не является узким местом для построения систем или проведения исследований в Anthropic. Claude способна автономно итерировать циклы исследований, микрооптимизировать сложные программы и строить новые сервисы с беспрецедентной скоростью и масштабом. Новое узкое место — вся инфраструктура разработчиков, рассчитанная на человеческий масштаб: контроль версий, сборка и CI.
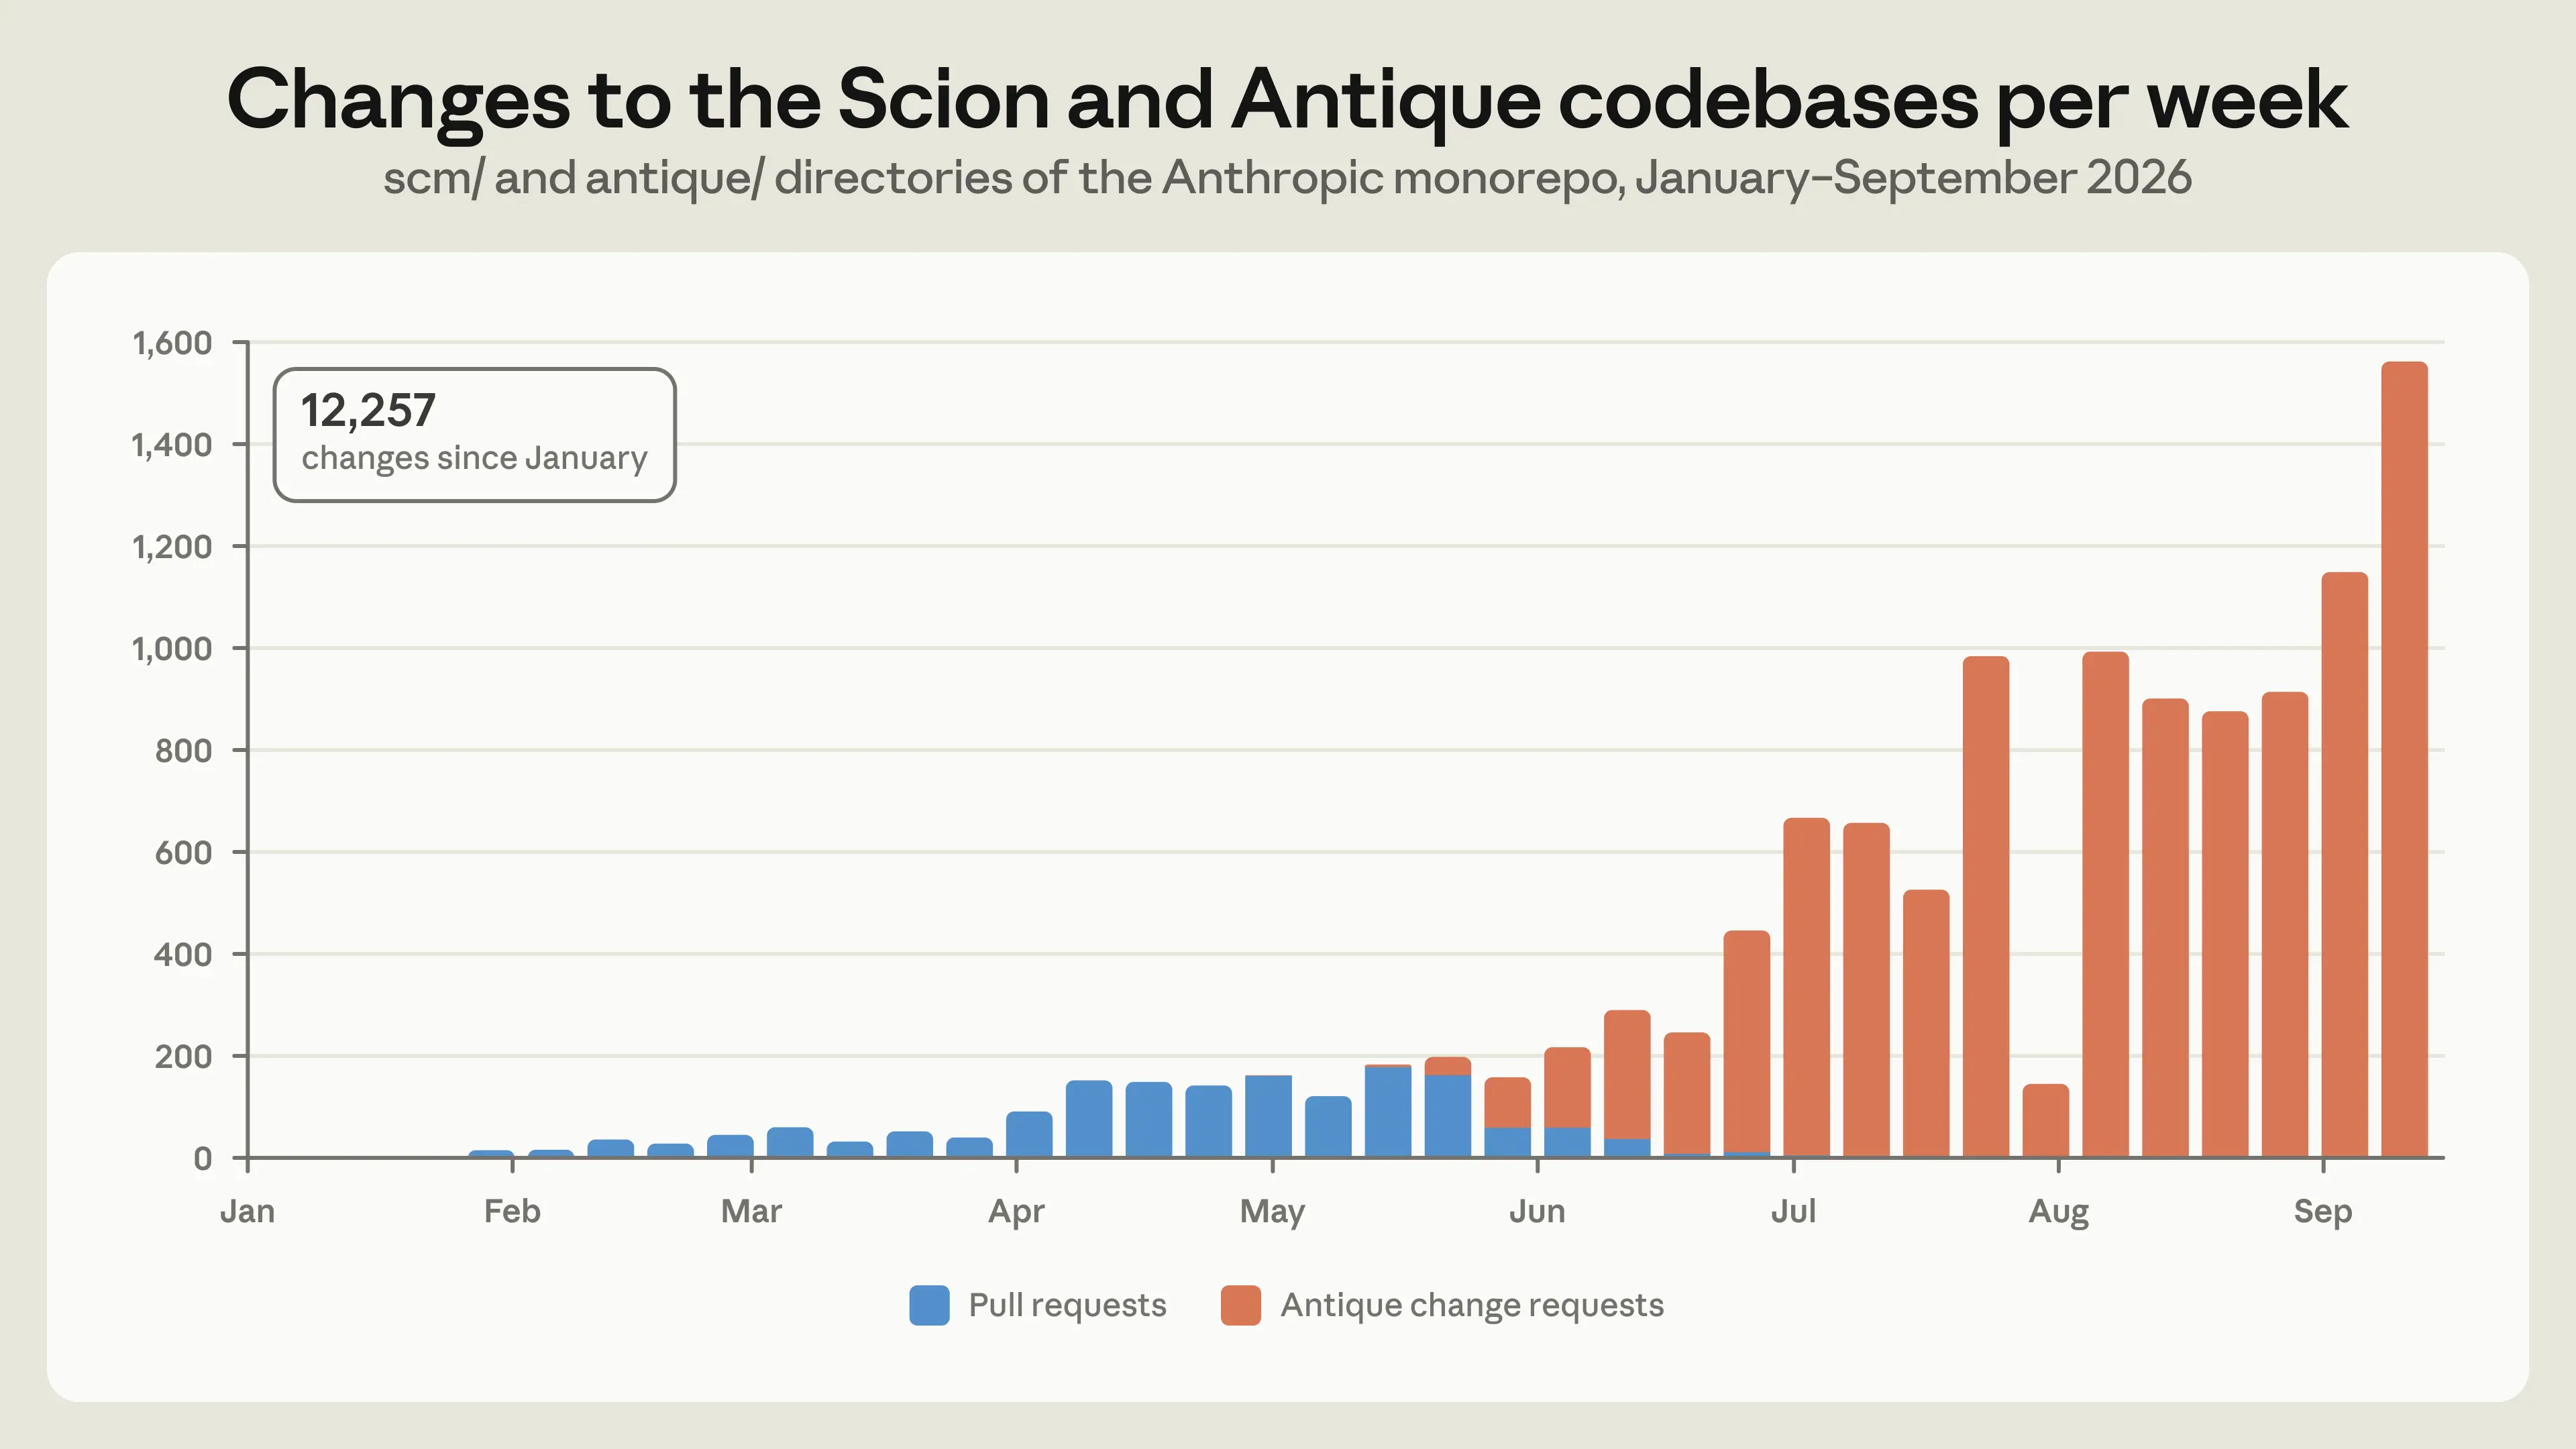
В мае 2026 года Anthropic в среднем выполняла около 2 500 изменений кода в день; по состоянию на сентябрь — более 30 000 в день. Темпы этого роста, похоже, не замедлятся; скрытый спрос на мержи кода практически бесконечен, и каждое устранённое узкое место немедленно приводит к дальнейшему увеличению объёма производимого кода.
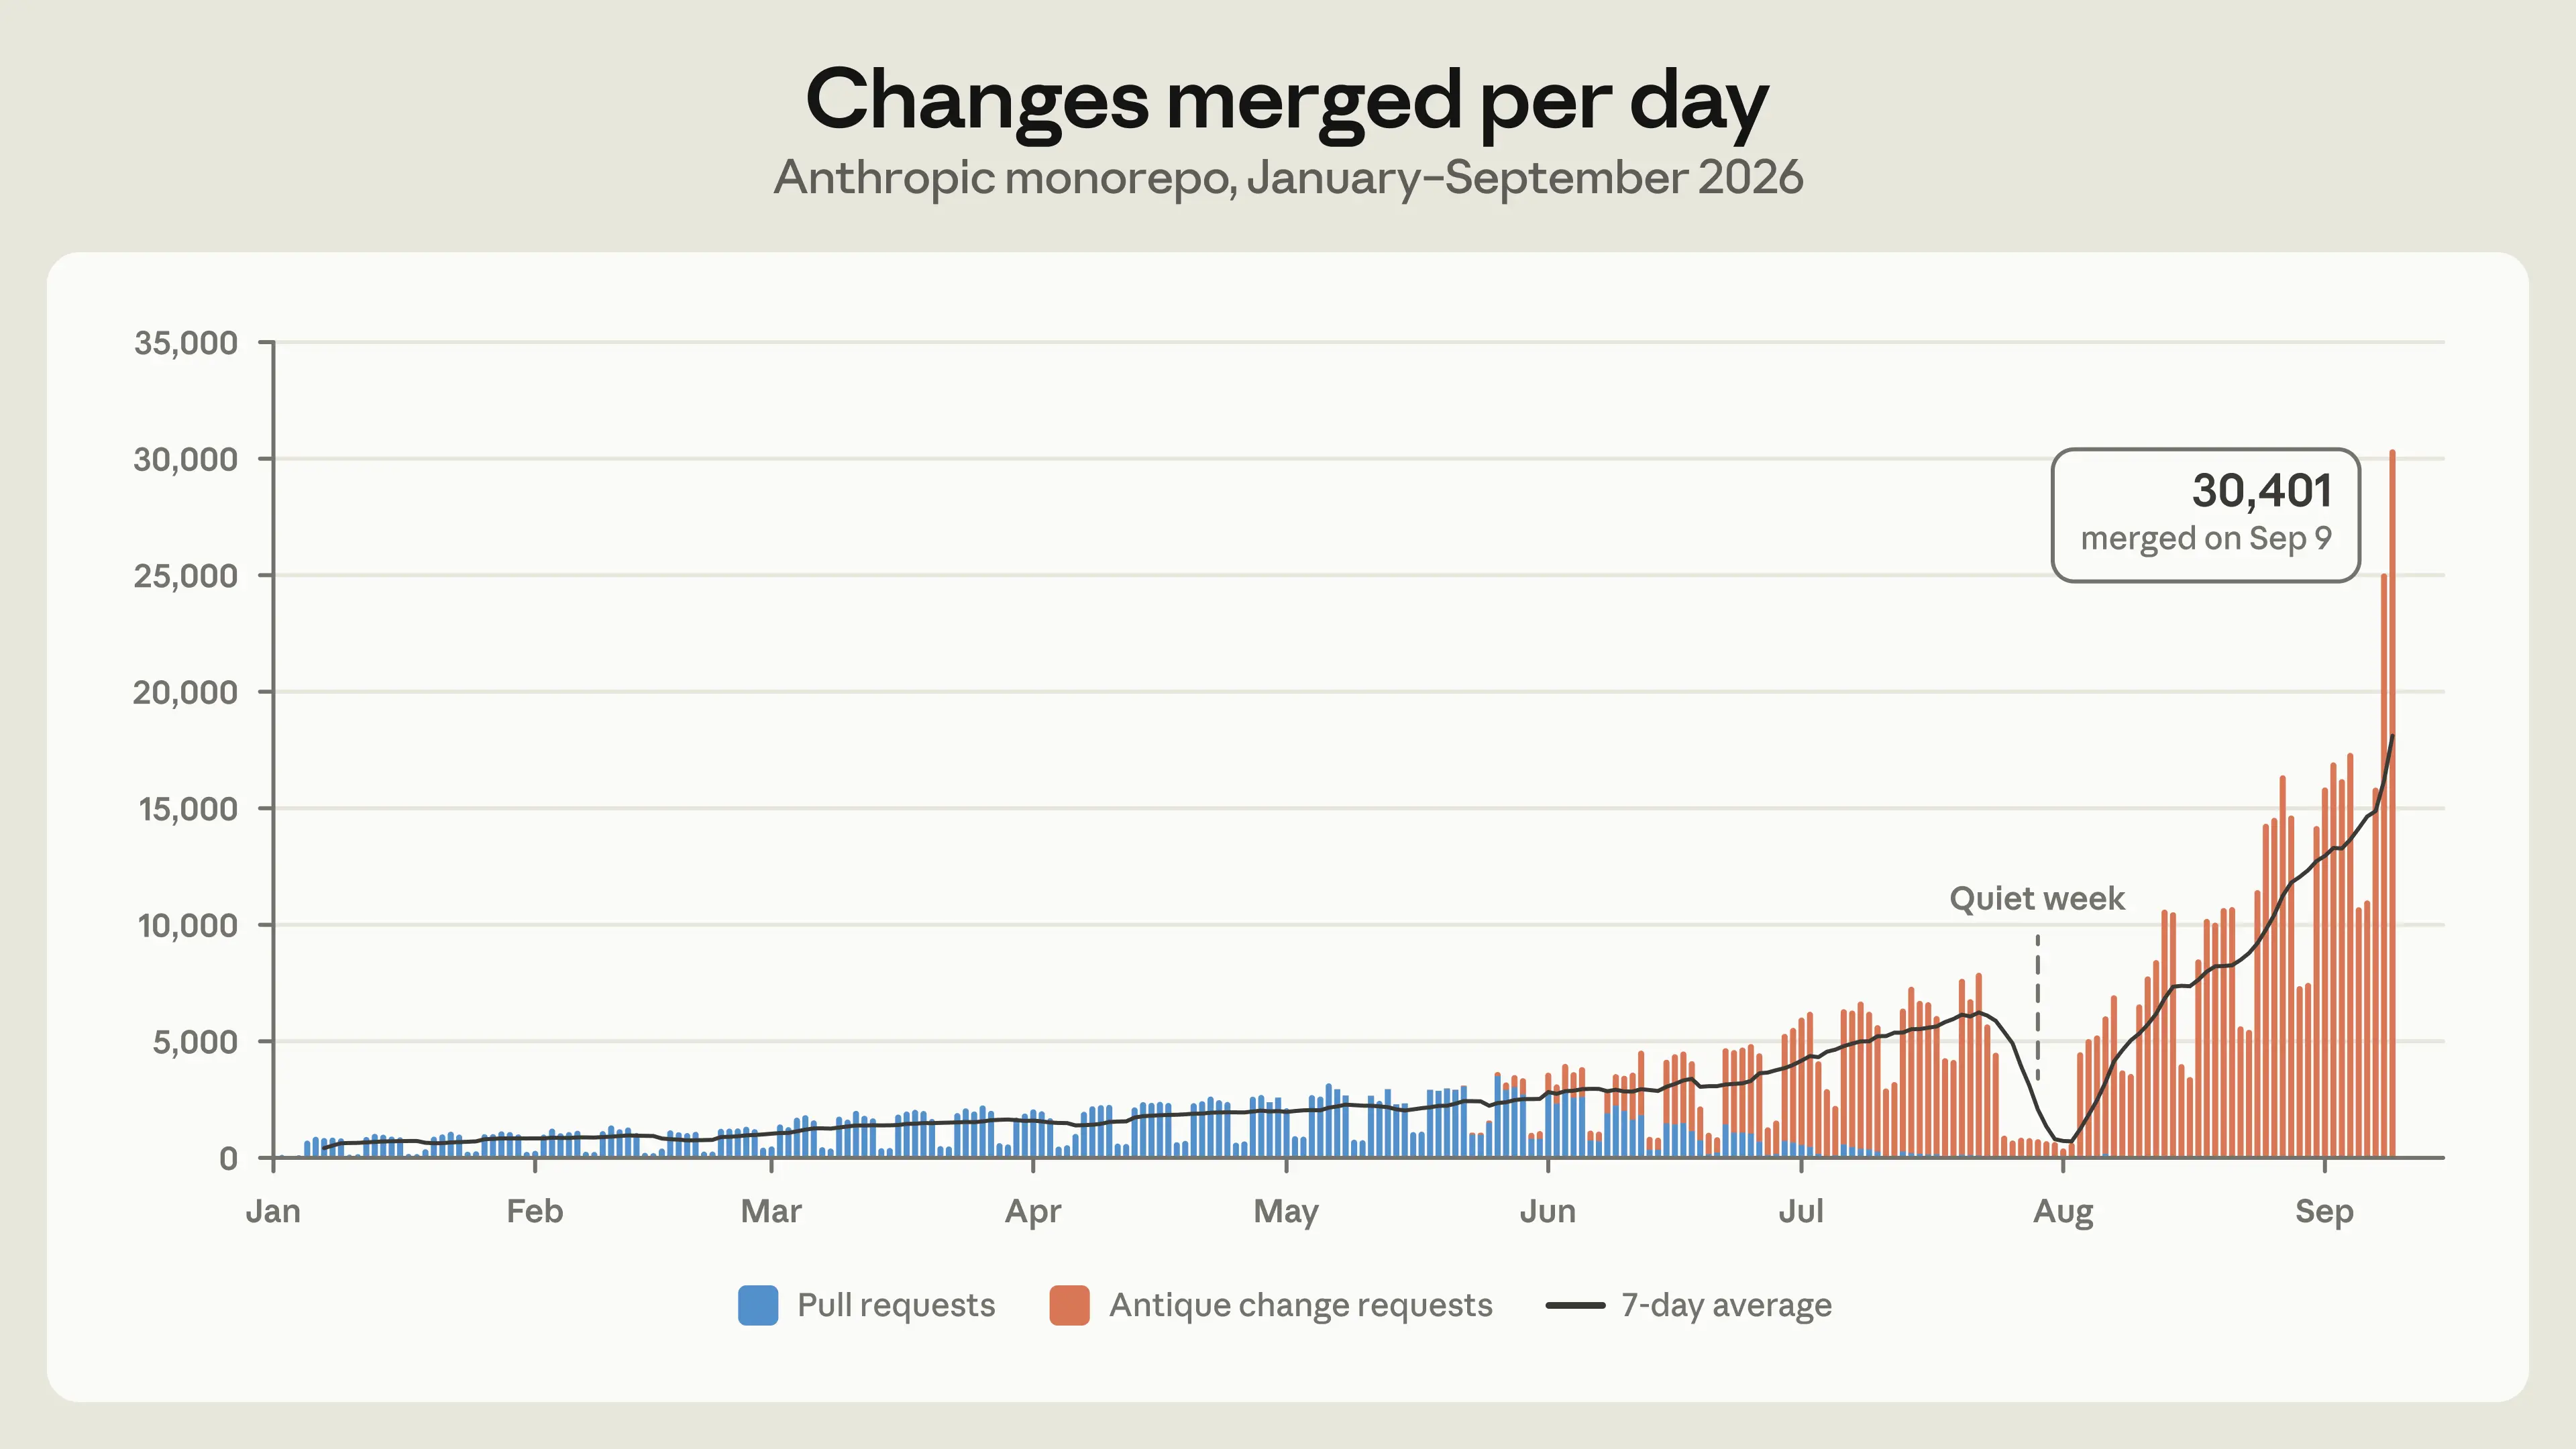
Чтобы поддержать этот рост, построили Scion — собственную систему контроля версий и полностью мигрировали монорепозиторий с Git за пять месяцев. Также разработали и развернули интерфейс рецензирования кода (Antique), поиск по коду, расширенную систему управления доступом и новые способы управления и слияния больших объёмов рецензируемого кода. В этой статье сосредоточимся на том, как именно построили Scion. Это интересный тематический анализ: способность Claude писать код — вот что создало эту проблему в первую очередь, и одновременно это позволило быстро построить высококачественную масштабируемую систему для её решения.
Растущий монорепозиторий
Перед тем как говорить о построенном решении, стоит подчеркнуть, насколько необычна рабочая нагрузка. Неудивительно, что Anthropic использует Claude для написания ПО намного больше, чем почти любая другая компания, поэтому они часто первыми сталкиваются с местами, где инструменты, спроектированные для человеческого масштаба, начинают ломаться. Контроль версий — только один из примеров. Хотя маловероятно, что большинство организаций столкнутся с этими проблемами в очень близком будущем, подозреваем, что скоро и другие, использующие инструменты AI-кодирования, столкнутся с этими же давлениями. Поэтому захотелось поделиться тем, что построили и чему научились.
Git — децентрализованная система: каждый клон — это полный, независимый репозиторий, который может вычислять diff, читать историю и blame, и проверять любую ревизию полностью офлайн. Для подавляющего большинства репозиториев это правильный дизайн, и это в значительной степени причина, почему Git стал стандартом.
По мере роста монорепозитория он всё меньше соответствует этому пространству дизайна. История только основной ветки — почти 100 ГБ, а сжатая рабочая копия — более 25 ГБ. В день выполняется порядка 25 миллионов checkout кода для CI, без учета среды разработчиков, изолированных сред агентов и исследовательских заданий. Если бы наивно fetching, это был бы более 600 ПБ git-трафика в день.
Git предоставляет инструменты для работы с частью репозитория, такие как shallow clones, sparse checkouts и promisor remotes. Помимо них, существуют стандартные обходные решения для больших монорепов, как внутренние git-зеркала и снимки репозитория (seeds), хранящиеся в blob-хранилище. Использовались все они — на пике работало несколько сотен внутренних git-зеркал для распределения нагрузки. Это выиграло время, но с увеличением темпа мержей они становились всё сложнее в управлении. Seeds отставали от кончика main между обновлениями, и всё больше заботы требовалось, чтобы поддерживать операции, зависящие от истории, такие как diff и blame, при работе с частичными клонами.
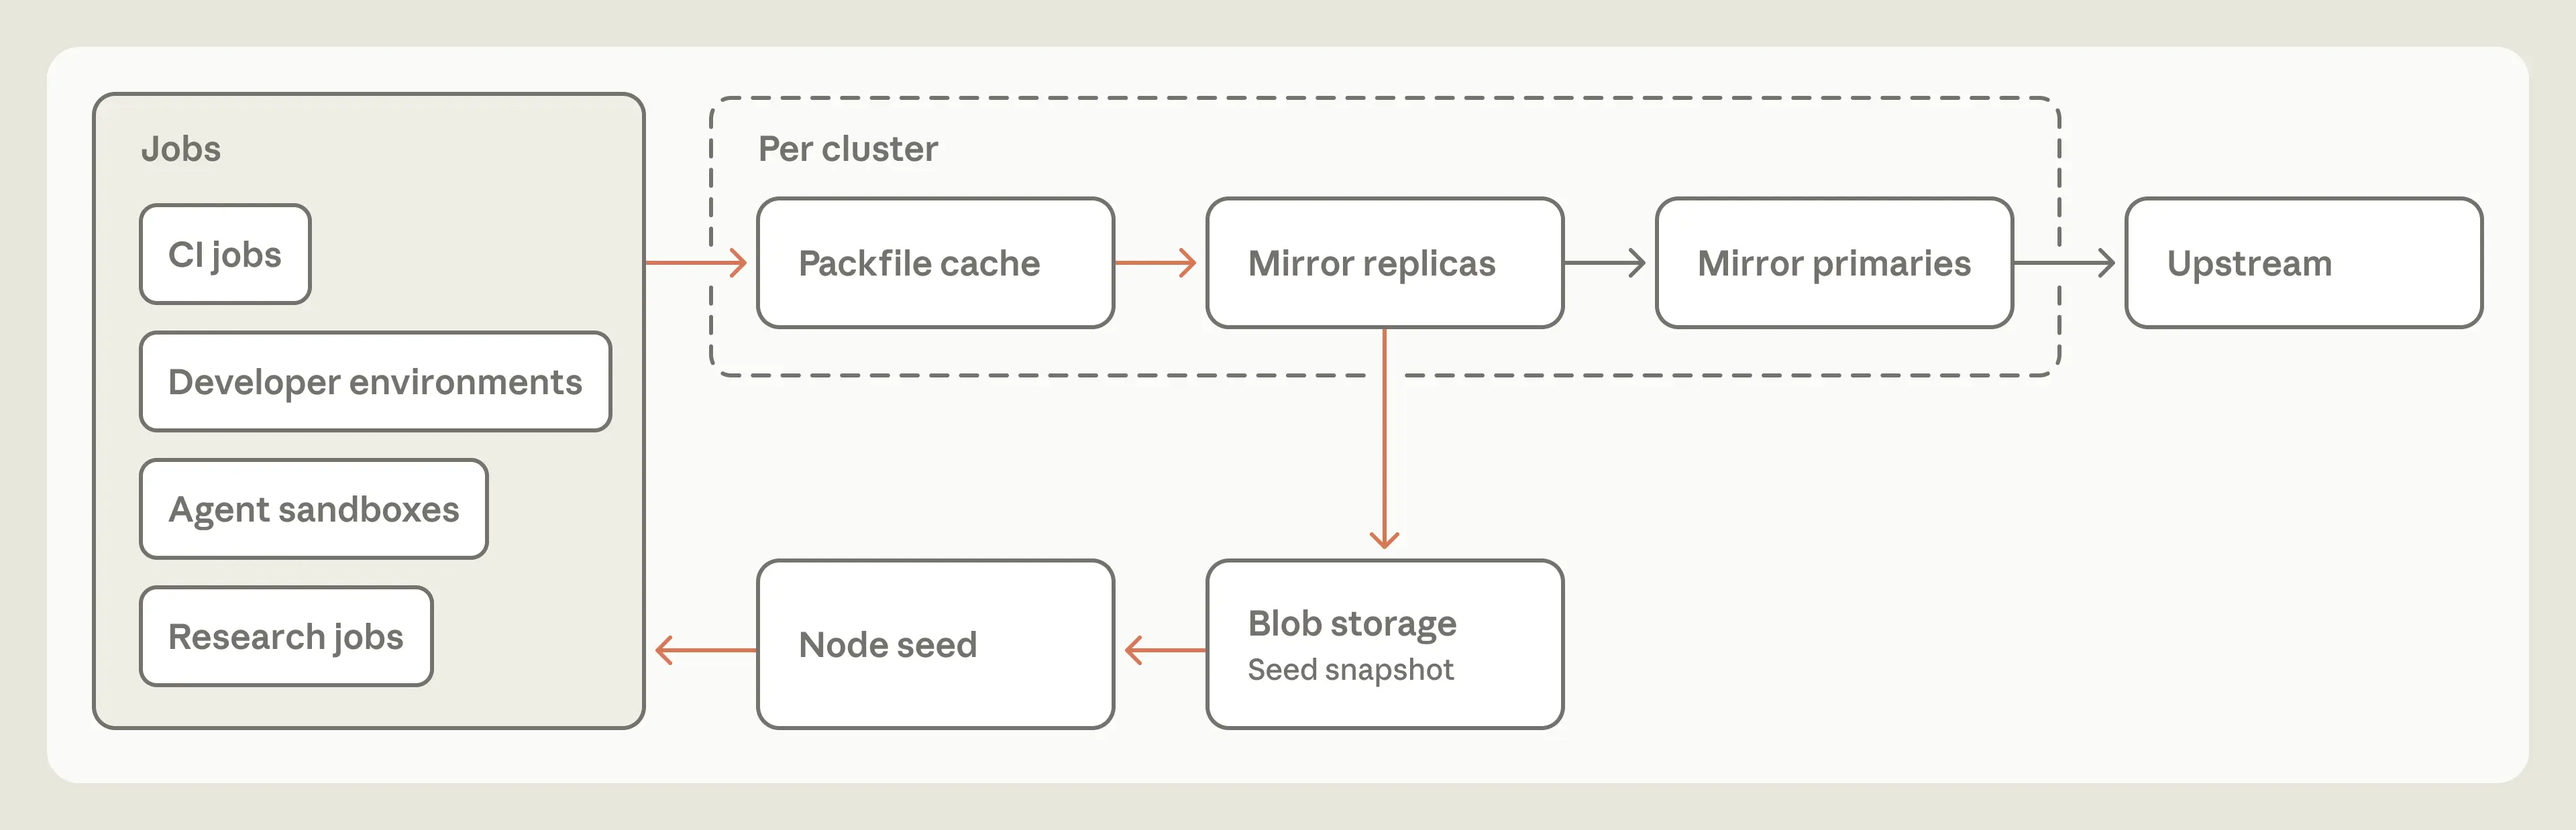
Сделав шаг назад, заметили, что, как и большинство компаний, использовали Git как централизованную систему с одной авторитетной копией, но почти все клиенты — агенты и задания, которые по определению онлайн. Свойства, делающие Git отличным для распределённой автономной работы, активно препятствовали способности масштабироваться по мере роста репо. Возник вопрос: если спроектировать контроль версий, имея в виду, что агенты всегда онлайн с самого начала, что бы это выглядело?
Принципы контроля версий в масштабе агентов
С агентным кодированием многие общие предположения о том, как разрабатывается ПО, эволюционируют. Эти изменения приняли при построении Scion, что позволило принципиально отличаться от Git по нескольким ключевым аспектам. Контроль версий для огромных монорепо имеет предшественников — заметим Google's Piper и Meta's Sapling — поэтому удалось построить Scion с учётом их опыта. Вот принципы:
Клиенты всегда онлайн. Git предполагает, что клиенты работают офлайн и нуждаются в полной копии репо. Поскольку почти все клиенты — агенты и задания, спроектировали клиент Scion и протоколы вокруг сервера, который всегда доступен, и клиенты fetching данные по мере необходимости.
Асимметрия клиент-сервер. В Git каждый клиент способен быть полноценным сервером. В Scion сервер отвечает на вопросы об истории файлов и blame, создаёт коммиты, выполняет мержи и rebases и так далее. Клиент поддерживает ограниченный локальный кеш объектов, размещает файлы рабочей копии на диск, мониторит изменения файловой системы и предоставляет пользователям эргономичный способ работы с сервером. Он может вычислять очень мало самостоятельно, но взамен требует намного меньше данных локально.
Всеобъемлющий сервис контроля версий может питать многие новые приложения. С Git, CI-задание или инструмент, который нужно спросить о репо — например, кто последним изменил строку или как связаны два коммита — должен поддерживать локальную копию репо или надеяться, что vendor-specific APIs предоставят ответ. С Scion все запросы контроля версий, которые использует клиент, также доступны через API, поэтому во многих случаях заданиям вообще не нужен локальный репо. Многие внутренние инструменты, такие как automated bisect и revert pipelines, были бы непрактичны в масштабе без этого дешёвого программного доступа к контролю версий.
Всё должно быть горизонтально масштабируемым. На пике работало несколько сотен git-зеркал, что значительно напрягало пропускную способность и перестало масштабироваться, когда репо превзойдёт дисковое или память зеркал. В Scion данные репо распределены, и каждый компонент независимо масштабируется; нет полностью материализованной копии репо нигде, даже на сервере. Нет эквивалента packfiles (сжатых пакетов объектов Git), поэтому не требуется обслуживание репо.
Коммиты должны быть дешёвыми, инкрементальными и без блокировок. В Git коммитят локально, затем push для обмена работой. В Scion каждый коммит, rebase или мерж происходит на сервере, поэтому нечего push, но каждая операция должна быть быстрой. Стоимость создания коммита и обновления его структур данных потомков должна масштабироваться с размером изменения, а не размером всего репо, иначе сервер не будет успевать. Цикл разработки в Scion обескураживает refs (указатели на коммиты, такие как branches и tags), кроме main ref или release branches, потому что глобальное состояние, которое каждый сервер должен согласовать — это масштабирующаяся проблема.
Рабочая копия опциональна и разреженна по дизайну. Поскольку монорепо огромен и checkout код выполняется десятки миллионов раз в день для CI, захотелось избежать checkouts всякий раз, когда возможно. С Scion, CI-задание, которому нужен diff между коммитом и его merge base, например, может спросить его у сервера. То же для записей: многие write workloads также могут пропустить checkout и работать полностью через API. Протокол Scion сосредоточен вокруг sparse checkouts, которые содержат только директории, запрашиваемые клиентом, и virtualized checkouts, которые материализуют файлы по требованию, поэтому когда заданию действительно нужны файлы на диске, клиент платит только за то, что действительно читает.
Как работает Scion
Полезно понять, как эти принципы воплотились на практике при построении Scion. Эти идеи могут применяться к другим системам контроля версий или, более широко, к другим этапам цикла разработки ПО.
Структуры данных
В Scion единица работы — "changeset", запись в write-ahead log. Changeset хранит большую часть того, что ожидаешь от коммита в Git. Но где git-коммит хранит указатель на дерево, changeset хранит список файлов, изменившихся относительно его первого родителя,1 вместе с адресованными по содержимому указателями на сжатое содержимое файлов в blob-хранилище. Changesets создаются на сервере и доступны везде, мгновенно.
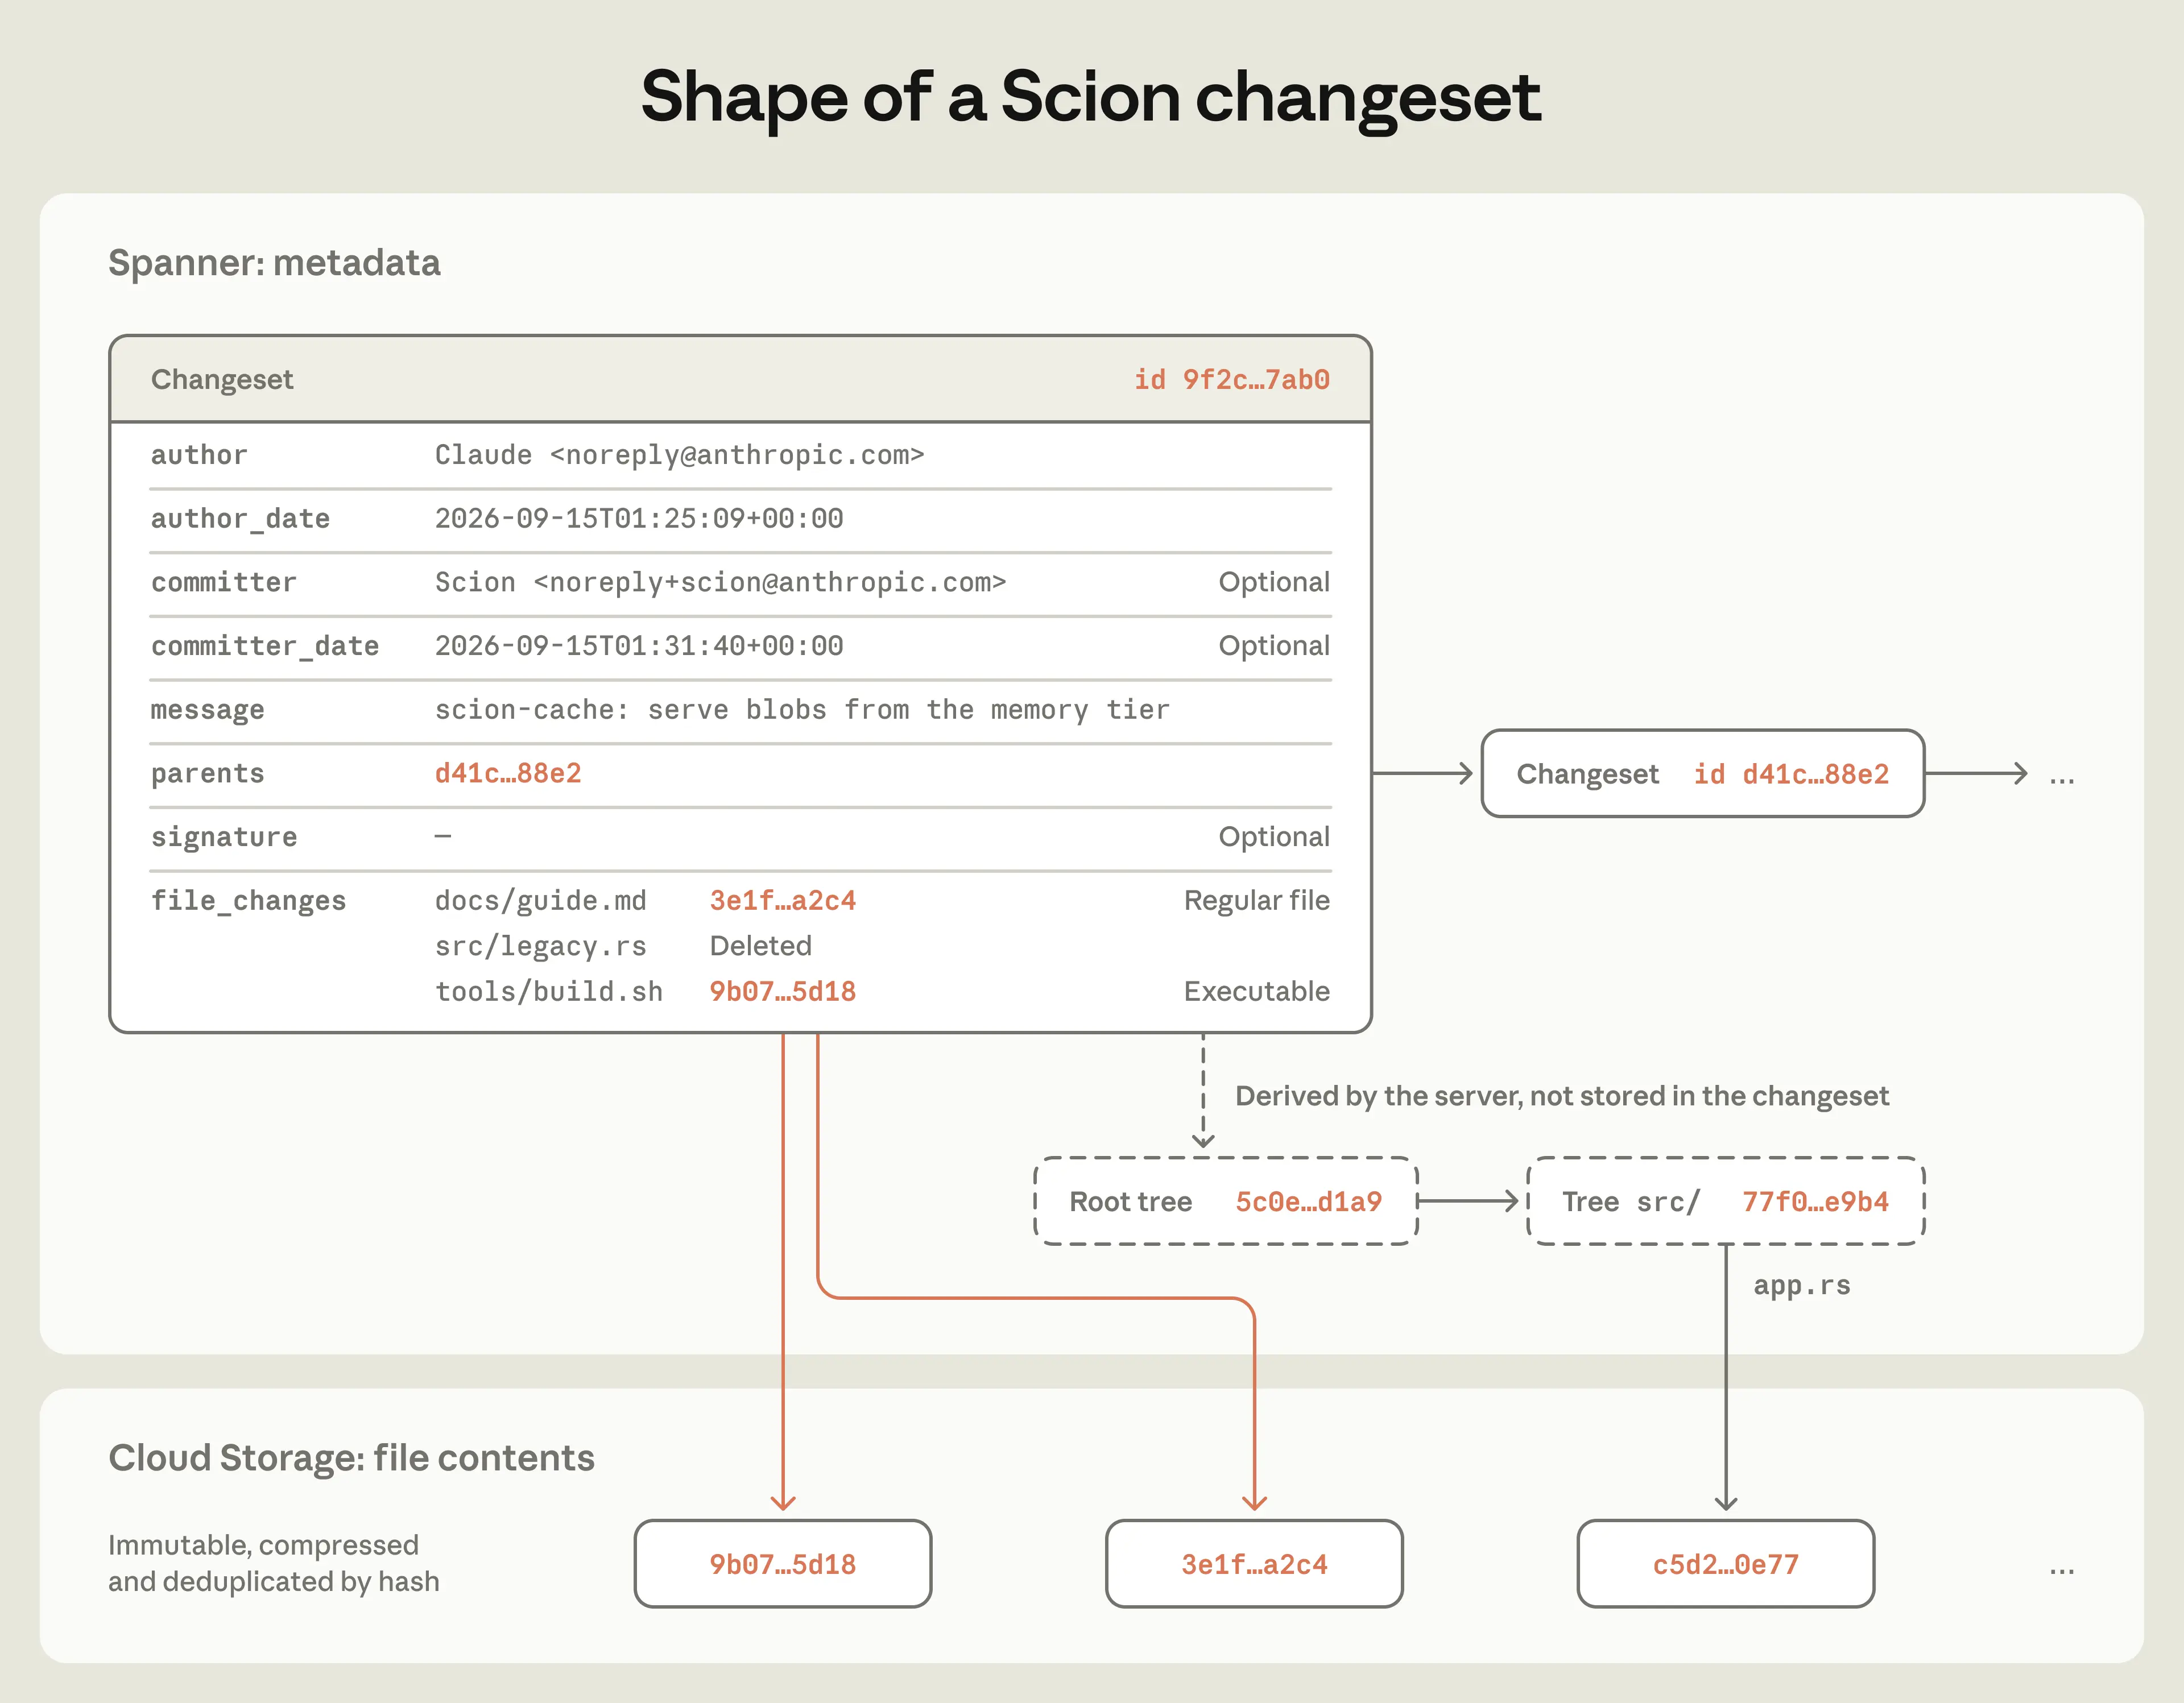
Такая структура позволяет принимать changesets с очень высокой пропускной способностью, потому что нет packfiles для принятия, нет блокировок или кросс-серверной координации, нет refs для перемещения. Scion технически поддерживает refs, но поскольку ни создание, ни fetching коммитов не включают их, перемещение — это compare-and-swap на единственной Spanner row, которое происходит отдельно от создания changesets.
Changeset записывает только то, что изменилось, поэтому самостоятельно не может быстро ответить на вопросы типа кто последним редактировал строку или какие коммиты повлияли на файл. Чтобы ответить, Scion строит дополнительные структуры данных из changesets, включая выделенные структуры для file blame и path history и skip lists для commit graph. Всё, что не является прямой частью changeset, называют "derived data", и вычисляют всё через один общий механизм. Каждый тип derived data определяется рекурсивно, поэтому его значение для changeset вычисляется из значений для родителей того changeset.
Этот механизм имеет три преимущества. Во-первых, легко добавить новый тип derived data, когда новая структура данных сделает какую-то операцию быстрее. Во-вторых, для каждого типа можно выбрать, вычислять ли его сразу или отложить работу, чтобы избежать материализации неиспользуемых данных. И в-третьих, поскольку клиент никогда не видит внутренности этих структур данных, можно оптимизировать их без изменения клиента. Добавили новые типы derived data много раз по мере роста системы, например новые индексы для выполнения copy detection или path-based file search.
Масштабирование Scion
Небольшой флот серверов Scion предоставляет API контроля версий для любой операции, которая может потребоваться клиенту, такой как получение changesets, вычисление diffs, поиск merge bases и fetching blobs. Все данные контроля версий адресованы по содержимому, поэтому данные никогда не изменяются после сохранения, и любой сервер может кешировать их без проверки с остальными. В результате серверы горизонтально масштабируемы и требуют мало координации. Они — по сути большие кеши, которые также могут вычислять derived data на лету и писать результаты обратно в Spanner.
Многие потребители Scion больше не нуждаются в поддержке собственных локальных репозиториев. Fetching и поддержка репо раньше были значительным бременем обслуживания для CI-заданий или инструментов, которым нужно было спросить о контроле версий, особенно об ancestry коммитов и blame. Ранней на миграции, до того как построили собственный клиент, format репо или протоколы, Scion только отвечал на эти запросы "metadata". Fetching содержимого файлов и материализация рабочих копий — намного более data-intensive операции, и им требовался собственный дизайн.
Клиент scn Scion отклоняется от fetch-протоколов Git несколькими важными способами и, в результате, подходит для очень масштабируемой архитектуры, требующей значительно меньше CPU, чем git-серверы. Переговоры Scion не говорят серверу, что клиент уже имеет; вместо этого работает исключительно с деревьями и blobs, которые клиент хочет. Начиная с root tree, клиент проверяет своё локальное хранилище на отсутствующие деревья и запрашивает их рекурсивно, затем повторяет процесс для blobs. Каждый запрос — для конкретного объекта, который никогда не изменяется, поэтому любой кеш может ответить на него, и архитектура близко напоминает традиционные многоуровневые кеши. Процесс также эффективен и возобновляем, потому что нет одного мультигигабайтного packfile-ответа. Sparse и даже virtualized checkouts не нуждаются в специальной поддержке, потому что клиент просто не запрашивает деревья, которые не хочет.
В флоте клиент говорит через сокет демону, scion-daemon, который хранит объекты для целого узла. Большинству узлов нужен доступ к монорепо, и задания на том же узле переиспользуют большую часть одних и тех же объектов. Каждый daemon начинается с периодически обновляемого снимка, затем говорит только с серверами кеша дерева и blob в его регионе, называемыми scion-cache. Эти cache-серверы streaming объектов прямо из памяти в формате диска, который consume будет daemon, поэтому не должны тратить время на вычисление missing objects клиента или выполнение delta compression. Когда cache не имеет объекта, спрашивает authoritative scion-servers, которые читают из Spanner или cloud storage по мере необходимости.
Scion-daemon, scion-cache и scion-server все отвечают на идентичные RPC для этого протокола, поэтому клиент не должен знать топологию кеша. Любой уровень теоретически мог бы говорить с любым другим, но строго соблюдается уровневая структура, чтобы изолировать failure domains. Хотелось избежать ситуации, где сбой в региональном scion-cache перегружает upstream scion-servers и приводит к отказу всей системы.
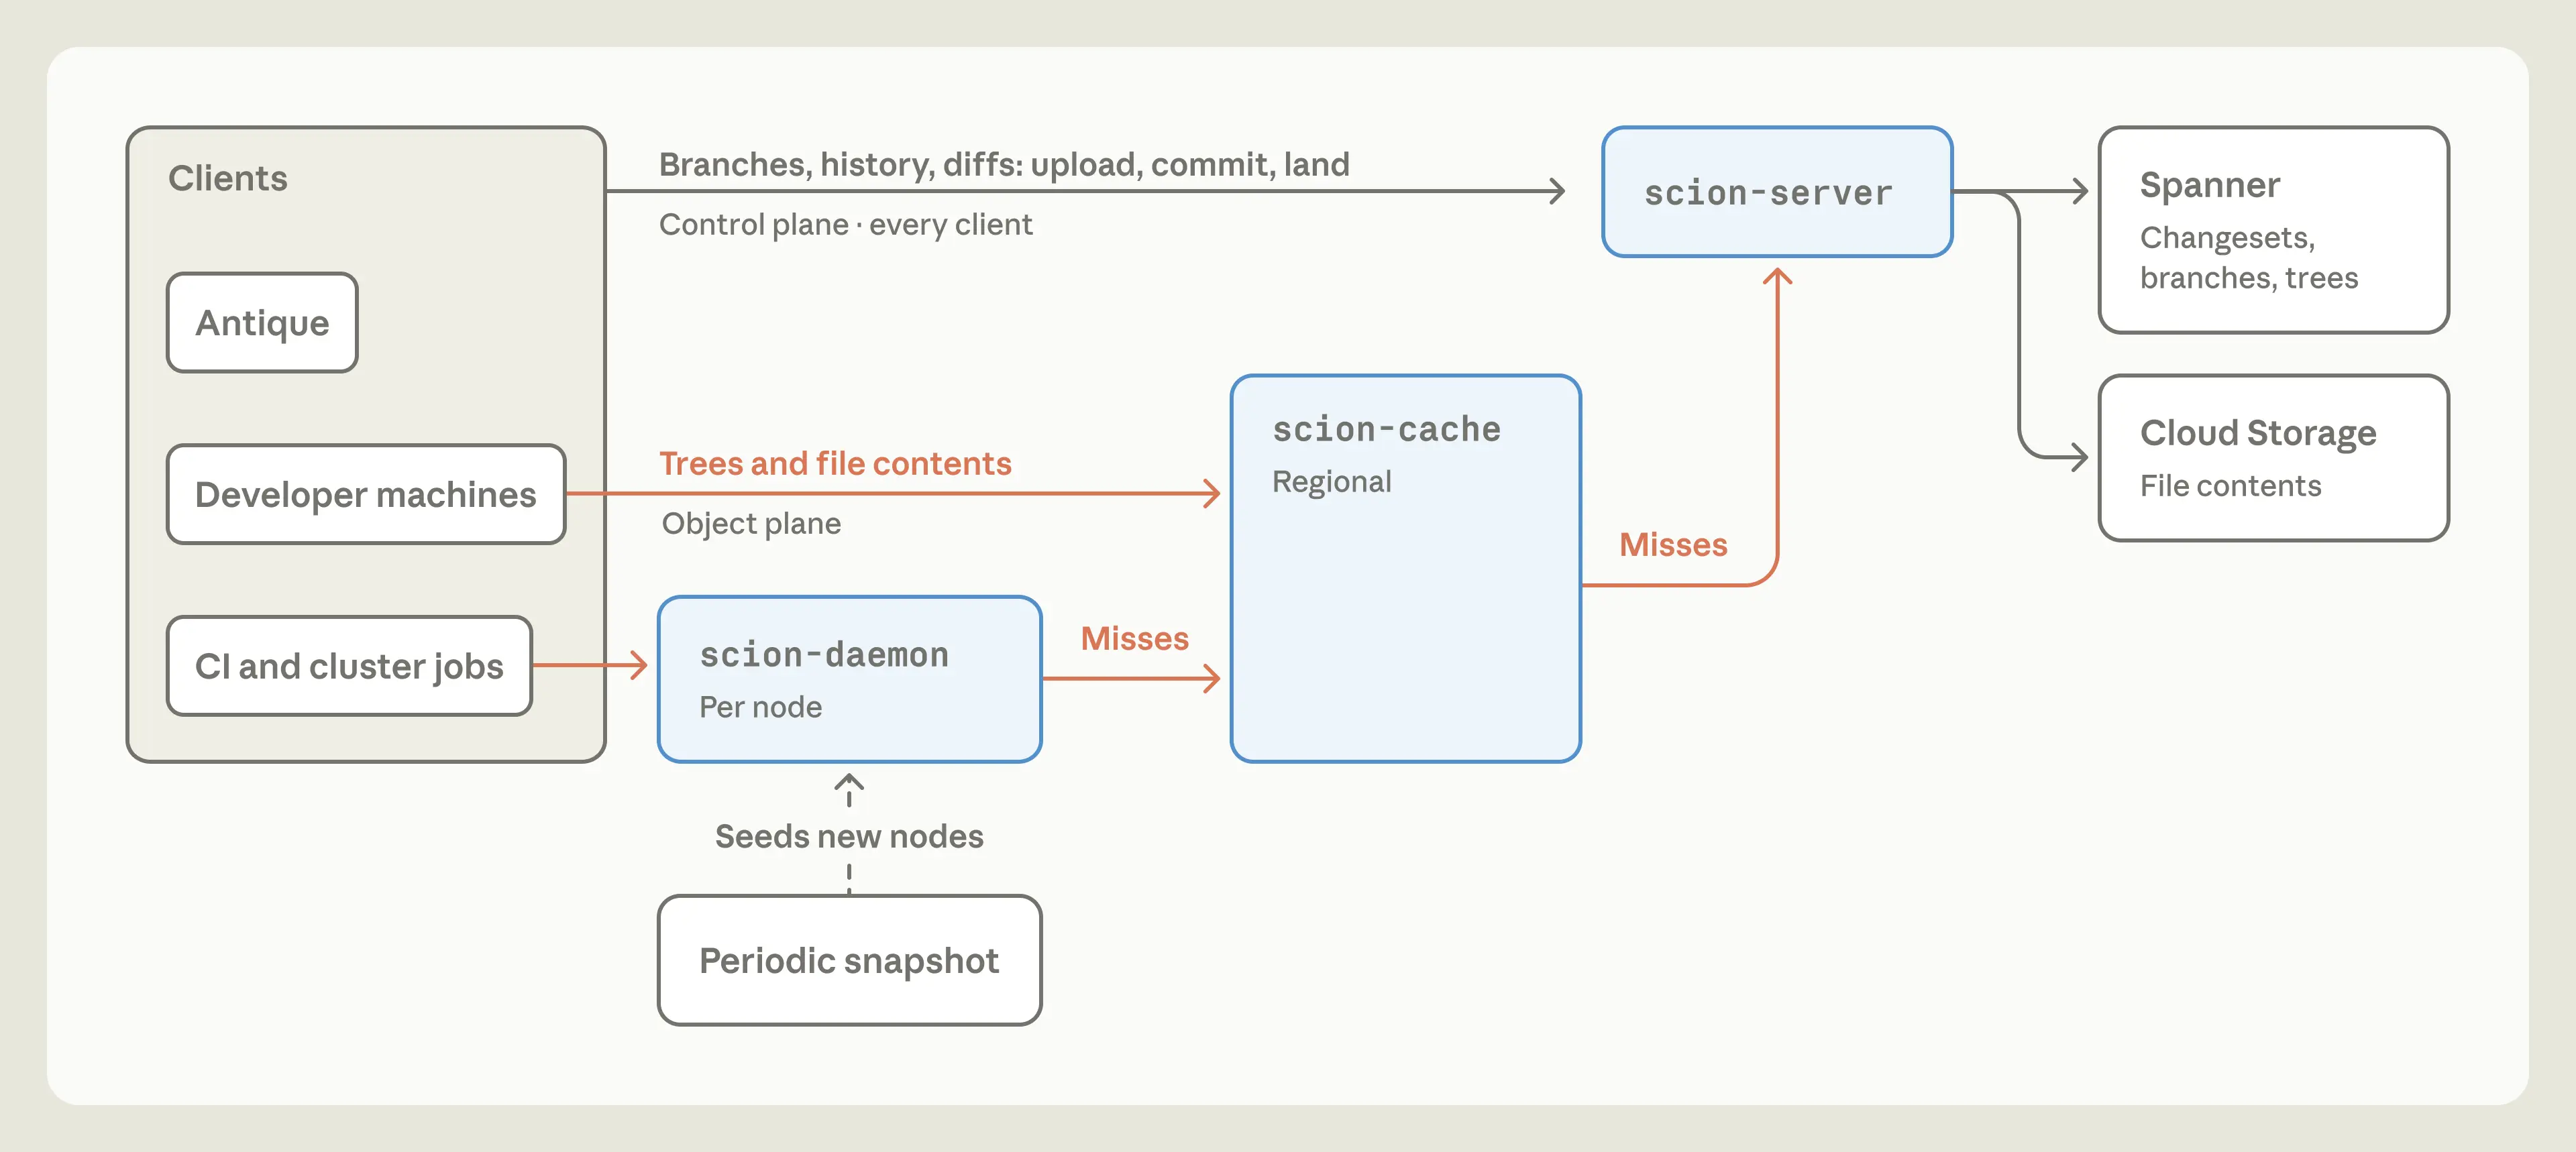
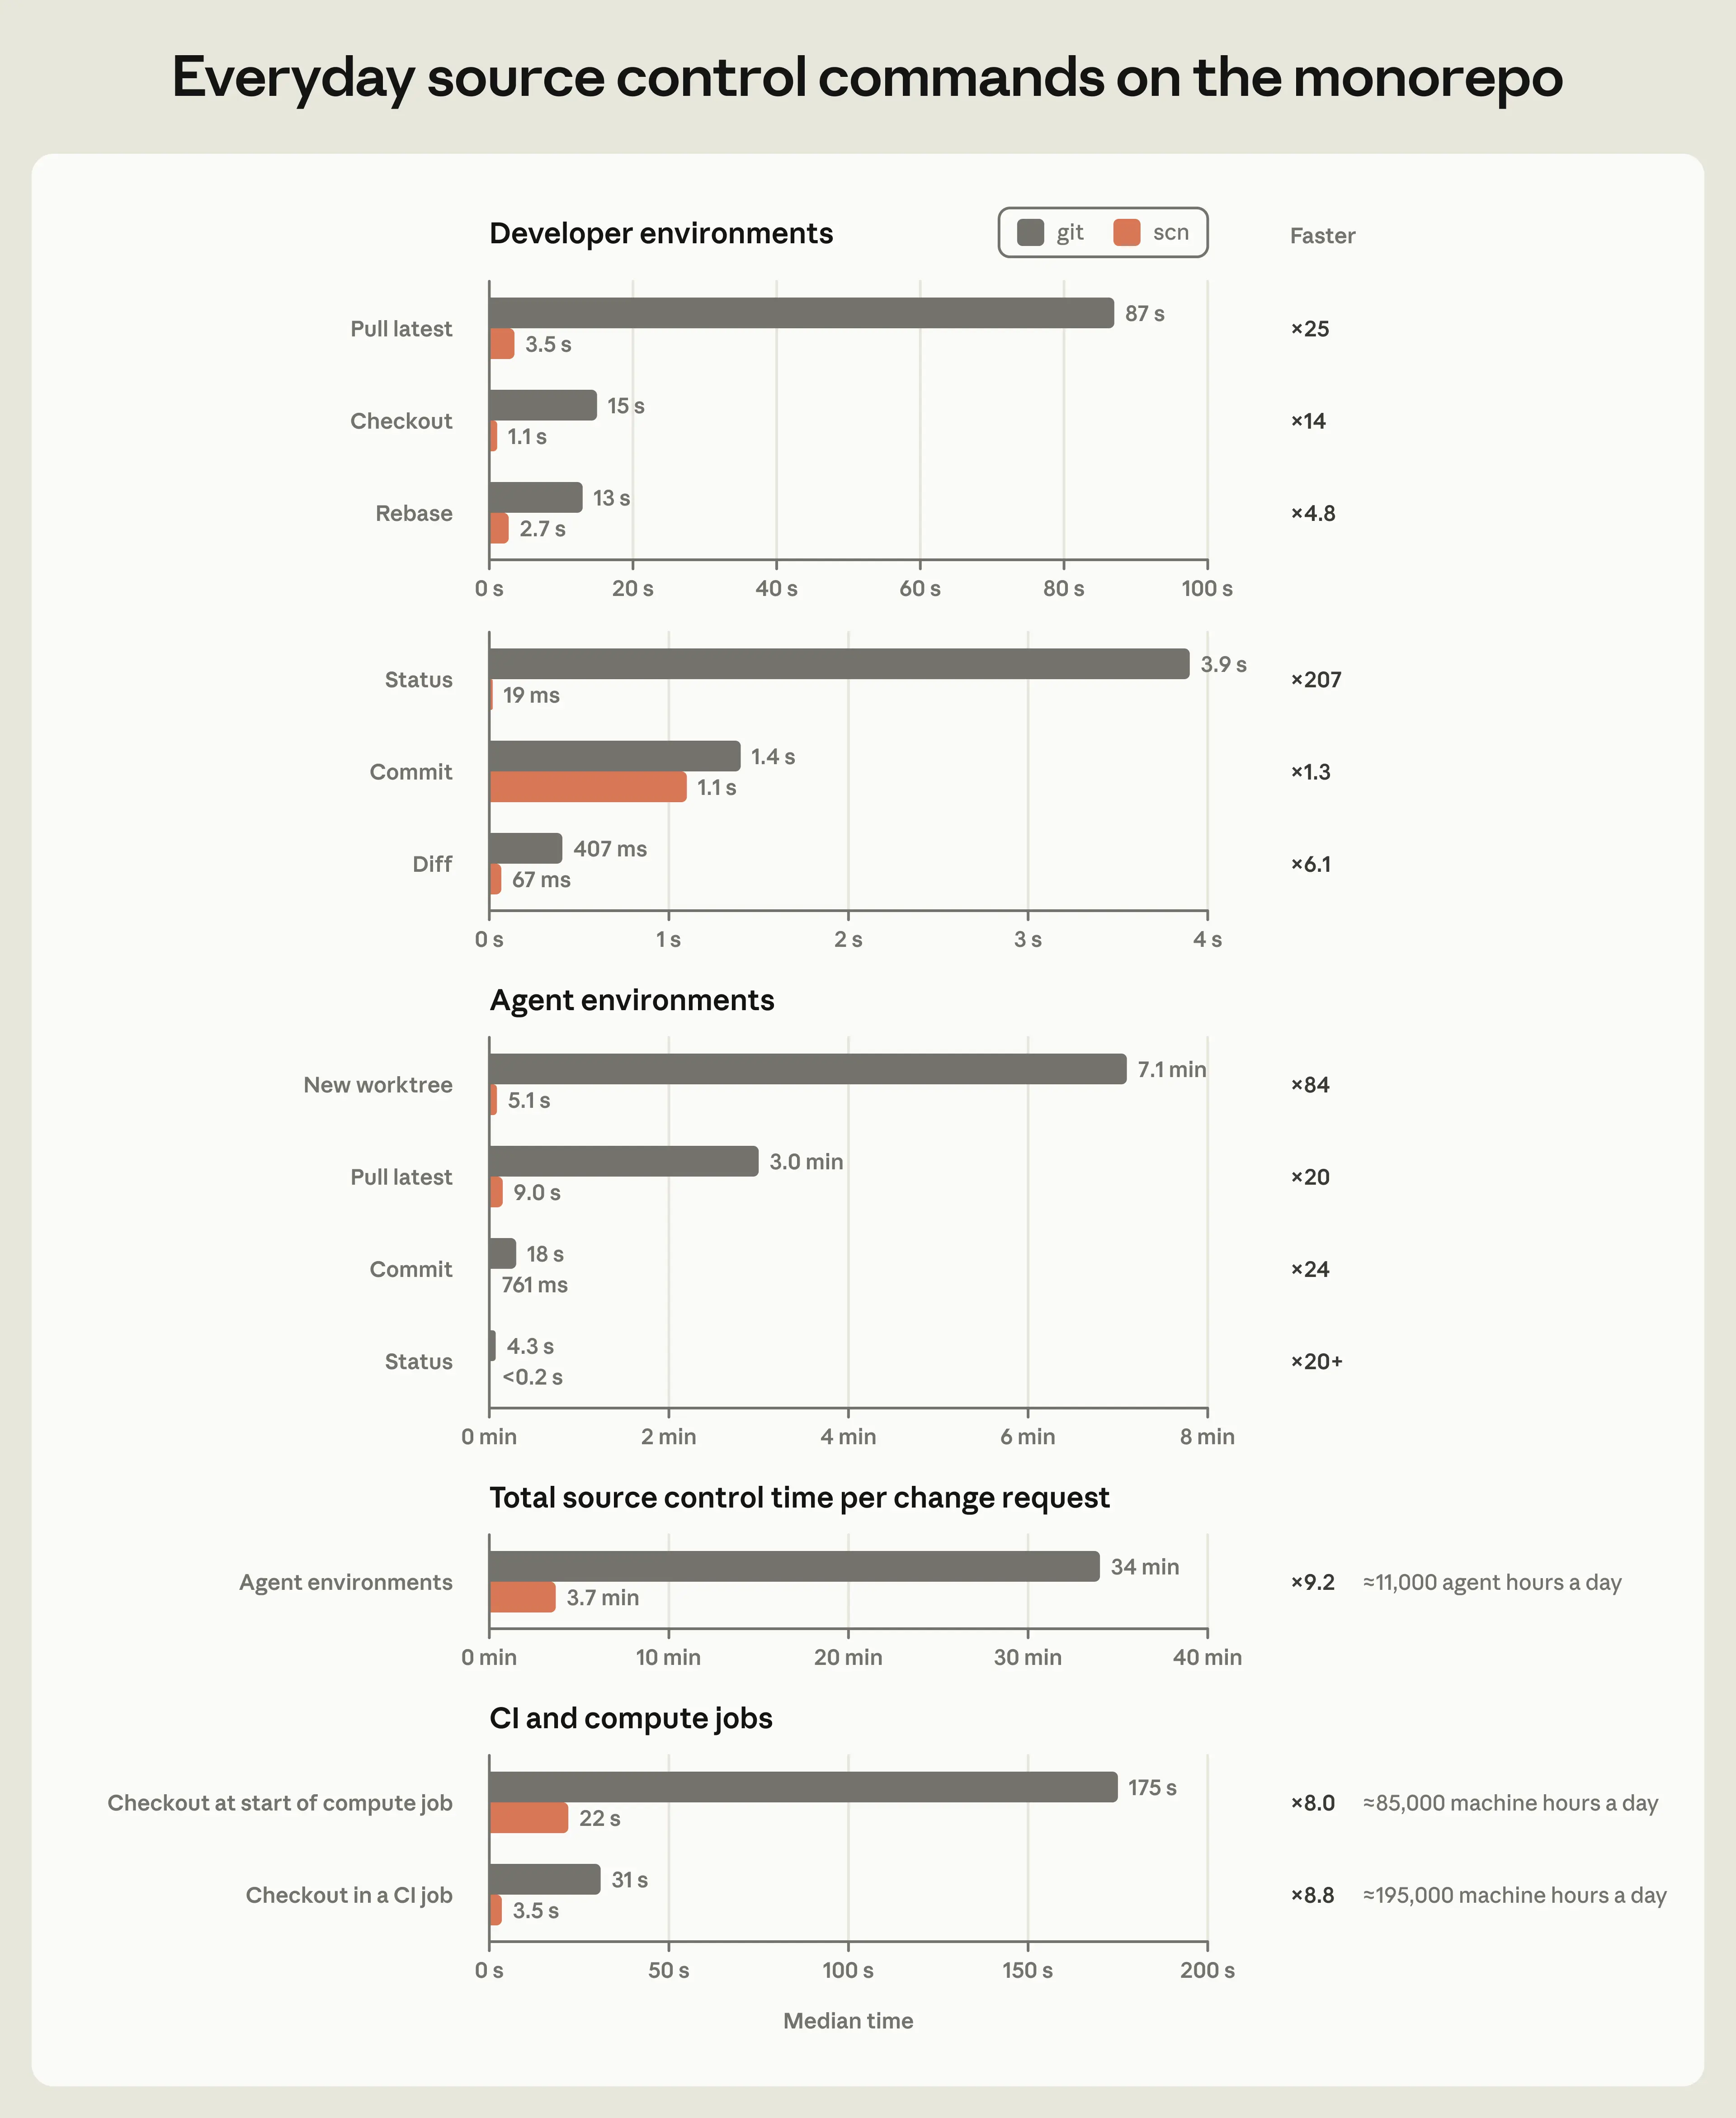
Каждый уровень этой системы поддерживает hit rate кеша свыше 99% и не требует долгоживущего состояния, поэтому легко масштабировать вверх при необходимости. Инфраструктурный footprint Scion теперь 200x меньше, чем предыдущая инфраструктура git-зеркалирования в терминах требований CPU и памяти. CI и research jobs checkout код на два порядка быстрее (секунды вместо минут), что освобождает значительный объём пропускной способности по флоту; CI один реализовал 25% win CPU пропускной способности. Ни клиентам, ни кешам не требуется выполнять обслуживание репо, что упрощает управление жизненным циклом заданий.
Что научились, строя Scion
Начали строить Scion примерно в то же время, когда Claude Mythos Preview и Claude Tag стали доступны внутренне. Оба эти релиза одновременно усилили необходимость в Scion и осмысленно ускорили скорость, с которой удалось построить.
Вот особенно поразительный пример. Ранее в году в значительной степени вручную написали первую версию pipeline миграции git-to-Scion как прототип. Думали, это хорошо — пока не получили руки на раннем внутреннем снимке Claude Mythos Preview. Попросили переписать всё, и без дальнейших инструкций произвела версию, которая потребляла 20x меньше памяти и была 4x быстрее, при этом сохраняя все неявные инварианты вокруг ingestion ordering и структур данных.
Опыт построения и использования Scion предоставляет интересные уроки для того, как может выглядеть построение ПО в масштабе агентов.
Быстрая разработка с маленькой командой станет более распространённой. Команда из семи человек построила и Scion и Antique (инструмент рецензирования кода, о котором легко можно написать целый другой blog post), не говоря о полудюжине связанных систем, и полностью мигрировала на них за пять месяцев. Сделали всё это, пока объём кода, смёрженного в день, вырос в 10 раз. В прошлом, разработка и развёртывание системы контроля версий, подобной этой, заняли бы у компании годы итеративной миграции, с намного большим числом инженеров. Думаем, такого рода быстрые, гибкие миграции станут более распространёнными в будущем.
Инженеры не менее ценны, но их работа меняется. Все инженеры, работавшие над этой системой, теперь оценивают Claude как лучшего в написании кода, чем себя. Но инженеры по-прежнему предоставляли неоценимое понимание компонентов систем высокого уровня и компромиссов на уровне дизайна, принимая информированные решения о проблемах, которые хотелось решить, и масштабе, который знали, нужно достичь. Очень часто роль инженеров была сказать Claude "нет". Агенты иногда нарушают основные ограничения системы, чтобы удовлетворить паттерн, который никогда не должен был быть разрешён в первую очередь. Это было особенно распространено в нашей миграции. Например, было несколько систем, которые пытались brute force поиска того, когда изменение смёрджилось в main, линейно читая commit log вместо того, чтобы спросить инструмент рецензирования кода. Anthropic также делает обширное использование adversarial review, и, хотя это невероятно эффективно во многих отношениях, это также может быть близоруким, поэтому квалифицированные инженеры должны были направить Claude прочь от over-engineering частей системы в ответ на hypothetical concerns. Например, один такой review был чрезмерно defensive об доверии другому внутреннему сервису, что привело к Claude добавлению чрезмерной валидации и complexity. Члены команды по-прежнему проверяют каждый change request для системы, но теперь они изучают intent изменения вместо чтения каждой строки кода.
Удалось существенно улучшить оптимизацию и качество. В силу способности Claude писать огромные объёмы кода намного быстрее, чем удалось бы самим, Scion — одна из самых хорошо протестированных и хорошо защищённых базы кода, с которой когда-либо работали. Даже при tight timeline удалось построить hermetic симуляции каждого нетривиального infrastructure и source control взаимодействия, которое когда-либо встречали, а также fuzzing и sophisticated rate limiting. Claude также случайно нашла значительные оптимизации — например, algorithmic optimization запросов ancestry, которые пропустили один из индексов — которые заняли бы эксперта дни или недели анализа и tuning… а затем сделала всё это снова на следующий день.
Заложили основу для новых форм безопасности монорепо. Управление safety, security и compliance в массивном монорепо так же важно, как управление размером и масштабом. Построили Scion с этим в виду с самого начала. Поддерживает rich control доступа на репозитории, а также способность применяет разрешения на отдельные директории, чтобы защитить самый чувствительный код без потери преимуществ монорепо. Кроме того, инструмент рецензирования кода, который построили, может выражать сложные семантические ограничения на одобрения, что позволяет дифференцировать простые вещи, как comment-only changes от чувствительных логических изменений, поэтому human reviewers могут сосредоточиться на самых consequential изменениях.
Возможна новая уровень операционного совершенства. Команда использует Claude Tag тяжело, что помогла мониторить каждый компонент системы. Например, создали Slack channels, где дали Claude задачу быть obsessively focused на здоровье одного компонента. Называют этих Claude "superfans". Есть scion-daemon superfan, scion-cache superfan, Antique merge queue superfan и так далее. У них есть доступ к telemetry и logs, и они действуют как опытный инженер, у которого нечего лучше делать, чем обновлять charts и смотреть на что-то странное. Также есть традиционные alerts для всех систем, но superfans могут обнаружить subtle и novel issues, которые делают эти alerts одномерными по сравнению.
Полностью переосмысляем priors. Этот проект побудил очень внимательно посмотреть на другие workflows, спроектированные для человеческого масштаба. Например, proper merge queue не имеет большого смысла в масштабе агентов. Что же такое CI, когда сотни или даже тысячи изменений могут смёржиться, пока тесты выполняются? Не удалось эффективно replicate industry standard глобальной repository lock на merge queue, поэтому вместо этого инвестировали в post-merge и pre-deploy automated testing. Это означает, что concurrent изменения могут конфликтовать, но Claude обычно может fix эти конфликты быстрее, чем люди могут даже их идентифицировать.
Способствуя более широкой экосистеме
Видим Scion как только одну часть ответа на проблемы масштабирования, которые всё более способные AI-агенты подняли. Делимся этими деталями как пример того, как команды могут решать похожие задачи, хотя не ожидаем, что решение или соображения подойдут для каждого случая.
Scion — отнюдь не подходящая замена Git для общего использования. Концепции, которые очерчены здесь, действительно имеют смысл только для действительно огромных монорепо, с либо десятками тысяч инженеров, либо swarms агентов, плодотворно пишущих код. Плюс, Anthropic уникальна тем, что способность тратить tokens для внутреннего использования намного превышает то, что любой другой бизнес реалистично захотел бы потратить. Делаем это и для решения собственных потребностей разработки ПО, и для тестирования возможностей Claude.
С практической точки зрения, сложно предложить Scion в форме, которая была бы широко полезна другим организациям. Значительно отличается от Git, означая, что компании нужно было бы мигрировать каждый piece цикла разработки, и требует собственный code review, code search и CI. Внутренние версии этих компонентов весьма bespoke, поэтому были бы сложны для других организаций adopt, и волновались бы, что попытка построить public версию, которая пытается угодить каждому, не была бы действительно полезна.
Однако ожидаем, что этот класс проблем станет более обычным в течение следующих 6—12 месяцев, и было бы неэффективное использование инженерных ресурсов для каждой компании, используя Git, столкнуться с похожими проблемами в одиночку. Given that, думаем, наиболее impactful вещь, которую можно сделать — поделиться thinking, чтобы другие разработчики могли apply некоторые из самых успешных частей Scion в Git без departing от общей модели. Git-сервер не должен работать так же, как git-клиент; существуют novel server архитектуры, которые обеспечивают значительные улучшения масштабирования. Git-платформы могут предоставить comprehensive server-side RPCs, подобно Scion, может быть, даже в standardized way через forges, которые git-клиент может learn говорить. Negotiation-протокол также не должен выглядеть точно так же, как сегодня, и различные sparse и shallow features в Git могут быть made compose хорошо.
Наконец, хотелось бы подтвердить, что git-сообщество потратило почти два десятилетия масштабирования платформы для миллионов разработчиков. Способствование ограниченнее: поделиться ранним взглядом на то, как agentic разработка ПО взаимодействует с этими системами, чтобы мы могли partner с GitHub, GitLab и OSS-сообществом для поддержки меняющихся потребностей разработчиков. Все в этом вместе, поскольку цикл разработки ПО пересекается с AI exponential.
Благодарности
Написано Nick G. и командой контроля версий: S.G., R.K., Dan C., Garrett H., Ben L., Colin M., Joe P. Благодарны Vilas J. и Sergiu D. за поддержку team контроля версий на этом амбициозном пути и Amir O. за ранние способствования к Antique.