Не кремний, но похоже
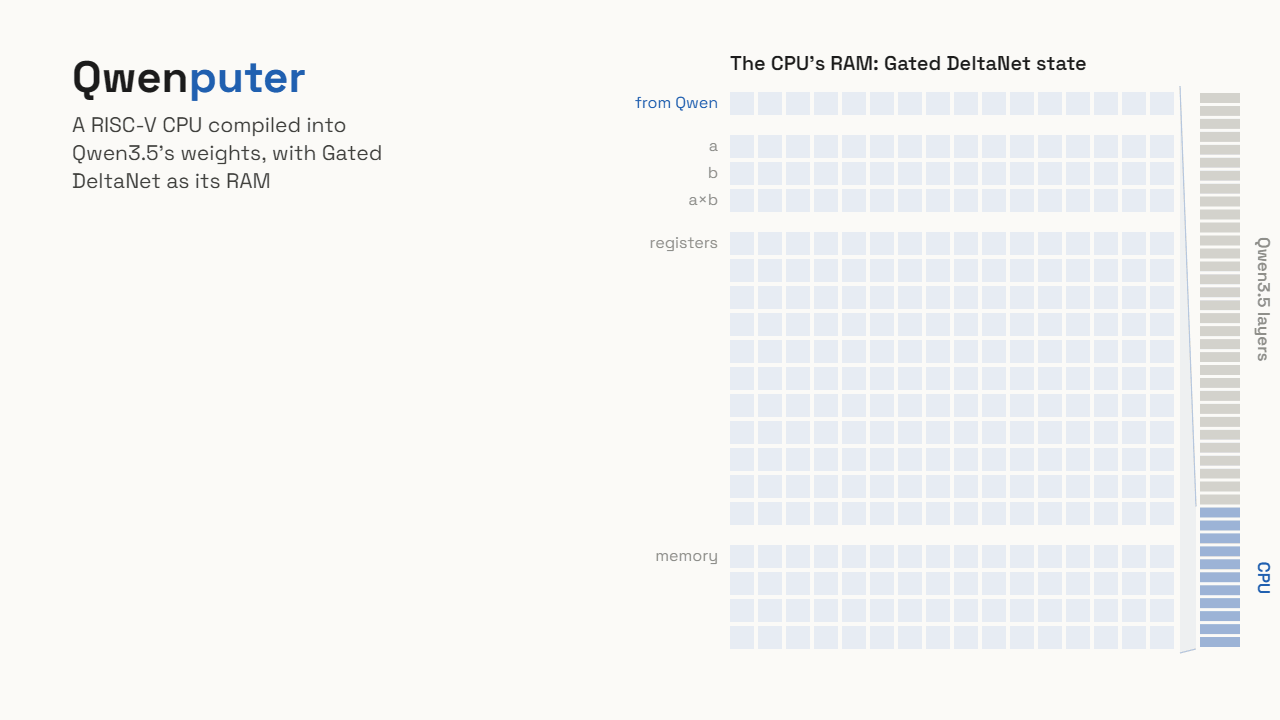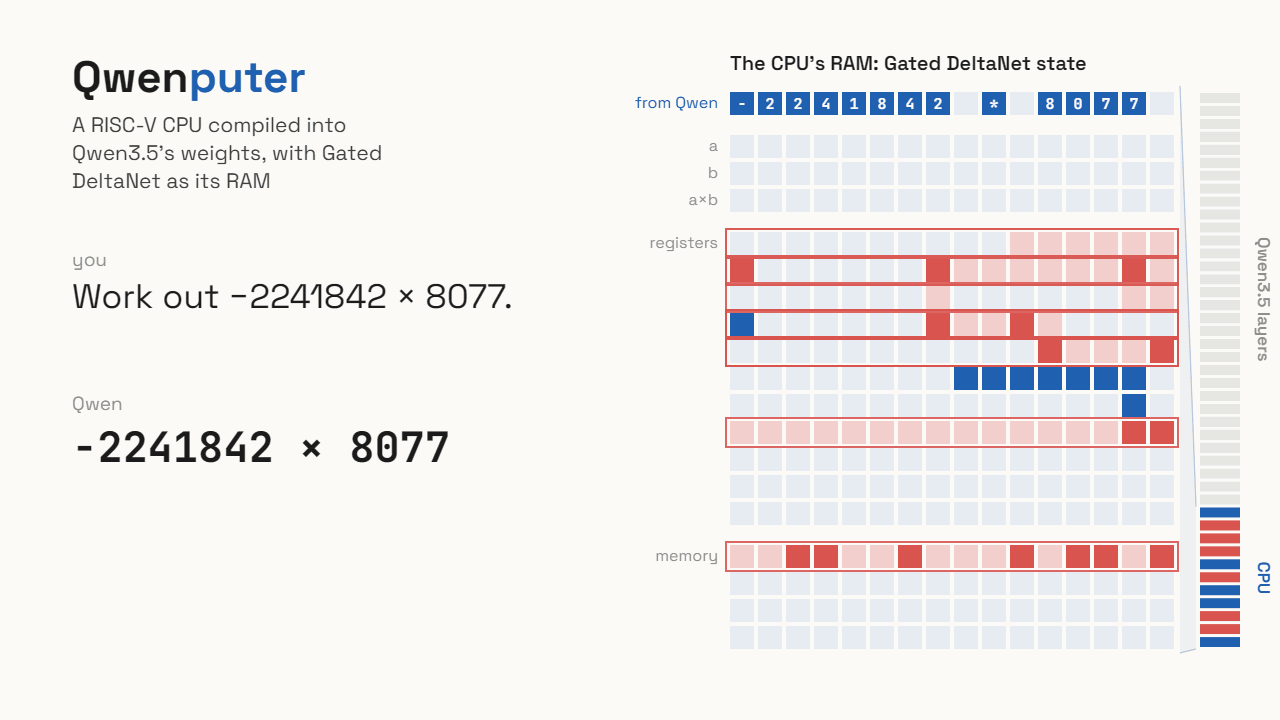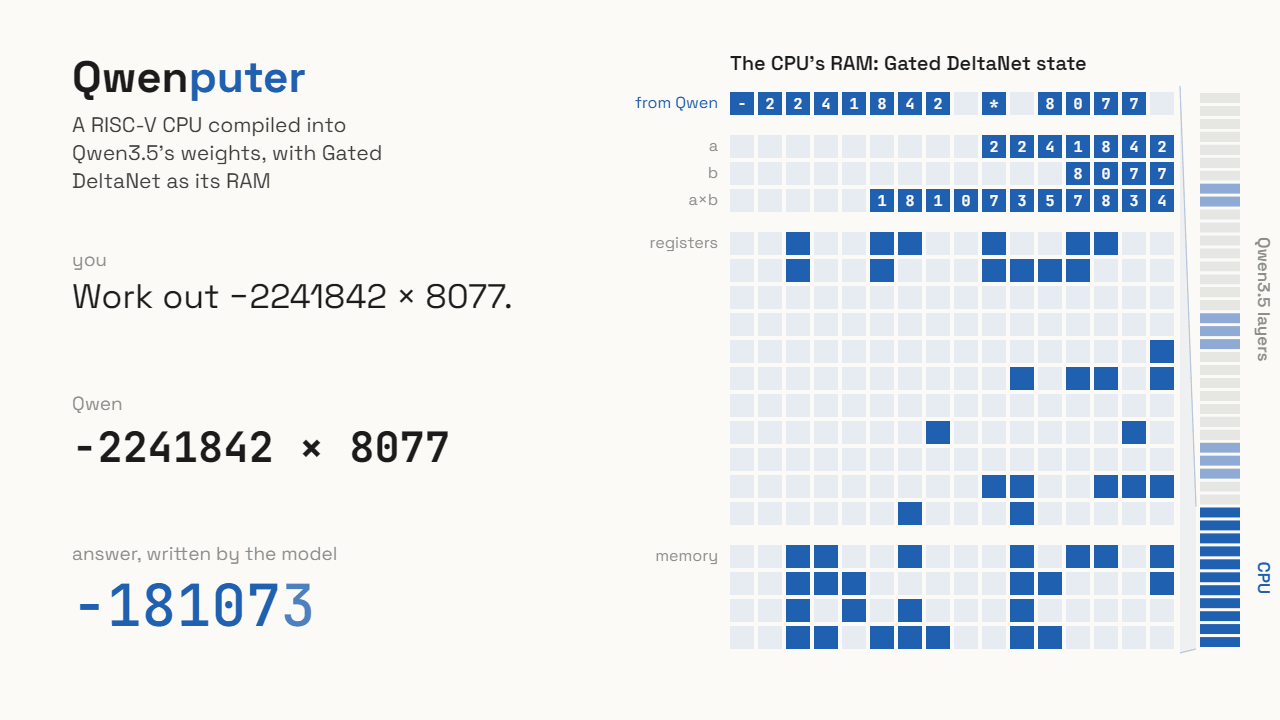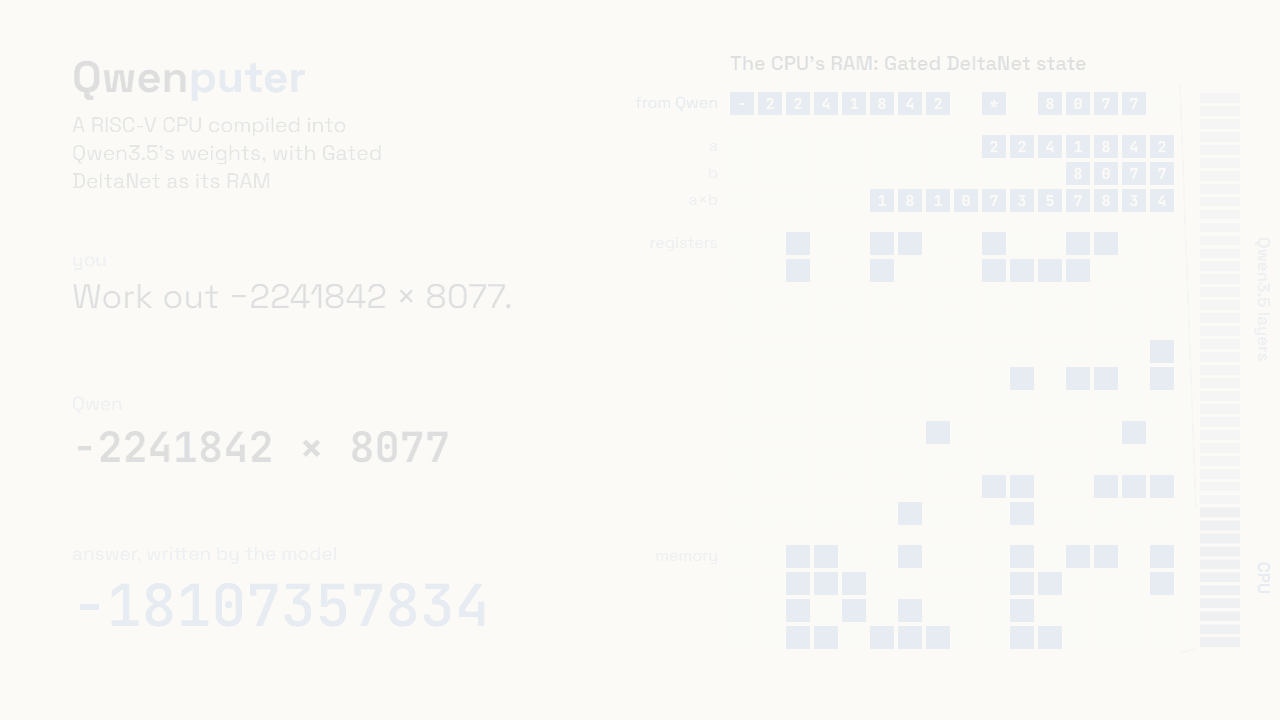
Qwenputer — интересный экспериментальный проект. Это стандартная Qwen 3.5 4B с одним добавлением: RISC-V процессор, встроенный в веса, который использует слои внимания Gated DeltaNet самой модели как оперативную память. CPU работает полностью внутри прямых проходов модели и может исполнять арифметические операции, код на C и MicroPython без каких-либо внешних рантаймов или инструментов.
Это не плагин, не инструмент и не песочница. Эта статья объясняет, как именно работает эта модель, как она использует слои GDN как RAM, и как была внедрена экспериментальная система хранения файлов.
Автор также написал две продолжения: как гибридные модели могут скрывать своё мышление в состоянии RNN и избежать отслеживания цепочки рассуждений, и как скомпилированные веса могут работать как встроенные инструменты мониторинга, которые модель не может отключить.
Qwenputer доступен на Hugging Face и ModelScope, исходный код — на GitHub.
RNN внутри Qwen3.5 может работать как точная RAM
Qwen3-Next и Qwen 3.5 (модель, на основе которой построен Qwenputer) используют интересный приём. 3 из 4 слоёв внимания используют Gated DeltaNet, линейный RNN, как механизм внимания. Каждая голова сохраняет матрицу состояния, которую обновляет дельта-правило.
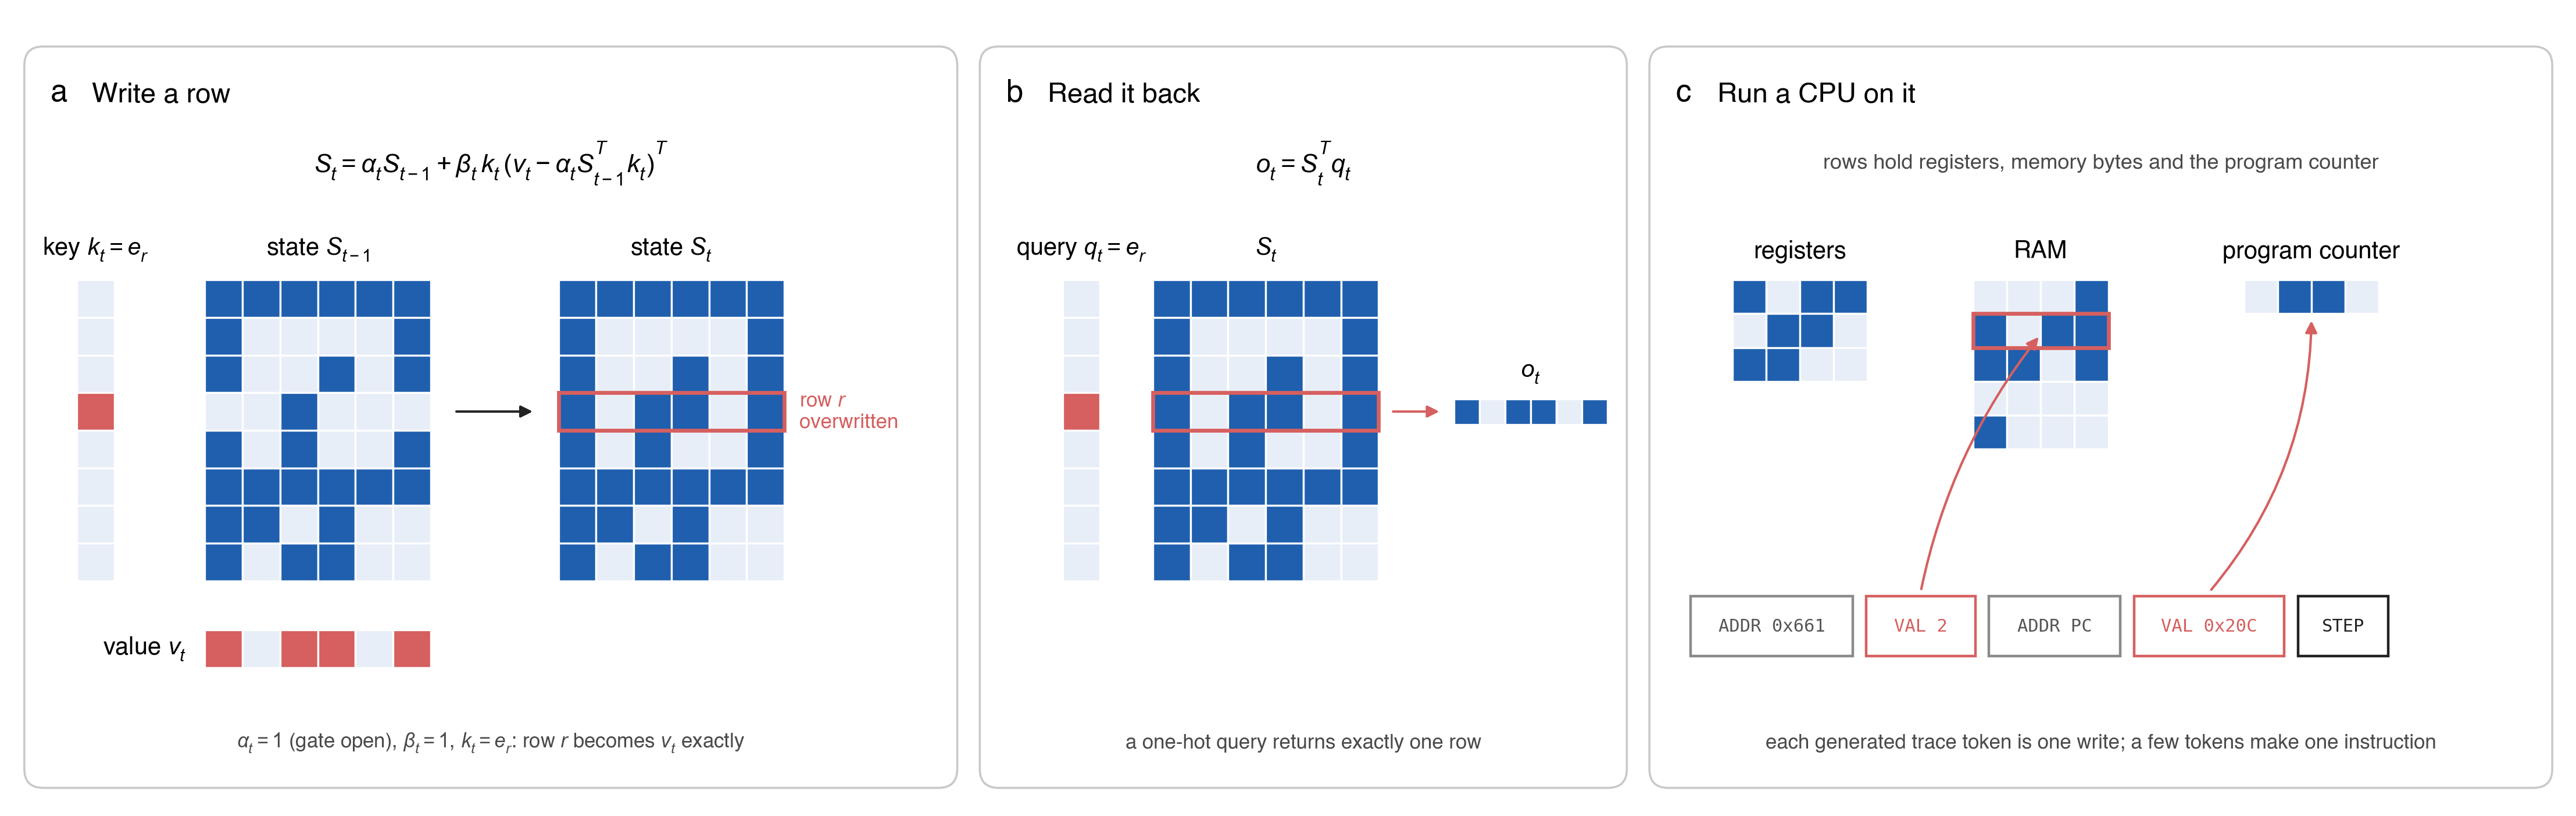
И вот тут начинается забавный эксперимент. Было обнаружено, что если установить gate равным 111 Каждая голова Gated DeltaNet сохраняет матрицу состояния, её память. На каждом токене перед записью чего-то нового она умножает всё состояние на gate — число между 0 и 1. Так RNN забывает: gate 0,9 чуть размывает всё хранящееся на каждом токене, а gate 1 означает, что ничего никогда не размывается., коэффициент записи (beta) равным 122 После gate голова подталкивает одно направление состояния к новому значению, и beta определяет, насколько далеко. Beta 1 означает, что старое значение в том направлении полностью заменяется вместо того, чтобы смешиваться., и используя one-hot кодирование ключей33 One-hot ключ — это вектор нулей с единственной единицей, он указывает ровно на одну строку состояния, как адрес памяти указывает на одну ячейку., каждая запись будет перезаписывать ровно одну строку, и каждый one-hot запрос может получить точное значение. Это означает, что слои GDN сами могут работать как точная RAM, намного дешевле, чем использование обычного внимания для RAM, потому что состояние голова GDN сохраняет постоянный размер независимо от длины диалога, в отличие от кэша KV обычного внимания.
Идея, что дельта-правило работает как память, известна давно: Schlag et al. (2021) показали, что линейное внимание с дельта-правилом работает как ассоциативная память или «быстрые веса»44 Imanol Schlag, Kazuki Irie и Jürgen Schmidhuber, «Linear Transformers Are Secretly Fast Weight Programmers», ICML 2021.. Новое здесь — сделать это точным и адресуемым, внутри работающей модели, достаточно надёжно, чтобы запустить на ней целый процессор.
Это основание, на котором построен весь этот эксперимент. В текущем виде стандартная Qwen 3.5 не сохраняет точные значения в GDN. С этой модификацией разблокируется следующая часть эксперимента.
Компилирование компьютера в слои
Когда есть полностью функциональная, дешёвая и быстрая RAM, можно переходить к компилированию рабочего CPU в веса модели. К счастью, здесь не требуется обучение: компилятор напрямую устанавливает каждый вес. CPU описывается как схема — длинный список небольших шагов вроде «прочитай этот регистр», «сложи эти два числа» или «прыгни если ноль», и компилятор превращает каждый шаг в кусок слоя трансформера: головы внимания, которые ищут значения, полносвязные блоки, которые делают арифметику, и головы DeltaNet, которые держат RAM. Процессор затем работает по мере декодирования модели.
Каждая инструкция становится несколькими сгенерированными токенами: один называет строку памяти для записи (ADDR), следующий несёт значение (VAL), а токен STEP завершает инструкцию. Эти токены — это трассировка выполнения процессора, так что во время генерации процессор фактически работает.
Процессор
Процессор — это 32-битное ядро RISC-V (RV32IM плюс расширение Zba и небольшой bignum блок для арифметики с большими числами), занимает 11 слоёв из 32 Qwen. На данный момент проходит официальные тесты riscv-tests, его программы совпадают с qemu, и уже отработал 18 миллионов инструкций в свободном режиме без единой ошибки55 Свободный режим означает, что процессор продолжает работать на своих собственных выходах на всё время запуска, без каких-либо эталонных машин, исправляющих его между шагами..
Этот процессор может также довольно хорошо запускать код на C и MicroPython в прямых проходах (хотя немного медленно). Это ещё не процессор класса Linux, но он реализует полный набор инструкций RV32IM.
Как Qwen его использует
Qwen 3.5 4B может использовать этот процессор довольно хорошо, без какого-либо доучивания. Процессор используется полностью внутренне и не вызывается через какие-либо внешние инструменты.
Чтобы модель использовала это надёжно, выбран простой путь: используя формат вызова инструментов, на котором модели хорошо обучены, Qwen отправляет процессору его инструкции и читает результаты обратно. Внешние инструменты или рантайм не используются. Как только процессор получает инструкции, работают слои компьютера и затем пишут ответ инструмента. Используется небольшой драйвер RvChat для загрузки прошивки в состояние GDN, и это держит токены трассировки вне слоёв Qwen.
Оригинальные веса Qwen остаются точно такими же. Веса компьютера добавляются сверху, в дополнительные размерности и слои.
Это работает?
Основной вопрос после прочтения всего этого, вероятно, звучит так: это действительно работает?
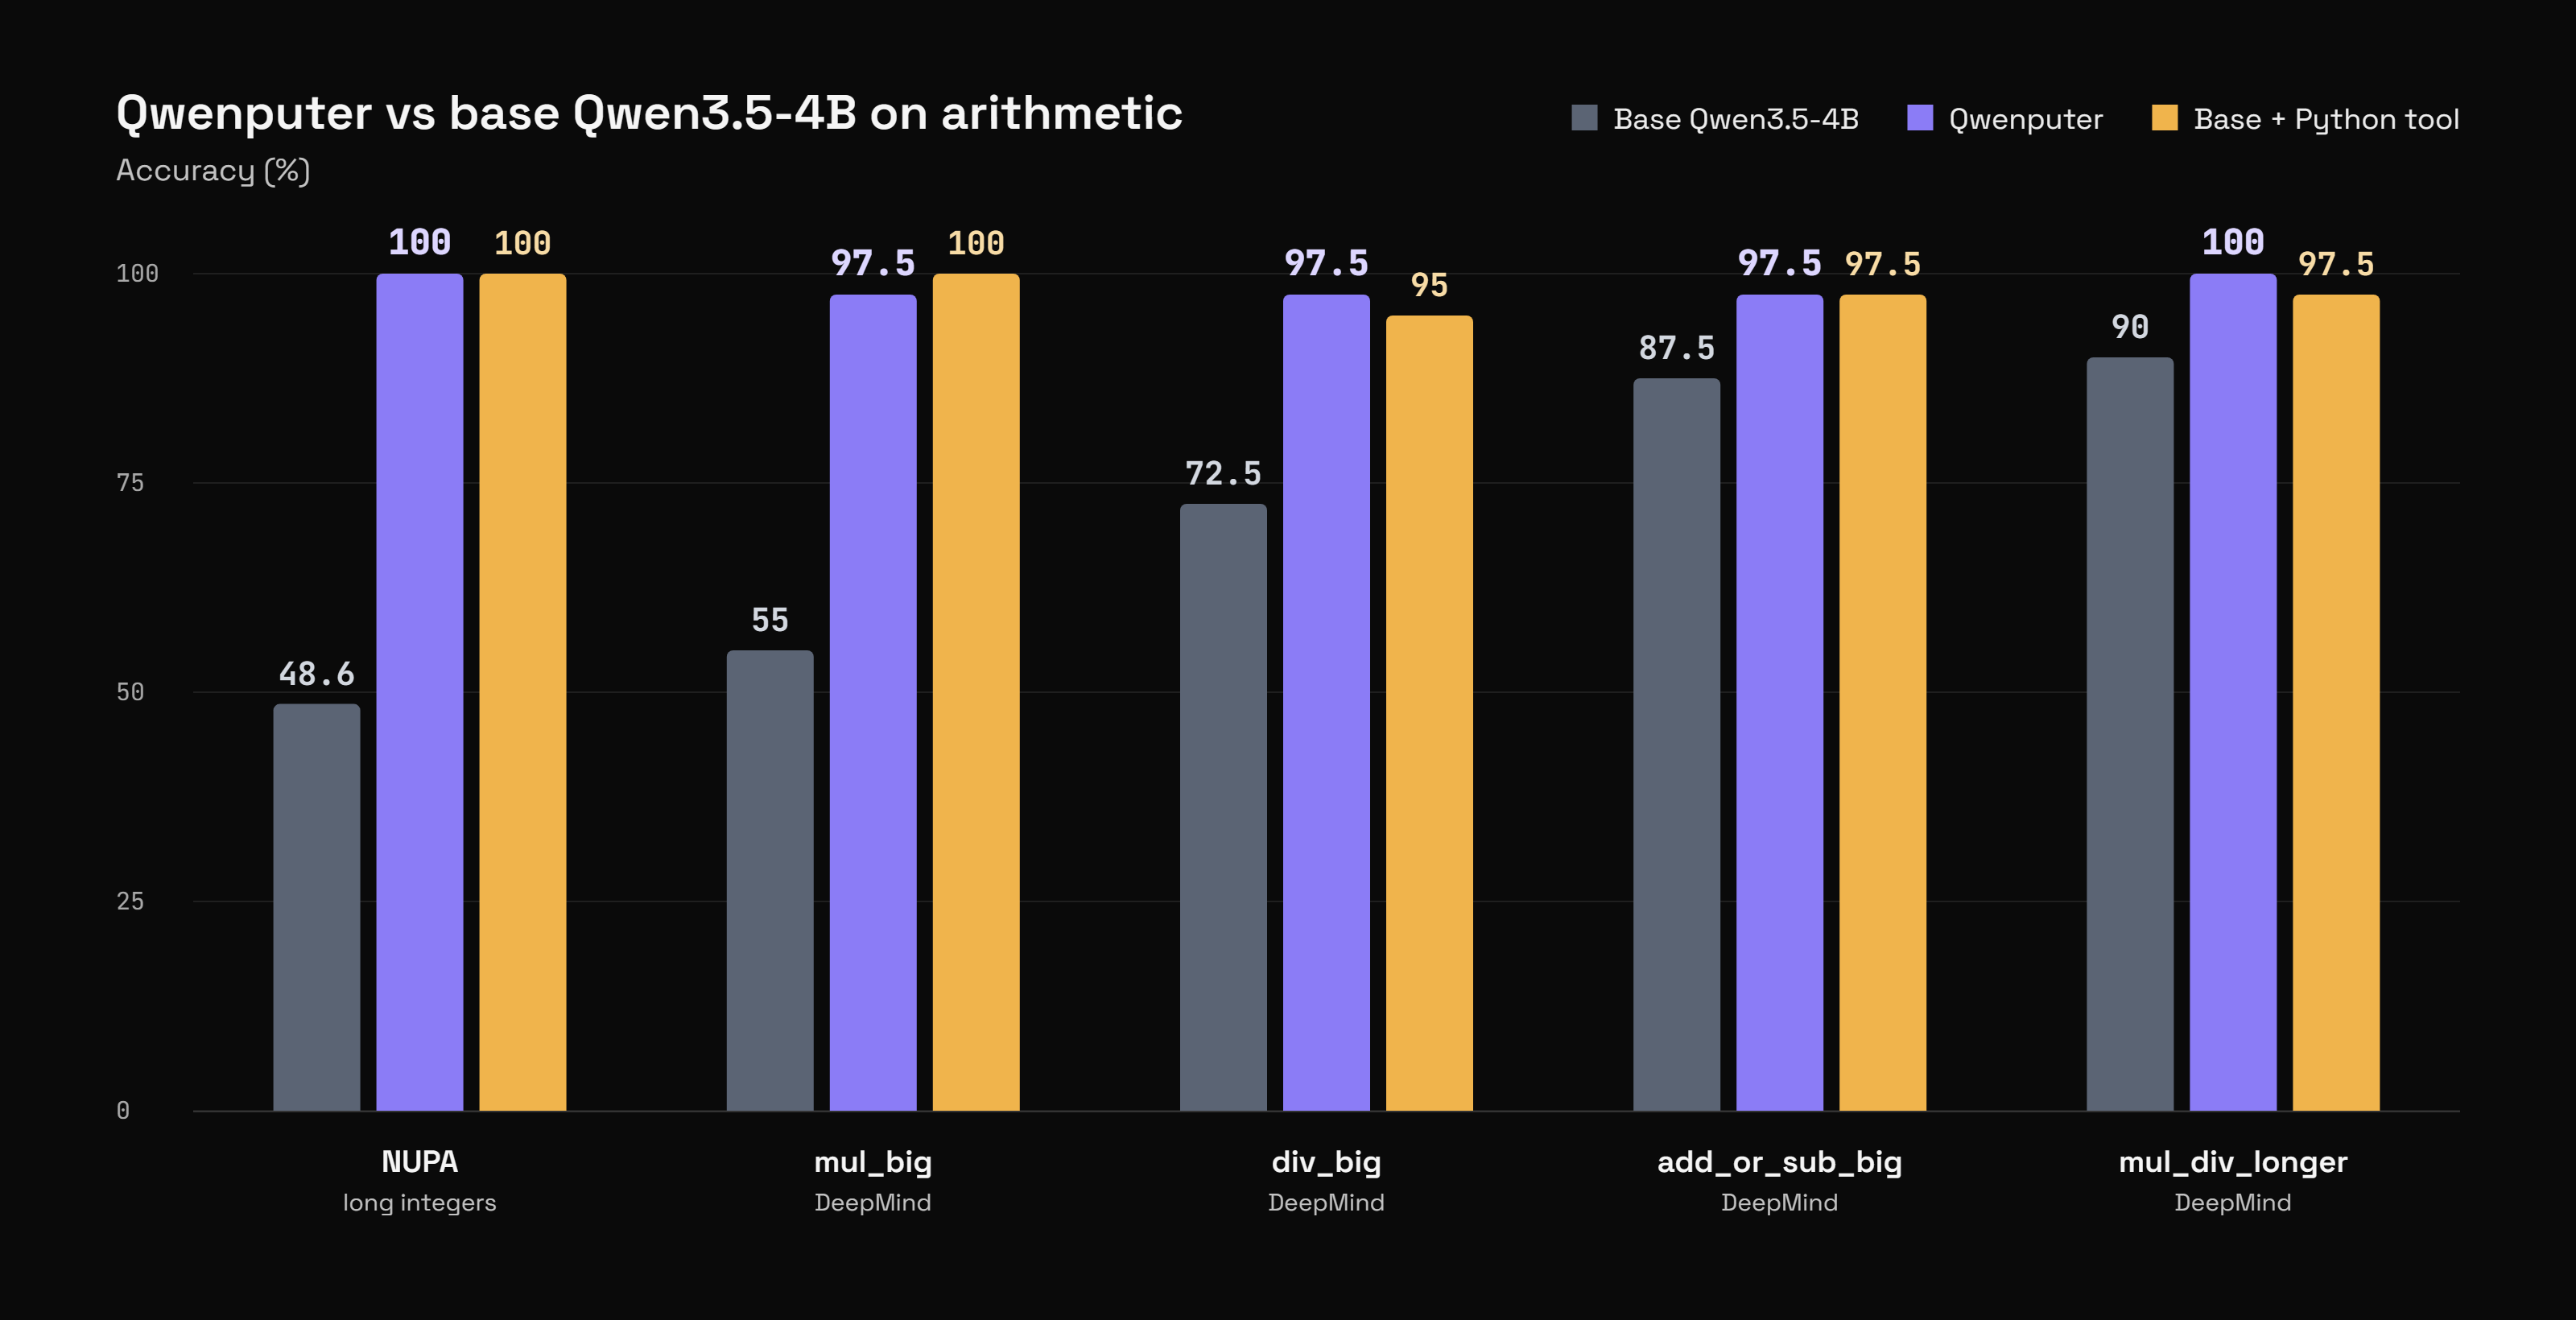
На наборах DeepMind:
- div_big: Qwenputer достигает 97,5%, против 95% при использовании инструмента Python с Qwen 3.5 4B и 72,5% для базовой Qwen;
- mul_big: Qwenputer достигает 97,5%, против 100% с инструментом Python и 55% для базовой Qwen;
- mul_div_multiple_longer: Qwenputer достигает 100%, против 97,5% с инструментом Python и 90% для базовой Qwen;
- add_or_sub_big: Qwenputer достигает 97,5%, как с инструментом Python, и 87,5% для базовой Qwen.
На арифметике с длинными целыми числами NUPA Qwenputer повышается с 48,6% до 100%, как при использовании инструмента Python с Qwen.
Числа, которые печатает процессор, точны: примерно 230 000 его выходных позиций были воспроизведены на эталонной машине, и не было найдено ни одного несовпадения. И добавление компьютера к Qwen не меняет то, как она говорит: её обычный текст остаётся в пределах шума базовой Qwen (KL 6e-4, при уровне шума 5e-4).
Жёсткий диск? В такие времена?
Потому что процессор внутри языковой модели явно уже был достаточно проклят, разумным казалось дать ему ещё и файловую систему.
Так как уже была функциональная RAM, это было в основном тривиально. На стороне модели это выражается через внутренние операции put / append / get / list / delete. И снова, никаких реальных вызовов инструментов. Когда Qwen «сохраняет» файл, скомпилированные слои хэшируют его имя в один из 1024 слотов в директории, сохраняемой в состояния DeltaNet, и хранят сам текст в других головах, по восемь токенов на строку, связанных вместе. В случаях, когда два имени попадают в один слот, просто проверяется следующий. Поиск файла снова занимает примерно два или три шага вместо полного сканирования, и может хранить до 512 файлов, что составляет около 53 000 токенов текста.
Забавный момент: это довольно постоянно. Можно сохранить состояние в конце диалога, загрузить его в следующий, и файлы всё ещё там. Используя эту файловую систему, Qwen правильно получает факты, которые изменились между чатами в 90% случаев, против 30% при вставке старых чатов обратно, и это сопоставимо с дачей Qwen инструментов памяти, работающих на Python (83,3% против 78,9%). Это ещё экспериментально, код находится на ветке rv-store, модель на Hugging Face и ModelScope.
Ограничения и что дальше
Qwenputer — это очень экспериментальный проект, поэтому есть несколько ограничений. Дополнительные слои и более широкий скрытый размер делают чекпоинт 18,8 ГБ, примерно в два раза больше базовой Qwen, хотя большинство из этого — нулевое заполнение. Также нужен небольшой драйвер (RvChat) для загрузки прошивки и держания токенов трассировки вне слоёв Qwen, поэтому пока не работает с простым вызовом `generate()`. И это немного медленно, каждая инструкция процессора стоит несколько декодированных токенов, поэтому большой расчёт занимает секунды, а не миллисекунды. Выполнитель с пакетной обработкой, используемый для бенчмарков, работает примерно 3200 токенов процессора в секунду на L4.
Далее хочется, чтобы Qwen писала Python и запускала его на MicroPython внутри своих весов, через инструмент `python()`, который работает так же, как `calc`. Ещё одно большое улучшение — сделать процессор быстрее.
Дальше арифметики
Точный контроль над слоями RNN полезен для намного большего, чем просто арифметика. Это также делает Qwenputer действительно хорошей испытательной базой для исследований безопасности AI, и написаны два продолжения: как гибридные модели, подобные Qwen 3.5, могут научиться скрывать своё мышление в состояния RNN и избежать отслеживания цепочки рассуждений, и как скомпилированные веса могут работать как инструменты контроля, как встроенный в веса монитор, который модель не может отключить, или ключи ответов для интерпретируемости.
Попробуй сам
Если хочешь поиграть с этим, модель работает на одном GPU объёмом 24 ГБ. Нужны uv и Hugging Face CLI. Не нужен сервер инструментов или песочница Python для расчётов: процессор запускает их внутри модели.
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \
    --ask "Use calc: what is 123456789 * 987654321?"
Всё открыто: код на GitHub и обе модели на Hugging Face (Qwenputer, Filesystem) и ModelScope (Qwenputer, Filesystem).
Если используешь это в своей работе, можно цитировать как:
@software{agrawal2026qwenputer,
  author  = {Agrawal, Divyansh},
  title   = {{Qwenputer}: a computer compiled into the weights of a pretrained language model},
  year    = {2026},
  url     = {https://github.com/divagr18/qwenputer}
}
Примечания
- Каждая голова Gated DeltaNet сохраняет матрицу состояния, её память. На каждом токене перед записью чего-то нового она умножает всё состояние на gate — число между 0 и 1. Так RNN забывает: gate 0,9 чуть размывает всё хранящееся на каждом токене, а gate 1 означает, что ничего никогда не размывается. ↩
- После gate голова подталкивает одно направление состояния к новому значению, и beta определяет, насколько далеко. Beta 1 означает, что старое значение в том направлении полностью заменяется вместо того, чтобы смешиваться. ↩
- One-hot ключ — это вектор нулей с единственной единицей, он указывает ровно на одну строку состояния, как адрес памяти указывает на одну ячейку. ↩
- Imanol Schlag, Kazuki Irie и Jürgen Schmidhuber, «Linear Transformers Are Secretly Fast Weight Programmers», ICML 2021. ↩
- Свободный режим означает, что процессор продолжает работать на своих собственных выходах на всё время запуска, без каких-либо эталонных машин, исправляющих его между шагами. ↩