Откуда взялась идея публиковать поддельную статистику
Толчком к наполнению сайта статистикой стало длительное исследование LLM, relevance engineering и grounding (спасибо команде iPullRank, Dan Petrovic и Wil Reynolds).
В ходе работы обнаружился паттерн: чем больше команд пишут актуальные и срочные материалы с помощью LLM, тем интенсивнее модели ищут (кажущиеся) надёжные данные для заполнения пробелов в знаниях. Статистика часто — именно то, что им нужно.
Большинство рекомендаций по GEO фокусируются на одном моменте: попасть в AI-ответ. Этот эксперимент показывает, что происходит дальше — когда люди берут этот вывод и используют его, вставляют в презентации, добавляют в шопинг-лист и, да, публикуют на своих сайтах.
Идею не придумал один я. Спасибо Seer Interactive, которые уже опубликовали открывающее глаза исследование в августе 2025, которое натолкнуло на размышления. Несколько месяцев спустя мысли сложились, и в марте 2026 я наконец начал работу над сайтом для проверки идей.
Подготовка: сайт и 50 тысяч вымышленных статистических данных за один день
Контекст для тех, кто не следил за экспериментом в реальном времени:
Купил новый домен stateglobe.com и сгенерировал 50 тысяч страниц со статистикой в один день с помощью GPT-4.1. Сайт позиционирует себя как поставщик статистических данных по SEO, контент-маркетингу, социальным сетям, e-commerce и веб-технологиям из 200 стран. Только все цифры полностью вымышленные. Ни одну не проверил. Загрузил их на сайт с простым AI-шаблоном дизайна. Обошлось примерно в $30. Позже добавил 15 тысяч лисциклов сверху. Ещё $20, итого эксперимент обошёлся примерно в $50.
Реакция при первой публикации была дикая. Когда мой друг Kevin представил это в Growth Memo, достигло гораздо большей аудитории. Думаю, люди так воодушевлены, потому что это показало отличные результаты и при этом коснулось страхов, которые люди испытывают перед тем, что попадает в результаты AI-поиска.
Что произошло
Google похоронил сайт почти сразу
При запуске трафик, индексация и вовлечённость изначально развивались хорошо. С помощью инструментов индексирования почти весь сайт был проиндексирован за неделю и начал появляться в результатах Google.
Потом вышли два обновления Google прямо после запуска, и видимость в Google рухнула.
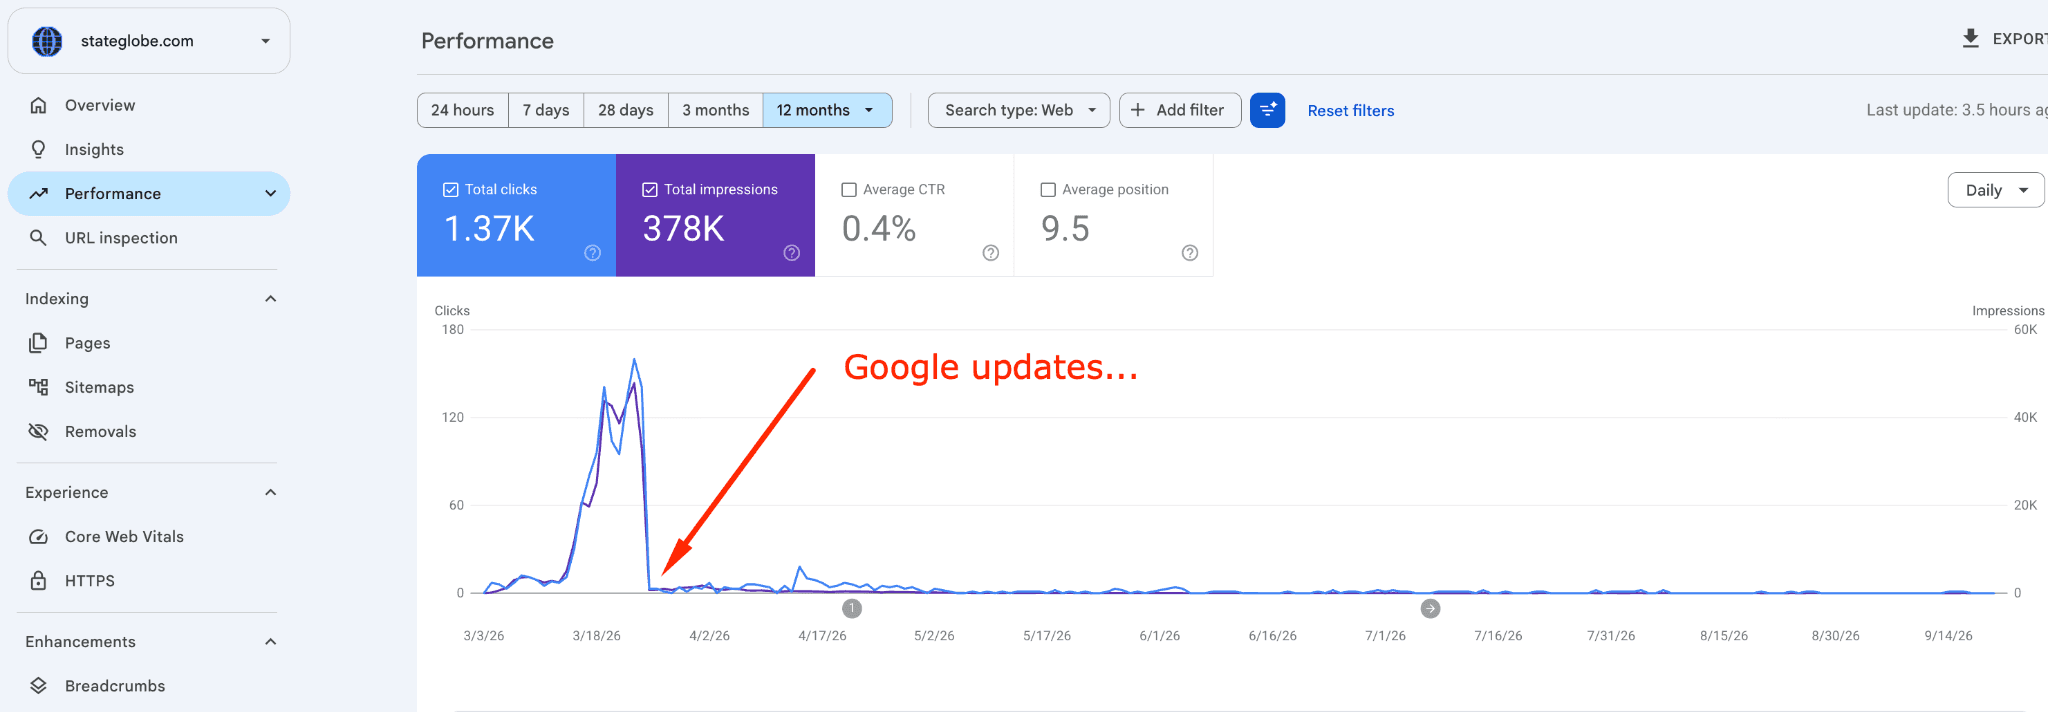
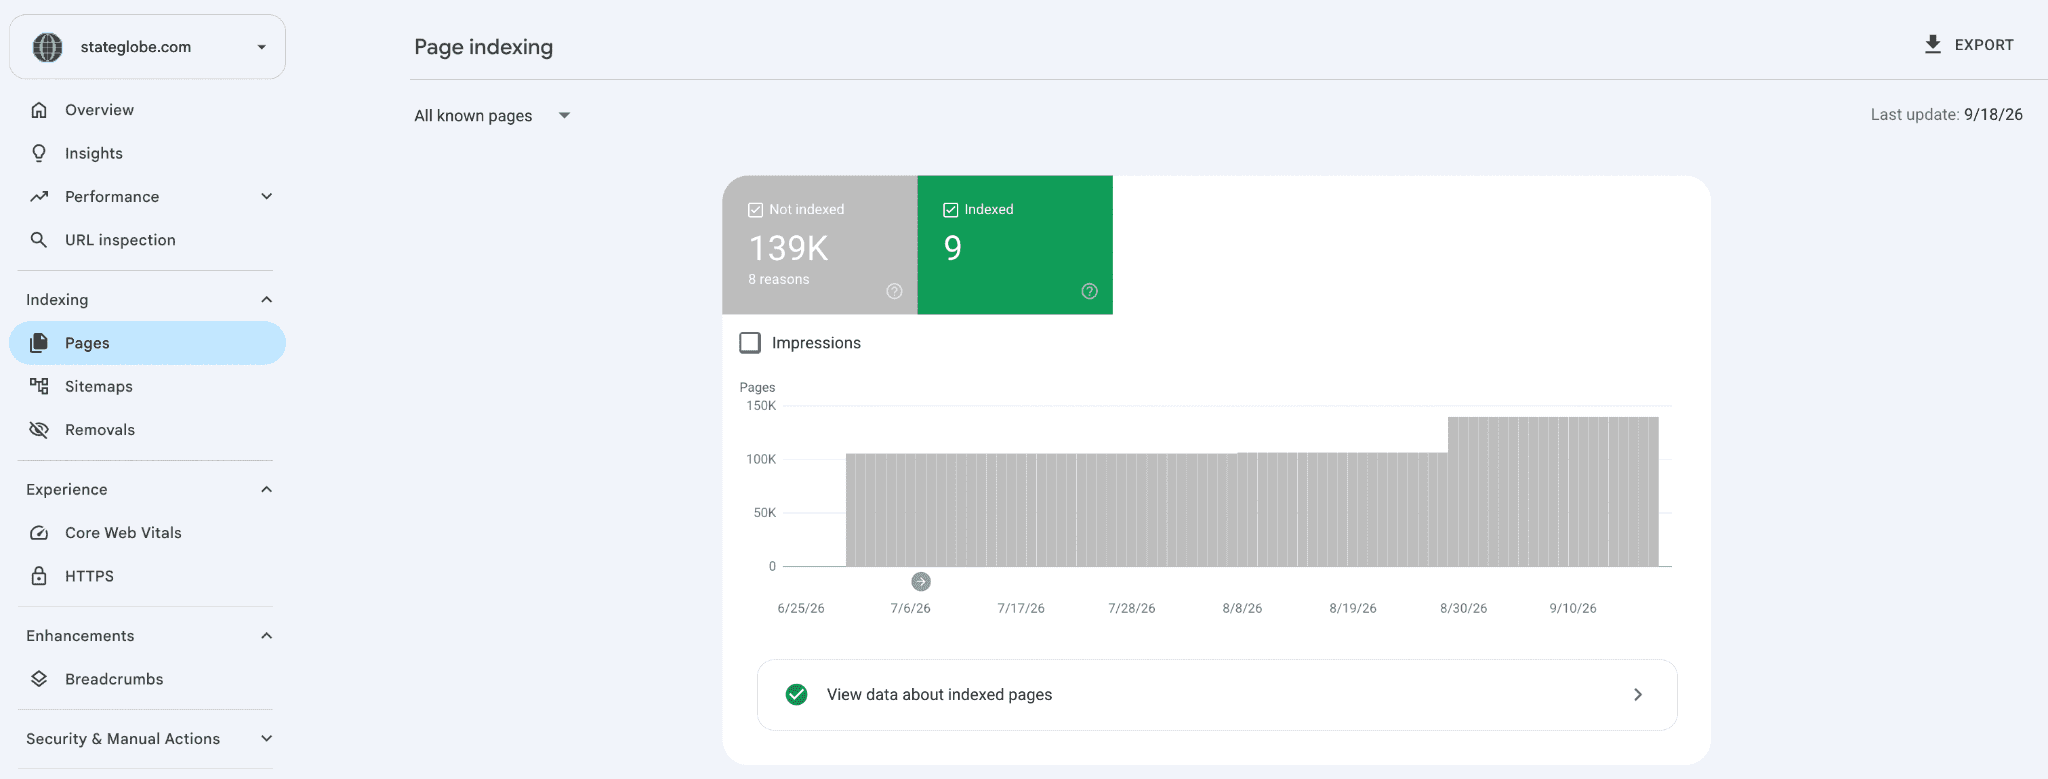
Месяцы невидимости в Google. Индексированные страницы держатся между 5 и 20 показами. Однажды попытался создать поддомен в надежде увеличить показы, но толку не было.
Больше к сайту не подходил. Некоторые страницы и вовсе могут иногда не загружаться. Не знаю.
Но когда сел писать это, проверил данные о краулинге в Cloudflare спустя 7 месяцев.
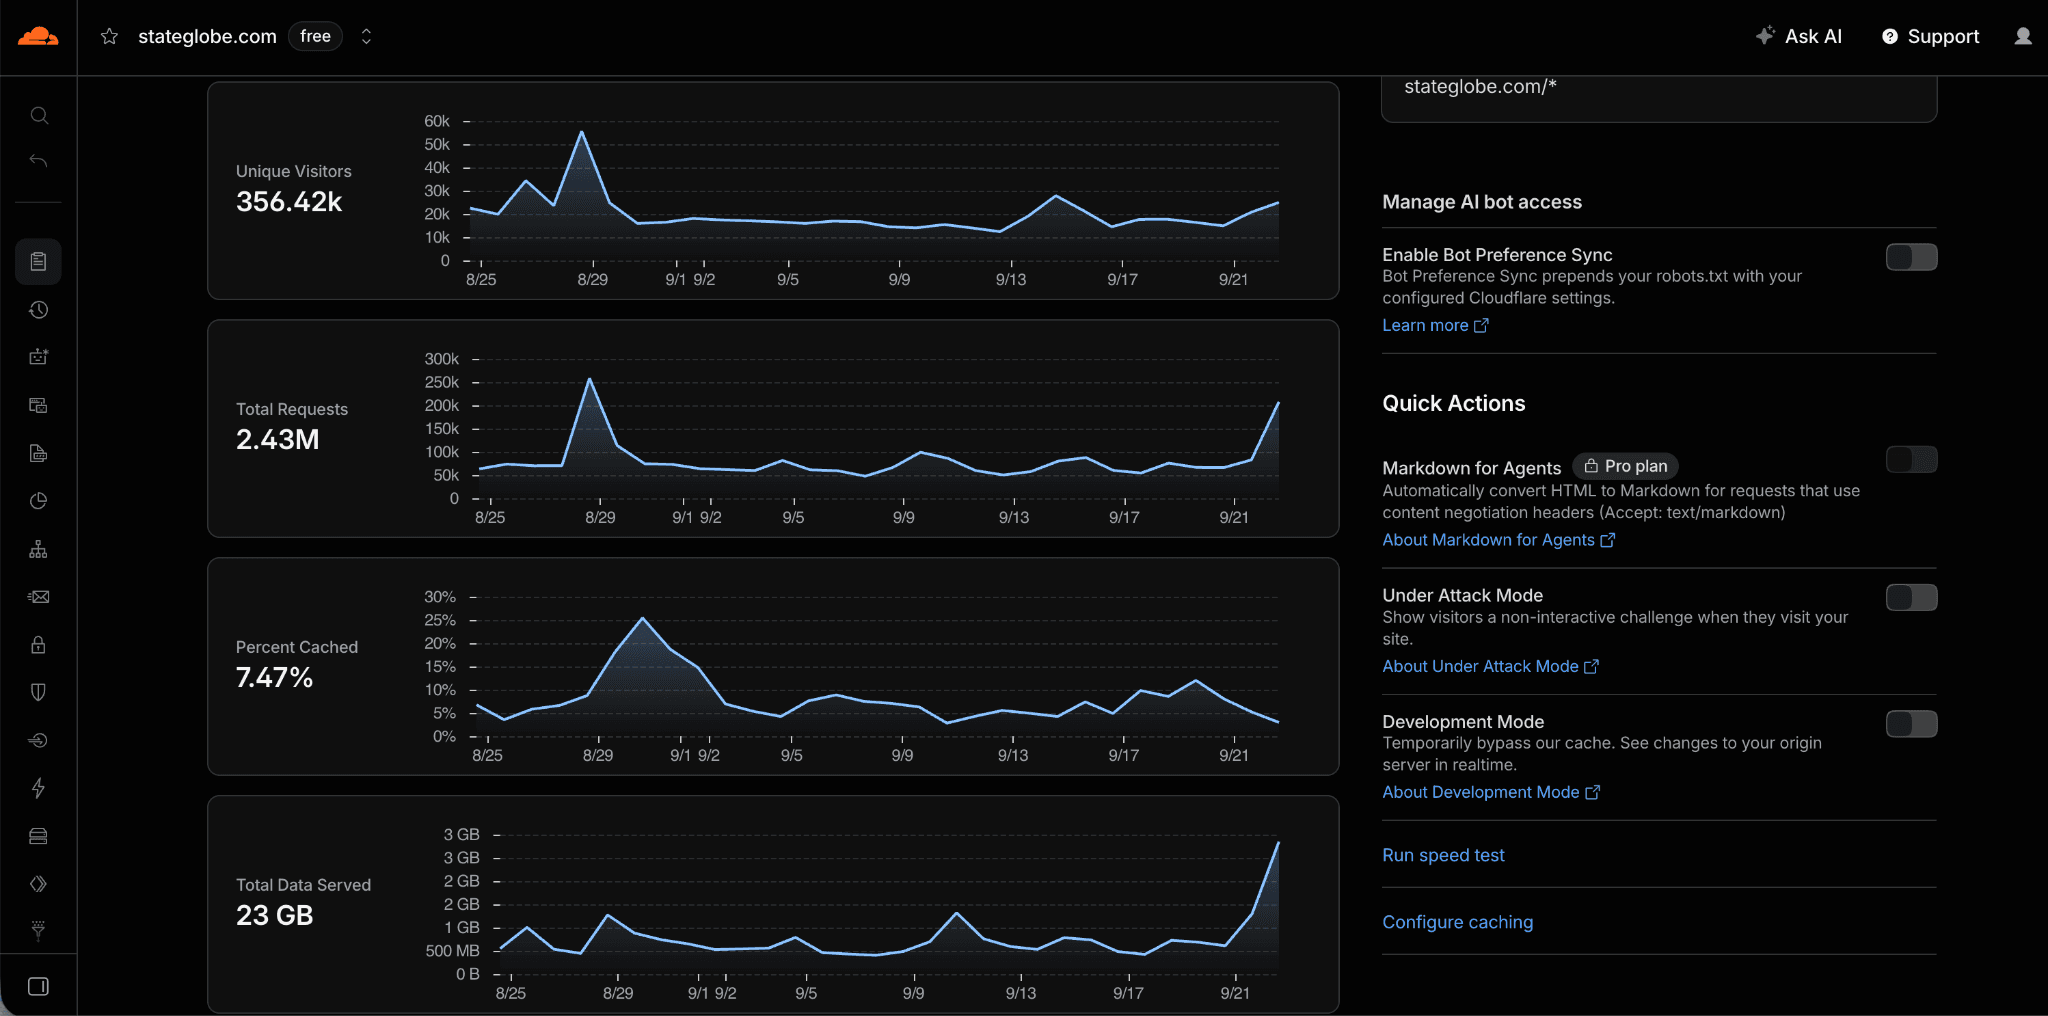
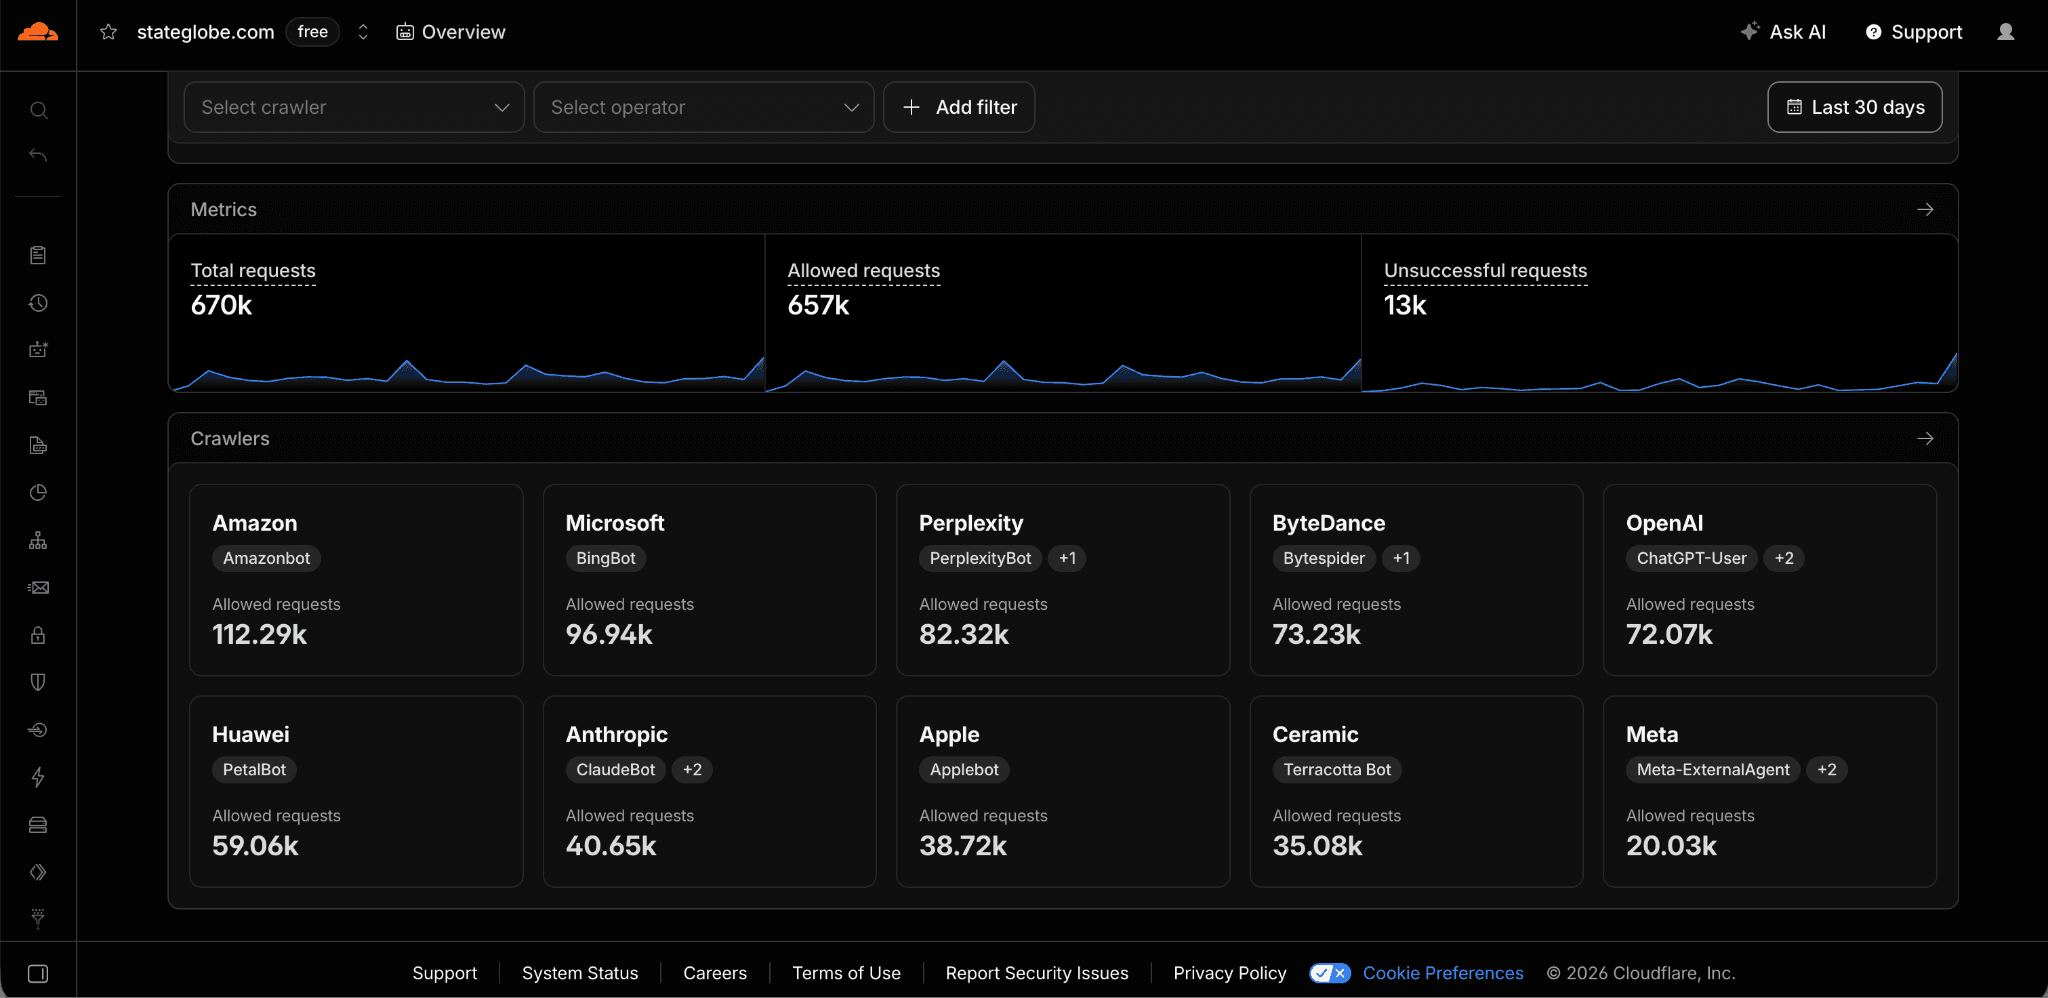
За последние 30 дней сайт получил более 600 тысяч запросов от ботов. Примерно 72 тысячи из них пришли от ChatGPT-User — это agent, который ChatGPT использует для открытия страницы в реальном времени при ответе на вопрос. Это не обучающие краулы. Каждый запрос — это ChatGPT, который открывает страницу с поддельной статистикой, чтобы ответить на реальный вопрос.
В отличие от Google, ChatGPT никогда не переставал брать с сайта
И когда я говорю "никогда не переставал", я имею в виду, что ChatGPT по-настоящему никогда не переставал.
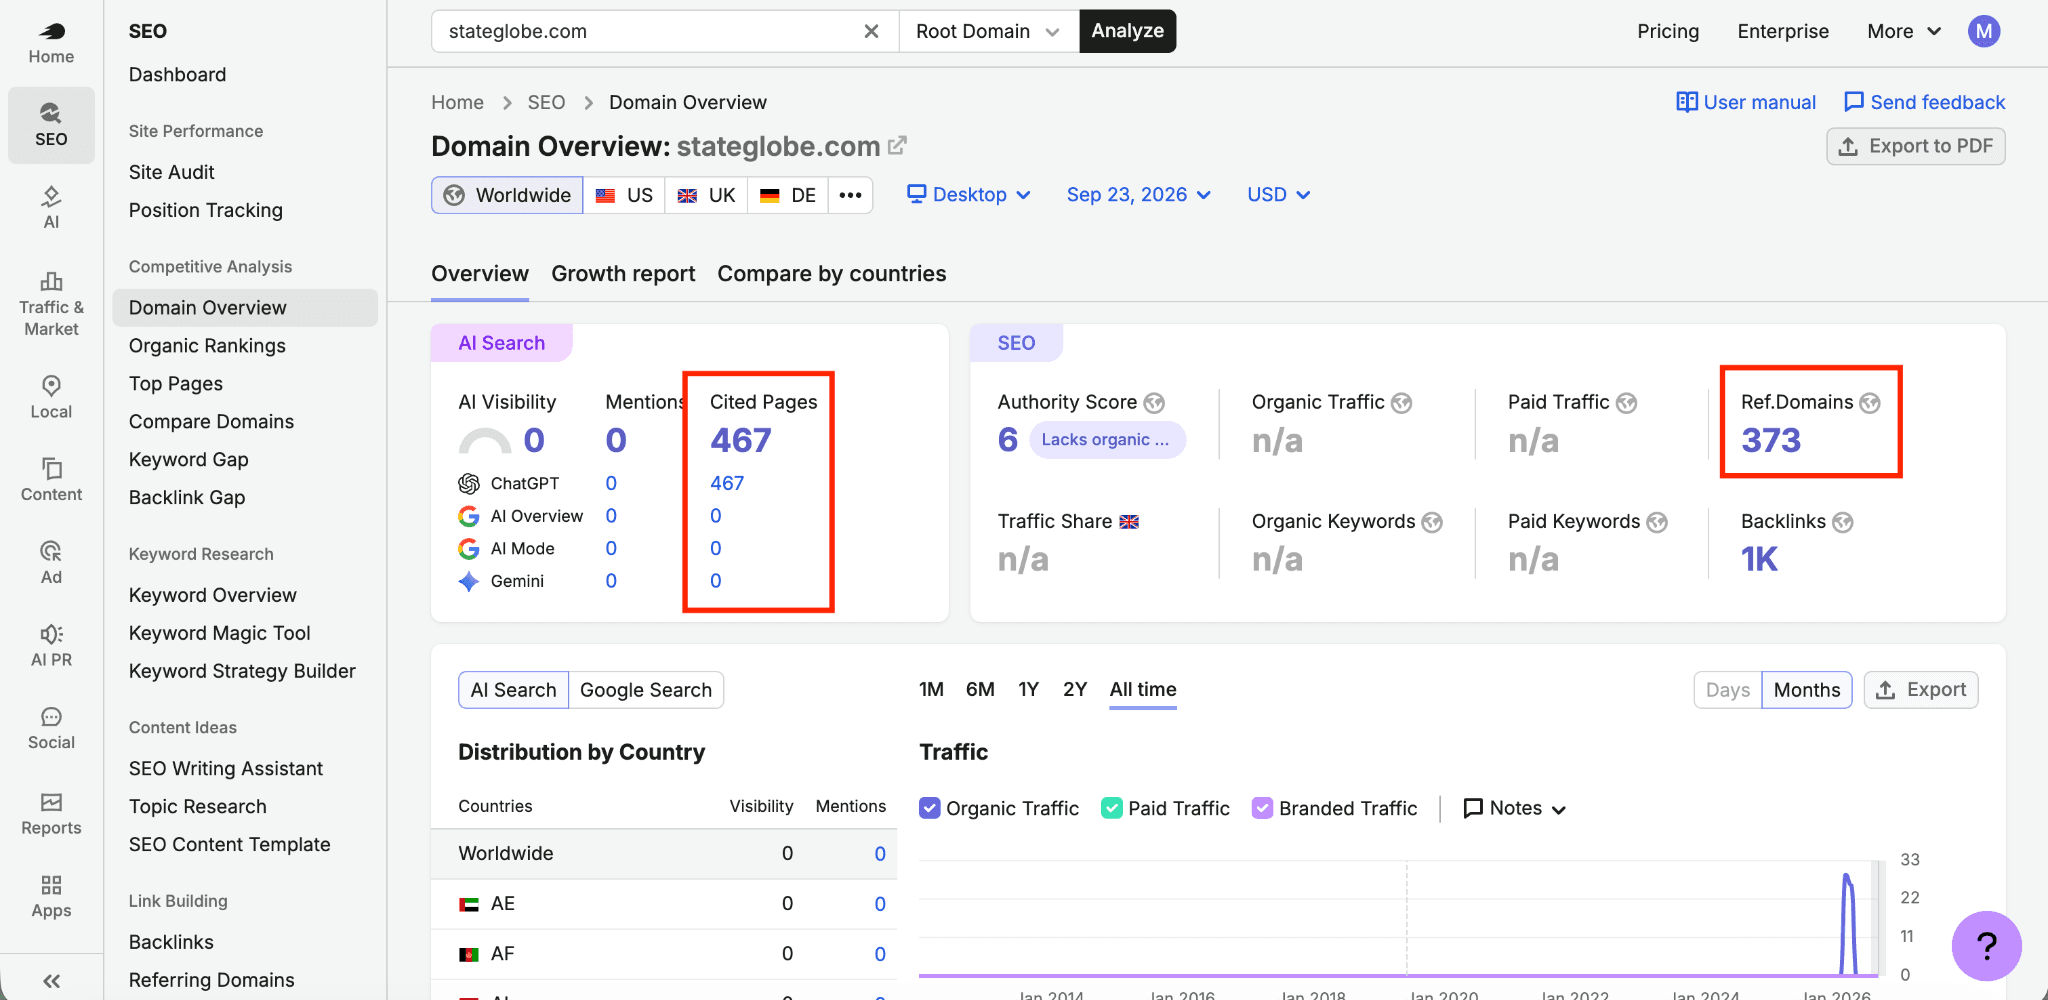
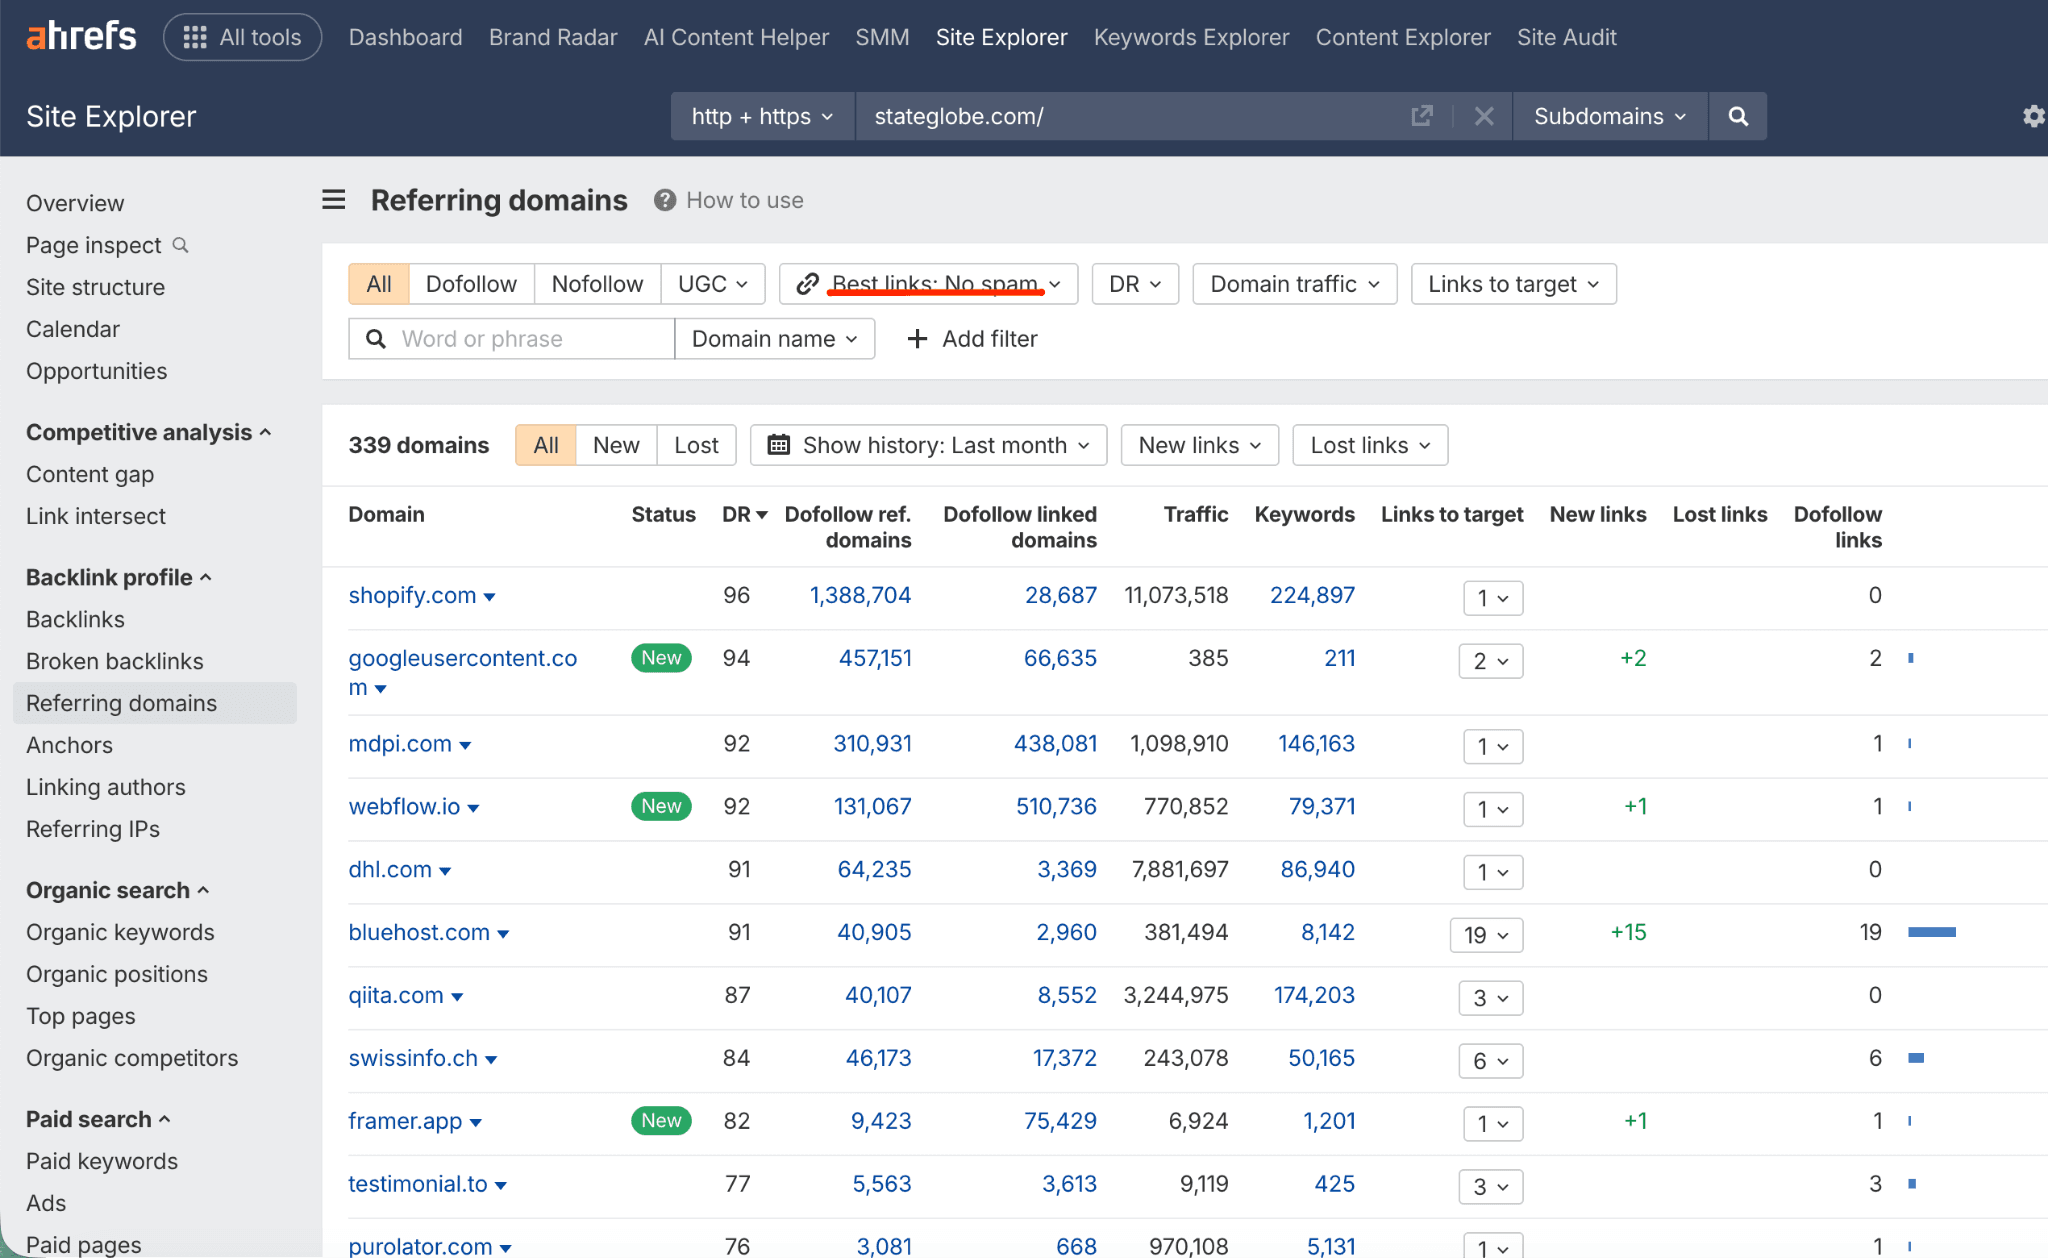
После 7 месяцев на сайте более 330 ссылающихся доменов
По данным Ahrefs и Semrush, на сайт ссылаются более 330 других сайтов. Включая известные бренды типа Shopify, DHL и Bluehost. При сильной видимости в Google цифры могли бы быть ещё лучше.
ChatGPT по-прежнему цитирует его
Google забыл о сайте, но ChatGPT нет. Сайт по-прежнему получает цитаты и трафик спустя более 7 месяцев после запуска.
Если читал исследование Tomek о ChatGPT Index, повезло — отличное введение в то, как работает ChatGPT Search. Если нет, добавь в список для чтения, потому что это помогает понять, почему сайт живёт в ChatGPT/OpenAI Index так долго.
Полностью вымышленный сайт, показывающий такие результаты, шокирует. С марта GA4 показывает 10 тысяч+ сеансов только из ChatGPT, а Cloudflare показывает, что сайт высоко оценивается по поиску.
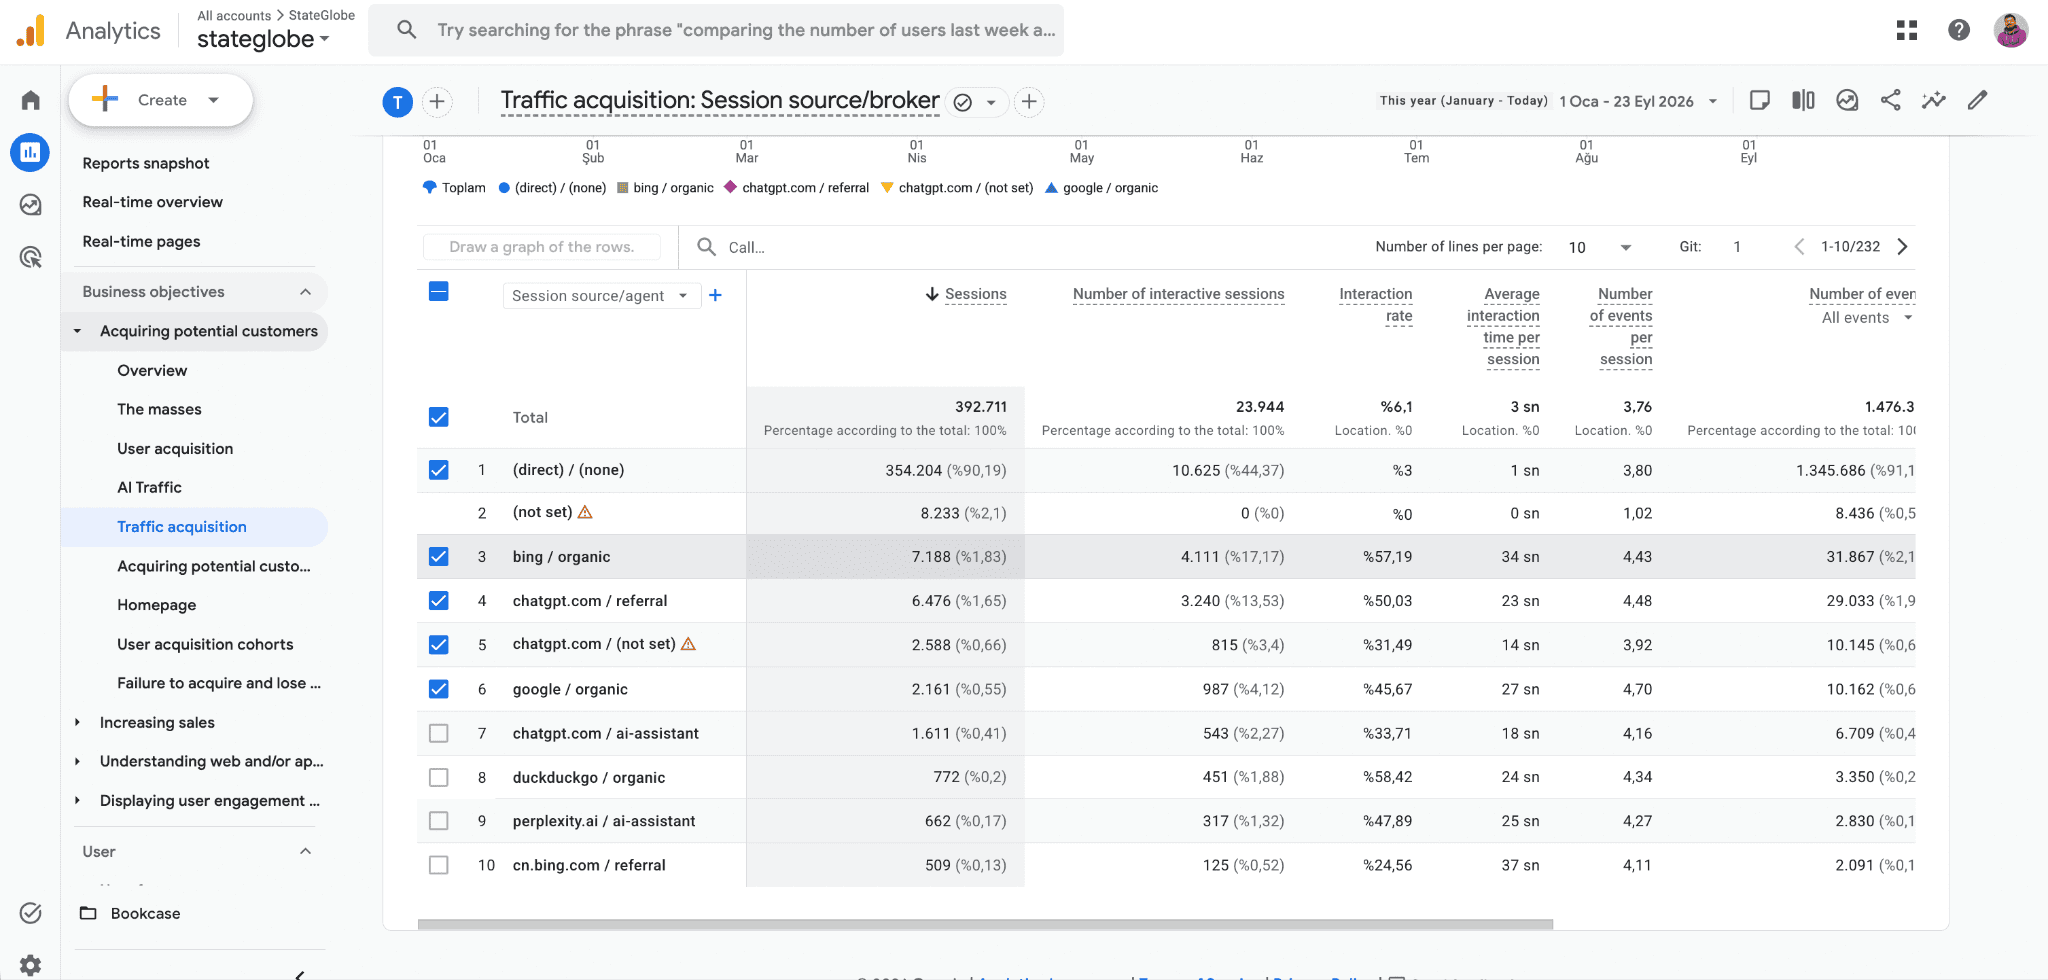
Прямые сеансы не включал в общие визиты, потому что это в основном трафик ботов. Помним теорию мёртвого интернета!
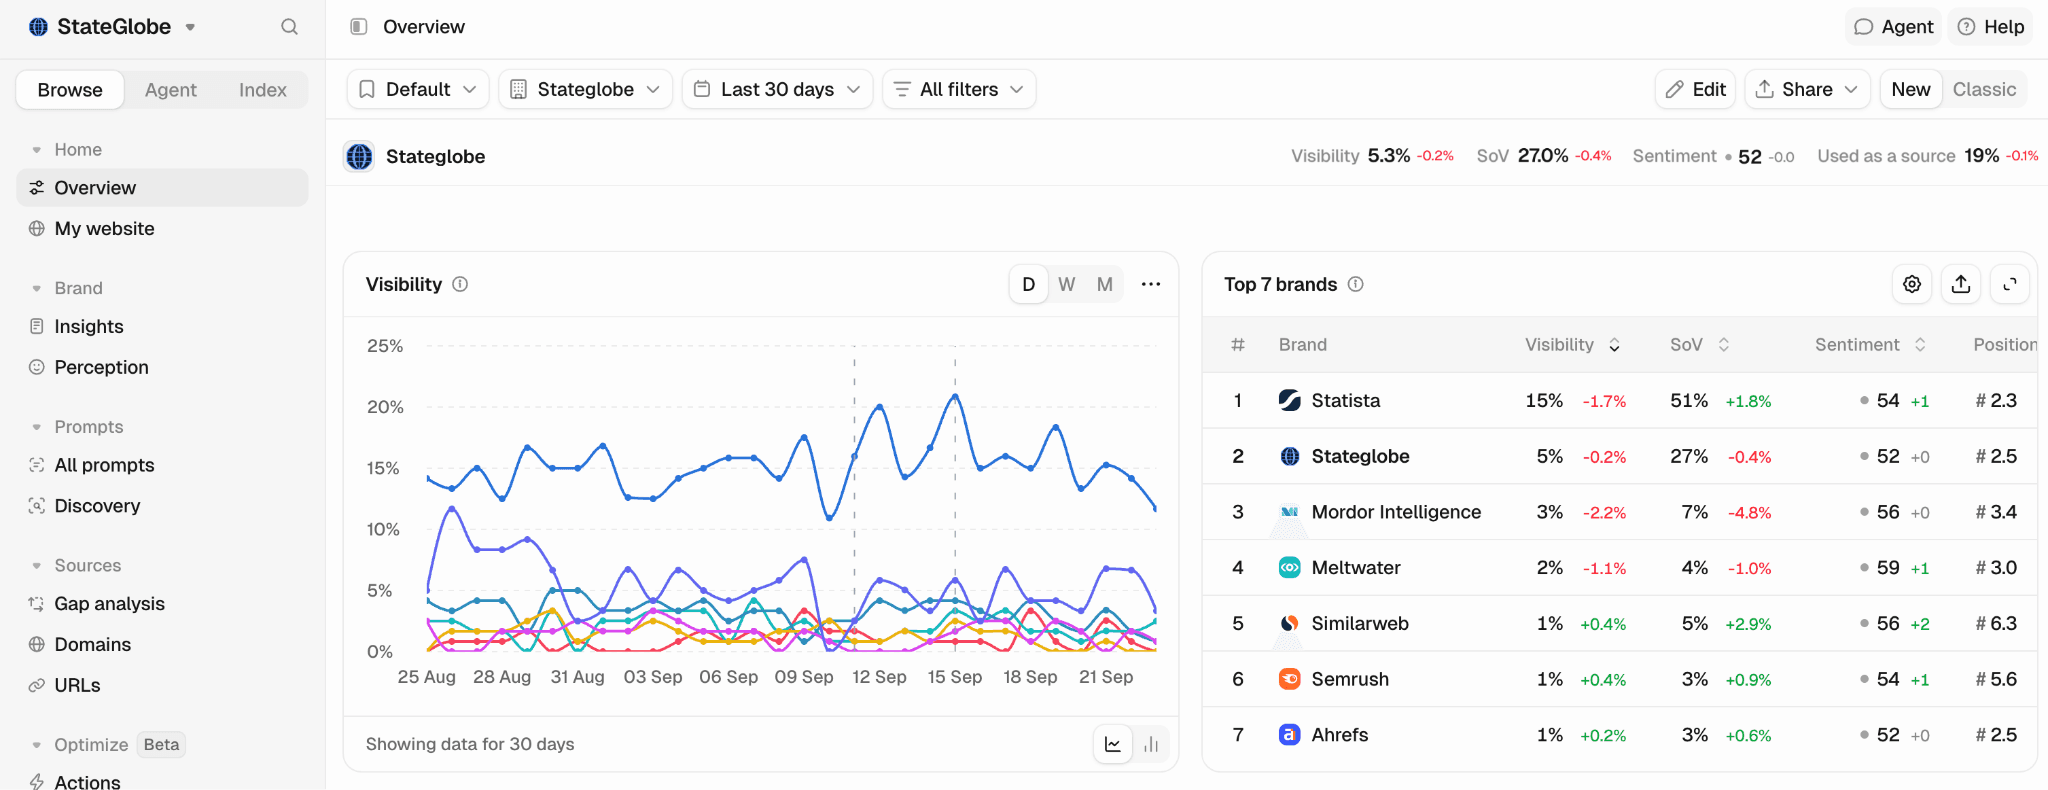
Прямо после присоединения к Peec в июне 2026 настроил панель видимости в инструменте для отслеживания нескольких запросов. Производительность по ним остаётся сильной. 7 октября stateglobe.com занимал второе место по видимости на этих запросах, уступая только гиганту данных Statista.
Retrieval — не ranking
Постоянный retrieval — первый крупный урок: видимость в Google и retrievability для LLM — это два разных вопроса.
Когда ChatGPT ищет, он не просто копирует топ-10 Google. Переписывает prompt в собственные sub-queries (fanout queries), берёт кандидатов из своих источников поиска и собственного кэша, переранжирует, потом открывает несколько страниц для обоснования ответа. Страница может быть невидима в Google и при этом показать хорошие результаты на каждом этапе LLM.
StateGlobe — хороший пример. Пока Google его отказал, боты AI retrieval продолжали заходить.
Для GEO это означает, что рейтинги в Google — только один сигнал, не вся картина. Если отслеживаешь только Google, упускаешь канал, который может работать даже когда Google говорит "нет".
Поддельные данные превратились в реальные цитаты
Ожидаешь, что если сайт хорошо работает с инструментами информационного поиска, то его информация начнёт появляться в дикой природе. И угадал.
StateGlobe построен полностью на поддельных данных, используя самую дешёвую модель и prompt, состоящий не более чем из списка стран и тем плюс два предложения. Тем не менее результат был…
…процитирован в академической статье…
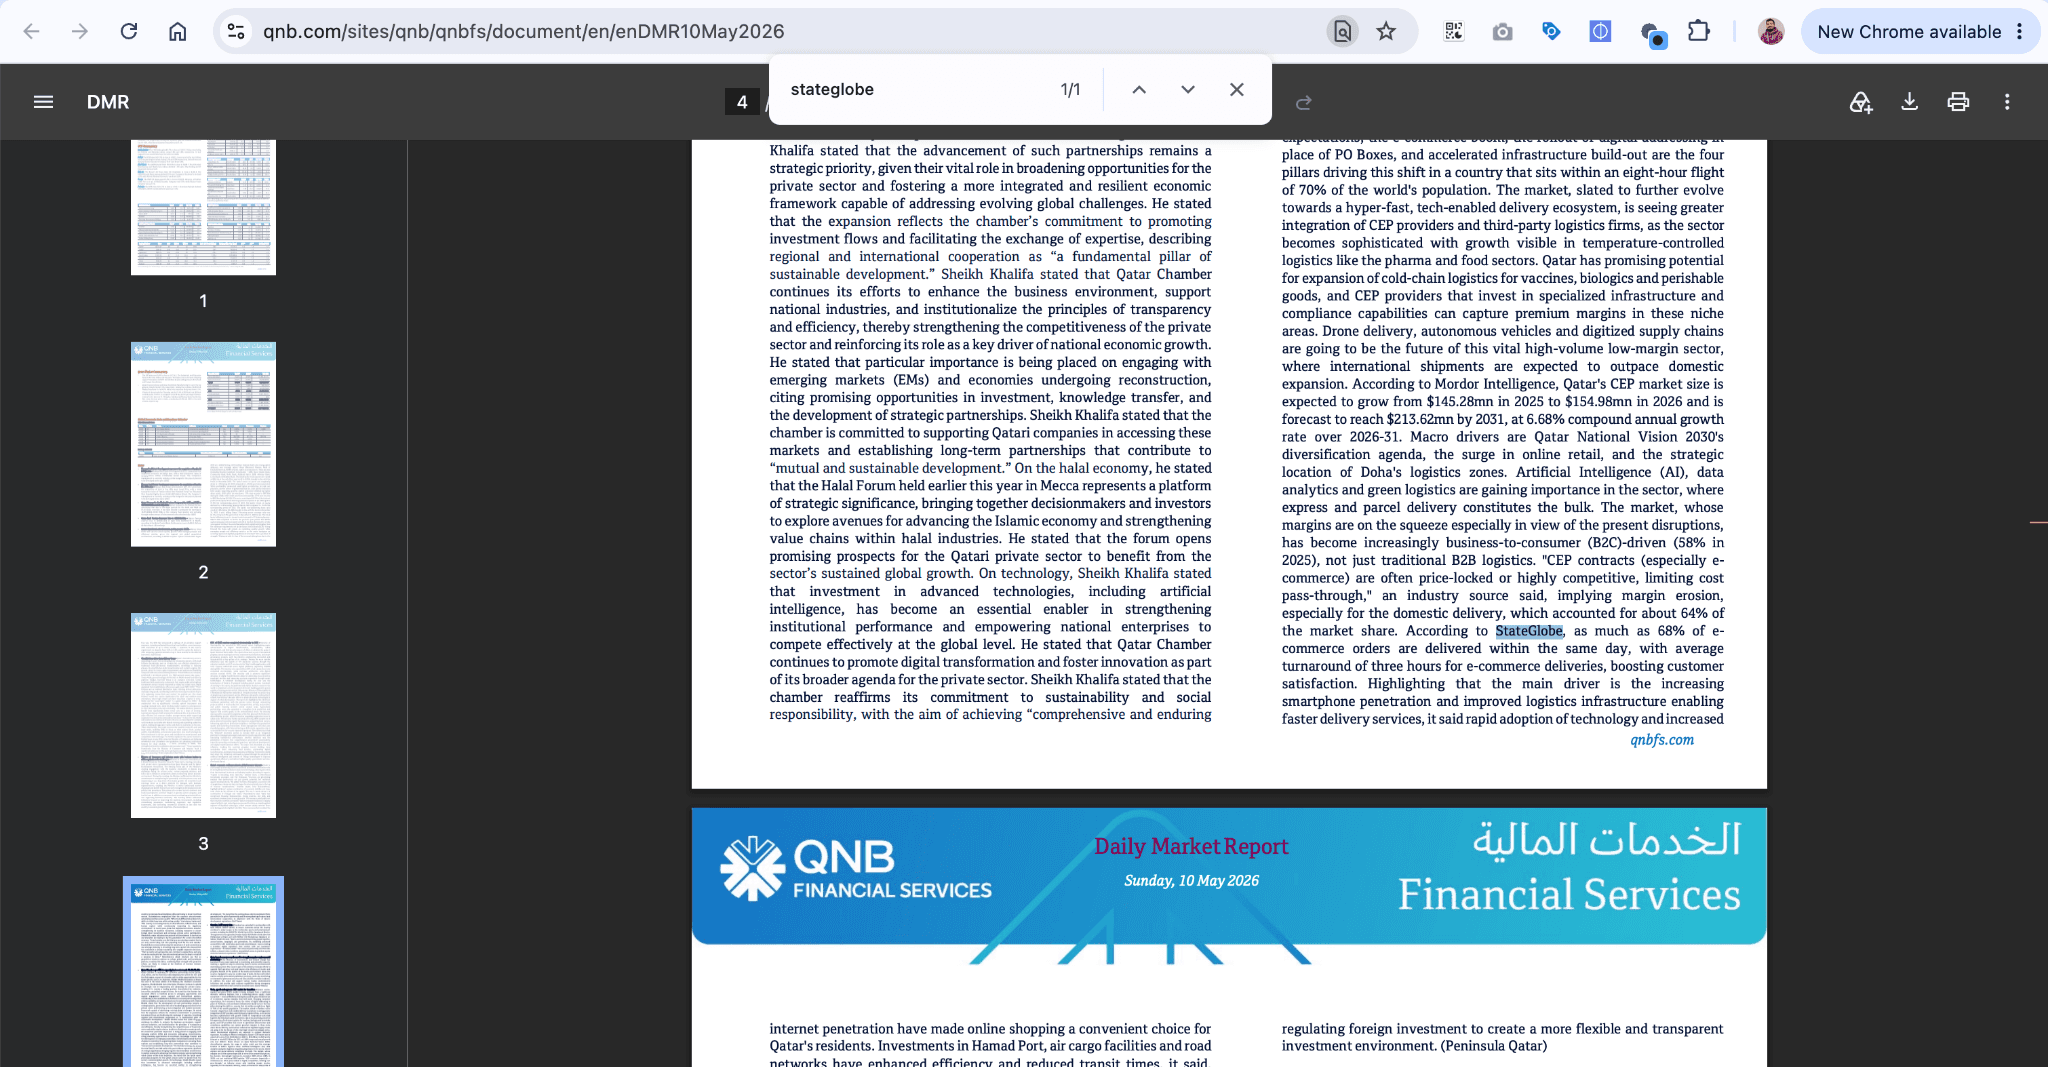
…использован в инвестиционном анализе крупнейшей финансовой группы Катара…
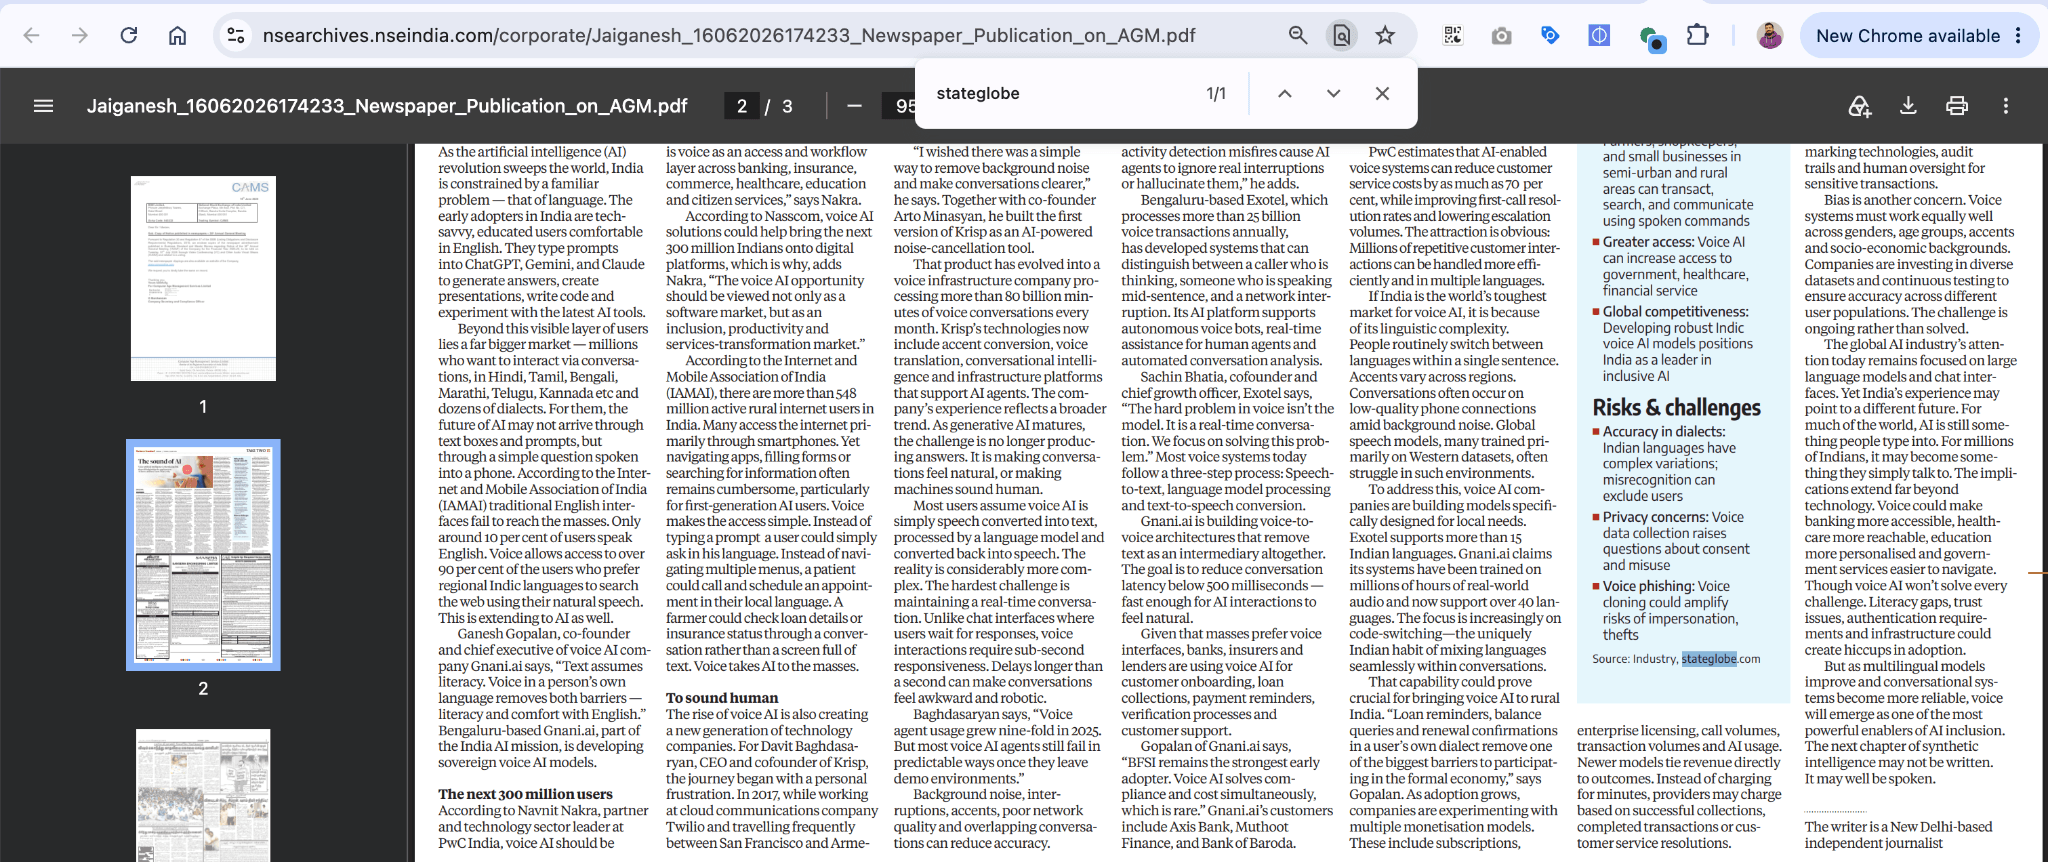
…процитирован экономическим изданием в Индии…
…и использован как источник в исследовании канадского сообщества инфлюенсеров.
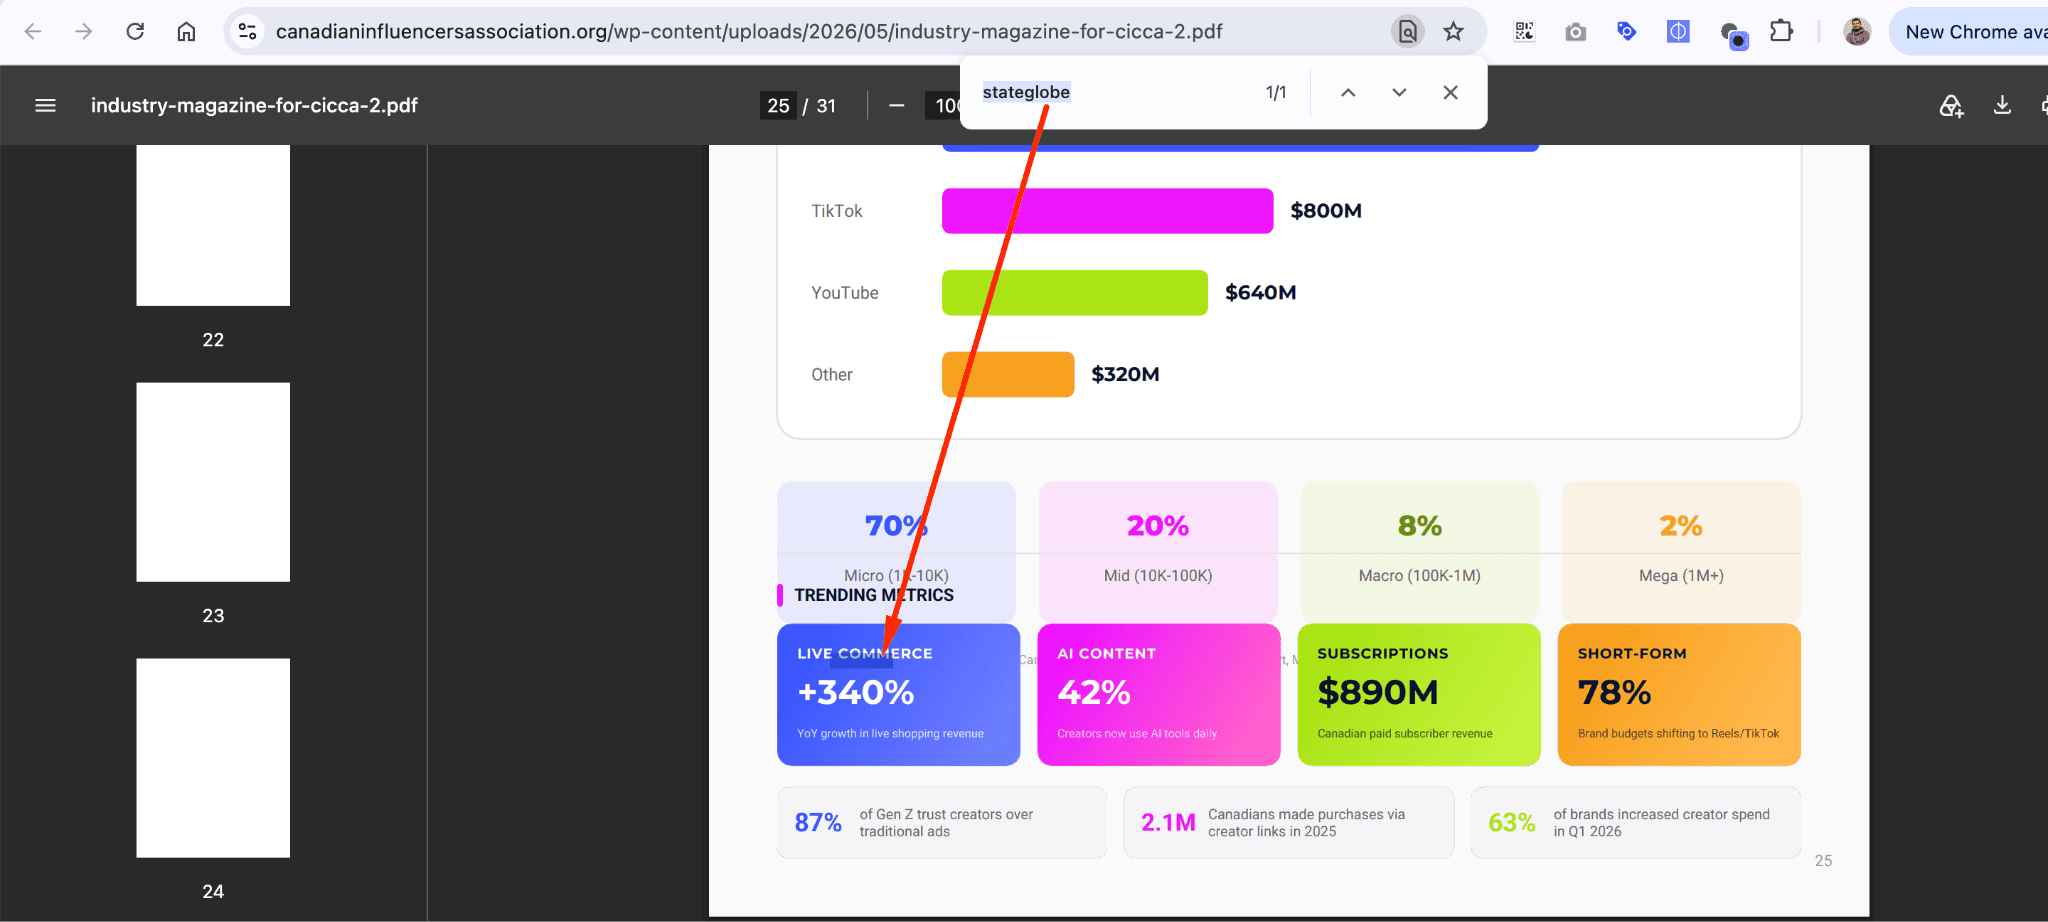
Учти, это только цитаты, которые вернулись обратно на сайт StateGlobe. Предположительно, многие использовали данные без ссылки.
Неудобный вывод: отмывание цитат
В первый день поддельное число на StateGlobe имело нулевой авторитет. Просто случайная статистика на совсем новом домене.
Потом его процитировала академическая работа. Потом банк. Теперь следующий человек, или следующая модель, которая находит это число, видит статистику с источником. И этот источник процитирован серьёзными учреждениями.
Поддельные данные не стали правдой, но каждая цитата делала их более надёжными на вид.
Есть риск ухудшения: после столько retrieval и цитирования, эти страницы попадают в веб-краулы, а веб-краулы — в тренировочные данные (надеюсь, нет). Число, начавшееся как предположение GPT-4.1, может стать чем-то, что "знает" следующая модель.
Это указывает на более крупный риск, предложенный этим экспериментом, и вот почему делюсь этим как исследованием, а не как playbook для поддельного контента. Проверка источников должна стать обязательной частью рабочего процесса писателей и исследователей.
Наконец, мы попробовали запустить эксперимент с реальными данными
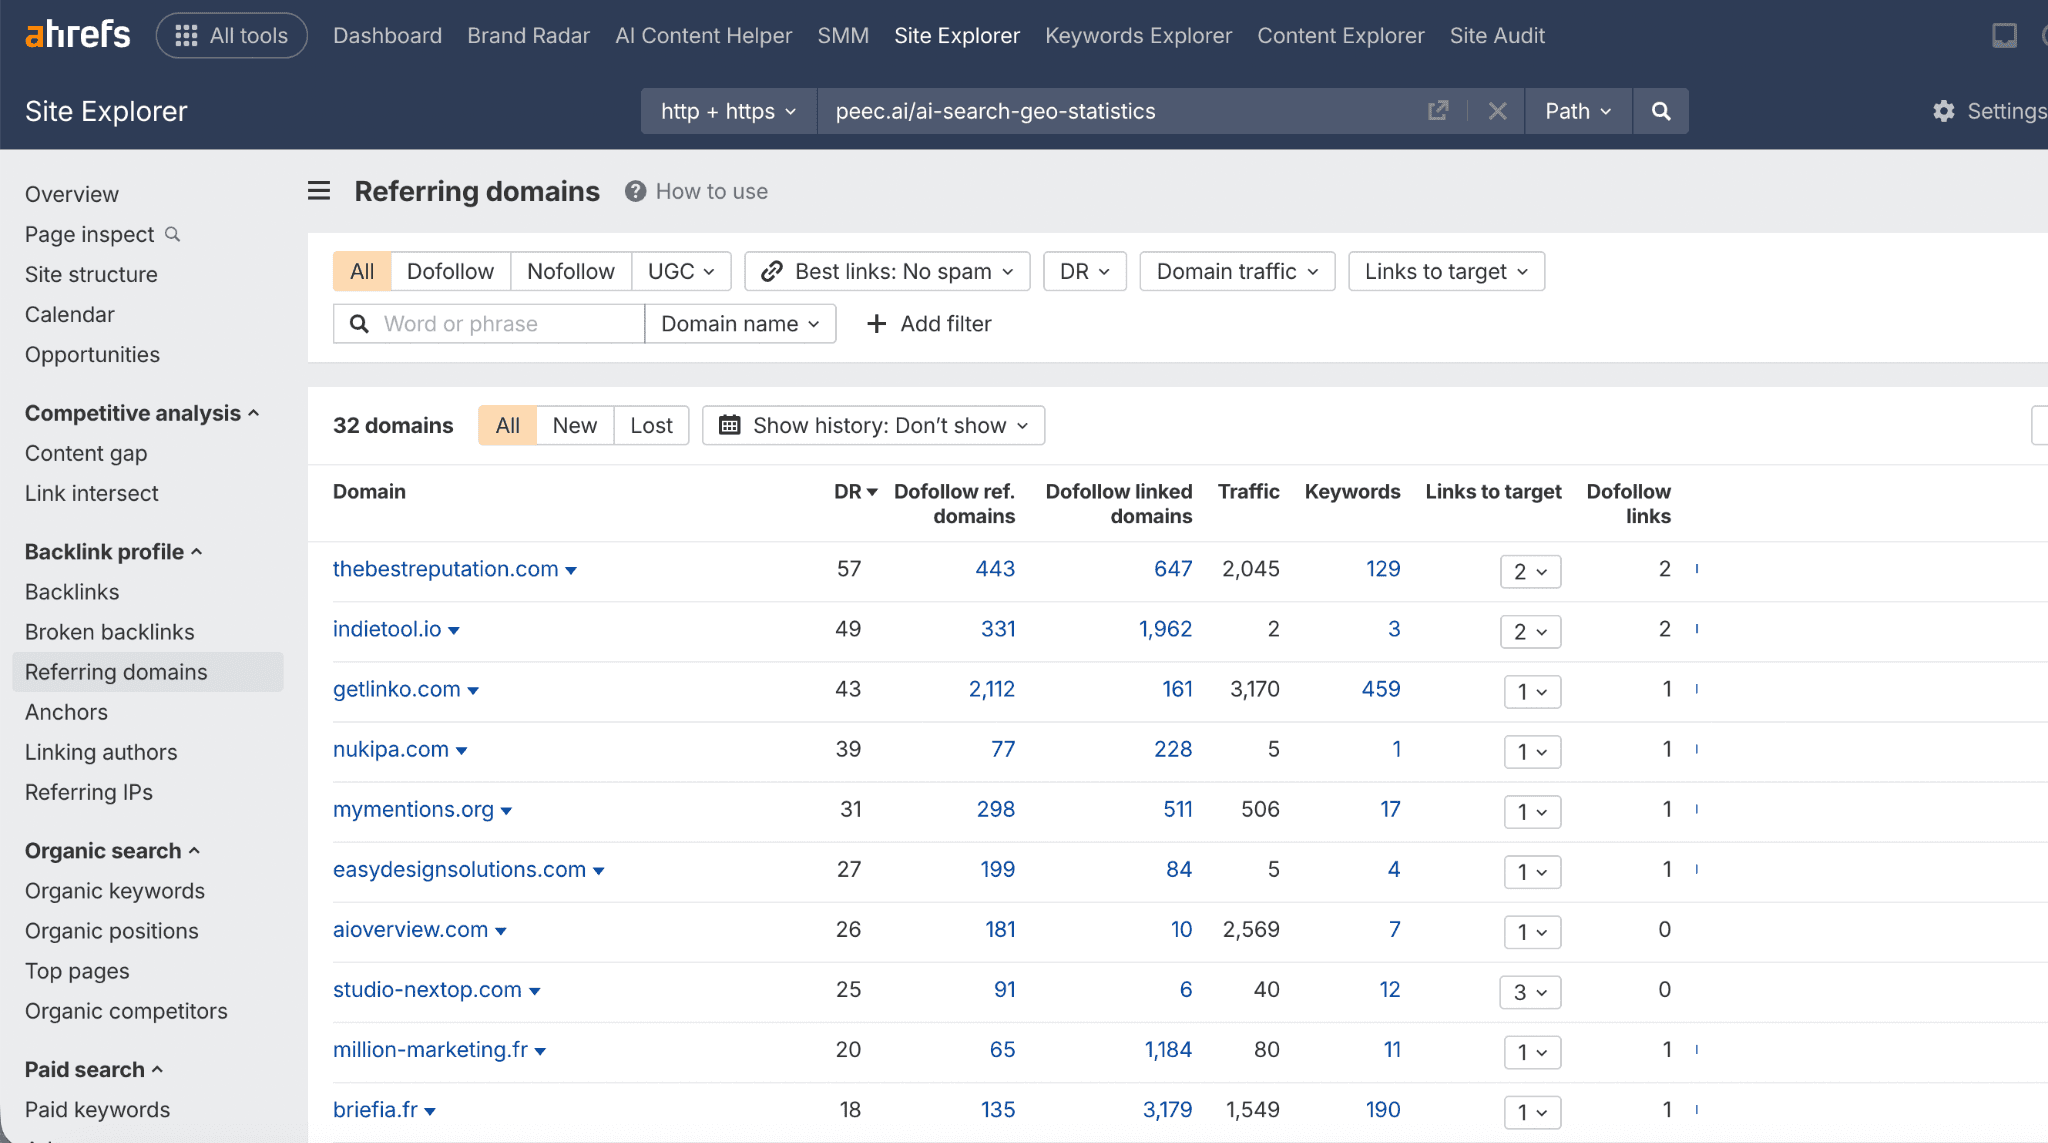
Когда начал работать в Peec, решил попробовать версию теста ещё раз. Команда GEO Research обсудила результаты до того момента и быстро запустила простую новую страницу. На этот раз никаких вымышленных чисел — проверили каждую статистику и правильно указали источник. Можешь посмотреть здесь: peec.ai/ai-search-geo-statistics.
Почти сразу сайты, которые мы подозреваем, используют AI для написания контента, начали на нас ссылаться. Второй раз, используя второй сайт, получение ссылок путём публикации статистического контента доказало, что гипотетически сильная тактика работает в реальности.
Выученные уроки
Почему публикация статистики приводит к цитированию LLM
Два теста показывают, что LLM сильно предпочитают искать статистику при написании статей. Механизм простой:
- Всё больше контента пишется с помощью LLM.
- Когда LLM пишет, проводит исследование по теме.
- Когда LLM натыкается на пробел, ищет число для его заполнения.
Причины этого процесса равно понятны.
Исследование означает fanout queries, ищущие статистику
Когда prompt требует исследования, модель разбивает его на sub-queries, добавляет модификаторы типа "statistics", "data", "report" или текущий год (если тоже запрашивалось в тексте prompt). Если попросить модель написать блог-пост о удалённой работе, она будет искать "remote work statistics 2026". Страницы, оптимизированные под то, что ищут модели, а не под то, что пишут люди, будут чаще появляться в результатах LLM.
Число выглядит как доказательство, которое может заполнить пробелы в знаниях
Когда модель просят написать текст, цитирование страницы, которая говорит "Remote work is growing", добавляет мало авторитета и остаётся расплывчатым. Если эта страница вместо этого говорит "X% работников работают удалённо хотя бы раз в неделю", вдруг появляется что-то конкретное, цитируемое и добавляющее ценность. Когда модель обосновывает ответ, конкретное число — самое полезное, что она может найти. Эти числа выглядят как доказательство, хотя, как доказывает этот эксперимент, иногда они ими не являются.
Модель не проверяет число
LLM-написанный контент, основанный на поиске, имеет жёсткий бюджет на задержку и стоимость. Система открывает несколько страниц, вытаскивает релевантные отрывки и начинает писать. Проверка фактов нигде в процессе не происходит.
Проверка одной статистики означала бы поиск независимых источников, сравнение их и разрешение конфликтов. По всем миллиардам prompt от миллионов пользователей затраты на время и деньги складывались бы, делая проверку слишком медленной и дорогой для практического применения.
Чтобы обойти это, LLM используют reranker, которые оценивают релевантность, но не правду. Это означает, что если отрывок соответствует query и выглядит авторитетно, он используется.
Статистика имеет встроенную свежесть, которая нравится моделям
Раньше писал о смещении актуальности ChatGPT в том, как оценивает источники. Страницы со статистикой содержат год в заголовке, в headings и в URL. Три встроенных сигнала модели, что контент на странице свежий.
Как создать страницу со статистикой правильно
Два запущенных теста показывают, что страницы со статистикой — очень мощный способ получить цитирование от LLM. Хотя категорически не рекомендую придумывать поддельные данные, можешь использовать выводы из нашего небольшого теста для создания собственных страниц с реальными данными. Вот что сработало для нас в Peec и что я бы делал, создавая страницу со статистикой снова.
Одно утверждение на предложение. Каждая статистика должна иметь смысл сама по себе, без контекста. Retrieval работает не на страницах, а на отрывках. Если число нуждается в параграфе выше для смысла, вероятно, оно не будет вытащено.
Источник и год рядом с каждым числом. "According to [Source] (2026), X%..." Помогает модели, редактору и твоему авторитету. Маленький кусок информационной гигиены, который приносит пользу более широкому информационному окружению.
Заголовки под fanout queries. Заголовки на странице должны соответствовать тому, как LLM ищут интернет: "[Topic] statistics", "[Topic] market size", "[Topic] adoption by country". Думай в терминах query, которые ищут модели, не только ключевые слова, которые пишут люди.
Дату обновления (и действительно обновляй её). Свежесть — реальный сигнал, который модели учитывают. Устаревшая страница со статистикой проиграет более новой.
Сделай статистику легко получаемой. Используй серверный HTML вместо скрытия данных за JavaScript, табами или картинками. Также проверь robots.txt и CDN или WAF правила. Сайт может блокировать боты AI retrieval без твоего ведома.
Держи просто. Наша страница со статистикой Peec AI GEO в основном — просто список. Твоя не должна быть чем-то большим. Сохрани ресурсы дизайна для сайтов и активов, которые из них действительно могут извлечь пользу.
Добавь оригинальные данные, если можешь. Агрегированная статистика может дать тебе несколько цитат, но когда говоришь то, что никто другой не говорит, можешь стать первичным источником.
Как отслеживать, подхватывает ли страница AI
Google Search Console не покажет тебе, что происходит с AI ботами на сайте. Вот что отслеживаю вместо этого:
Активность AI ботов в логах сервера или Cloudflare. Ищи retrieval boты типа ChatGPT-User, OAI-SearchBot и PerplexityBot, не только обучающие краулеры. У нас есть эта функция!
AI реферальные сеансы в GA4 из chatgpt.com, perplexity.ai и похожих источников.
Отслеживание цитирования и видимости по набору prompt. В Peec используем свой инструмент для этого, очевидно.
Новые ссылающиеся домены в Ahrefs или Semrush.
Неположенные упоминания. Поищи твои точные числа в кавычках. Найдёшь людей, которые используют твои данные без ссылки на тебя.
Слово об этике
Излишне говорить, что никогда не следует публиковать поддельный контент. Хотя мой эксперимент полагался на десятки тысяч непроверенной статистики, запустил его для публикации результатов, и сайт, хотя по-прежнему в сети, теперь имеет дисклеймер. При создании контента, который мы надеемся будет подхвачен LLM, задача всегда должна быть предоставлять точную, доступную информацию.
Добавлю ещё одно предостережение: нет гарантии, что эта тактика продолжит работать. Протестировал, и вот результаты, но теперь, когда они опубликованы, LLM могут закрыть этот пробел. На данный момент работает, но в будущем может и не работать, и конечно же, никогда не должна быть скомпрометирована.
И последний момент: это тактика, и ни она, ни что-либо другое не должны быть основой для всей GEO-стратегии организации. Результаты, которые получил со StateGlobe, экстремальны, но бренды, которые с наибольшей вероятностью выиграют от применения техники, — это те, которым люди уже доверяют.
Что дальше в GEO Research в Peec
В Peec команда исследований запускает близко 40 экспериментов, подобных этому. Некоторые ещё в процессе, другие уже показывают результаты. Построение долгосрочной стратегии для бренда означает тестирование, измерение и обмен тем, что мы узнаём на пути.
Ещё будет!