Общие принципы
Сначала убедитесь, что у вас есть проблема
Если начать искать красные флаги в Tokio приложении, они найдутся. Почти в каждом реальном приложении polls (время между точками .await, когда код возвращает управление runtime) длиннее, чем рекомендуемые 10–100 микросекунд. Однако эти проблемы могут вообще не влиять на интересующие метрики приложения.
Важно работать от обратного — от реальной метрики, которую нужно улучшить. Приложение может иметь длинные polls, которые совершенно безвредны; их «исправление» не повлияет на пользовательские метрики.
В подавляющем большинстве проблем, которые приходилось видеть, корень был в коде самого приложения, часто в взаимодействии компонентов распределённой системы (а не в Tokio). Инструмент dial9 дал много видимости в Tokio; как минимум так же часто, как находит проблему в Tokio, он показывает её отсутствие — что даёт людям уверенность искать дальше. Конечно, иногда проблема именно в Tokio.
Из Tokio метрик самой полезной стала недавно добавленная гистограмма задержки планирования (schedule latency). Это время между моментом, когда task готова к выполнению (например, у сокета есть данные), и моментом, когда Tokio начинает полировать future. Хотя это не скажет, в чём причина, schedule latency — наиболее частый признак проблем во взаимодействии Tokio и вашего кода.
Разделяйте для latency, батчьте для throughput
Более частые yields для оптимизации latency
Низкая задержка при обработке многих запросов требует справедливости (fairness) между соединениями.
Рассмотрим Redis или любое приложение, поддерживающее pipelining запросов. Наивная реализация читает данные прямо с соединения, пока они доступны. Когда запросы pipelined, весь pipelined запрос (или большая его часть) оказывается в буфере в памяти. При чтении фреймов каждый возвращает Poll::Ready без обращения к сети. Это создаёт и длинные polls, и несправедливость между клиентами.
Влияние на throughput обычно меньше: обрабатывается одинаковое число запросов. Latency же меняется кардинально — весь один pipeline может ждать за другим. Явный yield после каждого запроса может снизить latency примерно в 10× на этом примере. Можно добиться ещё большего, делая yield только после нескольких последовательных immediately-ready чтений.
async fn handle_conn(&mut self) -> crate::Result<()> {
    while !self.shutdown.is_shutdown() {
        // If the connection has buffered data, this can repeatedly return
        // Poll::Ready without yielding back to the runtime.
        let frame = tokio::select! {
            res = self.connection.read_frame() => res?,
            _ = self.shutdown.recv() => {
                return Ok(());
            }
        };

        execute_command(&self.db, &mut self.connection, frame).await?;

        // To improve fairness:
        // tokio::task::yield_now().await;
    }
}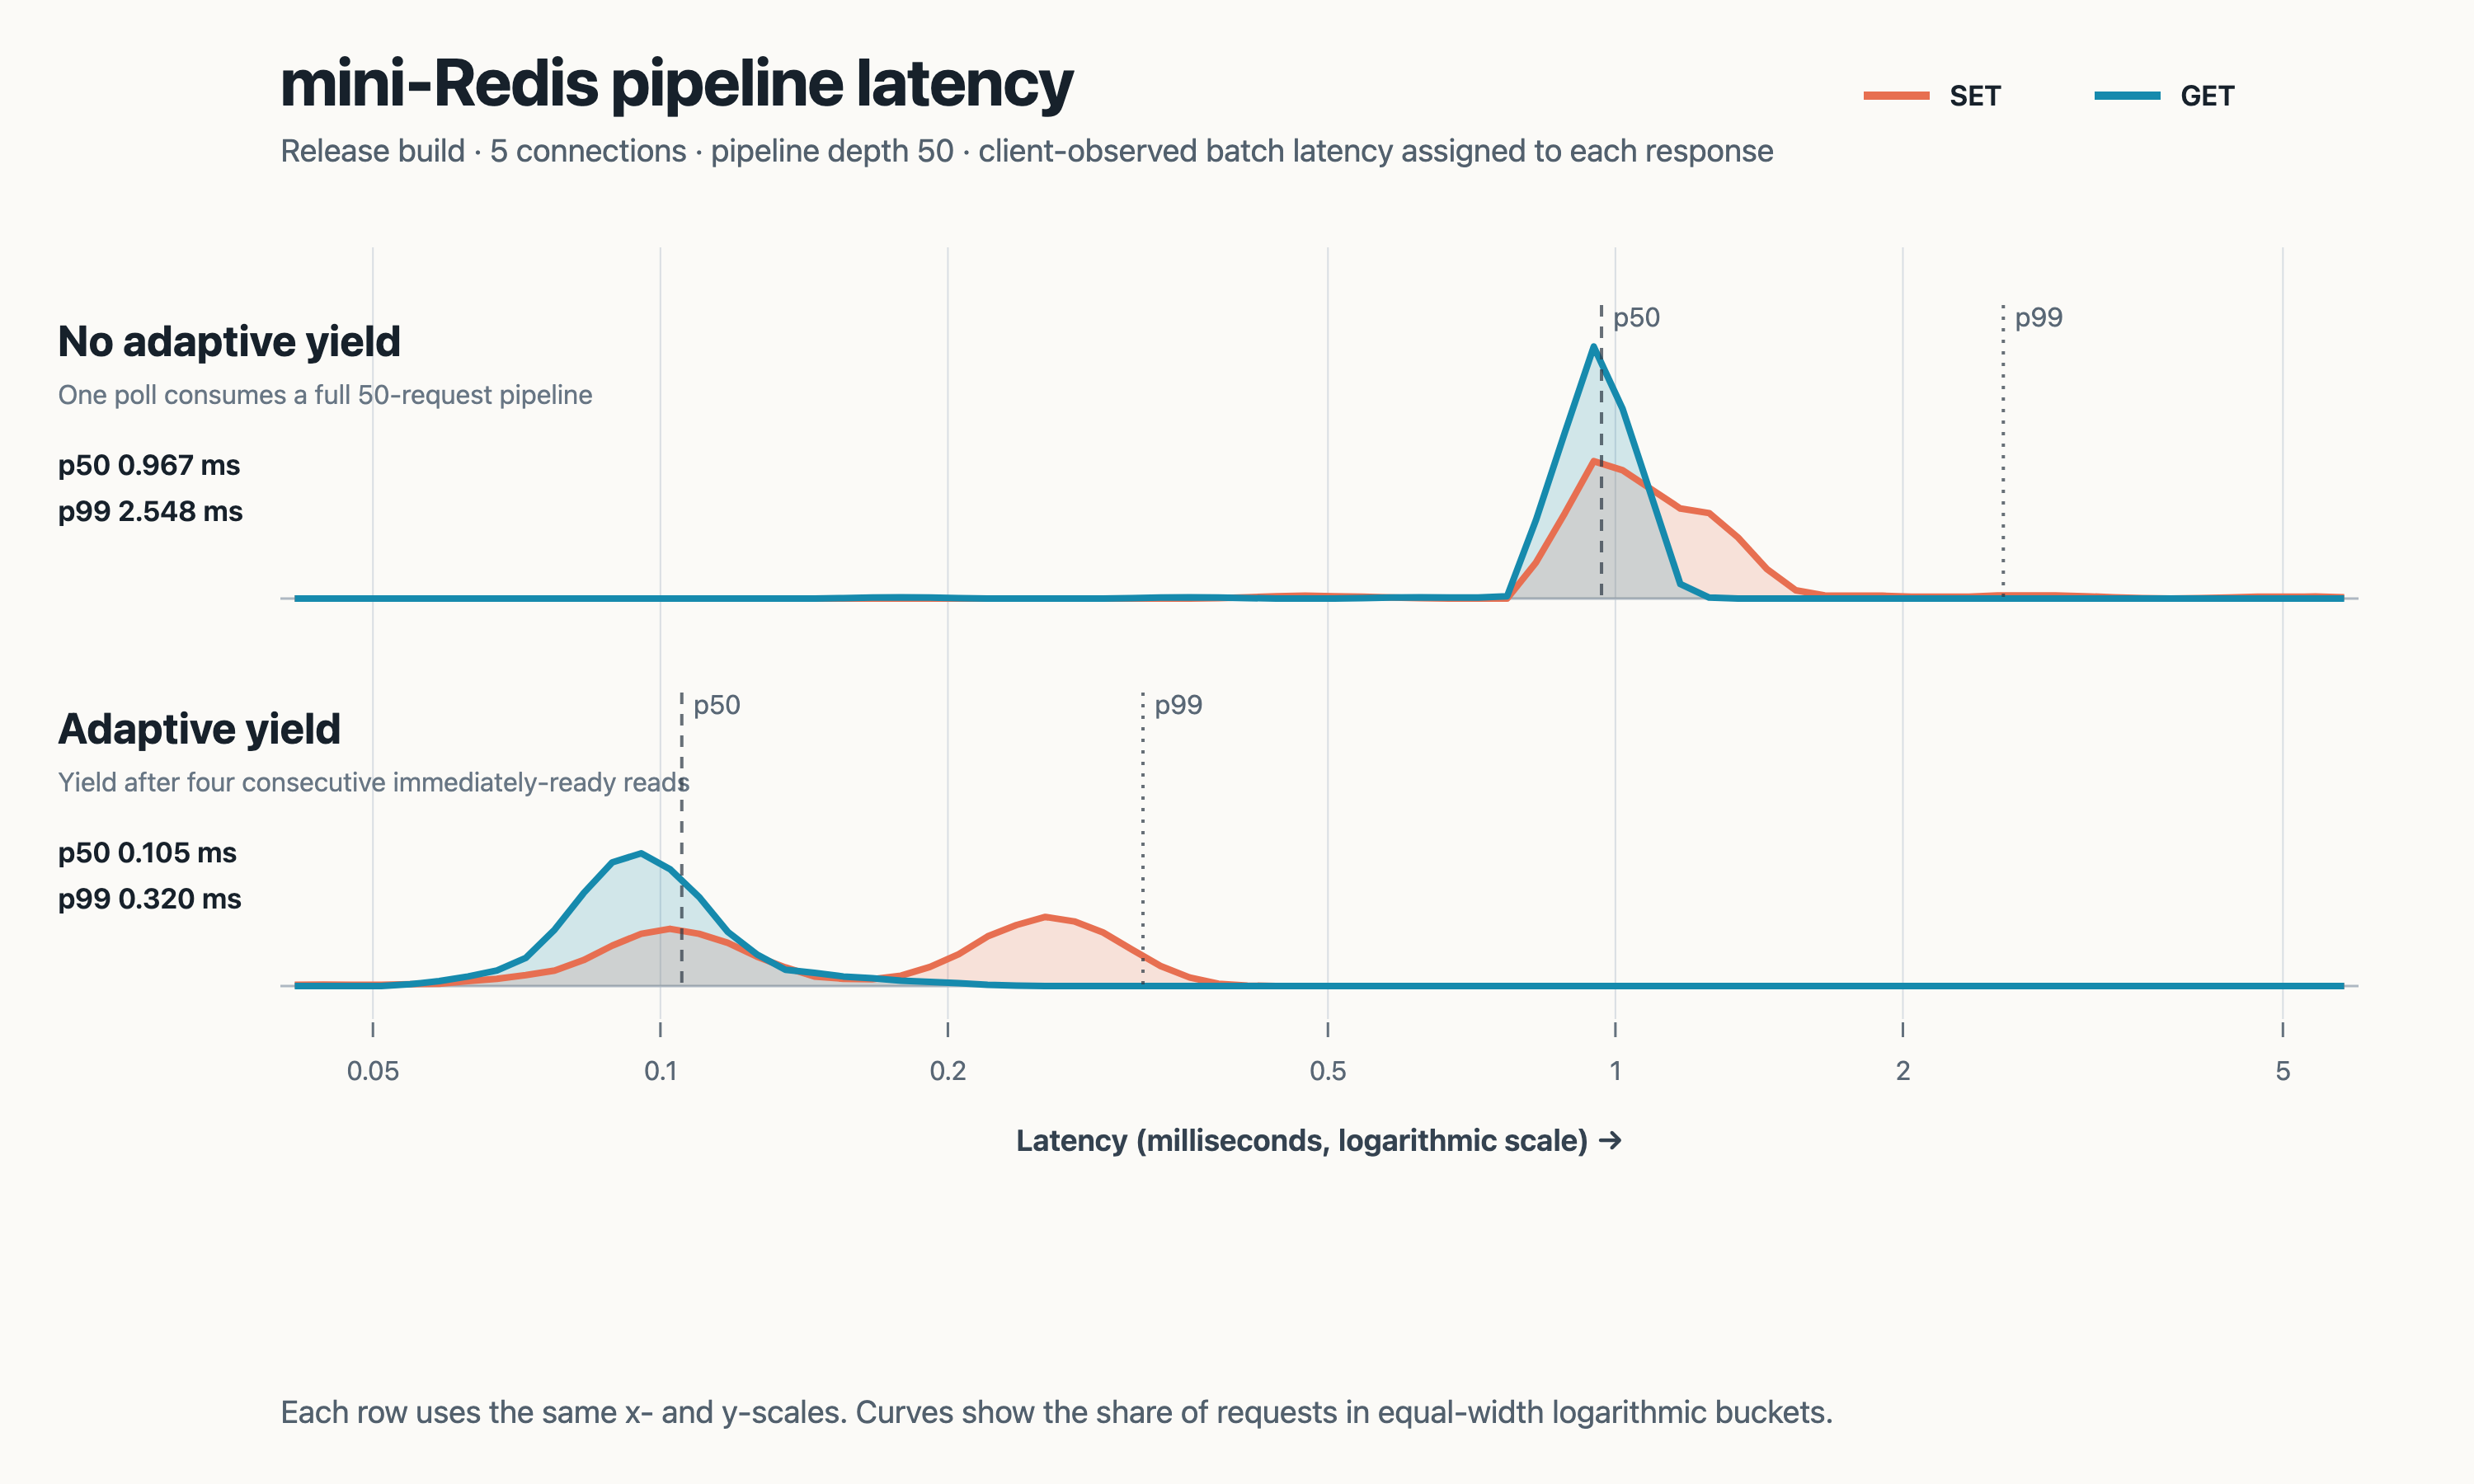
Yield после четырёх последовательных immediately-ready чтений делает pipelined запросы намного справедливее без полного отказа от батчинга.
Как узнать, есть ли эта проблема?
- P99 намного больше P50.
- Polls занимают дольше, чем должна работа внутри них.
- Много spans попадают в один poll.
Батчьте работу, чтобы амортизировать overhead
Справедливость не бесплатна. Чем больше полезной работы можно сделать за одно событие runtime — смену task, polling, движение между workers или потоками — тем эффективнее приложение.
Лучший пример — tokio::fs. Иногда говорят, что «tokio::fs опасен». Без io_uring Tokio запускает каждую файловую операцию в blocking pool. Каждый вызов spawn_blocking имеет cost, и каждый runtime использует shared blocking pool.
Если известно, что будет серия файловых операций — или любая другая blocking работа — соберите их в самый крупный разумный blocking сегмент. В некоторых случаях dedicated OS thread подходит лучше.
Этот принцип применим везде, где взаимодействуете с Tokio. Если известно, что отправите работу в global queue, батчинг может амортизировать и эту координацию.
Даже что-то столь быстрое, как spawn task, не бесплатно! Spawn task дёшев, но если спавнить сотни или тысячи tasks, каждая представляет работу, которую runtime должен обработать отдельно. Каждая создаёт больше шансов быть затронутой scheduling delay, больше отдельных polls, которые runtime должен обработать, и вообще больше overhead. Когда спавните task, подумайте, сколько работы вы на самом деле планируете: спавн 10-микросекундного куска работы в отдельную task — вероятно, контрпродуктивно. Инструменты вроде dial9 или tokio-metrics помогут отследить жизненный цикл tasks.
Как узнать, есть ли эта проблема?
- Tokio APIs вроде
spawn_blockingзанимают заметное время в flamegraphs. - Tight loop выполняет много отдельных файловых или blocking операций.
- Throughput улучшается, когда одинаковая работа сгруппирована в крупные единицы.
Остерегайтесь глобальных ресурсов
Tokio runtime планирует работу на workers — dedicated потоки, которые полируют готовые tasks. Workers масштабируются по ядрам, но некоторые runtime ресурсы требуют shared координации.
Blocking pool сейчас является глобальным ресурсом. При высокой достаточной скорости push work в blocking queue становится bottleneck и spawn_blocking может стать видным в flamegraphs. Видели негативные эффекты производительности примерно при 50,000 blocking tasks в секунду на 32-core хосте; ваш результат будет отличаться. spawn_blocking — не волшебное решение для любого blocking или CPU-heavy кода. Для короткой, ограниченной работы может быть быстрее дать Tokio workers и work stealing справиться, но, как всегда, «это зависит».
Tokio также имеет global task queue. Tasks попадают туда, когда local worker queues переполняются (обычно редко) или когда work планируется извне runtime worker, что может быть частым в некоторых приложениях. Один пример — channel, чей sender работает в non-Tokio потоке.
Как узнать, есть ли эта проблема?
- Runtime-wide операции вроде
spawn_blockingвидны в flamegraphs. - Global queue постоянно глубокая. В здоровом приложении она должна оставаться близко к пусто; в насыщенном приложении может занять долгое время на drain.
Будьте крайне осторожны с мьютексами
Один из самых простых способов остановить весь runtime — заблокировать worker на contended мьютексе.
Такие вещи, как registry метрик за мьютексом или read-write lock, особенно подвержены этой проблеме. Если flush держит lock во время дорогой работы, каждый Tokio worker может в итоге спланировать task, который пытается записать метрику и блокируется на том же lock. Stealing становится невозможным, потому что каждый worker stuck!
Держите critical sections в async приложениях крайне короткими (например, одно обновление hashmap). RWLocks почти никогда не правильный примитив, так как создают contention на atomics даже для read path. Не держите lock во время flush, выполнения I/O или await другого future.
tokio::sync::Mutex меняет одну проблему на другую: Tokio Mutexes намного дороже блокировать, подвержены тонким проблемам вроде FutureLock, и действительно подходят только если critical section длится несколько миллисекунд.
Как узнать, есть ли эта проблема?
- P99 spikes в предсказуемые интервалы, вроде раз в минуту когда работает background task.
- В dial9 множество tasks внезапно становятся blocked и off-CPU на нетривиальное время.
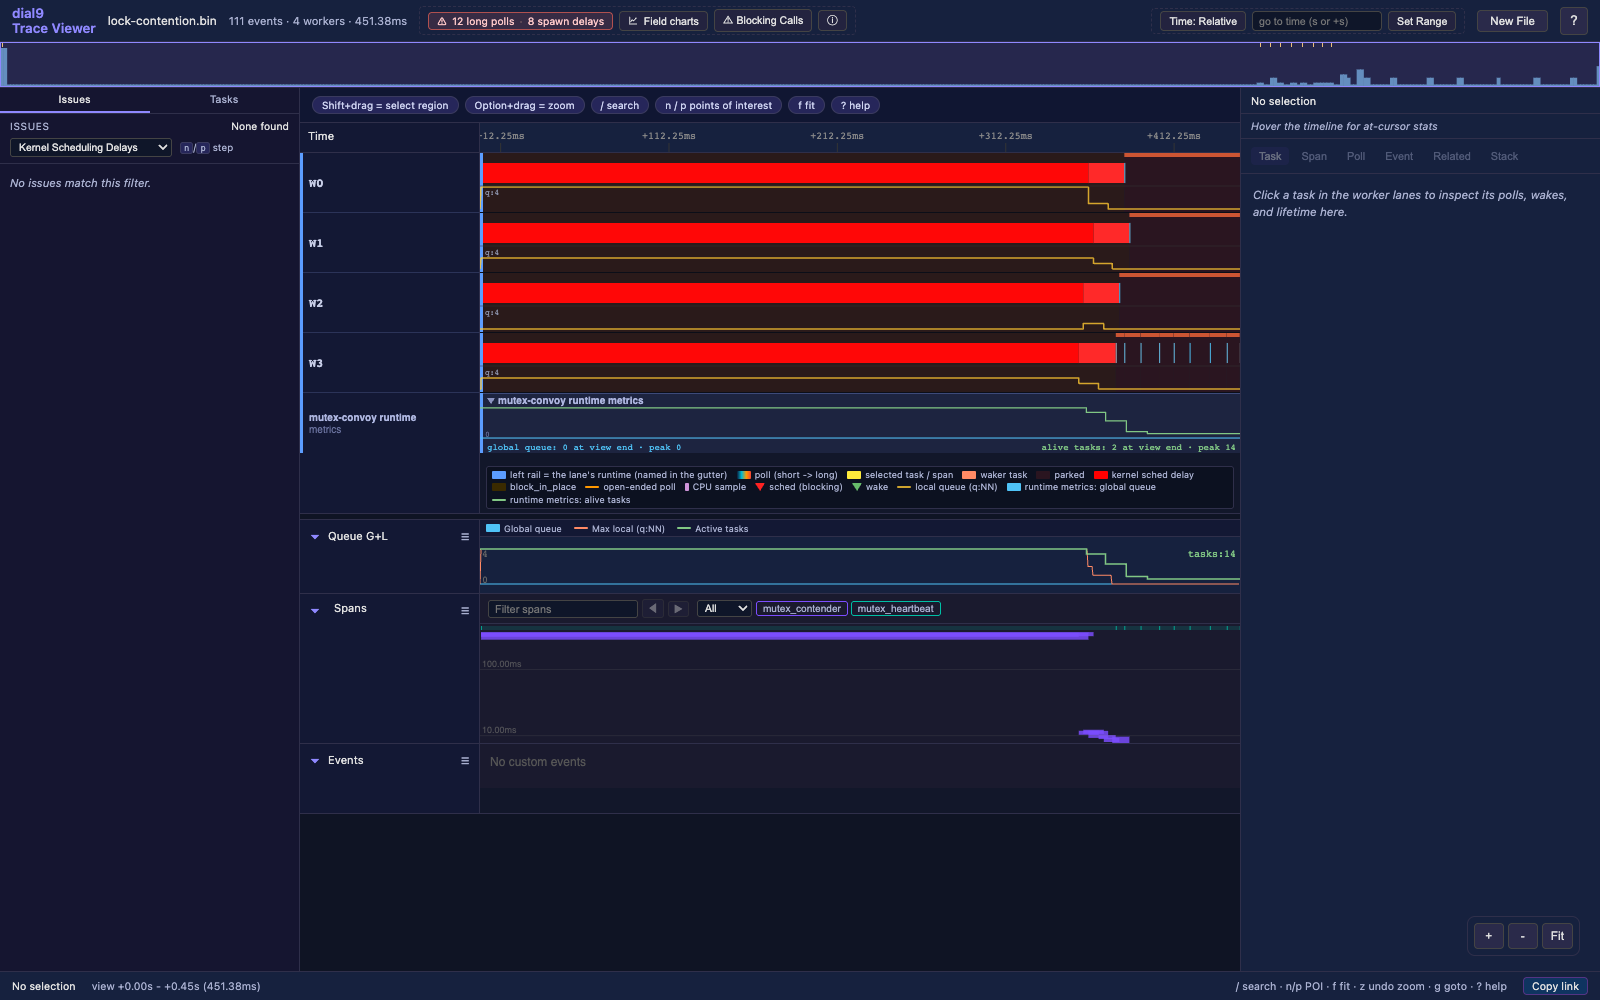
Contended blocking мьютекс останавливает все четыре runtime workers сразу.
Ограничивайте параллелизм — обычно
Tokio может с удовольствием спавнить намного больше tasks, чем остальная система может обработать. Случайно открыть 3,000 concurrent соединений к S3 потому что workload создал unbounded число tasks — очень частая ошибка.
Ответ скучный: ограничьте concurrency. Причудливые адаптивные алгоритмы иногда уместны, но Semaphore часто достаточна.
Изолируйте Tokio workers от других потоков
Дизайн Tokio полагается на быстрое пробуждение workers. Однако если операционная система высоко нагружена, может потребоваться 10–20 мс — или больше — ядру спланировать worker после того как Tokio пытается его пробудить. Если измеряете P99 latency в single-digit миллисекундах, это катастрофа. Видели это во время инкрементальной миграции с Java на Rust в Amazon, где оба процесса работали на одном хосте и Rust процесс постепенно брал на себя больше работы.
Чем меньше работы делал Java процесс, тем быстрее становился Rust процесс, даже когда обрабатывал больше работы. Эффект ещё сильнее, когда другие приложения используют большое число потоков.
Самое базовое решение — использовать cgroups или связанные API чтобы pinned Tokio workers и другой код на отдельные CPU cores.
Та же проблема может возникнуть от других Rust потоков. Background потоки, например используемые tracing_appender, иногда делают более 100 мс работы без yield CPU. Если Tokio пытается пробудить worker в это время, тот worker может быть задержан пока kernel не преемпт другой thread.
Если видите это происходящим, решение то же: pin некритичную background работу на её own core и переместите Tokio workers на другие cores. Вы редко нуждаетесь в каждом core для Tokio, и резервирование cores для другой работы обычно улучшает latency.
Как узнать, есть ли эта проблема?
- dial9 показывает kernel scheduling delay между worker-unpark event и тем когда worker на самом деле работает.
Трюки для когда вы знаете лучше
Паттерны в этом разделе обычно не правильное решение, но иногда они ровно то что нужно workload'у.
Блокировка executor'а может быть в порядке — иногда
В идеализированном async приложении вся работа происходит крошечными bursts с частыми yields обратно Tokio. Реальный мир не всегда работает так, и крошечные bursts не обязательно самый быстрый способ запустить software. Батчинг работы может быть эффективнее.
На практике длинные polls не всегда проблема. При лёгкой нагрузке Tokio's work stealing может компенсировать когда один worker занят дольше обычного. Это начинает ломаться при двух условиях:
- Tokio runtime тяжело нагружен и spare worker capacity не существует.
- Операционная система тяжело нагружена, поэтому unparking workers часто задерживается.
В обоих случаях stealing work занимает дольше. Если work не stolen быстро достаточно, core runtime maintenance — вроде driving I/O — может не происходить часто достаточно чтобы поддерживать низкую latency.
Важно! Этот совет не применяется если используете такие вещи как tokio::join! и tokio::select!, которые используют in-task concurrency. Внутри одного task нет work stealing; если блокируете executor, ничего другого работающего на том task не может прогрессировать. Это иногда проявляется как неожиданные timeouts и вообще плохая latency.
Используйте несколько runtimes чтобы изолировать workloads по приоритету
Самая сильная изоляция приходит от присвоения работы отдельным runtimes и pinned тех runtimes на dedicated cores. Много network services имеют оба latency-sensitive работу и lower-priority background работу. Помещение их на отдельные runtimes создаёт scheduling boundary между ними.
Можно также установить OS-level niceness когда runtime потоки стартуют. Смотрите dial9's multiple-runtime example и Tokio's on_thread_start hook.
На TokioConf общее впечатление от большинства talks то что folks закончили переходом на решение с по крайней мере двумя runtimes.
Spin чтобы сохранить контроль
Это очень advanced тактика для охоты на latency измеряемую в микросекундах. Я не рекомендую обращаться к этому в первую очередь, но это может определённо сработать.
Каждый раз когда вы yield обратно к Tokio scheduler — или Tokio parks worker thread и yields его операционной системе — создаёте шанс что та работа будет задержана когда проснётся.
Для крайне latency-sensitive работы один вариант — намеренно spin на короткий preset период, может быть 50 микросекунд, вместо yield пока ждёте следующий кусок полезной работы. Это потребляет core и может вредить соседним workloads, поэтому вероятно неправильно для большинства приложений. При тщательно контролируемых условиях, однако, это может быть правильный tradeoff.
Приложение: умственная модель Tokio в четырёх пунктах
- Rust futures делают incremental progress между await points. Эти активные секции называются polls, по методу
Future::poll. - Когда futures не полируются, они idle и ждут executor чтобы их запустить снова. Хороший executor полирует future только когда тому есть работа.
- Tokio запускает N workers, обычно один per available core. Каждый worker имеет local queue. Когда queue переполняется или work не может быть добавлена в local queue, task идёт в global queue.
- Когда queue одного worker'а резервируется, другой worker может steal работу из неё — если runtime обнаружит дисбаланс и другой worker имеет capacity.
1 Tokio 1.52.0 кратко поставил sharded blocking queue, но 1.52.1 reverted его после regression которая могла привести spawn_blocking to hang. Tokio PR #8337 позже re-landed sharded queue как unstable feature которая disabled по умолчанию.