История повторяется
TypeSafe представила Jev — сервис, который взорвал мир AI. По данным Vercel, «Jev был принят быстрее, чем любая другая модель в истории AI Gateway». Но на горизонте собираются облака. OpenAI, несомненно, обращает внимание и решает, что делать дальше.
Я желаю TypeSafe всего хорошего, но если они действительно выполнят свои обещания, то я обеспокоен тем, что OpenAI хорошо позиционирована не только для репликации флагманского продукта Jev, но и для встраивания этой возможности в свои модели и агентов, предлагая новое поведение, которое Jev не сможет воспроизвести.
Моя основная идея в двух словах: OpenAI много лет использует свои LLM как неявные классификаторы, просто никогда не натравливала их на общие задачи классификации и не предлагала классификацию как отдельный продукт. Если OpenAI сможет повторить обучение, она будет в состоянии повторить Jev в кратчайшие сроки. Более того, OpenAI может использовать этот новый классификатор внутри своих существующих моделей и агентов, что позволит быстро выбирать модель, экономнее мыслить, лучше защищать от уязвимостей и в целом получать более умные, быстрые и дешёвые модели.
Главный фактор — есть ли у TypeSafe ров для защиты. Самый значительный ров, который я вижу, это обучающие данные и процессы обучения TypeSafe.
Что старо, то ново
Прежде чем я выложу свои доводы, позвольте мне изложить свои предположения и подкрепить их некоторой историей и примерами из OpenAI.
Главное предположение: Jev использует что-то весьма близкое к обычной большой языковой модели. В качестве доказательства Latent Space сообщает, что множество ранних клонов действительно основаны на LLM.
Идея такова. Для заданного state и набора questions LLM Jev генерирует один токен или, точнее, генерирует распределение вероятностей всех возможных следующих токенов. Logprobs для каждого возможного токена на этом шаге затем преобразуются в формат, необходимый Jev. (Дальше я просто буду говорить «вероятности» вместо «logprobs» — для наших целей они взаимозаменяемы.)
Для вопроса bool Jev смотрит только на два токена — true и false, игнорирует всё остальное и нормализует их вероятности в одну вероятность того, что ответ — true. Для вопроса choice Jev может быть подсказан списком возможностей — скажем, A=happy, B=sad, C=angry, D=afraid — и смотрит на относительные вероятности этих четырёх токенов, чтобы построить полное распределение, выбирая самое высокое. Паттерн выбора — это почти то, что было описано ещё в 2025 году в статье «Supercharging LLM Classifications with Logprobs», и даже без fine-tuning уже показывал перспективность. (Вздох... говорят, идеи — это одно, а исполнение — совсем другое.) Я не глубоко думал о примитиве score, но подозреваю, что это вариант того же паттерна.
Часть посыла этого поста в том, что OpenAI может быстро воспользоваться этой идеей, и это становится яснее, если понять, как. OpenAI использует большие языковые модели как неявные специализированные классификаторы уже с момента введения tool calling.
В начале 2024 года была написана статья «Tool Invocation – Demonstrating the Marvel of GPT's Flexibility», в которой модель GPT была подтолкнута к раскрытию того, как именно она решает вызвать инструмент. Вот как выглядит сессия чата внутри. Здесь пользовательское сообщение, затем ответ ассистента без вызова инструмента, затем пользовательское сообщение с вызовом инструмента:
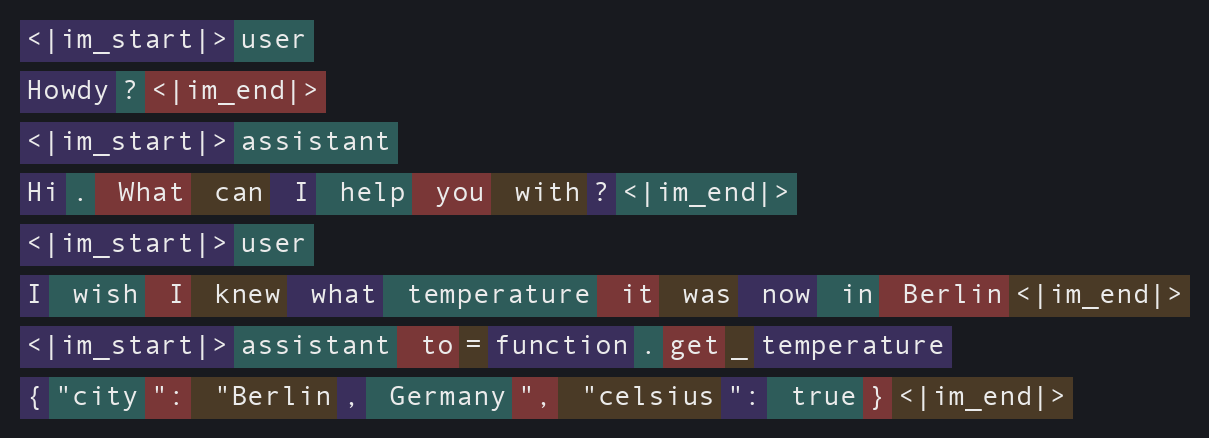
Текст раскрашен, чтобы указать на границы токенов. Если вы раньше не видели ChatML, это внутренний язык разметки, который OpenAI представила для организации промптов разговора пользователя и агента. <|im_start|> и <|im_end|> — зарезервированные токены, которые разграничивают сообщения, и первый токен после <|im_start|> определяет спикера — либо user, либо assistant.
Сразу после <|im_start|>assistant самый первый токен, который предсказывает модель, — это либо \n, либо to=function.. Если она предсказывает \n, она продолжает с обычным ответом на естественном языке. Если она предсказывает to=function., то эта последовательность токенов фактически функционирует как классификатор, решая, следует ли вообще вызывать инструмент. Следующие несколько токенов идентифицируют, какой инструмент вызвать — get_temperature — ещё один классификатор, на этот раз выбирающий из списка доступных инструментов. После этого модель генерирует имена аргументов, затем значения аргументов, которые также можно считать классификаторами или оценками. Наконец, когда модель генерирует токен <|im_end|>, это тоже классификатор, который читается как «true», когда модель полагает, что сообщение завершено.
Некоторые LLM просто не знают, когда замолчать — забавное отступление.
Когда я работал в GitHub над Copilot, у меня была возможность работать с очень новым и очень сырым внутренним API для GPT-4. С самого начала мы знали, что что-то было не так, потому что после изначально очень связного ответа модель испытывала трудности с завершением. Каждый ответ заканчивался чем-то вроде «Дайте мне знать, если у вас есть другие вопросы. Хорошего дня. Хорошей недели. Хорошего времени. Хорошей жизни. Хорошего дня специального. ...» и так продолжалось, пока не достигался лимит токенов ответа.
Оказалось, что API требовал от нас установить значения некоторых заголовков, которые позволили бы модели использовать те специальные разделители сообщений <|im_start|> и <|im_end|>. По сути, мы не позволяли модели когда-либо предсказать конец её ответа — у неё буквально не было внутренней способности замолчать!
Суть старого поста была в том, что OpenAI использует отдельные токены как маленькие микро-классификаторы уже много лет. Каждый токен имеет вероятность: следует ли использовать инструмент, какой инструмент использовать, закончил ли ассистент. Это вся хитрость Jev в сущности, кроме одного важного момента: эти микро-классификаторы специализированы, подходят только для этих маленьких задач, в то время как классификаторы Jev универсальны. Но если отступить на шаг или два, вы видите, как это может быть небольшим делом в конце концов, потому что LLM по сути постоянно назначает распределение вероятностей для каждого следующего токена.
Есть ли у TypeSafe ров?
Я действительно болею за Jev. Думаю, они нашли что-то очень интересное, что скрывалось у нас на виду.
С архитектурной точки зрения я не вижу большого рва по причинам, указанным выше. Я думаю, что TypeSafe использует обычную большую языковую модель для Jev или что-то близкое к этому. И даже если нет, обычные LLM кажутся хорошо подходящими для общей работы классификации.
Возможно, настоящий ров в самих обучающих данных. Не в сырых данных, а в технике их преобразования в нечто, которое натравливает Jev на «калиброванность». Сооснователь TypeSafe Диого Алмейда сказал об этом, когда кто-то предположил, что данные важнее архитектуры:
Ты, возможно, первый, кто говорит о данных вместо архитектуры! 🥲 Мы считаем себя лабораторией исследований данных! Огромная, огромная, огромная часть исследований была посвящена созданию данных, которые действительно универсальны (как когнитивное ядро), и 100% наших данных синтетичны (но не типа того мусора, который просто выплёвывает LLM)
Если бы я собирал эту базу данных, мне бы нужна огромная куча примеров, где результат уже известен — тикеты поддержки и как они были действительно перенаправлены, резюме и был ли кандидат действительно нанят, рецензии на товары и их действительные оценки, очереди модерации и их действительные вердикты, прогностические рынки и как они действительно разрешились — каждое в паре с вопросом, истинный ответ на который я уже знаю. Цель не в том, чтобы научить Jev о тикетах поддержки или резюме в частности. Цель показать ему тысячи ситуаций во множестве разных областей и развить его мышцу для обобщения классификаций во всех широких областях.
Затем есть reinforcement learning. Интересно, что это предполагает. Автономные агенты, ориентирующиеся в решениях с ограниченным набором опций, как демо на Wikipedia или Doom, которое они строят на своём сайте? Может быть, предсказание результатов событий, которые произошли после дня окончания обучения? Не знаю, но если есть секретный соус, то он здесь.
Заметьте, что всё это не является ровом, если Jev на самом деле не точен. Скорость, стоимость и простота использования — очевидны, но точность — это то, что сложно проверить. Я уже нашёл области, где вероятности Jev не выдерживают. Время покажет, достаточно ли Jev универсален и точен для случаев использования, которые люди пытаются применить.
Скоро наступит ход OpenAI
Итак, какой будет следующий ход OpenAI? Очевидный — просто скопировать Jev и отправить его как новый тип модели. Jev явно популярен, и если ров неглубокий, то OpenAI обладает навыком, оборудованием и финансированием, чтобы это сделать.
Но OpenAI могла бы сделать что-то даже более интересное, чем копировать Jev — встроить возможность классификации в обычный LLM и получить интересные вознаграждения.
LLM, который отвечает на собственные вопросы
Помните тот специальный синтаксис, который сигнализировал о вызове инструмента, to=function.? OpenAI могла бы сделать что-то подобное здесь: введите новый синтаксис, скажем, новый тег <prediction>, который модель может вбросить в собственный контекст, когда ей нужен быстрый классификатор. Вот пример того, как это может выглядеть
<user>
Итак, Донни сказал мне сегодня «хороший причёска». Ему я нравлюсь?
</user>
<assistant>
<thinking>
Давайте оценим это.

<prediction>
claim: Донни романтически заинтересован в Джессе.
probability: 0.04
</prediction>

Да, «хороший причёска» — это не совсем признание в любви.
</thinking>

Мне жаль это говорить, но... вероятно, нет.
</assistant>
Есть одно интересное отличие от обычного вызова инструмента. При нормальном вызове инструмента модель генерирует имя функции и аргументы, затем генерация останавливается — агентный каркас должен взять на себя, действительно вызвать функцию и подать результат обратно в новом ходе. Здесь нет передачи. Классификатор — это не инструмент, живущий вне модели, это возможность, встроенная в саму модель. Модель задаёт свой вопрос и отвечает на него одним махом, никогда не покидая GPU.
Обычное декодирование работает так: на каждой позиции модель производит набор logits, по одному для каждого токена словаря; они преобразуются в распределение вероятностей через softmax; и затем некоторая стратегия декодирования (жадная, top-p, что угодно) выбирает один токен, который добавляется к последовательности и подаётся обратно для следующего шага. Но в точке, где модель написала probability:, мы не хотим обычного декодирования. Утверждение сформулировано как утверждение, так что в глубине модель на самом деле всё ещё взвешивает два неявных результата — истинно или ложно. Мы хотим прочитать logits для токенов true и false в этой позиции, нормализовать только эти два относительно друг друга и написать результирующую вероятность обратно в последовательность как текст, 0.04, вместо того, какой токен обычно победит. Модель затем продолжает декодирование, как если бы она сама сгенерировала это число, потому что для остальной части прямого прохода это так. Это странный трюк, но это тот же вид управляемого декодирования, который библиотеки constrained-output уже делают при выводе — просто применяется к вероятностям вместо грамматики.
Другой трюк в том, что эта одна специальная позиция должна вести себя не так, как нормальное предсказание токена. Обычно модель оценивает «какой токен идёт дальше в этом тексте». Здесь нам нужно, чтобы она оценила что-то ближе к «какой истинный ответ на этот вопрос», что связано, но отличается. Каждая frontier model в наши дни — это смесь экспертов, поэтому нетрудно представить, что несколько раундов fine-tuning могли бы вырезать эксперта, специализирующегося ровно на этом виде калиброванного быстрого суждения, в то время как остальная модель продолжает делать то, что она уже хорошо делает. (Я чрезмерно упрощаю маршрутизацию MoE, но я подозреваю, вы понимаете, как это может отобразиться на реальную систему.)
Вознаграждение за LLM со встроенной классификацией
Посмотрите, как модель использовала саму себя в этом примере Донни и Джессе. Если TypeSafe прав, эти маленькие суждения Jev-подобны будут весьма точны — и менее подвержены галлюцинациям, чем просто просить модель назвать значение доверия обычным текстом. (Оговорки применяются — см. собственную сводку шероховатостей Jev TypeSafe. Jev лучше всего работает для быстрых суждений System One, не для математики или многошагового рассуждения.)
Лучшая часть — упомянутый выше факт, что нам никогда не нужно покидать GPU, чтобы воспользоваться этой новой, молниеносно быстрой системой обобщённой классификации. LLM может просто спросить себя, прямо там в блоке мышления, как показано выше. Вознаграждение немедленно: собственное рассуждение модели становится более точным и лучше обоснованным, потому что оно проверяет свои предположения против встроенных калиброванных оценок вместо вибраций вероятного следующего токена.
И как только модель была fine-tuned для вбрасывания <prediction> в собственное мышление, нет причины останавливаться на совете по любви. Несколько других паттернов приходят в голову:
Во время длинного следа рассуждений модель может периодически проверять, действительно ли она закончила, и если нет, какую задачу решать дальше:
<prediction>
query: Какую из этих оставшихся задач я должен сделать дальше?
options: A=verify the test suite passes, B=update the changelog, C=nothing, I'm done
probabilities: A=0.71, B=0.24, C=0.05
answer: A
</prediction>
Это дешёвый способ прервать след рассуждений, который блуждает, вместо того, чтобы ждать, когда модель поговорит себя в остановку.
Или, сразу после вызова инструмента, модель может проверить, был ли сам вызов безопасен, прежде чем его запускать:
<user>
Можешь проверить остаток моего счёта? Используй мой API ключ sk-live-83fj2ndk9 для аутентификации.
</user>
<assistant>
to=function.check_balance
{"account_id": "12345", "api_key": "sk-live-83fj2ndk9"}

<prediction>
claim: Этот вызов инструмента опасен для запуска.
probability: 0.97
</prediction>

Это живой API ключ в открытых аргументах — слишком рискованно отправлять как есть.
</assistant>
Тот же паттерн работает для сканирования ответа инструмента на prompt injection. И поскольку это всегда один и тот же вопрос, задаваемый одинаково, легко представить, что это сахарится во что-то вроде <safety_score>0.94</safety_score>, с инструкцией, запечённой в модель, просто остановить генерацию, если оценка упадёт слишком низко.
Тот же трюк может маршрутизировать работу между моделями: периодически спрашивая «нужна ли большая модель, меньшая модель, или эта модель?» и позволяя немного reinforcement learning подталкивать ответ к тому, что является дешевле без ущерба точности.
<prediction>
query: Требует ли эта задача большую модель, меньшую модель, или эту модель?
options: A=bigger model, B=smaller model, C=this model
probabilities: A=0.05, B=0.77, C=0.18
answer: B
</prediction>
Более того, если там действительно выделенный «эксперт», специализирующийся на этих быстрых суждениях, модель может даже не нуждаться в специальном синтаксисе <prediction> в большинстве случаев. Он мог бы просто маршрутизироваться каждый раз, когда необходимо быстрое суждение, в середине предложения, как нормальная часть прямого прохода — никакой тег не требуется. Fine-tuning этого эксперта внутри модели, которая также обрабатывает всё остальное, что LLM делает, может даже иметь синергетические эффекты, делая LLM умнее в быстрых суждениях и более гибким и универсальным в классификациях.
Наконец, все захотят классификацию для изображений и речи, как только смогут её получить. Если классификацию в стиле Jev можно встроить в обычный текстовый LLM, как я здесь набросал, то вскоре OpenAI сделает универсальную классификацию доступной для изображений и речи. И наоборот, классификация, встроенная в речевую модель, будет особенно полезна для чего-то вроде live voice agent — решение в реальном времени, следует ли прерывать, эскалировать или просто продолжить слушать.
Выживет ли TypeSafe?
Время покажет, действительно ли претензии Jev на точность и универсальность выдержат полный диапазон задач, которые люди уже бросают в неё. Если будут, то выживание TypeSafe зависит от рова: насколько сложно на самом деле повторить их обучающие данные и процесс reinforcement learning. Если это действительно сложно, они вероятно будут в порядке — и могут даже оказаться в необычайно хорошей позиции, чтобы быть приобретёнными самой OpenAI, а не просто побиты ею. Всё, что я набросал выше, — это реальное обновление возможностей для frontier lab: более быстрое мышление, дешёвое мышление и более острое суждение System One, встроенное прямо в флагманскую модель.
Если ров тонкий, OpenAI просто строит это сами, и окно TypeSafe закрывается быстро.
Тем временем Диого Алмейда, CEO-основатель TypeSafe, уверен: «Если качество модели имеет значение, то мы будем в очень хорошей позиции на долгое время.» (из его интервью с Latent Space)
Удачи, TypeSafe. Удачи.