Куда ушли токены в этом месяце
Вот распределение токенов согласно AgentsView, одному из инструментов, рекомендуемых для отслеживания использования AI:
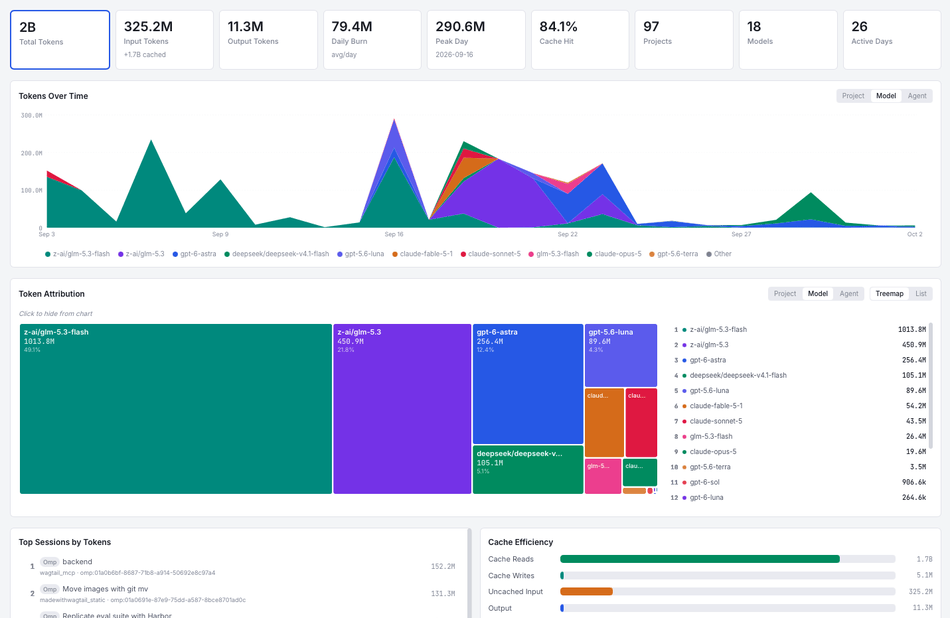
Если присмотреться к распределению по моделям:
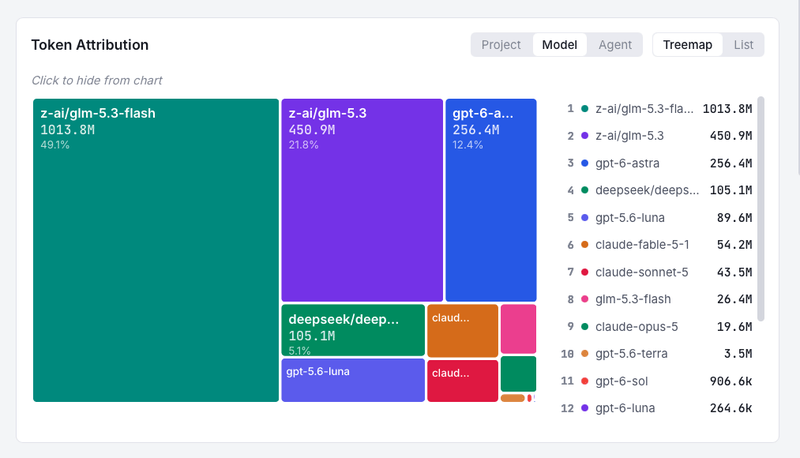
Целью было провести весь месяц на GLM 5.3 Flash (выделена бирюзовым). Что получилось хорошо:
- Успешно провел первую половину месяца только на этой модели.
- Использование модели остался в рамках бюджета ($68, примерно 4 кВт·ч энергии / 365 грамм CO₂).
Во второй половине месяца дела пошли хуже — миллиард токенов ушел на другие модели.
Непредвиденные препятствия
Честно говоря, можно было бы их предусмотреть! Но вот что произошло:
Цена «вибе-кодирования»
Экспериментальный Wagtail MCP сервер — это прототип, написанный по принципу «вибе-кодирования». Для прототипа это подходит, но есть последствия. Выбрал неправильную модель для него, и потратил 450 млн токенов / $150 / 5 кВт·ч почти за ночь. Сервер работает хорошо и дает отличную демонстрацию возможностей, но урок усвоен:
Это напоминание о важности правильного выбора модели и внимательности с агентными паттернами. При том же результате можно было потратить в 5 раз меньше денег, не требуя существенных дополнительных усилий. Урок на будущее: нужно бюджетировать это и быть осторожнее. Можно было предусмотреть заранее, но теперь знаю.
Проблемы с инфраструктурой
Еще одно неожиданное препятствие — проблемы с доступностью инфраструктуры. Экспертиза в сравнении провайдеров inference помогла, но они очень популярны и не имеют той же пропускной способности, что и большие лаборатории с кучей GPU. Заметна деградация производительности GLM 5.3 Flash, вероятно, потому что она расположена так высоко на фронтире Парето для нашей работы.
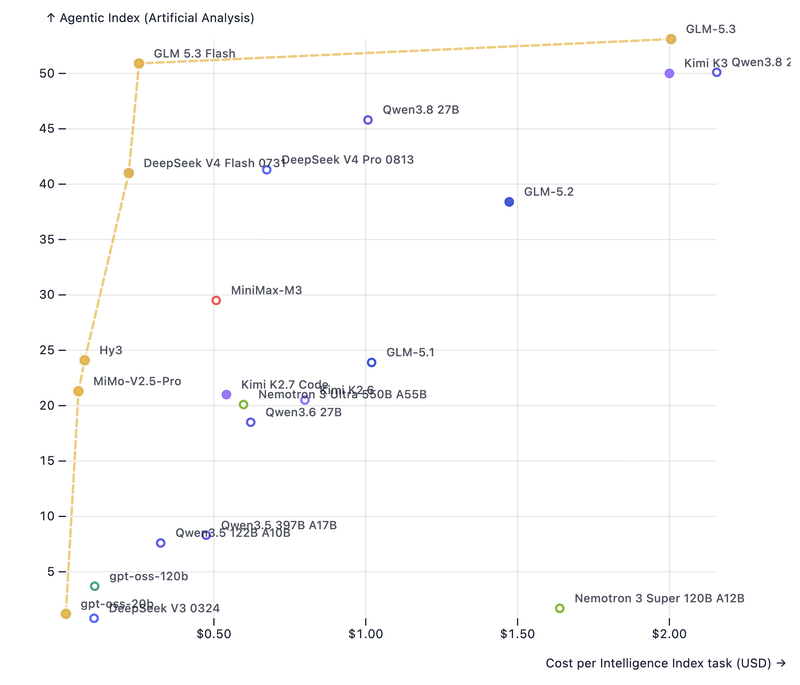
Примечание: фильтр показывает только открытые модели, подтвержденные в европейских дата-центрах. Ваш фронтир может выглядеть по-другому, если вы готовы запускать inference в других местах.
В нашем случае пришлось переключиться на похожие модели (DeepSeek V4.1 Flash, Qwen 3.8 Flash). Это просто делается, но было неожиданно!
Цена экспериментов и R&D
Помимо использования одной модели для повседневной разработки, казалось необходимо постоянно экспериментировать с широким диапазоном моделей, следить за новыми релизами. Это особенно важно, когда начинают бенчмарить модели на задачах Wagtail — нужны данные по множеству моделей. Вот превью бенчмарка:
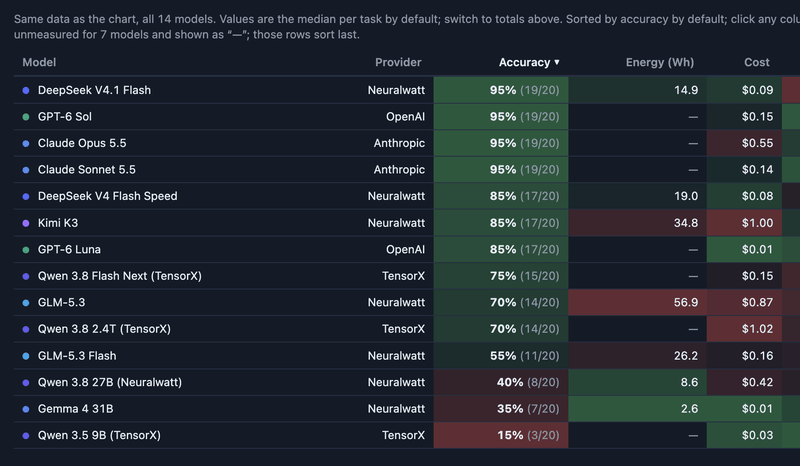
Гораздо проще рекомендовать людям более эффективные варианты, когда есть конкретные данные. Также это помогает сделать такие варианты более практичными с помощью agnet skills или нового CLI прототипа, который рассчитан на хорошую работу с агентами.
Что получилось хорошо
Не все было плохо. Хочется продолжить челлендж, но только для 50%+ обычной ежедневной «production» работы, без R&D. GLM 5.3 Flash сама по себе была отличной! Стоит повторить из сравнения моделей, почему она так хорошо подходит для такого челленджа:
- Контекстное окно в 1 млн токенов — любая расширенная задача кодирования возможна.
- Поддержка vision — может работать со скриншотами и визуально проверять QA.
- Доступна у множества провайдеров — видны преимущества здоровой конкуренции.
Использовал ее для работы с самим Wagtail, сайтами, построенными на нем. UI задачи, AI R&D, немного документирования. Много eval-ов. Действительно универсальная.
Выводы и планы на октябрь
Технически челлендж провалился. Только 50% использования целевой модели, 1 млрд из 2 млрд токенов. Примерно 35 кВт·ч энергии вместо 10. Но много чему научились, что в данный момент критически важно. Вот что необходимо для октября:
- Постоянное локальное измерение и отчетность об использовании. Смотреть не только на токены, но и на энергию и затраты, в идеале — как это приводит к конкретным положительным результатам.
- Бюджетирование экспериментов, а не только ежедневных задач. Более осознанные решения о том, какие прототипы стоит строить и как.
- Лучший выбор промптов и многоагентные техники. Orchestrator vs. scout vs. implementer vs. reviewer агенты. Ограниченные цели. Не rocket science, но еще одна вещь для обучения.
- Продолжить продвижение в сторону более эффективных техник и моделей. Decision diffusion модели в стиле Jev выглядят очень многообещающе, если могут работать так эффективно. Последние флагманские модели тоже смотрятся шагом в правильном направлении.
Для ежедневной разработки вполне возможно сосредоточиться на одной-двух flash-tier дешевых моделях. Разумная цель — чтобы большинство AI inference работы выполнялось на таких эффективных моделях, измеряемое в стоимости или энергии, а не в бессмысленных токенах. Это цель на октябрь! Попробуйте сами, многому научитесь в процессе.
Встретимся на Wagtail Space 2026 в ноябре, чтобы услышать, как все это обернулось!