Двери, которые «сосут»
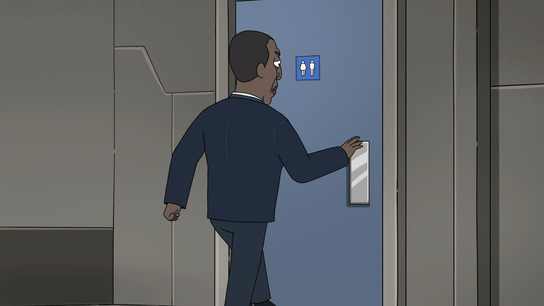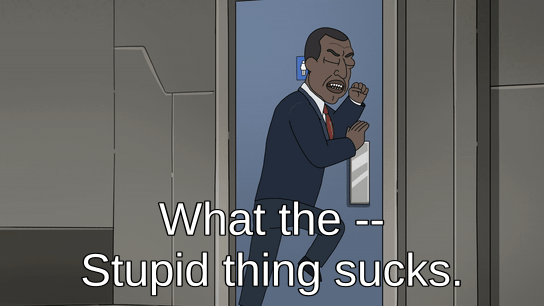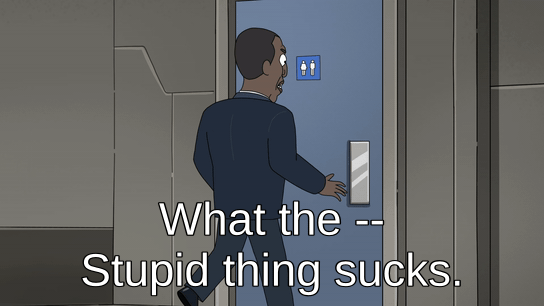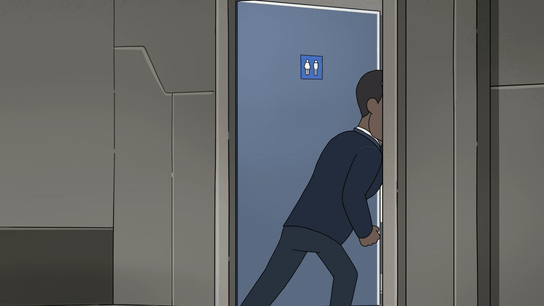
В одном из эпизодов сериала President Curtis персонаж дважды борется с дверью, которая не открывается. Первый раз её блокирует тело человека, второй раз — примерно миллиард долларов золота.
В обоих случаях в ответ на разочарование персонаж бормочет: «stupid thing sucks». Но это же совершенно неразумная модель дверей! Двери не должны просто «сосать» без причины. Эти моменты вызывают бешеный смех, хотя, может быть, просто сам автор такой же неумелый.
Jev: ещё больше неработающих дверей
Интернет обсуждает Jev — модель AI от TypeSafe AI, которая возвращает типизированные значения с оценками вероятности. По сути, это:
- быстро и дёшево,
- можно быстро строить на этом,
- быстро, и
- дёшево.
Сложность в том, что технология требует всё так же проделать труднейшую часть работы. Чтобы понять, работает ли Jev, нужно создать тесты и pipeline с ground truth. А если уже есть тесты и pipeline, то уже можно большую часть пути пройти, просто дообучив свою модель.
Но может быть, это и не требуется?
Никто из покупающих это не запускает никаких тестов. Они просто скидывают непрозрачные вопросы в Jev и получают непрозрачные ответы. В лучшем случае это позволяет поставить галочку «AI-powered» и отправить в продакшн до конца недели. Когда это сломается в downstream логике, можно просто пожать плечами: «ну, AI же может ошибаться».
Error budgets? Failure modes? Test sets? Всё это можно разобрать потом. Пользователь сам обнаружит частоту сбоев! Ты же уже отправил продукт!
Ложная уверенность
«Погодите,» — скажет критик, — «вы же не учли, что Jev выдаёт оценки уверенности!»
Что ты с ними будешь делать?
Чтобы разумно использовать оценки уверенности, нужно понимать, как откалиброваны эти оценки, и иметь модель затрат на неопределённость.
На стороне калибровки: реклама Jev говорит в основном о бенчмарках, но не о том, насколько хорошо откалиброваны их оценки уверенности. Есть рецепт использования confidence scores для классификации по дереву, но это принципиально не о качестве самих оценок.
На стороне моделирования затрат: никто не хочет об этом думать. Обычно получается: «Ну, давайте просто берите любой ответ выше какого-то порога. 0.9 звучит неплохо? Что на обед?» Их же документация сама придумала порог 0.5 для «ничего не делать» и 0.9 для «делать рискованные действия», при этом оговорившись, что «правильные пороги зависят от вашего домена и производительности модели в вашем случае».
В лучшем случае люди используют confidence scores как cargo cult. В худшем — как оправдание неудачи API. Модель была уверена только на 73%! Значит, мой error budget 27%!
Ответственность
Когда кнопка на сайте сломана, у меня есть модель того, что должно было произойти. Где-то нарушен контракт. DNS сломан. Кто-то пушнул код с синтаксической ошибкой JavaScript в определённой ветке. Handler выбросил исключение, которое не ожидалось. Может, у меня и нет доступа отладить HTTP 500, но я ожидаю, что есть человек, чья задача — понять, почему endpoint возвращает 500. Ответственность чётко определена, хоть и непрозрачна.
Однако для большинства пользователей опыт примерно такой: «stupid thing sucks». ПО уже кажется капризным; больше сбоев просто меняет частоту разочарований. Похоже, не такая уж большая потеря — отказаться от возможности найти конкретную причину отказа. Иногда вещи просто не работают.
И это ведёт к нормализации необъяснимости.
Мой страх не в том, что ускоренное LLM-разработкой ПО будет ломаться чаще. Будет. И уже ломается. Это цена новизны разработки.
Мой страх в том, что «иногда это просто не работает» станет приемлемым концом расследования. Это грустно, потому что LLM-ускоренная разработка действительно может помочь решить некоторые из этих проблем. Есть множество автоматизированных QA workflows, которые не написаны из-за нехватки времени разработчиков. Те самые тесты, которые приблизили бы тебя к замене (или даже обоснованию использования) Jev, могут быть в нескольких prompt'ах от готовности.
Трагедия софтверной инженерии сегодня в том, что мы активно проектируем системы, где ни пользователь, ни создатель не проявляют интереса проверить, есть ли труп за дверью.
Мы просто пожимаем плечами и приходим к выводу: stupid thing sucks.
¹ Это напоминает поговорку, которая мне кажется столь же забавной: «иногда ты получаешь лифт, иногда получаешь шахту». Это тоже совершенно неразумная модель лифтов!
² Lock-in network effect имеет смысл, но я всё ещё недоумеваю, как люди стандартизировались на продукте, который не может надёжно доставлять сообщения. Я видел потерянные сообщения в free, paid и enterprise инстансах, которые появлялись недели спустя.
³ Ну, может быть, «чётко определена» — это слишком оптимистично. После того как Билл Гейтс знаменито не смог скачать Movie Maker, все согласились, что это предположительно кого-то проблема, просто не обязательно их. Идеально было бы получить хотя бы этот уровень ответственности без необходимости быть Биллом Гейтсом.