Le Chonk
Mistral анонсировала публичный предпросмотр Mistral Large 4. Неофициально — ML4, но по всей форме: le Chonk. ML4 выходит на границу open-weight производительности. Попробовать предпросмотр API можно прямо сейчас в Mistral Studio. Веса будут доступны в конце этого месяца.
Производительность на границе возможного
ML4 — триллионапараметровая нативно-мультимодальная модель с 49 миллиардами активных параметров. Это самая крупная и способная модель Mistral на сегодня, и она продолжает быстро совершенствоваться по мере её доработки.
Модель демонстрирует исключительную производительность в кодировании, агентических рабочих процессах и мультимодальном понимании. Уже сейчас она достигает производительности, конкурентоспособной с самыми сильными open-source моделями в мире, при этом значительно превосходя любую open-weight модель, разработанную в США или Европе. На критических enterprise рабочих нагрузках — включая кибербезопасность, финансы и право — оказывается state-of-the-art среди открытых моделей. В некоторых областях, таких как visual grounding, она идёт дальше и превосходит даже frontier closed модели.
Веса будут выпущены в конце месяца. До тех пор модель проходит red-teaming в реальных условиях вместе с лидерами в кибербезопасности, отобранными партнёрами и государственными органами, которые получат доступ к той же модели с ослабленной модерацией и расширенными киберспособностями.
Выкованная в Европе. Построена для суверенитета AI
ML4 была обучена с нуля на 3800 NVIDIA Grace Blackwell GPU в собственных дата-центрах Mistral в Европе. Публичный предпросмотр обслуживается той же инфраструктурой. Это значимая веха в долгосрочных инвестициях компании в инфраструктуру, исследования и разработку продуктов: state-of-the-art производительность в критических вертикалях, доставляемая через open weights, разработанная для того, чтобы дать пользователям контроль над своим AI.
Это особенно важно в кибербезопасности, где отказы на уровне провайдера могут заблокировать законные исследования уязвимостей и реагирование на инциденты, а потеря доступа к способности посередине инцидента может сама стать критическим риском безопасности. ML4 объединяет первоклассную кибербезопасность с open weights и self-deployment, предоставляя организациям как способность, так и автономию для выполнения продвинутой безопасностной работы в соответствии со своей политикой.
Модель будет доступна в нескольких регионах по всему миру, включая европейское развёртывание, которое Mistral управляет end-to-end, независимо от других провайдеров цифровых услуг и в соответствии с европейским правом. Интересный факт: значительная доля данных обучения ML4 была многоязычной, охватывающей более 160 языков, включая все официальные языки Европейского союза.
Работали в тесном сотрудничестве с ведущими предприятиями по всему миру в финансах, инженерии, производстве, логистике, фармацевтике, науке, судоходстве, государственном секторе и других критически важных отраслях для обучения ML4. На самом деле, модель использует тот же процесс обучения, кастомизации и RL-окружение, которое предлагается клиентам через Mistral Forge.
Попробуйте сегодня
Впереди ещё много. По мере продвижения к выпуску весов будут поделиться дополнительными деталями об архитектуре модели, дополнительными бенчмарками и методологией post-training.
Эта модель также послужит основой для нового поколения специализированных и оптимизированных моделей Mistral. Пока что приглашаем попробовать предпросмотр API и поделиться отзывом в социальных сетях.
Глубокий разбор возможностей
Кибербезопасность
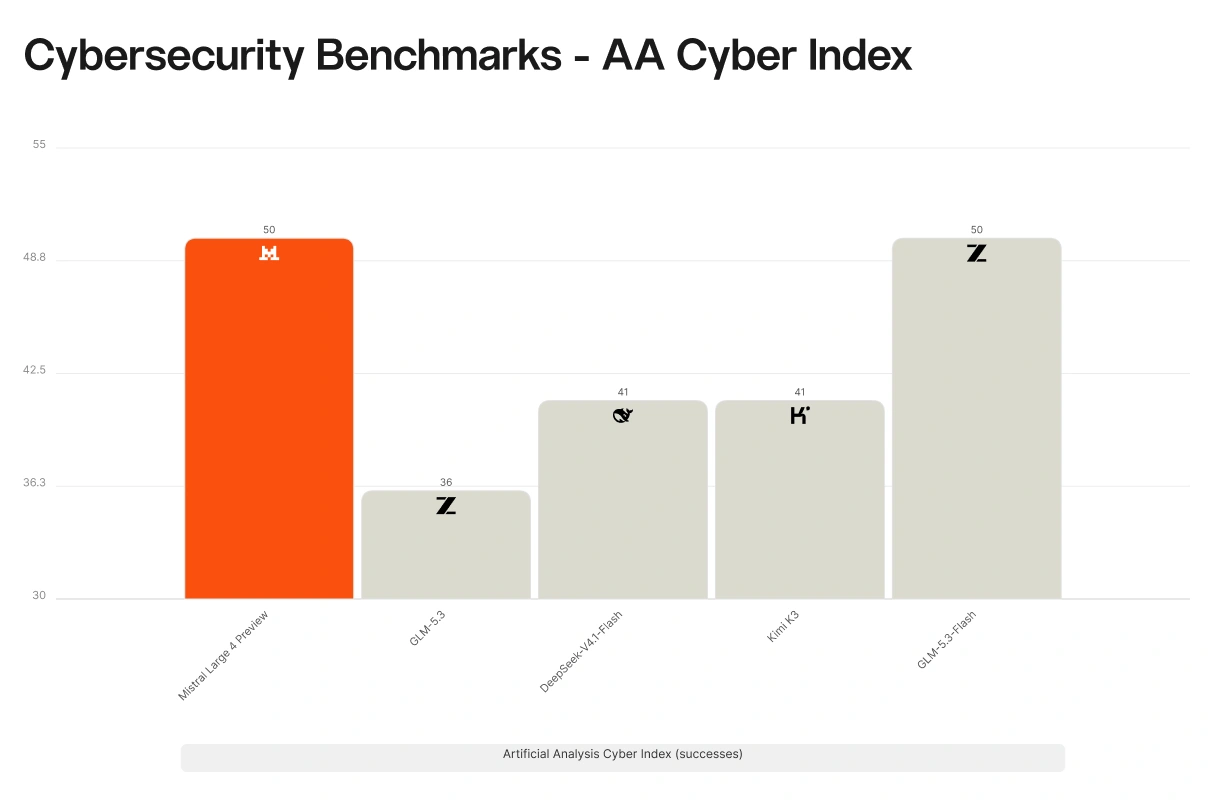
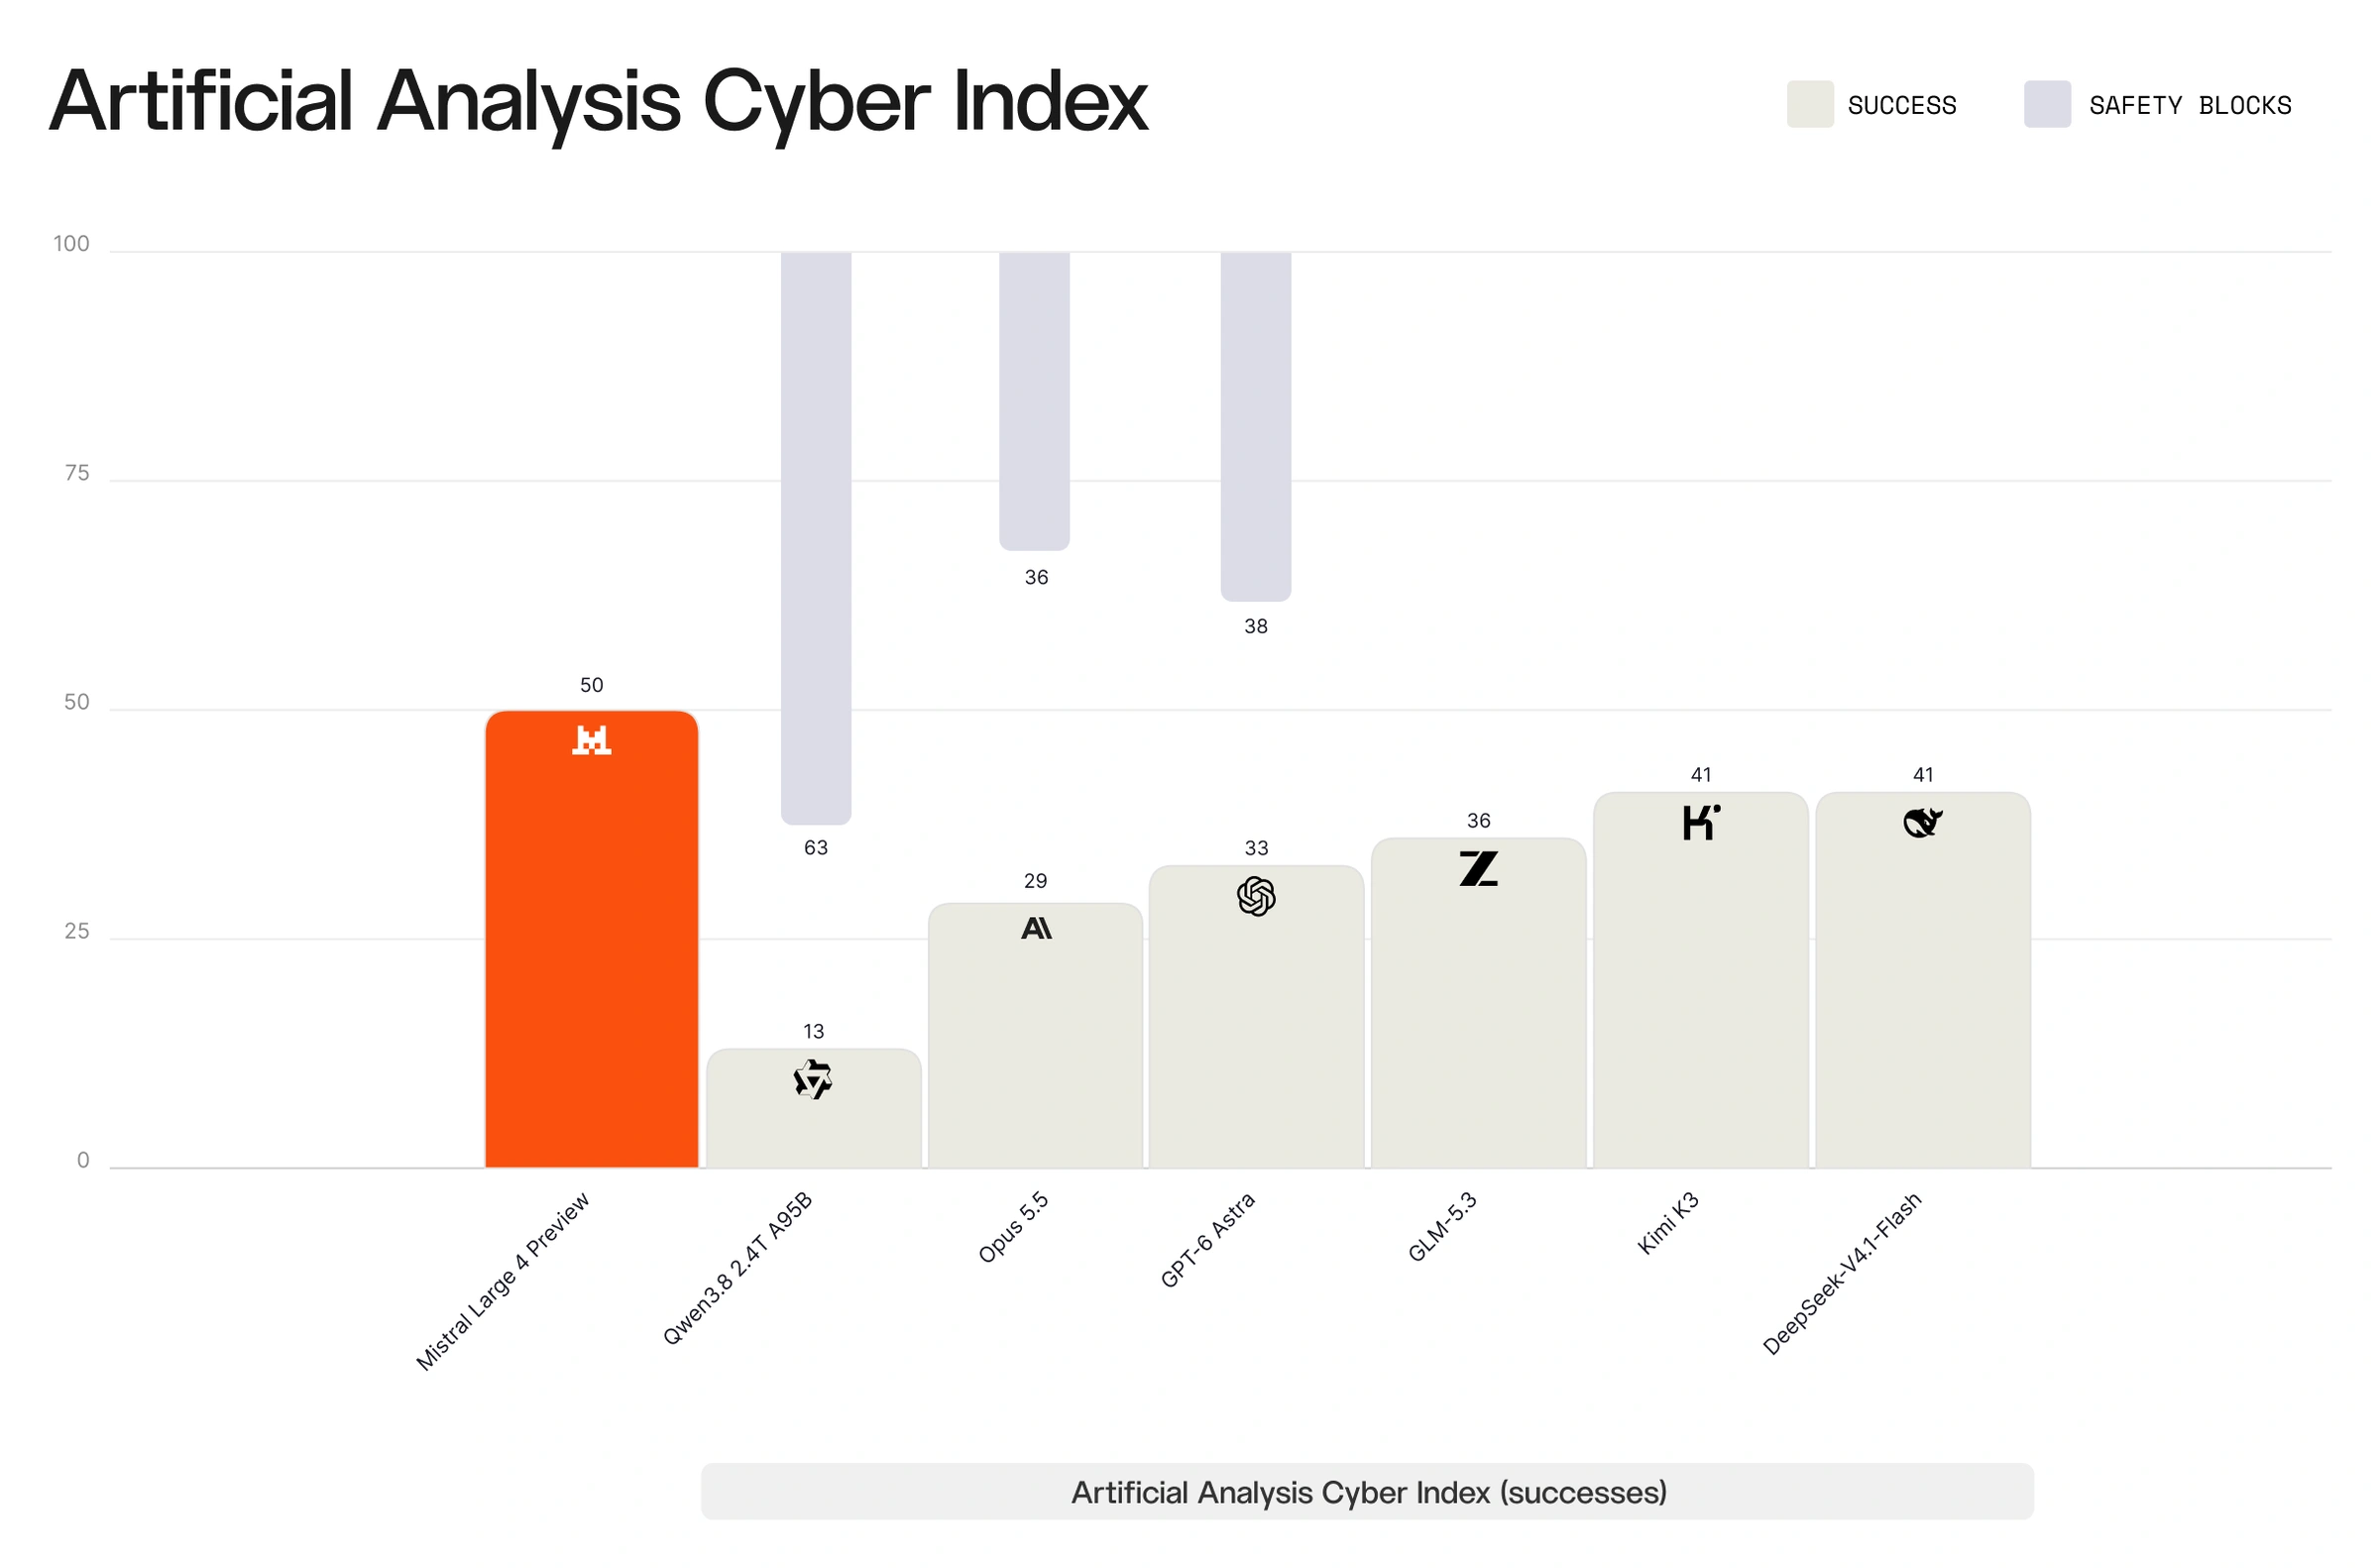
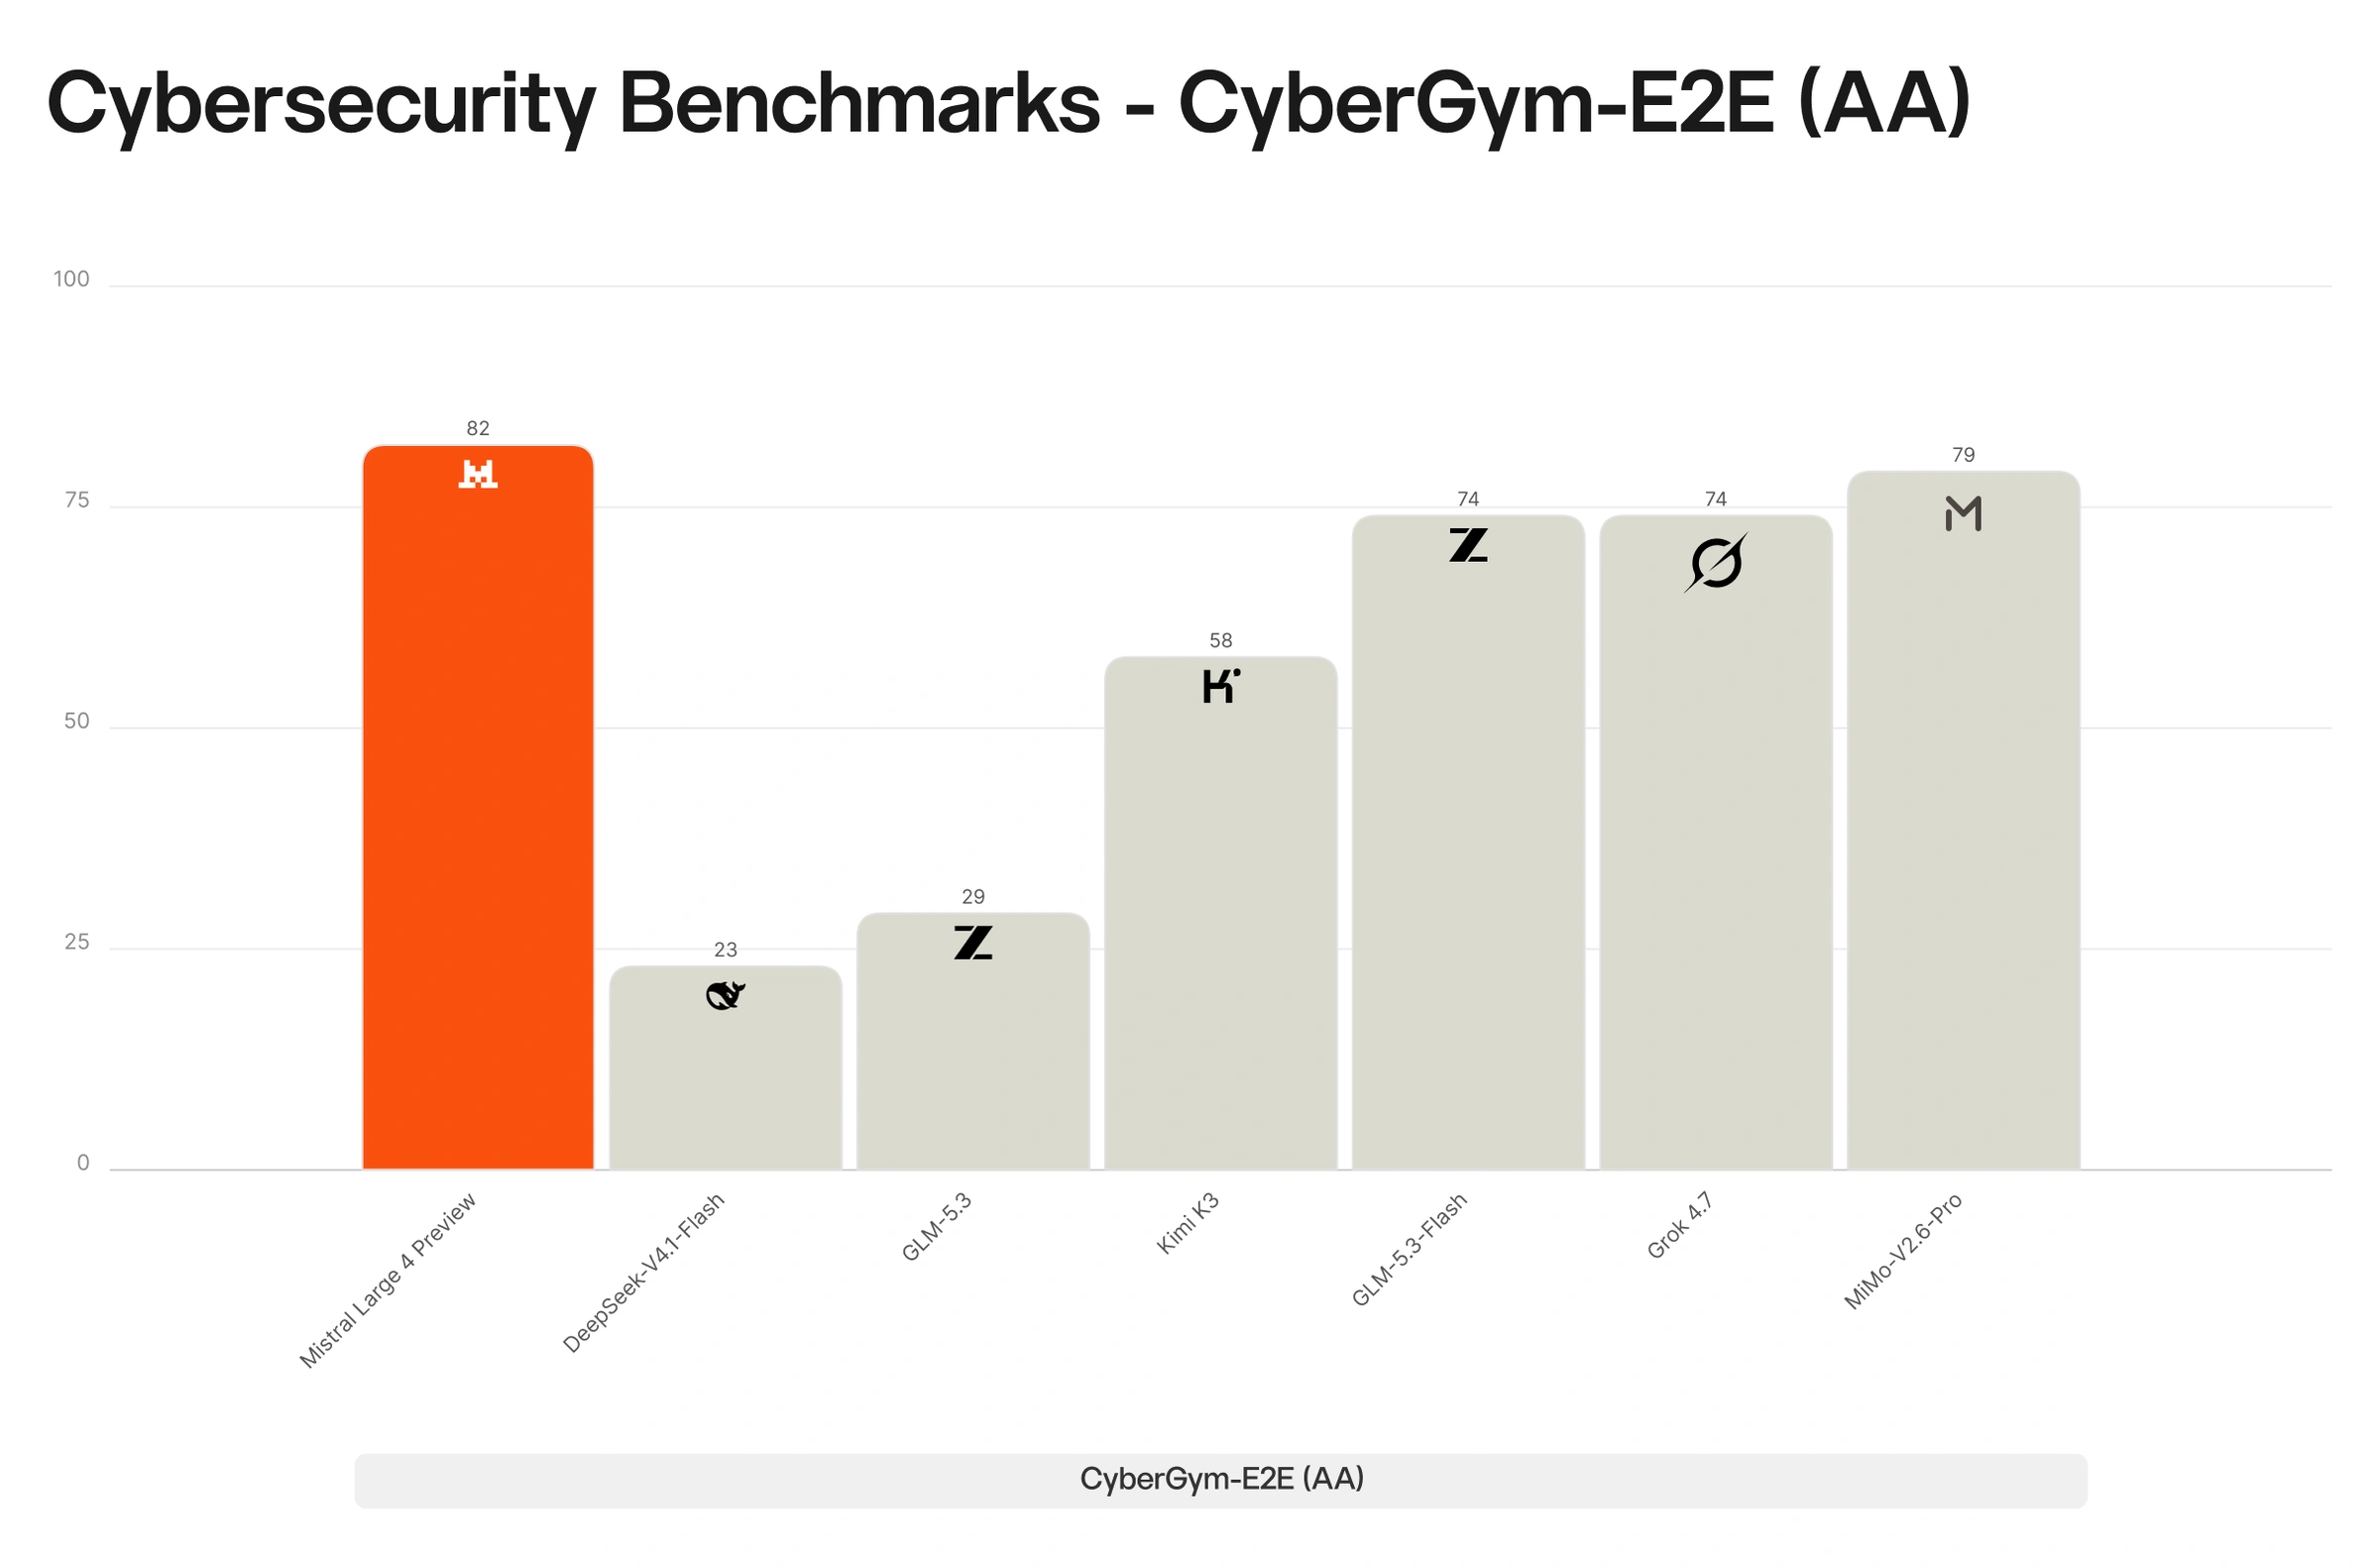
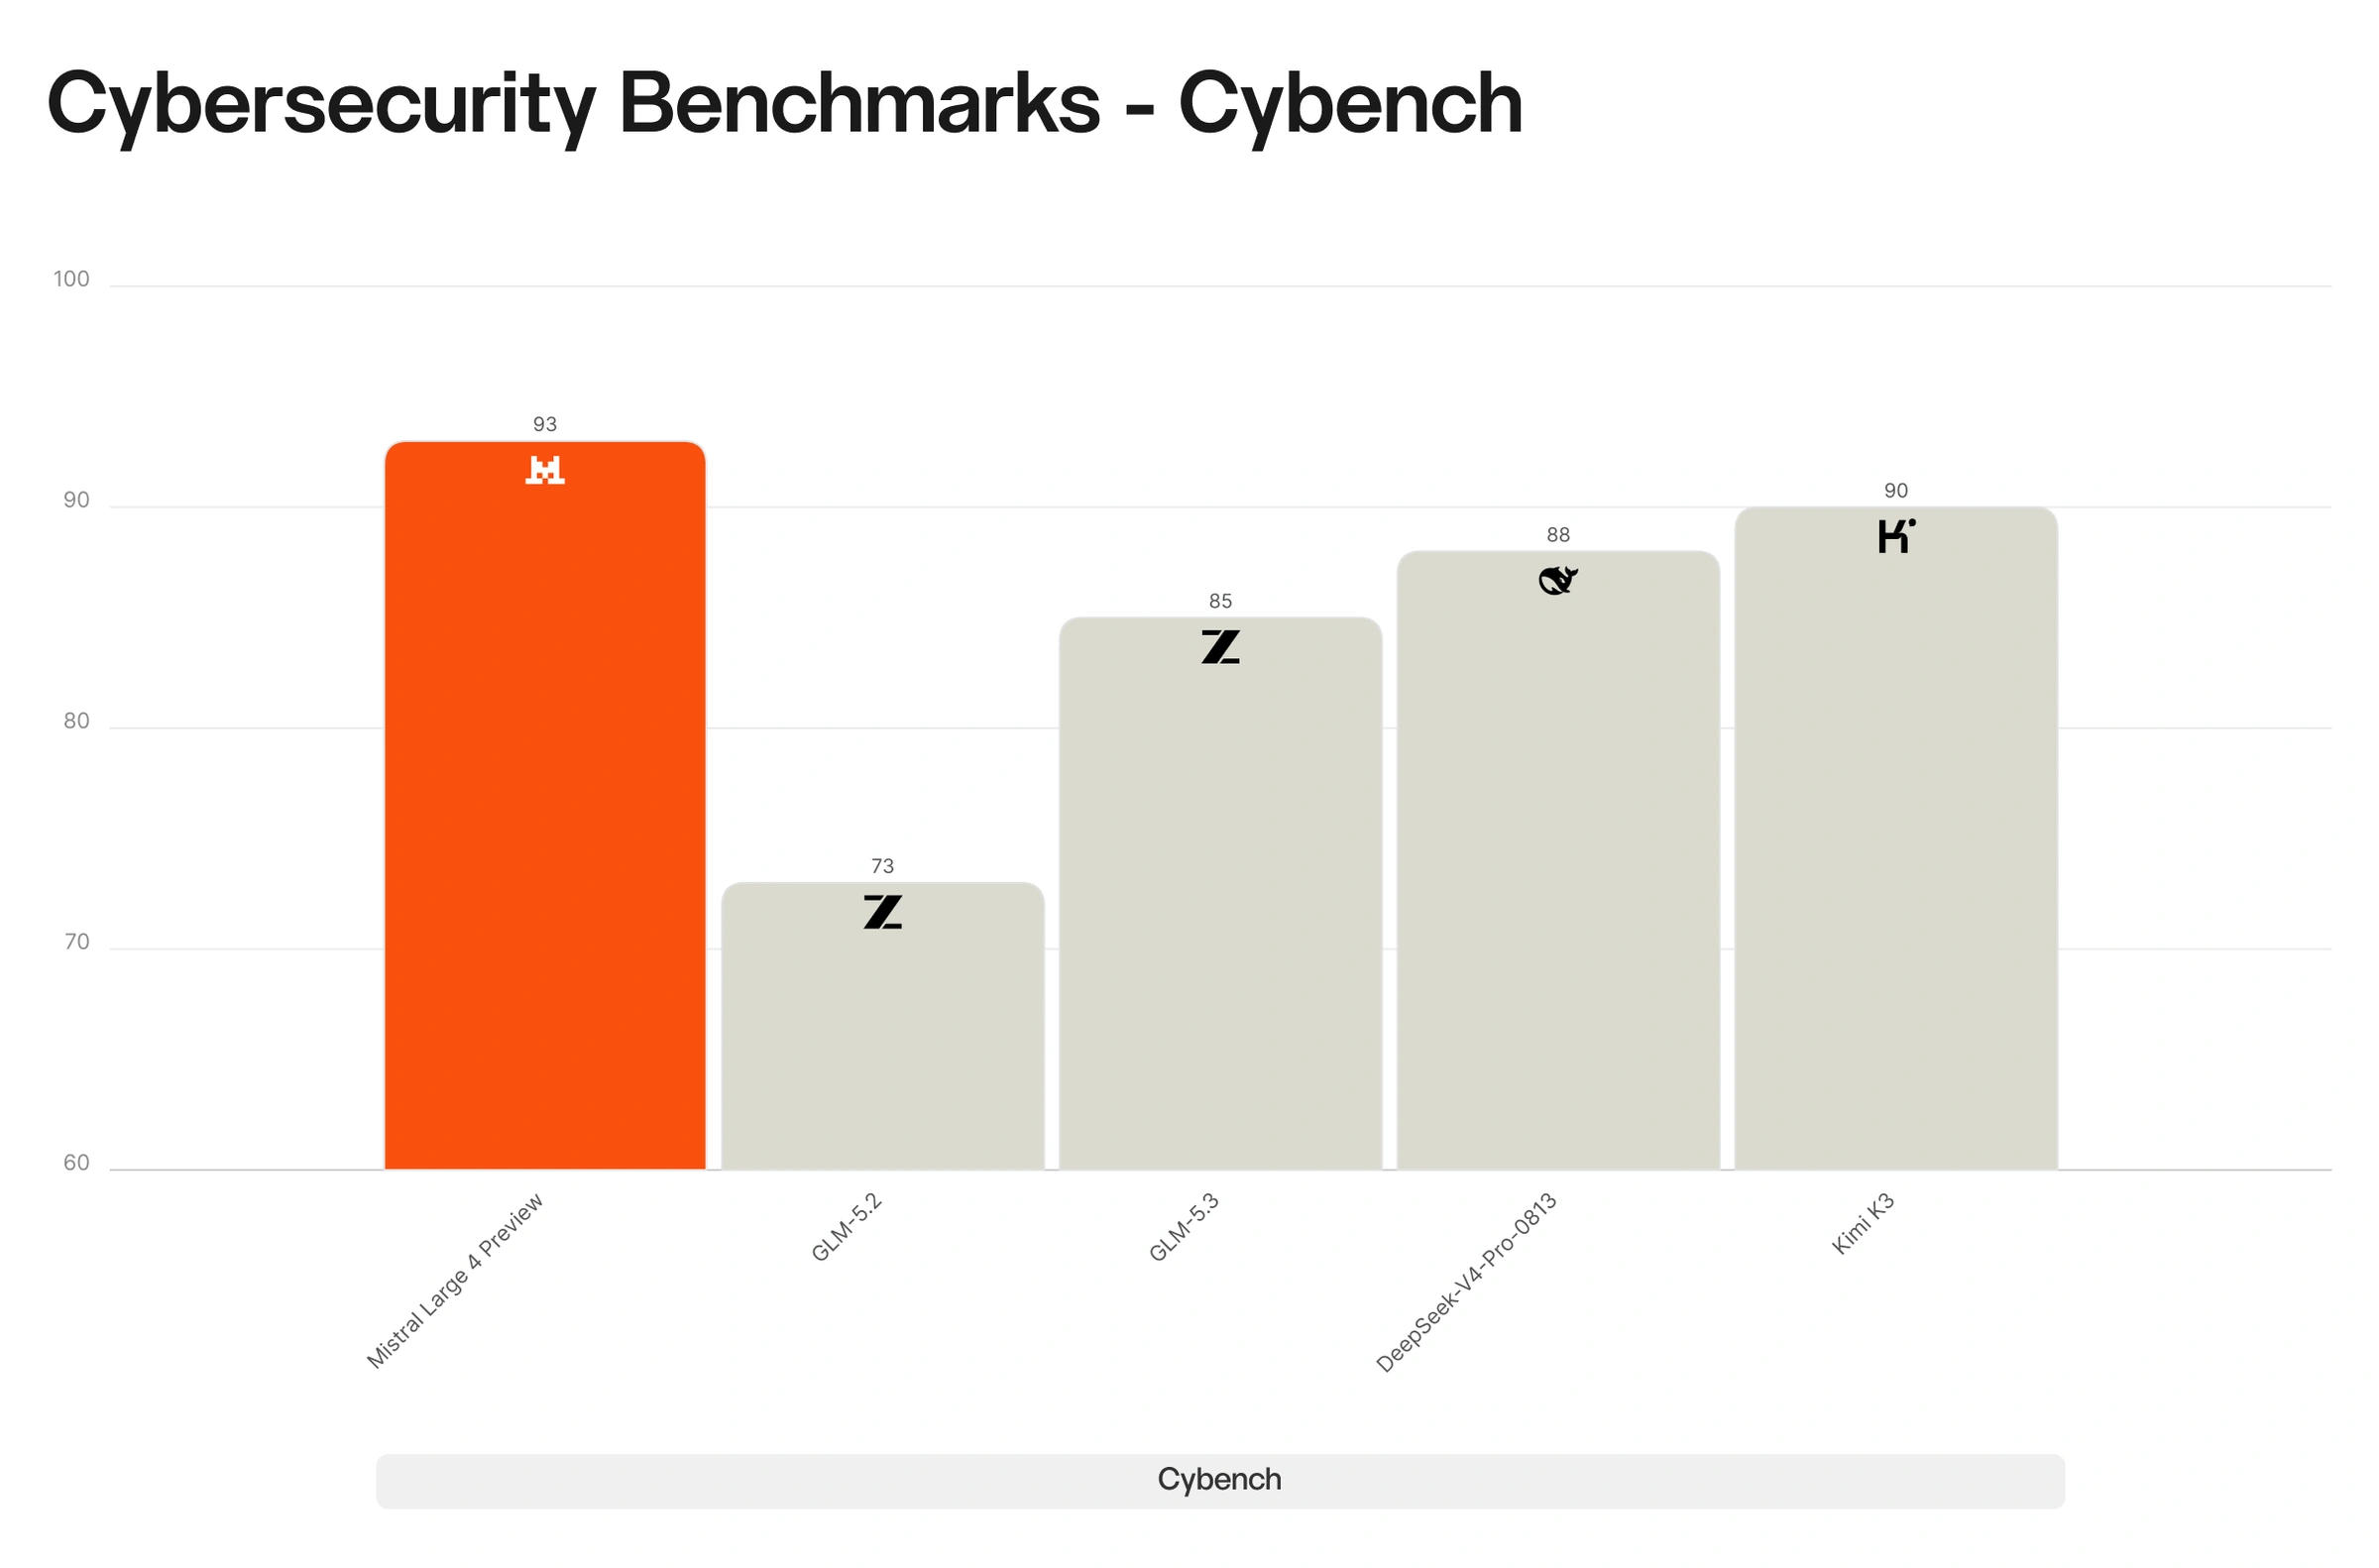
ML4 — одна из самых сильных AI моделей в мире для кибербезопасности. На Artificial Analysis Cyber Index, независимой оценке того, насколько хорошо AI модели находят и исправляют уязвимости безопасности в реальном ПО, она входит в топ-пять моделей глобально и лидирует среди open-weight моделей, разработанных вне Китая, с большим отрывом. На одном из тестов индекса, который просит модель воспроизвести реальную уязвимость в open-source ПО, а затем её исправить, ML4 набирает 82% — максимум среди всех моделей. Также решает 93% заданий в Cybench — наборе из 40 упражнений из соревнований по безопасности, что является одним из самых высоких результатов для open-weight модели.
Этот топ-результат отражает практическое преимущество. Несколько ведущих closed моделей, включая Claude Opus 5.5 и GPT-6 Astra, набирают близко к нулю на том же тесте, потому что отказываются выполнять задачу. Однако защита ПО часто начинается с доказательства того, что недостаток реален — именно то, что фильтры безопасности в closed моделях могут блокировать. Это ещё важнее, поскольку угрозы всё чаще взламывают эти же модели для поддержки наступательной киберактивности: защитникам нужны системы, которые могут соответствовать этим способностям без той же модерации. ML4 может проделать эту работу, и её способности расширяются за пределы того, на что она была явно обучена: во внутреннем тестировании она оказалась полезной для анализа вредоноса, приоритизации уязвимостей и написания правил обнаружения. Для организаций, которым нужен суверенный, проверяемый AI для операций безопасности, она сможет работать на приватном облаке или on-premise.
Агентическое кодирование
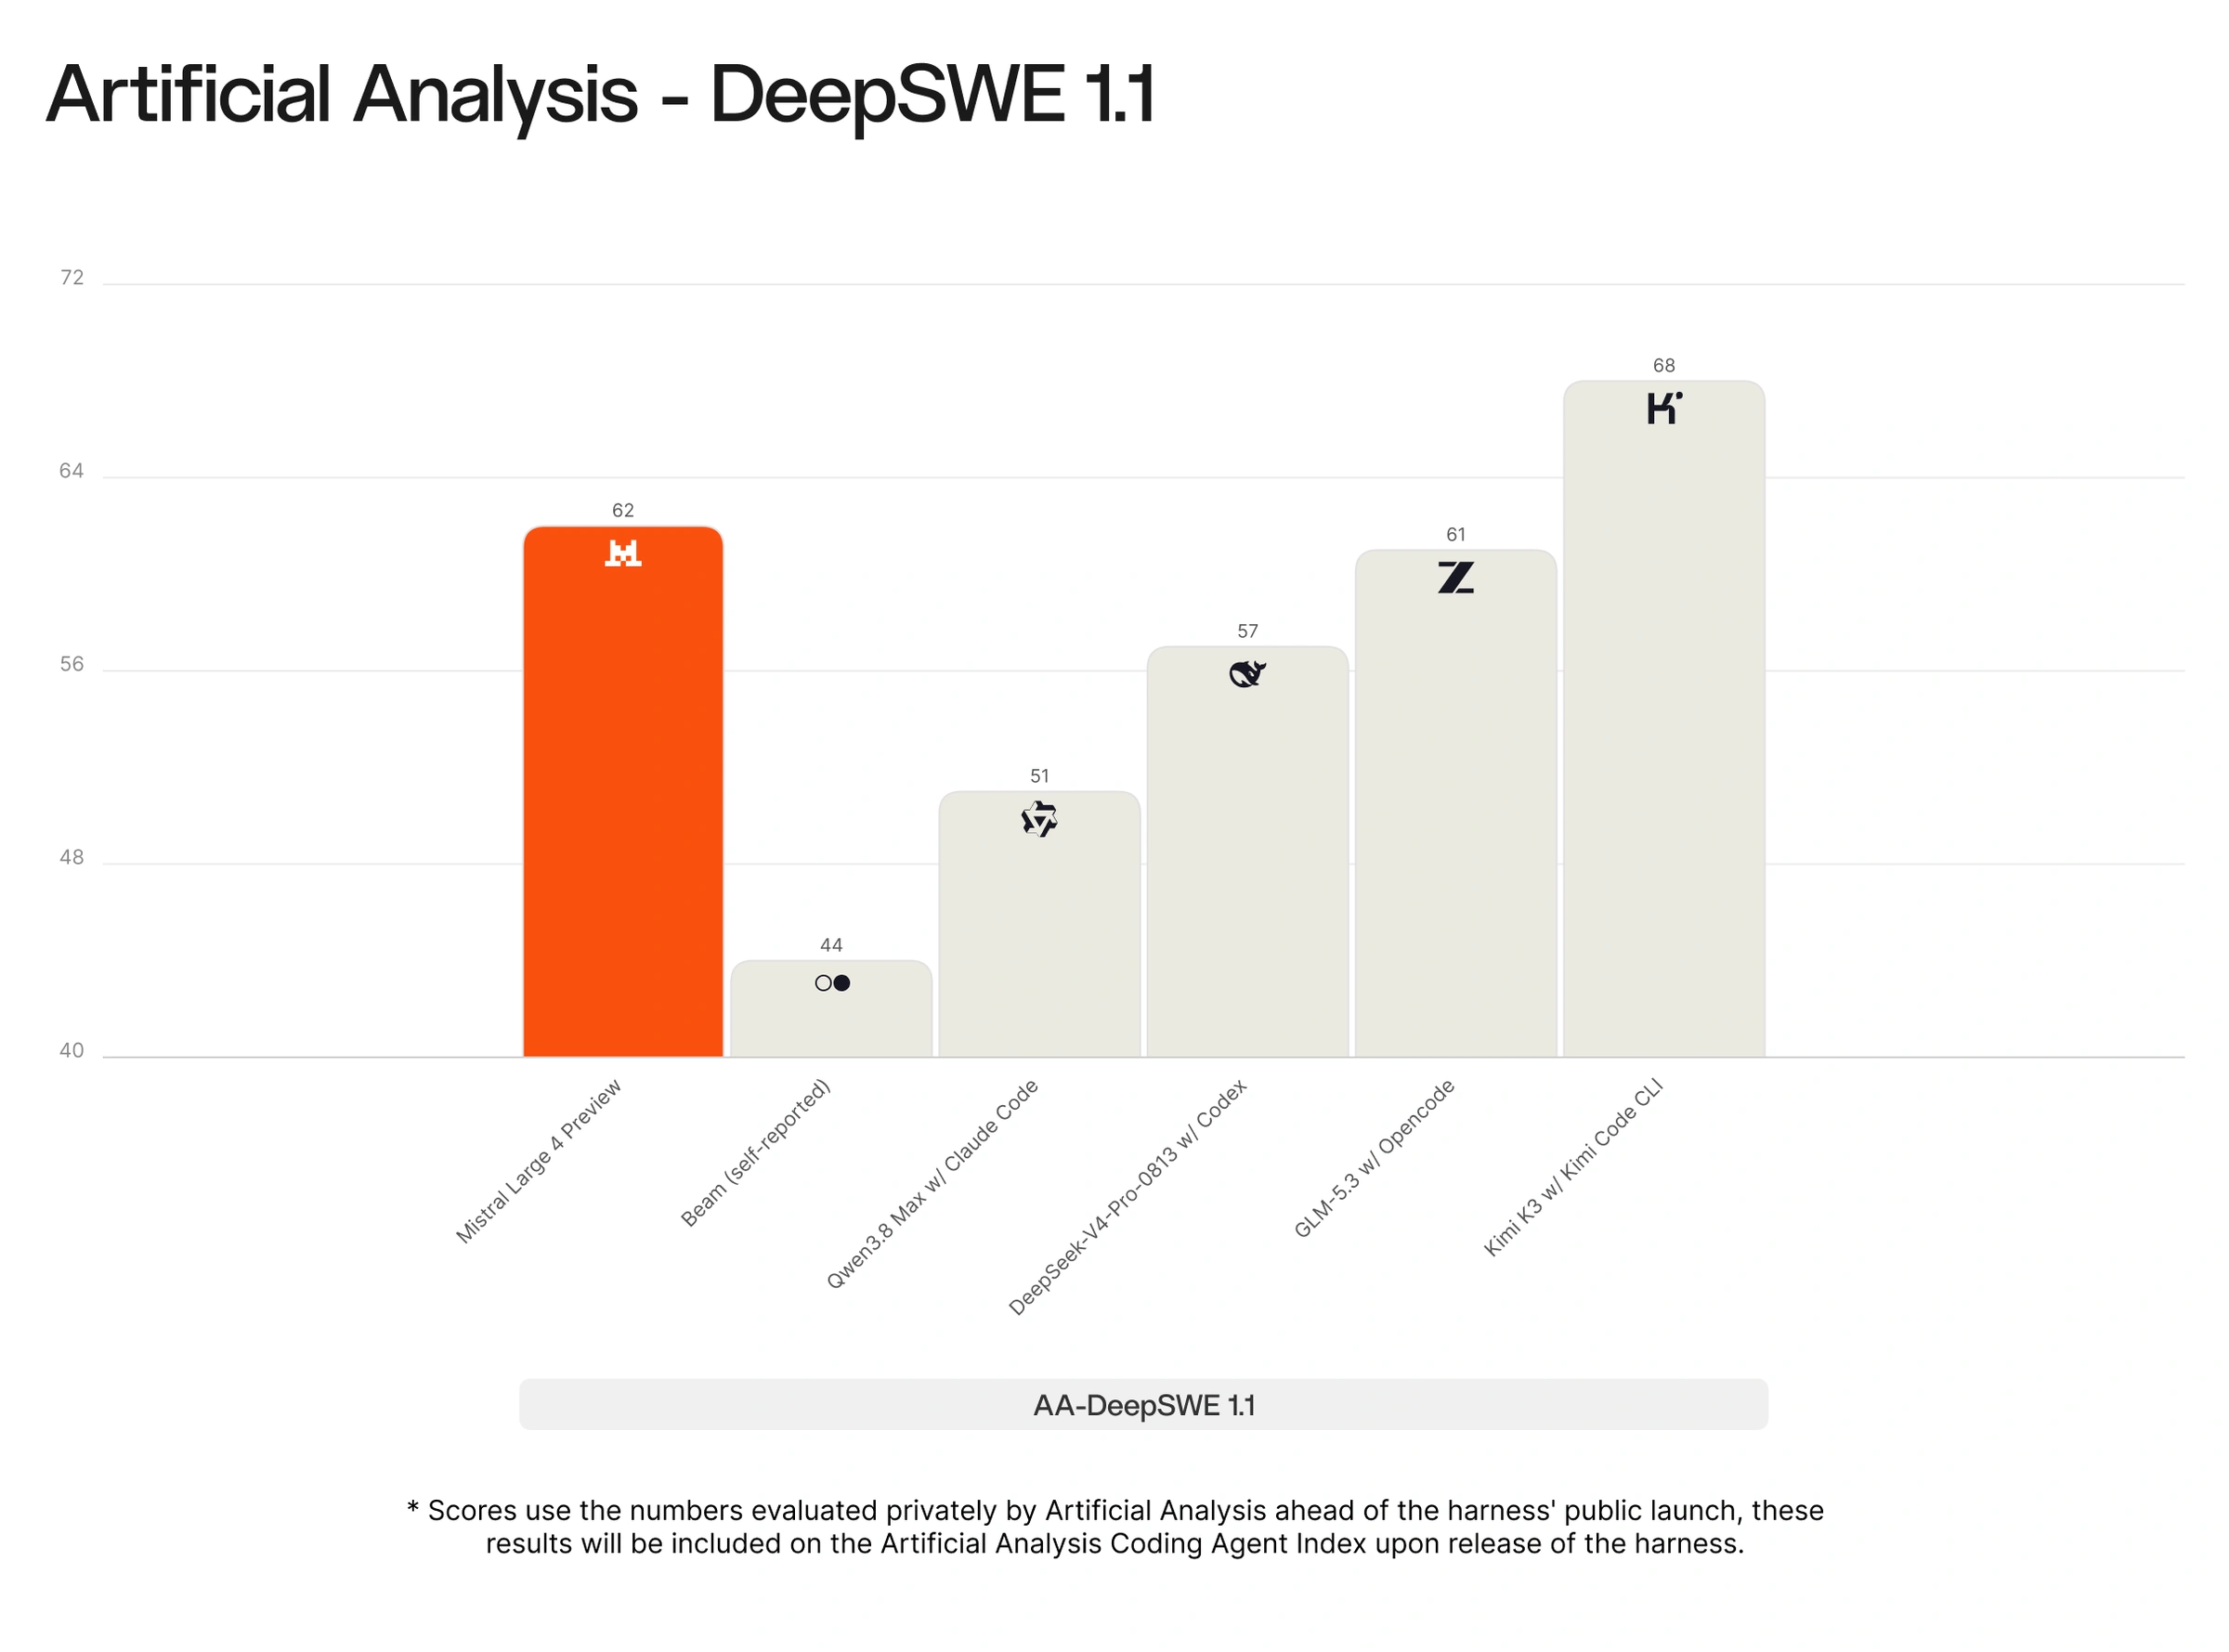
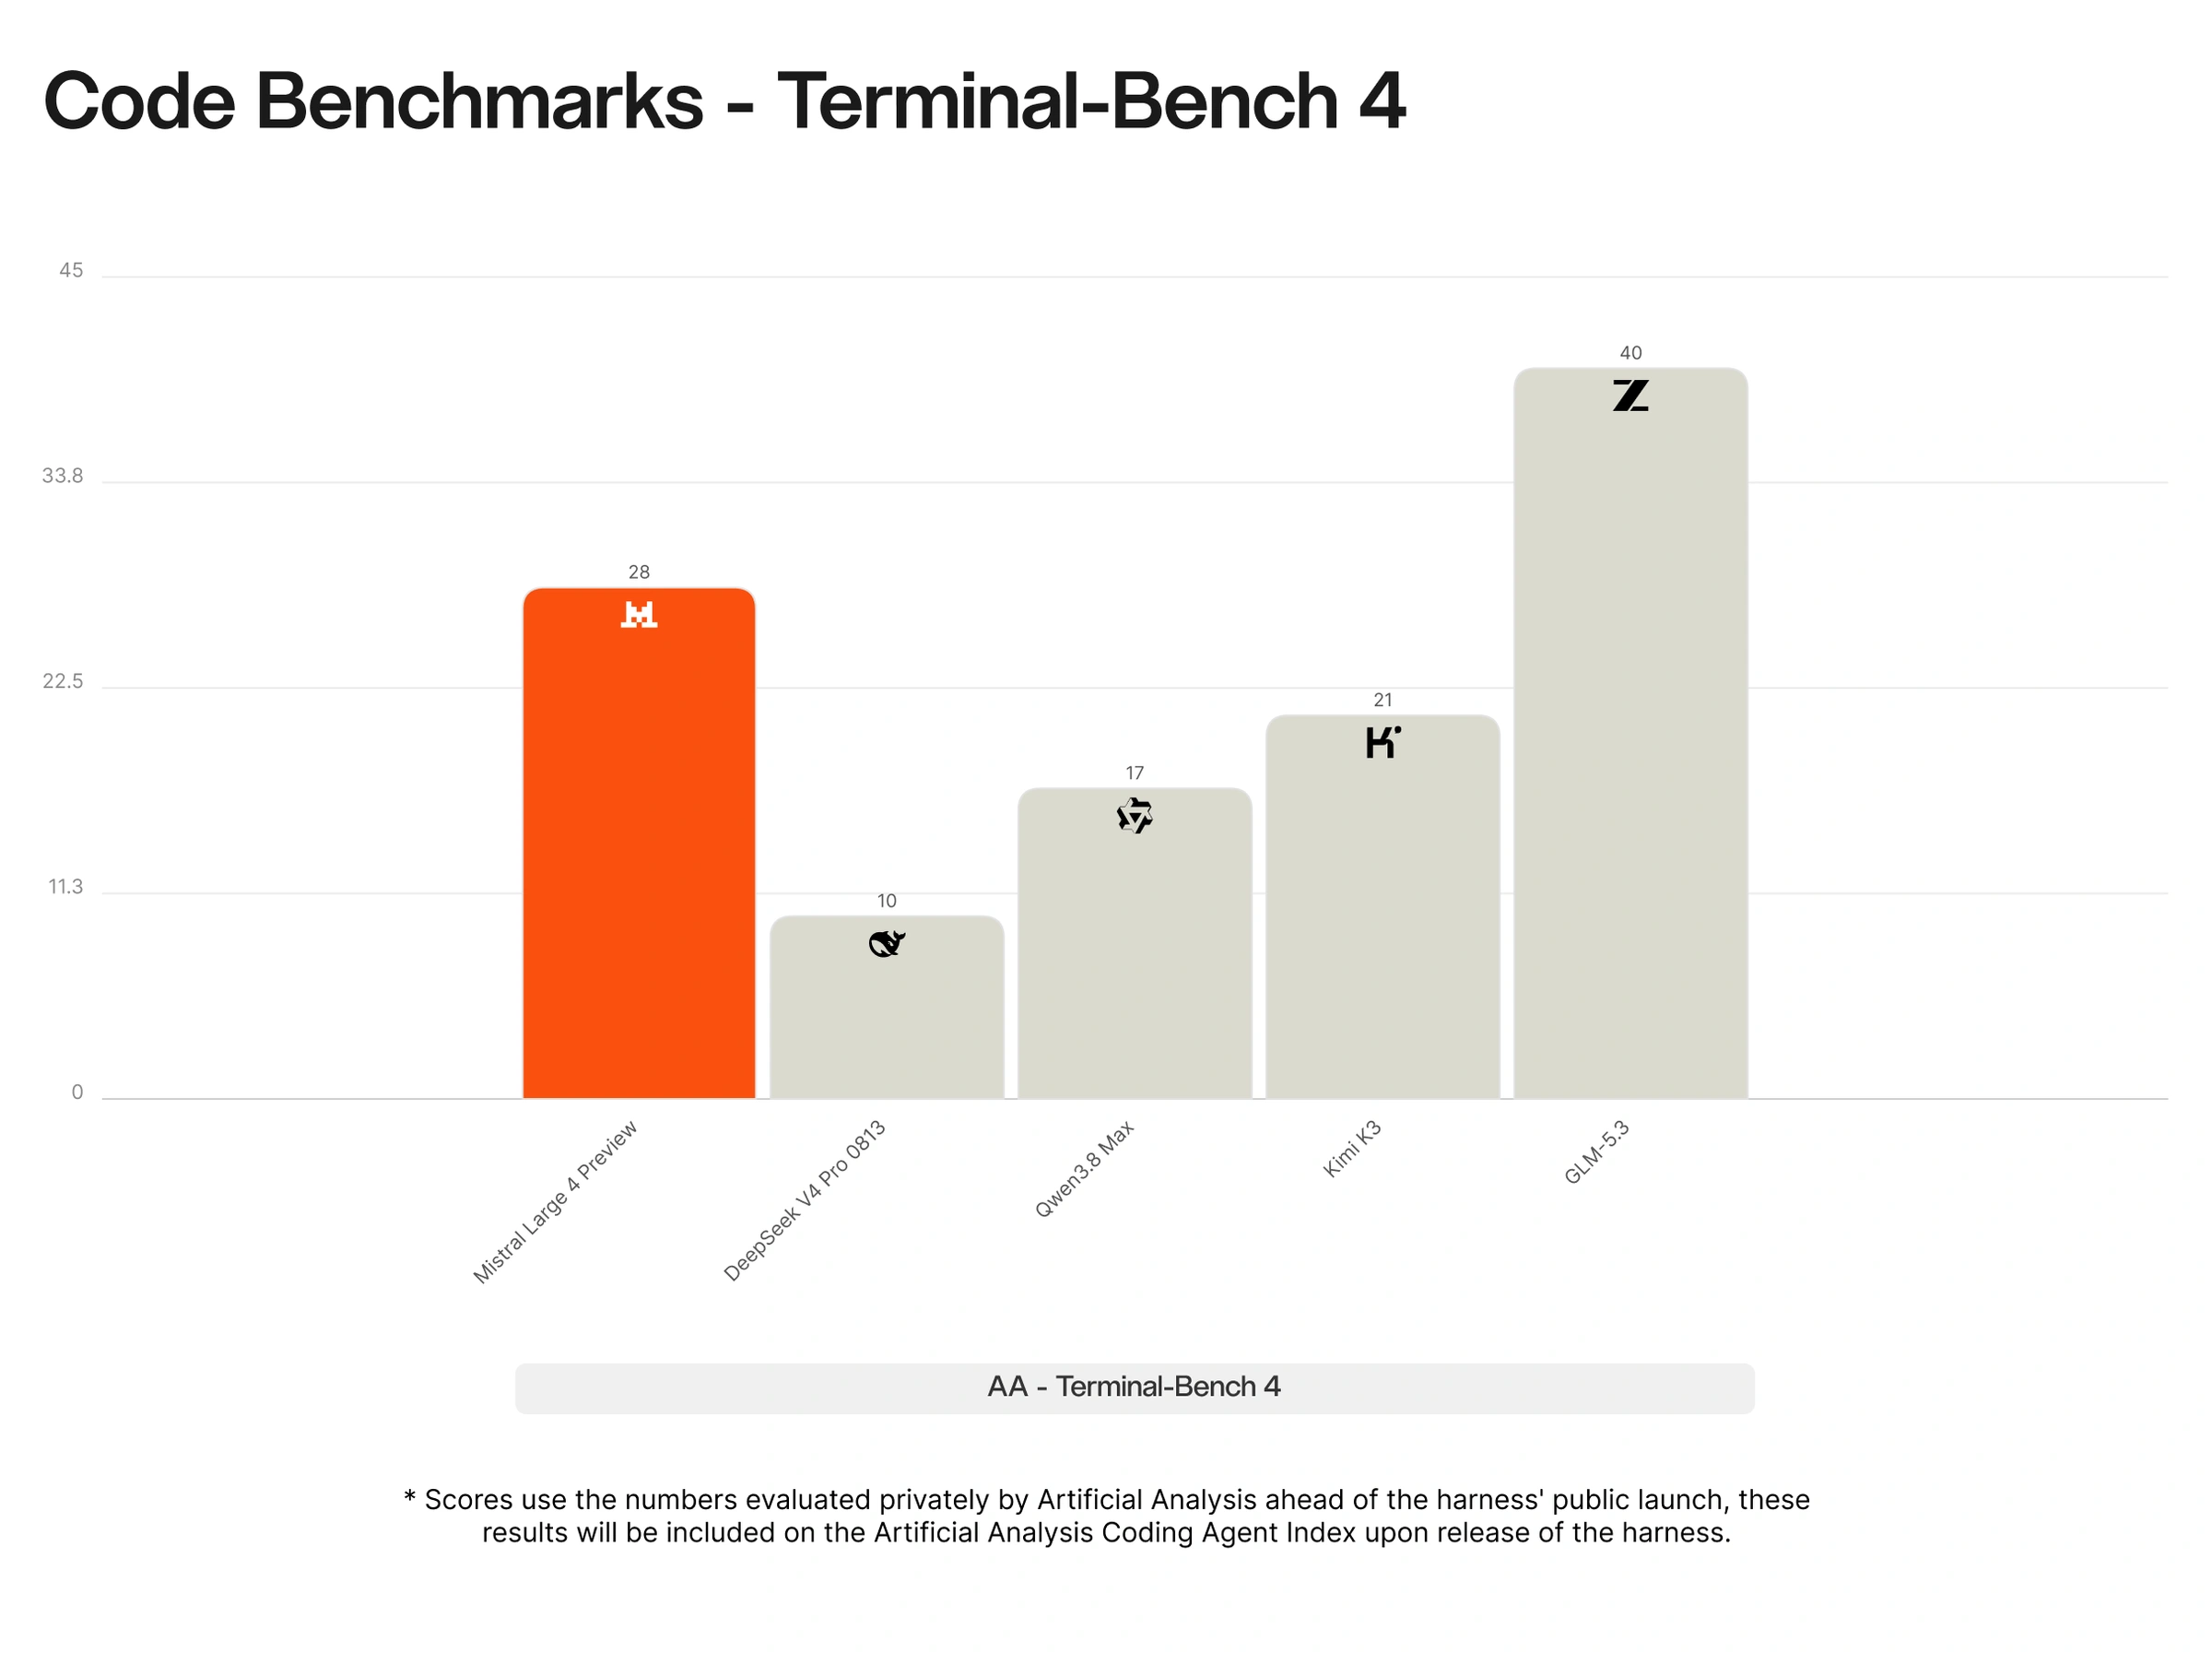
ML4 превосходна в инженерии ПО, понимании репозитория и сложных терминальных рабочих процессах, набирая 61,7% на DeepSWE v1.1, 59,4% на SWE-Atlas-QnA и 28,3% на Terminal-Bench 4. Её комбинированный Coding Agent Index результат в 49,8% ставит её впереди DeepSeek V4 Pro 0813 и Qwen3.8 Max.
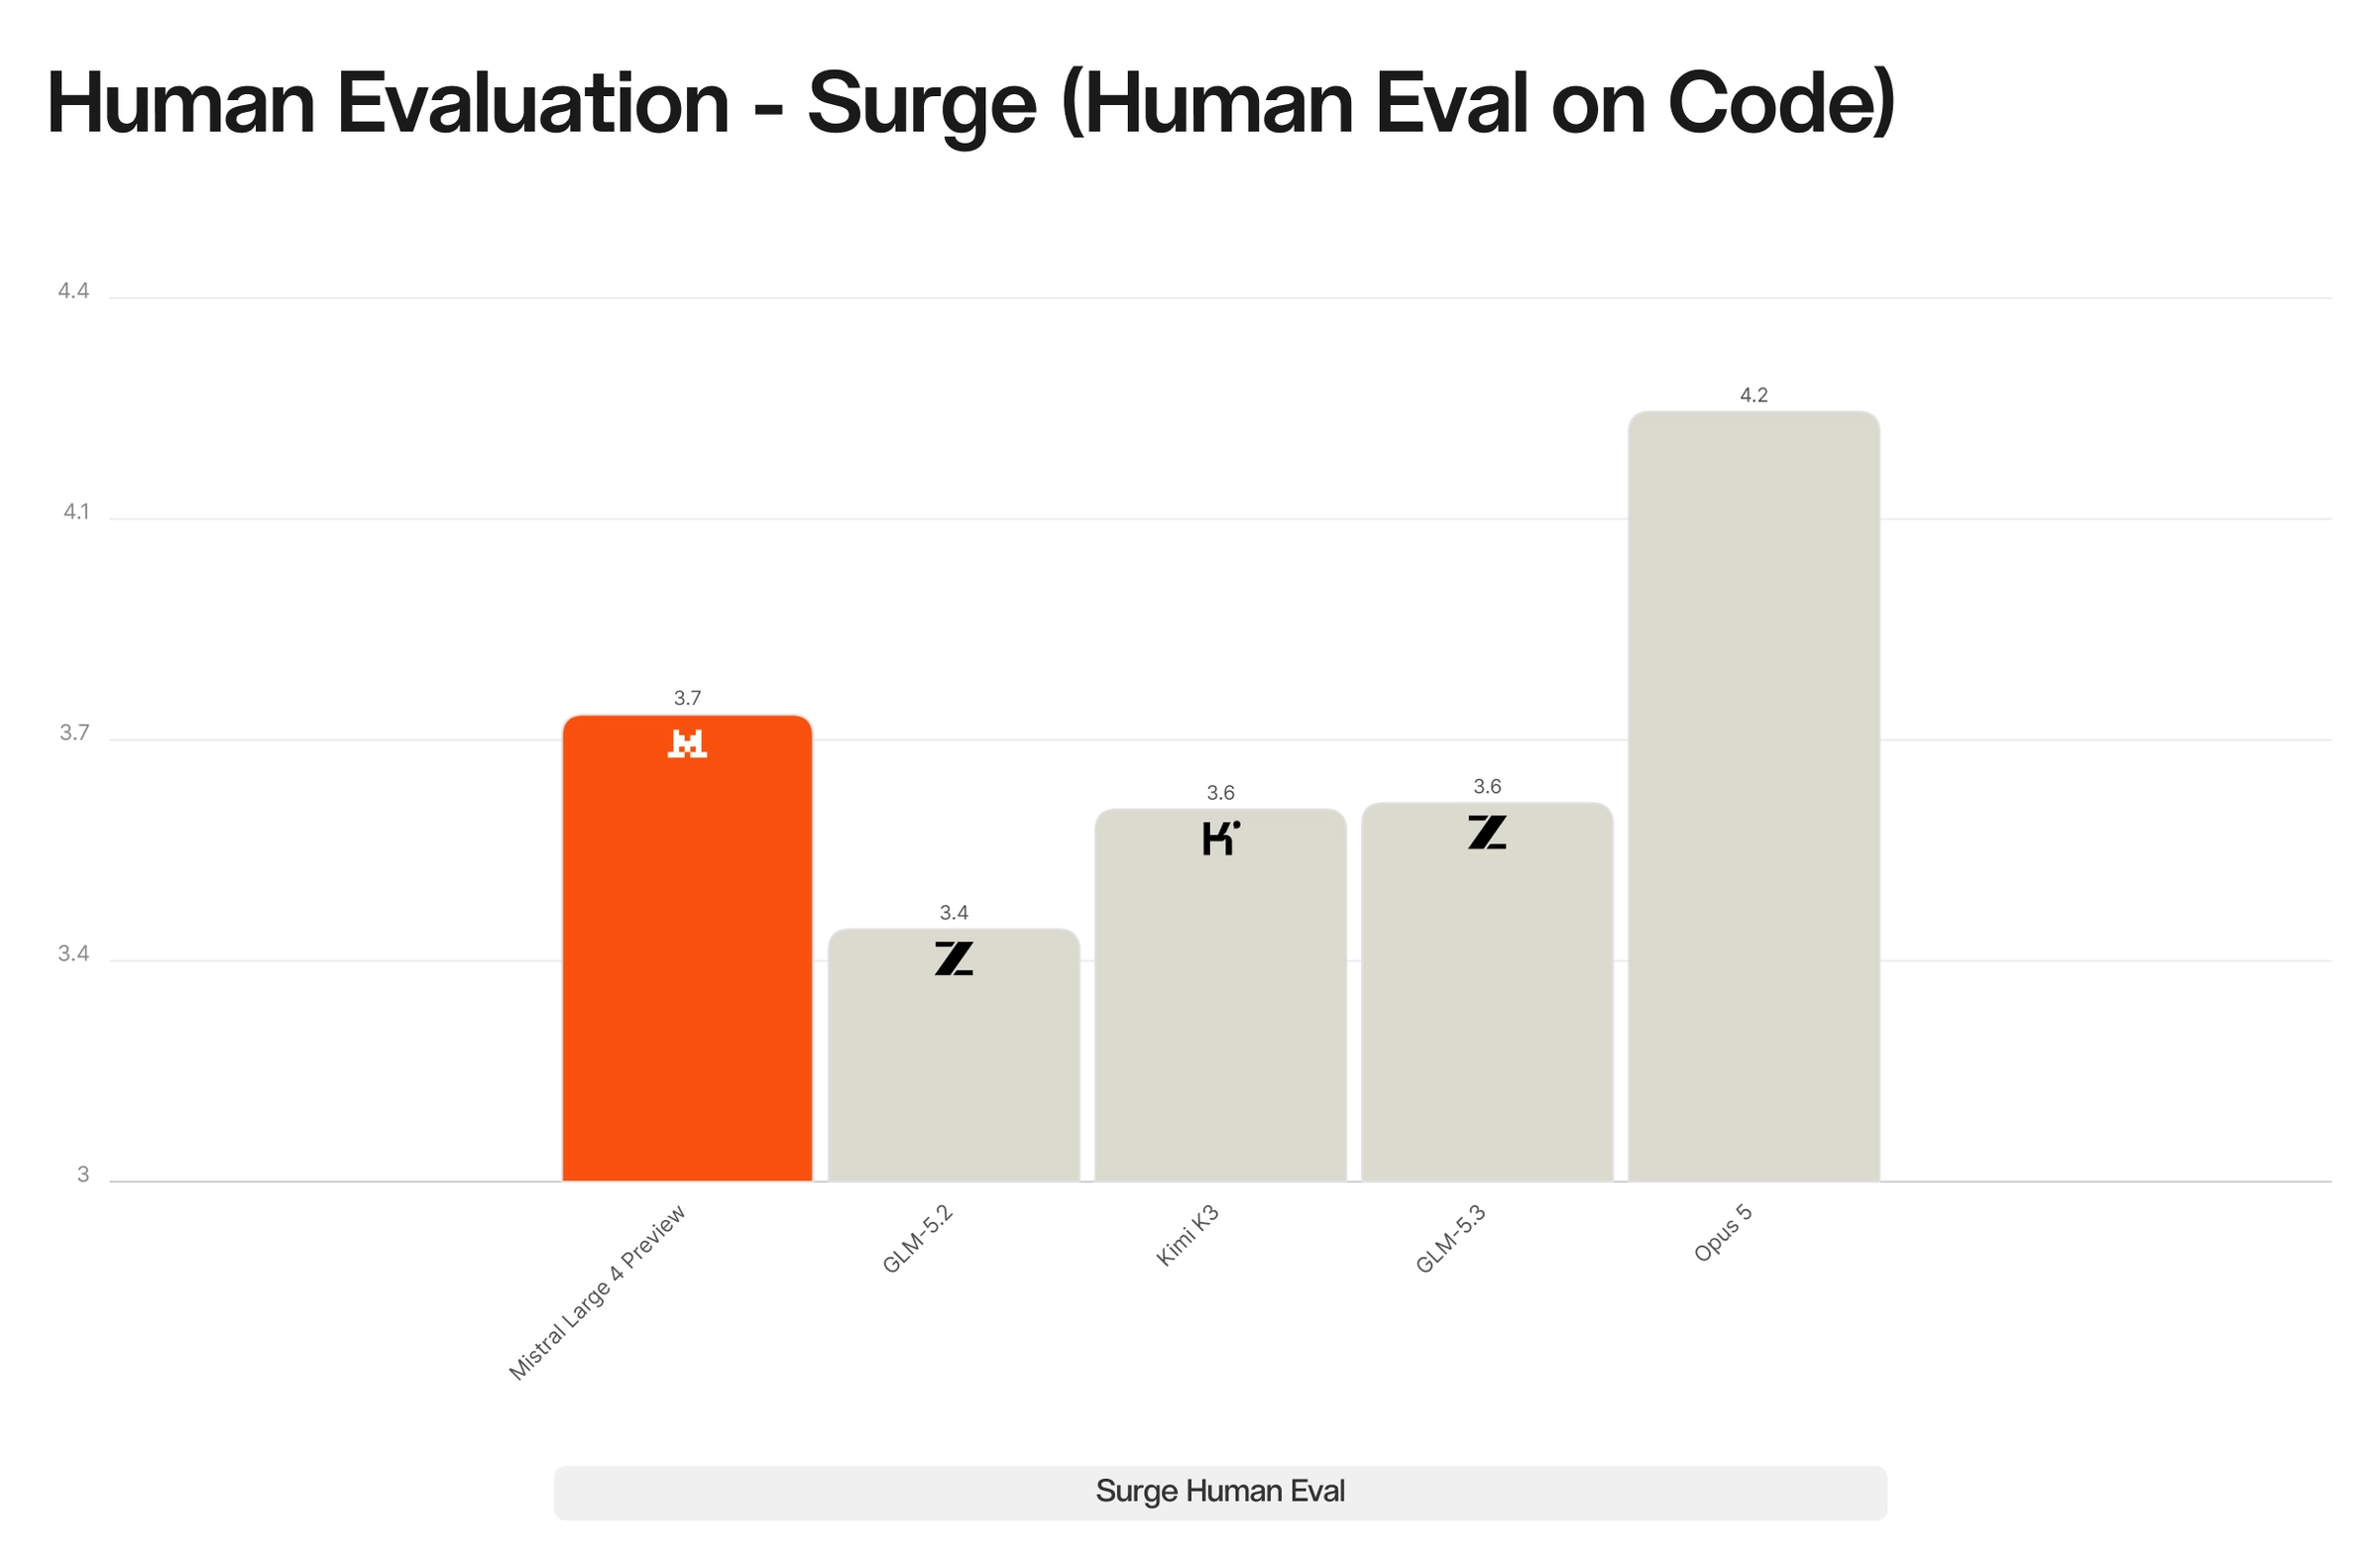
Также провели слепую оценку качества кода с Surge AI: профессиональные аннотаторы оценивали результаты моделей по шкале 1–5, с скрытыми идентификациями моделей. ML4 Preview занял второе место из пяти моделей (3.74), впереди Kimi K3 (3.59), GLM-5.3 (3.60) и GLM-5.2 (3.40), и позади только Claude Opus 5 (4.22).
Агентические рабочие процессы
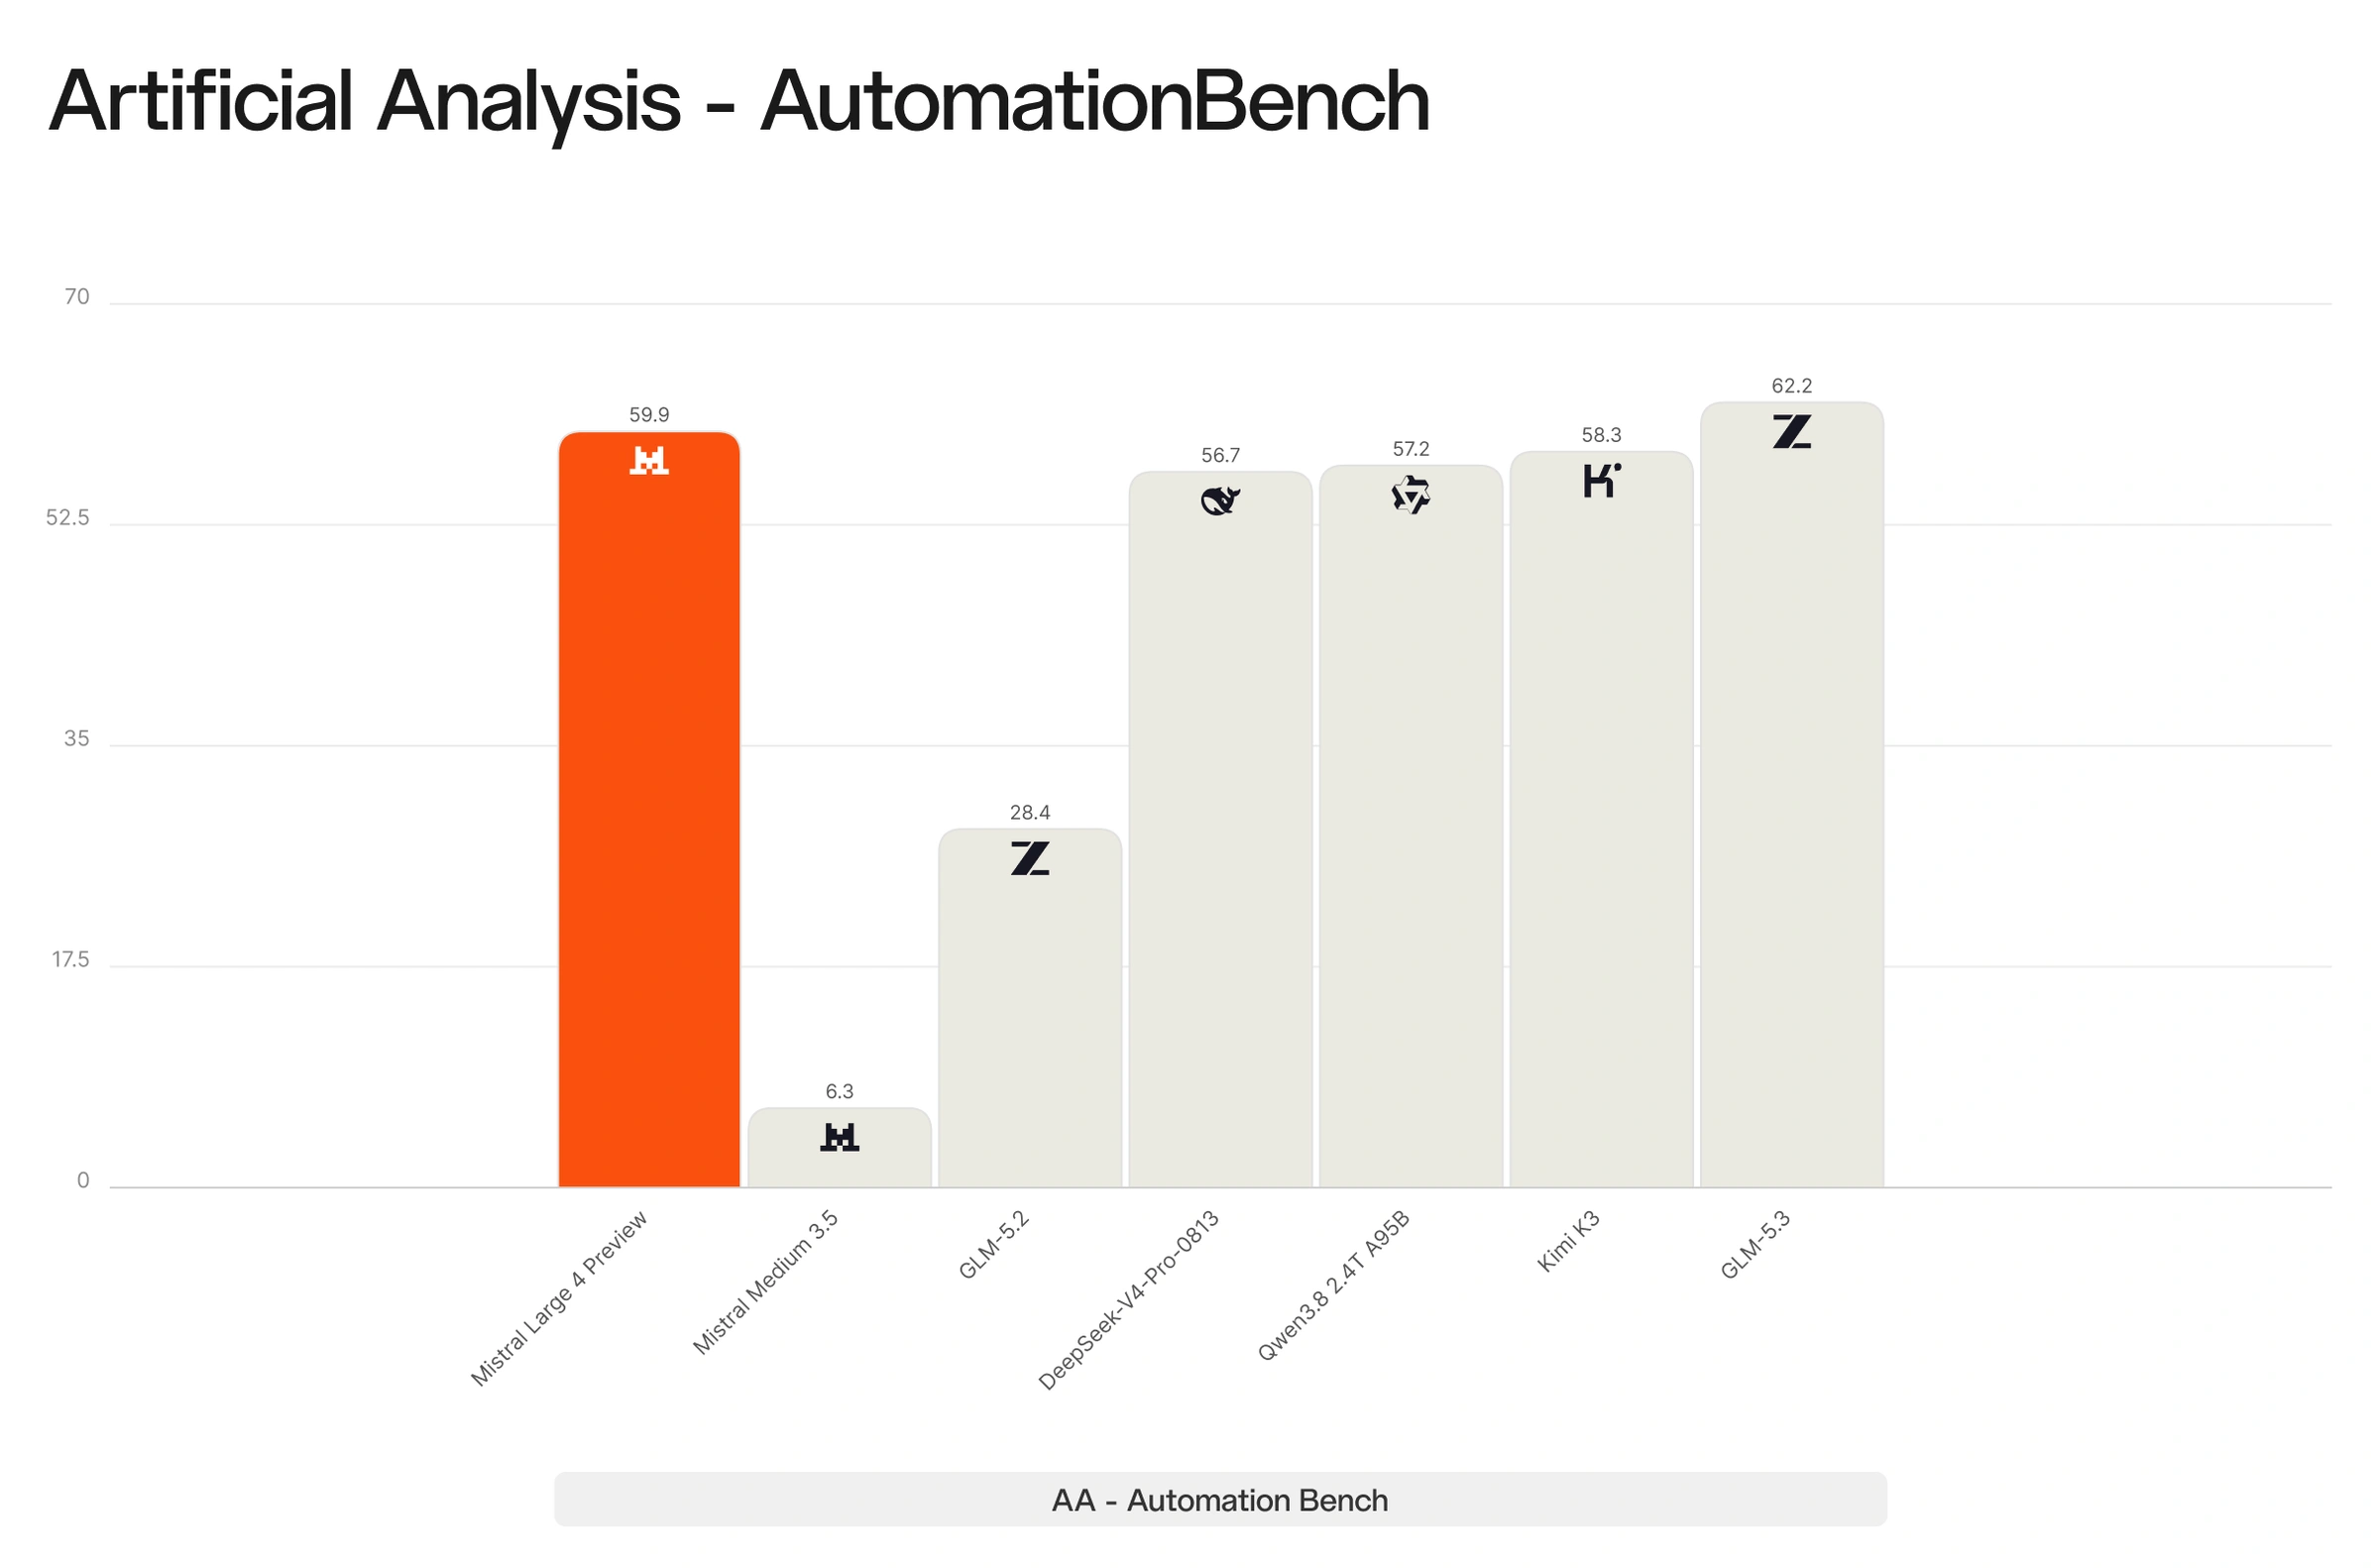
ML4 запускает general-purpose агентов, которые собирают информацию, используют инструменты и создают готовые результаты через сложные рабочие процессы. На AutomationBench — 657 бизнес-рабочих процессах через приложения вроде Gmail, Google Sheets, Slack и Salesforce — она набирает 59,9%, впереди Kimi K3, MiMo-V2.6-Pro и DeepSeek V4 Pro.
Она одинаково сильна в профессиональных результатах, которые производит knowledge work: электронные таблицы, слайды и PDF. На AA-Briefcase, которая оценивает long-horizon knowledge work, она достигает 1393 Elo, впереди DeepSeek V4 Pro.
Мультимодальность
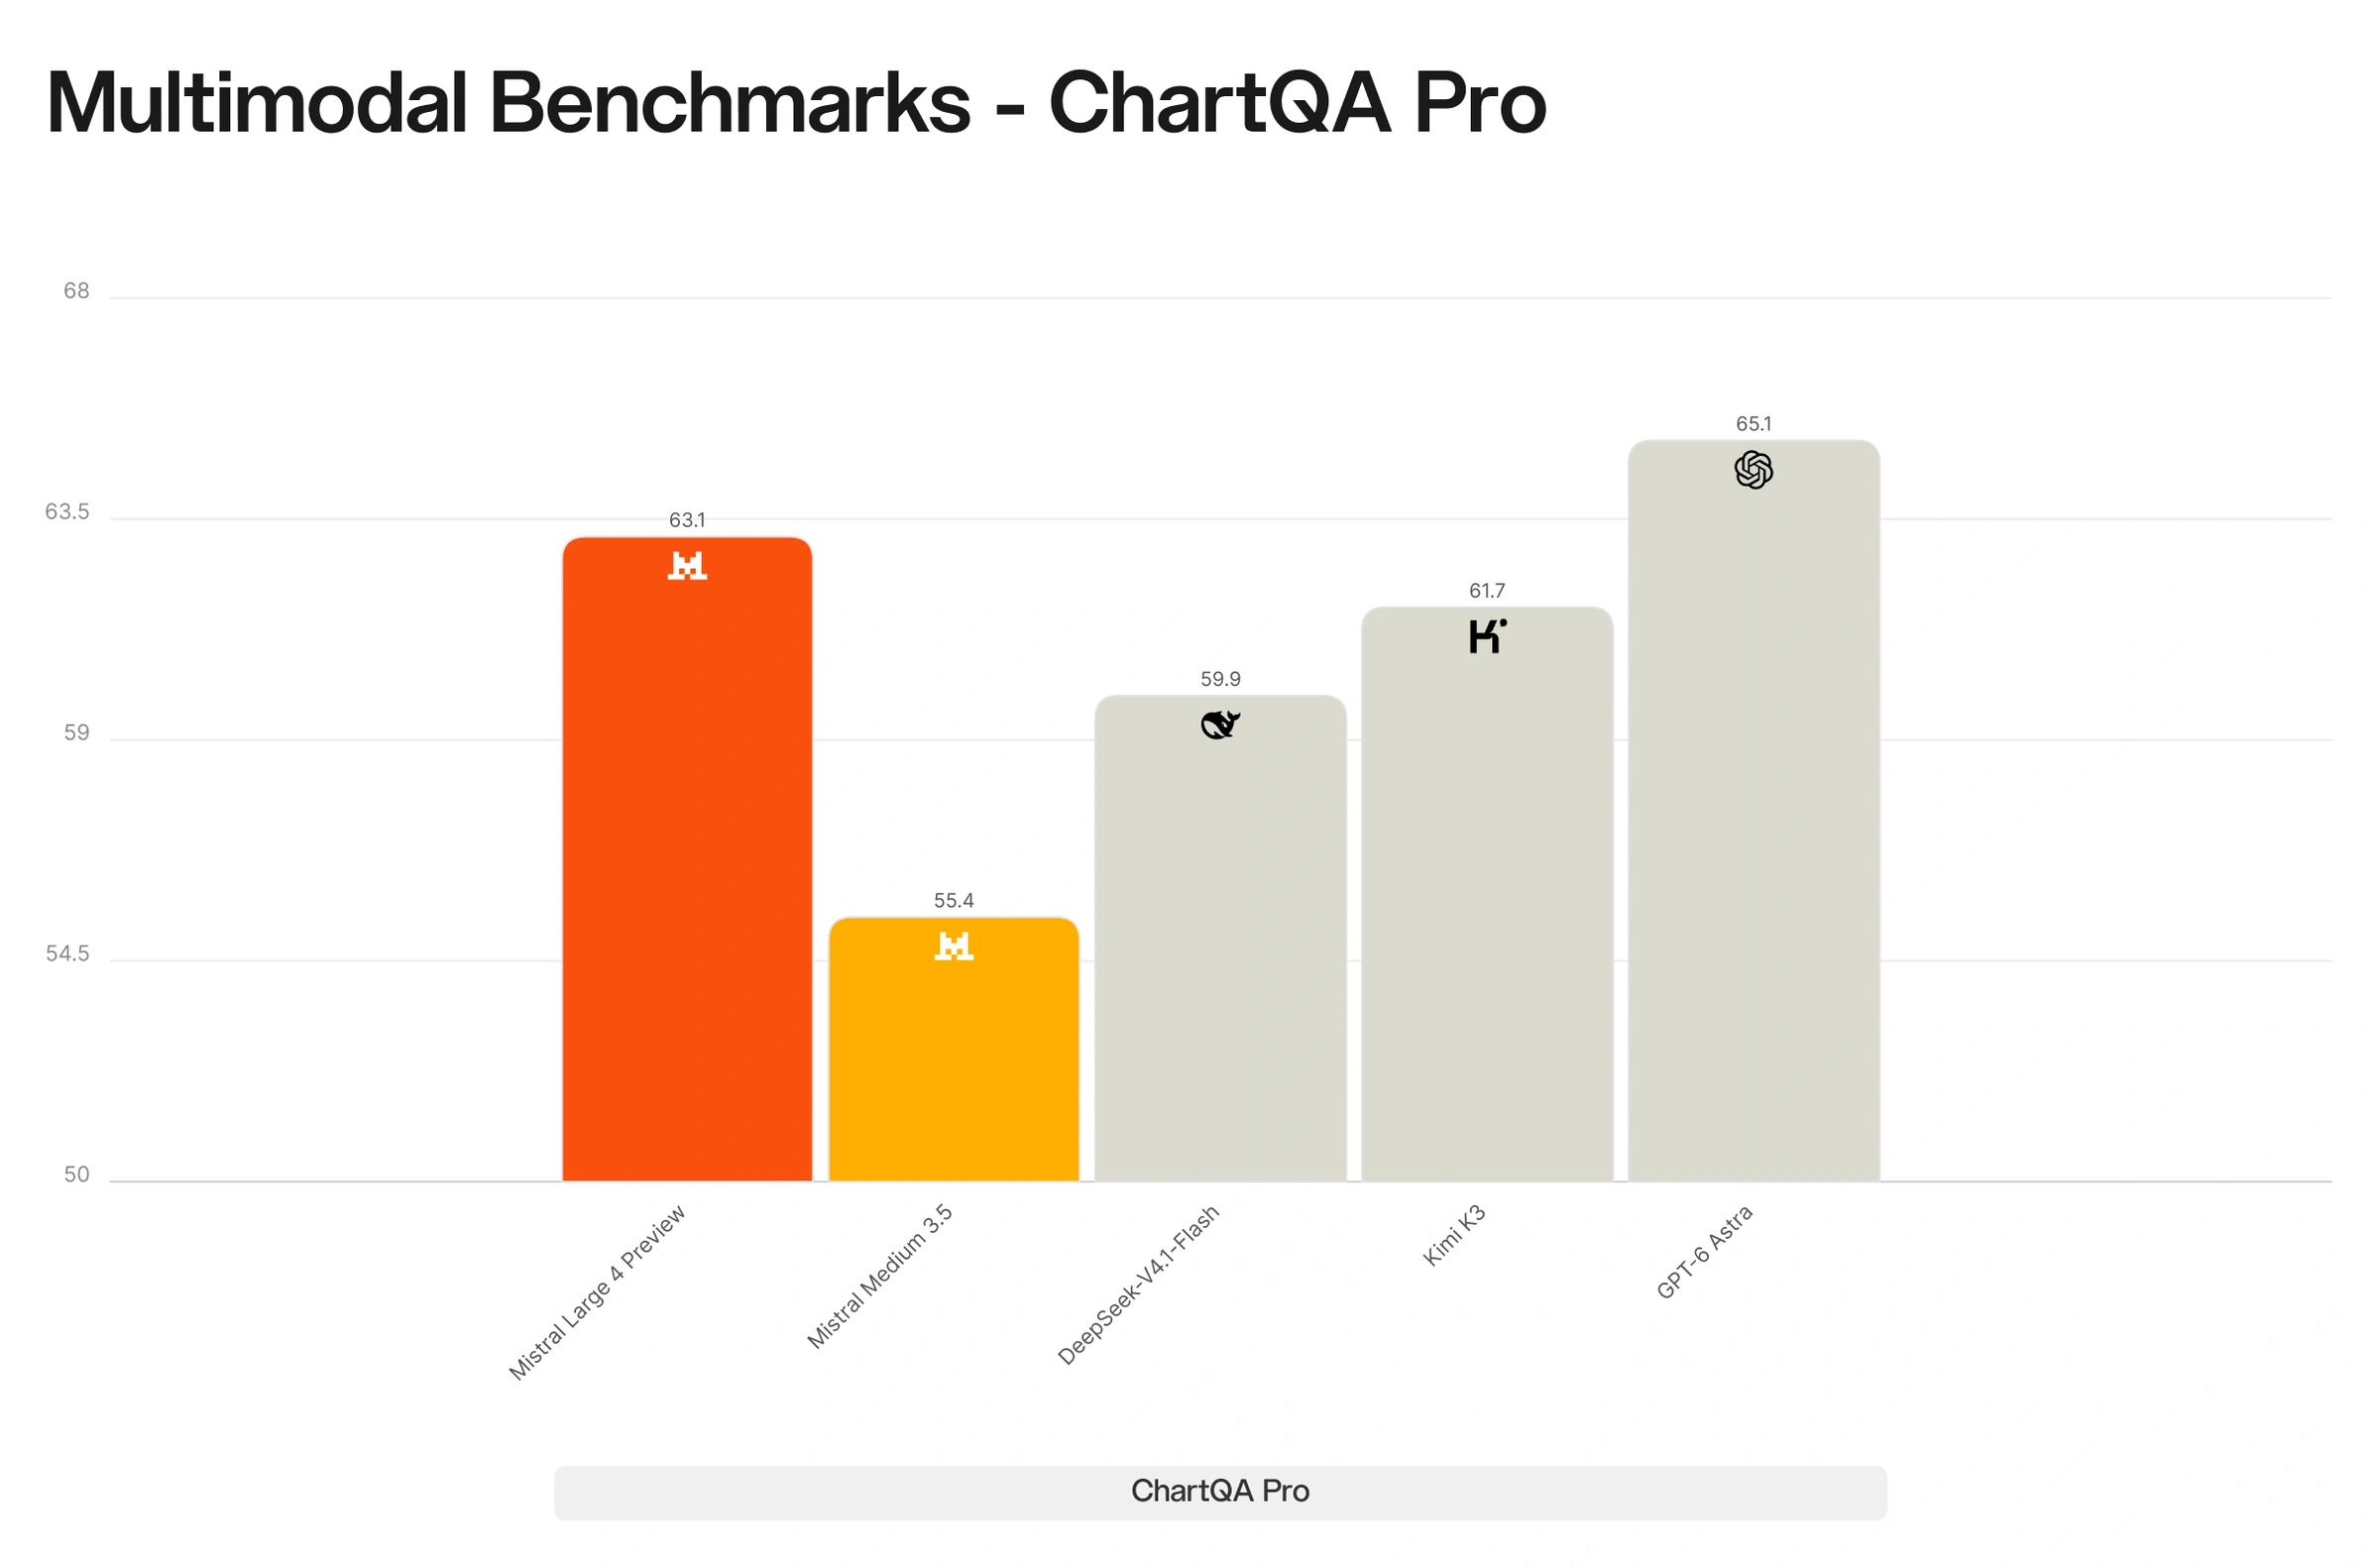
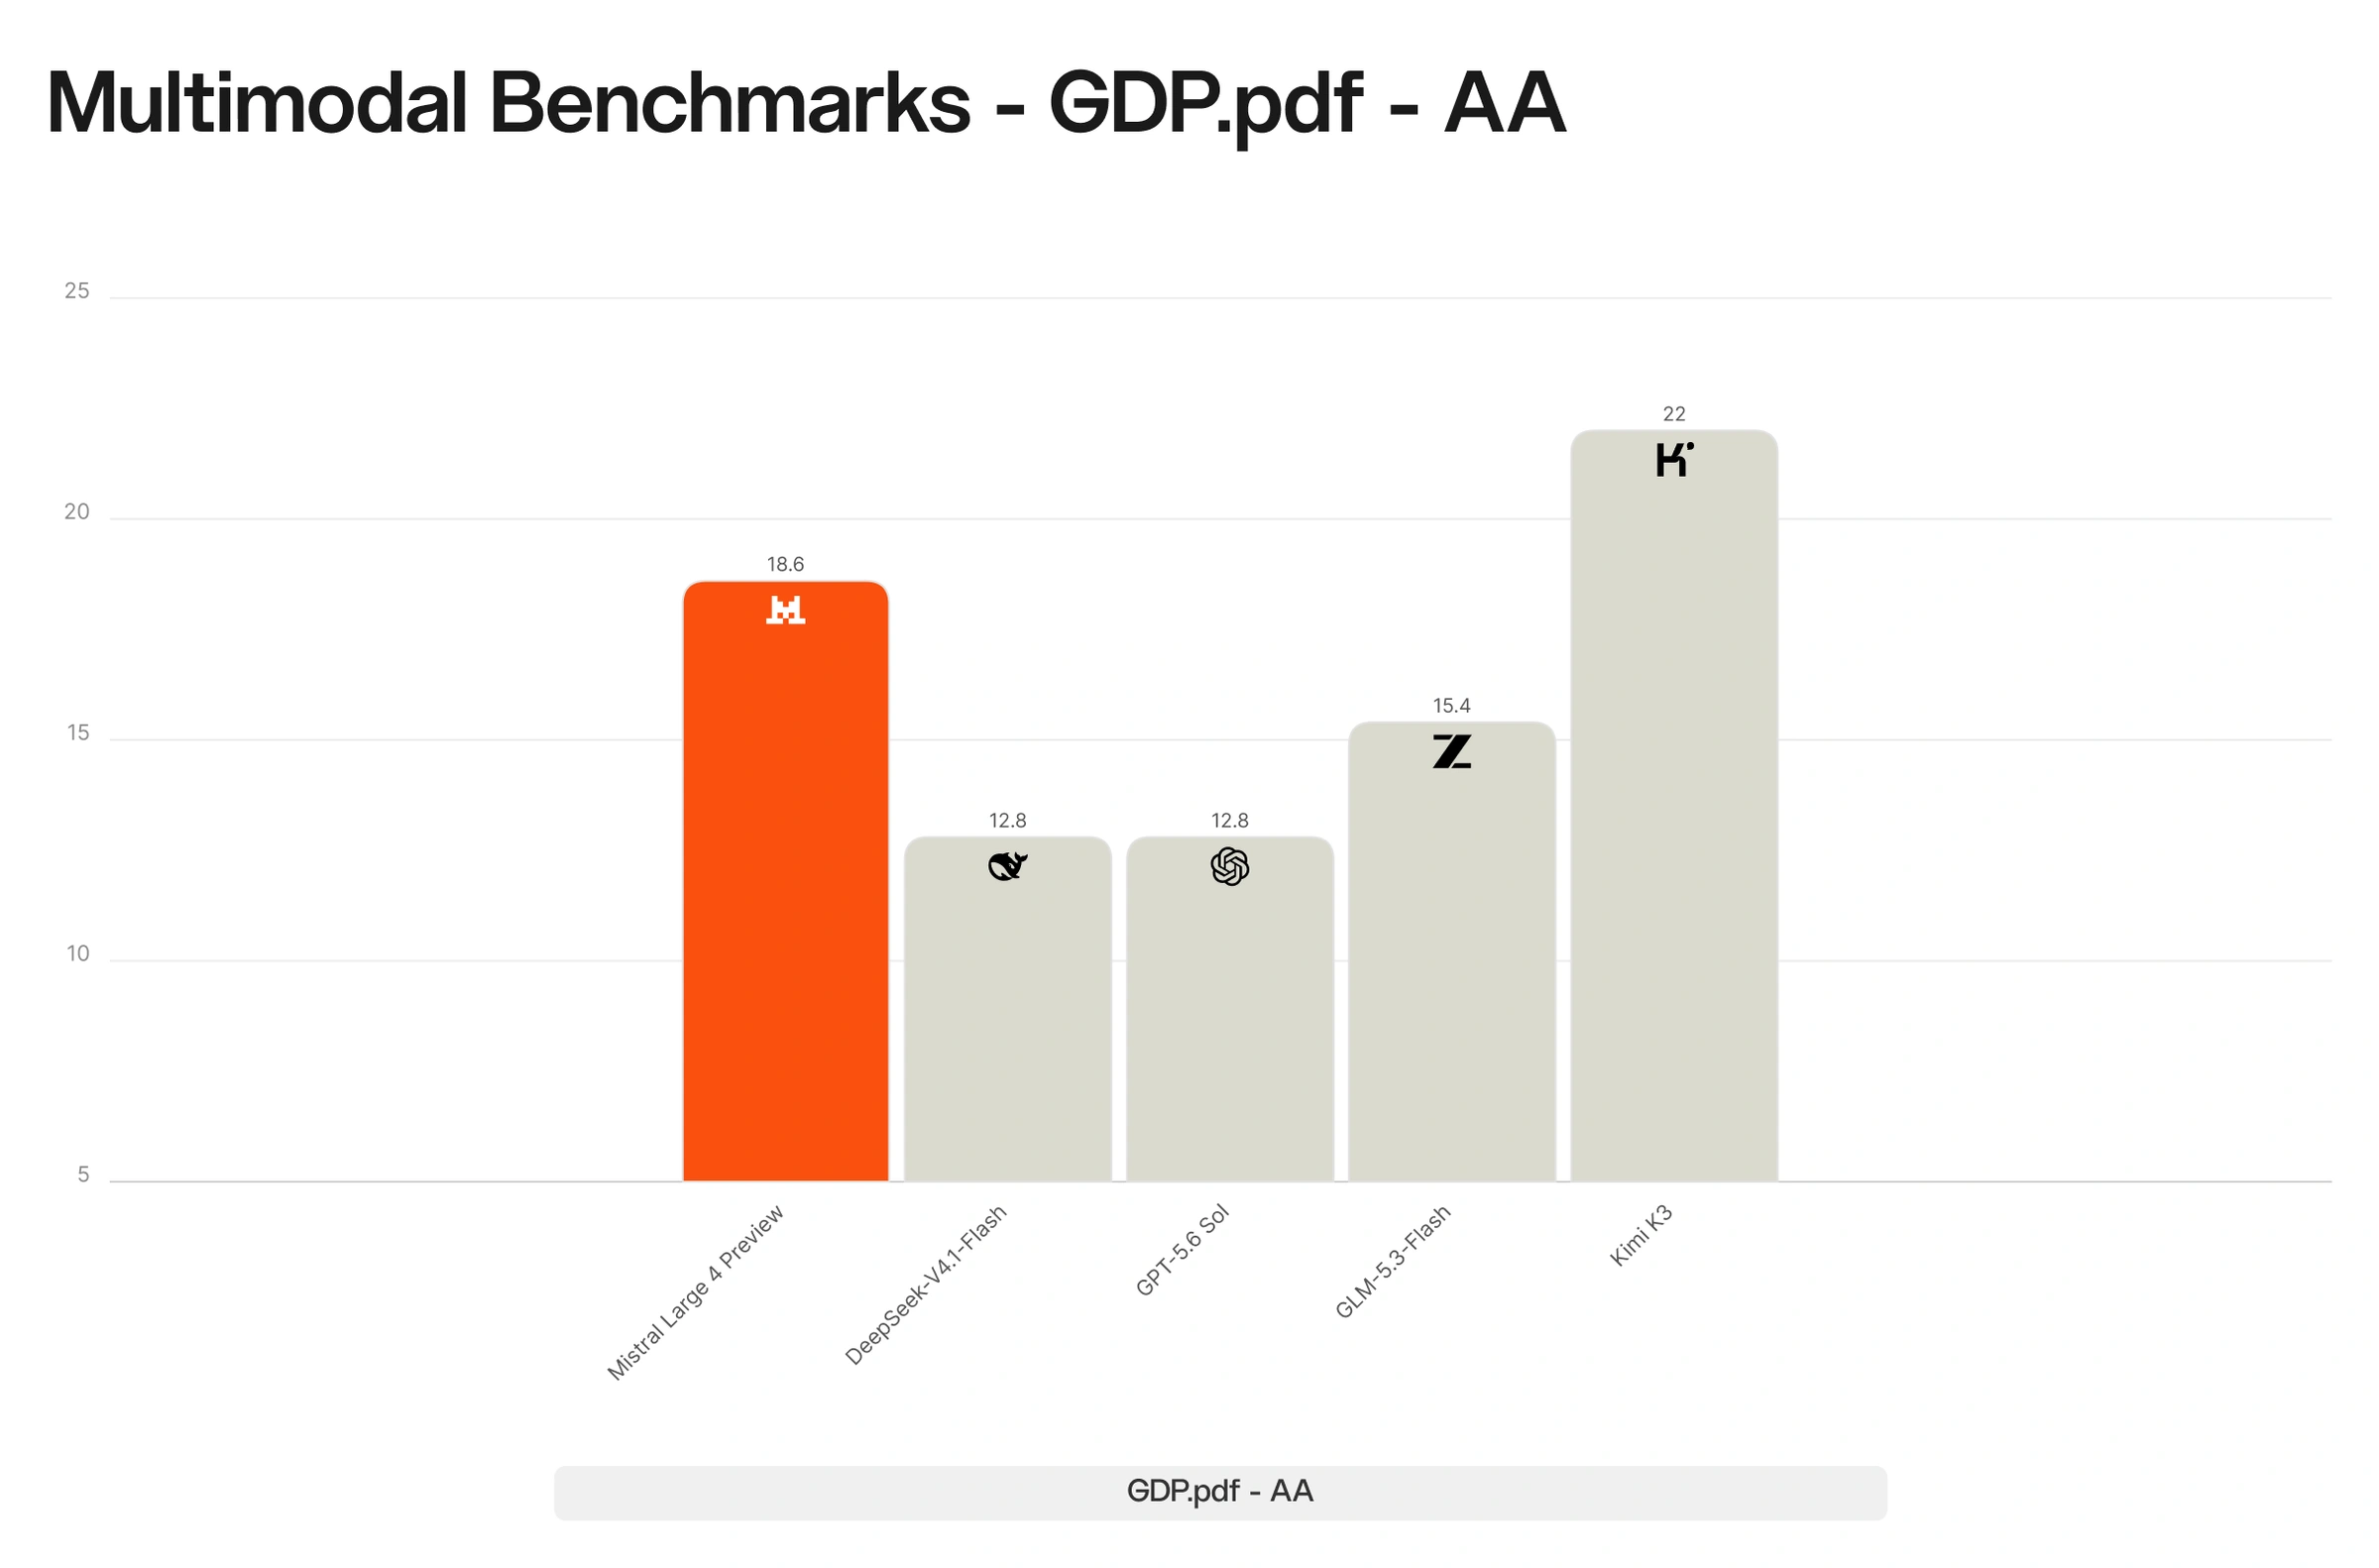
ML4 — это скачок в способности моделей понимать изображения. Мощно рассуждает о сложных документах, графиках и натуральных изображениях, и приносит зрение в отрасли, где восприятие критично, такие как инженерия, производство и earth observation.
Модель может дополнительно объединять visual grounding с агентическими способностями: от анализа гигапиксельных спутниковых снимков — помощи командам реагирования на бедствия действовать когда счёт идёт на секунды — до анализа инженерных чертежей — увеличение, проверка и верификация пока ответ не станет точным. В демонстрациях выше ML4 осуществляет грounding плотных натуральных сцен, проверяет механические части в технических чертежах, извлекает доказательства из PDF и сканирует огромные геопространственные изображения на предмет наиболее сложно находимых объектов.
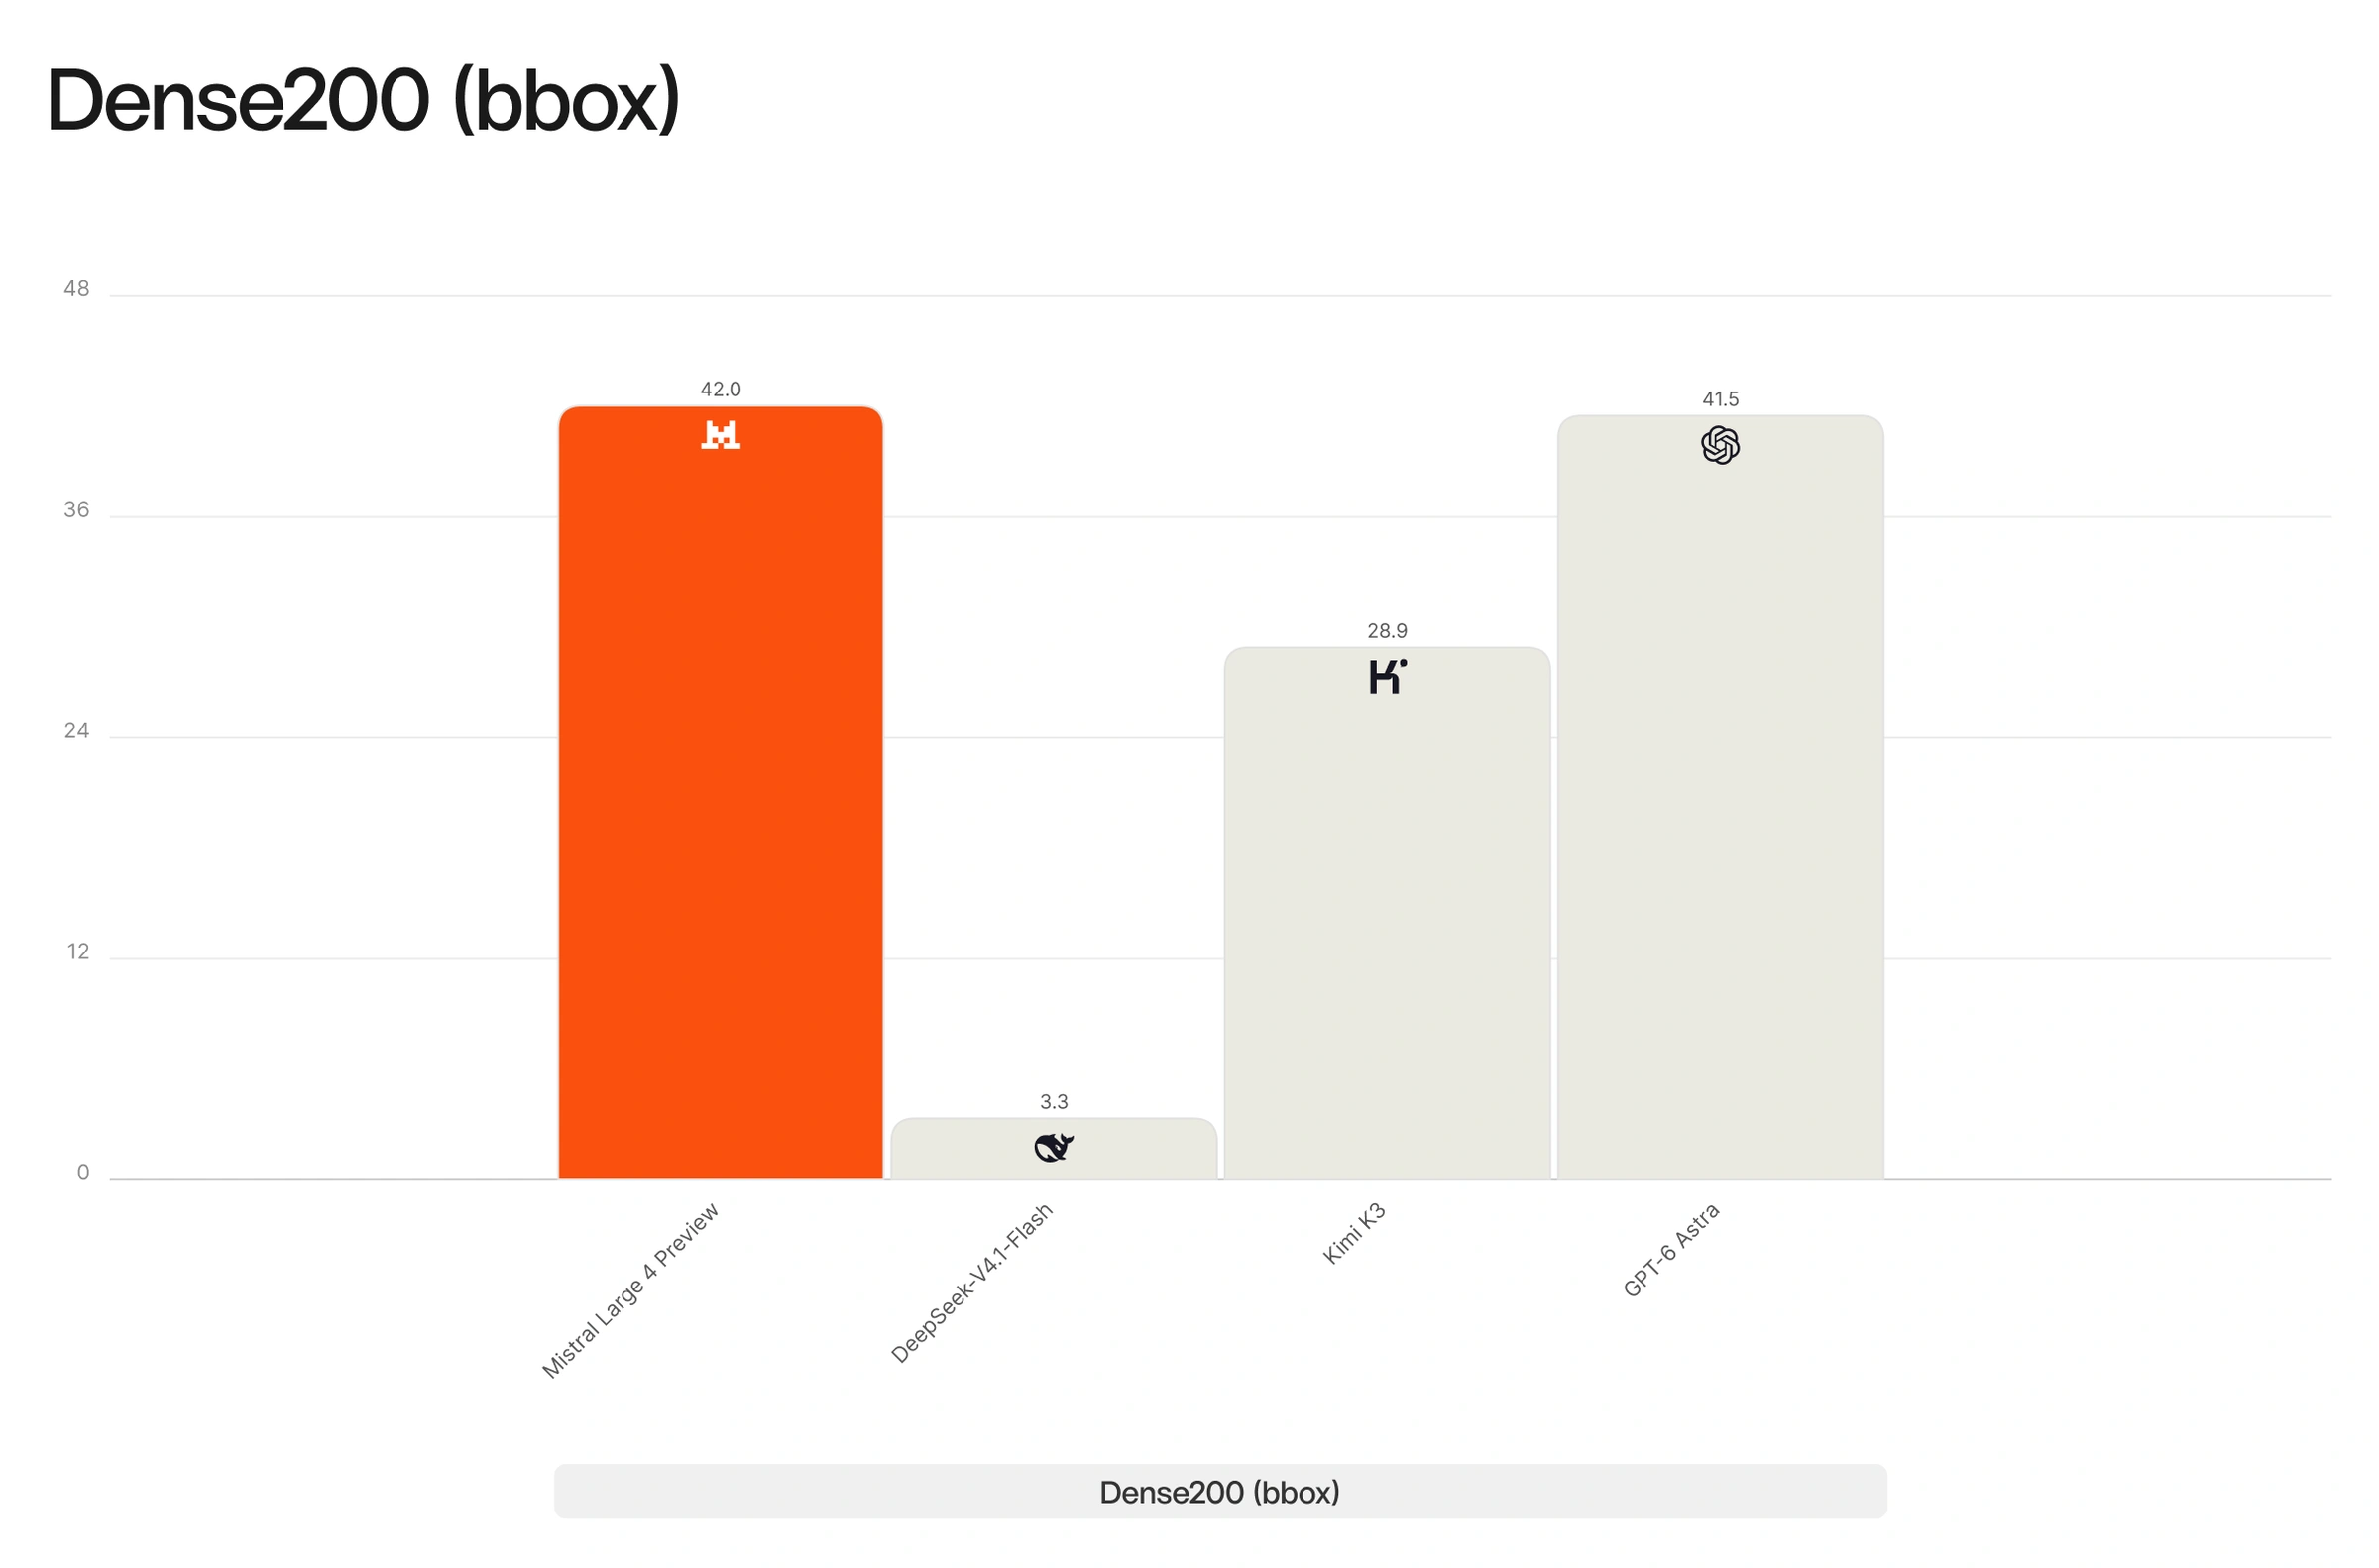
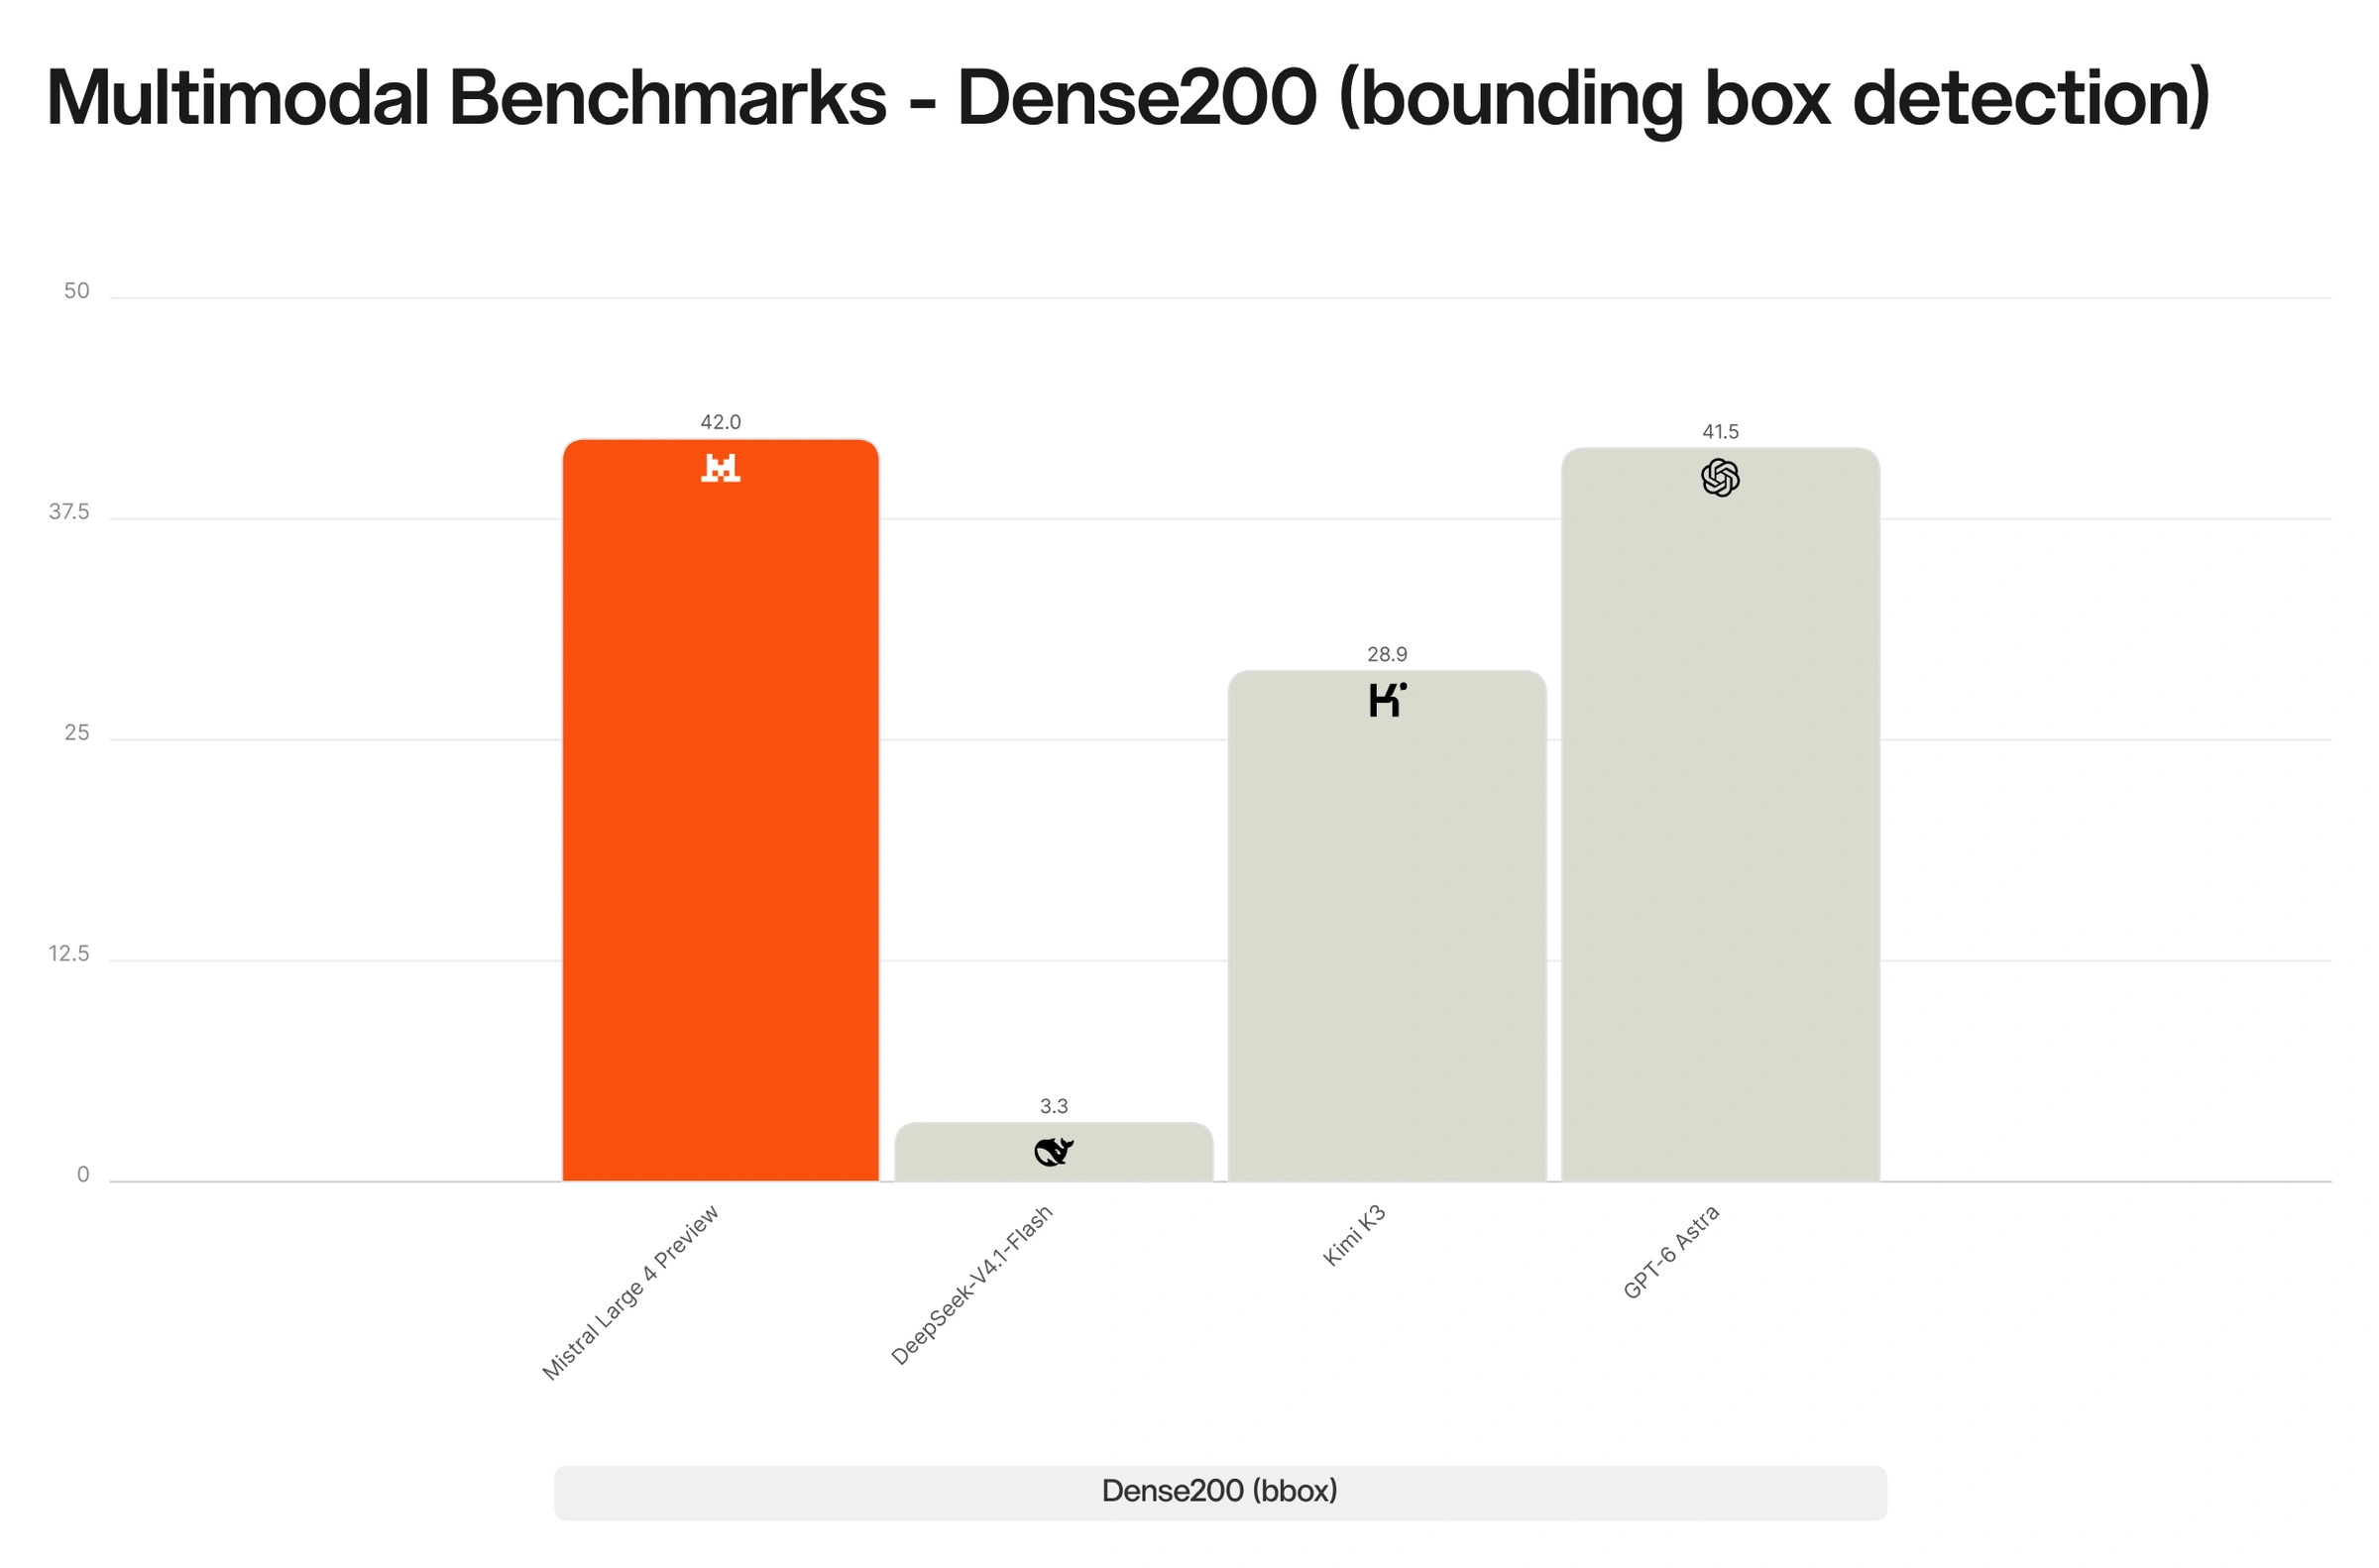
В visual grounding особенно мы находим ML4 одной из самых способных моделей, которые тестировали, например, превосходя GPT-6-Astra на Dense 200 (42% против 41%).
Наука и математика
ML4 приносит сильные научные способности, построенные путём объединения методов на базе AI с экспертизой исследователей в математике, физике и химии.
Высоко квалифицирована в агентическом кодировании для научных задач, таких как анализ данных, моделирование и симуляция физической реальности, что позволяет исследователям сосредоточиться на вопросах вместо инструментария. В бенчмарках ML4 является state-of-the-art на SciCode-Verified среди open-weight моделей. На практике может создать полную Hartree–Fock симуляцию одним выстрелом — сложная, многошаговая химическая задача, построенная из серии продвинутых подпрограмм.
Математика ML4 сильнее также, как в формальном рассуждении, так и в прикладной математике. В наших оценках человеком рассуждает более точно и структурировано чем GLM-5.3, и может поддерживать длинные, специфичные для области задачи прикладной математики, включая работу, относящуюся к frontier теоретической физике.
Вместе эти способности делают ML4 сильным исследовательским ассистентом по всему техническому процессу — от первого вопроса до финального результата.
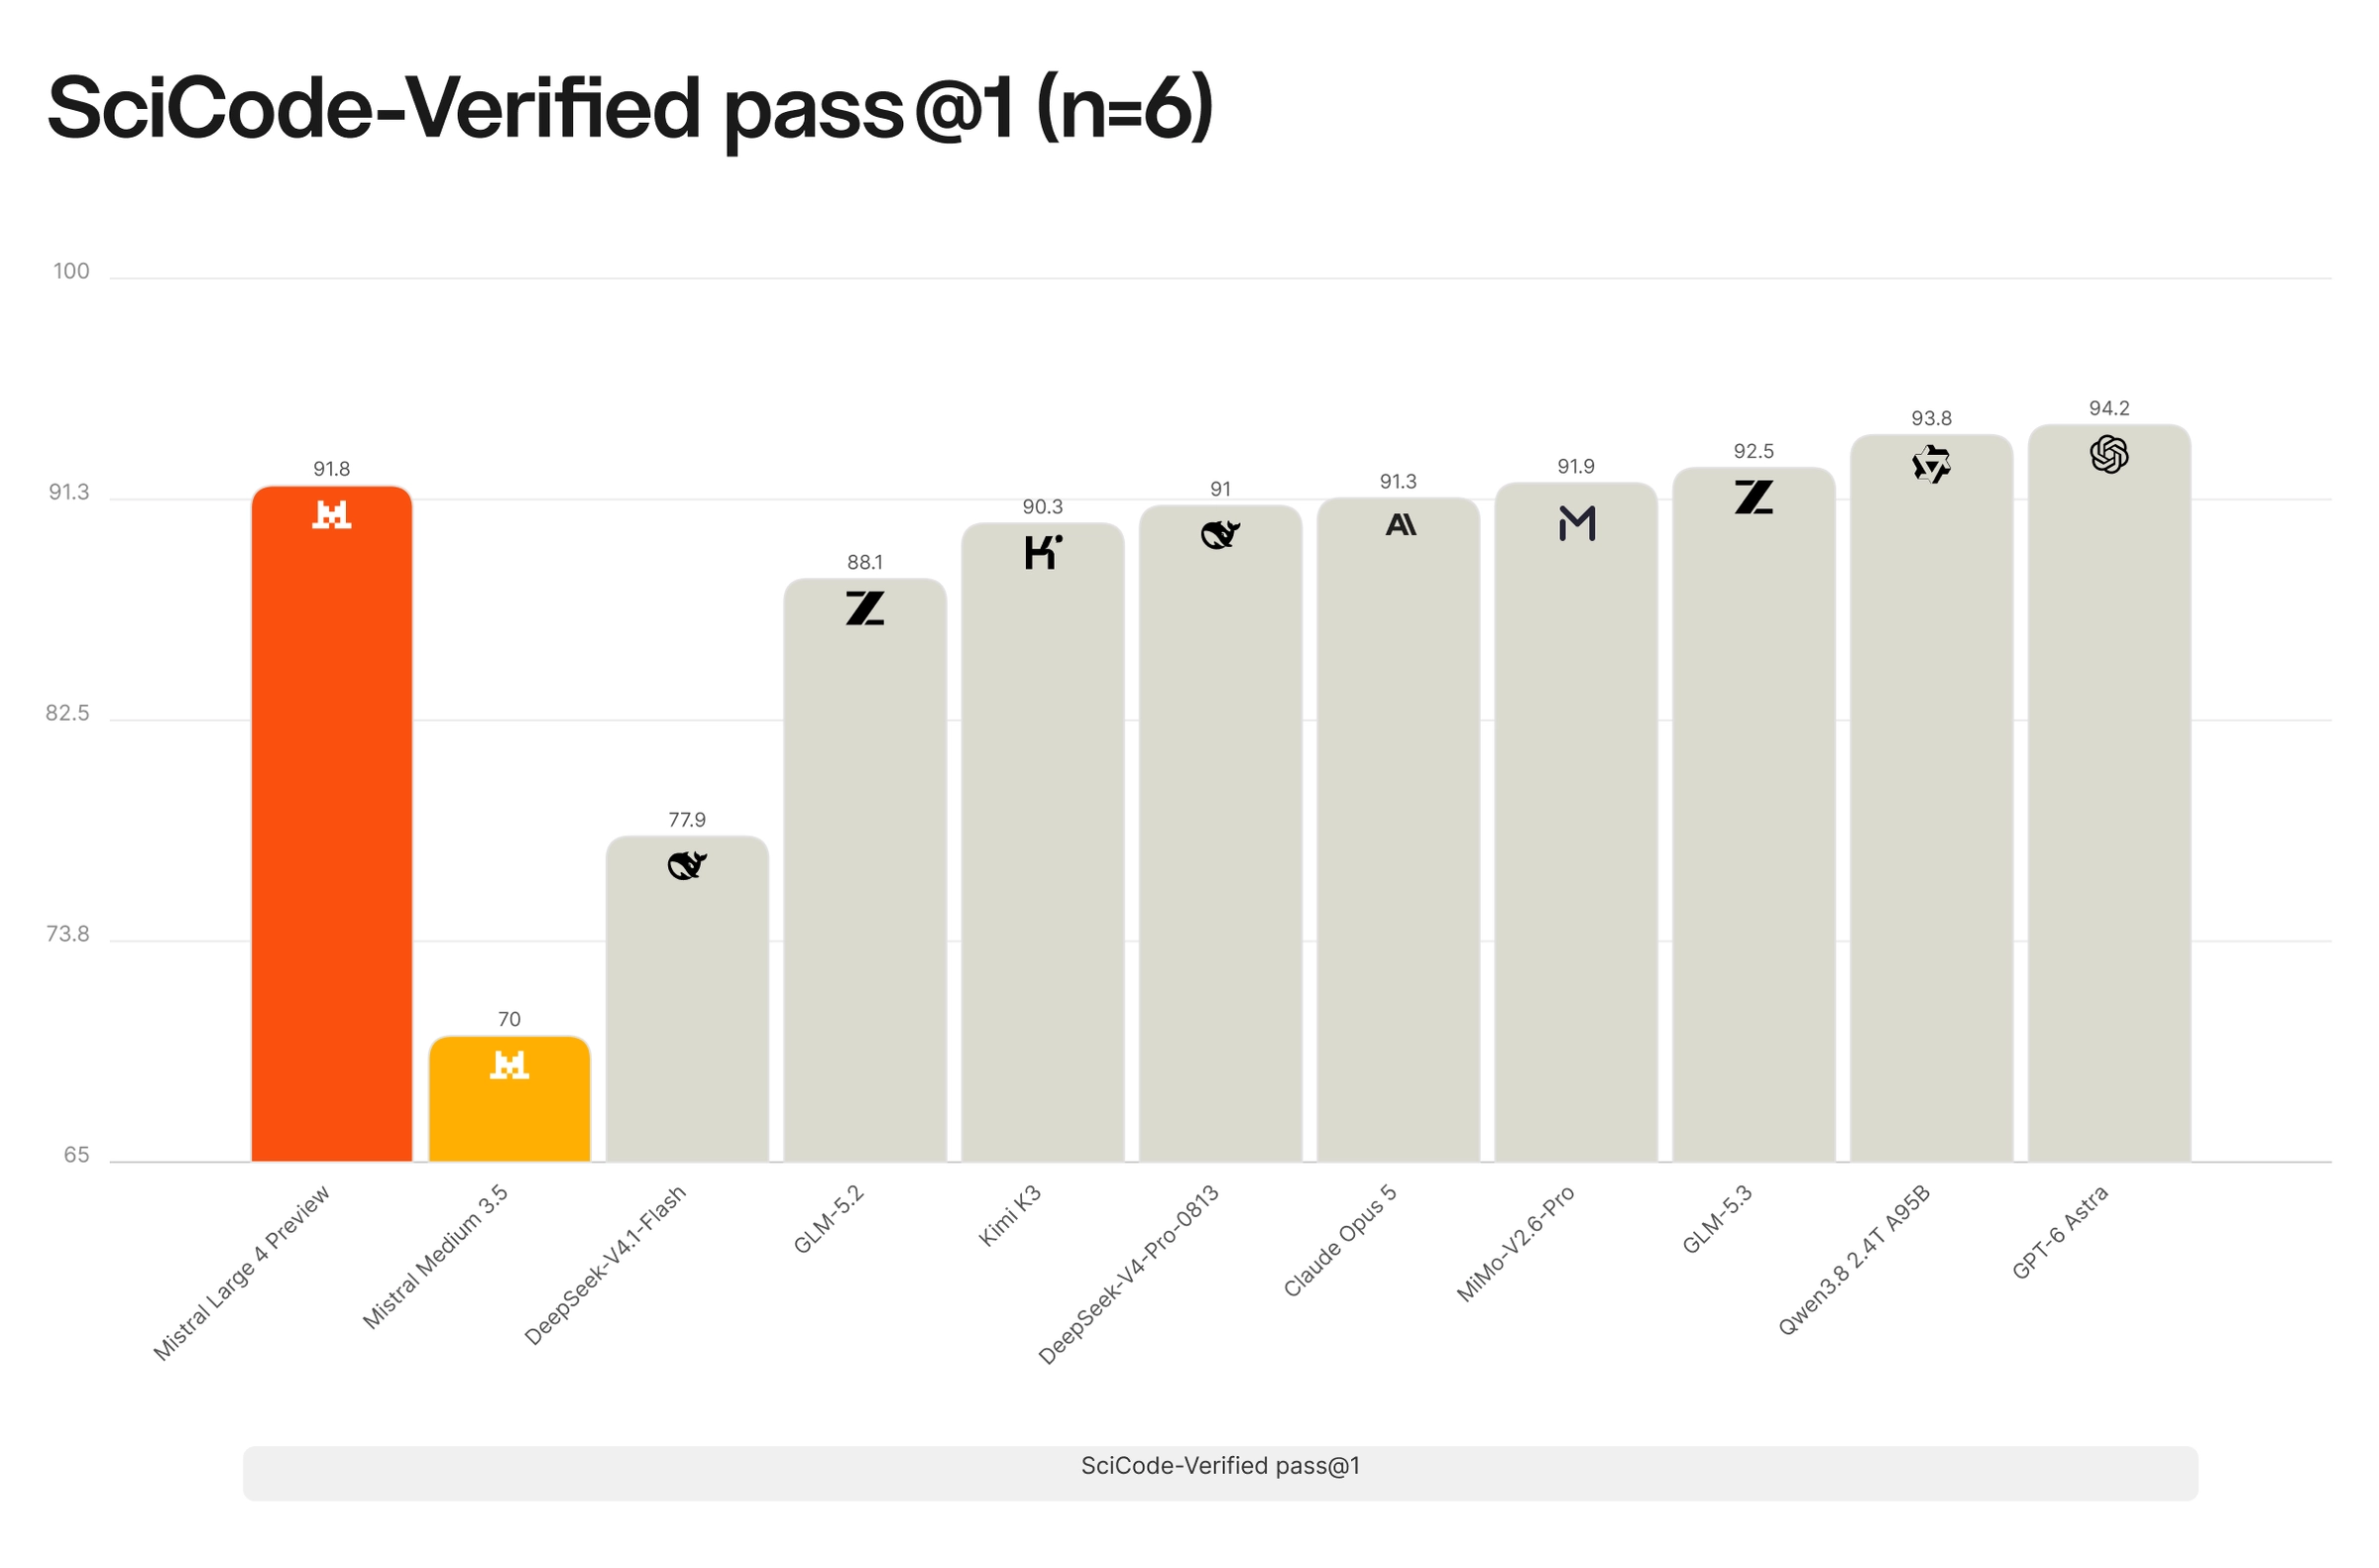
SciCode-Verified тестирует способности моделей реализовывать сложные научные рабочие процессы в коде для областей таких как физика, математика, наука о материалах и биология.
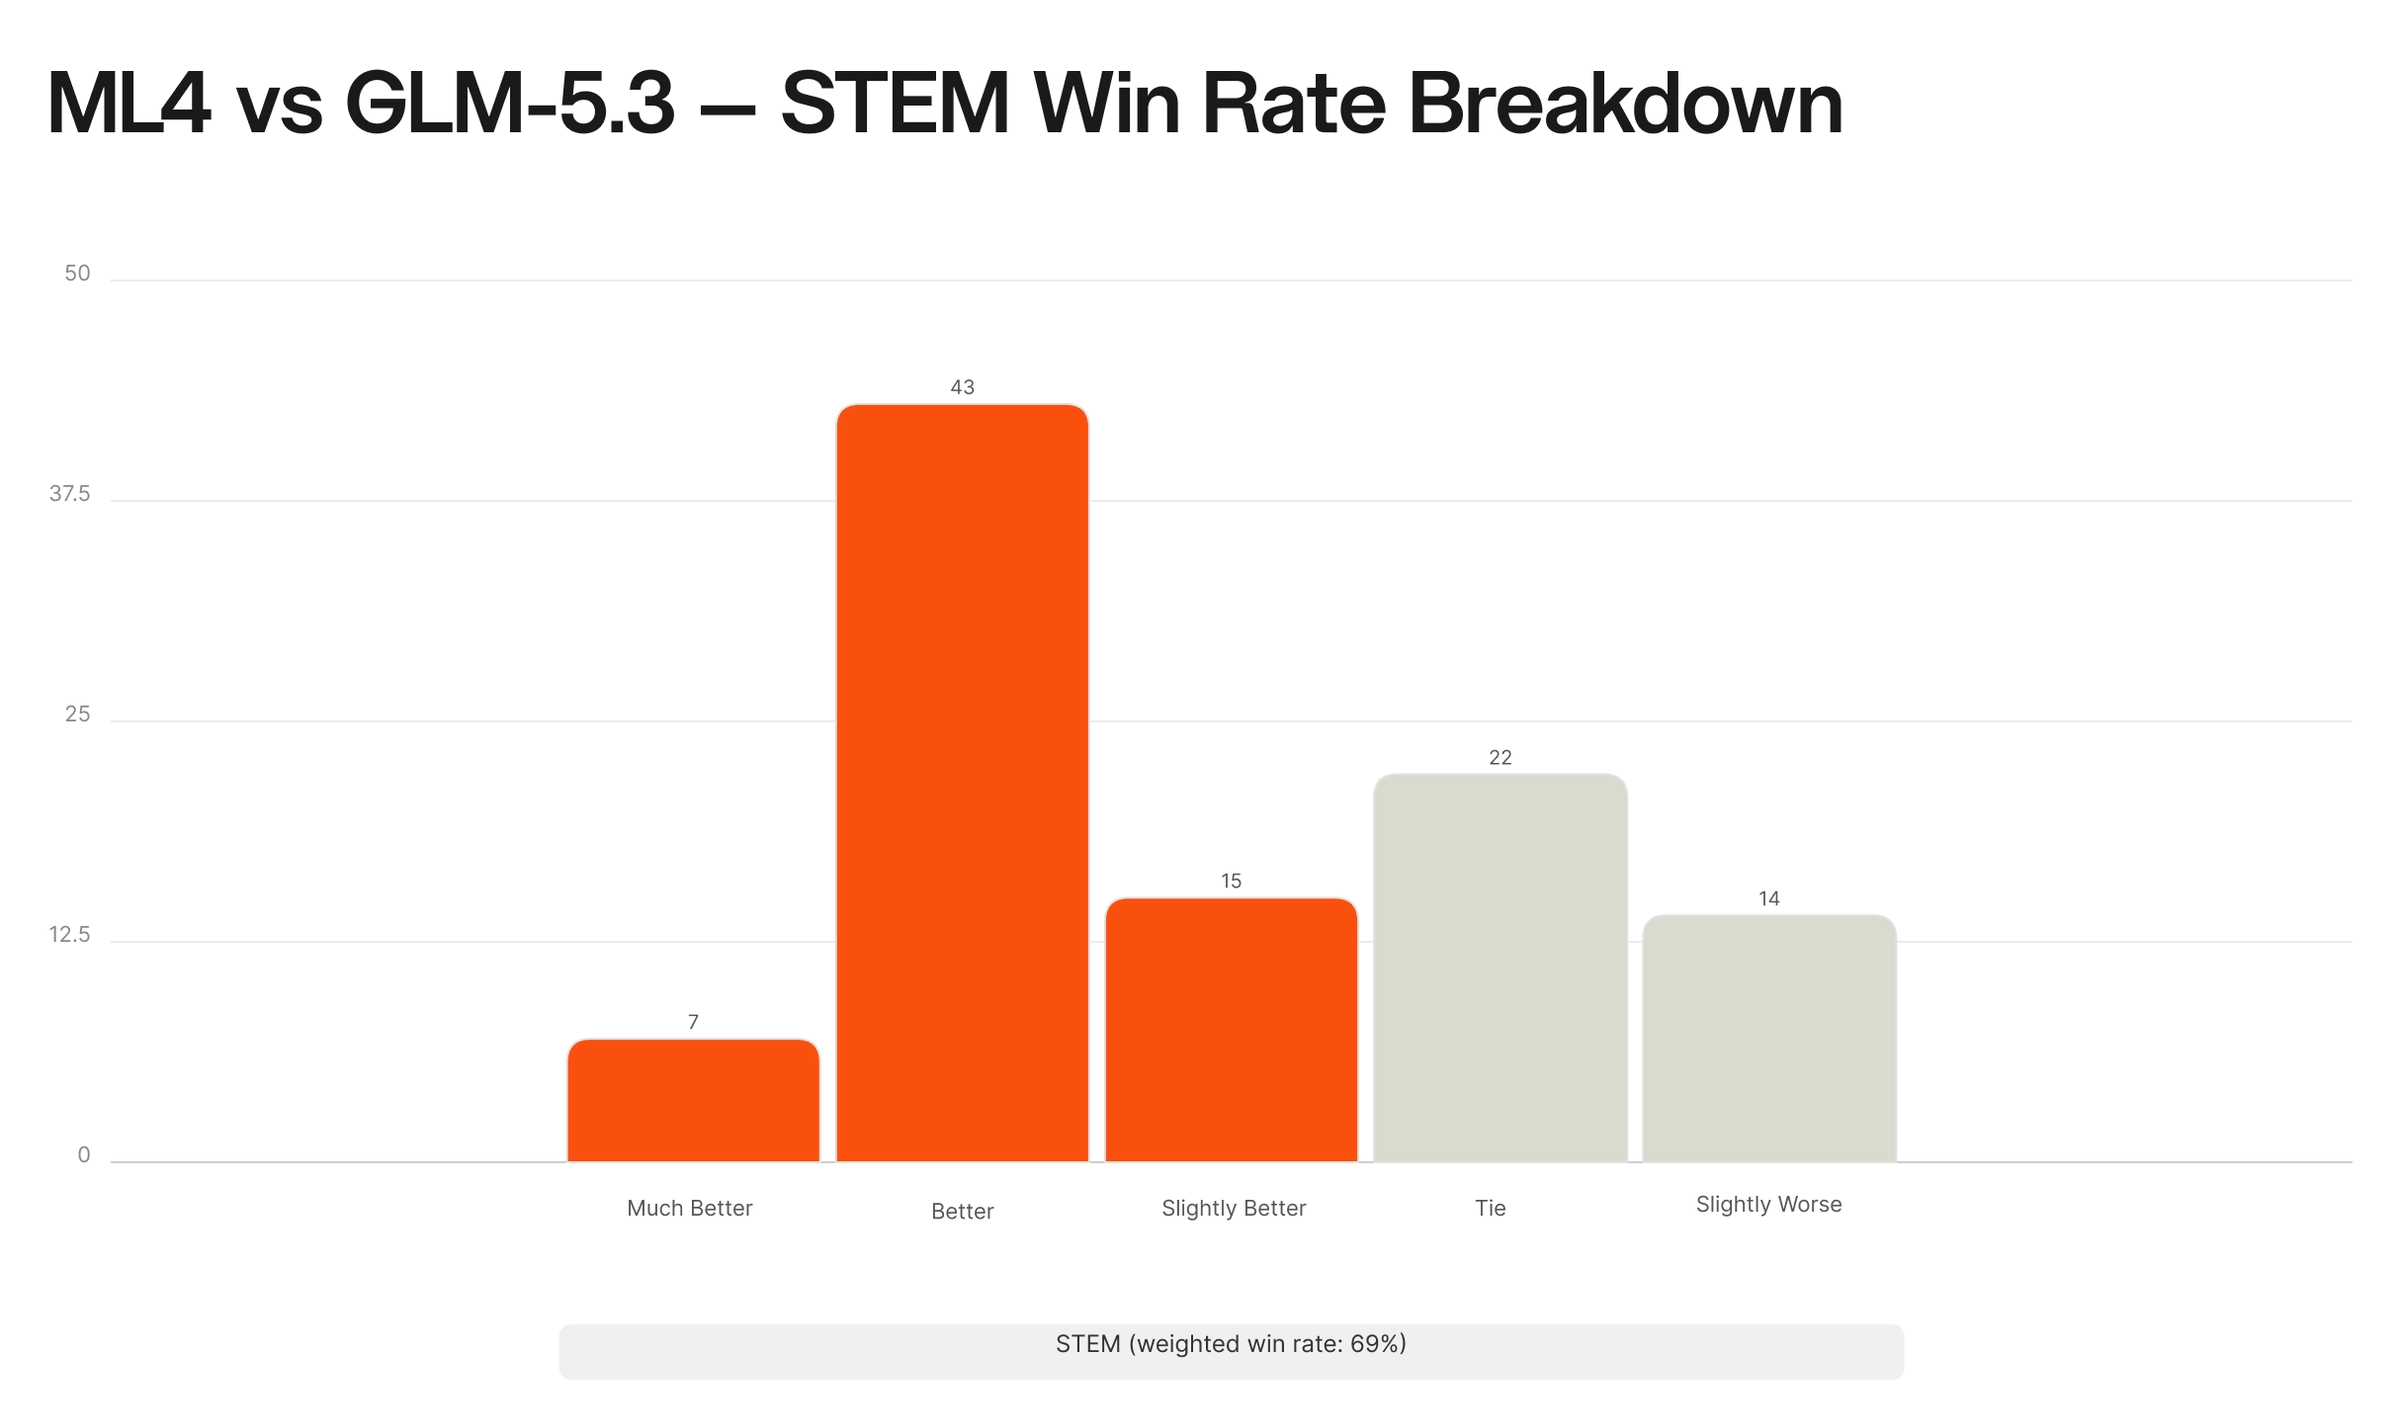
Внутренняя оценка ML4 против GLM5.3 на задачах STEM (математика и физика)
Knowledge work
ML4 — самая способная модель для real-world задач, которые обрабатывают профессионалы каждый день. Может создавать, редактировать и исправлять сложные электронные таблицы и документы, показывая образцовую производительность как на legal, так и на financial бенчмарках.
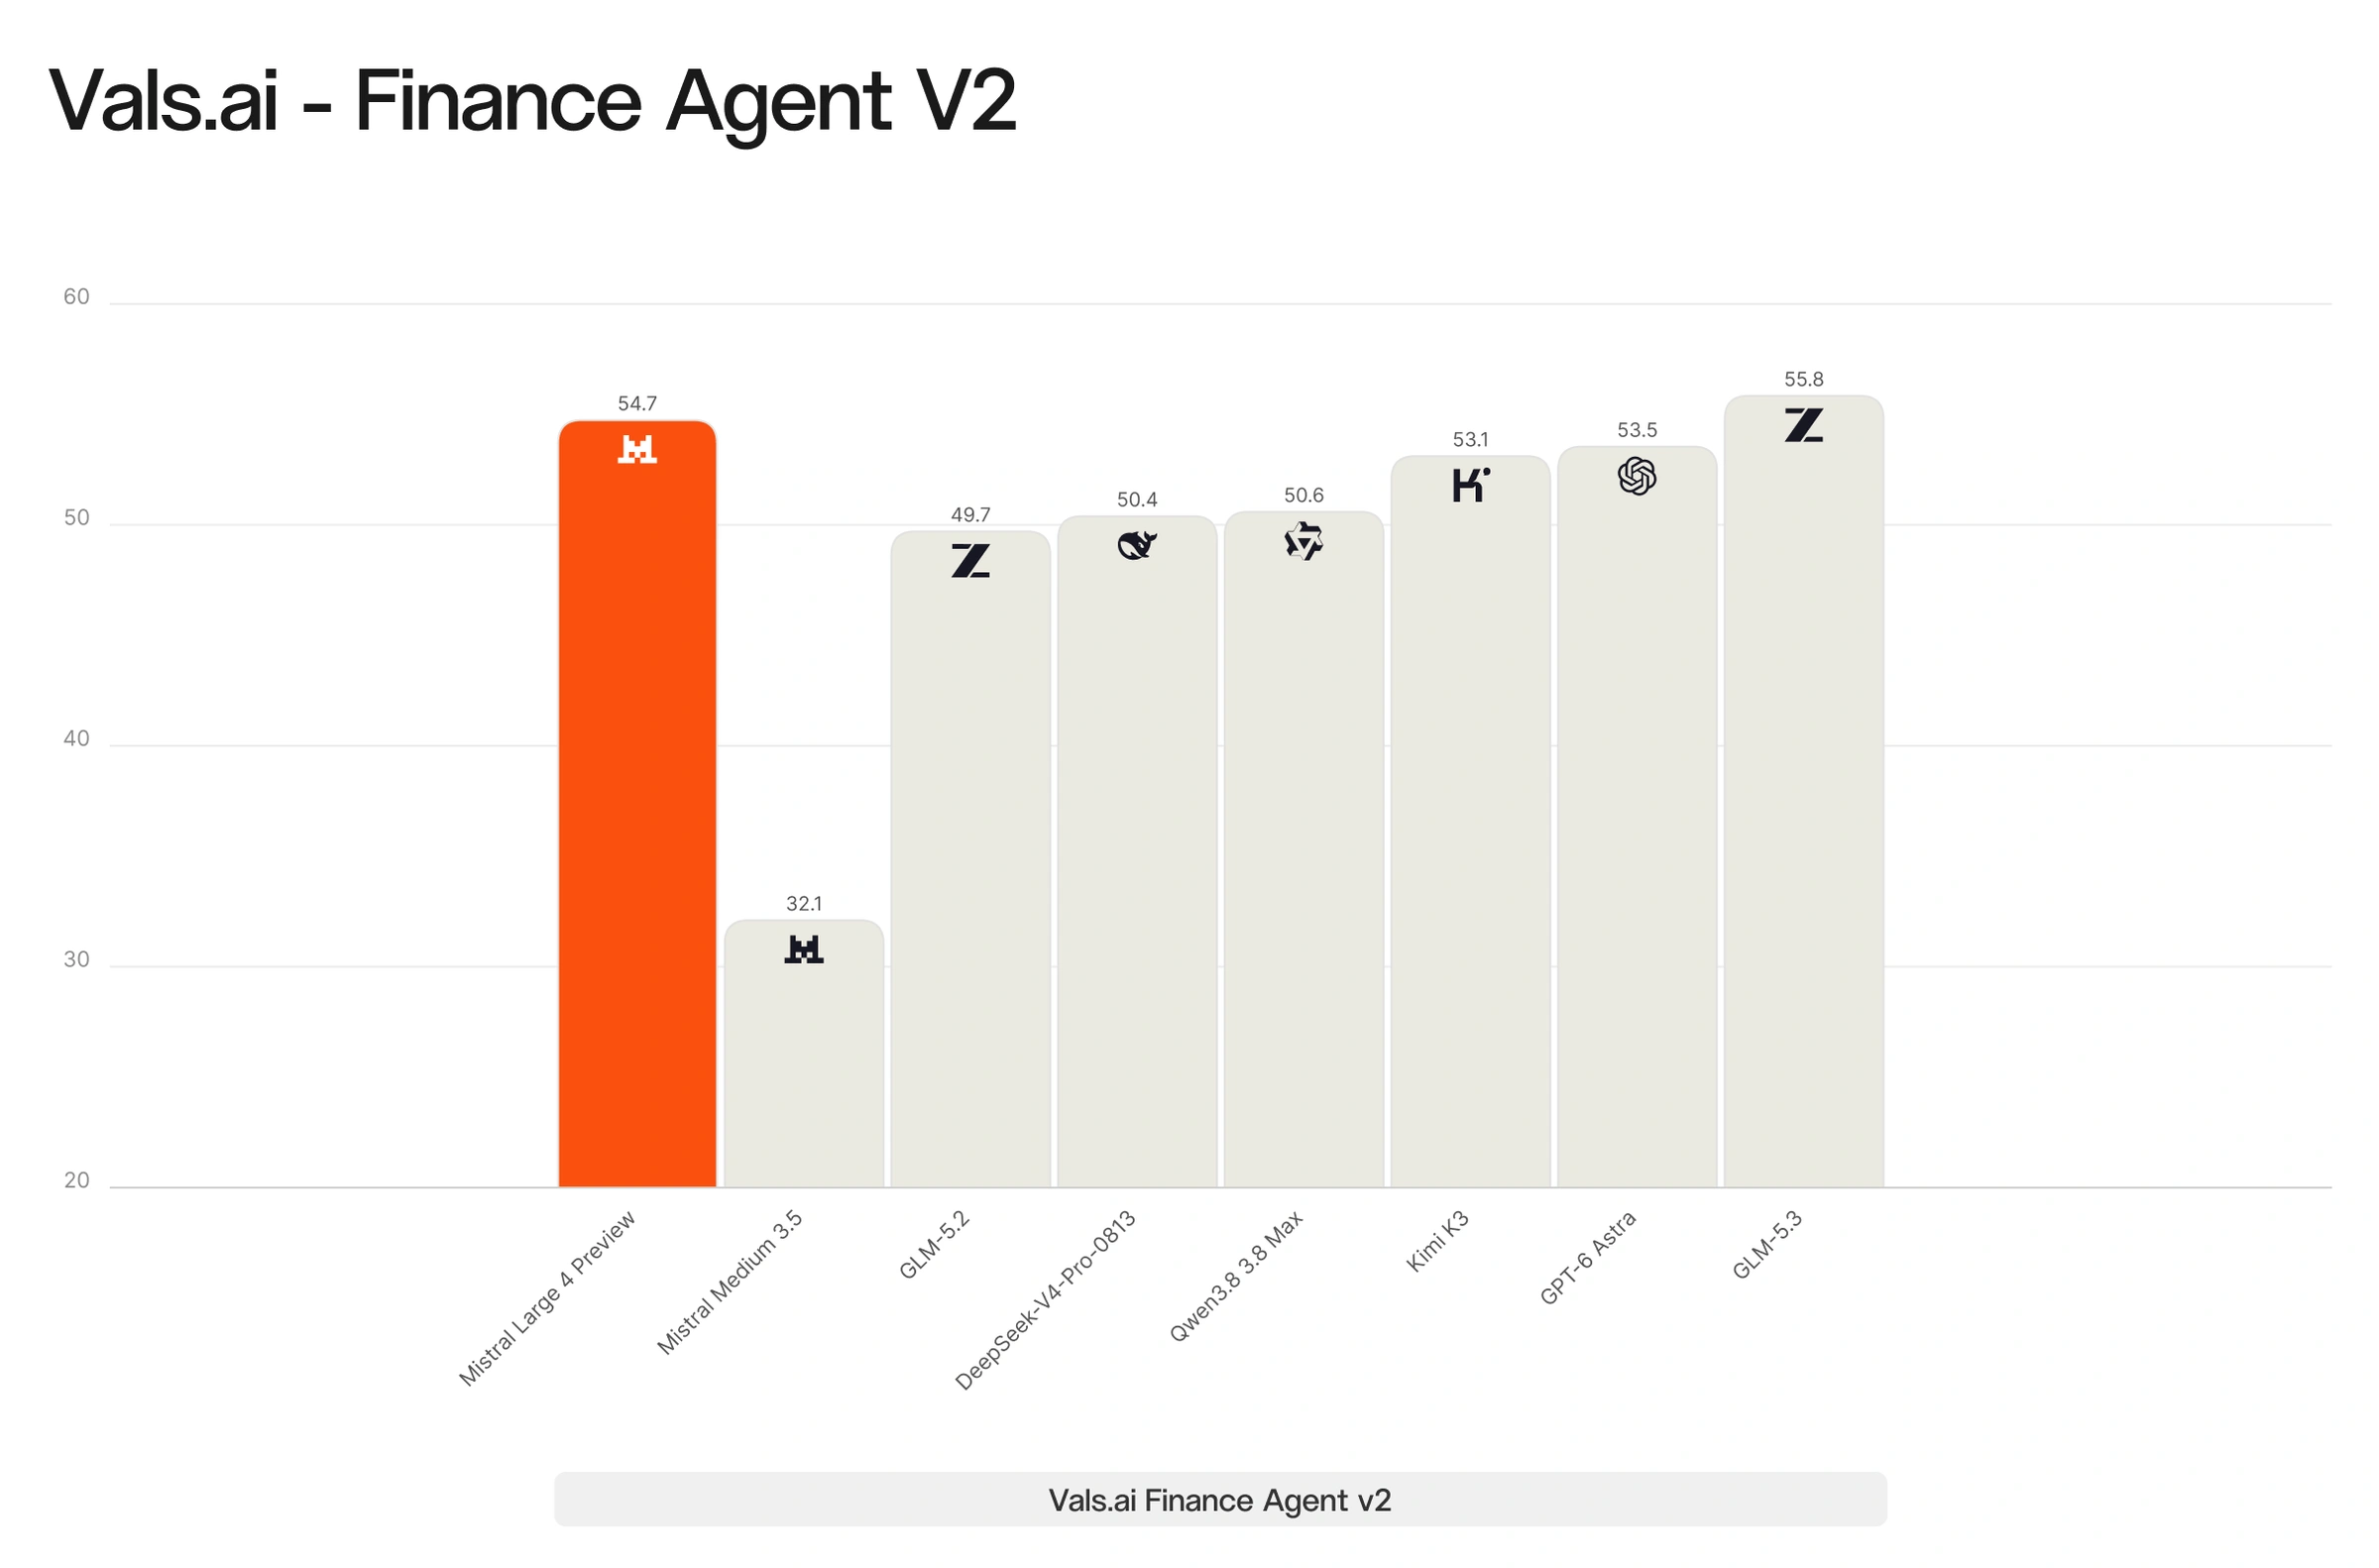
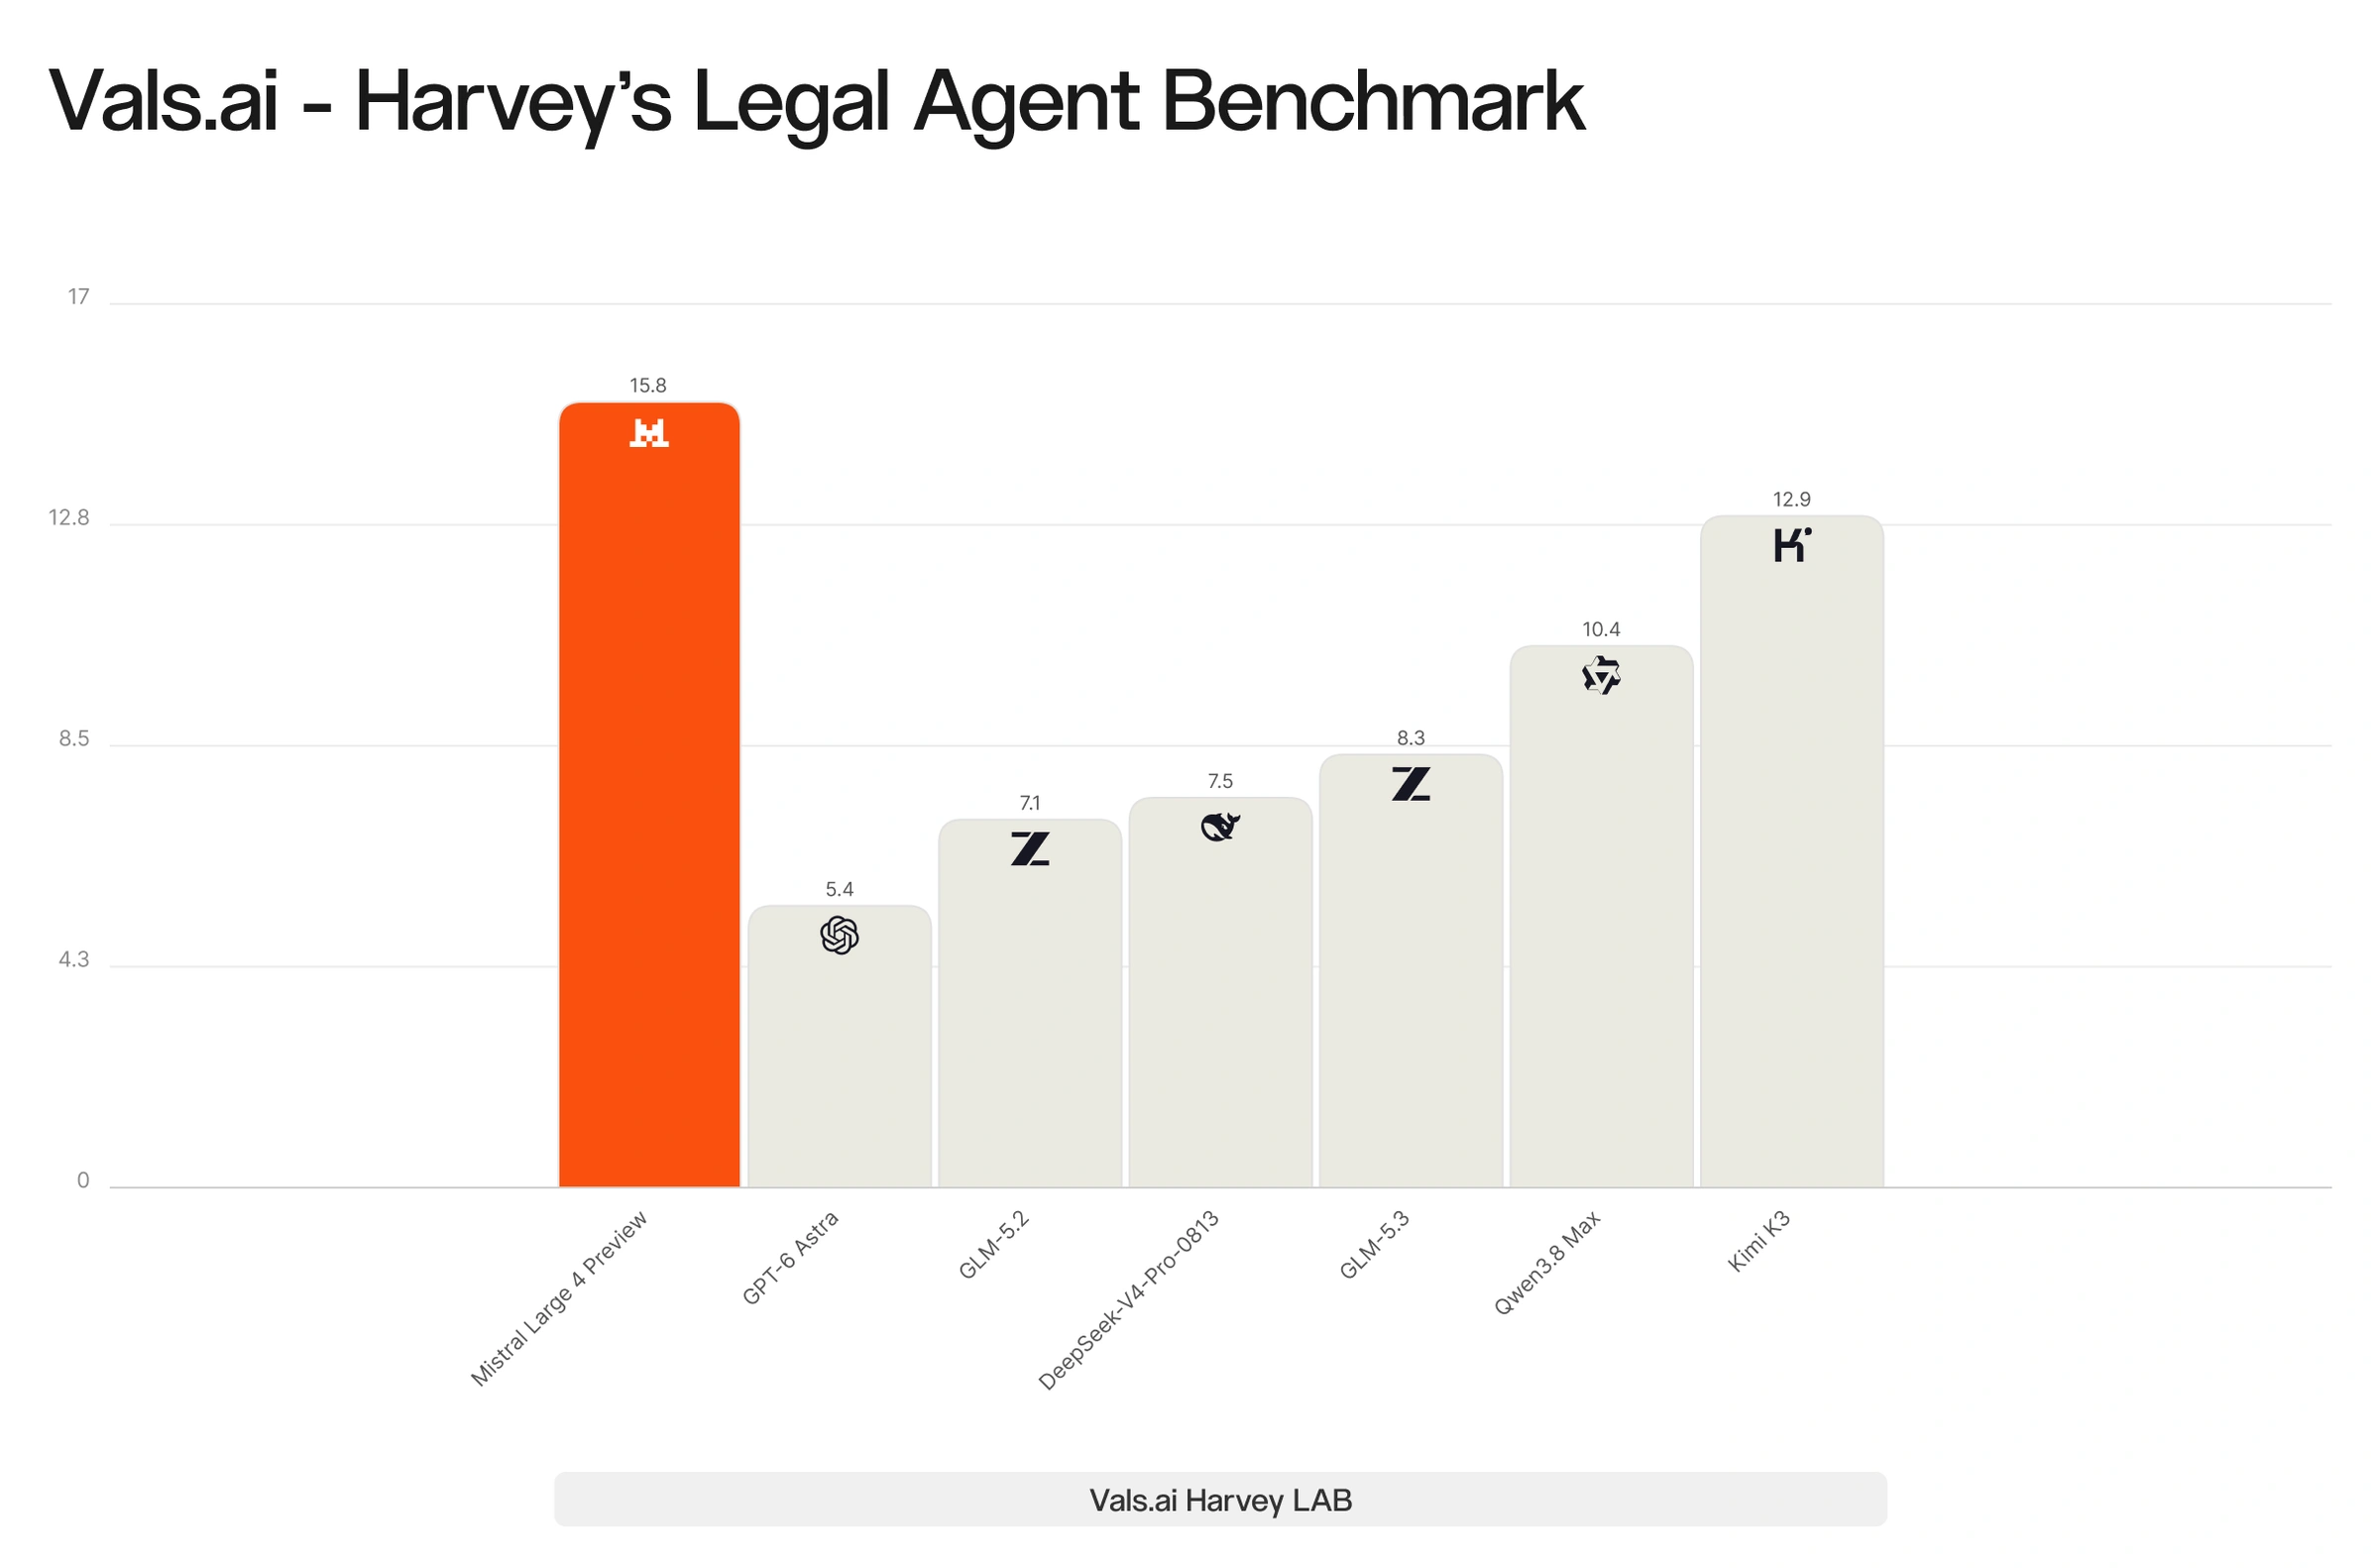
Примечательно, что оценили ML4 через сторонних evaluators (vals.ai) на репрезентативных задачах как для legal, так и для financial работы, обнаружив, что модель превосходит GPT-6-Astra в обоих случаях. На HarveyAI's Legal Agent бенчмарке ML4 превосходит все open-source модели.
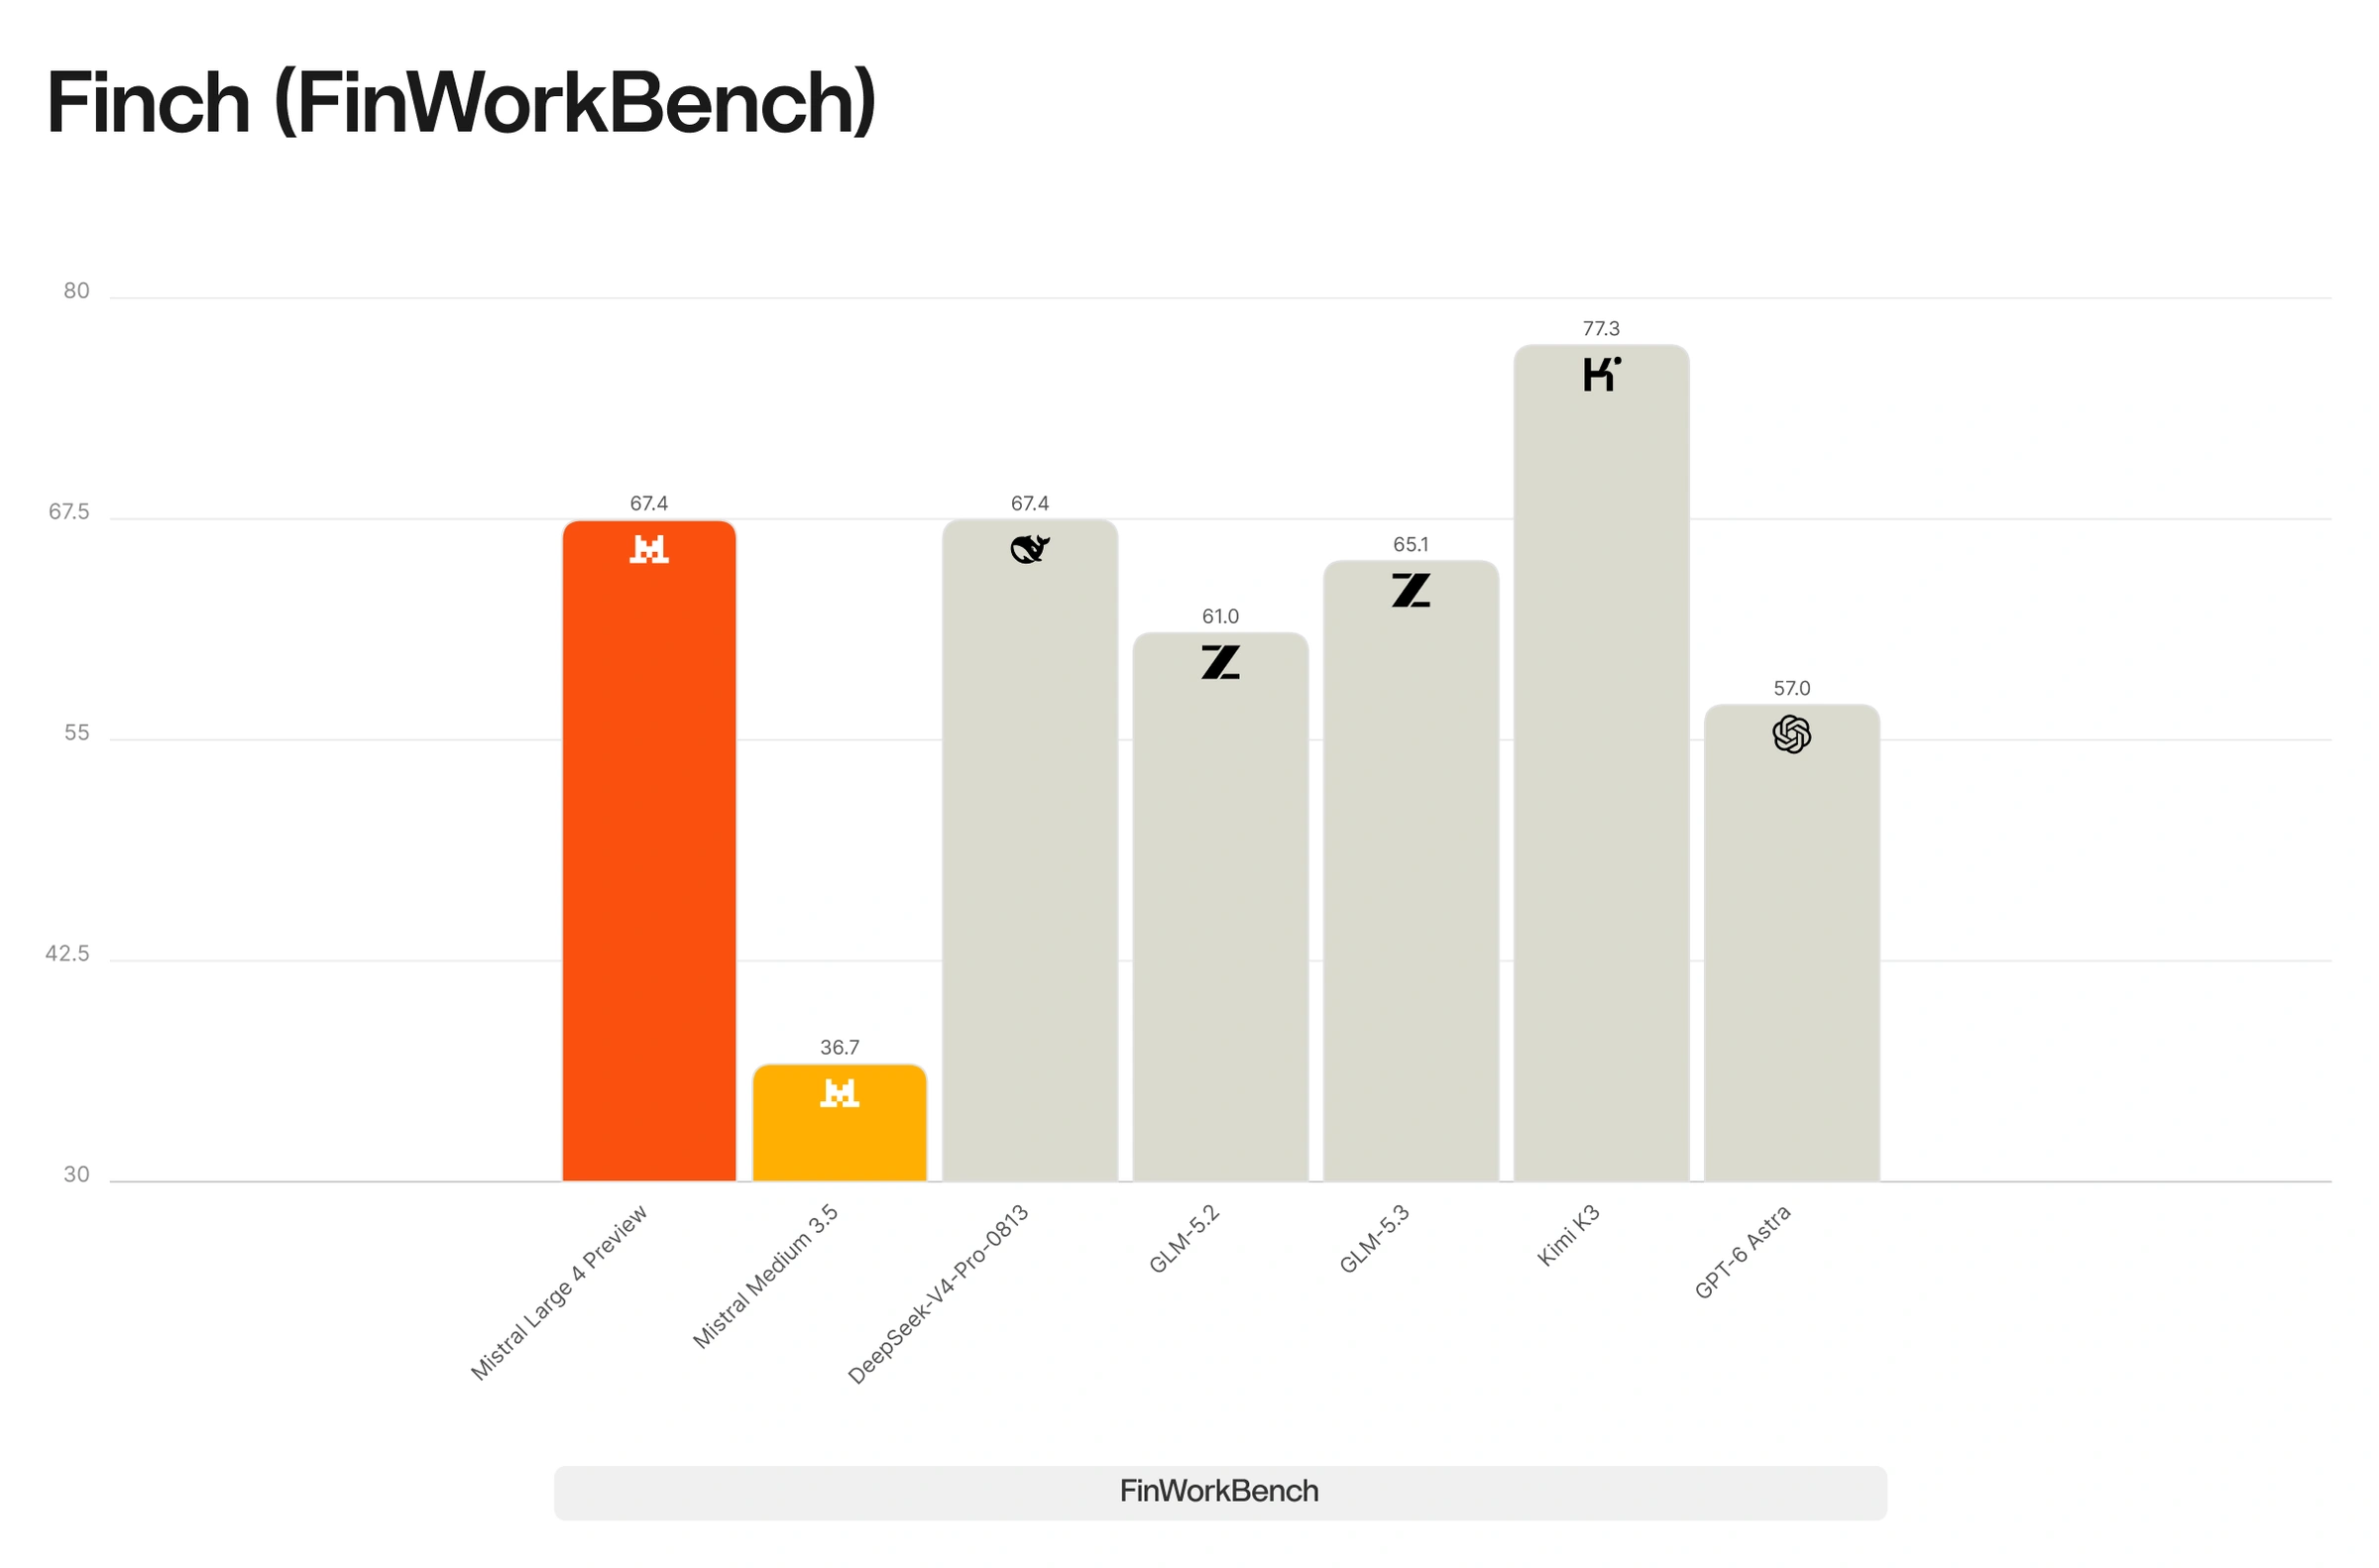
FinWorkBench тестирует способности модели создавать/редактировать электронные таблицы на real life Finance и Accounting примерах использования.
Финансовый анализ требует точности и способности синтезировать информацию из множества источников, процесс, который остаётся время-затратным во многих финансовых учреждениях сегодня. В этой демонстрации ML4 в сравнении с другими топ OSS моделями берёт на себя ту же многошаговую задачу корпоративных финансов, поиск через публичные компаний filings и финансовые отчёты, такие как доступные через EDGAR и эквивалентные европейские базы. Анимированная семантическая карта отслеживает путь каждой модели к решению, подсвечивая каждый полученный документ. Позиция каждого трека отражает собранные доказательства, результаты вычислений и вопросы, которые остаются нерешёнными. Зрители могут следить как развёртываются расследования и сравнивать различные пути каждой модели перед прибытием к финальному ответу.
Безопасность модели
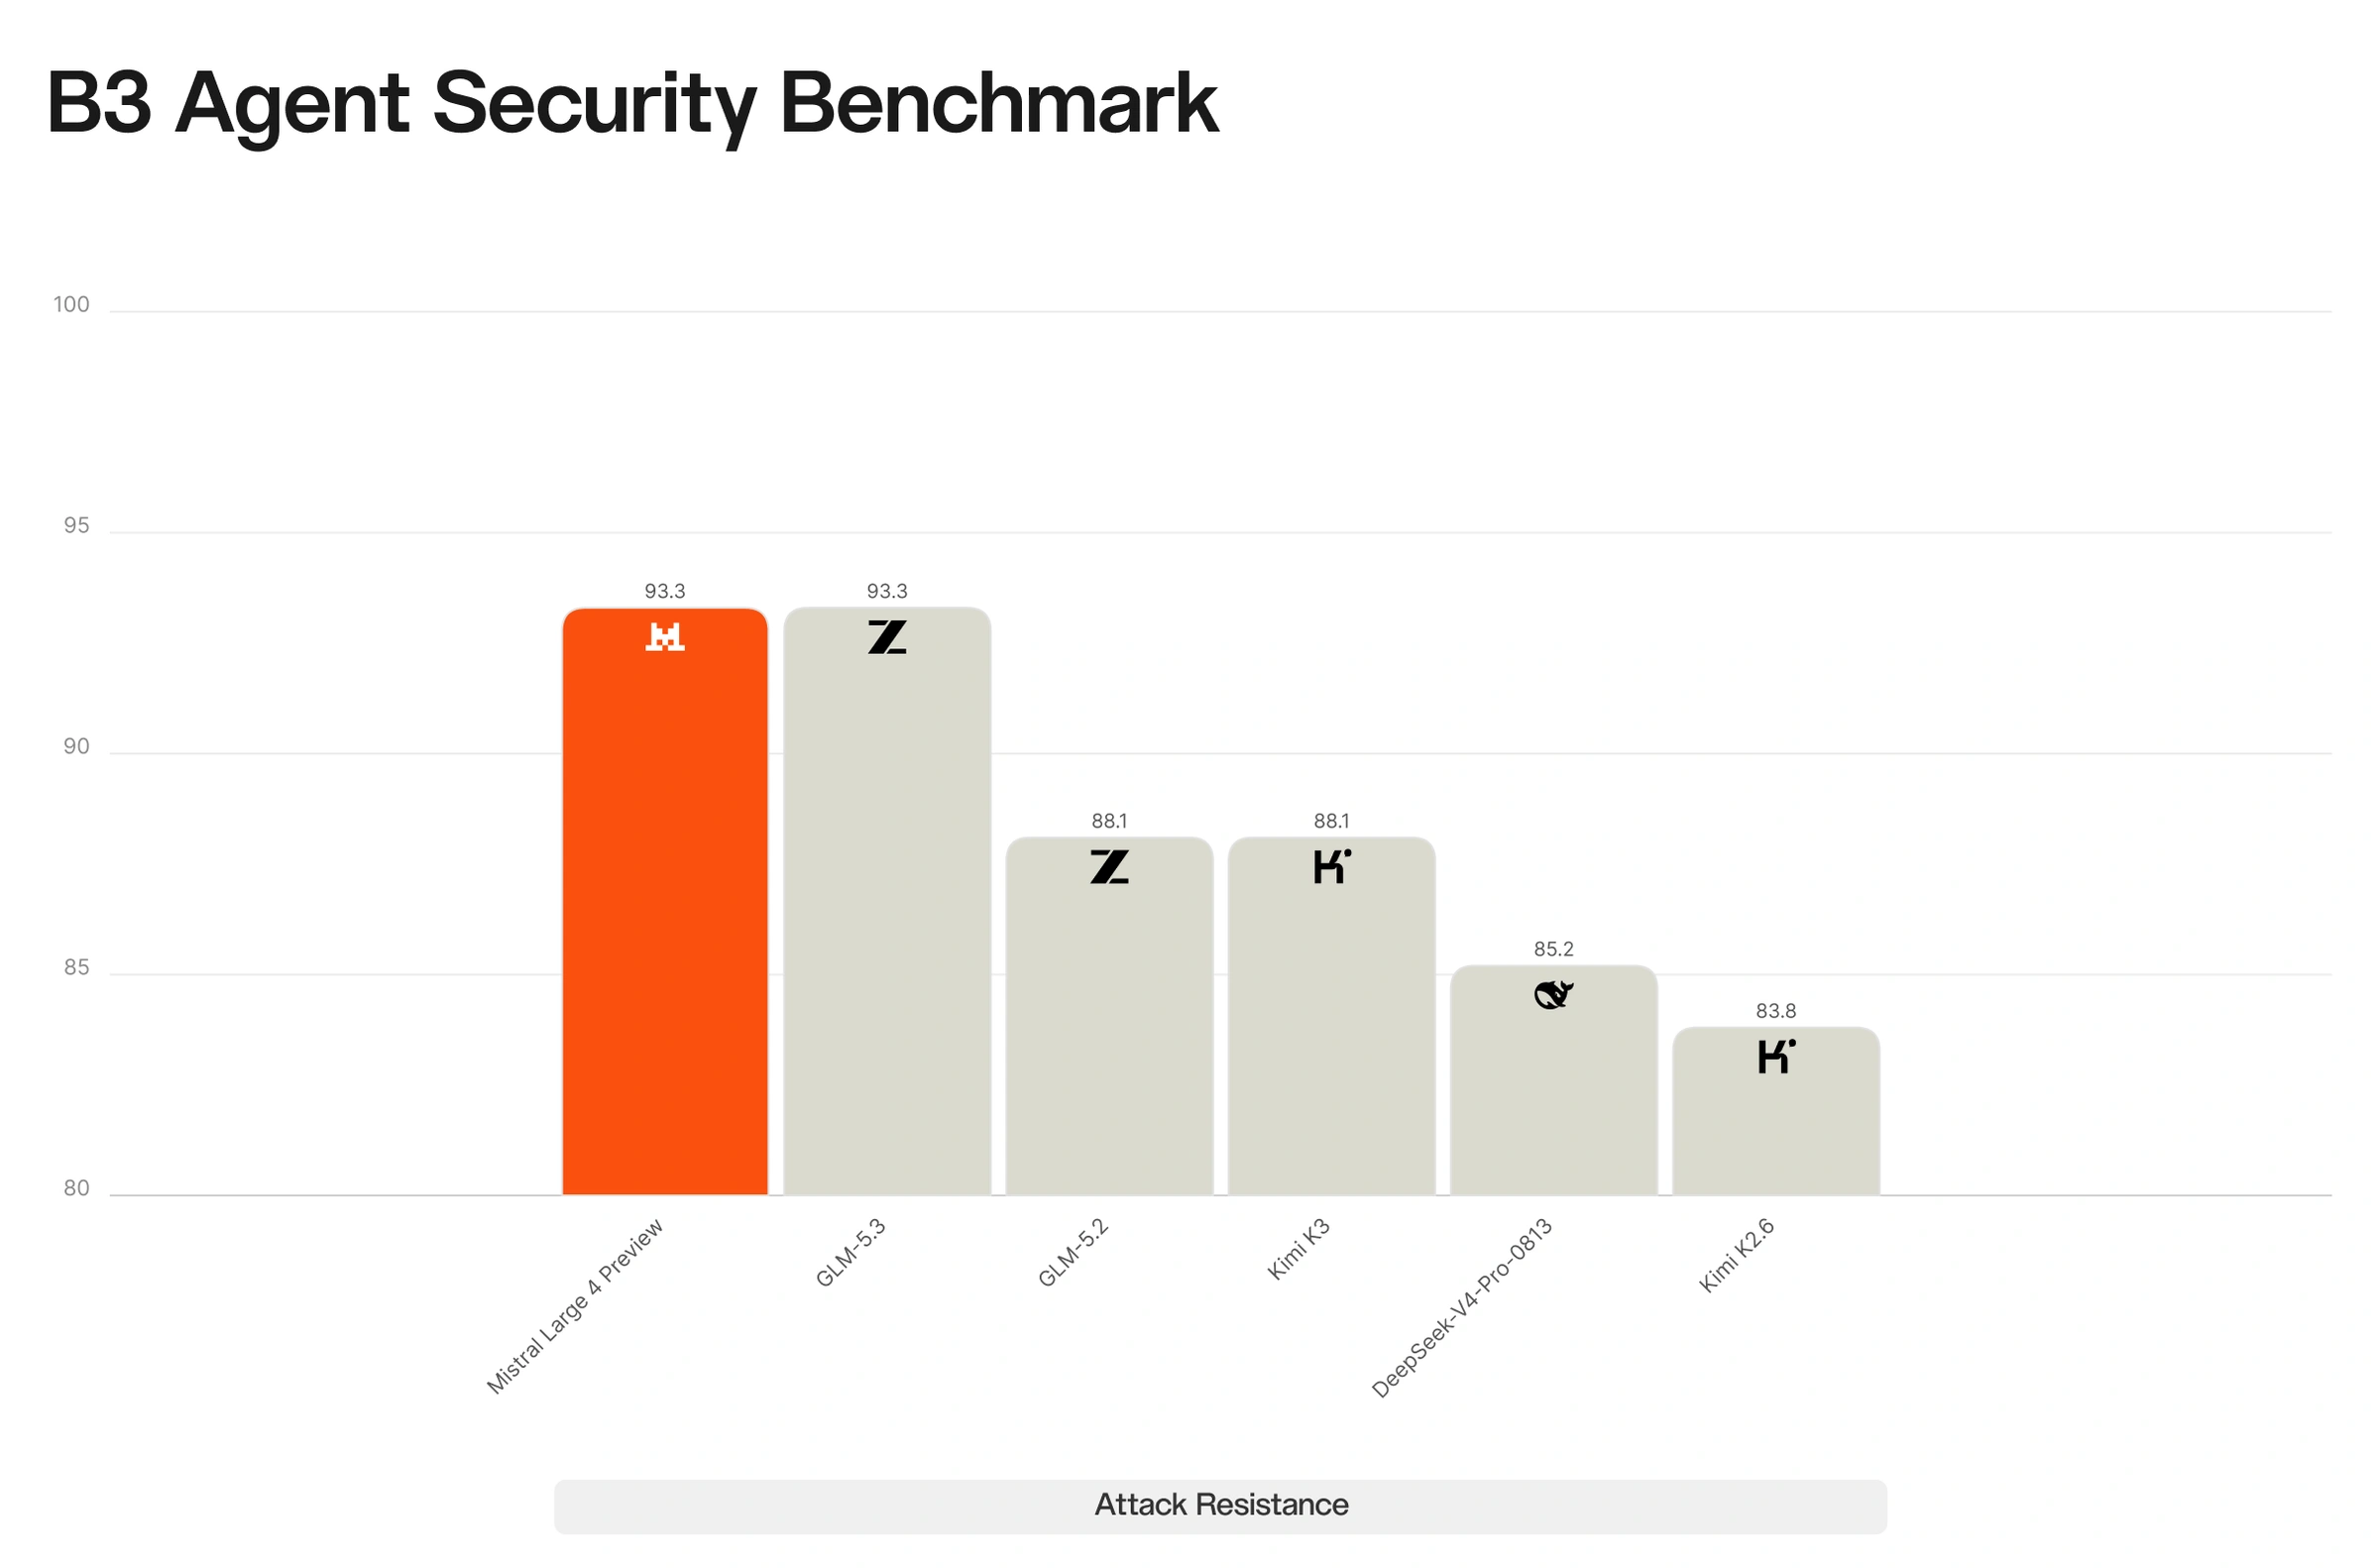
ML4 насыщена нашими бенчмарками на робастность к indirect prompt injections, помещая её на границу OSS моделей (в сравнении с GLM-5.2, GLM-5.3, Kimi-K2.6, Kimi-K3, DS-V4-Pro-0813). На публичном B3 AI Security Benchmark от Lakera, ML4 устойчива к 93,3% атак — мы не видим более высоких результатов среди конкурентов.
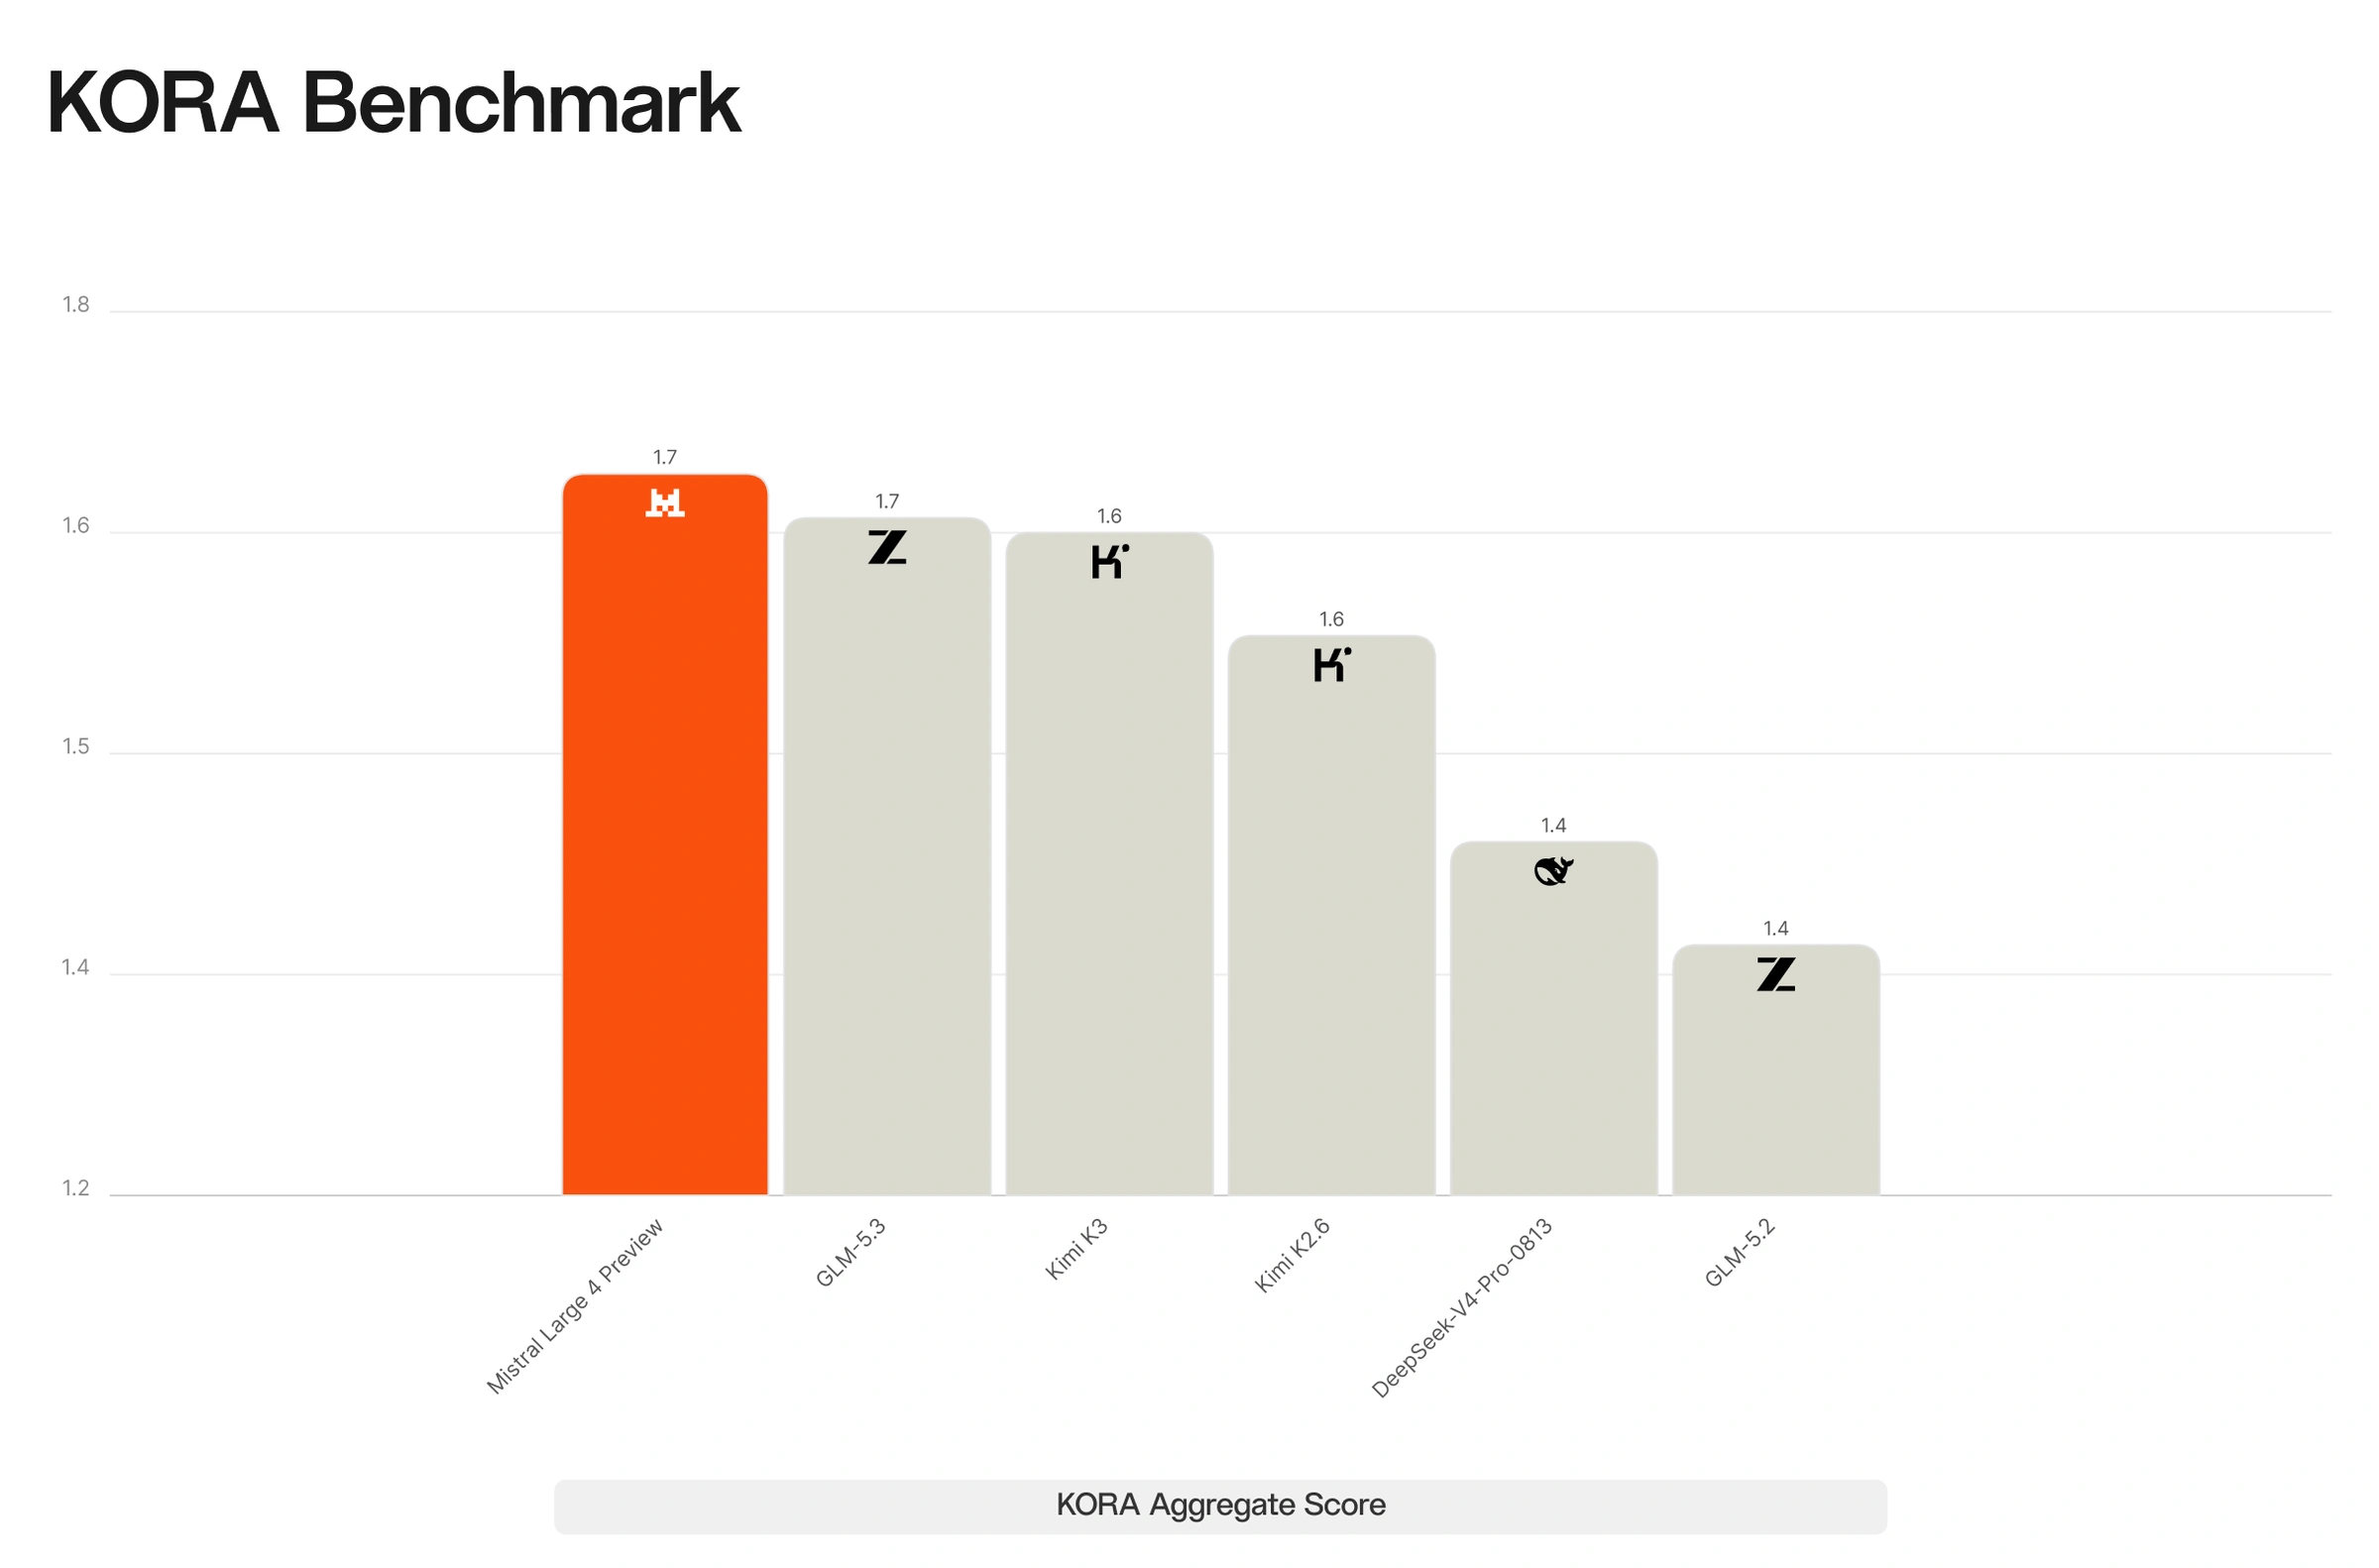
ML4 также более ответственно взаимодействует с пользователями чем любая из предыдущих моделей. Подчеркиваем наши результаты на KORA Benchmark, где ML4 снова сидит на нашем наивысшем измеренном результате среди OSS моделей (1.691, с 2 являющейся максимумом обозначенным как «Образцовый»).
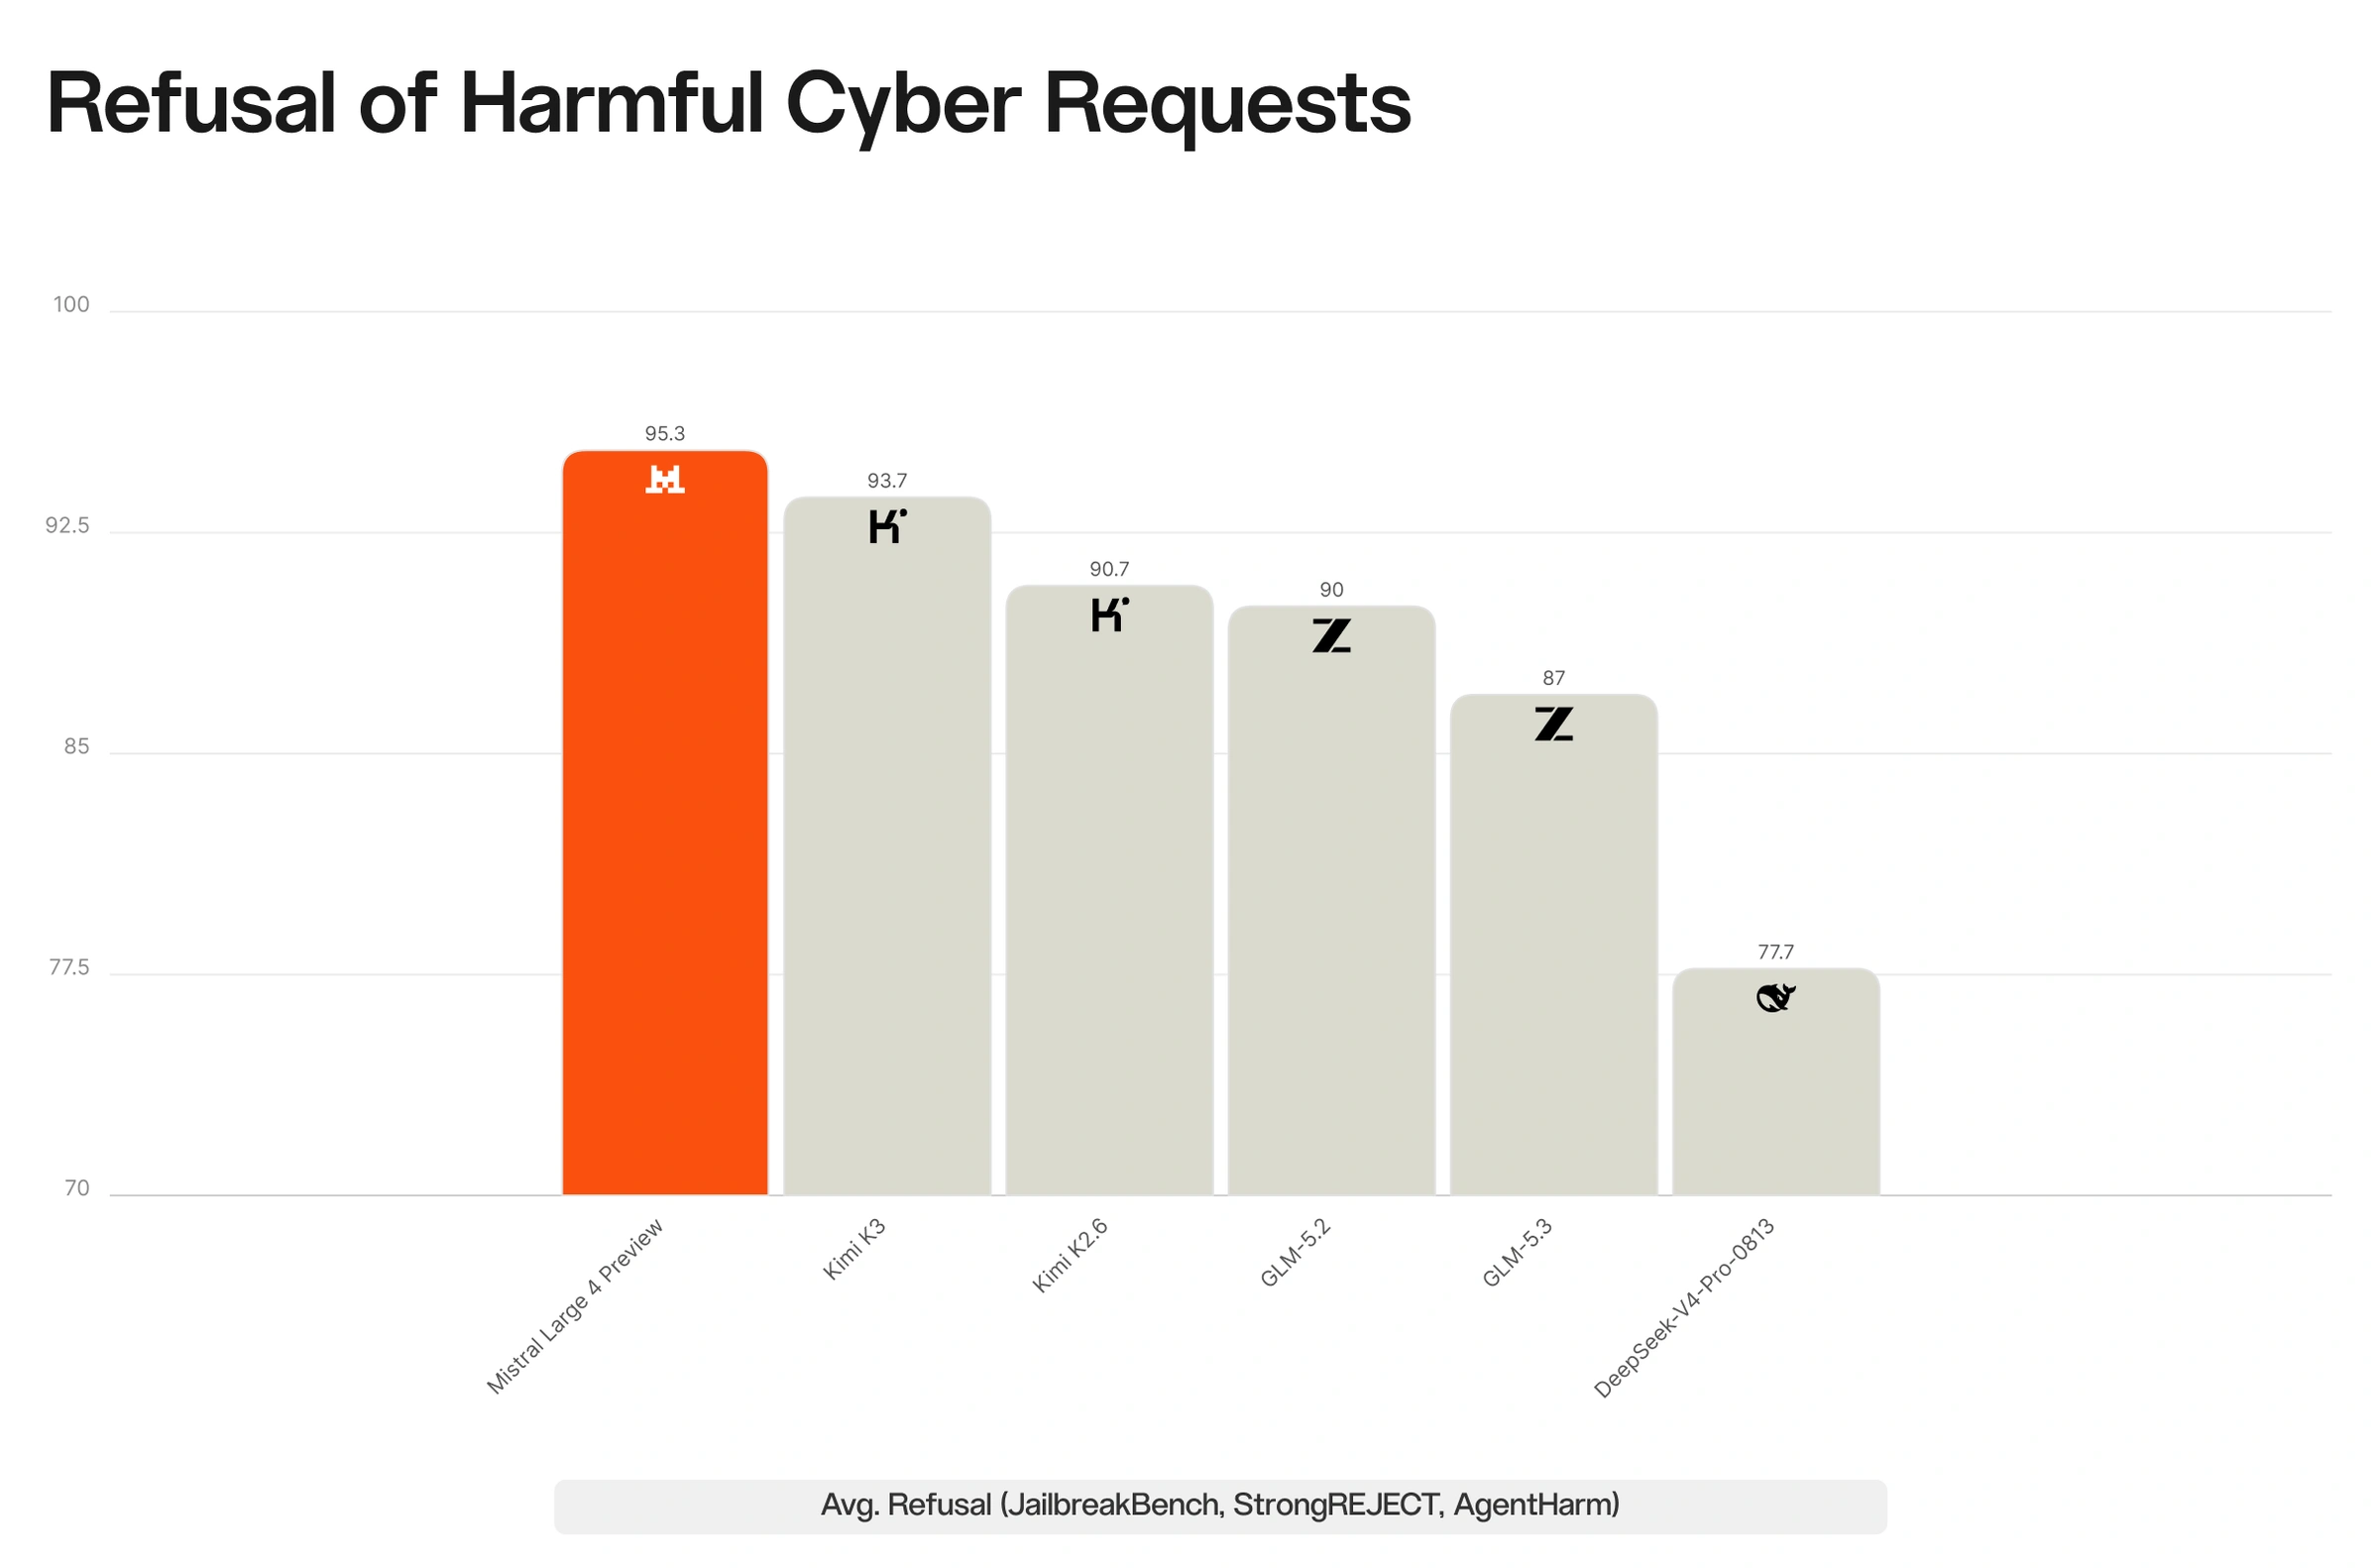
Особенно релевантна склонность модели отказываться от вредоносных запросов касающихся кибербезопасности. Несмотря на сильную производительность на Cyber бенчмарках, средний уровень отказа модели на киберзапросах из JailbreakBench, StrongREJECT и AgentHarm выше чем у всех OSS моделей.
Оценка человеком
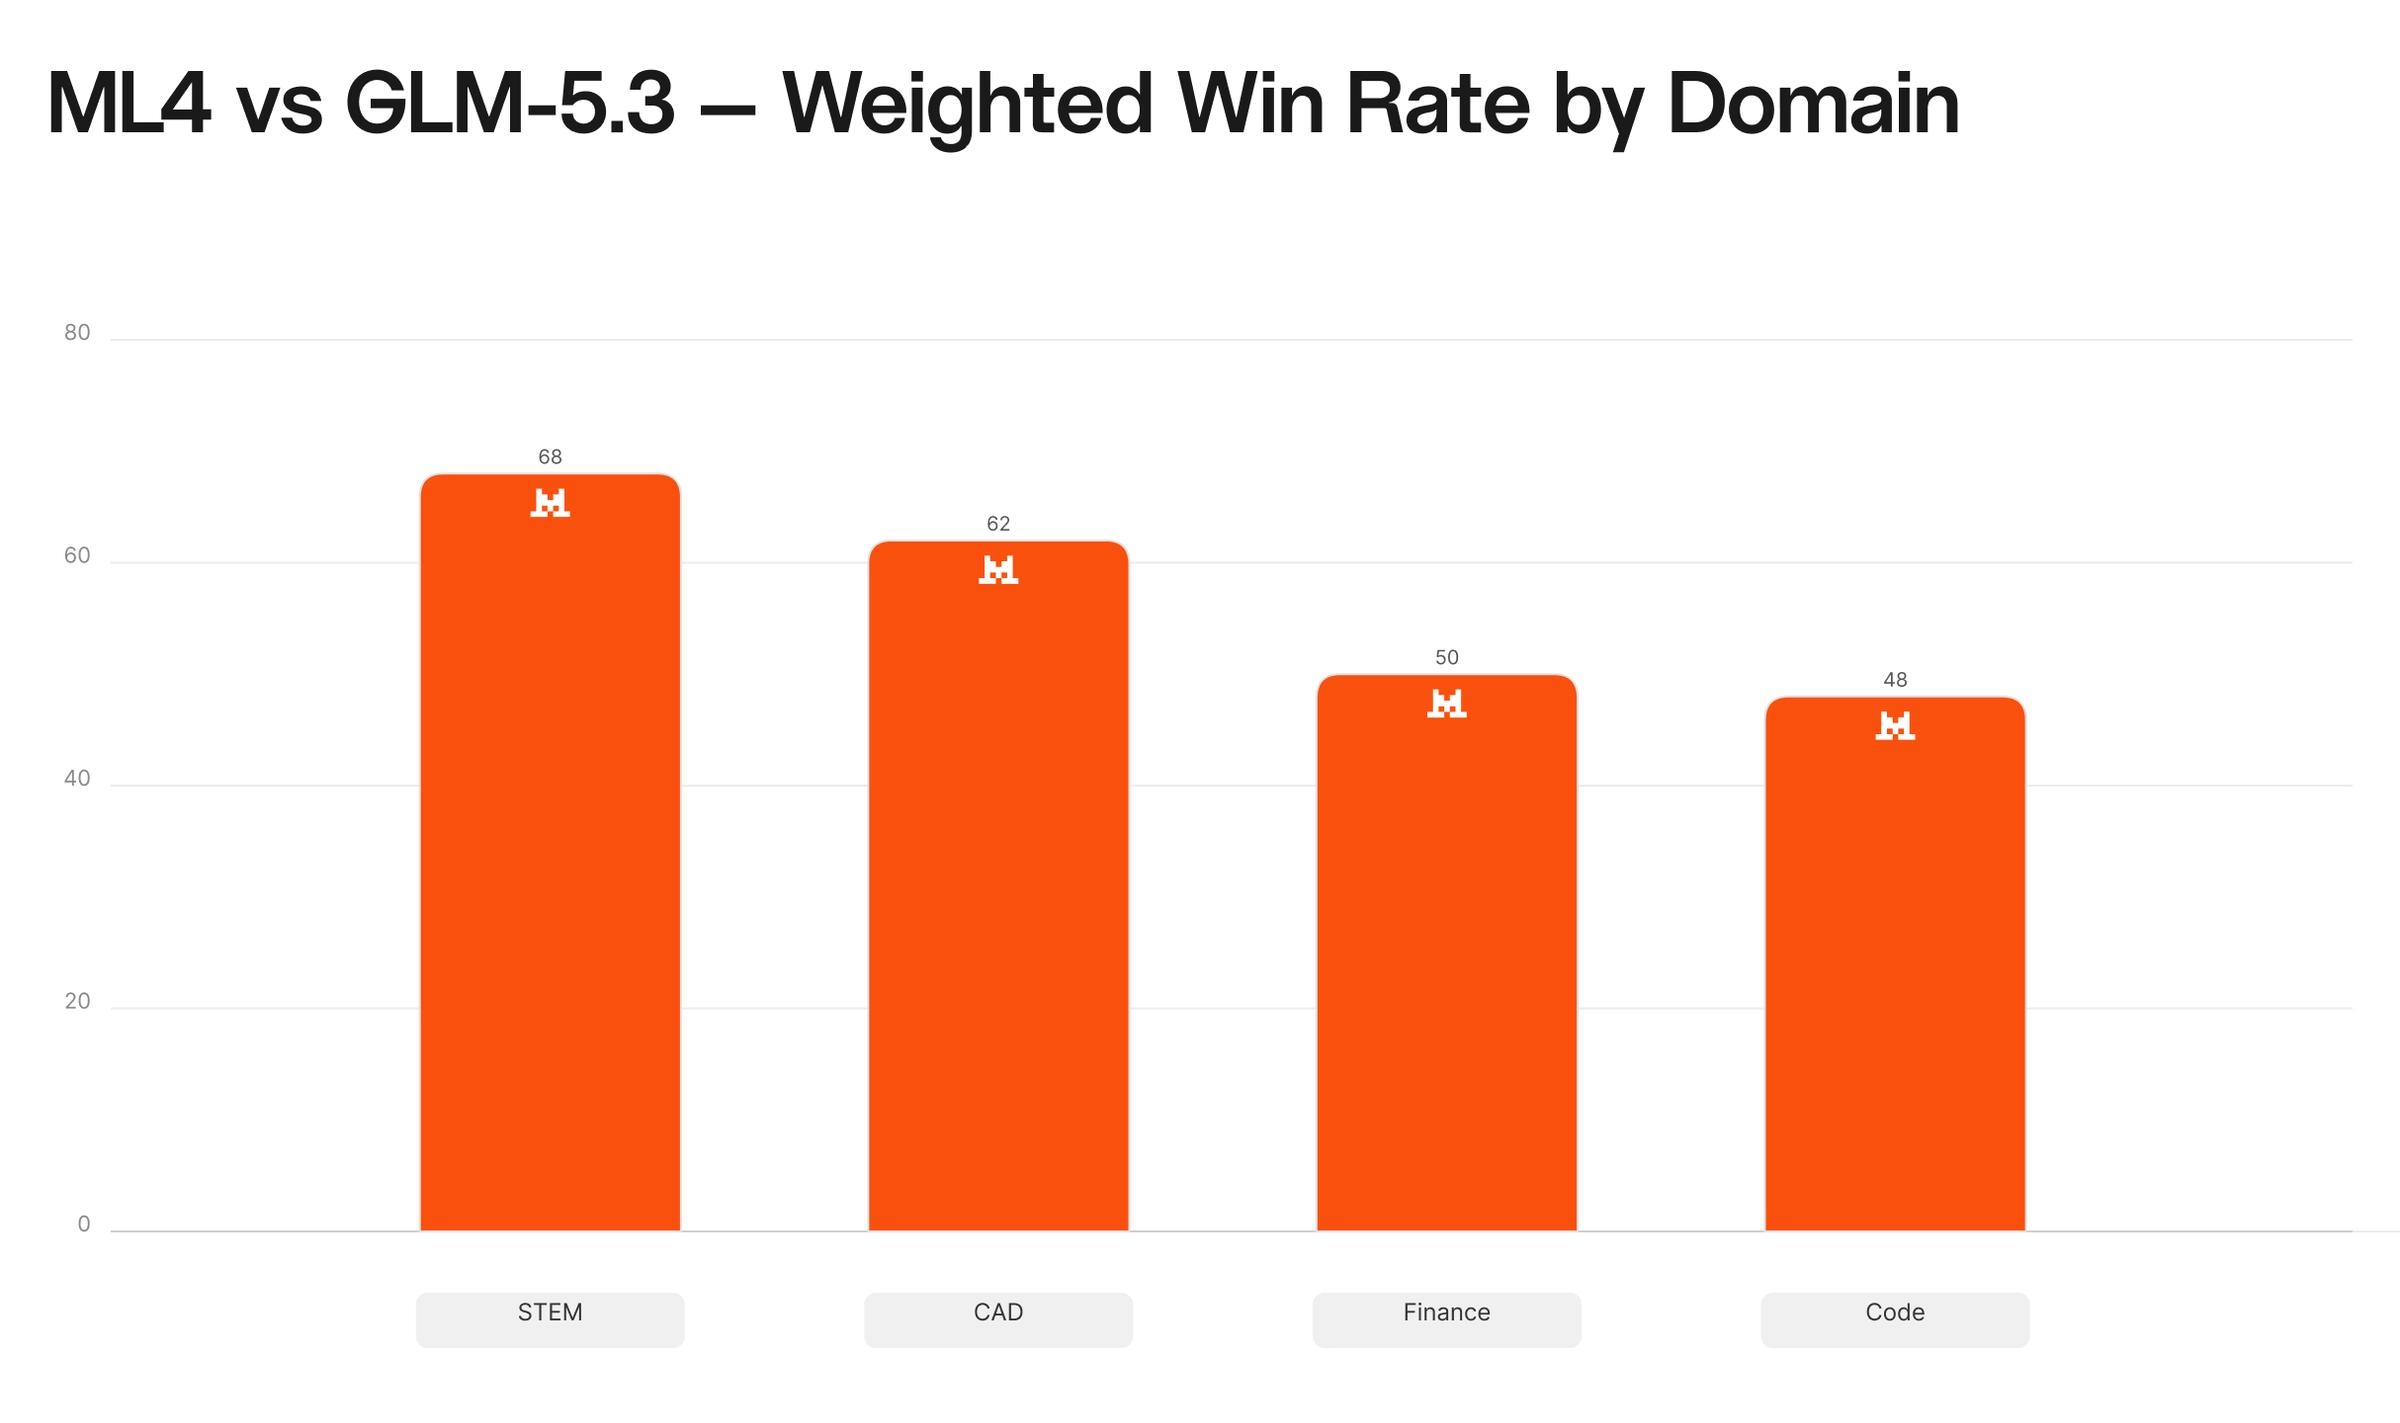
Провели внутреннюю оценку, в которой expert аннотаторы в кодировании, компьютерном дизайне (CAD), финансах, математике и физике сравнили Mistral Large 4 с GLM-5.3. ML4 была предпочтена в CAD и STEM, в то время как показала ровную или близкую производительность к GLM-5.3 в финансах и кодировании.
Reinforcement learning в масштабе
Base модели совершенствуются быстро, и post-training должна идти в ногу. Рецепт, настроенный на модель вчерашнего дня, оставляет способность на столе у frontier модели сегодня, потому что ground truth примеры, которые когда-то толкали модель к пределам, не будут больше. Используем Reinforcement Learning (RL), потому что она адаптируется как модель: тренируем на результатах собственных попыток модели, и можем поднять сложность и ширину задач как она становится сильнее.
RL библиотека была разработана чтобы сделать новые окружения легко добавляемыми и тренируемыми в масштабе. Разделённый, компонуемый интерфейс позволяет одному training run объединять задачи от single-turn chat и сложного научного решения проблем до safety alignment, factuality и long-horizon tool use. Эти окружения разделяют скаффолды и ресурсы такие как code sandboxes, web search и external APIs. Та же компонуемость распространяется на верификацию, с reward models, unit tests, LLM judges и static checks объединёнными как необходимо для каждой задачи.
В runtime, автоскейлящаяся флота акторов генерирует десятки тысяч rollouts параллельно в то время как training модели идёт асинхронно. Pipeline генерации и training оптимизирована для long trajectories, поддерживая rollout бюджеты миллионов токенов через несколько compactions при сохранении staleness низкой. Новые методы и оптимизации через обе стадии минимизируют off-policy drift и включают stable RL над long horizons.
В нашем текущем масштабе (3k GPUs), один training run производит примерно 33 миллиарда токенов в день, из которых примерно 16 миллиардов trainable completion токенов после фильтрации и маскирования. Можем видеть progress run прямо в training rollouts: training rewards поднимаются через несколько representative окружений как policy учится решать всё более сложные задачи. Ниже несколько примеров.
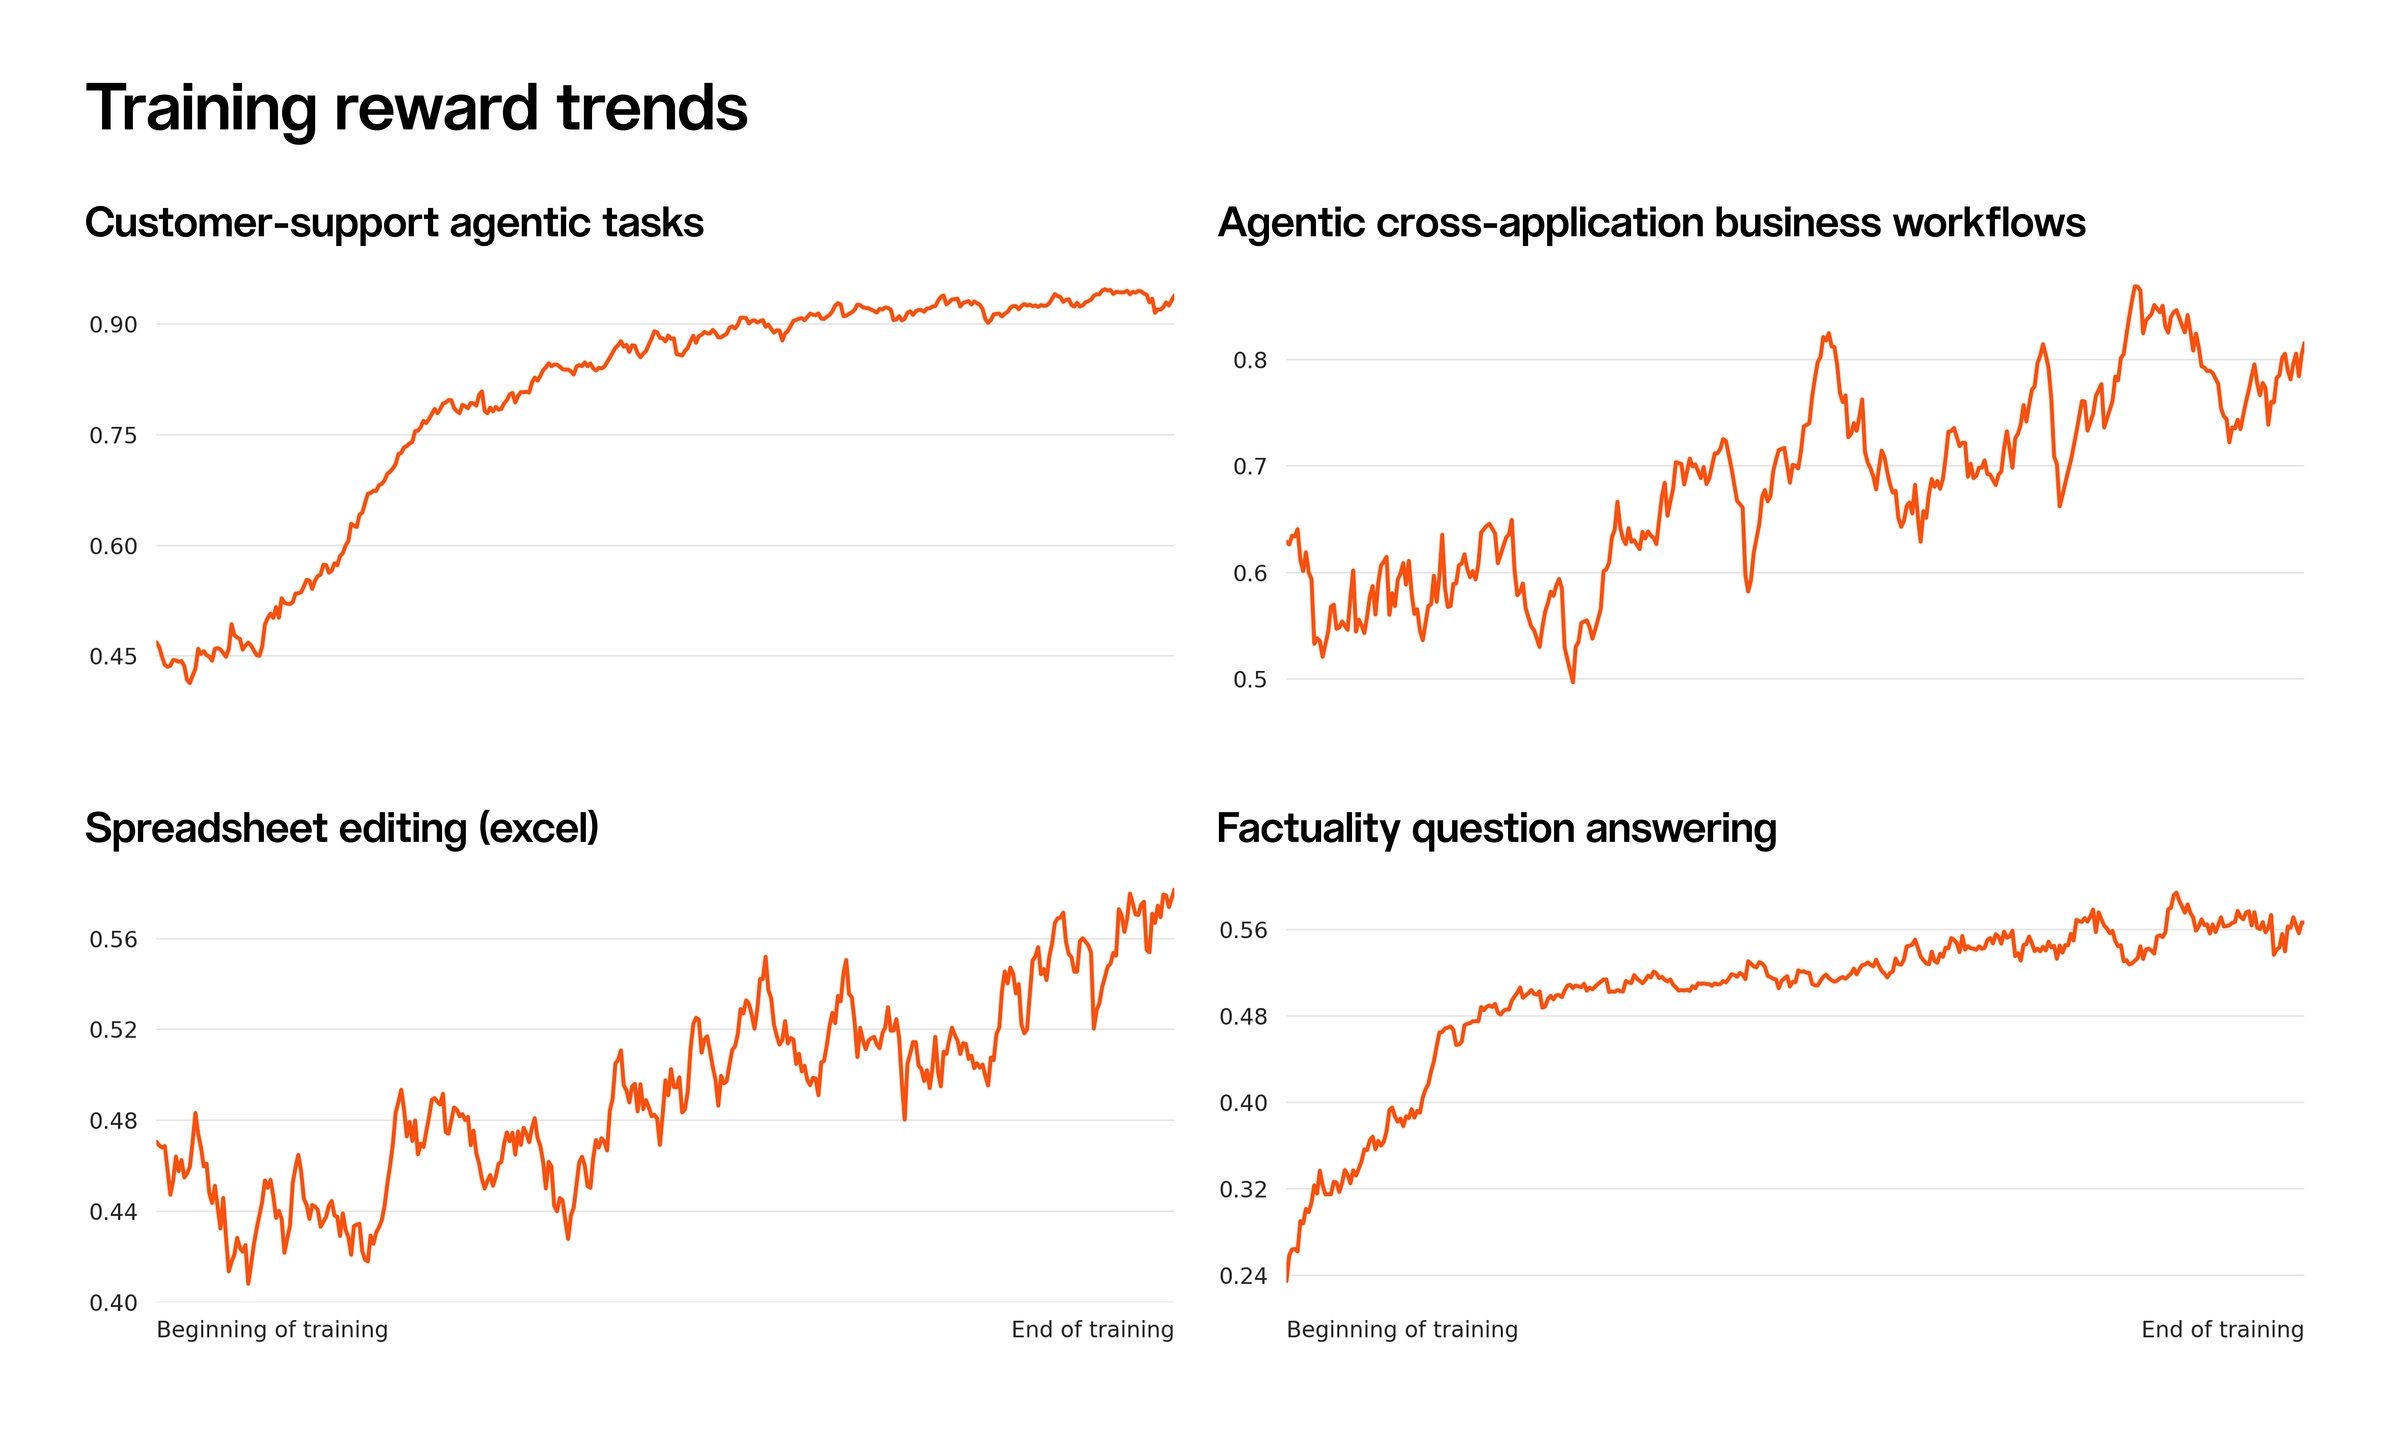
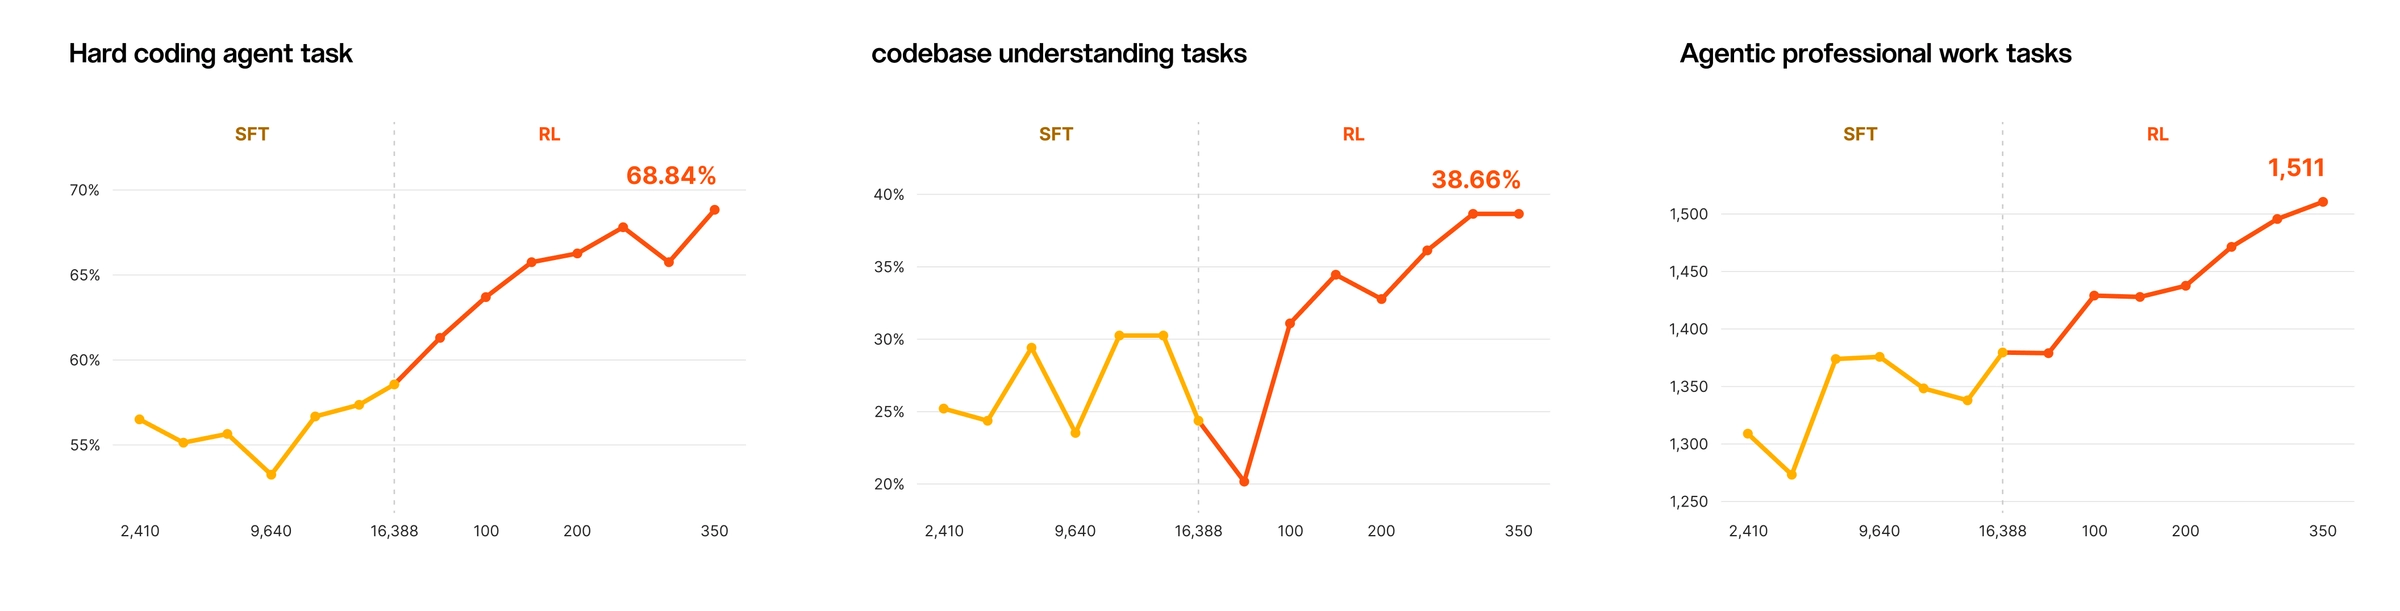
Улучшения не специфичны окружениям на которых тренируем; они переносятся на downstream evals, и финальная модель им обязана обеим post-training стадиям (supervised fine-tuning и RL), как показано на графиках.
Что дальше
Это только начало. ML4 — первый миль-стоун на roadmap, финансируемый €3 миллиардным Series D — крупнейшим раундом акционерного финансирования, когда-либо привлекаемым европейской технологической компанией. Этот капитал уже введен в работу: значительно масштабируем мощность вычислений в собственных европейских дата-центрах, и намного больше поступит в течение ближайших месяцев.
Больше вычислений означает больше обучения. Reinforcement learning run позади этого preview всё ещё в пути, и модель не показывает признаков насыщения — есть существенный простор впереди. По мере масштабирования обучения на расширенной инфраструктуре, ожидаем большие и быстрые улучшения в недели и месяцы впереди.
Веса будут выпущены в конце месяца, вместе с дополнительными деталями на архитектуру, дополнительными бенчмарками и post-training методологией. И ML4 — только основание: она будет служить базой для нового поколения специализированных и оптимизированных моделей Mistral, построенных для отраслей и рабочих нагрузок, которые волнуют клиентов больше всего.
Темп прогресса отсюда будет быстрым. Следите за новостями.