Mercury 3 в двух словах
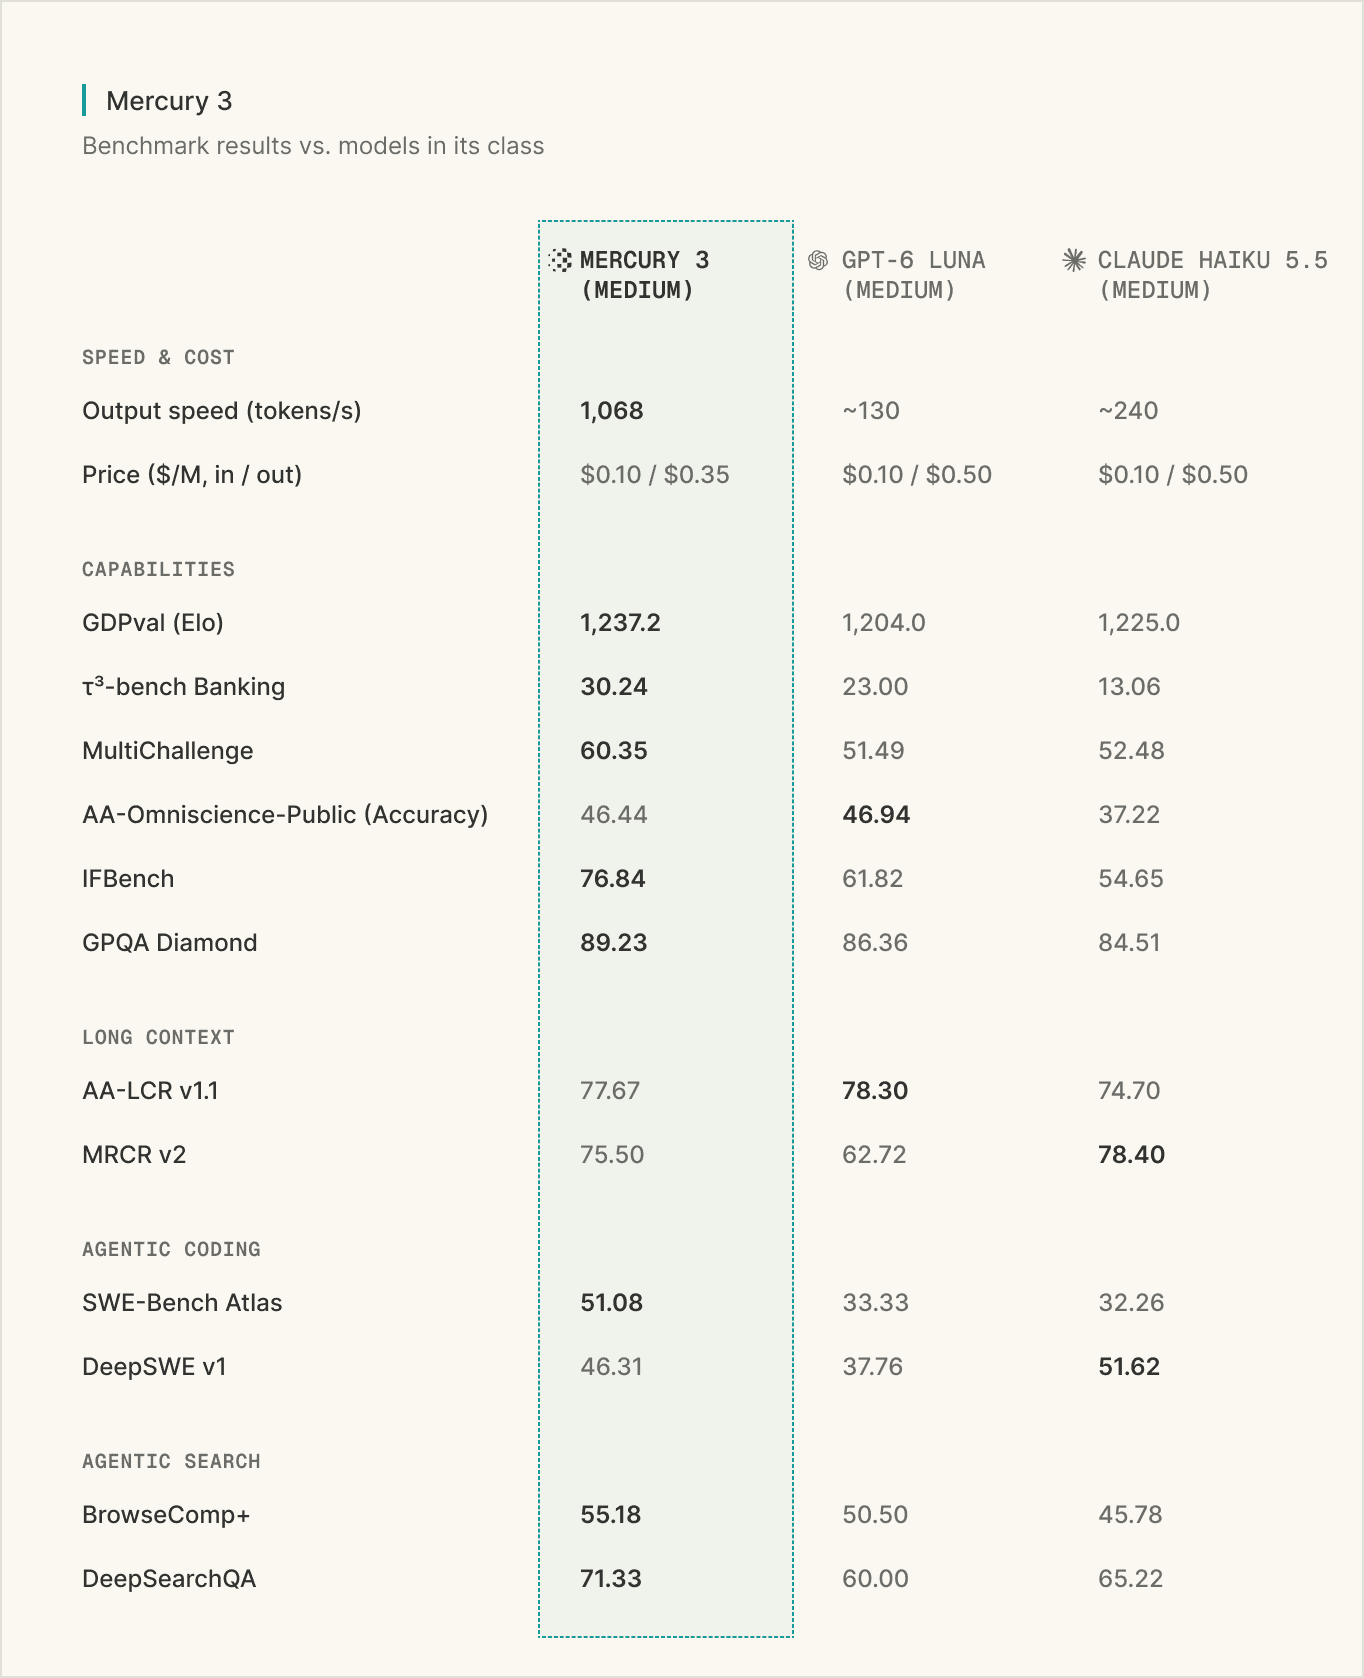
Качество: на уровне или выше, чем у ориентированных на скорость фронтир-моделей вроде GPT-6 Luna и Claude Haiku 5.5.
Скорость: 1068 токенов в секунду на GPU NVIDIA.
Контекст: 1М токенов, рост с 260K в Mercury 2.5.
Цена: $0,20 за миллион входящих и $0,70 за миллион исходящих токенов.
При запуске Mercury 3 стоит на 50% дешевле — $0,10 за 1М входящих и $0,35 за 1М исходящих. Закешированные токены обходятся на 90% дешевле входящей цены.
Диффузия в масштабе
Когда выпустили Mercury 1, это был первый proof point того, что диффузионные LLM можно строить для коммерческих приложений. Вопрос, который обсуждали в AI-сообществе: могут ли диффузионные LLM масштабироваться и конкурировать с autoregressive моделями на сложных задачах?
Mercury 3 отвечает на этот вопрос утвердительно. Модель выросла более чем в 40 раз по числу параметров, при этом интеллект на наборе стандартных бенчмарков увеличился в 3 раза — от Mercury 1 (mini) к Mercury 3. Масштабирующие законы, которые двигали прогресс в autoregressive моделях, работают и для диффузии.
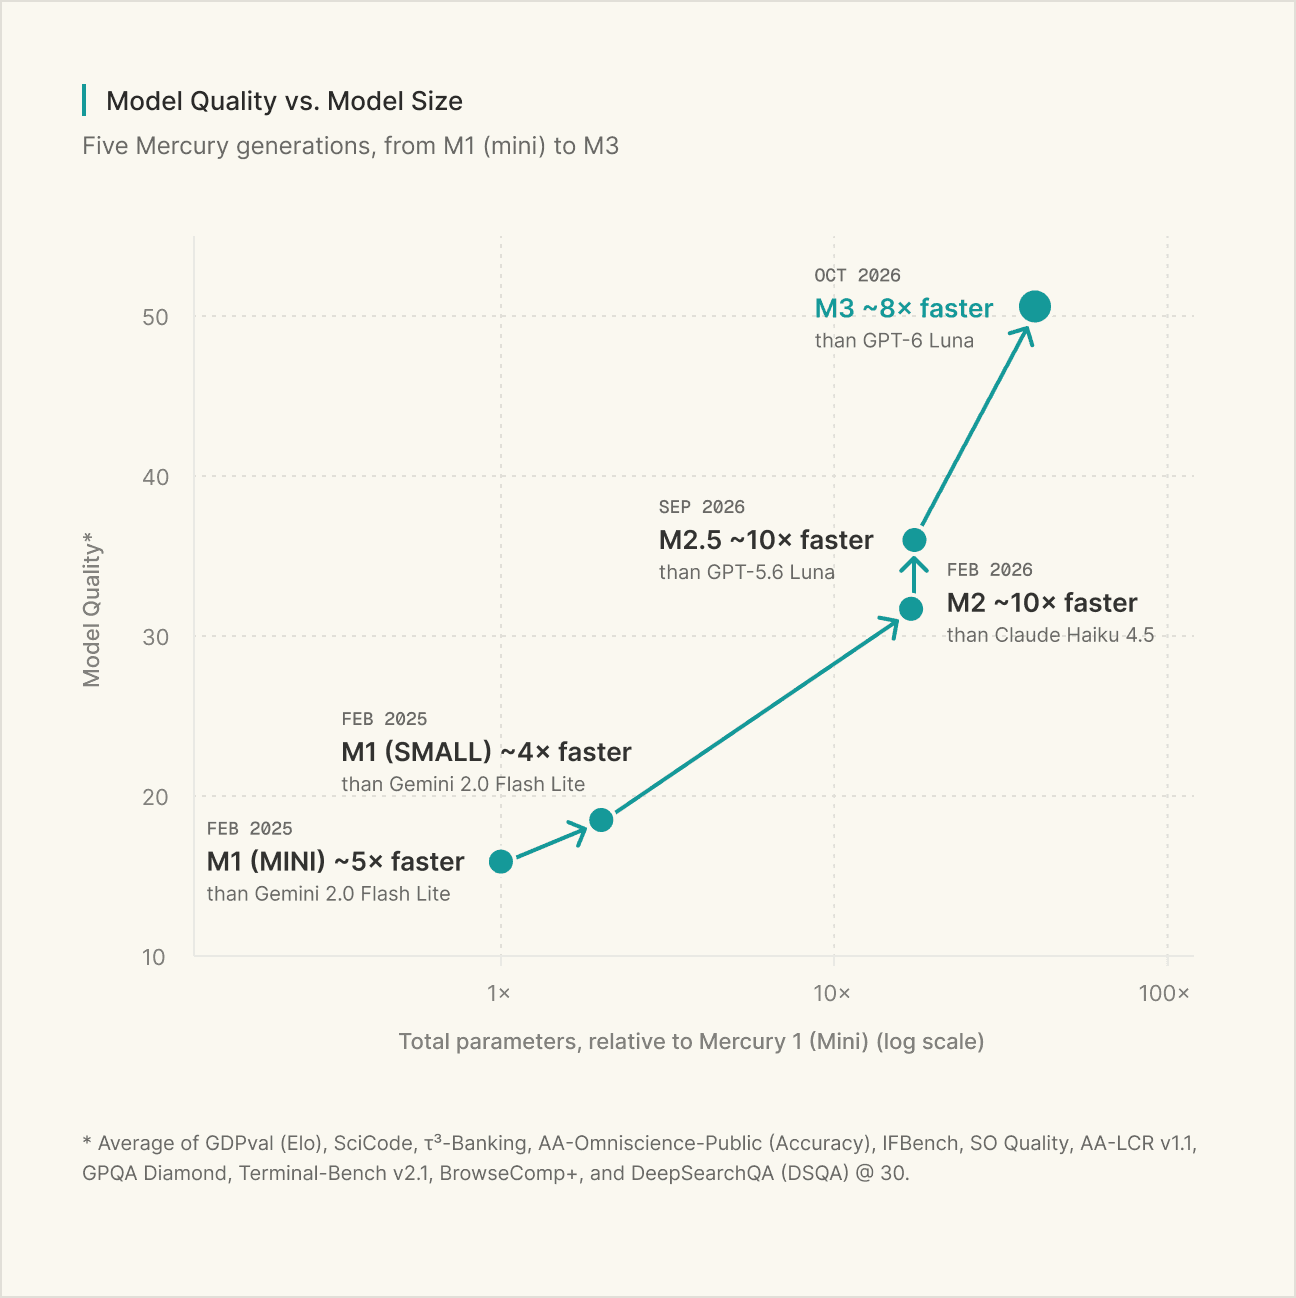
Mercury 3 в production
Партнёры, получившие ранний доступ, уже используют Mercury 3 для питания приложений, чувствительных к задержкам: браузерные агенты, интерактивное обучение, поисковые агенты реального времени и служба поддержки клиентов.
Браузерные агенты
Агенты ожидают ответа модели на каждом шаге, поэтому даже небольшие задержки быстро накапливаются. Mercury держит каждый проход быстрым, независимо от того, навигирует ли агент по сайтам, ищет информацию или анализирует логи и трассирует инциденты. Агенты завершают задачи быстрее и имеют время попробовать больше подходов перед ответом.
Мы запустили Mercury 3 внутри нашего production harness для веб-агентов, протестировав на 50 реальных задачах навигации из Mind2Web. Mercury 3 решила 50% из них — значительно больше, чем GPT-6.1-Sol. При этом используя тот же объём токенов и то же число шагов агента, что и фронтир-модель, но по дроби от цены за токен.
— Shuhao Zhang, Cofounder, TinyFish AI
Интерактивное обучение
Обучение работает на циклах быстрой обратной связи, и любая задержка выбивает студента из потока материала. Mercury рассуждает через каждый запрос и отвечает почти мгновенно — будь то голосовой репетитор, ведущий беседу, помощник, проверяющий работу, или приложение, адаптирующее следующий вопрос в зависимости от того, что студент только что решил неправильно.
Mercury 3 дал нам возможность давать каждому студенту моментальную обратную связь, не жертвуя рассуждениями. Подсказки, отмеченные ответы и определения теперь возвращаются примерно за секунду, с качеством не хуже или лучше, чем у моделей, которые мы использовали раньше. Когда студент застрял на вопросе, такая скорость заставляет его работать вместо ожидания — и это была простая замена в нашем существующем стеке.
— Michael Tong, Co-founder/CTO, General Learning aka RevisionDojo
Поисковые агенты реального времени
Приложения поиска начинают казаться неотзывчивыми после задержки в несколько секунд. Mercury 3 работает достаточно быстро, чтобы обработать десятки документов и всё ещё ответить, пока пользователь в фокусе.
На смарт-очках ответ, который занимает пять секунд, кажется сломанным. В тестах нашего Sense API поиск Octen занимал около 80ms; узким местом было генерирование модели. Mercury 3 доставила лучший баланс скорости и качества среди быстрых моделей, которые мы тестировали, с медианным временем генерирования 0,9 секунды и медианным end-to-end временем ответа 2,2 секунды.
— Kuan Zou, Founder & CEO, Octen AI
Служба поддержки клиентов
Агенты поддержки должны отвечать быстро, часто для регулируемых бизнесов, где неправильный ответ обходится дорого. Mercury держит ответы естественными, не жертвуя точностью.
В Lorikeet мы помогаем сложным и регулируемым компаниям построить консьержа для своих клиентов, работающего через голос, чат и электронную почту. В чате и голосе клиентам нужны быстрые ответы, но мы не можем пожертвовать точностью или правильностью выполнения задачи. В ранних тестах Mercury 3 превзошла другие модели по задержкам, при этом показав более высокие результаты на эвалюациях и в production.
— Michael Gribben, Member of Technical Staff, Lorikeet
Портфель продуктов реального времени
Mercury 3 — флагманская модель в расширяющемся портфеле продуктов, позволяющих AI работать в реальном времени.
Mercury Voice: оптимизирована для экстремальных требований низкой задержки голосовых приложений и минимизации времени до первого токена ответа (TTFAT), а не только end-to-end задержки. Уже питает агентов в Audivi AI, Altur и OpenCall.
Mercury Decide: модель решения, построенная для массовой классификации. Превосходит Jev на бенчмарках, включая JevBench и LegalBench.
Начните
Mercury 3 доступна сегодня на Inception API Platform и через OpenRouter, Baseten и Vercel. Она совместима с OpenAI API, поэтому встаёт в ваш существующий стек без переписывания. Enterprise-развёртывания поддерживают выделённую ёмкость, автомасштабирование, элементы управления соответствием и настраиваемое сохранение данных.
Попробуйте API со 100 миллионами бесплатных токенов
Enterprise-эвалюации: мы будем работать с вами над соответствием рабочей нагрузки, дизайном эвалюации и производительностью при ваших ограничениях обслуживания. Свяжитесь с нами.