Меньше потребления памяти для небольших пакетов
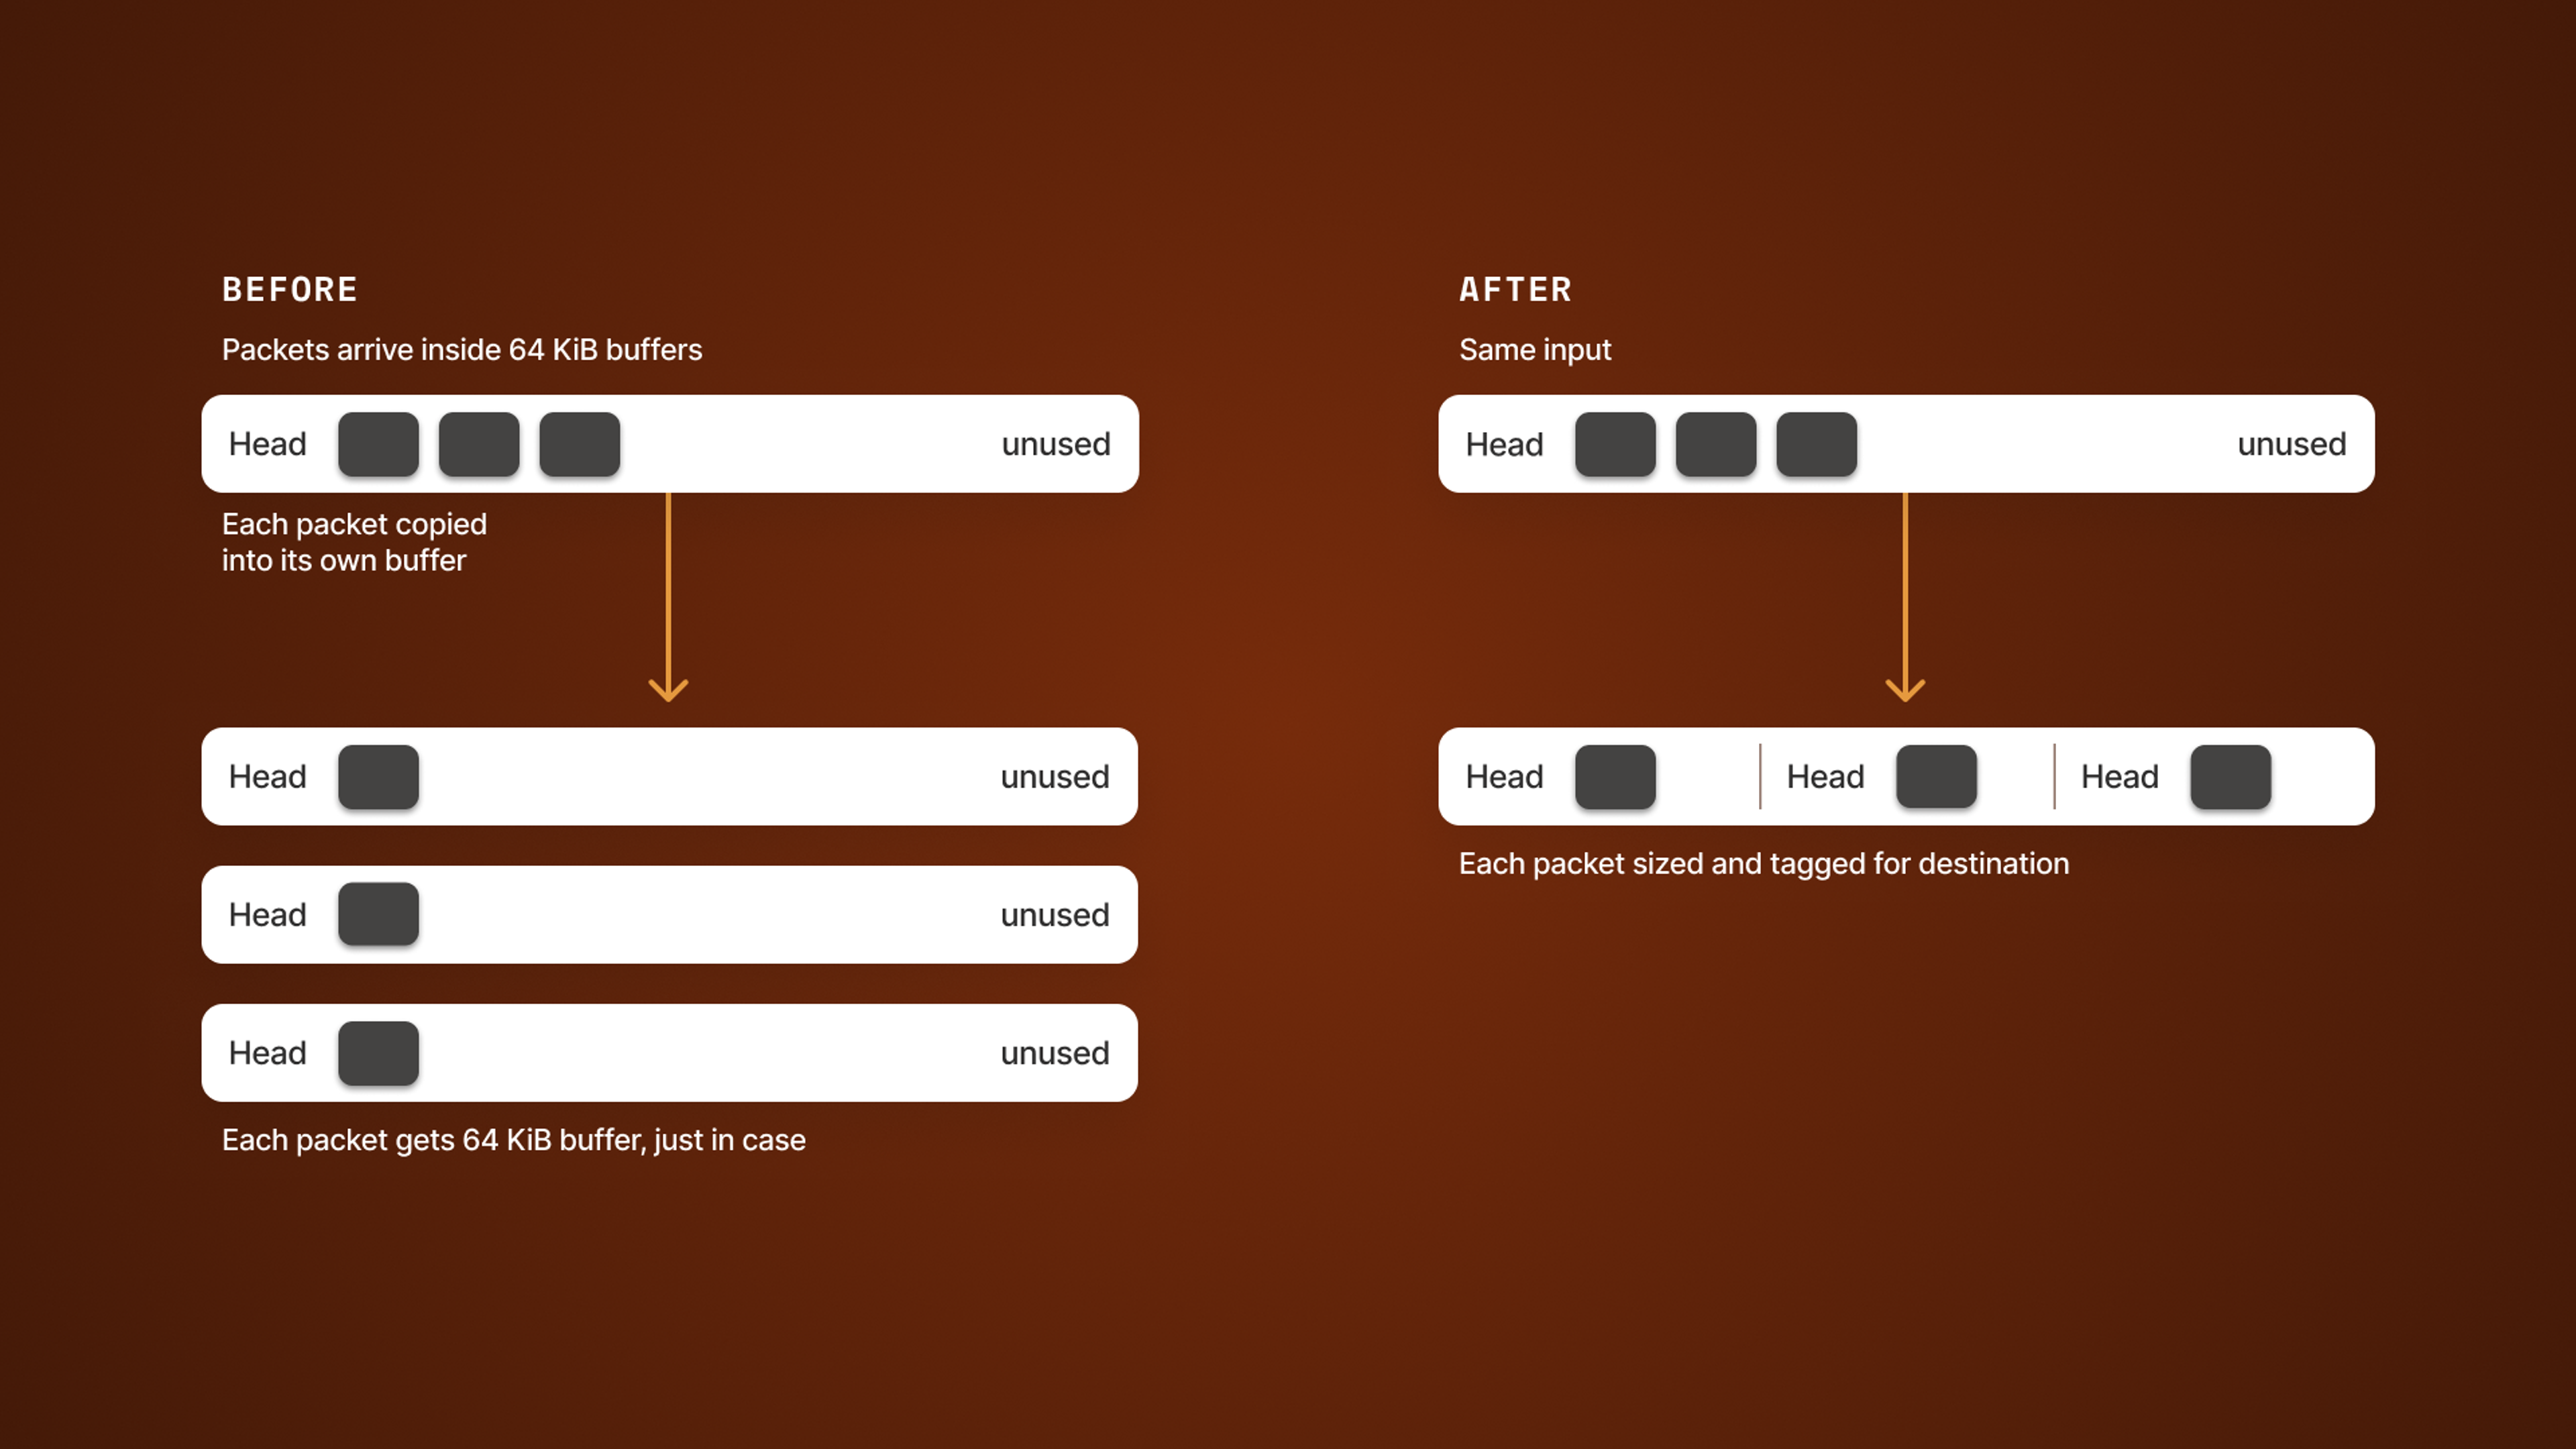
Большинство сетевых пакетов невелики — примерно 1 КиБ. Но чтобы использовать самые эффективные инструменты Linux, например Generic Receive Offload (GRO), Tailscale должен быть готов одновременно принять 64 КиБ трафика. Это похоже на контейнерную доставку: порты, корабли и грузовики рассчитаны на контейнеры одного размера, независимо от того, насколько они заполнены.
Tailscale должен распаковать эти контейнеры — каждый пакет расшифровывается и доставляется отдельно. Реализация wireguard-go, которая обеспечивает криптографию и сетевую функциональность Tailscale, предоставляет только один буфер размером 64 КиБ для распаковки. Таким образом, пакет размером 1 КиБ копируется в собственный 64-килобайтный буфер каждый раз. Это явная цель для оптимизации.
На Linux и Android Tailscale теперь оставляет пакеты там, где они приземлились. Система определяет, где начинается и заканчивается каждый пакет внутри одного большого чтения, вместо того чтобы копировать его в новое место. Небольшие пакеты остаются небольшими в памяти, многие используют одно выделение, и они тратят меньше времени на копирование. Само по себе это привело к приблизительно 5%-ному ускорению во многих конфигурациях сети.
Отдельно мы сократили очереди пакетов — линии, в которых пакеты ждут между этапами конвейера. Очереди нужны для поглощения всплесков трафика. Тестирование показало, что большая часть их глубины не использовалась, тогда как более короткие очереди означали меньше времени ожидания и меньше затрат памяти.
Что мы делаем со всем освобожденным пространством в памяти? Мы передали сбережения некоторым из наиболее загруженных узлов: маршрутизаторам подсетей и соединителям приложений.
Многоочередность для маршрутизаторов подсетей, соединителей приложений и узлов выхода
Маршрутизаторы подсетей могут выглядеть совершенно по-разному в разных tailnet. Для того, кто управляет небольшой домашней лабораторией, маршрутизатор подсети может легко обрабатывать небольшой набор устройств 192.168.x.y без Tailscale. Маршрутизатор подсети, находящийся перед облачным развертыванием со сотнями пиров, будет нести значительно больше трафика.
До недавнего времени маршрутизаторы подсетей, соединители приложений и узлы выхода обрабатывали пакеты для нескольких независимых потоков в одном упорядоченном конвейере с одним потоком. Это означало, что один канал использовался совместно несколькими соединениями, потому что принимающее приложение никогда не должно видеть пакеты в неправильном порядке.
Благодаря сокращению объема памяти нам удалось реализовать систему многоочередности: несколько каналов вместо одного, масштабируемых в зависимости от ресурсов машины, а не количества пиров. Каждый поток пакетов получает свой канал и остается там, пока каналы работают параллельно, позволяя работе распределяться по ядрам CPU.
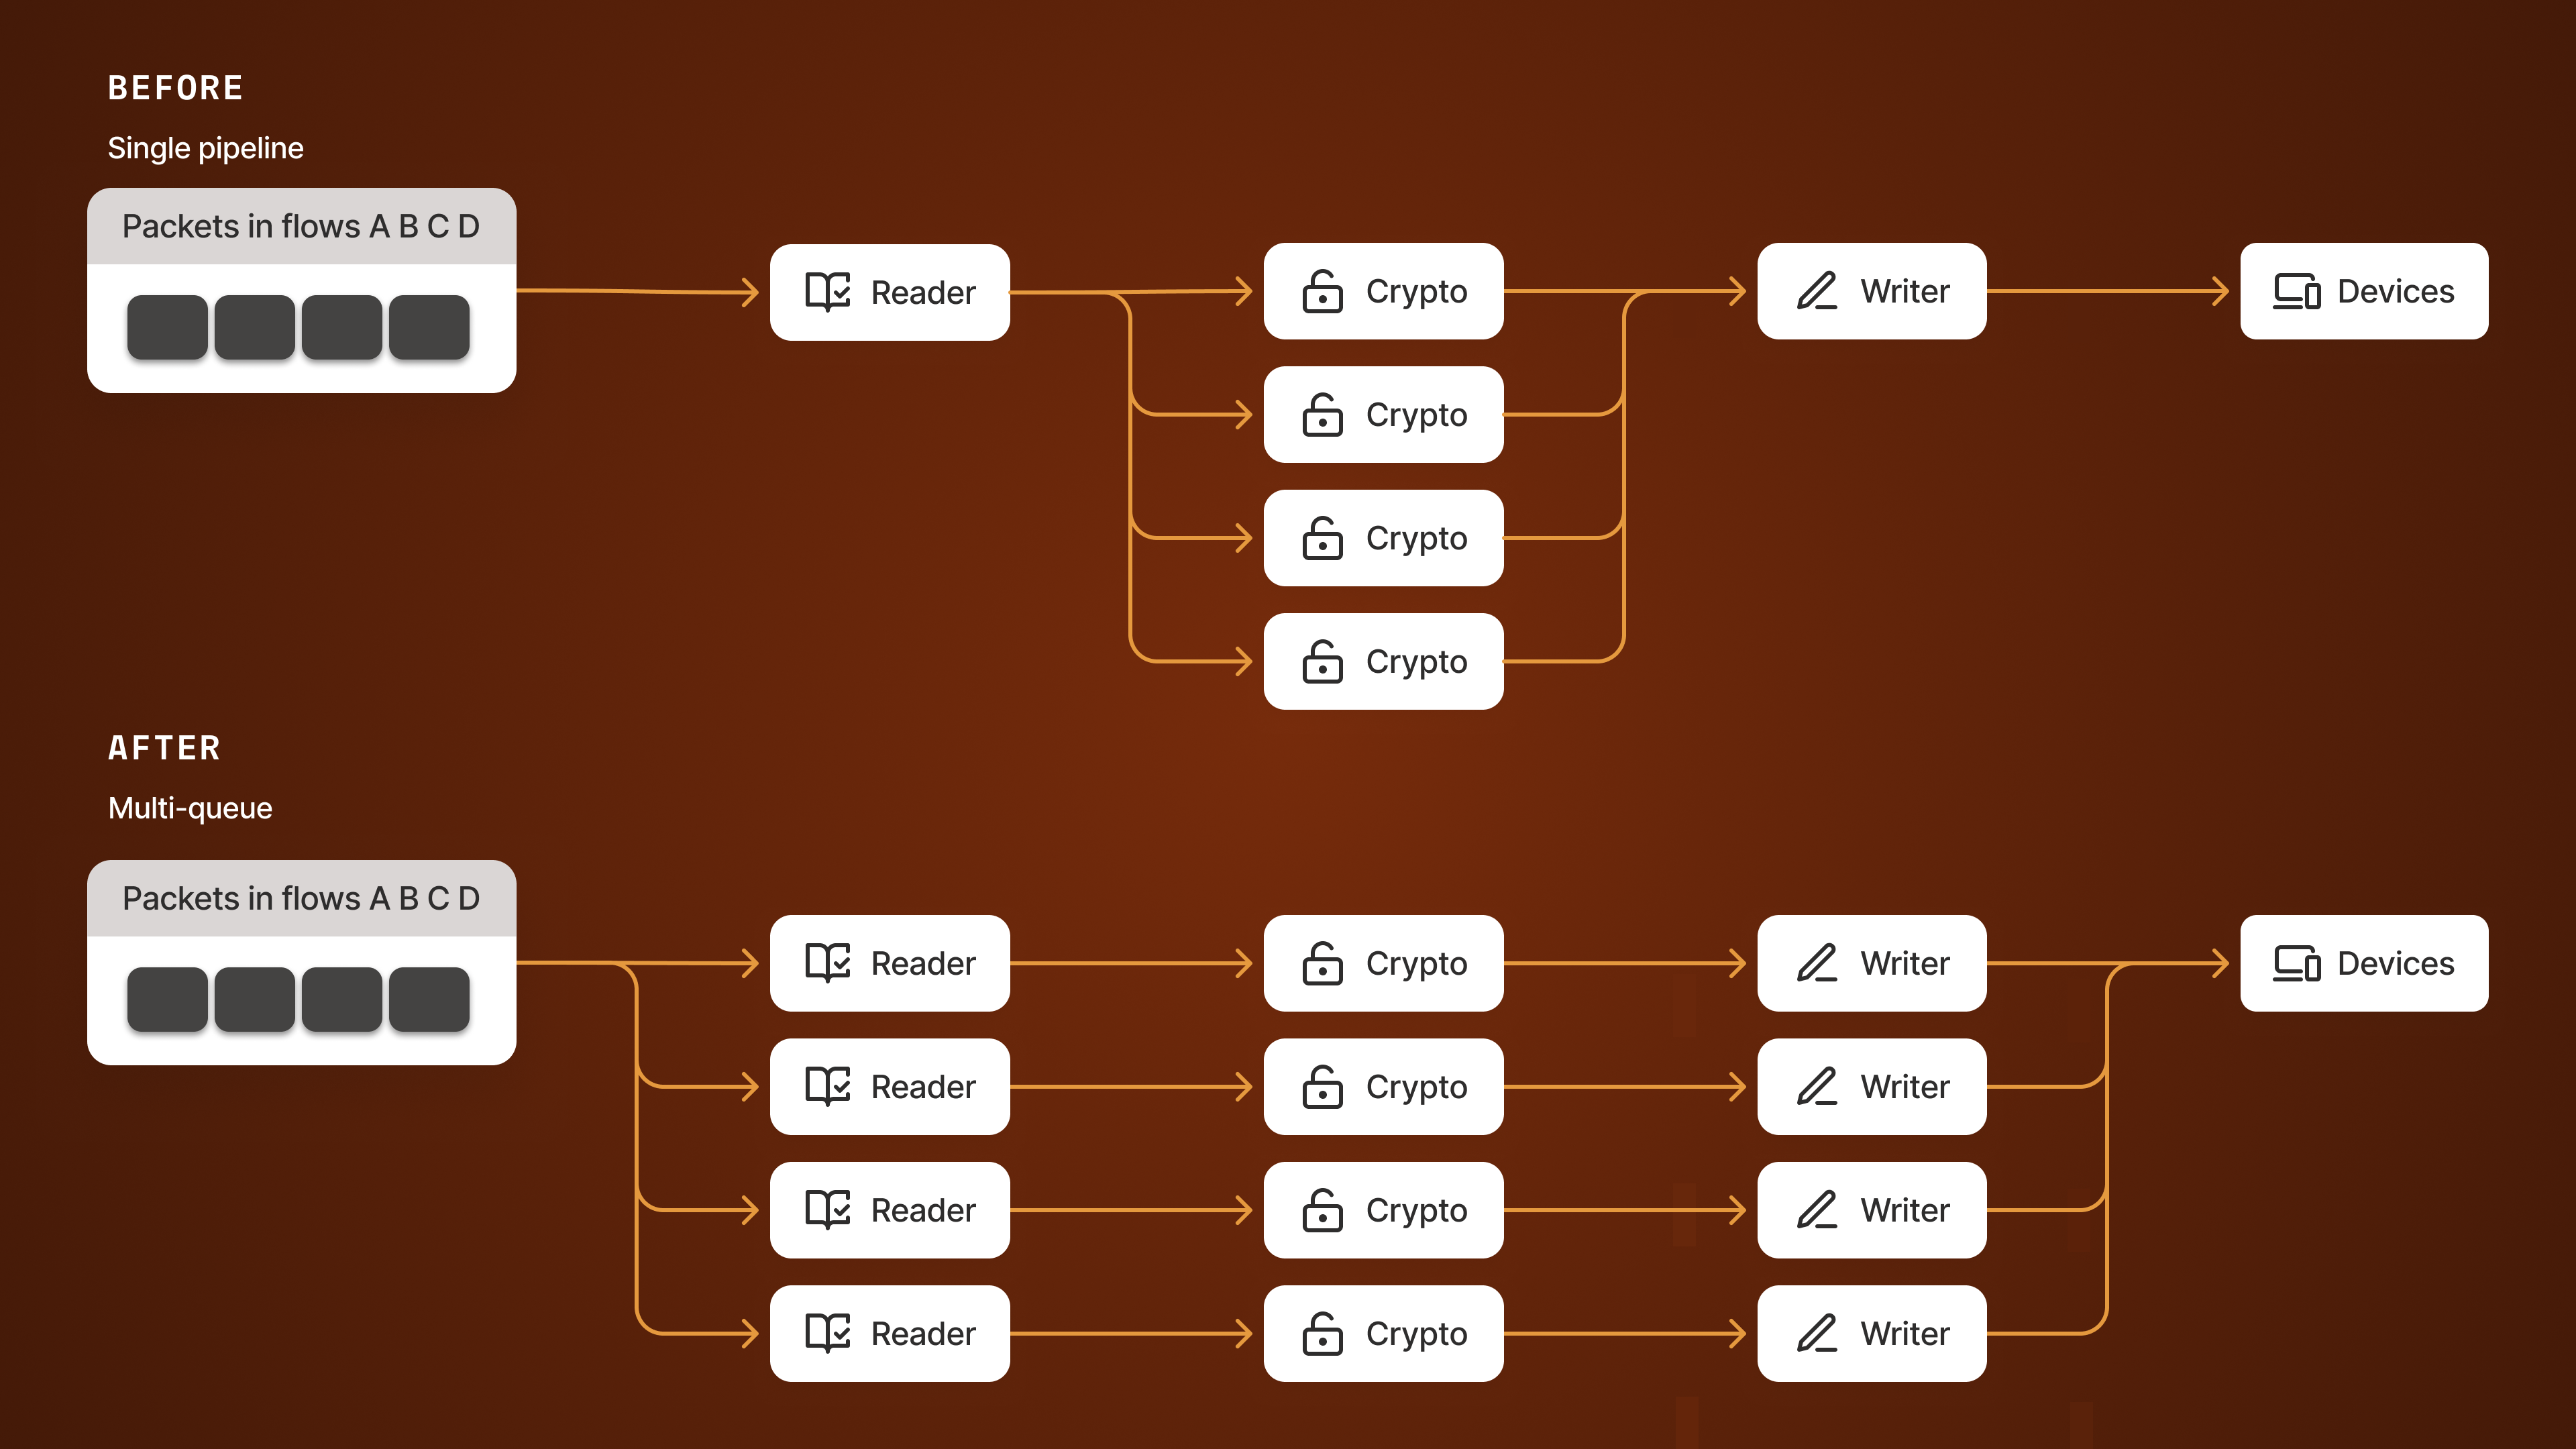
Это результирует в более высокой совокупной пропускной способности и более низкой задержке между приемом и передачей пакетов для маршрутизаторов подсетей и соединителей приложений. Оборудование, которое уже есть, используется более эффективно. Соединители приложений и узлы выхода, обычно обслуживающие множество пользователей с короткоживущими соединениями, получают особенно заметное улучшение.
"Это приводит к более низкой задержке, по сути более быстрой обработке данных с момента их чтения из сети до момента их отправки в ОС", — сказал Алекс Валиушко, член технического персонала Tailscale.
Увеличение пропускной способности с помощью writev
Используя возможности Linux writev в клиенте Tailscale, система может передать несколько частей данных пакета ядру Linux за одну операцию, вместо того чтобы копировать и объединять эти части перед передачей ядру. Буква v в writev обозначает "вектор": Tailscale может описать отдельные части данных, которые нужно переместить, без их физического перемещения. Это означает меньше копий данных пакета в памяти, меньше операций записи и более высокую пропускную способность.
Более быстрый запуск с кешированием netmap
Пока эти ускорения доступны только на системах Linux и, где применимо, Android. Но мы также работали над функциями, применимыми к другим системам. Скоро клиенты Tailscale смогут использовать кеширование netmap для более быстрого запуска во многих условиях.
Машина, подключающаяся к Tailscale, обычно начинает с подключения к плоскости управления Tailscale, что занимает примерно 100 миллисекунд в типичной сети. Машина проходит аутентификацию и получает "сетевую карту" (netmap), описывающую устройства, до которых она может добраться, и как их достичь. Этот процесс запуска должен быть быстрым, возможно мгновенным, и при хорошем подключении обычно так и происходит.
Но когда вы находитесь в Wi-Fi самолета, в отеле с агрессивной фильтрацией или в других условиях с плохим подключением, может потребоваться много времени для машины, чтобы достичь плоскости управления — а иногда вы можете вообще не смочь ее достичь. Часто не ясно, где проблема, но эффект в том, что вы не можете достичь других устройств.
Даже в идеальных условиях сети 100 миллисекунды задержки запуска могут быть слишком большими для некоторых рабочих нагрузок, чувствительных к задержкам.
Кеширование netmap помогает машинам подключиться, когда плоскость управления не быстро доступна. Когда включено, каждое устройство в вашем tailnet хранит копию netmap на диске. Когда устройство запускается, оно может использовать эту кэшированную копию для установления соединений с другими устройствами в tailnet, пока оно не сможет связаться с плоскостью управления для получения последней информации. (Эти соединения согласовываются непосредственно между устройствами, и Tailscale не видит никакого трафика, как обычно).
"Плохие сетевые условия — вот именно то место, где люди могут получить большую пользу от кеширования netmap", — сказал Клаус Ленсбёль, член технического персонала. "[Клиент устройства говорит]: 'Знаешь что? Мы еще не разговаривали с управлением. Мы, вероятно, скоро туда доберемся. А пока вы все еще можете начать что-то делать.'"
Есть несколько ограничений. Кеширование может работать только, если устройство ранее подключалось к tailnet хотя бы один раз, чтобы получить сетевую карту от плоскости управления. Кроме того, кеширование netmap требует, чтобы устройство имело постоянное дисковое пространство для хранения кэша. Мы позаботились о минимизации ненужных записей на диск, но в некоторых случаях вы можете не захотеть его включать. Например, на исключительно больших tailnet обновление кэша может потребовать большого объема дисковых операций. Аналогично, устройства, использующие медленное или подверженное износу хранилище, как SD-карты, могут предпочесть не включать кеширование netmap.
Для большинства устройств в большинстве tailnet эта функция может заметно ускорить скорость установления соединения между устройствами при запуске. Мы видели tailnet с плохой доступностью плоскости управления, начинающие отправлять данные через плоскость данных, при "теплом" кэшированном запуске на один-два порядка величины быстрее, чем при "холодном" запуске. Для устройств, сталкивающихся с переменной задержкой запуска, или находящихся далеко от сервера DERP или плоскости управления, преимущества особенно ощутимы.
Когда вы увидите все эти ускорения
- Уменьшение памяти благодаря изменениям буфера (Linux/Android) ожидается в клиенте v1.104.
- Многоочередность для маршрутизаторов подсетей и соединителей приложений запланирована на выпуск после v1.104.
- Увеличение пропускной способности (Linux/Android) было частично реализовано весной 2026 г.; использование дополнительных достижений в памяти и пропускной способности запланировано на выпуск после v1.104.
- Кеширование netmap доступно как флаг функции в текущем клиенте Tailscale; ожидается его появление по умолчанию в v1.104 после дальнейшего тестирования. Мобильные клиенты должны получить эту функцию в выпуске после v1.104.
Производительность по-прежнему трудно диагностировать и тестировать
Конечно, мы думаем, что Tailscale быстрый. Но вам не нужно верить нам на слово. Именно поэтому мы исследуем набор инструментов мониторинга и тестирования, поддерживающих Tailscale. Мы хотим предоставить нашим клиентам инструменты, необходимые для тестирования, диагностики и понимания конфигурации их сети способом, который является нативным для Tailscale.
Вот пробелы, которые мы видим в современном тестировании производительности:
- Затраты на распределение: Большинство инструментов производительности работают точка-в-точку и требуют установки на каждую конечную точку.
- Жесткие рабочие процессы: Довольно легко запустить неправильный тест, получить неправильный результат и гонять проблему, которой там нет.
- Поддержка протоколов: Многие инструменты не поддерживают новые протоколы, такие как QUIC и HTTP/3.
- Поддержка Tailscale: Инструменты общего назначения не являются нативными для Tailscale. Они не могут сказать вам, использует ли соединение DERP или является ли оно прямым, может ли вам помочь пиринг relay, или как путь соединения меняется со временем.
Существующие инструменты не понимают нативные пути и состояния Tailscale. Поэтому мы исследуем инструменты, которые это делают. Помогите нам формировать будущее тестирования производительности в Tailscale.