Почему локальные AI-модели?
Вопрос справедливый: зачем нужны локальные модели, когда облачные фронтир-модели работают лучше и часто быстрее? Само оборудование дорого, и за то время, пока окупится инвестиция, можно несколько лет платить за самую дорогую подписку Anthropic, сэкономить деньги и получить лучшую производительность.
У разных людей разные ответы. Одни выбирают локальные модели из соображений приватности — предпочитают обрабатывать чувствительные данные локально, а не загружать их в облако. Другие просто считают это крутым — и в этом им не поспоришь. Для AI-разработчиков это имеет практический смысл: нужна хорошая локальная установка для обучения собственных адаптеров или fine-tuning.
В личном опыте автора путь в локальный AI объединил фактор «крутизны» с вопросами приватности и стоимости. Летом в процессе подготовки обзора iOS и iPadOS 27 была создана внутренняя app Desk для организации сотен заметок, сессий, PDF-документов и вырезок из веб-страниц, а также глав обзора. К концу проекта база состояла из 310 документов. В Desk команда локальных агентов на базе DeepSeek V4 Flash (плюс olmOCR для PDF) работала 24/7 в течение 99 дней, выполняя задачи:
- Транскрибирование любимых сессий WWDC
- Извлечение фич iOS и iPadOS 27 из вырезок, сессий, PDF-гайдов и заметок
- Кросс-ссылки между фичами из разных источников и отслеживание принадлежности к главам
- Извлечение фич и багов из загруженных скриншотов
- Работа с Notion API для организации всего по разным базам
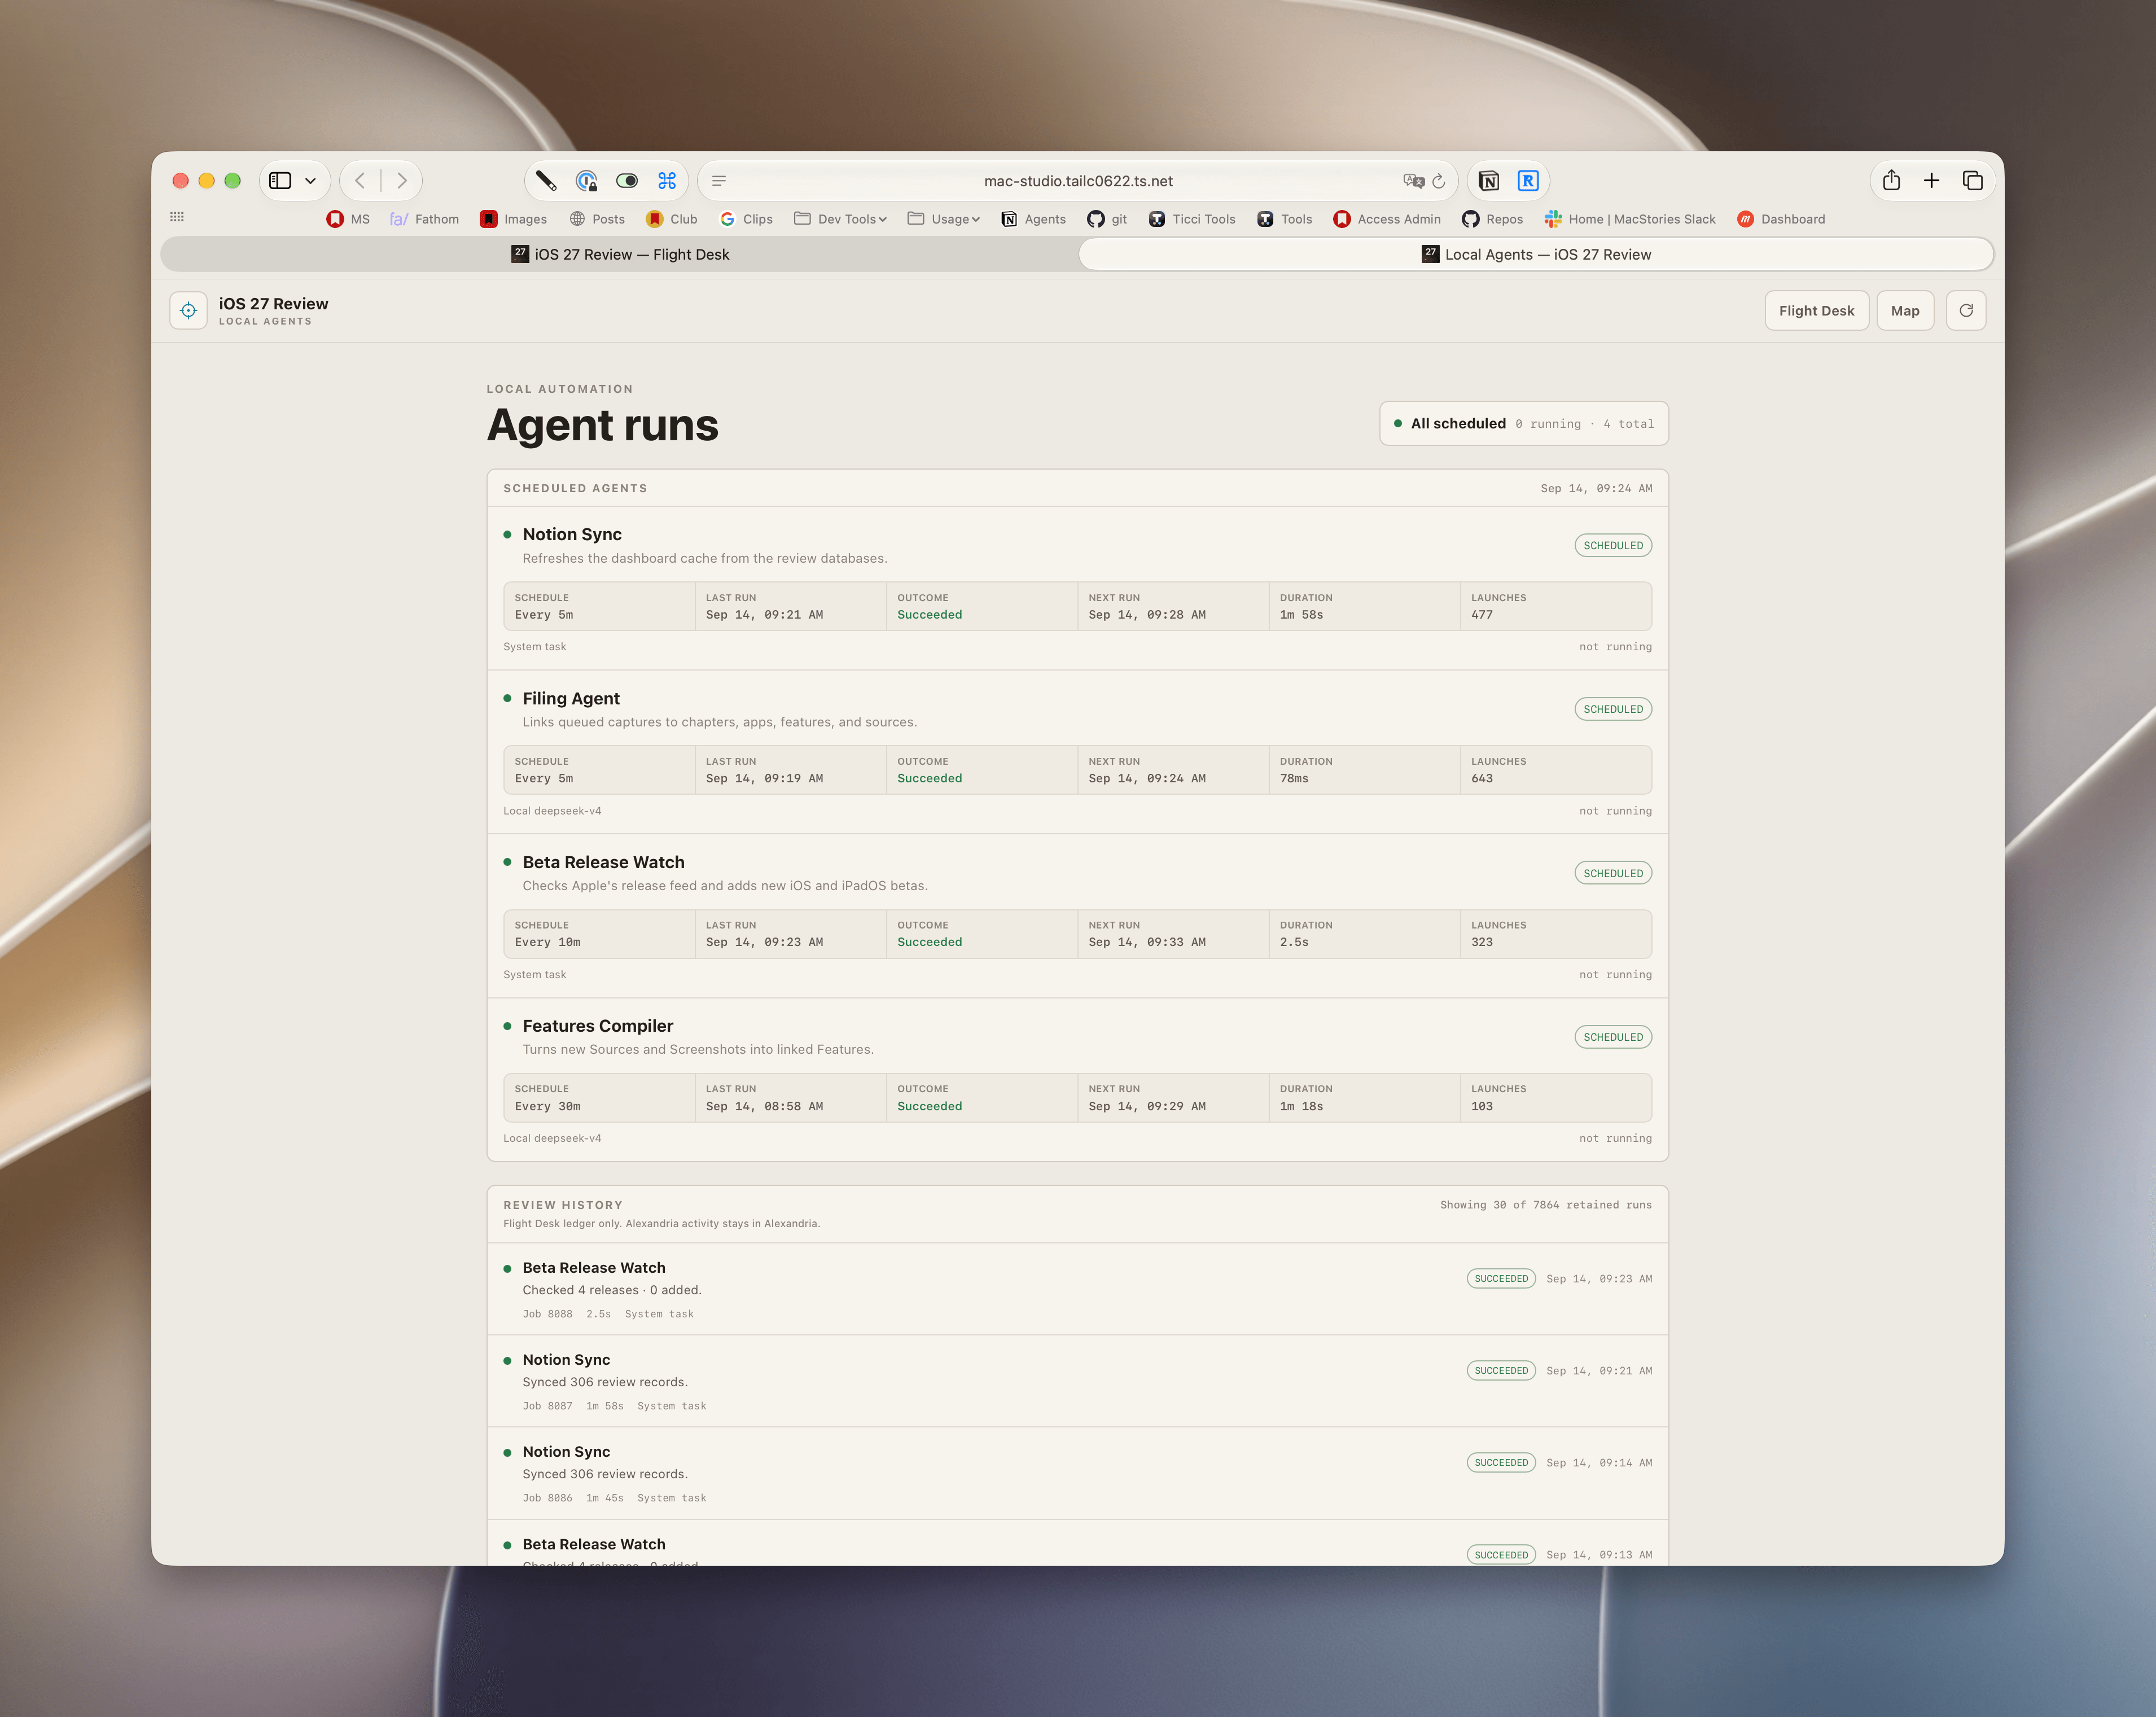
Когда в начале июня началась работа с этой установкой, стало ясно, что полагаться на OpenAI или Anthropic API для такой always-on, постоянно фоновой задачи было бы просто неподъёмно дорого. Поэтому переход на локальный AI — и результат есть: полный обзор iOS и iPadOS 27 на MacStories, написанный старомодным способом: собственными человеческими руками. Но весь исследовательский стек, глубокое связывание заметок и отслеживание новых фич и бета-версий выполнялись локальными агентами на Mac Studio с общей стоимостью $0.
Если это не кажется интересным или мощным концептом для изучения — статья вероятно не для вас, и это нормально. Работа с такими моделями требует усидчивости, и это не то, что рекомендовать какому-то, кто просто хочет заплатить $20 за Claude. Такая установка, по определению, находится на переднем крае AI-вorkflow'ов в этот момент.
Если вы придерживаетесь противоположной точки зрения и считаете такое крутым — Mac Studio с M5 Ultra это огромный скачок в производительности для локальных моделей на основе MLX, и у автора есть несколько примеров доказать это.
Скачок в обработке подсказок и генерации
M5 Ultra Mac Studio выглядит идентично заменяемой им модели M3 Ultra, но снабжен совершенно новой архитектурой Apple silicon, которая использует UltraFusion для подключения двух dual-die M5 Max чипов, образуя quad-die архитектуру — первое для экосистемы Apple. С точки зрения локальных AI-нагрузок нужно обратить внимание на два направления (которые автор отслеживал с момента обзора M5 iPad Pro для локального AI в прошлом году): GPU и пропускная способность памяти.
M5 Ultra имеет новое поколение GPU с 80 ядрами, каждое с Neural Accelerator, что дает до 4.5× прирост пиковых AI-вычислений по сравнению с M3 Ultra. По памяти объединённая архитектура памяти Apple по-прежнему топит на 512 ГБ (хотя эта модель выходит в конце октября), но пропускная способность выросла с 819 ГБ/с до 1.2 ТБ/с — на 50% больше, чем у M3 Ultra.
С этими цифрами автор начал тестировать M5 Ultra против M3 Ultra с 512 ГБ ОЗУ и собственного RTX 5090. Краткая версия: с M5 Ultra значительно меньше времени ждать, пока модель прочитает подсказку и начнёт генерировать ответ; а когда она начинает отвечать, текст появляется намного быстрее, чем на M3 Ultra. Эти два улучшения делают машину жизнеспособной для современных agentic loops, требующих быстрой итерации с моделью и, как следствие, больших окон контекста.
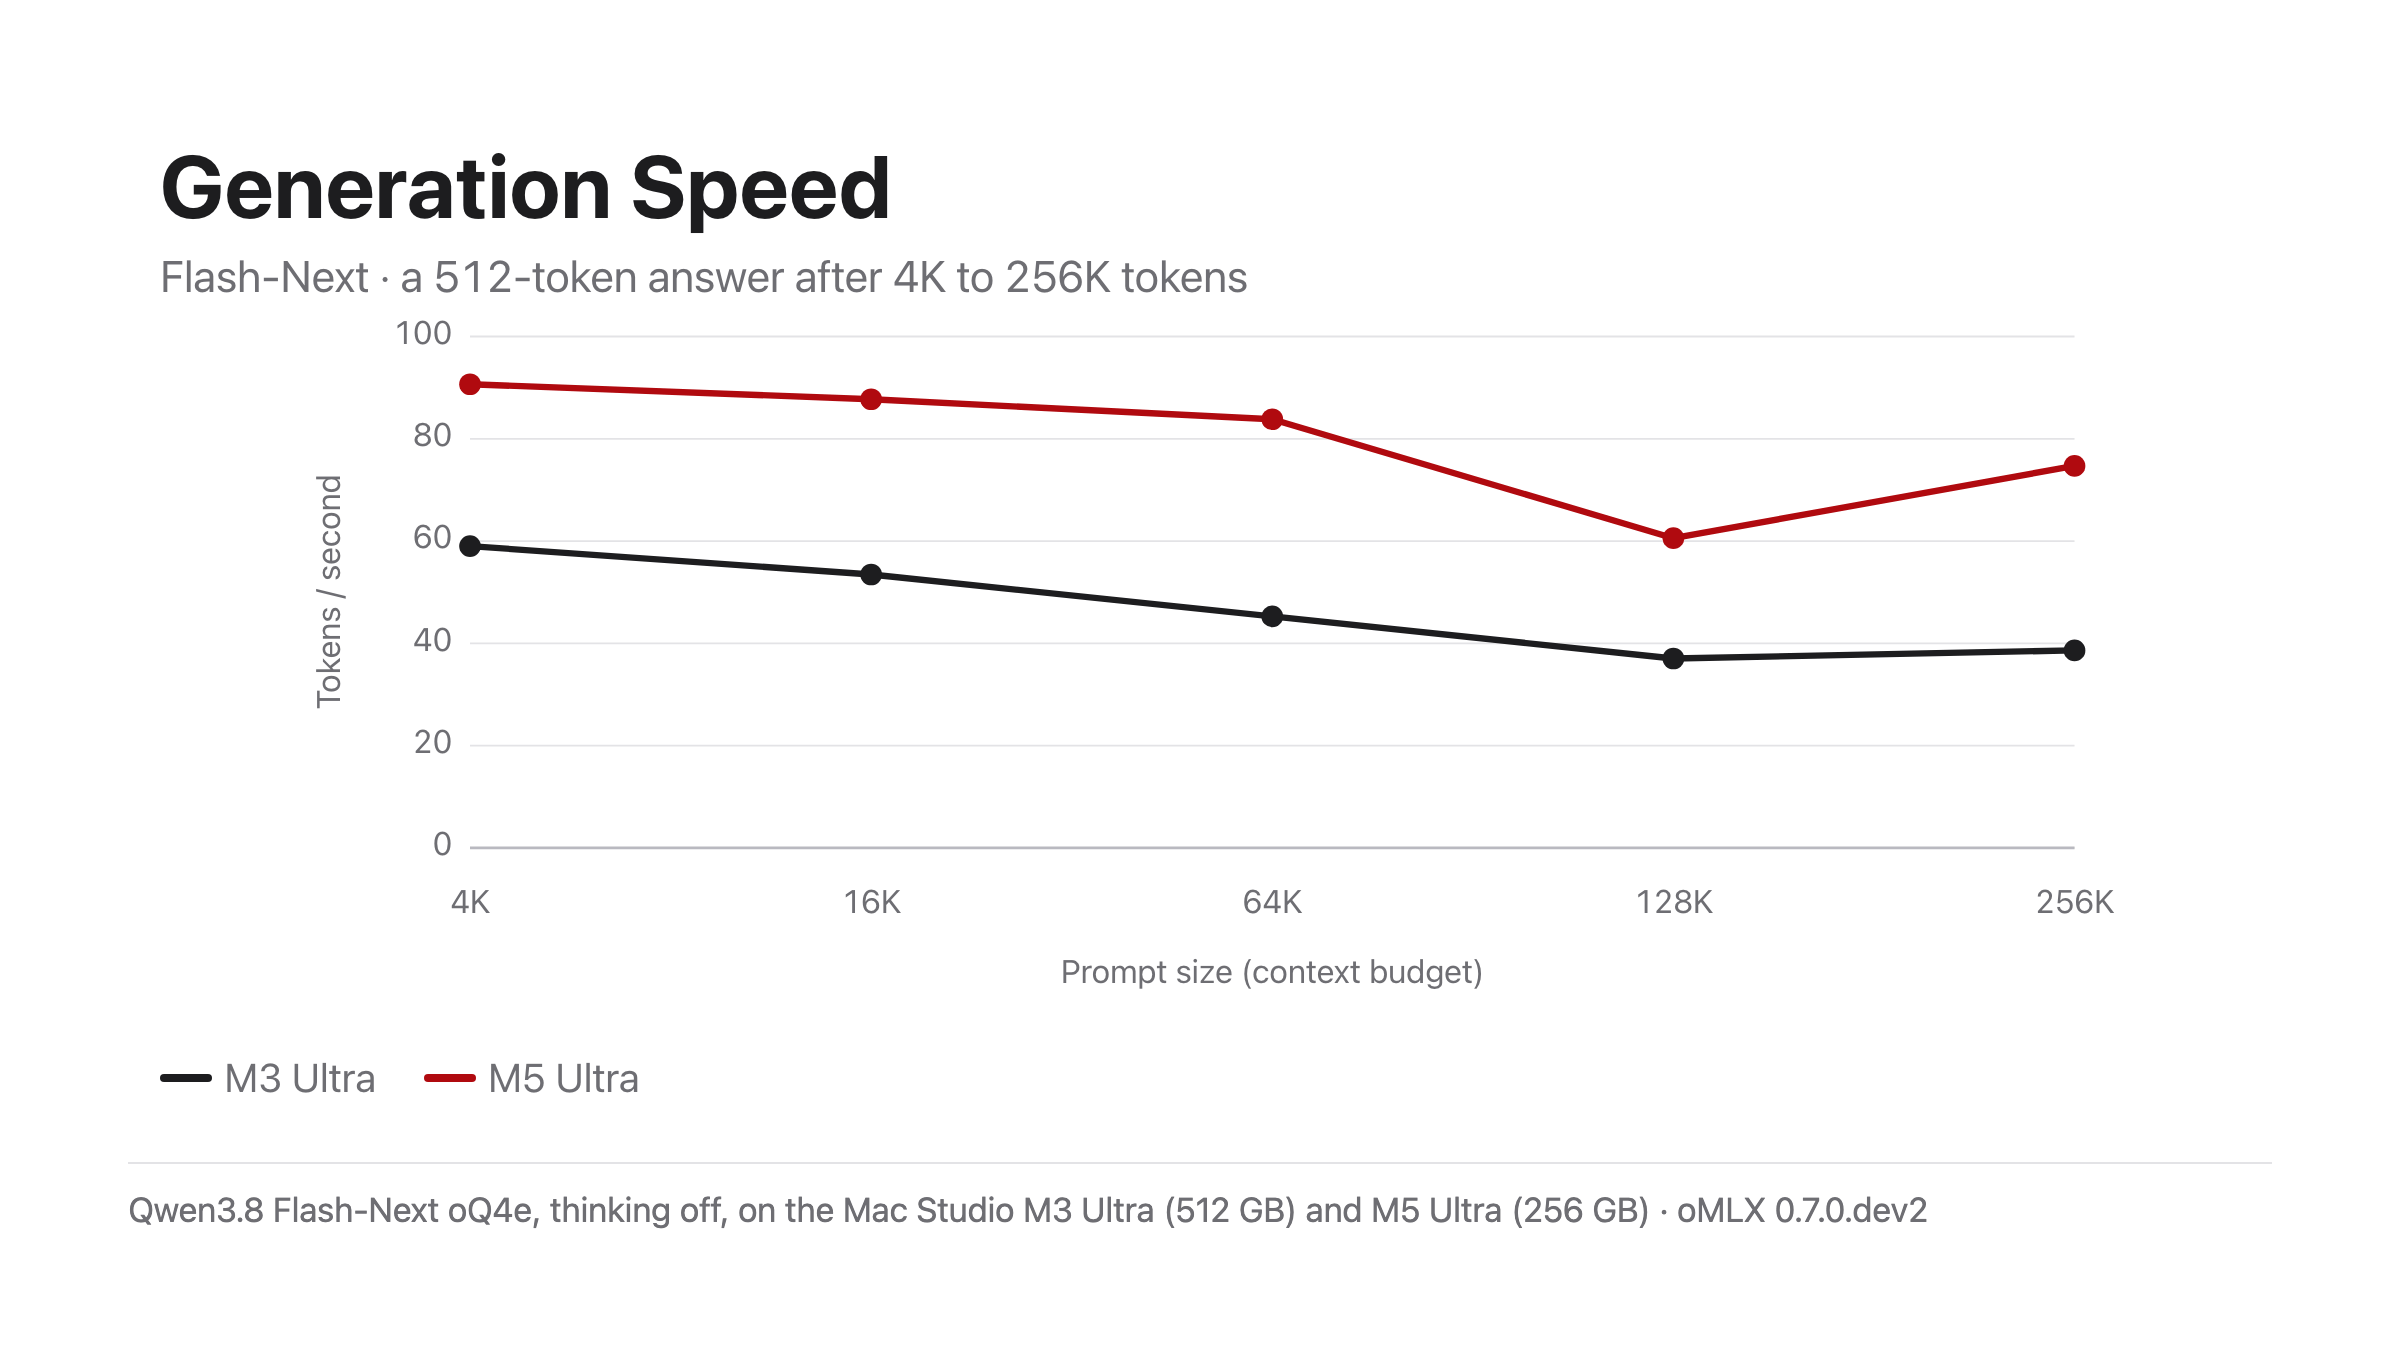
В повседневном опыте запуска агентов на M5 Ultra эти улучшения в token prefill (как быстро обрабатывается подсказка) и генерации токенов замечены сразу. При сравнении модели на M3 Ultra и M5 Ultra бок о бок с Open Minis на iOS, M5 Ultra была примерно на 70% быстрее в среднем, чем M3 Ultra при генерации ответа. Как будет видно дальше, то, что модель типа Qwen3.8-Flash-Next может выдавать 100+ токенов в секунду на коротких подсказках и всё ещё пишет со скоростью 60–85 при 64K–256K контекста — это не шутка, и это позволяет ощущать приятное взаимодействие между пользователем и моделью, особенно когда задействованы tool calls.
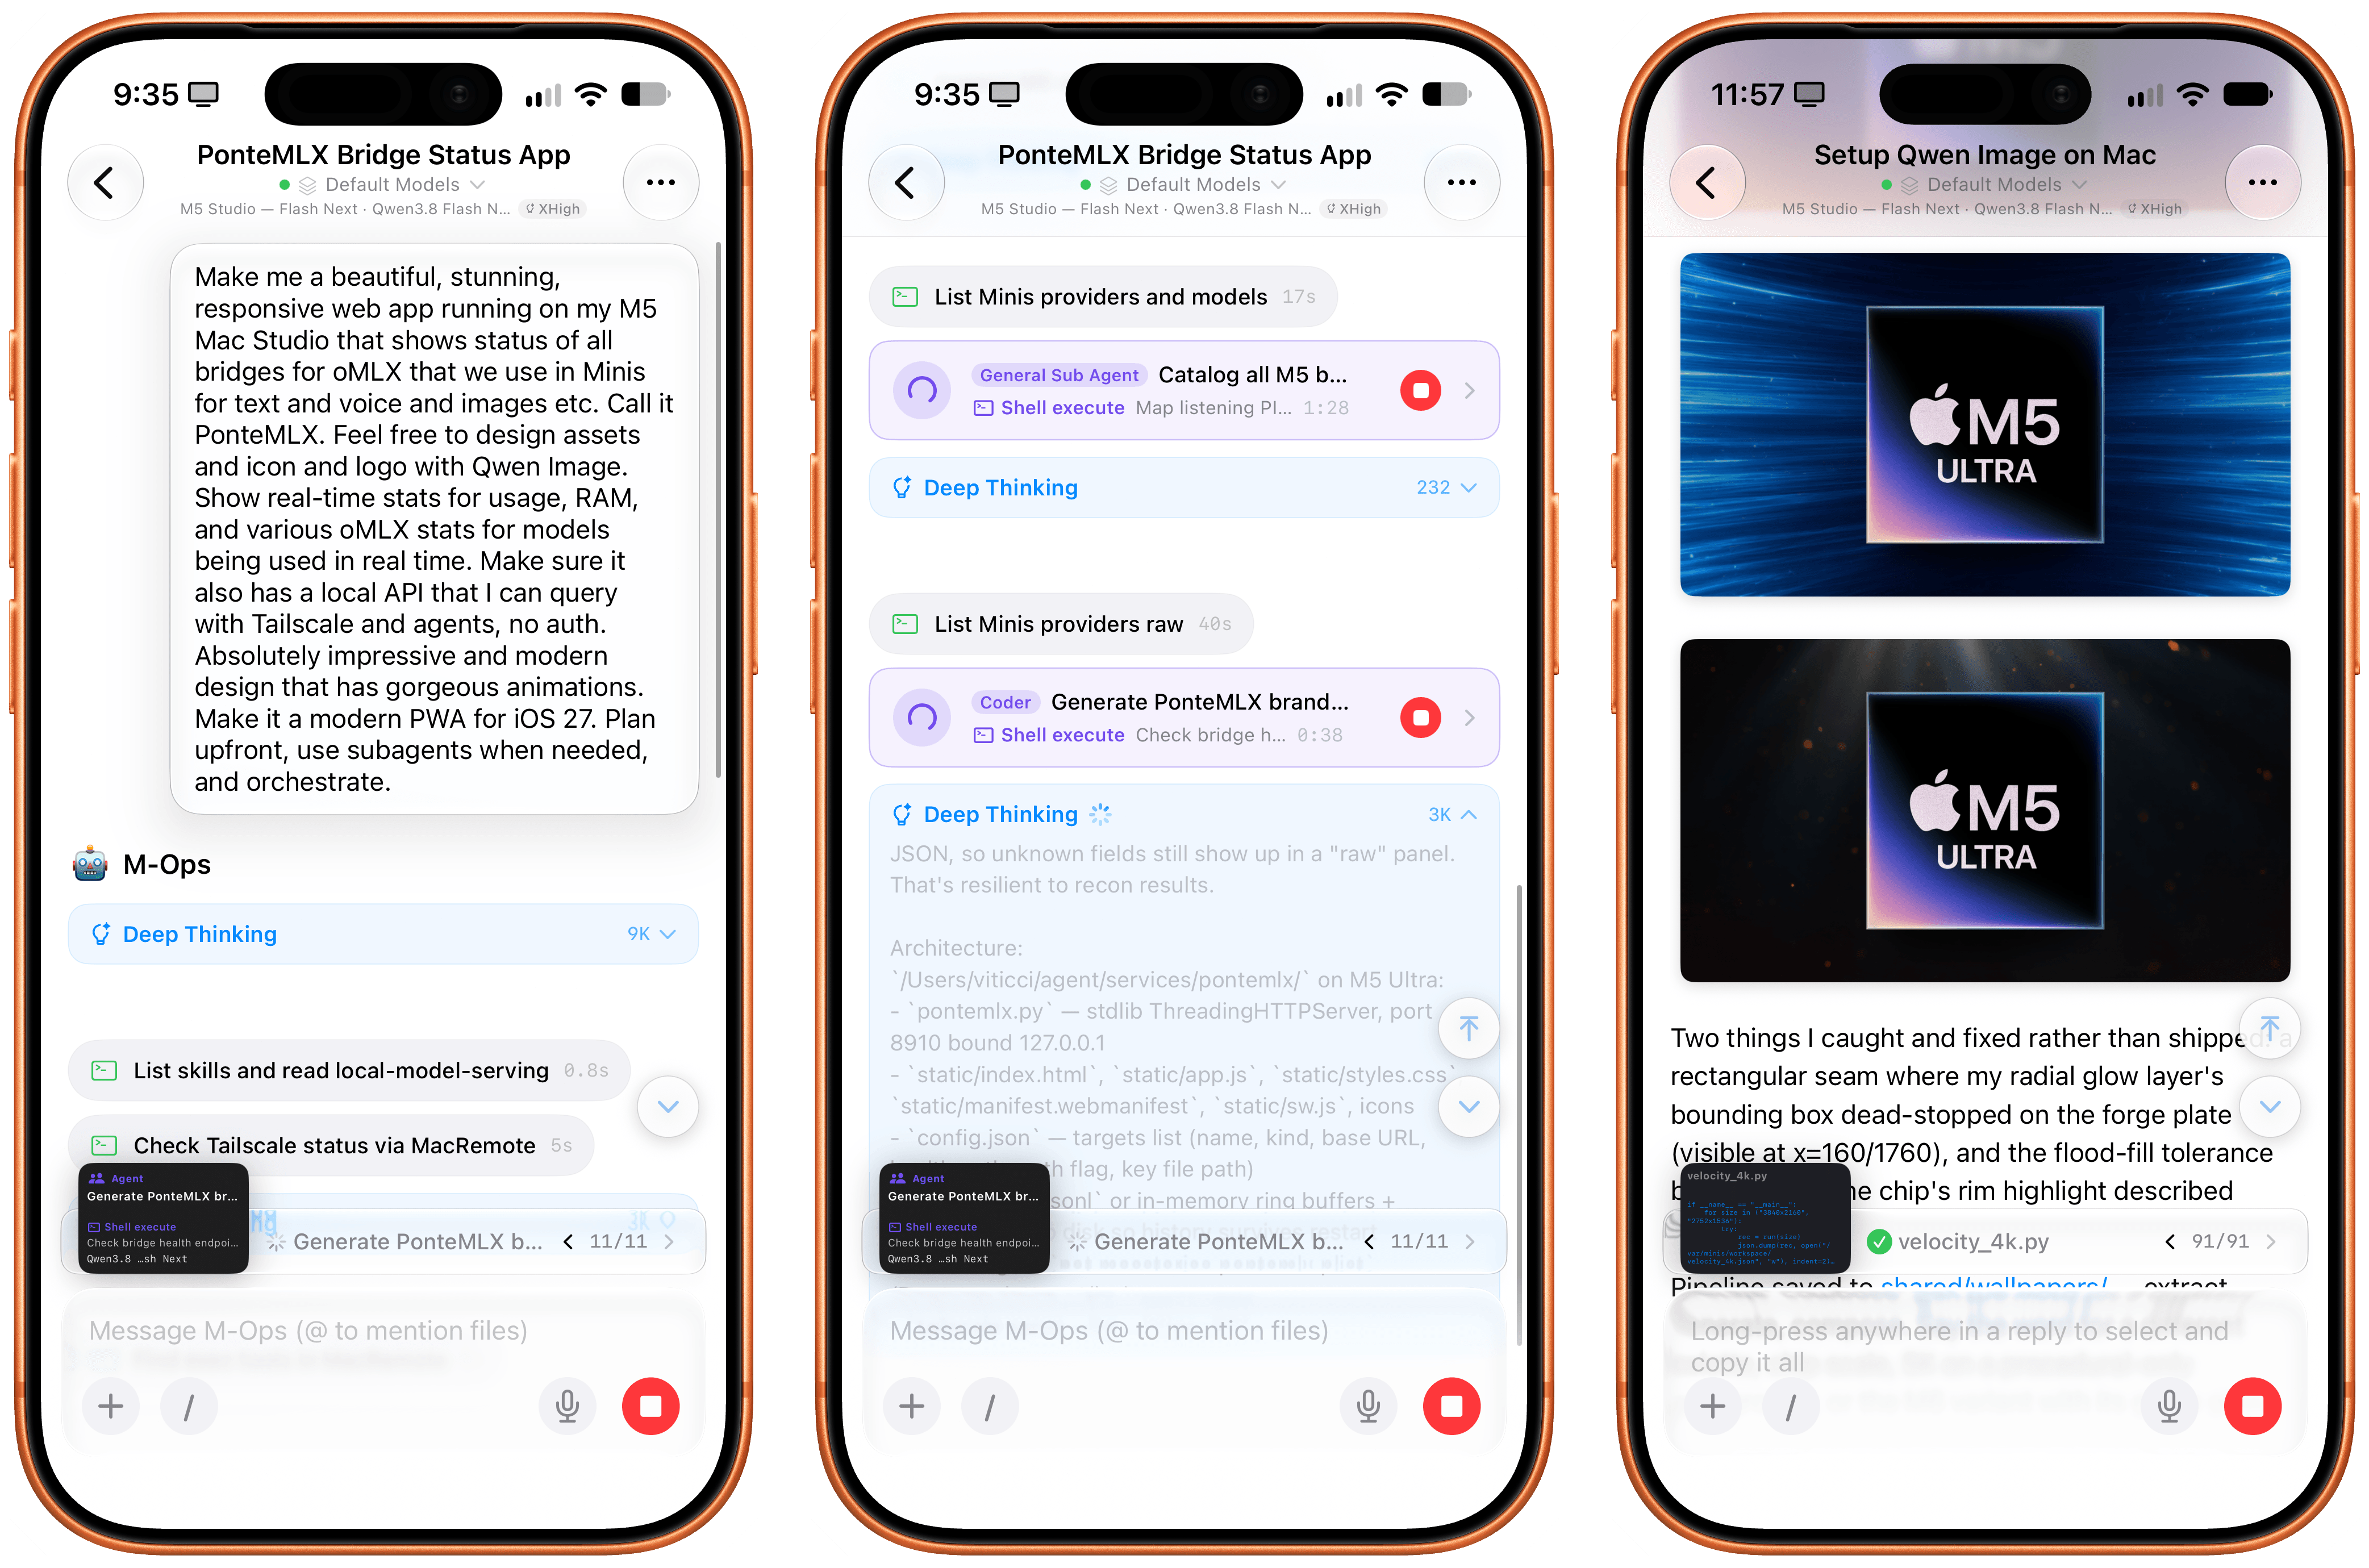
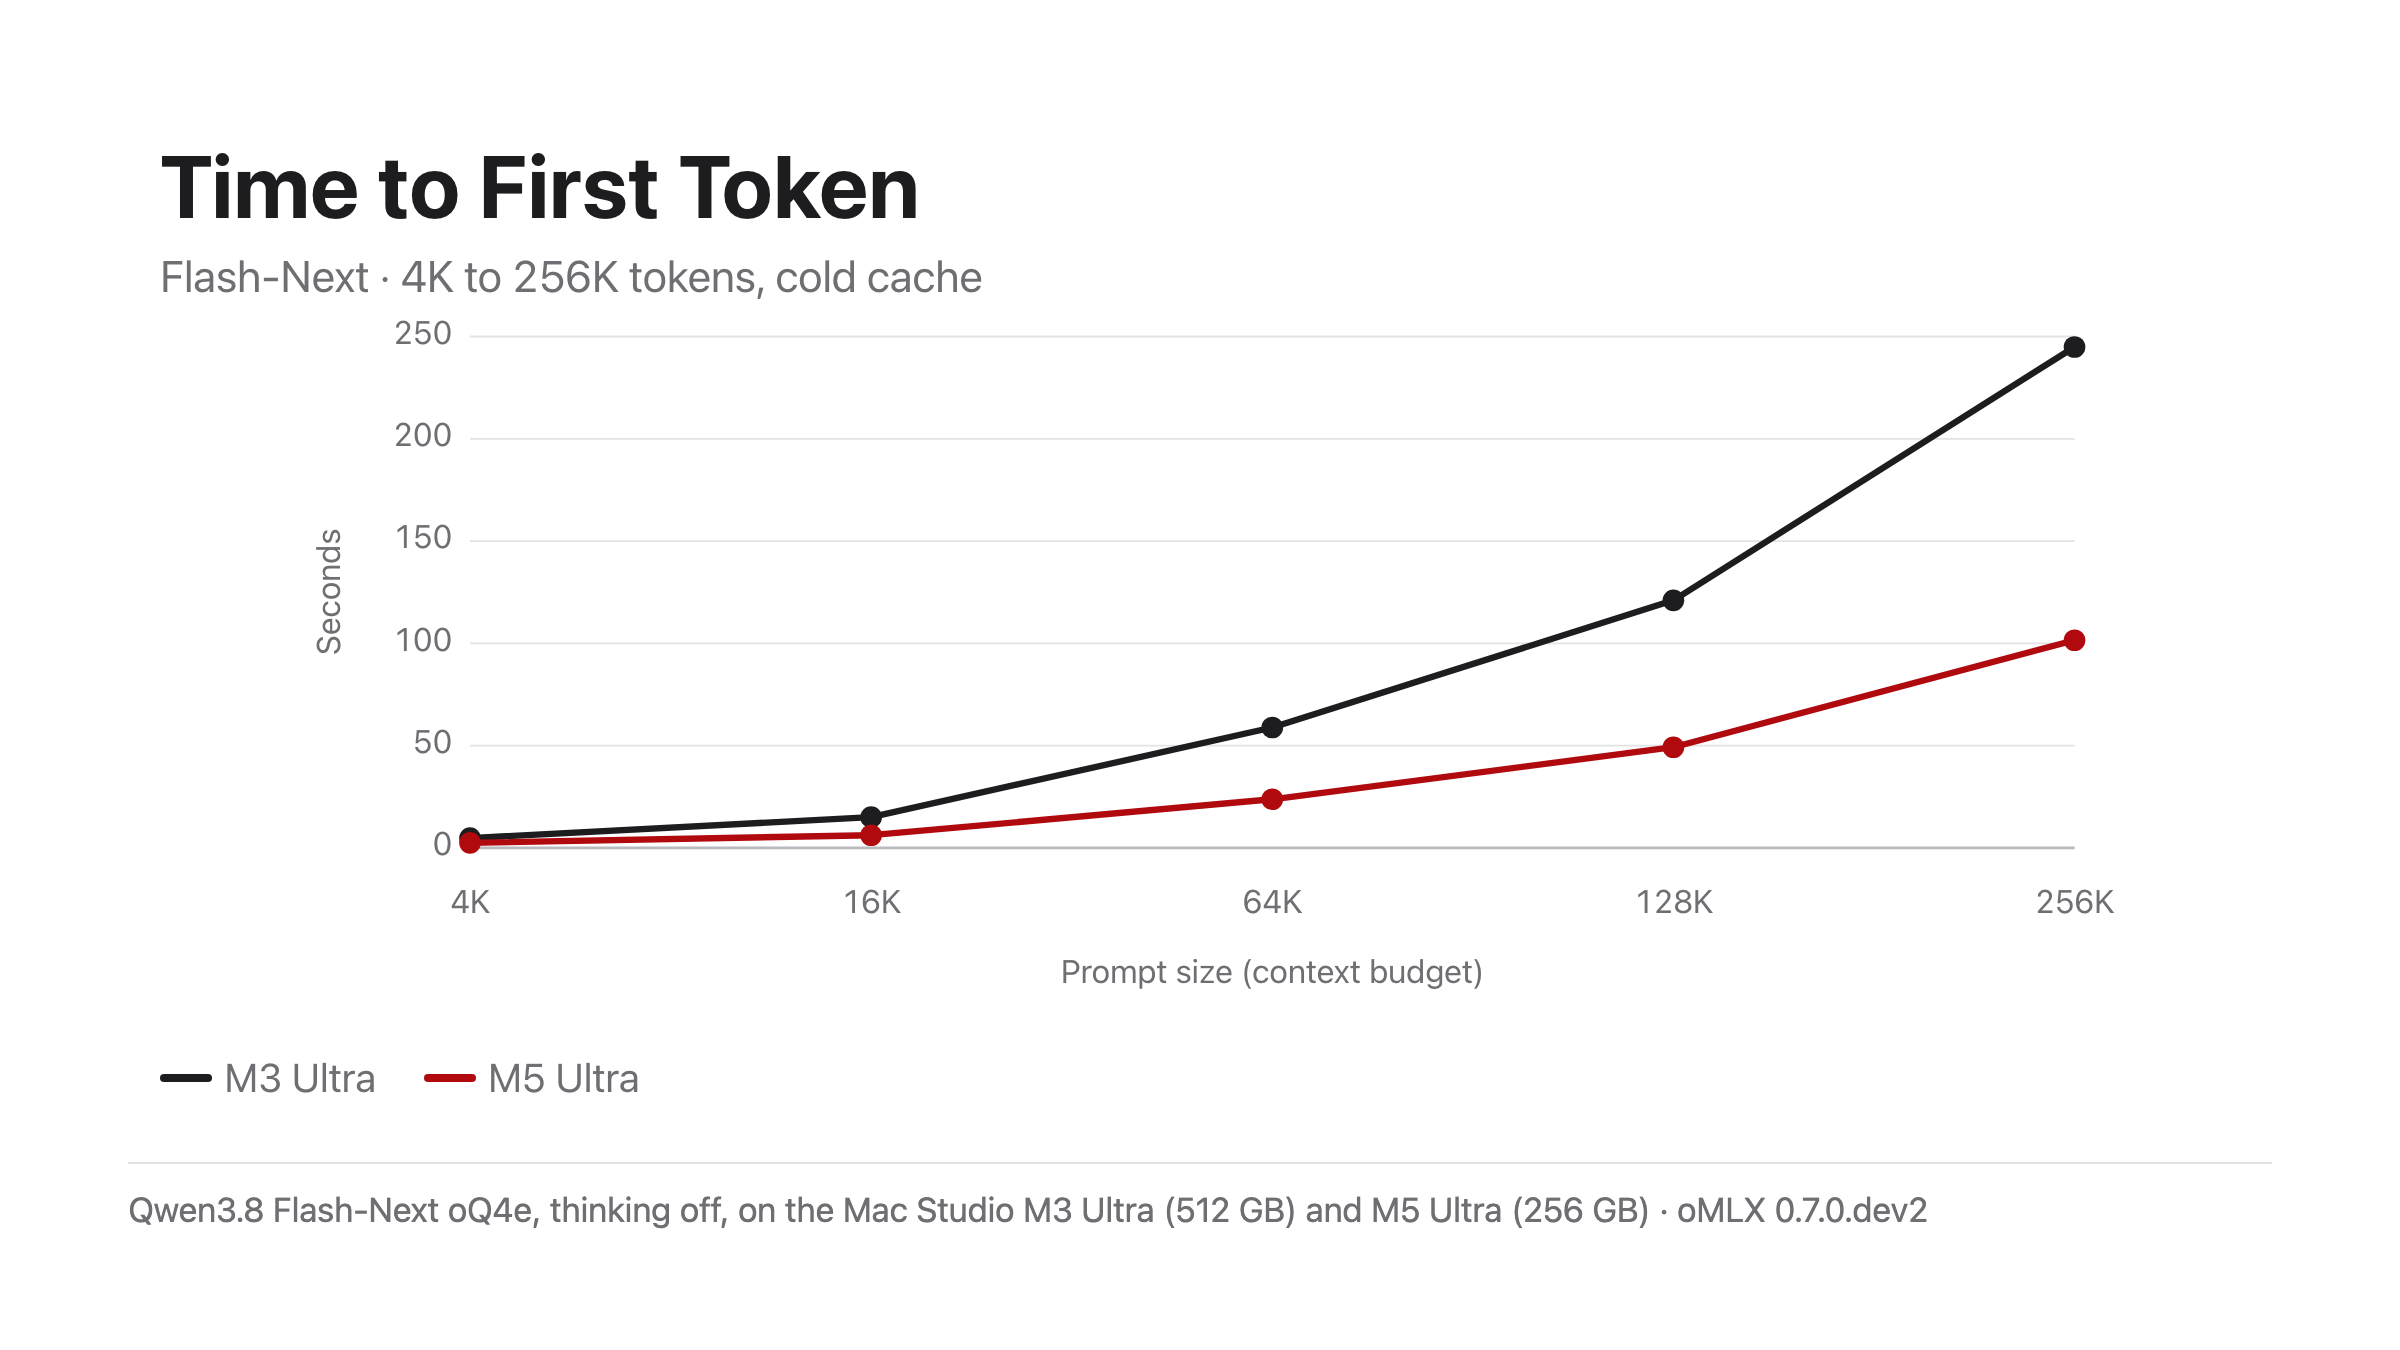
Однако автор был более впечатлён приростом производительности в token prefill. Когда используются assistants вроде Hermes или Codex, модель получает целый блок инструкций, который включает system prompt, персонализацию пользователя и session memories, описания skills и MCP, и ещё кое-что. Одни агенты лучше других в обрезании инструкций, которые отправляют, но в целом, когда используется современный агент, стартуешь не с пустого context window. Из-за этого никогда не получалось стабильно использовать локальные модели с этой новой волной агентов: они работали, но приходилось смотреть на пустой экран и loading indicator'а какое-то время перед тем, как модель начинает генерировать. И на каждом шаге loop производительность деградировала (из-за растущего контекста сессии), и опять ждать.
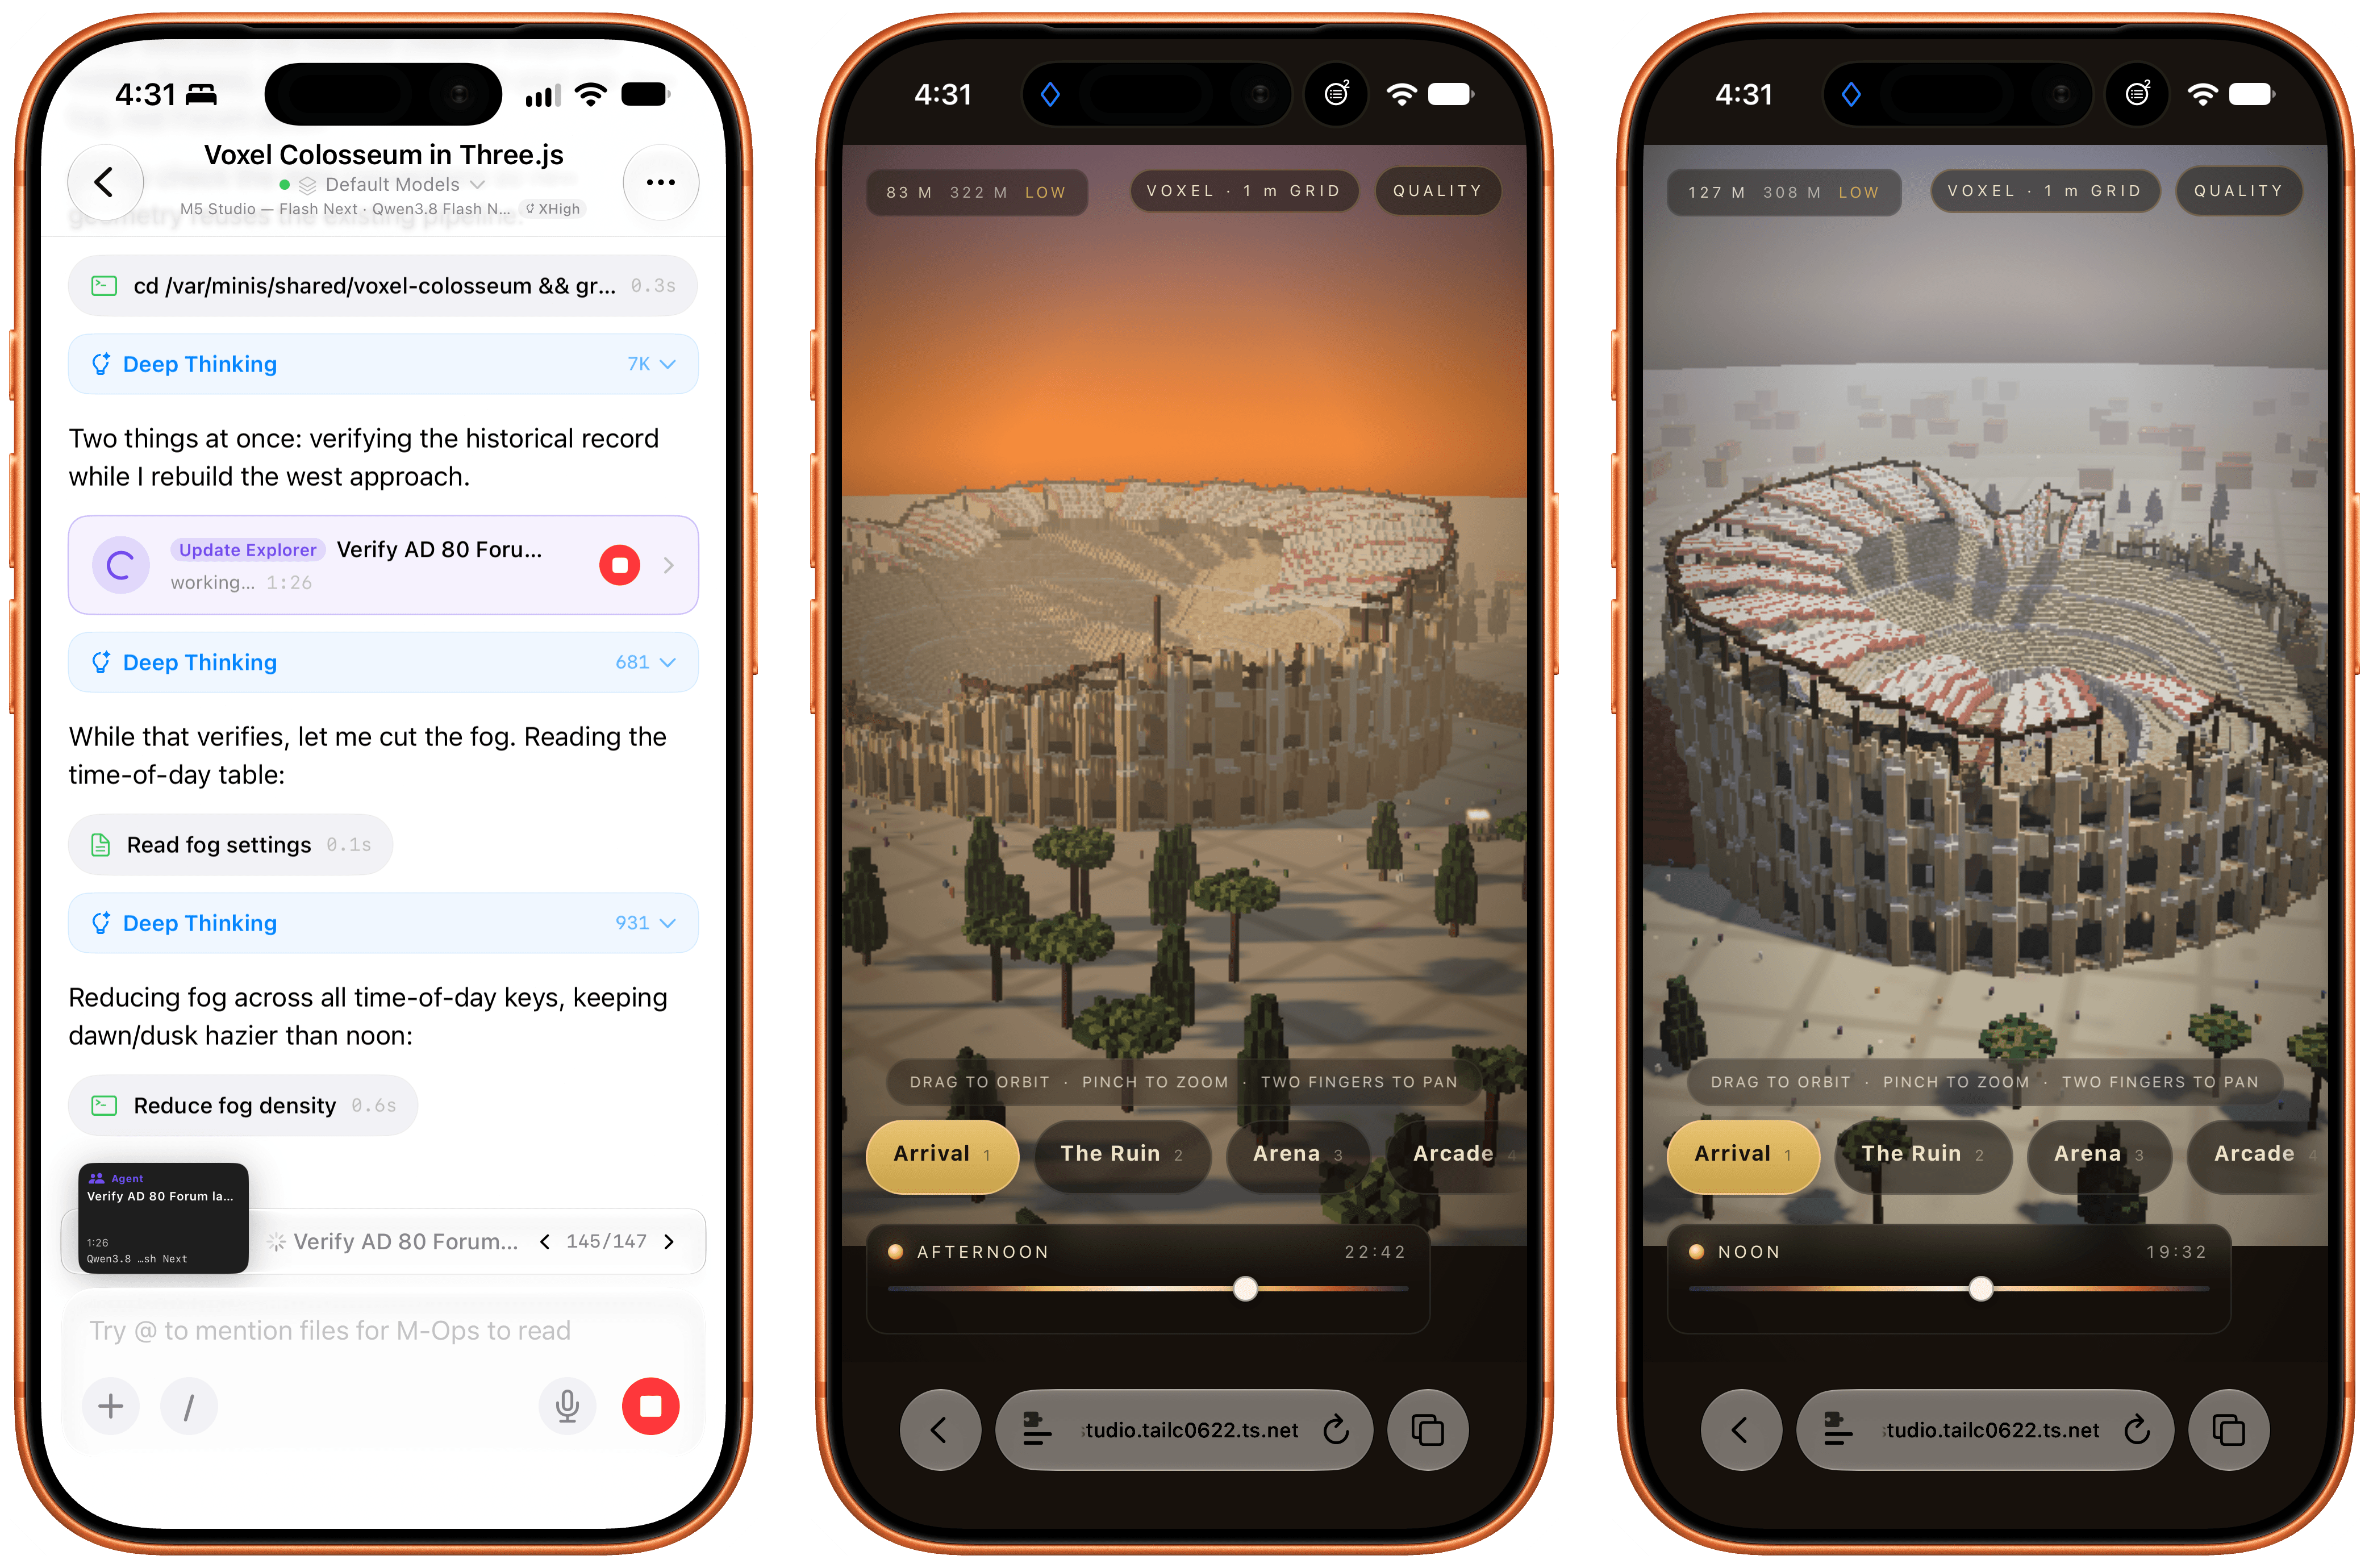
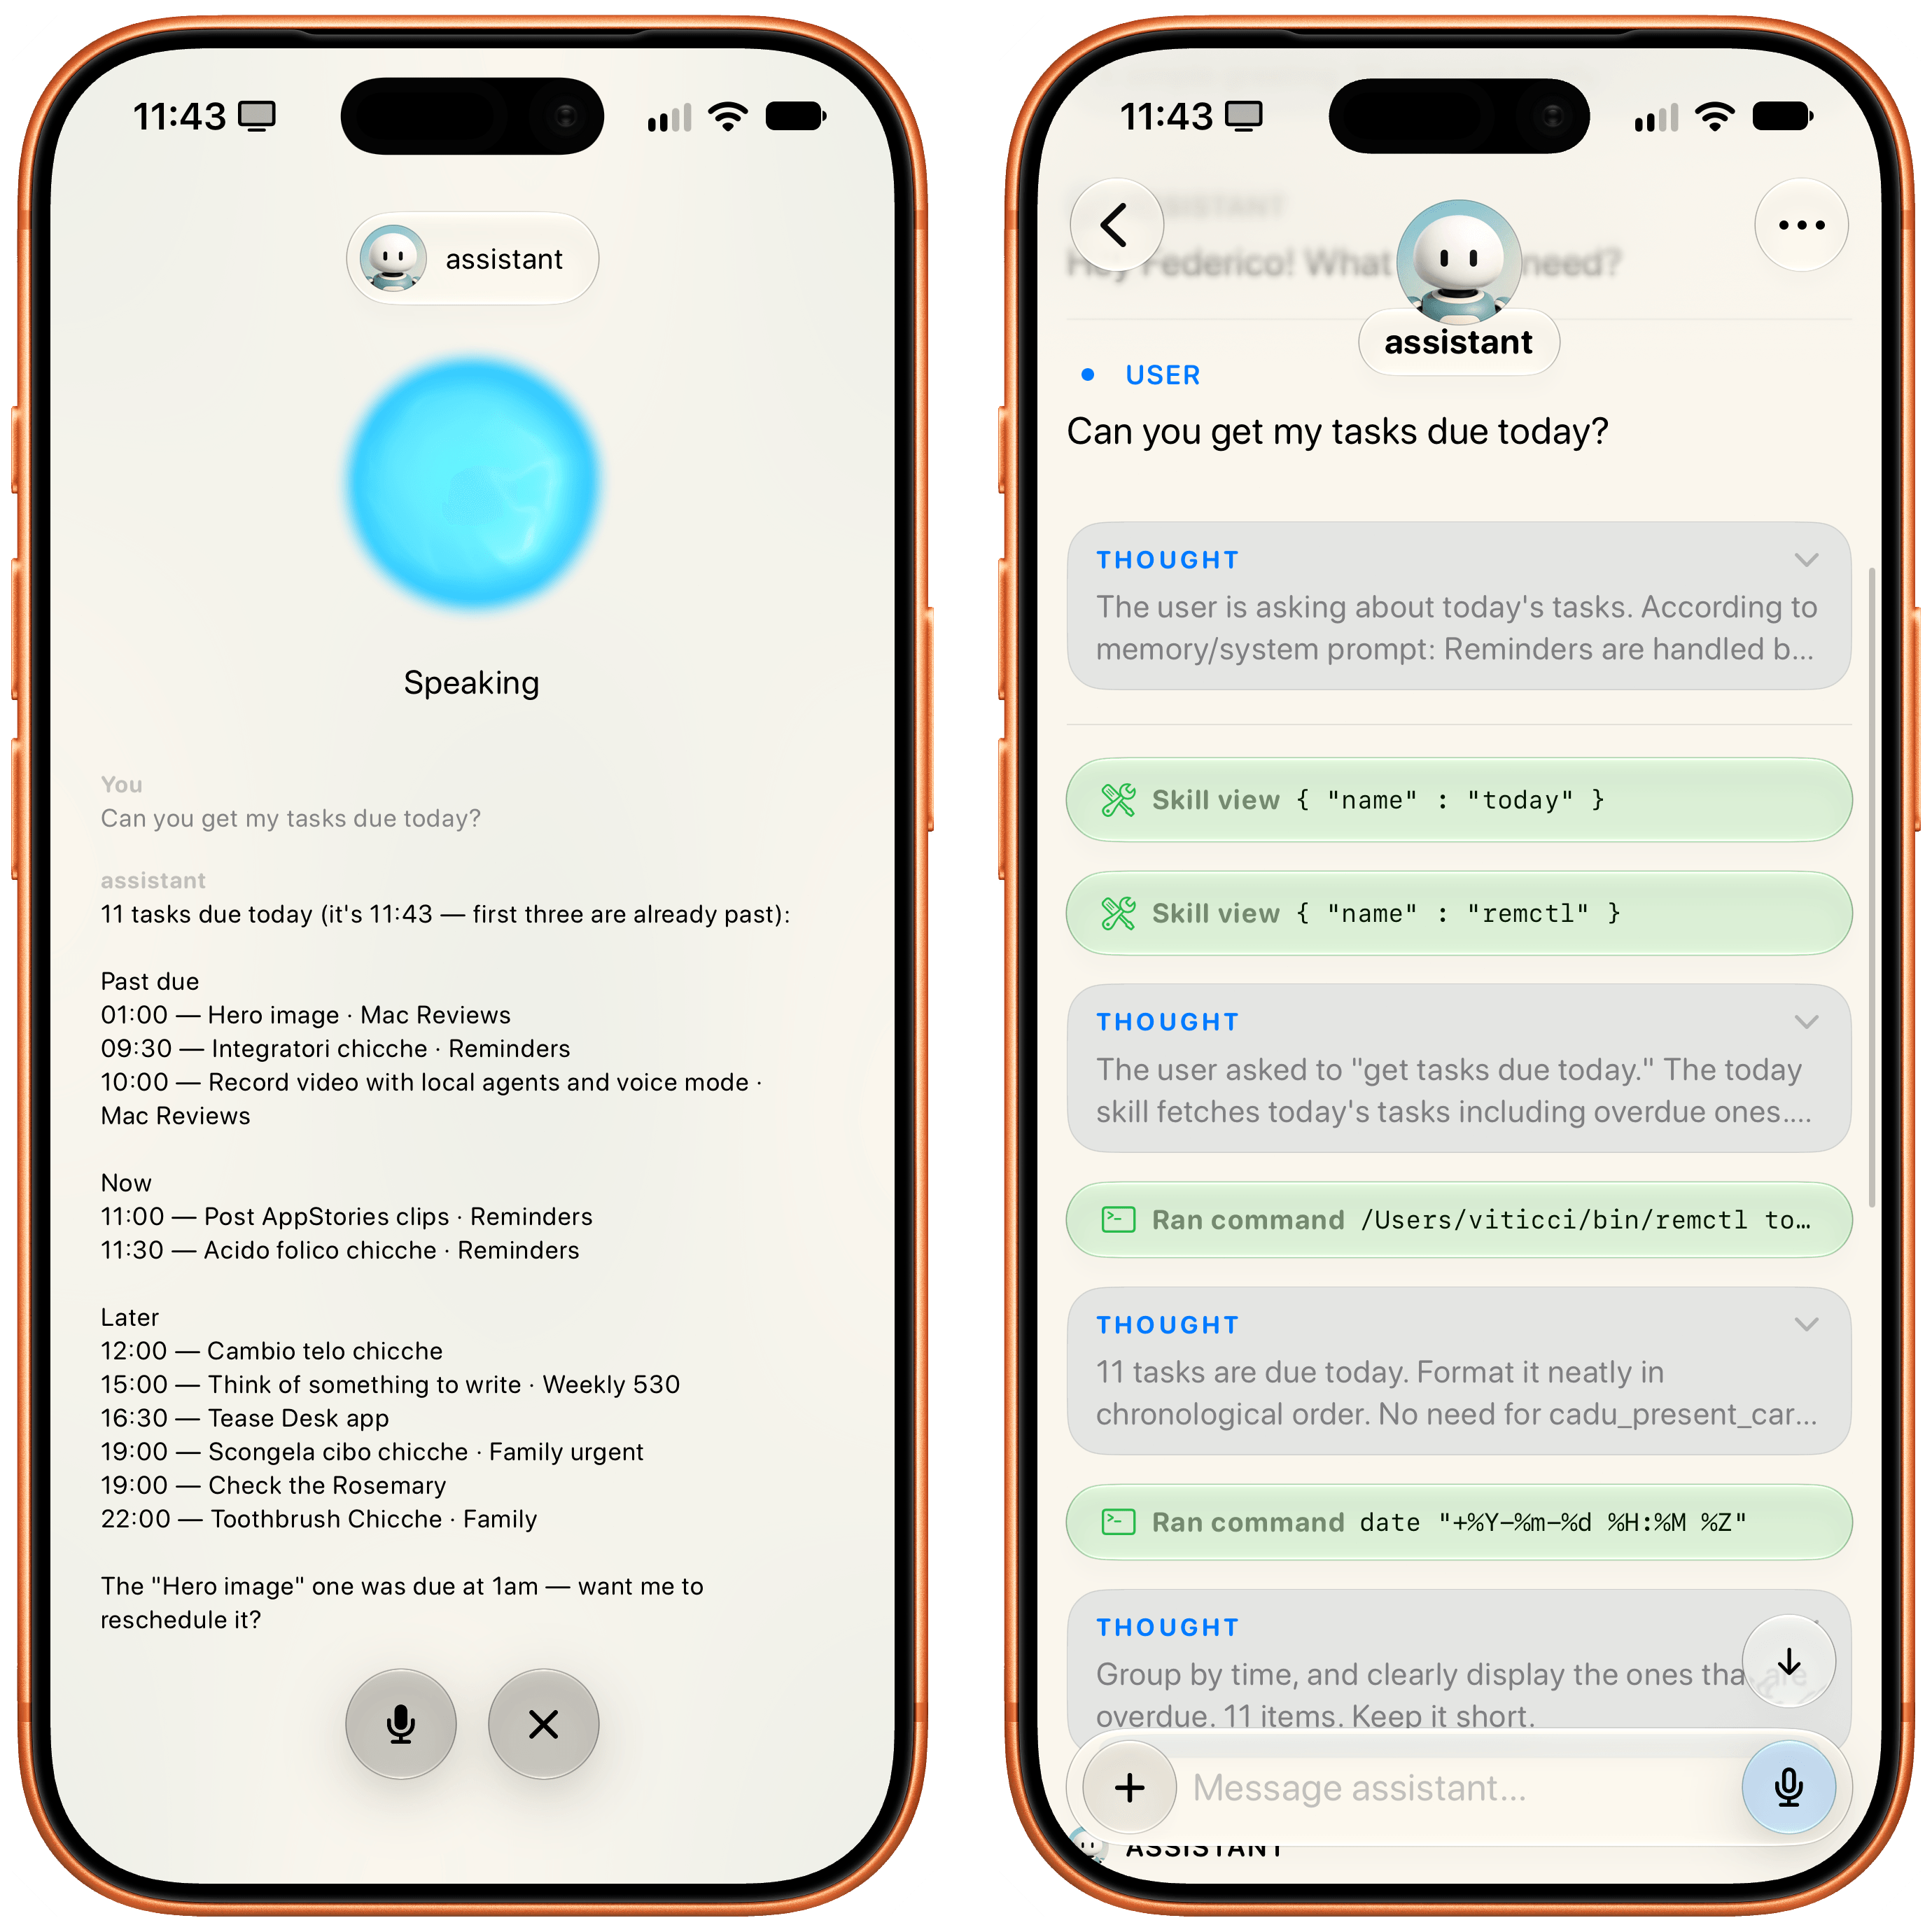
В тестах обработка prompt'а выросла на 150% в среднем по сравнению с M3 Ultra — примерно 2.5× улучшение от предыдущей установки. Это изменение одно делает локальные модели солидным выбором в приложениях типа Open Minis и Hermes Agent. Когда попросить Flash-Next на M5 Ultra получить задачи на неделю с RemCTL, не нужно ждать, пока агент обработает подсказку и Open Minis' — за несколько секунд начинает работать, рассуждать, выполнять tool calls и так далее. И когда работаешь над большим проектом, как интерактивное demo Colosseum внизу, модель способна быстро обрабатывать multi-turn loops, диспетчировать и координировать субагентов, и делать это со скоростью 60–85 токенов в секунду по мере роста потока.
Автор большой поклонник assistants, которые могут agentically выполнять задачи в дополнение к ответам на вопросы, но для того, чтобы приносить удовольствие от использования, они должны быть быстрыми. За последние несколько месяцев протестированы несколько «бутик» облачных провайдеров с Open Minis: Inco, который подаёт Kimi K3 на 300+ TPS; Cerebras с Qwen3.8-27B на ошеломляющих 1,800 TPS; и вроде Fireworks и Baseten, каждый преодолевший барьер 150 TPS. Все эти провайдеры очень приятны в использовании в Open Minis и Hermes, но они дорогие (в прошлую неделю потрачено 20 баксов Inco credits буквально за 10 минут), и, конечно же, все данные идут… куда-то при их использовании. Когда запустить Open Minis с Flash-Next и набором Apple CLI, которые создаются, всё остаётся локально, внутри машины, которую можно видеть и перезагружать когда угодно.
И самое важное: модель типа Flash-Next может быть «маленькой» достаточно для запуска с большей точностью на 256 ГБ M5 Ultra (можно запустить 5-bit полностью в ОЗУ; 6- и 8-bit могут offload свои n-gram таблицы на SSD с этой новой архитектурой), но в то же время умной достаточно для поддержки длинных потоков и множественных agentic tool calls.
На вкус автора 5-bit quantization попадает в sweet spot на этой версии Ultra с балансом интеллекта, производительности и потребления памяти. Но автор уже знает, что если когда-нибудь получится тестировать 512 ГБ M5 Ultra, был бы действительно заинтересован измерить производительность 8-bit quant без SSD offloading.
Не потрачено много времени на tinkerting с offloading coding tasks для различных проектов на локальную модель, но проведено несколько интересных экспериментов. С такой производительностью, и особенно учитывая возможность поставить up to three concurrent Flash-Next сессий с субагентами в oMLX с 256 ГБ ОЗУ (больше дальше), можно теперь реалистично рассмотреть передачу более простых coding tasks локальной модели и поручение frontier облачным проверить её работу. Например, удалось настроить Qwen3.8-Flash-Next в Codex, что позволяет использовать локальную модель с Codex harness. Это означает, что можно дать main GPT модели оркестрировать локальные субагенты, дать Flash-Next координировать её собственные субагенты, или даже просто использовать модель с iPhone с Codex Remote на iOS.
Автор любопытен читать больше на эту тему от реальных разработчиков, которые вскоре получат M5 Ultra. С open-weights моделями, которые теперь превосходят на потребительском оборудовании то, что считалось «frontier» примерно 10 месяцев назад, и с производительностью на M5 Ultra, которая делает agentic coding реалистичным, автор думает, что увидим невероятные эксперименты от MLX сообщества очень скоро.
M5 Ultra vs. RTX 5090
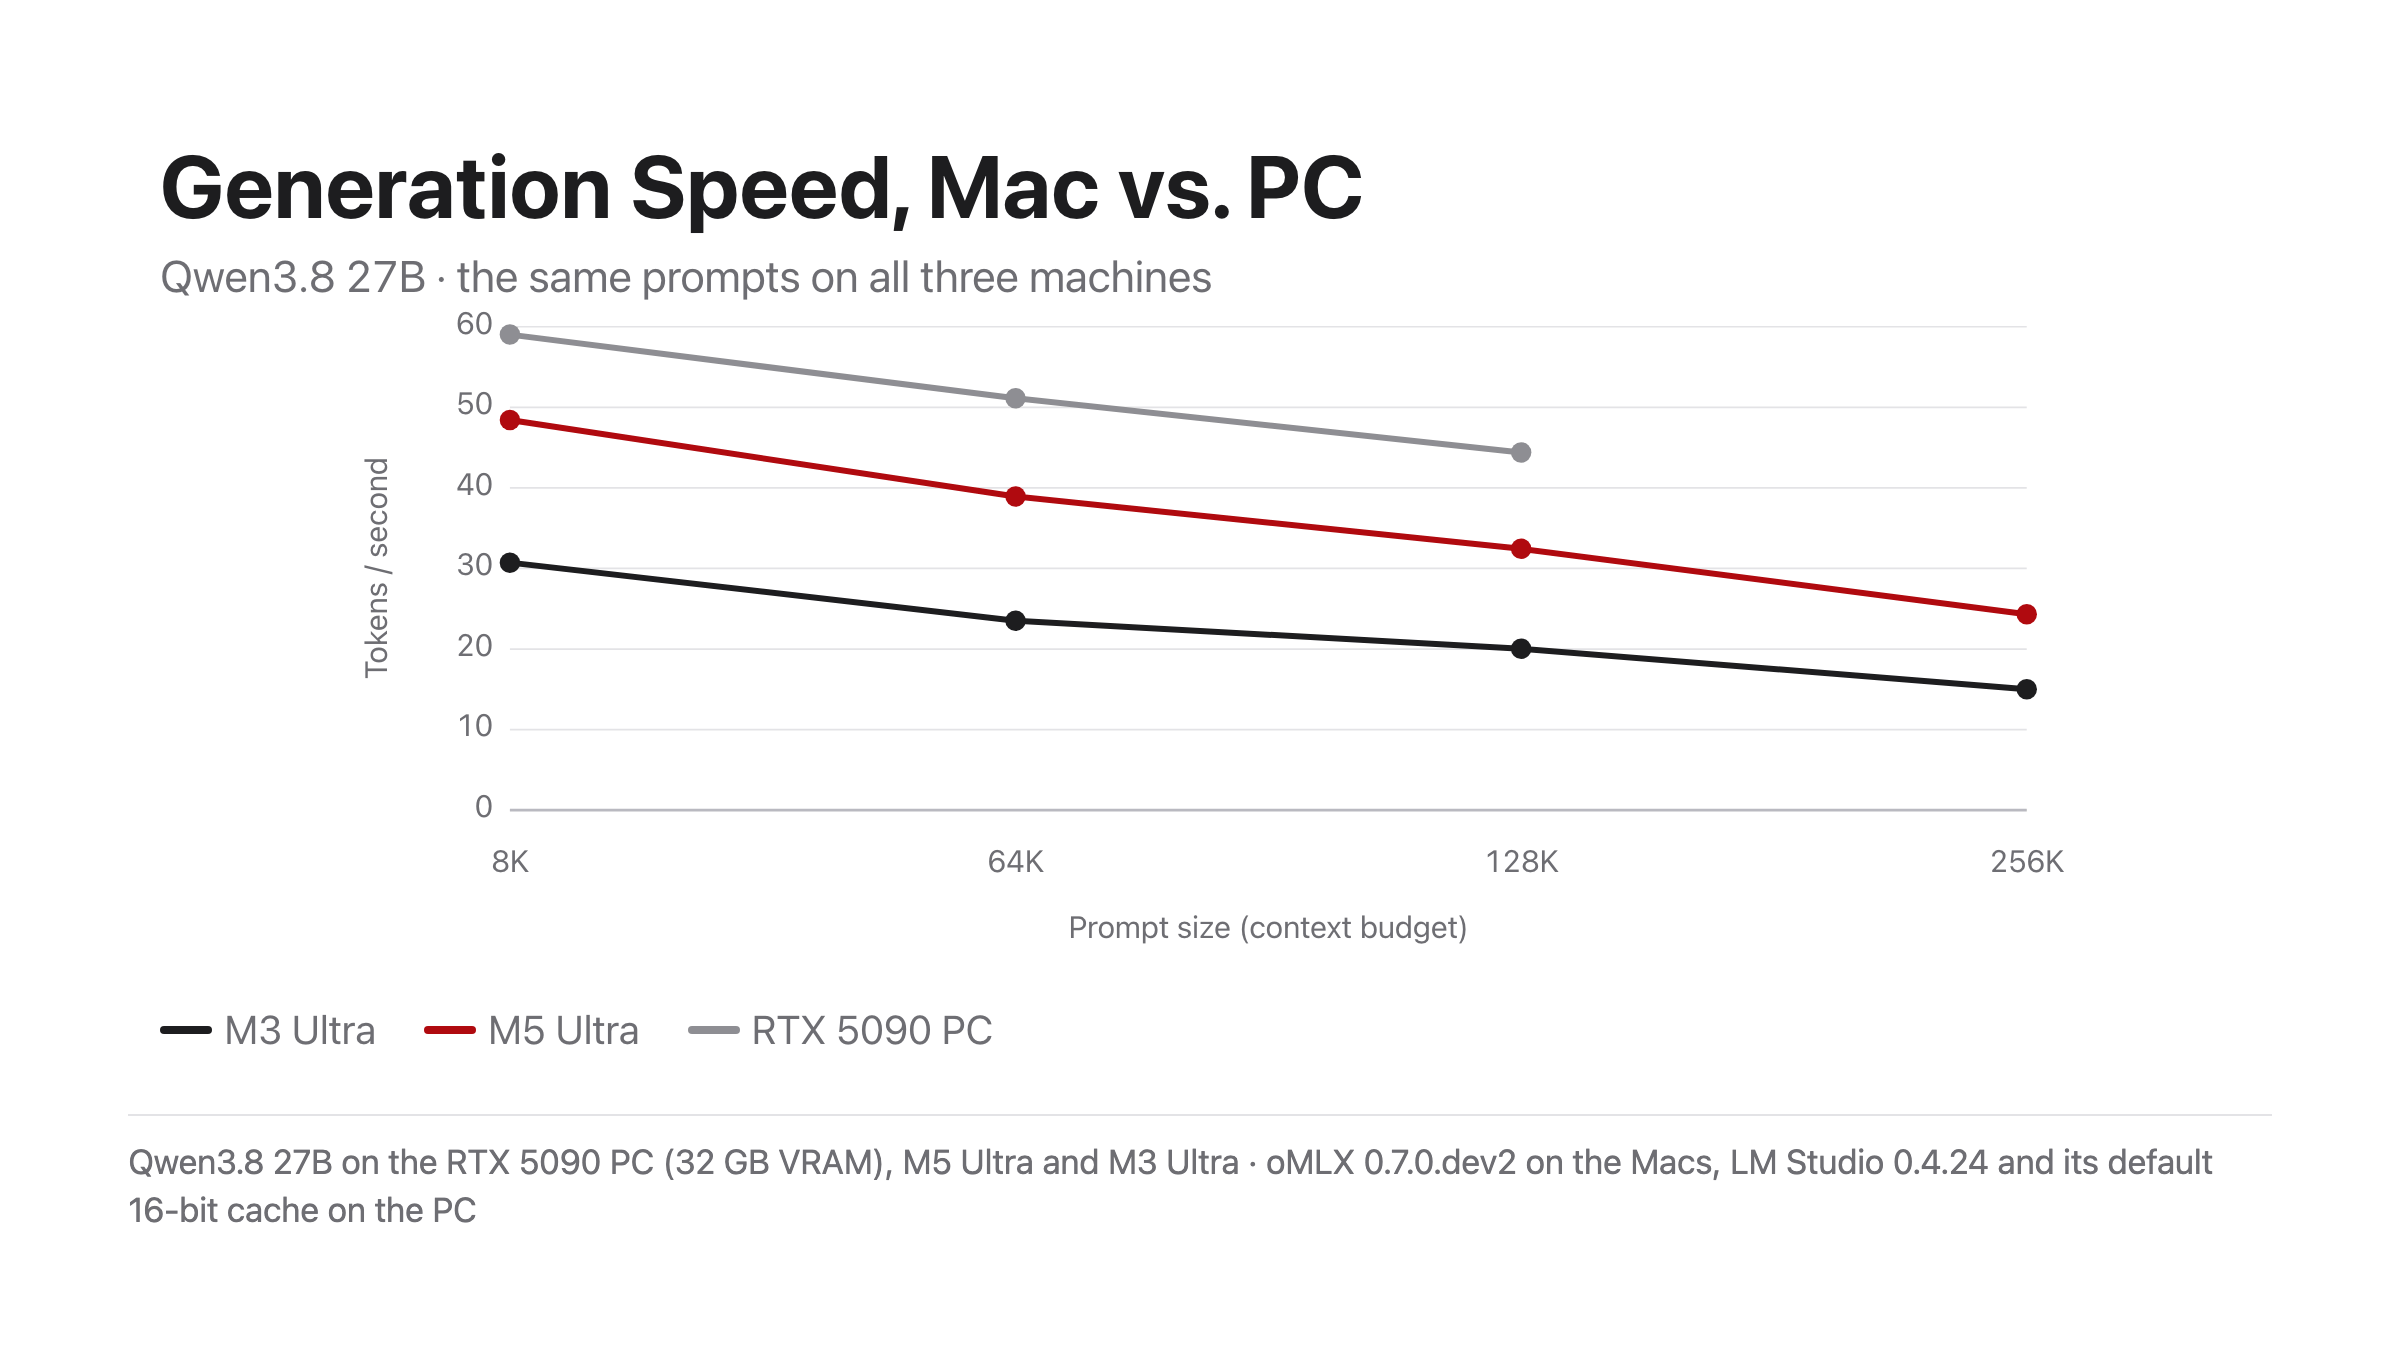
Как видно из визуализаций дальше, RTX 5090 от NVIDIA по-прежнему быстрее, чем M5 Ultra от Apple, несмотря на её «скромные» 32 ГБ VRAM, по двум причинам.
Скорость обработки подсказок определяется compute: модель читает всю подсказку за один гигантский matrix multiplication, что в точности то, для чего построены NVIDIA's Tensor Cores. Apple's новые Neural Accelerators (один в каждом из 80 GPU cores M5 Ultra) сокращают разрыв, но не могут его закрыть. На 6,000-token подсказке M5 Ultra читала на ~1,700 tok/s; 5090 выдавала ошеломляющие ~3,000 с Qwen моделью в LM Studio. Генерация токена, с другой стороны, это bandwidth: модель пишет один токен за раз и вытаскивает всю модель из памяти для каждого, так что 5090's 1.79 TB/s против M5 Ultra's 1.2 TB/s даёт ей стабильный ~25% lead на каждом размере prompt'а. Что у 5090 нет — это память: на 256K, 5090 заканчивает только с 8-bit attention cache. 32 ГБ VRAM только столько может.
Однако есть два проблемы с этим сравнением. Первая: хотя 5090 действительно выигрывает у M5 Ultra с меньшими моделями, отсутствие unified memory pool означает, что ограничен 32 ГБ VRAM в GPU, если хочется запустить модель на сумасшедшей скорости. Момент, когда хочется запустить что-то больше 32 ГБ (типа упомянутых выше более высоких Flash-Next quants), 5090 должна offload модель layers через PCIe на (намного более медленное) system RAM, и это не способ жить.
Вторая: gaming PC автора огромный по сравнению с Mac Studio, который укладывается на стол — и это компактная сборка с корпусом Lian-Li A3. Не говоря о том, как громко и горячо становится при запуске локальных моделей с большими окнами контекста: когда вошли в офис после того, как бенчмарки поработали, было неудобно теплее по сравнению с остальной квартирой. В контрасте, «минускульный» Mac Studio на столе был тёплый на ощупь, но он был заметно тише 5090, вентиляторы не крутились так быстро или громко, и, что самое важно, позволял запустить большие модели типа GLM-5.3-Flash локально с приличной производительностью благодаря unified memory архитектуре Apple silicon. В повседневном использовании, когда весь день запускалась Flash-Next oQ4e, никогда не услышал вентилятор Studio на столе если бы не приложить ухо прямо на компьютер.
Судя по прогрессу, который Apple делает в последние годы, не удивился бы, увидев M7 Ultra, который превосходит memory bandwidth 5090 в ближайшем будущем. Но это история для другого раза.
Заметка о тестировании
Наконец, перед тем, как прыгать в raw numbers и charts: как всё это тестировалось?
Автоматизированные тесты проводились с harness, построенным с GPT-6 Astra, который координировал множественные instances Codex на M3 Ultra и M5 Ultra Mac Studio, а также на PC с Codex app для Windows и Computer Use. На macOS выбран oMLX (версия 0.7.0.dev2) в качестве локального backend для MLX моделей, и запущены Qwen3.8-Flash-Next-oQ4e-mtp, GLM-5.3-Flash-MLX-mixed-4_8bit, и Qwen3.8-27B-oQ4e-mtp на macOS Golden Gate 27.0 для большинства тестов. На Windows использован LM Studio и Qwen3.8-27B-GGUF с CUDA 12 runtime и со всеми 66 слоями offloaded на GPU для full-GPU тестов, плюс отдельные тесты splitting модели между GPU и system RAM.
Наряду с отдельными экспериментами с Open Minis' native subagents, использован кастомный testing harness для измерения concurrent requests и workflows, вовлекающих lead модель и множественные helpers, с oMLX подающей Mac модели и LM Studio подающей Windows модель.
Numbers были собраны Astra на протяжении четырёх дней, и позже визуализированы Claude Fable 5.1 и Opus 5 используя предстоящий Projects feature от Anthropic, который удалось протестировать рано при работе над этой историей. Интерактивная визуализация была построена с pure HTML и CSS на основе MacStories' style, и включает комментарии и аннотации от автора.
Цель с следующими интерактивными widgets'ами была не только помочь лучше понять числа, но и визуализировать, что stats значат на практике. Автор доволен widgets'ами, которые приблизительно показывают, как различные tokens per second ощущаются, так как это метрика, которая часто трудна для визуализации. Надеется, что эти анимированные charts будут полезнее, чем обычные «статичные» которые видели в других местах (они также включены внизу).
Визуализация M5 Ultra
Flash-Next и GLM-5.3 на двух Mac Studios
Начнём со сравнения, которое волнует автора больше всего: M5 Ultra против M3 Ultra. В этих тестах использованы одни и те же модели, prompts и oMLX build. Единственное отличие: отправленный M5 Ultra имеет «только» 256 ГБ ОЗУ.
Flash-Next на четырёх квантизациях
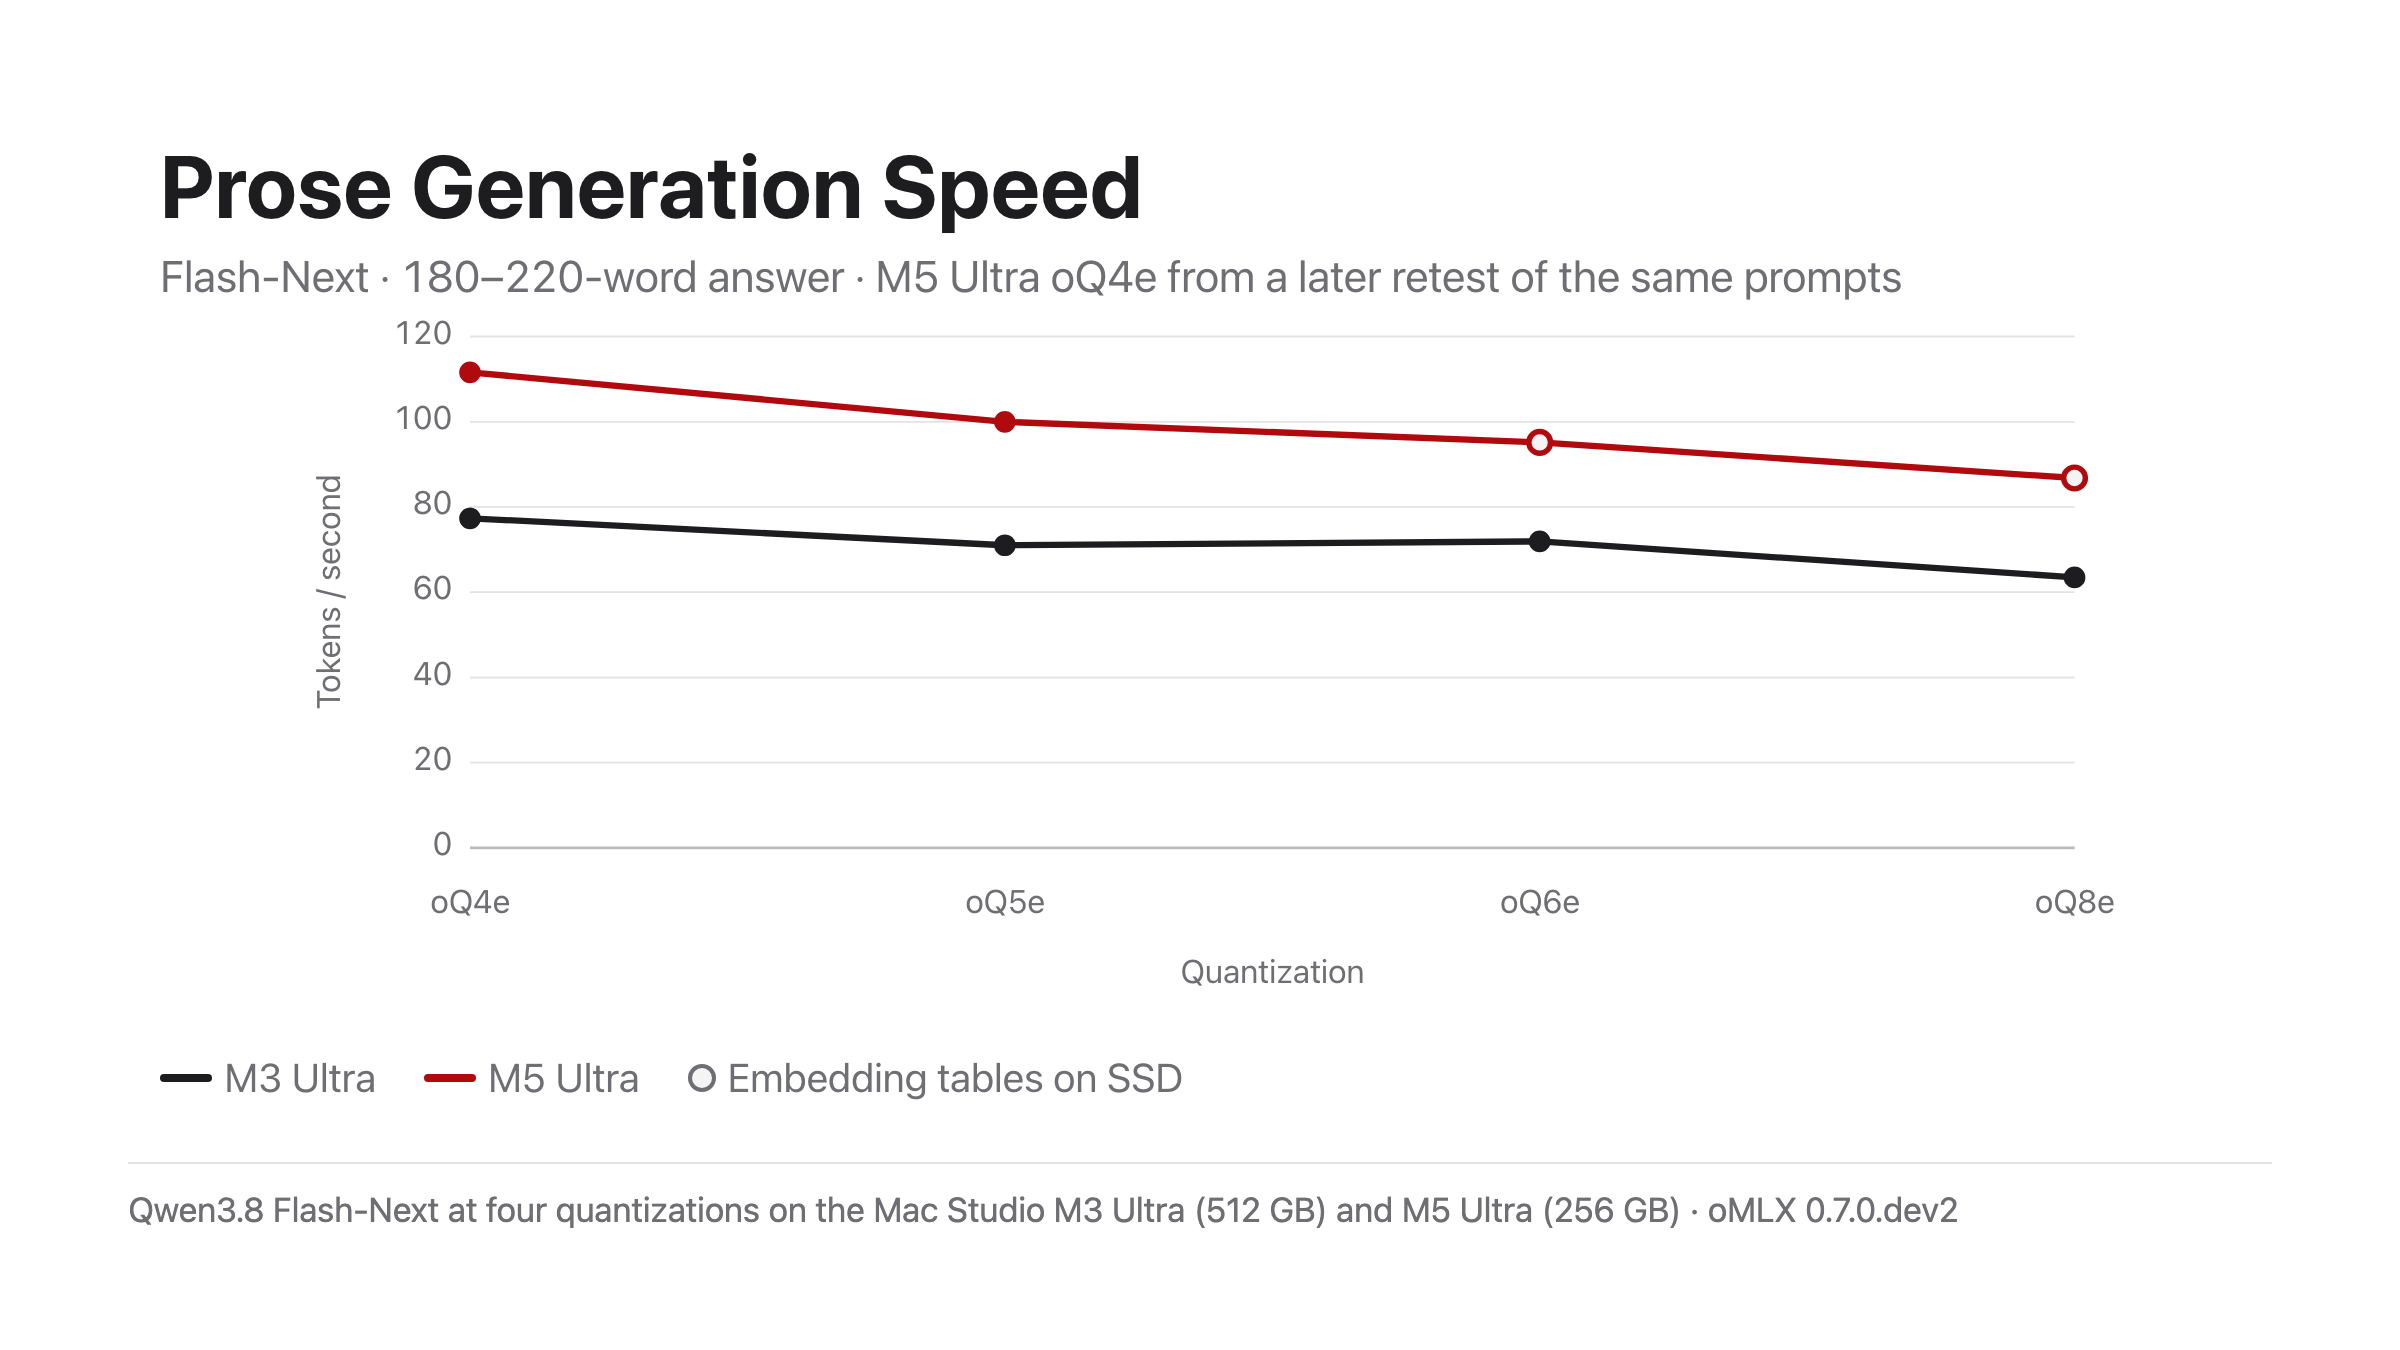
Хотя в большинстве тестов в этом обзоре сосредоточен на 4-bit oQ4e build Flash-Next, тоже поставлена против 5-, 6- и 8-bit builds на обоих Mac Studios. Все четыре запустились в отдельной сессии, с тремя runs каждый, так что 4-bit числа здесь немного отличаются от цифр выше. Больше бит означает больший (и более точный) модель. M3 Ultra Mac Studio с 512 ГБ ОЗУ держит все четыре в памяти. M5 Ultra имеет 256 ГБ: oQ4e и oQ5e укладываются, и oQ6e и oQ8e работают только с их embedding таблицами offloaded на SSD, как они появляются в каждой figure внизу.
Charts
Также собраны классические line charts, нарисованные из чисел, измеренных в этих тестах — давайте взглянем на них.