Представляем System One Models и Jev
Диого Алмейда, основатель TypeSafe
Модели уже много лет превосходят людей в чате — но где же вся автоматизация?
Этот вопрос движет мной вот уже четыре года. В OpenAI я помогал разрабатывать методы, которые сделали языковые модели полезными для следования инструкциям и общения с людьми. Эта работа легла в основу исследований ChatGPT. Тогда я думал, что chat-модели могут привести к AGI, но несмотря на весь хайп, стало очевидно, что что-то по-настоящему важное отсутствует.
После двух лет разработки в режиме stealth, множества технических вызовов и прорывов в исследованиях... я рад объявить, что сегодня TypeSafe AI выпускает нашу первую System One Model — новый класс frontier-моделей, построенных для быстрых структурированных решений, которые программное обеспечение может использовать напрямую.
Мы создали совершенно новый стек, сосредоточенный на автоматизации: с новой архитектурой модели, параллельным сэмплером для максимальной эффективности и методом обучения, который мы называем Reinforcement Learning for Calibrated Decisions (RLCD).
Наша первая публичная модель — Jev, доступная сегодня в ранний доступ. Jev достигает уровня интеллекта, сопоставимого с существующими LLM на задачах System One, при этом быстрее и эффективнее в два порядка величины. Хотя Jev не генерирует строки, она оптимизирована для структурированных выходов и не может галлюцинировать.
Думайте о Jev как о frontier-интеллектуальном вызове функции: неструктурированное состояние на входе, типизированные вероятностные решения на выходе.
Экстраординарные утверждения требуют экстраординарных доказательств, поэтому ниже — все детали. 💅
Границы: старые и новые
Существующие LLM | System One + Jev | |
|---|---|---|
Оптимизация | Reinforcement Learning with Human Feedback (RLHF) / Reinforcement Learning with Verifiable Rewards (RLVR) | Reinforcement Learning for Calibrated Decisions (RLCD) |
Оптимизирует | Предпочтение человека: тексты и ответы в чате, которые предпочитают оценивающие люди. Проверяемые награды: выходы, которые можно программно проверить. | Калиброванные решения: ответы с эпистемически честными вероятностями на задачи System One. |
Входы | Неструктурированные данные (напр. текст) с упором на последовательные сообщения. | Неструктурированные данные (напр. текст) с упором на структурированное состояние программы. |
Выходы | Строки / генерируемый текст. Строки гибкие и могут быть чем угодно: ответы в чате, код, галлюцинации, отказы или даже типизированные структурированные значения. Чтобы использовать программой, ответы нужно парсить + валидировать. Также всегда есть риск, что AI выйдет из-под контроля. | Типизированные структурированные значения. Возможные выходы и структура определены заранее. Модель никогда не делает ошибок типов. Все ответы сопровождаются калиброванными вероятностями и оценками уверенности. |
Сэмплирование | Последовательное. Генерирует один токен за раз, каждый обусловленный предыдущим. | Параллельное. Генерирует все выходы в одном запросе. Невероятно эффективно и осведомлено о железе. |
Стоимость | Входные токены: от $0.20 до $10 / MTok. Выходные токены: примерно в 5 раз дороже входных токенов. | Входные токены: $0.042 / MTok ($42 за млрд токенов). Выходные токены: БЕСПЛАТНО (слишком дешево для учёта). |
Скорость | Сквозное время ответа составляет 3–329 секунд для frontier-моделей. Достаточно быстро для взаимодействия с человеком, но серьёзное узкое место при интеграции в код. | Сквозное время ответа 70–500 мс для TypeSafe. Это может быть в 40–200 раз быстрее при том же уровне frontier-интеллекта на запросах в стиле System One. |
Уверенность | Даже если попросить оценку уверенности, модели склонны к переуверенности и непоследовательности. Если модель выполняет задачу в 95% случаев, но не говорит, когда она в 5%, она не может автоматизировать эту задачу. | Всегда сообщает уверенность и неопределённость с каждым выходом. Калибрована: выше уверенность — выше точность. Более последовательна: возвращает похожие ответы на похожие входы. |
Примеры использования | Задачи с участием человека (чатботы, копилоты, agenty кодирования). Общие и мощные, но требуют человеческого надзора, потому что их свобода также означает, что они могут выйти из-под контроля.
Демо. Гибкость строк позволяет невероятно быстро создавать прототипы, которые работают иногда. | AI-Powered Workflows / умные if-операторы. Структурированные выходы встраиваются в обычное ПО как нечёткие правила решения: классифицируй, маршрутизируй, оценивай, извлекай или ветвись там, где написанная вручную логика слишком хрупка. Окружающий код ограничивает их свободу, облегчая композицию в надёжные системы.
|
Доказательства / технические результаты
Мы любим скептиков и сами скептики.
Есть утверждения, которые легко проверить:
Скорость на вызов: Мы действительно настолько быстры, хотя наши опубликованные эвалюации обычно запускаются с наших ноутбуков на западном побережье (там сейчас расположен наш сервис).
Стоимость на вызов: Мы делаем нашу цену прозрачной. Мы не можем доказать, что она не субсидируется; нам нужно время, чтобы доказать устойчивость нашей цены (которая, как мы ожидаем, будет снижаться, а не расти).
Без ошибок типов: Это было бы легко опровергнуть одним контрпримером, но это математически невозможно.
Для более смелых утверждений мы хотим дать как можно больше нюансов.
Демонстрация рядом
Наша демонстрация рядом показывает ключевое различие между нашими моделями и LLM: Jev выводит все вероятности параллельно вместо авторегрессивной генерации по токенам. Строки невероятно мощны и универсальны, но дорогостоящи. «Отказ» от строк на самом деле дает нам много суперспособностей!
Нюансы:
Для людей с ранним доступом к TypeSafe вот реальный запрос.
Запрос сильно упрощен и
questionsвыбраны так, чтобы иметь описательные, удобочитаемые ключи, чтобы выход на экране был понятен.state— это также короткий, плотный и детальный абзац, чтобы подчеркнуть разницу в методологии сэмплирования. Относительно более короткий вход выглядит выгодно для нашей модели.
Для внимательного глаза в записанном запуске единственное разногласие с GPT-5.6 Terra — на «Уровень вероятности оттока». Реальный ответ нам кажется действительно неоднозначным.
Мы использовали GPT-5.6 Terra с рассуждением по умолчанию для этого примера, потому что считаем его наиболее сопоставимым по интеллекту с Jev в среднем.
Забавный факт: похожая демонстрация убедила нас полностью сосредоточиться на направлении System One Models!
Workflow-эвалюации
Мы создали новый тип оценки для измерения того, насколько хорошо AI работает внутри кода. Мы не оптимизируем для наземной правды классификации и позволяем harness-у и модели меняться (потенциально позволяя overfitting через harness-инженерию). Вместо этого мы предполагаем, что существует правильный граф вычислений («workflow» представленный в коде) и используем предсказания крупнейших, умнейших и самых дорогих внешних моделей в качестве эталонных вероятностей.
Переформулировано: каждая модель получает один и тот же workflow. Мы тестируем, как они сравниваются со средним из умнейших моделей (в этом случае Astra и Fable).
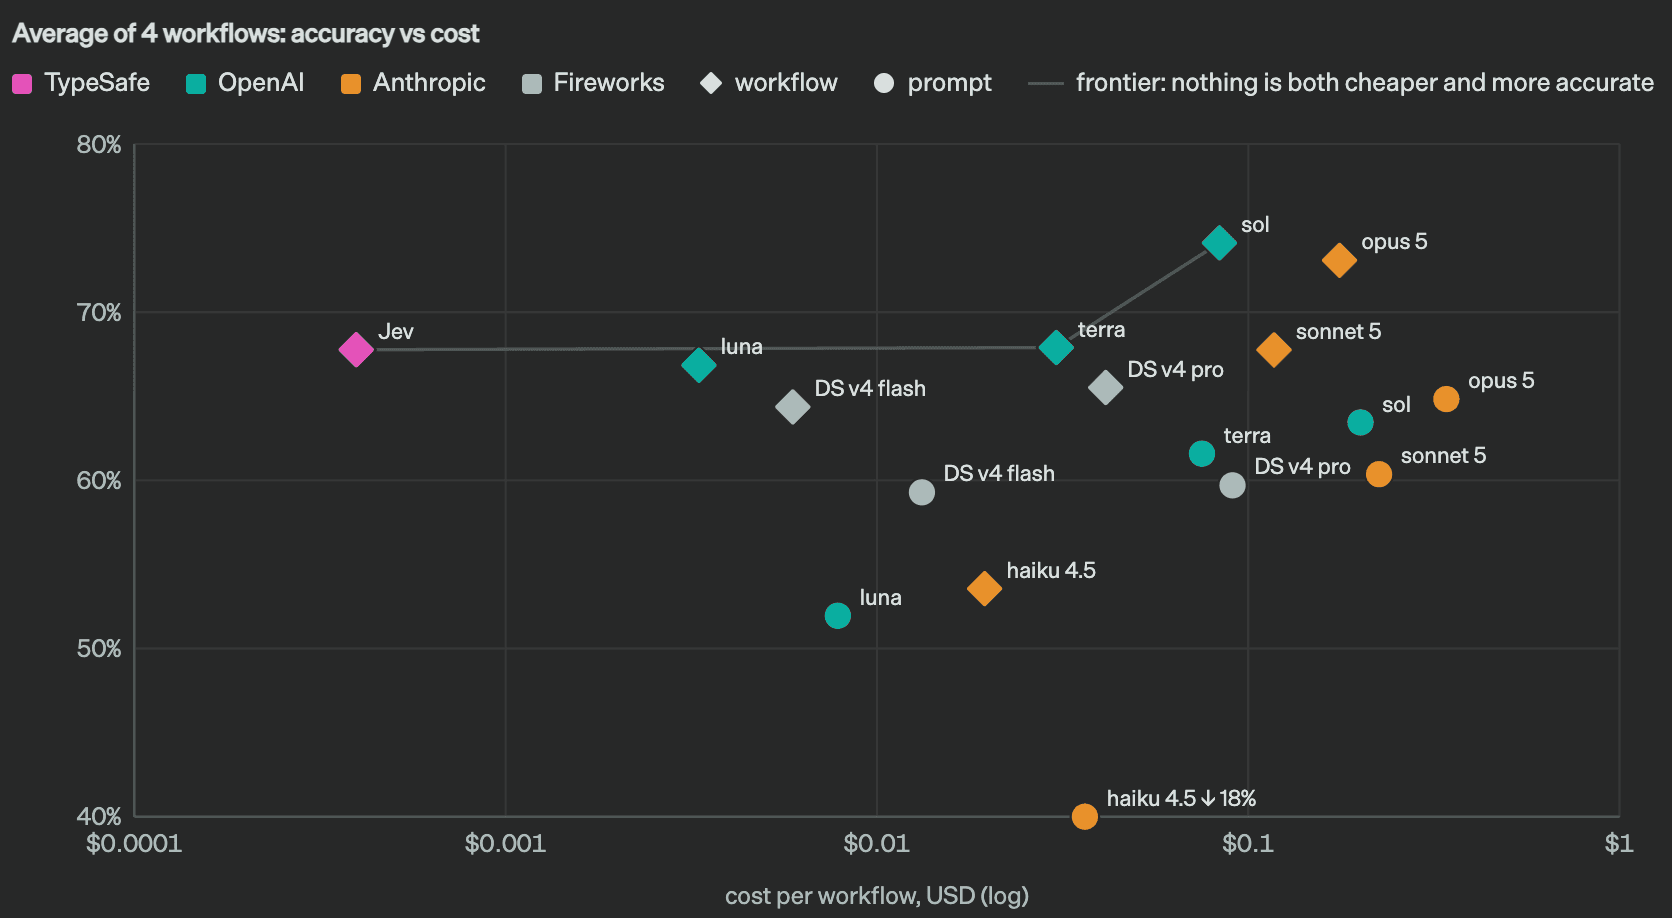
Jev зашкаливает — занимает Pareto frontier почти на два порядка величины. Мы также сравниваем с моделями с сгенерированным промптом, выполняющим всю логику в их цепи мышления, но это, как правило, намного хуже, чем использование самого workflow.
Обратите внимание, что вызовы здесь значительно более сложны, чем демонстрация рядом выше. Это потому, что они более репрезентативны для типов рабочих нагрузок в production, необходимых для истинной бизнес-автоматизации. Ниже приведён самый простой из 4 workflows, которые мы публикуем:
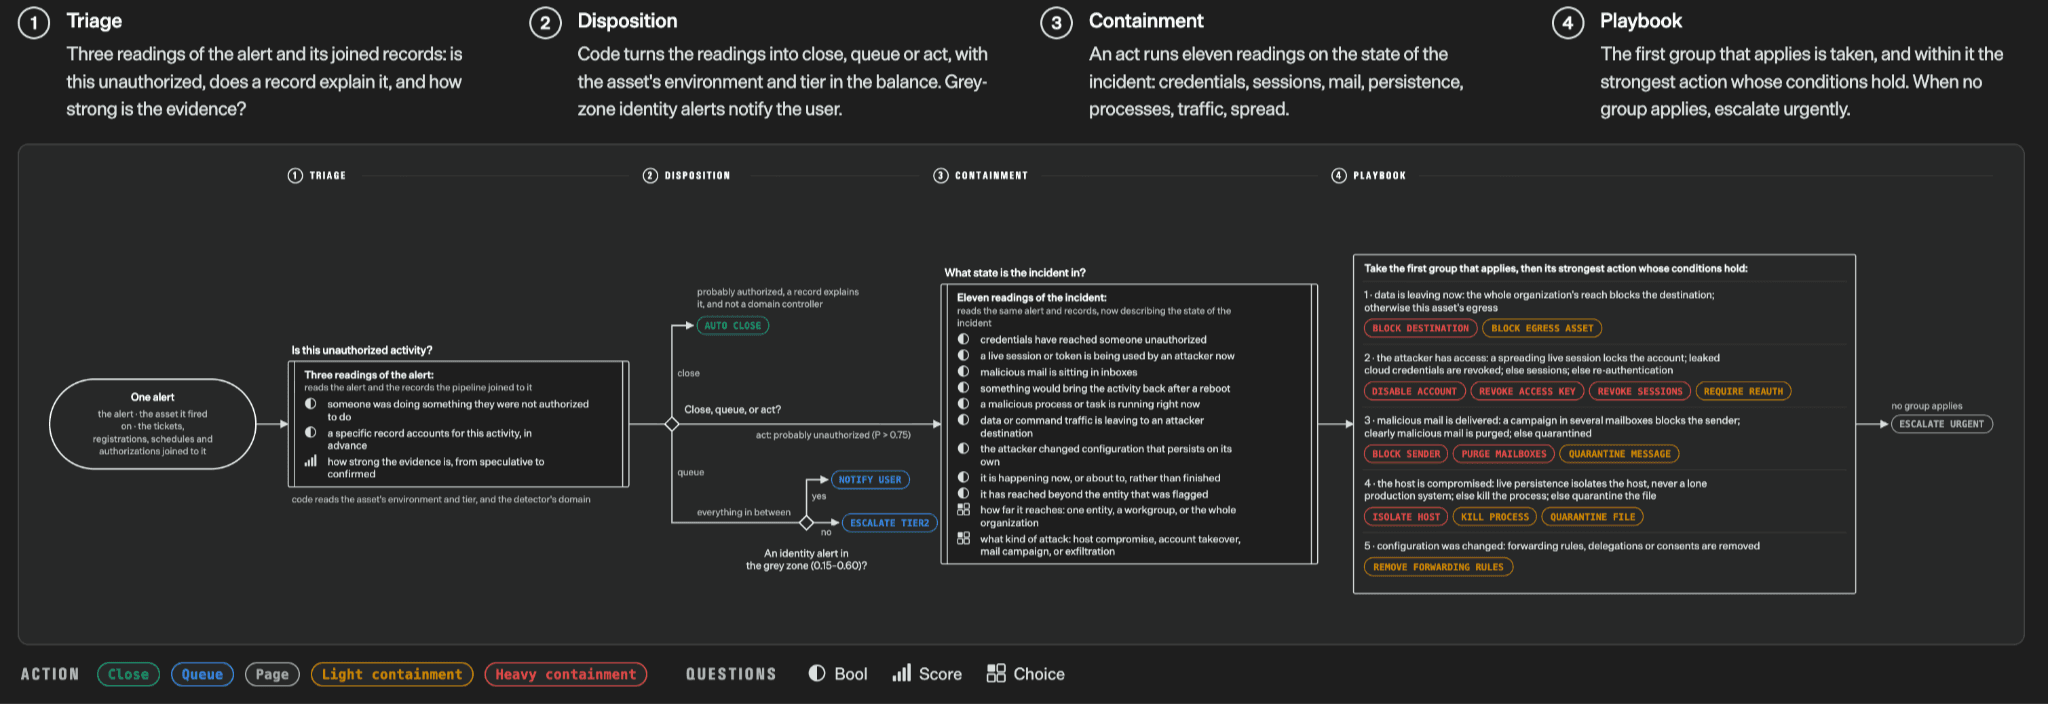
Наиболее надёжные реальные workflow-и обычно имеют много независимых, декомпозированных вопросов с мелкозернистым поведением, зависящим от вероятностей вместо дискретных решений. Конечный результат — дискретное ветвление, но путь к финальному ответу включает много специфической для домена инженерии, которая должна выполняться высоко последовательно.
Полные детали см. на нашем сайте workflow-эвалюаций: примеры, разногласия, полные запросы и каждый workflow.
Нюансы:
Вот откуда берутся утверждения о ускорении в 193.6x, удешевлении в 444.6x на нашей домашней странице, и мы ожидаем, что это находится на верхней границе реальных достижений.
Содержимое этих workflow-ов не было намеренно выбрано или сконструировано, чтобы наша модель выглядела хорошо, и они не в нашем распределении обучения. Однако они были созданы людьми из нашей команды по возможностям модели, поэтому какая-то предвзятость может существовать.
Мы используем среднее из GPT-6 Astra и Fable 5.1 в качестве эталонного ответа, что смещает ответы в сторону моделей OpenAI и Anthropic. Мы, вероятно, недооцениваем относительную производительность нашей модели и моделей DeepSeek.
LLM-ы используют наше System One LLM обёртку, которая ограничивает LLM выводом структурированных решений, совместимых с нашим API. Мы обнаружили, что это наиболее точный способ получить решения от LLM, но это, как правило, медленнее и дороже, чем принятие решений без вероятностей.
Галлюцинации и Type-safety
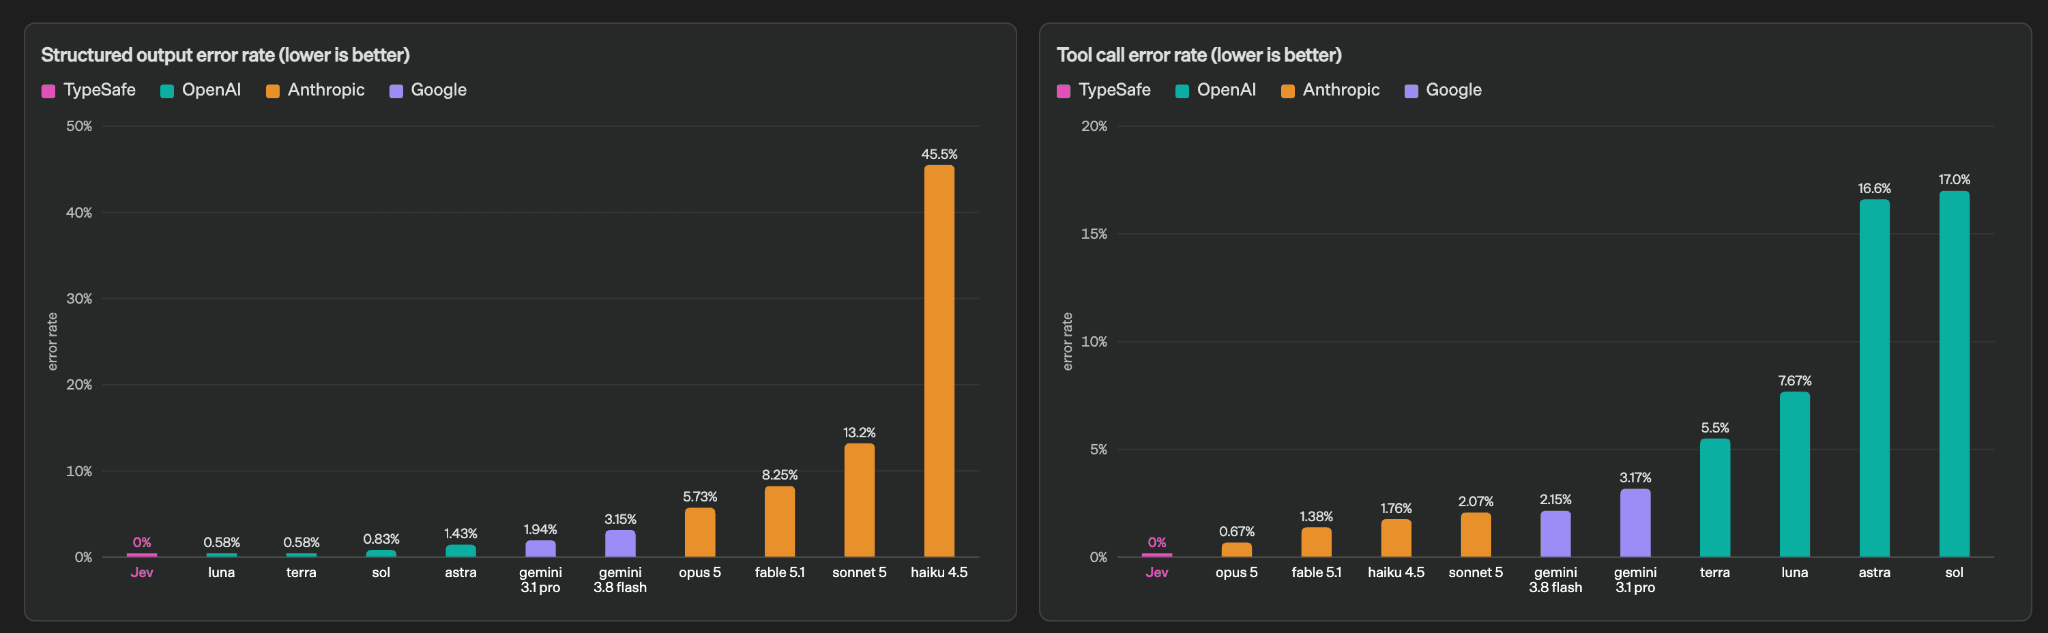
Галлюцинации и type-safety внутренне связаны, и мы считаем последнее основополагающим для автоматизации. Галлюцинированный вызов инструмента неудобен в агенте, но абсолютный стопор, если он является частью системы с гарантиями задержки или зарыт несколько слоёв глубже в цепи зависимостей. Существующие модели, независимо от того, насколько они умны, всё ещё галлюцинируют и допускают ошибки типов.
Нюансы:
Цифры для LLM-ов с OpenRouter, то есть почти наверняка есть предвзятость: более сложные запросы могут быть направлены на лучшие модели.
Наша цифра не эмпирическая. Сопоставление схемы гарантировано, поэтому мы можем уверенно добавить 0% в графики.
Забавные демо
Возможно, наиболее захватывающая часть нашей работы — это открытие новых вариантов использования. У нас есть гораздо больше, чем показать, но вот несколько избранных демо от команды:
Doom
Нам нравится, как это демонстрирует интеллект реального времени и то, что можно сделать с кодом + AI. Инженер, стоящий за этим, беспокоился о выполнении 10 запросов в секунду (что в итоге обходится примерно в $7/час), но остаток из нас согласился, что это ниже ожидаемого! Это настолько забавно, что мы намеревались не только выпустить подробное объяснение, но и провести некоторые события для хакинга на этом.
Нюансы:
Демо находится на структурированном состоянии как структуре данных с текстом, а не на изображениях (пока...)
Неискусственный doom-бот мог бы играть лучше, но мы хотели бота, который был бы реактивен к различным представлениям состояния игры, и самое главное... следование инструкциям было чёртовски крутым!
Wikiracing
Цель игры — начать на одной странице Wikipedia и достичь определённой другой страницы, используя только ссылки, встречаемые при навигации. Каждый шаг может означать выбор из сотен тысячи ссылок! Это отличная площадка для демонстрации не только интеллекта в секунду, но и кумулятивных преимуществ не галлюцинирования с выборами высокой мощности.
Нюансы:
Насколько нам известно, было совершенно случайным, что оба 2-й и 3-й вызовы начинались с «Rubber Duck». Автор заметил это только когда команда указала на это.
Наши ускорения здесь, как правило, намного меньше, чем в предыдущих демо. Это потому, что это против режимов без рассуждений моделей (кроме Astra, который был установлен на самый низкий параметр рассуждений). Это также причина, по которой Jev обычно заканчивалась за меньшее количество шагов (признак большего интеллекта). Это было сделано для того, чтобы демо было более сносным для просмотра. LLM-ы выглядят намного хуже на этой задаче, чем с включённым рассуждением.
Jev поддерживает мощность до 255. Для выборов с более высокой мощностью мы используем 2-этапную систему независимой оценки, затем явное выбирание, отсюда иногда замедление.
Дальнейшие направления
Мы всё ещё в ранних днях Jev. У нас в pipeline-е много ещё, и мы очень рады продолжать отправлять 🔥.
Сегодня мы открываем ранний доступ и как можно быстрее переводим разработчиков со списка ожидания. Мы хотим узнать, какие решения вам нужно автоматизировать, где Jev работает, и где она не справляется. Скажите нам, какую научную фантастику вы хотите построить!!
Мы основали TypeSafe, потому что верим, что AI нуждается в интерфейсе, на который может полагаться программное обеспечение. Мы не можем дождаться, чтобы увидеть новые варианты использования непрерывно распространяться через сообщество и экономику.
FAQ
Откуда берутся названия «System One Models» и «Jev»?
Вдохновлены «Thinking, Fast and Slow» Даниэля Канемана. Имя класса модели вытекает из различия между быстрым, интуитивным System 1 мышлением и медленным, осознанным System 2 рассуждением.
«System 1 thinking» также подразумевал ошибки. По причинам, в которые мы углубимся в будущем, мы верим, что System One Models могут быть сделаны более надёжными, чем его альтернативы.
Мы назвали Jev в честь Уильяма Стэнли Jevons. Мы ожидаем, что машинный интеллект будет следовать аналогичному пути к углю, после того как эффективность паровой машины привела к увеличению спроса. Каждое снижение стоимости интеллекта на порядок величины открывает порядки величины больше вариантов использования.