Откуда берётся видимость?
Когда работаешь над идеей, над куском кода или над многомиллиардным SaaS, который спасает мир — всё равно упираешься в один вопрос: что происходит с моими запросами? Может быть, автоматизируешь производство товаров на основе нейросети, или использует токены для поиска информации о макронутриентах. Скорее всего, работаешь через фронтенд, который подключен к платной подписке у выбранного провайдера: TUI, GUI, голосовой звонок — что угодно. Твои данные входят, их данные выходят. На этом строится бизнес провайдеров, и понимание их заинтересованности в этом логично.
Они часто показывают что-нибудь вроде этого в качестве доказательства работы:
Выглядит внушительно, но толку?
Это отвлечение. Это не статистика использования токенов с временными рядами, предназначенная для инженеров. Невозможно принять решение, опираясь на такое. Логично ожидать, что в аналитической панели будут полезные инсайты:
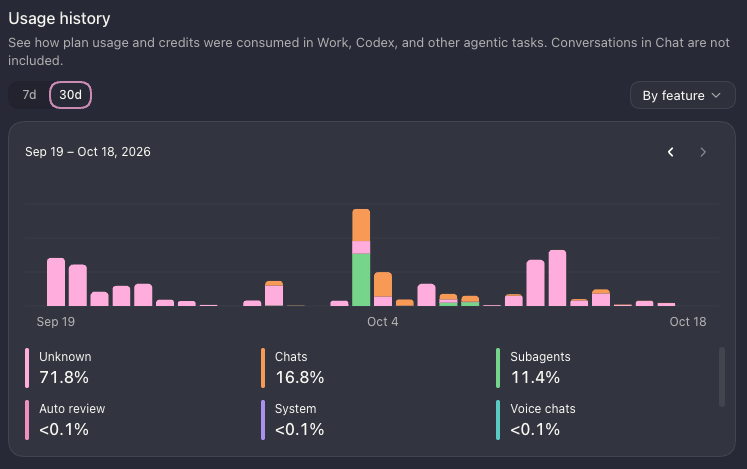
Но обычно это не так. Слышишь — «есть же опции OTel export!» Ладно, может быть. Это одна причина, вот ещё пять прямо с ходу:
- мультипровайдер, мультимодель, один контролируемый endpoint
- логи вызовов: какой ключ, какую модель, какой клиент вызвал, когда и с каким статусом
- виртуальные API ключи, чтобы не раскидывать основной ключ по всему коду, агентам и тестовым фреймворкам
- это инфраструктура, которой ты управляешь
- можно мгновенно переключиться на другую модель или провайдера без переналадки всего с нуля
Контроль над инструментом
Предлагать готовый прокси-сервис для использования — значит быть тяжелым советчиком. Лучше запустить его самостоятельно там, где это твой контроль. И когда выбрал, не забыть: можешь модифицировать под свои нужды. Лучшую видимость, кастомные MCP серверные endpoints, дополнительный функционал — всё это настраивается.
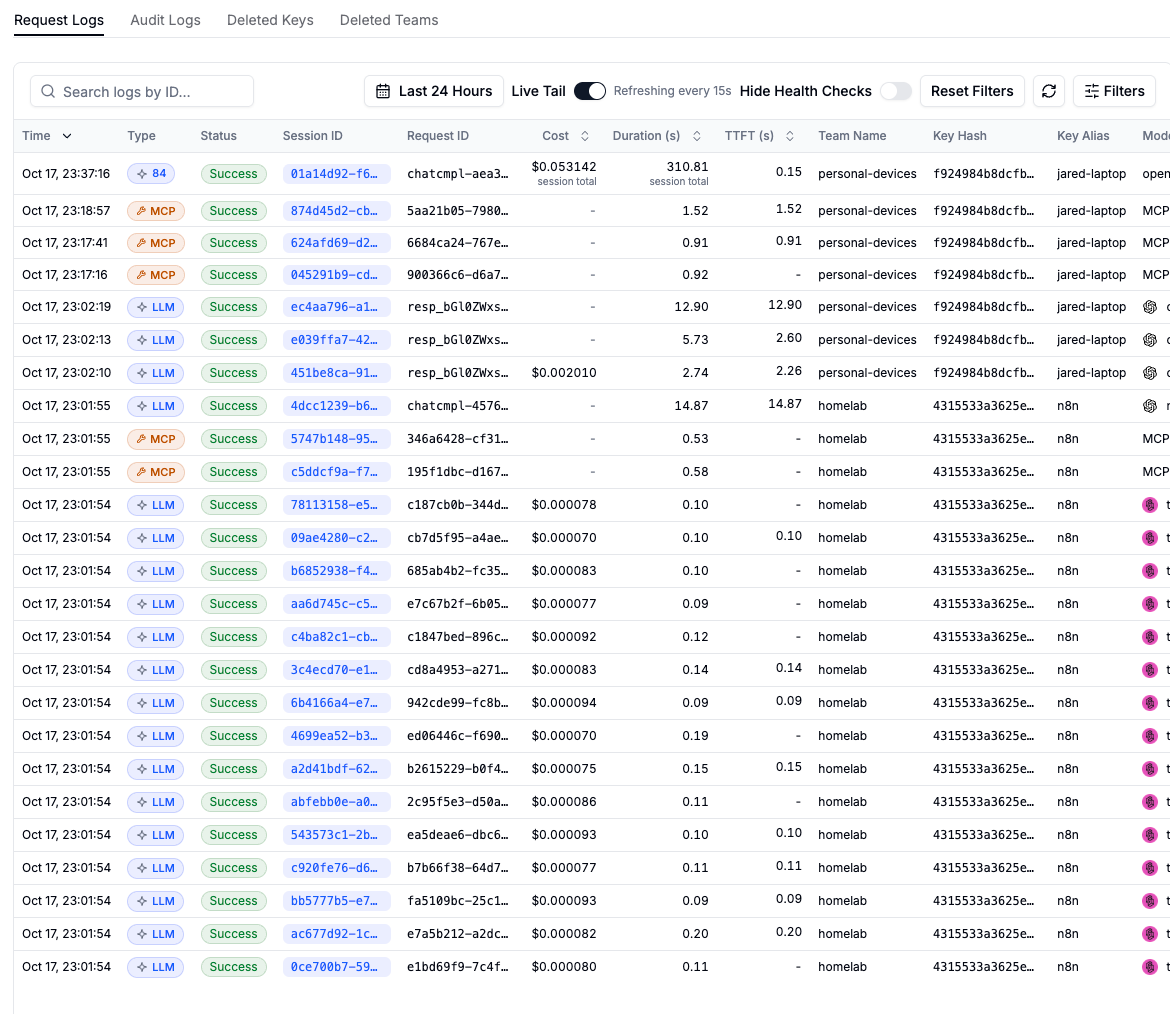
Когда кэш не попадает во время сессии кодирования, можно вычислить причину за 20 секунд вручную. Пока не автоматизировал, но прокси, который использую, имеет API — можно будет автоматизировать.
Управлять инфраструктурой, видимостью приложения, путями движения данных и хранением — это необходимо. Дома делаю это потому, что интересно и так учусь. На работе делаю это потому, что иначе не делаю свою работу правильно. Может быть, никогда полностью не пойму, как работает большая языковая модель настолько хорошо, чтобы раскидать схему на доске на собеседовании. Но можешь приручить LLM и убедиться, что он правильно инструментализирован, пока выполняет вывод.