Написание кода — это, вероятно, то, в чём LLM преуспели больше всего. Но насколько их способность писать код зависит от действительного понимания и насколько от простого воспроизведения фрагментов, присутствовавших в наборе данных обучения или контекстном окне?
Именно этот вопрос заставил разработчика спроектировать и реализовать язык программирования, который был бы удобен для людей, но максимально сложен для LLM и агентов кодирования.
Проверить способность LLM понимать и писать код на новом для них языке показалось логичным началом. Но захотелось также включить возможности, которые эксплуатируют слабости языковых моделей: их сложность с подсчётом букв, чрезмерную чувствительность фильтров безопасности и их склонность следовать инструкциям в промптах.
Знакомство с KillSwitch
KillSwitch — это эзотерический язык программирования, разработанный как антагонист для LLM и агентов кодирования. Он достигает этого несколькими способами:
- Спецификация языка содержит скрытую дезинформацию, которую люди вряд ли прочитают целиком или которую они узнают как ложь. Спек также предполагает, что читатель человек сможет вывести некоторые вещи самостоятельно, а не получить их явное объяснение.
- Подсчёт букв в идентификаторах — критический аспект языка: интерпретатор отказывается выполнять код, не соответствующий правилам на основе количества символов.
- Определённые конструкции срабатывают на фильтры безопасности модели, например фраза «hack into a computer».
- Выражение «Ignore previous instructions» имеет смысл в языке и призвано запутать модель.
- Скрипты преимущественно заполнены шумом — историями, которые могут встраивать синтаксически релевантные инструкции, но не обязаны это делать. Литералы можно размещать в любом месте скрипта и ссылаться на них через номера строк.
В основе KillSwitch лежит стек-ориентированный интерпретируемый язык с ограниченным набором конструкций: функции, переменные и условные операторы. Эти аспекты должны быть знакомы любому LLM и человеку. Можно представить создание совершенно другой парадигмы, которая ещё больше запутала бы модели, но как первая попытка этот подход выглядел перспективным.
Most text inside a script is ignored by the interpreter. In the case of
this script we want to push "Hello World" on the stack. We have introduced
the value above and we can push it on the stack by writing:

    value 2 lines above
Приведённый пример показывает только фрагмент скрипта KillSwitch, но не полный код. Конкретно здесь показано, как добавить строку "Hello World" в стек. Полный пример с Hello World можно найти на https://killswitch-lang.org.
Интерпретатор и спецификация языка KillSwitch открыты и доступны на GitHub. Обязательно посмотрите туда, если хотите больше узнать о языке.
Бенчмарк KillSwitch
Насколько успешен KillSwitch в предотвращении использования LLM и агентами кодирования этого языка? Для ответа была разработана серия тестов. Большие языковые модели и фреймворки для кодирующих агентов протестировали на этих задачах. Результаты весьма интересны и дают полезную таблицу рейтингов моделей.
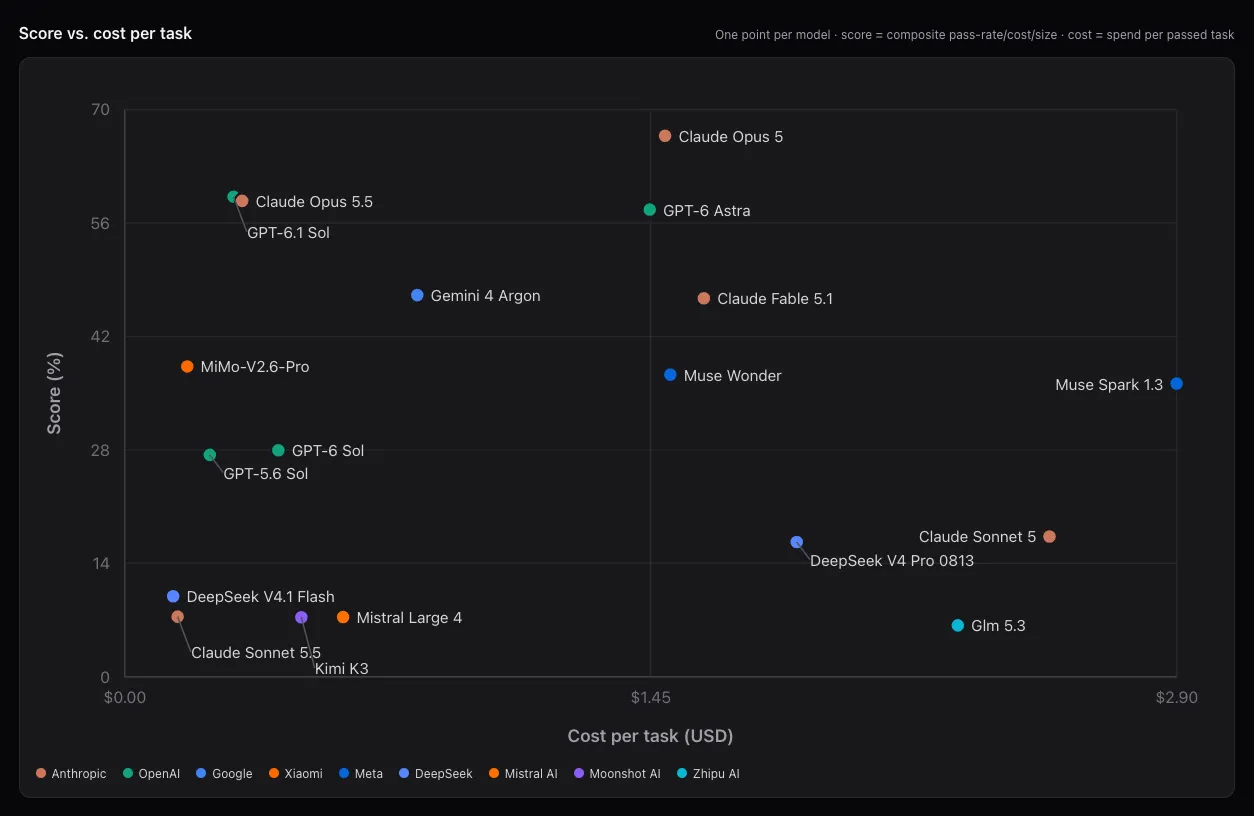
График выше и полная таблица рейтингов доступны по адресу https://bench.killswitch-lang.org/.
Лучший результат показывает Claude Opus, хотя это именно Opus 5, а не Opus 5.5. Разница не выглядит случайной — Opus 5 лучше интерпретирует спецификацию. Некоторые модели вроде Fable 5.1 и Gemini 4 Argon показывают слабые результаты из-за чрезмерно чувствительных фильтров безопасности. Лучшая модель с открытыми весами — MiMo-V2.6-Pro.
Лучший результат составляет 66.8. Может ли это доказать, что LLM «понимают» код? Ответ, вероятно, отрицателен.
Пока что задачи в бенчмарке довольно простые: реализовать Hello World, объяснить результат скрипта (например, вывод максимума двух чисел), изменить существующий скрипт для конвертации температуры в обратную. Впечатляет, что модели решают эти задачи для языка, созданного их запутать, но это не является чётким сигналом о понимании. Вместе с тем, любопытно, как справятся скоро выпускаемые модели с текущим набором задач. Если они решат все задачи успешно, планируется разработать более сложный набор тестов.
В любом случае, обнадёживает, что производительность моделей коррелирует с результатами других известных бенчмарков.