Два простых правила, которые помогут LLM улучшить вашу прозу, не превращая её в промышленный продукт
Писать о написании сложно. Звучит как хвастовство — ты намекаешь, что пишешь хорошо. Может быть, и правда хорошо, а может и нет, но где-то в интернете точно найдется армия критиков, которые будут уверены, что ты пишешь паршиво. Я тщеславен и неуверен в себе, как все остальные, и находу это странно неприятным. Но пережимаю себя и делаю это, потому что совет этот важный, спорить с ним трудно, и он прямолинеен.
Читатели чувствуют слова LLM на любом расстоянии. Сколько бы ты ни работал над шлифовкой и гуманизацией текста, LLM-абзац воспримется аудиторией не как текст, а как результат вычислений. Плохая новость: писать придётся самому.
Но LLM всё ещё невероятно полезны. Только использовать их нужно как корректора, а не как отряд призраков. Первый шаг метода: написать текст самому. Второй шаг: отправить его хорошей модели, чтобы та нашла ошибки.
Но прежде чем говорить о том, как это работает, нужно разобраться с двумя правилами. Они защитят от LLM-заражения, которое затянет тебя в некромантскую долину между выражением и выводом и выкинет из внимания читателя.
Правило первое: ни одного слова из LLM
Нарушение этого правила — верный способ попасть в беду. Причина проста: передовые модели сверхъественно хороши в подборе красивых оборотов речи. Это вообще их основное занятие. Проблемы с тем, что предлагают модели, тонкие. Представь себе так: передовые модели застряли в режиме, где всё, что они пишут, — это заголовок журнала. Заголовки хороши, но было бы странно читать статью с дюжиной заголовков подряд.
Так что я считаю разумным принять за правило: любой конкретный оборот речи, который предложит LLM, запретен. Соблюдай правило строго! Вся идея в том, что ты не сможешь надёжно заметить все способы, которыми передовые модели превратят твою прозу в синтетический маргарин. Даже если слова нравятся, даже если уверен, что они лучше твоих, LLM-фразы — дисквалифицированы.
Правило второе: избегай поощрения
LLM заражают текст и через влияние. Это гораздо более тонкая проблема, и урон менее очевиден, но это всё ещё способ, которым LLM делают прозу хуже. И если результат будет такой, то зачем вообще связываться с моделями.
Суть в том: отправь LLM любой текст, и она ответит «это золото!» Но это не то, что нужно слышать!
В первом черновике большинство абзацев плохи, логика темы запутанна, и на 750 слов больше, чем нужно. Модель хвалит общую структуру. Потом — абзацы и переходы. Потом выбор слов и метафоры. Культурные отсылки. Всё плохо! Совсем плохо! Не слушай!
Вот как это может сломать тебя. Ты начнёшь удваивать все свои первобытные инстинкты из черновика. Но обычно ты так не делаешь. Обычно ты редактируешь, переосмысляешь, переписываешь целые абзацы. Эти переосмысления — несущие стены твоего голоса. Читатели не смогут пальцем указать на проблему, но почувствуют, что ты стал синтетическим.
Пару лет я открывал каждый промпт редактирования ложью, что я не автор, а редактор интернет-издания, отбирающий материалы для публикации. Помогает, но модель обычно переигрывает, переобучаясь под «цели» моего издания.
Поэтому сейчас мой лучший совет: запрети модели хвалу и будь паранойей по отношению к похвалам.
Что они всё же могут делать?
Они отлично ловят проблемы. У тебя их будет много. Их можно найти механически, но это скучная и изнурительная работа. Модели не устают. Так что они лучше тебя замечают:
- переупотребление (или, если верить LLM во всём, может быть, недоупотребление) пассивного залога, номинализацию глаголов, скрытие действия, повтор одних и тех же оборотов речи и словоупотреблений;
- словечки вроде «очень», «к сожалению», «правда», «собственно» рассыпаны по черновику как стружка на столе;
- почти наверняка есть 2–3 абзаца, которые можно быстро передвинуть в другое место статьи, и это сразу улучшит ясность (это действительно очень удовлетворяющий вид редактирования).
Если ты программист, как и я, то хочется, чтобы была книга со схемой для таких редакций — что-то вроде стандарта на архитектуру. И она есть. Книга называется «Style: Lessons In Clarity And Grace», и клянусь, она превращает редактирование в Java-кодирование. Одна и та же нудота, одна и та же эффективность. Узнал о ней от Ричарда Габриеля, и удивляюсь, почему не все программисты держат её на столе.
Так что прочитай «Style» или что-то подобное и делай пометки. Составь список промптов для модели и прогоняй их несколько раз через работу.
Вот что получается с таким подходом:
- Попроси модель найти проблемы в твоём тексте.
- Для каждой проблемы переписать абзац (или предложение, или раздел).
- Показать модели оригинал и новую версию, попросить сказать, какая лучше.
Злобно, но тут ты снова наталкиваешься на вариант Правила Два, потому что модель знает, что ты только что переписал что-то, и знает, что ты хочешь услышать, что новая версия лучше. Поэтому отправь варианты модели, которая не знает контекста твоего редактирования.
Я написал небольшую программу для управления этим, после того как потерял терпение с десятком вкладок браузера и попытками убедить модель, что я не автор, а суровый и полезный тренер по написанию, помогающий студенту, который может быть хорошим, а может быть ужасным. Вот промпт, который хорошо срабатывал:
«Мы строим инструмент для редактирования. Сначала основу. Python, HTMX для взаимодействий, SQLite бэкенд, Tailwind фронтенд, локальная сборка, не CDN. Действительно отличный редактор прозы, в стиле Notion. Поддержка подсвечивания (мы будем делать проходы редактирования). Комментарии в сайдбаре, как на Genius, совпадающие с подсвеченным. Убедись, что можем переключаться между предложениями. Несколько документов, отслеживание версий, возможность отмечать крупные правки. Дай мне это, потом я скажу, что я действительно хочу.»
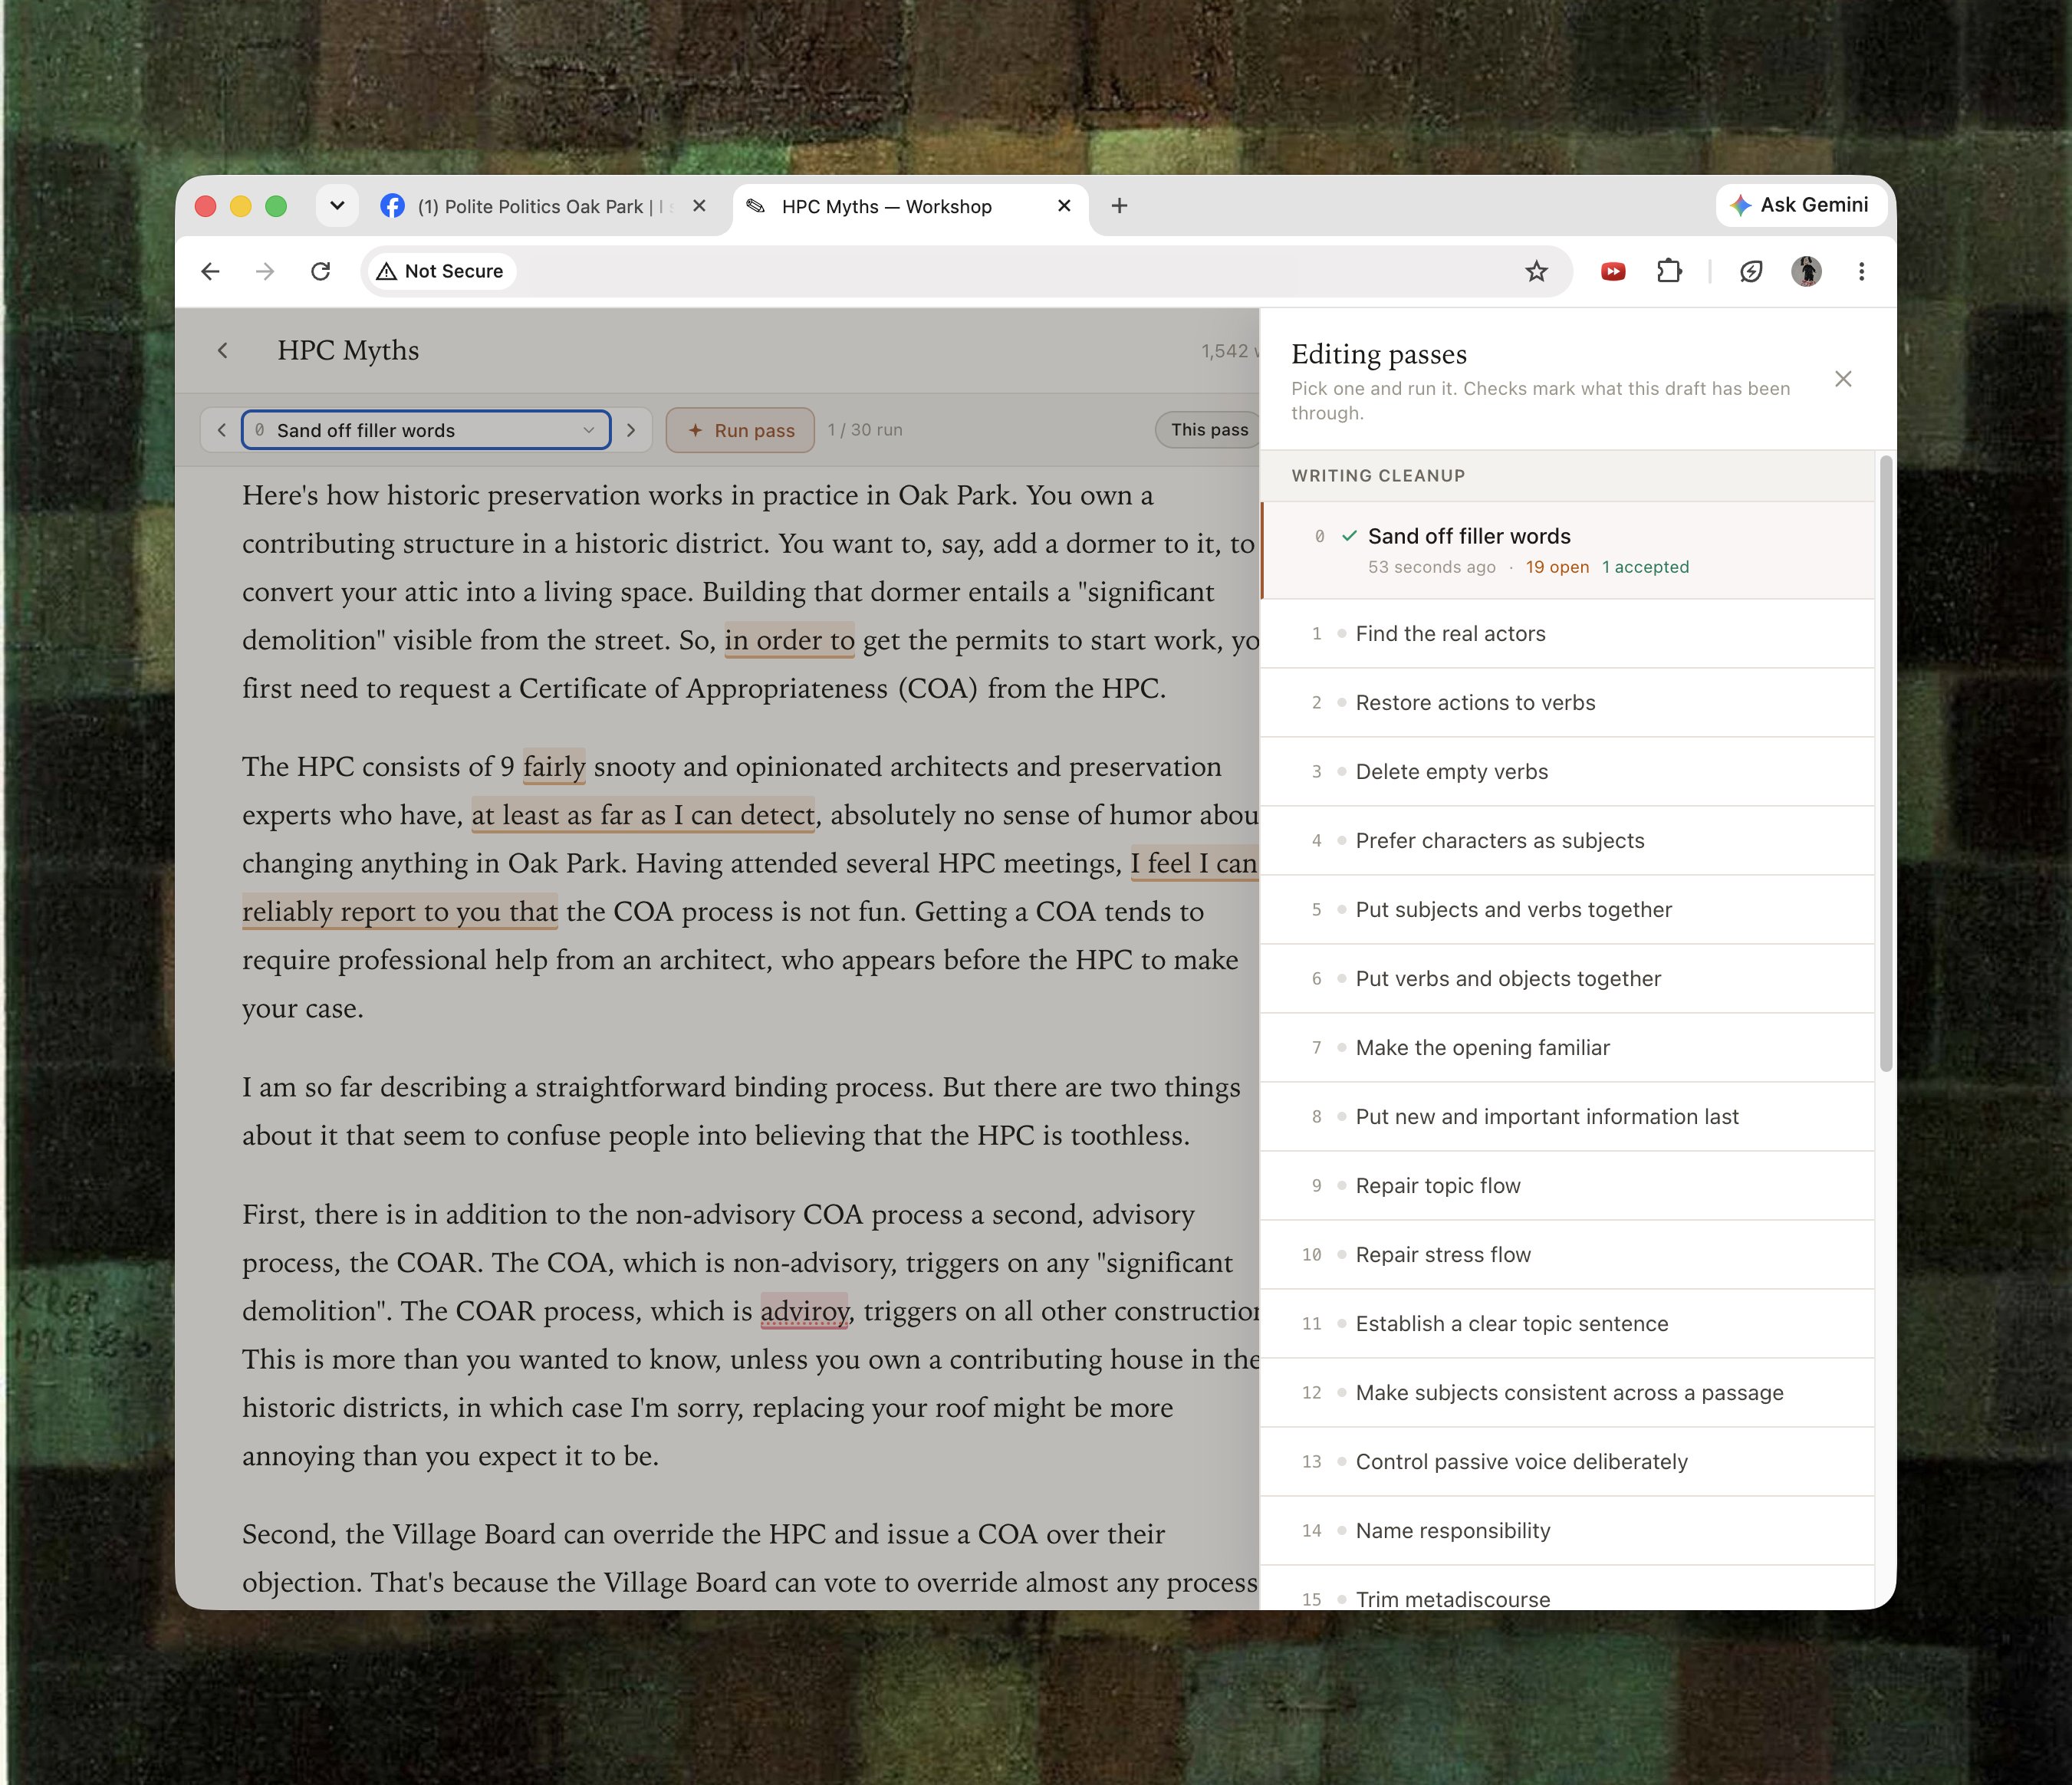
Потом дай инструменту список промптов редактирования, которые ты составил, и запусти каждый через Codex, Claude или Antigravity CLI. Что бы ты ни придумал, это будет лучше, чем моё, потому что каждый придумывает для себя лучше, чем берёт чужое.
Так что: не давай LLM выбирать слова. Будь осторожен, чтобы она не обманула тебя насчёт качества первого черновика. Потом передай ей всю самую скучную работу. Твой голос останется нетронутым, а работа будет быстрее, лучше и менее болезненна.
Ещё одно. Не слушай все рекомендации модели по редактированию. Это следствие Правила Два. Я отправил эту статью GPT-5 минуту назад («я это не писал»), и она сказала, что статья на 20% слишком длинная. Она, похоже, права. Но я это исправлять не буду. Я буду просто я.