OpenAI ускорила разработку чипа Jalapeño с помощью LLM
25 августа OpenAI полностью представила Jalapeño — свой дебютный AI-ускоритель. Чип доставляет до 13,4 петафлопс 4-битных вычислений и имеет доступ к 232 гигабайтам самой продвинутой памяти с пропускной способностью 15,4 терабайта в секунду. По бенчмаркам OpenAI, Jalapeño может сократить сквозную задержку (время от запроса до последнего токена) в 3,6 раза по сравнению с Nvidia GB300 — чипом, на который компания опирается сейчас, — и при этом потребляет меньше энергии.
Остаётся неясным, будут ли эти показатели подтверждены в реальных условиях, когда Jalapeño начнёт массовое использование в инфраструктуре OpenAI, но производительность — это только половина истории. Вторая половина касается процесса разработки самого чипа, который, как можно было предположить, был ускорен благодаря большим языковым моделям (LLM) OpenAI. Jalapeño прошла путь от первой архитектурной концепции до готовой микросхемы менее чем за 20 месяцев. От первого RTL (регистро-транспортного уровня кода, определяющего логику чипа) до tape-out — отправки готового дизайна в производство — прошло всего девять месяцев.
Это быстрый график, но эксперты полагают, что он вскоре может выглядеть медленным по мере улучшения LLM и их более глубокой интеграции в инструменты проектирования чипов. OpenAI, как и следовало ожидать, оптимистична в отношении возможностей.
«Модели дают суперсилы нашим инженерам, — говорит Ричард Хо, вице-президент по аппаратному обеспечению OpenAI. — Наши инженеры по-прежнему ведут работу. Они остаются окончательными арбитрами происходящего. Но они могут делать вещи намного быстрее. Они могут исследовать намного больше путей.»
Небольшая команда достигла быстрых результатов
Хо отмечает, что команда, проектировавшая Jalapeño, в среднем состояла из менее чем 100 человек и продолжает работать в этом составе при разработке второго и третьего поколений. Это число охватывает широкий спектр ролей в аппаратной команде — от системного проектирования до программного обеспечения и управления цепочкой поставок, но не включает специалистов из Broadcom, который партнёрствовал с OpenAI по проекту.
Разделение труда между OpenAI и Broadcom было, как правило, разделено между проектированием и реализацией. Команда OpenAI отвечала за сквозное системное проектирование, включая AI-ускоритель, иерархию памяти и сетевые функции. Broadcom отвечал за «физическое проектирование от уровня логических вентилей и далее».
Партнёрство с Broadcom вызвало некоторые возражения на счёт скорости OpenAI. Дэвид Чин, соосновитель стартапа Verkor.io, занимающегося проектированием чипов с помощью AI-агентов, говорит, что «расписание, которое они предоставили, вполне достоверно», но считает, что помощь Broadcom была критически важна для быстрого графика Jalapeño. «Если кто-то другой начнёт с нуля, это будет невозможно», — добавляет он. Рави Кришна, соосновватель Verkor, назвал скорость OpenAI «относительно впечатляющим результатом», но добавил, что он ожидает, что улучшения возможностей LLM могут привести к ещё более быстрым временным рамкам, если бы проект начался сегодня.
Эндрю Канг, заслуженный профессор Калифорнийского университета в Сан-Диего, также высоко оценил скорость OpenAI, назвав её «вероятно лучшей в своём классе сегодня». Канг вспоминает семинар IEEE Design Automation Futures 2016 года, который он организовал. На семинаре Ричард Хо, в то время инженер Google, выступил с докладом. Он высказал твёрдые мнения по поводу автоматизации проектирования и рассматривал время, необходимое для завершения дизайна чипа, как функцию количества итераций, которые команда могла выполнить за день.
Как LLM OpenAI ускорили проектирование Jalapeño
«Автоматизация уже существует в проектировании чипов десятилетия. Это не новая проблема, — говорит Анкур Шривастава, директор инициатив в области полупроводников и инноваций Мэрилендского университета в Колледж-Парке. — Где LLM отличаются от предыдущих инструментов автоматизации, так это в их способности понимать язык и код.» По его словам, это делает их особенно пригодными для задач проектирования чипов, которые «всё ещё находятся в языковой области проблемы».
Команда OpenAI спроектировала рабочий процесс, использующий эту силу. Front-end рабочий процесс OpenAI был построен вокруг Accelerated Hardware Synthesis (XLS) — набора инструментов синтеза с открытым исходным кодом, первоначально разработанного Google. Синтез высокого уровня — это форма автоматизации проектирования чипов, которая позволяет инженерам проектировать чип в более знакомой среде программирования. В случае XLS проектировщики чипов могут писать на языках, таких как DSLX (специализированный язык, вдохновленный Rust) и C++. XLS затем конвертирует их в Verilog — язык описания аппаратуры, используемый для описания электронных систем.
«Мы думали о том, как использовать AI для ускорения проекта, и AI была намного лучше в работе с вещами, похожими на программное обеспечение, — говорит Крис Лири, технический специалист OpenAI. — XLS в некоторых отношениях выглядит как программное обеспечение, поэтому он получил это преимущество.» Это также помогло тому, что Лири был исключительно хорошо знаком с тем, как должен функционировать XLS, так как он запустил его во время своего времени в Google.
Канг согласен, что решение использовать AI для ускорения высокоуровневого синтеза, такого как XLS, имеет смысл, так как это «более естественно для работы LLM» и предоставляет возможность быстрой итерации. «Я вижу это как общеполезный рабочий процесс, и это то, что «будет актуально» в будущем, — говорит он.
Та же логика привела команду Jalapeño к сосредоточению внимания на оптимизации программного обеспечения. Когда первые чипы вернулись из foundry в мае, команда направила свои внутренние AI модели на проектирование программного обеспечения для запуска бенчмарков, таких как InferenceX компании SemiAnalysis. На бенчмарке многоголового ядра скрытого внимания DeepSeek производительность выросла с 0,31 процента теоретического потолка (установленного вычислениями и пропускной способностью памяти чипа) до 88,94 процента примерно за 40 часов. По словам Хо, этот результат повторяем, поэтому время между поставкой первых чипов из foundry и началом серийного производства может быть сокращено. «Все наши предположения о расписании будут основаны на том факте, что у нас теперь есть эта возможность, — говорит он.
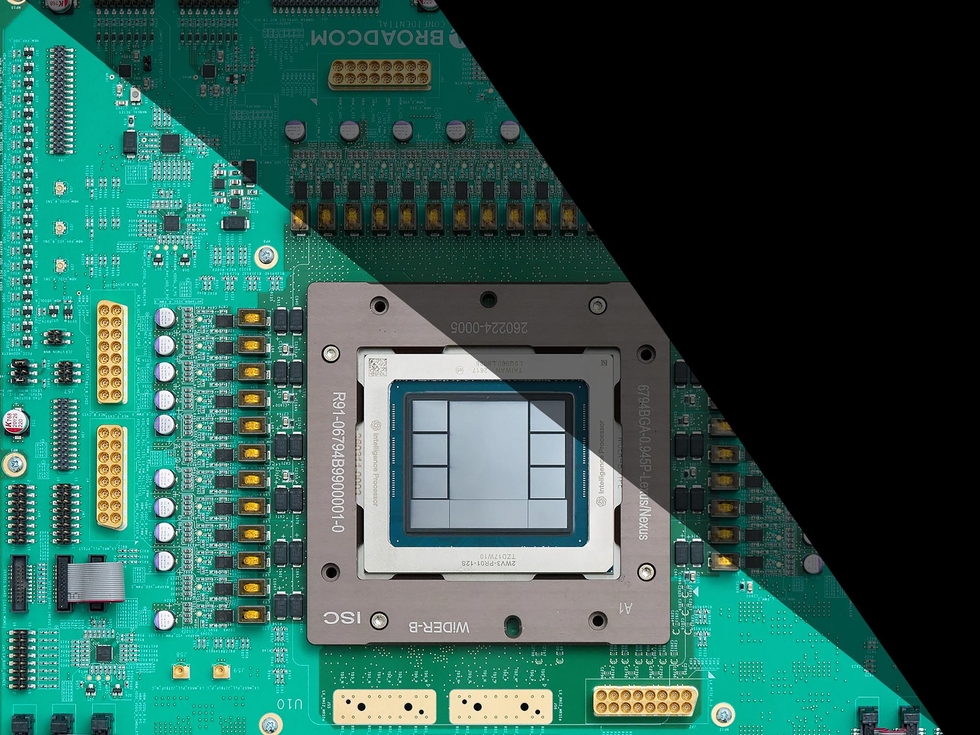
Jalapeño предназначена для развёртывания в подсистемах, включающих 2048 чипов.
Хотя широкие штрихи AI-ускоренного рабочего процесса команды Jalapeño были предугаданы Хо и Лири в начале, улучшения моделей OpenAI принесли несколько сюрпризов.
Лири говорит, что проект начался с помощью моделей, таких как o3 OpenAI, которая была выпущена для публики в апреле 2025 года (но была доступна команде Jalapeño раньше). К тому времени, когда проект завершился, команда получила доступ к моделям, которые были предшественниками GPT-6 Astra, которая не была выпущена для публики до 3 сентября 2026 года. Более новая модель может работать непосредственно в Verilog без необходимости трансляции XLS с обычных языков программирования, и она близка к тому, чтобы иметь возможность работать с собственными инструментами проектирования самостоятельно, говорит Лири.
Хо также подтвердил, что команда имела доступ к внутренним LLM, настроенным на проектирование чипов, которые недоступны для общественности. Он отказался подробнее рассказывать о используемых моделях. Однако он добавил, что команда Jalapeño сотрудничала с исследовательской командой OpenAI. Хотя не все конкретные модели, используемые для проектирования Jalapeño, доступны для общественности, Хо говорит, что целью является внедрение уроков, извлечённых из проекта, в коммерческие LLM компании. «Можно с уверенностью сказать, что Astra и следующие модели будут очень хороши в проектировании чипов, — говорит он.
AI была менее полезна для оптимизации backend, но это может измениться
Как упоминалось выше, основная работа OpenAI над Jalapeño сосредоточилась на «front-end» проектирования чипов, который охватывает задачи от начальной концепции чипа через написание RTL-кода для определения дизайна и проверку того, что дизайн будет работать при физической реализации. Большая часть проектирования «backend» — которое включает такие задачи как маршрутизация соединений, завершение и проверка спецификаций часов и питания, а также отправку необходимой информации о дизайне в foundry — была передана Broadcom, который провел чип через производство.
Это не означает, что рабочий процесс OpenAI игнорировал backend. Команда Jalapeño включает инженеров физического проектирования, которые работают со своими коллегами из Broadcom для предоставления рекомендаций по плану этажа чипа и маршрутизации, помимо прочего.
На IEEE Hot Chips 2026 Хо и Лири привели цифры по выигрышам от оптимизации физического проектирования с помощью AI, включая снижение площади на 10 процентов для блоков матричного умножения в сравнении с оптимизированной человеческой базовой линией. Другими словами, OpenAI утверждает, что AI-управляемая оптимизация помогла разместить больше схем на одной и той же площади кремния, чем это было бы возможно раньше.
Broadcom использовал собственный внутренний рабочий процесс. Команда компании не имела доступа к внутренним моделям, которые OpenAI использовала для помощи в проектировании Jalapeño, но имела доступ к публичным коммерческим моделям OpenAI.
Рави Кришна из Verkor говорит, что подход OpenAI к проектированию backend уже кажется немного консервативным. Он верит, что это артефакт времени, когда проект, начавшийся в октябре 2024 года, имел место. «Модели за последние четыре-пять месяцев улучшились. С апреля 2026 года и далее… тогда они действительно начали лучше справляться с этими задачами, — говорит он. Сурэш Кришна, соосновватель Verkor, согласился, сказав: «нет причины, по которой у вас не было бы агентского цикла, который бы в значительной степени ускорил и backend процесс.»
Хо и Лири также намекнули, что рабочий процесс, использованный для проектирования Jalapeño, может выглядеть старомодным по сравнению с усилиями их следующей команды.
«Как вы можете себе представить с Jalapeño, мы пытались работать как можно быстрее. Поэтому существует компромисс между «хотим ли мы потратить время на некоторые инновации, или мы хотим делать вещи, которые мы знаем исторически работают?» — говорит Лири. — С второго поколения у нас есть возможность для переоценки, чтобы спросить о всех вещах, которые мы хотим установить.»
Хо говорит, что рабочий процесс чипа второго поколения имеет «много мест, где мы вводим AI». Он упоминает возможности для большего использования AI в проверке и физическом проектировании. Лири добавляет, что команда теперь имеет инструменты для автоматического манипулирования и просмотра формы волны. Это автоматизирует анализ для выявления сигналов часов чипа, связанных с отказами, и может улучшить отладку аппаратуры, пока она все ещё проектируется.
Несмотря на эти ожидаемые улучшения, Хо и Лири были ясны в том, что они не считают, что проектирование чипов может быть полностью автоматизировано. «Мы не говорим, что каждый может просто прийти и построить самые передовые, граничные AI/ML чипы-ускорители, используя только платформу кодирования Codex, — объясняет Хо. — Мы говорим о некоторых очень специфических вещах о том, как быть лучше в Codex и как мы сосредоточены на небольшой команде и быстрых сроках для достижения качественных результатов.»