Переосмысление назначения код-ревью
Когда агенты пишут код, объём изменений растёт экспоненциально. В монорепозитории Anthropic количество приземляющихся изменений выросло с около 2500 в день в мае до более чем 30000 в сентябре этого года.
Claude Code живёт в собственном репозитории, отдельно от монорепо, но также испытывает значительную нагрузку. При такой скорости поставок ручное построчное ревью практически невозможно.
Код-ревью решает две задачи:
- Найти и исправить проблемы до релиза
- Построить общее понимание кодовой базы и её архитектуры в команде
Эта статья сосредоточена в основном на первой задаче, но к второй вернёмся ближе к концу.
Вместо вопроса «прочитал ли человек код?» более важно спросить: «что может пойти не так с этим изменением, и какая проверка — автоматизированная или ручная — лучше всего его поймает?»
Этот вопрос также изменил когда происходит ревью. Раньше ревью было шлюзом в конце пути: напиши код, открой PR, жди коллегу.
Теперь ревью работает непрерывно, больше как проверка орфографии во время письма. Большинство изменений уже проверены и исправлены Claude хотя бы один раз до того, как на них посмотрит человек. Это ловит большинство рутинных ошибок и экономит внимание команды для вопросов более высокого уровня.
Дефицитный ресурс: человеческое время и внимание
Нужно сохранить время людей и их внимание для проблем, которые может решить только человек, и убедиться, что автоматизированные проверки ловят остальное. При текущей скорости изменений людям есть что делать, и команда почти ежедневно встречает новые и необычные вызовы.
Человеческое время охватывает обе стороны стоимости ревью: время на проверку и время на исправление того, что сломал плохой код. Сокращение первого не помогает, если время просто перейдёт во второе.
Целевой результат: большинство PR в репозиториях Claude Code (CLI, десктопное и веб-приложения, мобильные приложения) должны мерджиться с максимум одним человеком в цепи — которым может быть сам автор — без увеличения количества reverts или инцидентов. Для измерения человеческого времени отслеживаем количество одобрений человека на PR (медиана и 95-й перцентиль), комментарии людей и время ожидания ответа человека на PR. Коэффициенты reverts и инцидентов — это guardrail: если они растут, мы не сэкономили время, а просто переместили его.
Жизненный цикл изменения
Типичное изменение проходит несколько уровней кода-ревью: от ноутбука инженера (или сессии Claude в Slack) до пользователей.
Слой за слоем
1. Работа проверяется до того, как на неё посмотрит кто-то другой
Большинство ревью теперь происходит до создания PR. Даём Claude что-то, что оно может запустить — тесты, сборку или скриншот для сравнения с дизайном — и просим показать результат вместо того, чтобы просто сказать «готово». Затем субагент проверяет diff со свежим контекстом. Оба подхода из нашего руководства лучших практик.
Перед открытием PR многие из нас запускают несколько внутренних skills: один охотится за багами, один упрощает diff, один проверяет поведение end-to-end. Изменения UI также проверяются против гайдлайнов дизайна.
Борис Чёрни, создатель Claude Code, назвал
дать Claude способ проверить свою работу вероятно самым важнымдля получения хороших результатов. По его оценкам, это делает финальный результат в два-три раза лучше. Он пишет: «Верификация выглядит по-разному в каждой области. Это может быть просто запуск bash-команды, запуск набора тестов, тестирование приложения в браузере или симуляторе телефона».
Когда автоматизированный ревьюер постоянно указывает на одно и то же, фиксим это у источника: в skill, с lint-правилом или обновлением инструкционных файлов, таких как:
CLAUDE.mdрассказывает Claude, что такое проект: стек, конвенции, цели и non-goals. Каждый ревью его загружает, поэтому в большой кодовой базе держим его кратким и указываем на другие docs. Ревьюер также отмечает код, нарушающий конвенцию, и изменения, которые делают строку в нём устаревшей.REVIEW.md, написанный владельцами кода, говорит ревьюеру, что важно в их части кода. Отдельно проверяем, следует ли ревьюер ему на самом деле. Хорошие файлы короткие. Они описывают, как выглядит отказ в том репо (для документации это «ложь», для конфига это «неправильная маршрутизация»), ограничивают придирки, перечисляют пути для пропуска и просят файл и номер строки как доказательство вместо догадки по имени. Они также просят резюме, которое начинается с числа и ясно говорит, когда нечего фиксить.
2. AI-ревью каждого pull request
Каждый PR получает ревью от Claude до того, как на него посмотрит человек. Оно читает diff относительно всего репо и указанного намерения PR, и спрашивает: решает ли изменение свою проблему, подходит ли системе, или ломает что-то ещё?
На исправлении бага ищет root cause. Публичная версия, Code Review для Claude Code, теперь доступна на планах Team и Enterprise, а /code-review запускает более лёгкую версию локально.
Когда мы запустили research preview, доля внутренних PR, получивших содержательные комментарии ревью, выросла с 16% до 54%. Большинство PR свыше 1000 строк получают findings, большинство маленьких возвращаются чистыми. Админы устанавливают каждый репо на Quick, Standard или Deep. Deep стоит того, где один пропущенный баг стоит больше, чем дополнительное время ревью.
Findings проверяются другими агентами до того, как люди их посмотрят. Несколько агентов одновременно ищут баги. Затем отдельная группа голосует по каждому finding, и оно постится только если достаточно много согласны, что оно реально. Findings только о стиле, диагностике или cleanup удаляются. Мы A/B-тестировали эти фильтры на своих PR до того, как их оставить. Что остаётся, появляется как встроенные комментарии, отсортированные по серьёзности. Каждый помечен Important, Nit или Pre-existing, так что баг, который PR не ввёл, не выглядит виной автора.
На каждый finding нужно ответить. Либо фиксишь, либо закрываешь thread с причиной. Часто агент подхватывает исправление ночью, и автор приходит к PR, который уже прошёл ещё один раунд.
3. Проверка безопасности, которая может заблокировать
Безопасность получает своё собственное автоматизированное ревью тоже. PR не может мерджиться, пока какое-либо finding из bug-ревью или security-ревью остаётся открытым. Либо фиксишь, либо закрываешь thread с кратким обоснованием — так закрываешь false positive.
Если позже коммит исправляет проблему, finding очищается само. Можно установить то же самое с open-source security-ревью GitHub Action или командой /security-review. Setup описан в автоматизированных security-ревью в Claude Code.
4. Автоматизированные проверки, которые могут заблокировать
Обычное: lint, type checks, тесты на каждой платформе, сборка. (Писали о масштабировании CI для такого объёма здесь.) Типичный CLI PR может запустить десятки проверок до того, как кто-то посмотрит на него. PR template спрашивает, как тестировалось изменение и как его откатить. Claude может заполнить это, но человек, который просил изменение, подписывается на это.
5. Одобрение человеком, масштабируемое по риску
Исправление документации и изменение auto-updater'а — разные риски, поэтому получают разное ревью.
| Риск | Примеры | Одобрения человеком |
|---|---|---|
| Низкий | Документация, текст, только-внутренние фичи, additive изменения за флагом | Не требуется, если автоматизированное ревью и security checks зелёные |
| Средний | Обычные changes продукта и изменения в чувствительных областях, таких как кеширование, auto-updater или system prompts | Один человек |
| Высокий | Самый высокорискованный код плюс маленький набор путей, которые всегда требуют двух людей | Два человека |
Уровень устанавливает изменение, не автор. Классификатор читает изменение и выбирает его уровень риска. Второй классификатор спрашивает, нужен ли этому конкретному изменению ещё один человек, даже когда его уровень это не говорит. Некоторые пути всегда нужен человек, что-либо владельцы отметили как чувствительное и любой файл CI workflow.
Только доверенные авторы получают лёгкие пути. Только авторы из trusted list репо получают лёгкие пути, в основном команда, которая его владеет. Все остальные нужен второй человек на одобрение. Одобрение агента никогда не считается одобрением человека. Автоматизированное ревью может очистить низкорискованное изменение, но не может заполнить слот, требующий человека.
Кто бы ни подсказал изменение, тот за него ответственен. На agent-written PR человек, руководящий агентом, считается одним из требуемых ревьюеров, так же как если бы сам напечатал код.
Одобрение покрывает один конкретный коммит. Если приходят новые коммиты, которые система не может гарантировать, как push агента или merge кто-то разрешил вручную, одобрение нужно дать снова.
6. Merge queue, флаги и постепенный релиз
Merge queue перезапускает каждую проверку против main с применённым изменением, так что два PR, прошедшие отдельно, не могут объединиться в сломанный main. Новое поведение обычно шипит за флагом сотрудникам Anthropic сначала, и интенсивное использование часто обнаруживает регрессии до пользователей. Публичные релизы идут на канал latest сначала. Канал stable отстаёт.
7. Быстрое обнаружение, быстрый rollback
Некоторые ошибки ещё пройдут, поэтому последний слой о том, чтобы их ловить быстро. Флаги выключаются без deploy. Claude Code имеет еженедельную ротацию on-call, и reviews инцидентов спрашивают, какой слой должен был поймать проблему.
Заметить плохой merge ещё зависит от автора и on-call а также от dashboards reverts и инцидентов. Пока нет circuit breakers, которые затягивают одобрение когда эти числа движутся; инженеры здесь хотят их до того, как больше кода перейдёт на zero-human merges.
Один коллега сказал, что замедление действительно снижает коэффициент ошибок, но в основном потому что делаешь меньше всего. Скорее хотим получше ловить и исправлять проблемы.
Как делаем ревьюера лучше
Процесс код-ревью постоянно улучшается в цикле.
Любые инциденты теперь — это eval. Команда собрала прошлые PR, вызвавшие инциденты, с их fix-forwards и reverts, и попросили инженеров, знающих тот код, подтвердить каждый баг и где он жил. Ревьюер запускается против этого набора ежедневно.
Шум измеряем, наблюдая, что люди делают с комментариями. Легко ловить больше багов, если не заботишься о том, чтобы отмечать много не-багов, поэтому нужна проверка на это. Сортируем каждый комментарий, который оставляет ревьюер, по тому, как человек на PR ответил: фиксил, говорил, что это неправильно, говорил поведение было намеренным, или решил, что не имело значения. Также запускаем ревьюера на PR, которые мы знаем чистыми и считаем, как часто оно что-то отмечает, что бы привело кого-то к вредоносному изменению. Наш приоритет, записанный, ловить реальные баги сначала и резать раунды ревью вторым.
Шум стоит больше когда автор — агент. Человек может махнуть рукой на nit за секунды. Агент это фиксит, что означает ещё один коммит и ещё один раунд ревью.
Ревью должно сходиться. Автор-агент и ревьюер-агент могут держать друг друга занятыми бесконечно. Один CLI PR прошёл более чем пятьдесят раундов ревью и исправлений ночью до того, как его автор остановил это.
Когда запустили git blame на то, что ревьюер постоянно отмечал, около 59% это был код, который был там с первого pass'а ревьюера. Ревьюер редко находил новые баги, находил немного больше старых в каждом раунде.
Усугубили сами. Привыкли запускать несколько раундов по умолчанию, так как каждый pass ловит что-то новое. Это может быть стоящим на рискованном изменении, но не на каждом PR. Команда теперь отслеживает rounds-to-pass рядом с recall, и изменила re-review:
- Лимит раунда. После трёх раундов ревьюер просит автора отступить и переосмыслить подход.
- Diff-only re-review после первых нескольких pass'ей.
- Флаг класс бага, так автор фиксит каждый экземпляр, не один line.
- Нет повторов findings уже постленных.
Review agents тоже запускаются ночью над существующим кодом, помогая ловить старые баги до того, как появятся ещё где-то.
Где люди остаются в цепи
Вытащить senior инженера из deep work'а, чтобы поймать рутинную ошибку, стоит намного больше, чем автоматизированное ревью. В Anthropic роли переместились с чтения каждого diff на решения, которые машины плохо принимают:
- Стоит ли вообще это строить? Направление, вкус и область. Одна команда, которая объявила свой bottleneck ревью решённым, всё ещё держала human-ревью для changes от вне команды, так кто-то спрашивает «стоит ли мы это делать?»
- Рискованный код такой как billing, auto-updater и CI workflows.
- Архитектура которая устанавливает паттерн, который другие скопируют.
- Чтение доказательства. Output тестов, команда, которая запустилась и что вернула, скриншот, findings ревьюера. Если не можешь сказать, что проверки пропустят, просишь реальное ревью вместо быстрого одобрения.
- Владение результатом. Человек ответственен за каждое изменение, которое шипит, кто бы его ни печатал.
Распределение контекста по команде
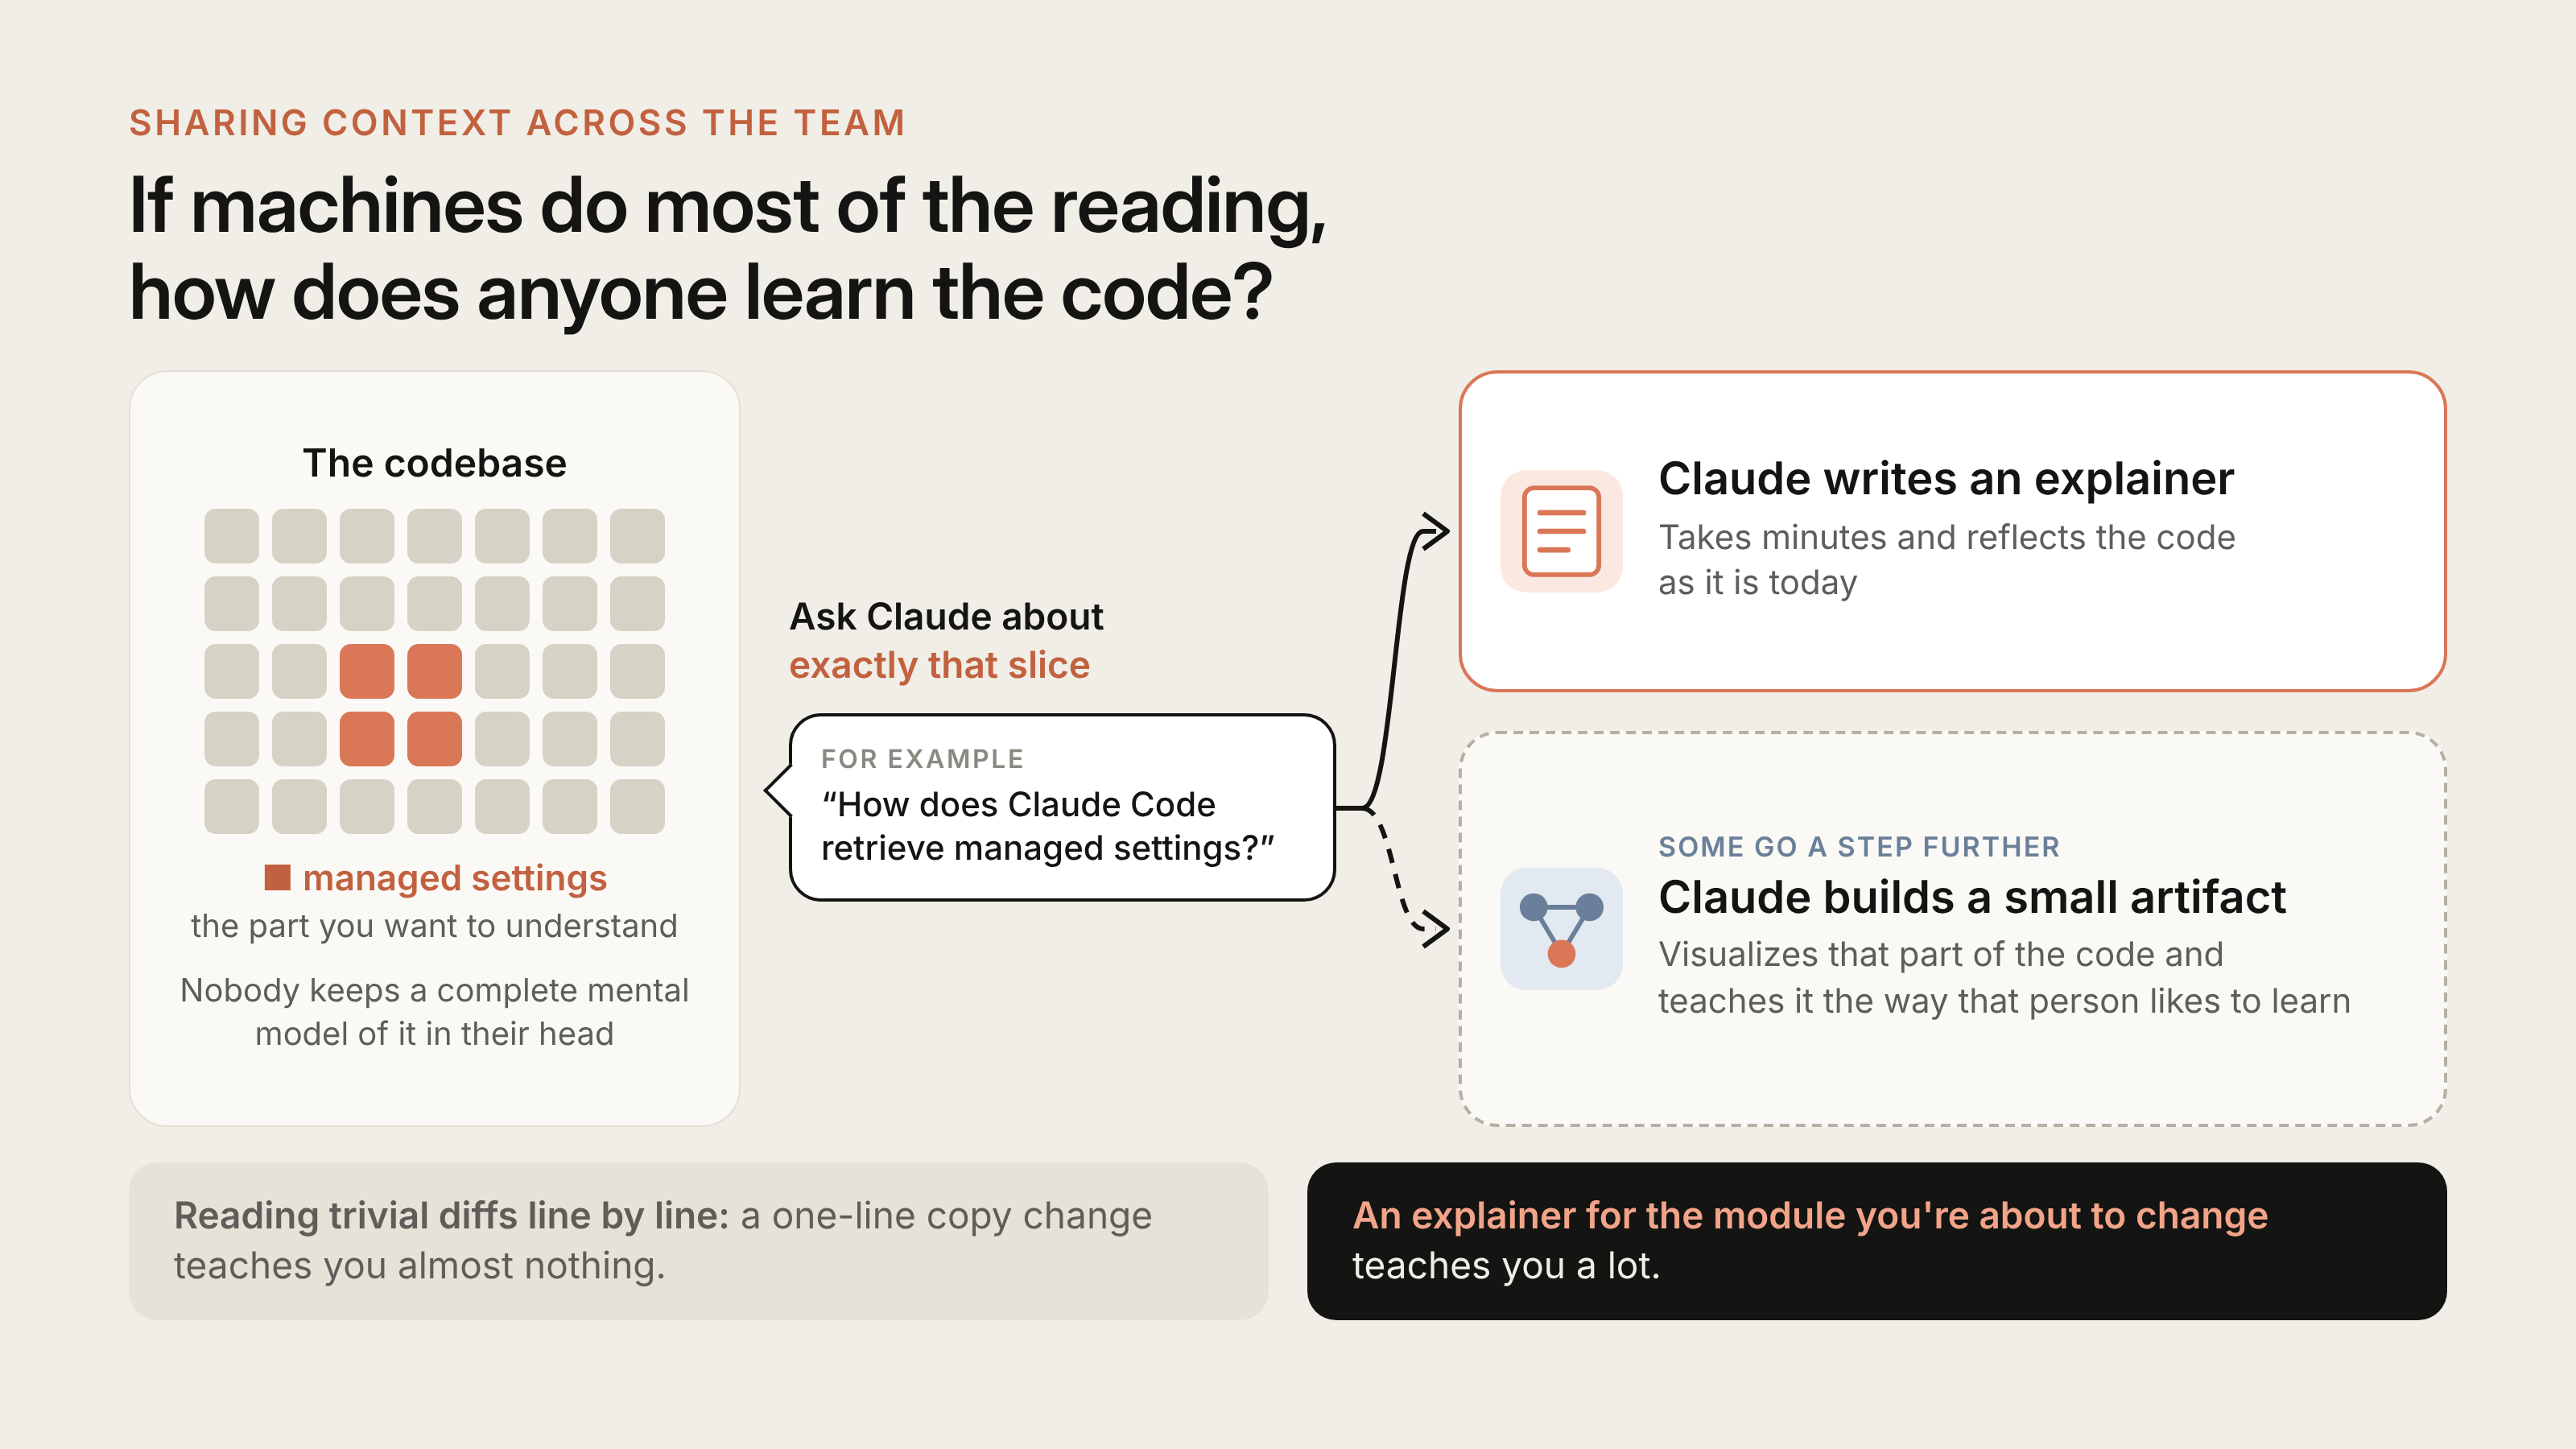
Вторая работа код-ревью всегда была распространением понимания кодовой базы. Чтение diff коллеги — как ты узнаёшь, что изменилось и как куски подходят. Если машины делают большую часть чтения, как кто-либо узнаёт код?
Нет формального процесса для этого. Никто на команде не держит полную mental model Claude Code в голове, и не думаем кто-то должен. Когда кто-то хочет понять часть кодовой базы, просит Claude написать explainer ровно для того slice. Это берёт минуты и отражает код таким, какой он есть сегодня.
Некоторые из нас идут дальше и просят Claude построить маленький artifact, который визуализирует ту часть кода и учит её так, как эта персона любит учиться.
Если цель потратить внимание людей хорошо, это бьёт построчное чтение тривиальных diffs. One-line copy change учит почти ничего. Explainer для модуля, которую собираешься менять, учит многое. Наша культура работы в открытых Slack-каналах помогает тоже, так видишь, что другие строят пока они это строят.
«Ты его приземлил, ты им владеешь»
Если ты приземлил маленькое или среднее изменение и что-то ещё пойдёт не так, team norm что ты обычно это фиксишь. Несколько вещей держат это от плохого:
- Изменения маленькие, так они легко ревьюить, дебажить и откатывать.
- Всё обратимо. Флаги, reverts и staged releases откатывают большинство ошибок в минуты.
- Blast radius устанавливает планку. Дорогой код получает больше людей и больше проверок.
- Регрессии выплывают быстро через телеметрию и внутреннее использование.
- Это не blame. Владение fix'ом означает у тебя больше всего контекста; incident reviews смотрят на систему.
Владение тоже общее. Большая часть команды работает в открытых каналах, где любой видит, что другие строят, подхватить thread или указать Claude на gap, и feedback приходит от людей, которые тоже не владеют кодом. Та открытость большая часть как качество остаётся высоким без шлюза на каждой line.
Когда меняем направление
Агенты делают дешёво начинать вещи, так какая-то работа не должна приземлиться. Обычно кто-то в канале спрашивает почему, указывает на раннее решение или предлагает более простой маршрут, и автор закрывает или переделывает PR.
Так как код был быстро написан, закрытие PR не чувствует как потеря. Трюк поднять другое направление в thread рано, не как блокирующий комментарий на законченном PR.
Как можешь принять этот процесс
Большинство кусков, чтобы это делать с твоей командой, существуют сегодня.
До pull request
- Дай агенту проверки, которые оно может запустить, перечисленные в коротком
CLAUDE.md, плюс hooks, которые запускают formatters и linters. - Запусти
/code-reviewи/security-reviewлокально, или fresh-context субагент-ревью. - Добавь
REVIEW.md, и двигай повторяющиеся комментарии ревью в это.
На каждом pull request
- Требуй CI, и добавь "Testing", "Risk" и "How to revert" в PR template.
- Добавь AI reviewer (Code Review для Claude Code, или Claude Code GitHub Action) на один репо, настрой
REVIEW.mdнесколько недель, потом расширь. - Добавь автоматизированный security-ревью, и требуй каждый review thread разрешён до merge.
- Согласуй effort ревью с риском: быстрый pass на рутинные changes, глубокий где пропущенный баг дорог (Quick, Standard или Deep в Code Review).
- Лимитируй раунды ревью; после первых нескольких, re-review только новый diff.
Одобрение
- Запиши уровни риска, устанавливаемые из изменения а не автора; начни strict и ослабь с доказательством.
- Держи лёгкие approval paths для авторов, которым доверяешь.
- Используй CODEOWNERS и branch protection так auth, billing, CI и release workflows, и installers всегда нужен человек.
- Никогда не позволяй bot approval заменять требуемого человеческого; отмени approvals на новых коммитах.
Merge и после
- Используй merge queue, feature flags, внутреннее использование сначала, staged releases и one-step rollback.
- Поверни инциденты и reverts в eval set, и переоцени ревьюера когда его prompts, tools или model меняются.
- Измеряй человеческое время, с revert и incident rates как guardrail.
Куда это идёт
Announcement Code Review'я сказал одобрение PR всё ещё human call; продукт постит findings, не approvals. Наши собственные репо идут дальше, позволяя владельцам решать какие низкорискованные изменения мерджат на автоматизированных проверках одних, и эта линия продолжает двигаться.
Когда ревью что-то пропускает, спрашиваем что модель не имела перед собой и кладём fix в CLAUDE.md, skill или новую проверку. Цель не изменилась: меньше человеческого времени на изменение, и не больше reverts чем раньше.
Если твоя команда позволяет агентам открывать pull requests, хотели бы услышать какие проверки ты автоматизировал, какие всё ещё нужен человек, и что ты думаешь мы неправильно.
С благодарностью Эмме Вебб, Майклу Сегнеру и Эми Ротерхэм за их ревью.