Развёртывание триллионнопараметрических моделей на Cerebras
Один из самых частых вопросов, которые получает Cerebras — как развертывать большие модели на wafer-scale чипах WSE-3T. Отдельный wafer Cerebras WSE-3T имеет 44 ГБ встроенной памяти, а триллионнопараметрические frontier-модели требуют терабайты только для хранения весов.
В этой статье рассказывается, как распределить большую frontier-модель на несколько wafers WSE-3T и запустить многотриллионнопараметрические модели со скоростью 1000–2000+ токенов в секунду.
Разбор будет проведён на примере открытой модели Kimi K3 с примерно 3 триллионами параметров.
После прочтения вы поймёте:
- как вместить полную модель во встроенную память чипа;
- как отобразить модель на несколько чипов;
- как обрабатывать большое количество одновременных запросов.
Разбор на примере Kimi K3
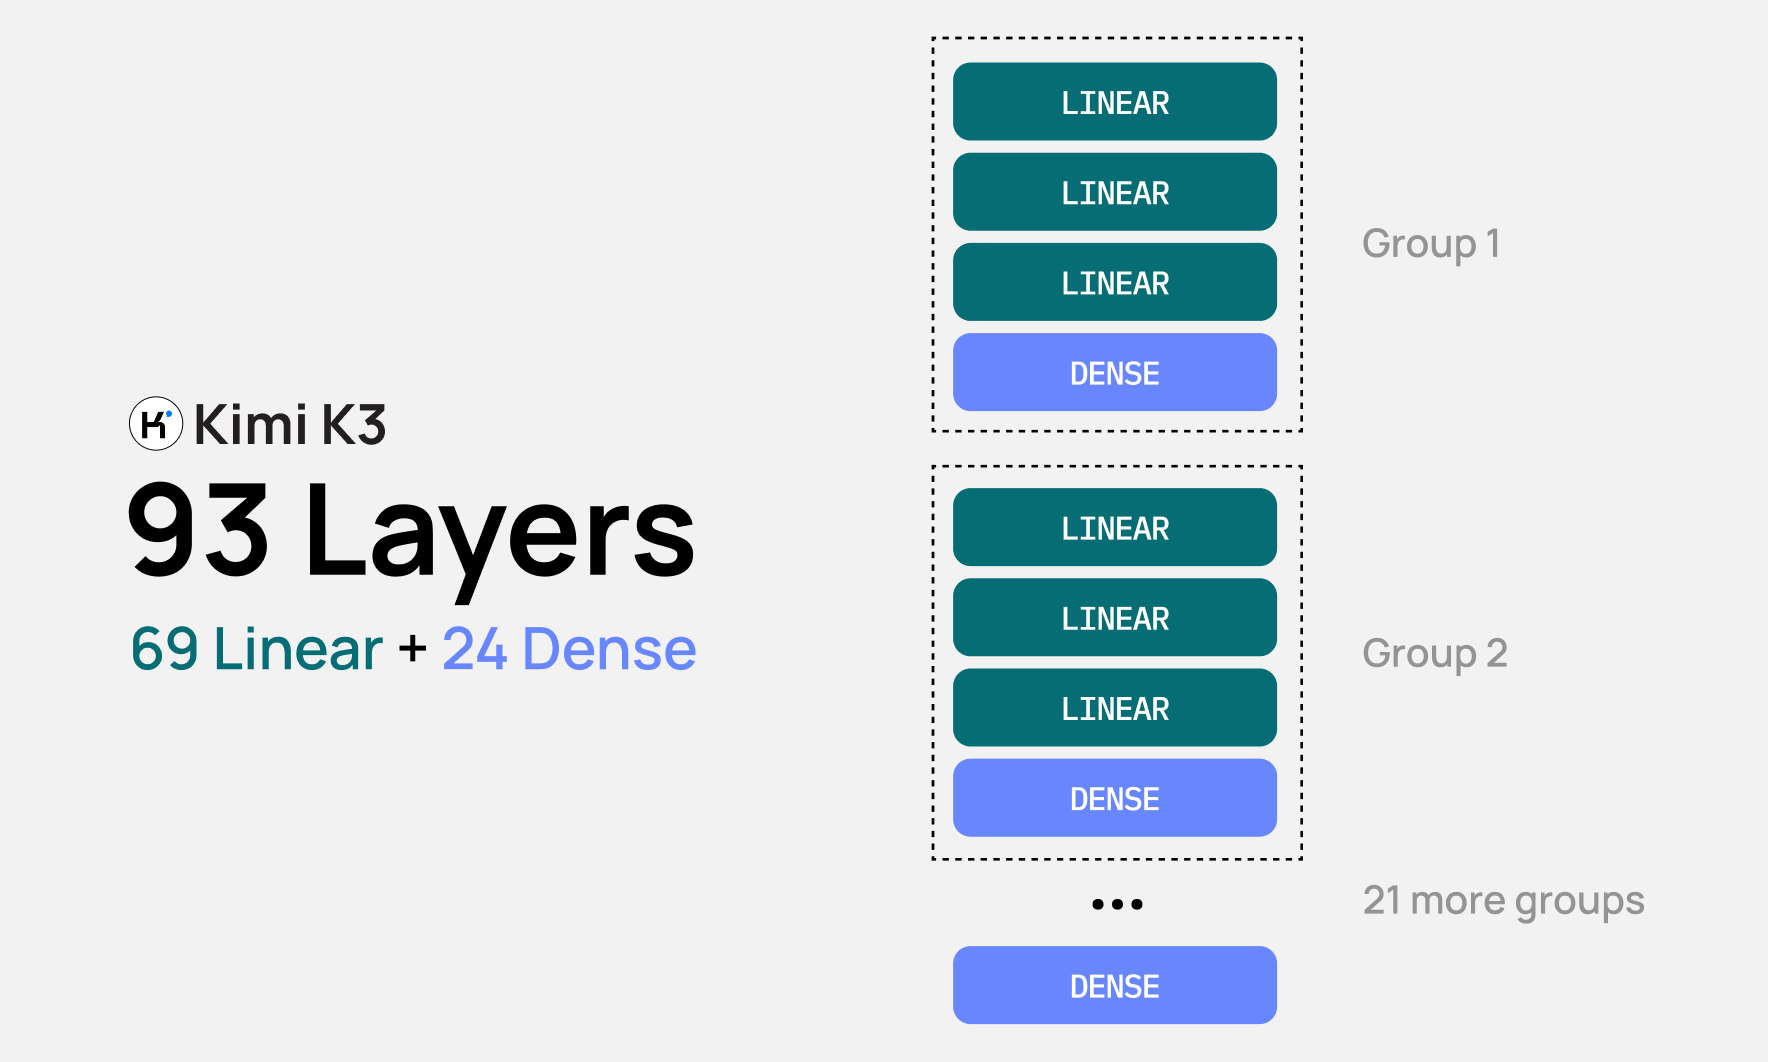
Kimi K3 — это открытая модель с 3 триллионами параметров, 69 слоями linear-attention и 24 плотными слоями (dense layers).
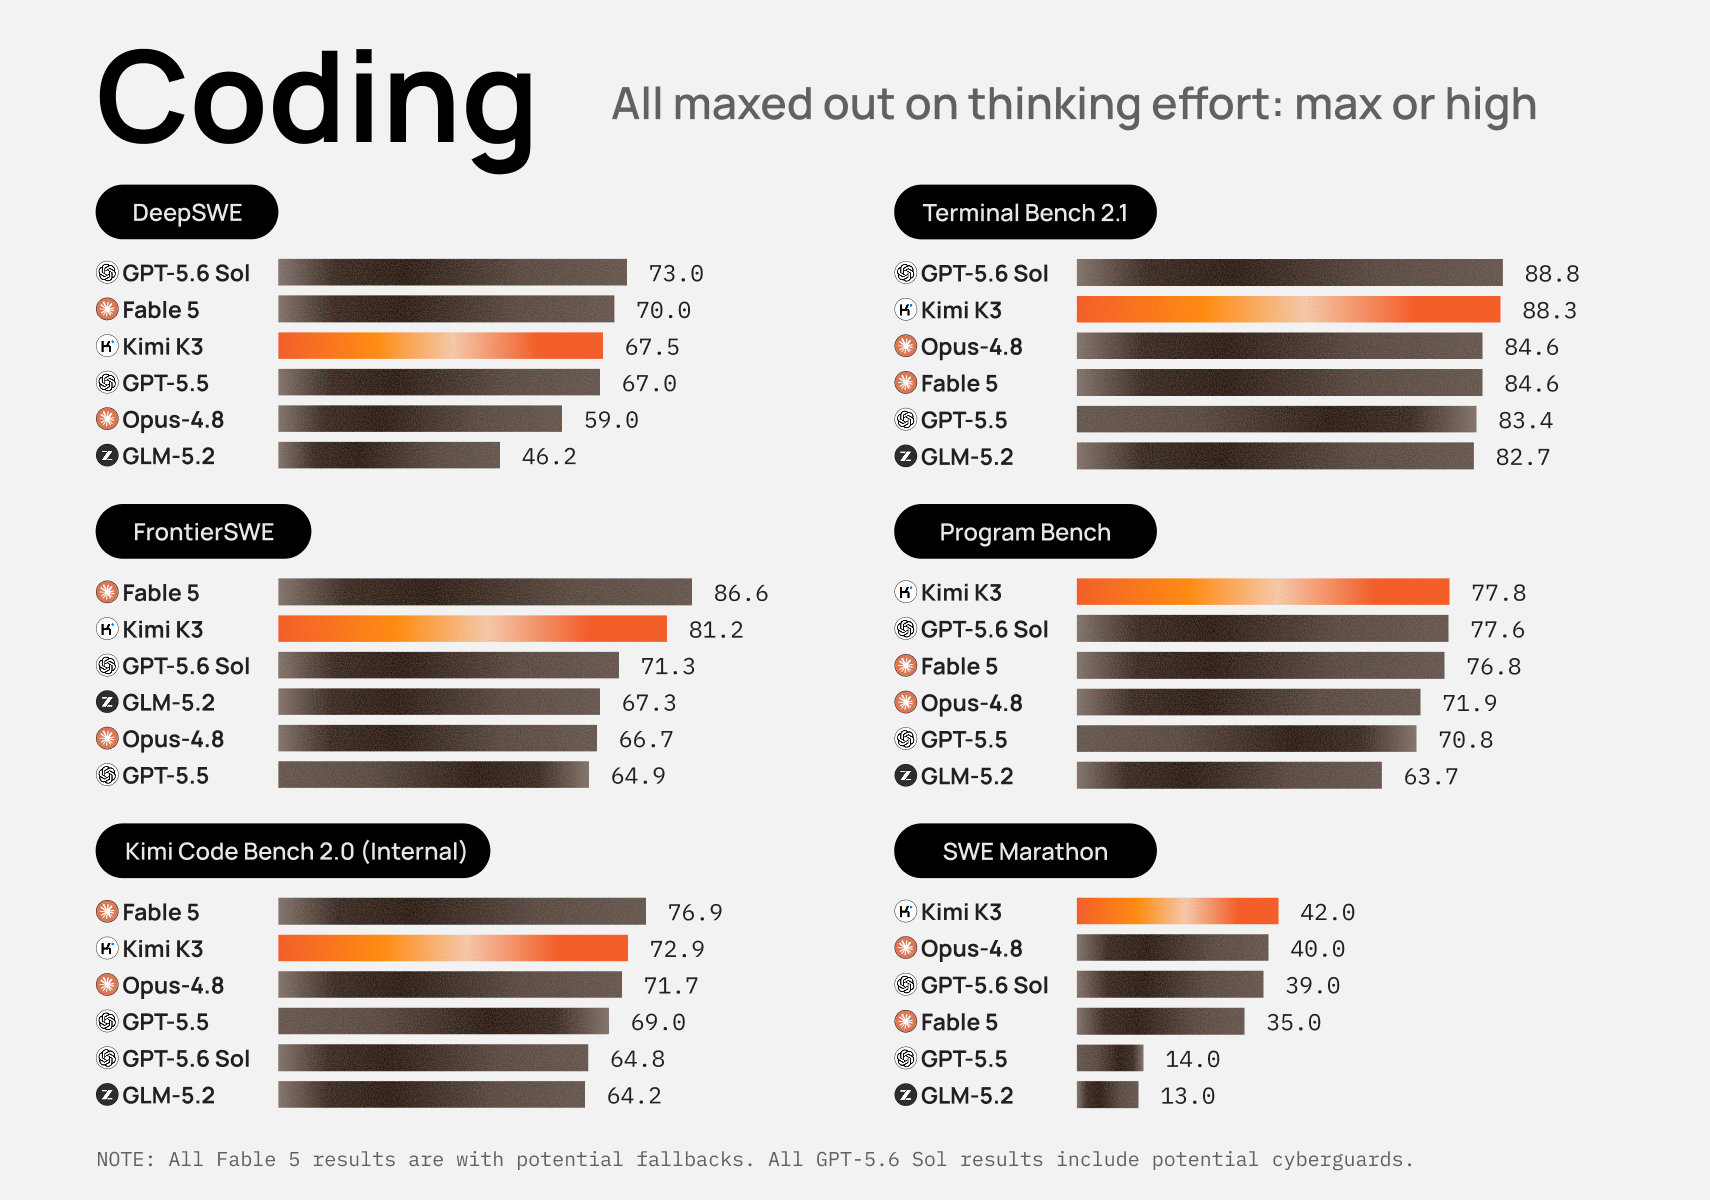
Модель демонстрирует впечатляющие результаты: 88,3% на Terminal-Bench 2.1 (против 88,8% у GPT-5.6 Sol) и 91,2% на BrowseComp (против 90,4% у GPT-5.6 Sol). Эти показатели свидетельствуют о frontier-уровне возможностей кодирования и agenttic-способностей, порой превосходя ведущие проприетарные модели по отдельным бенчмаркам.
Для этого примера использованы следующие параметры:
- средний размер запроса 256k;
- 4-битное квантирование весов (как в реализации Hugging Face);
- 8-битный KV cache.
#1: Размер каждого слоя
Для расчёта общего количества wafers Cerebras WSE-3T, необходимых для поддержки Kimi K3, сначала определяем размер каждого слоя модели.
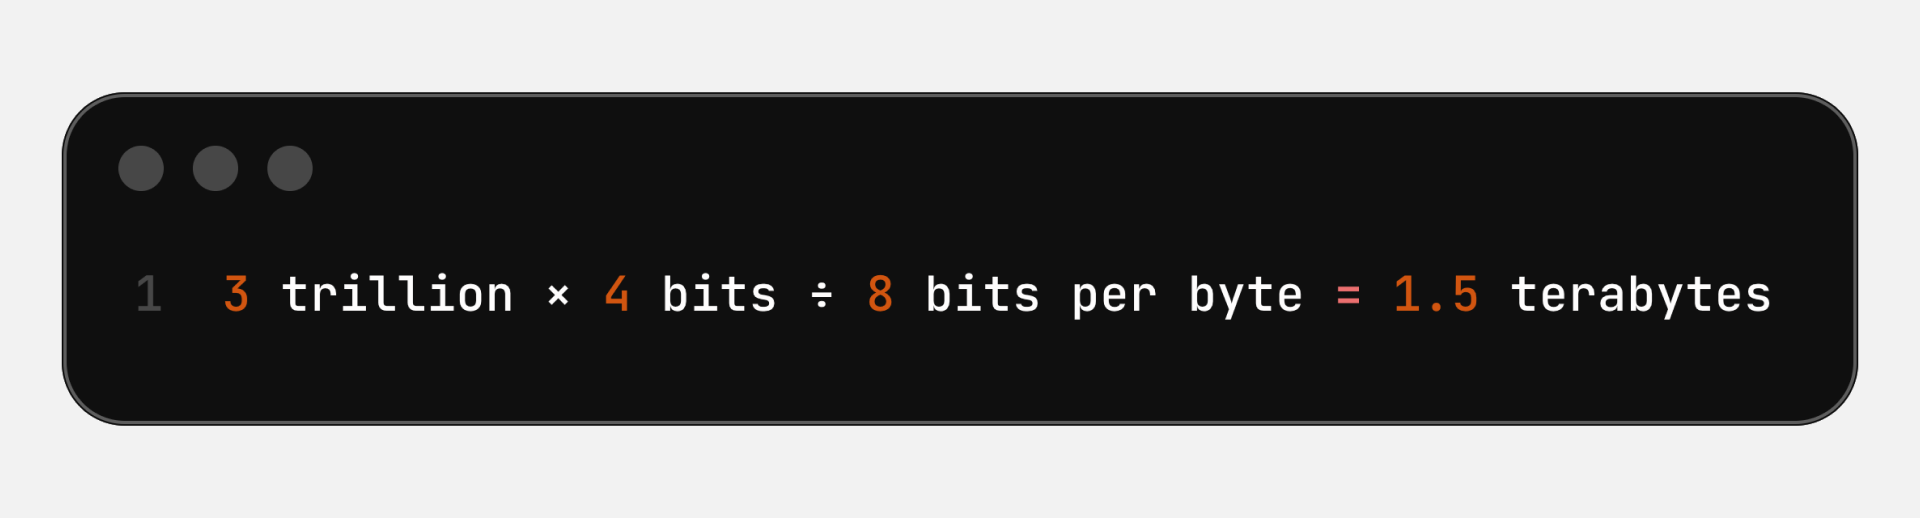
Kimi K3 имеет 3 триллиона параметров. Если все 3 трлн параметров хранятся по 4 бита каждый, то размер сырого набора параметров составляет:
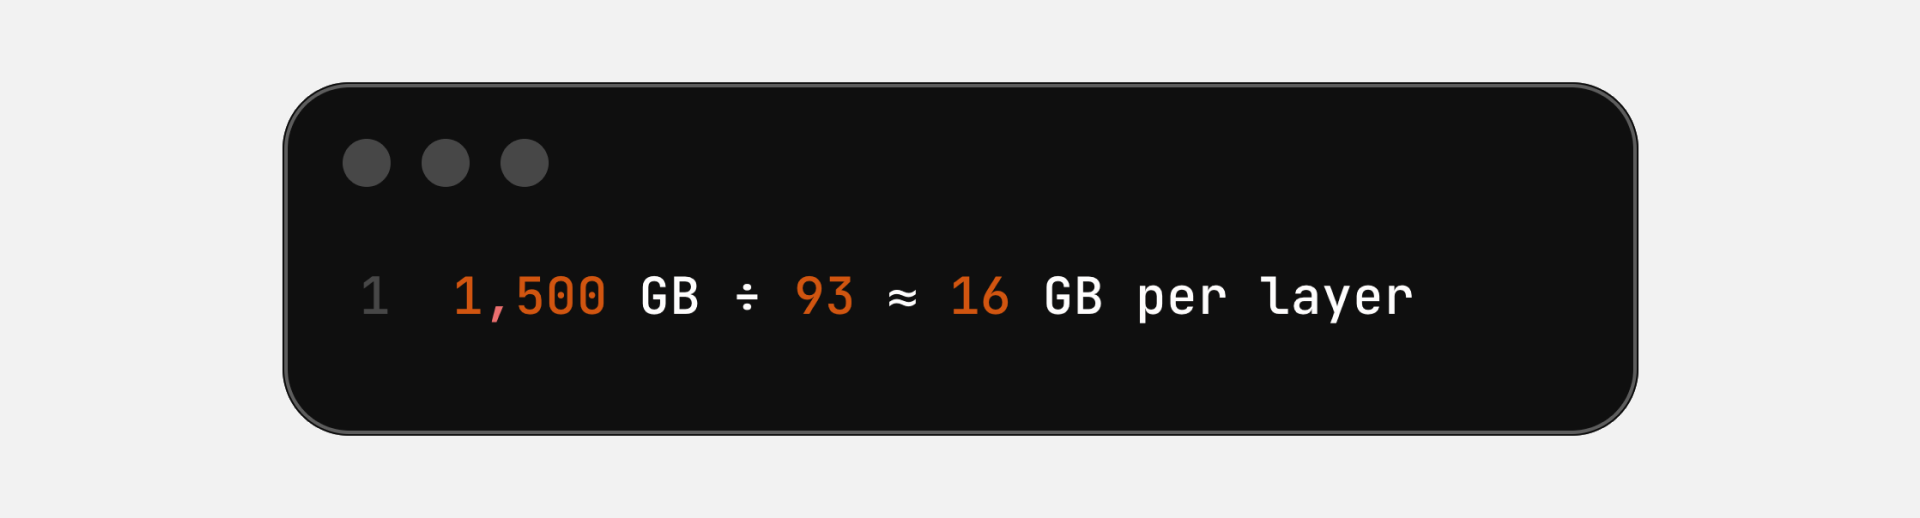
Разделив этот объём на 93 слоя, получаем:
#2: Количество wafers
Теперь, когда известно, что каждый слой требует около 16 ГБ, можно рассчитать, сколько слоёв поместится на каждый 44 ГБ wafer. Ответ зависит от типа слоя:
- Плотные слои (dense layers) требуют дополнительной памяти для KV cache, так как каждый слой полного внимания сохраняет ключи и значения для каждого токена в каждом активном запросе. Поэтому один плотный слой размещают на одном wafer, оставляя оставшуюся SRAM для его KV cache.
- Слои linear-attention не требуют дополнительной памяти для KV cache. Вместо хранения ключей и значений для каждого токена слой linear-attention хранит небольшое фиксированное состояние на запрос, независимо от длины контекста. Это оставляет место для двух linear-слоёв на wafer (2 × 16 ГБ = 32 ГБ).
Таким образом, с 69 linear-слоями и 24 плотными слоями Kimi K3 получаем:
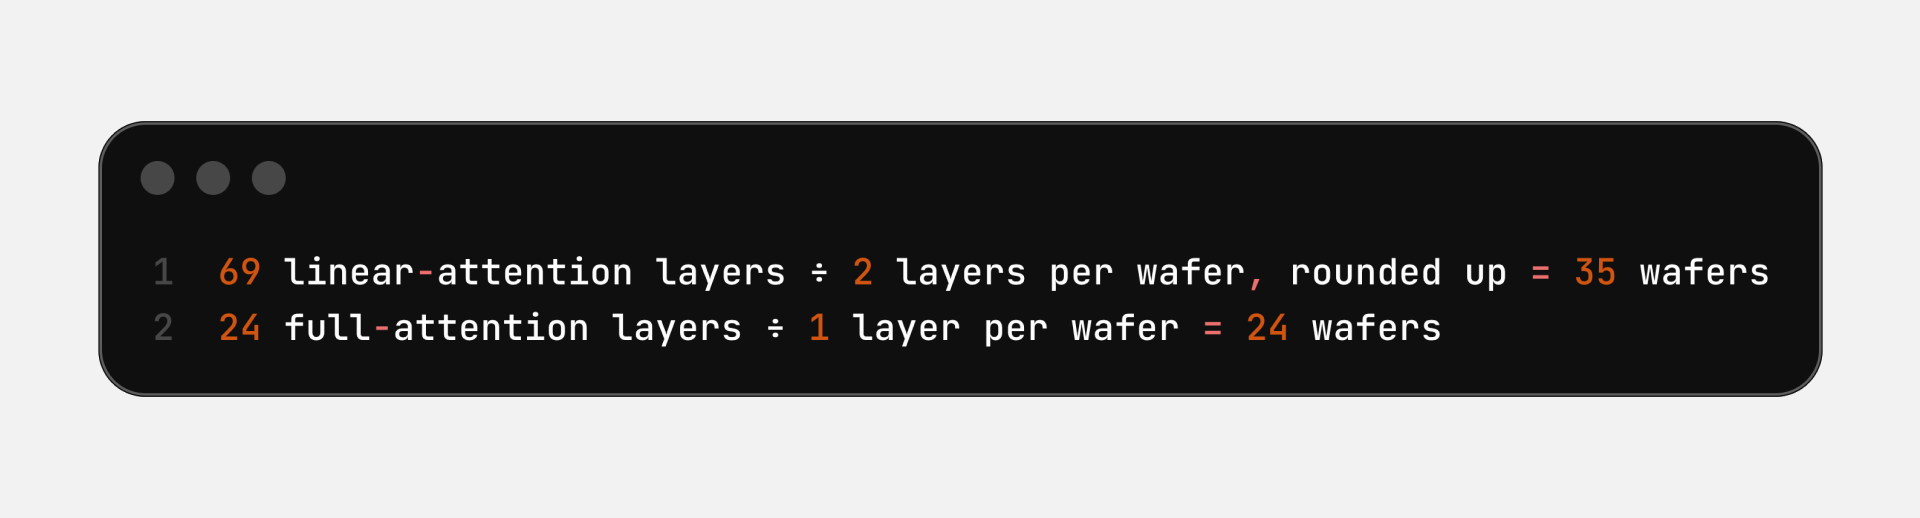
Всего получается 35 + 24 = 59 wafers.
#3: Соединение wafers вместе
Cerebras выполняет модели в режиме pipeline. После того как compiler Cerebras отображает слои модели на регионы wafers, runtime определяет путь для прохождения токенов между wafers. Для минимальной латентности между wafers передаются только activations, что можно сделать через RDMA по Ethernet. Это занимает примерно 2 микросекунды за один переход.
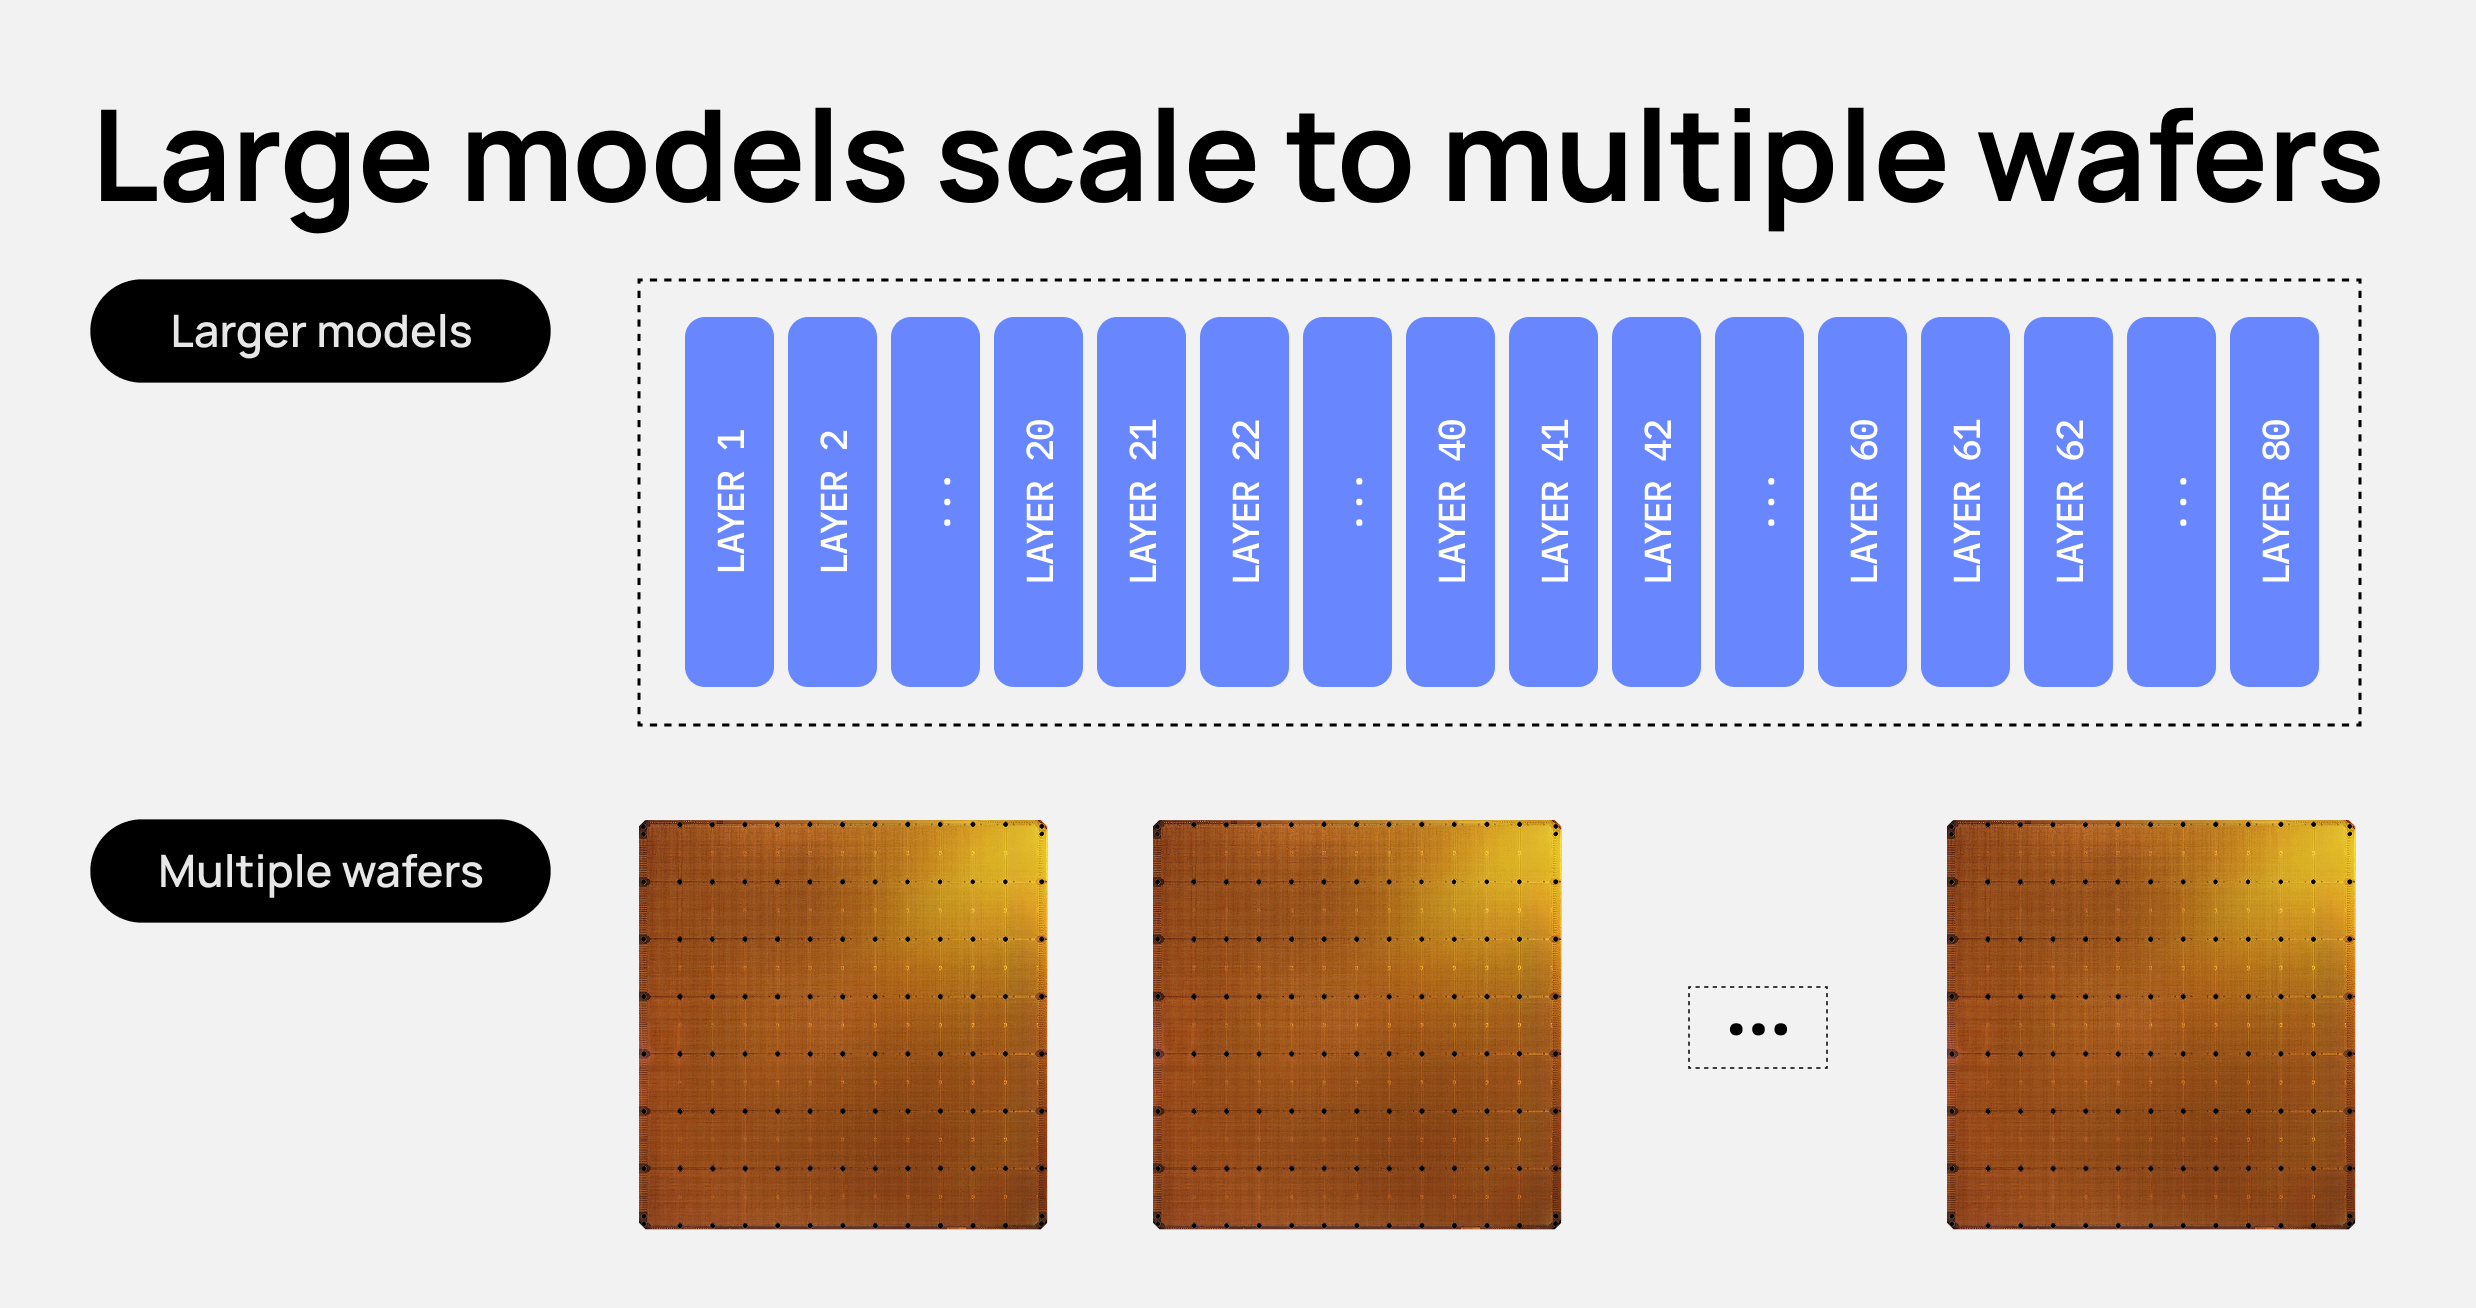
Важно подчеркнуть: так как каждый wafer Cerebras имеет 44 ГБ встроенной SRAM, а каждый слой занимает только 16 ГБ, полные слои модели обычно размещаются прямо на чипе.
Это означает, что в большинстве случаев веса модели никогда не перемещаются, и слои не нужно разделять между wafers. Через wafers передаются только activations.
#4: Обработка одного запроса
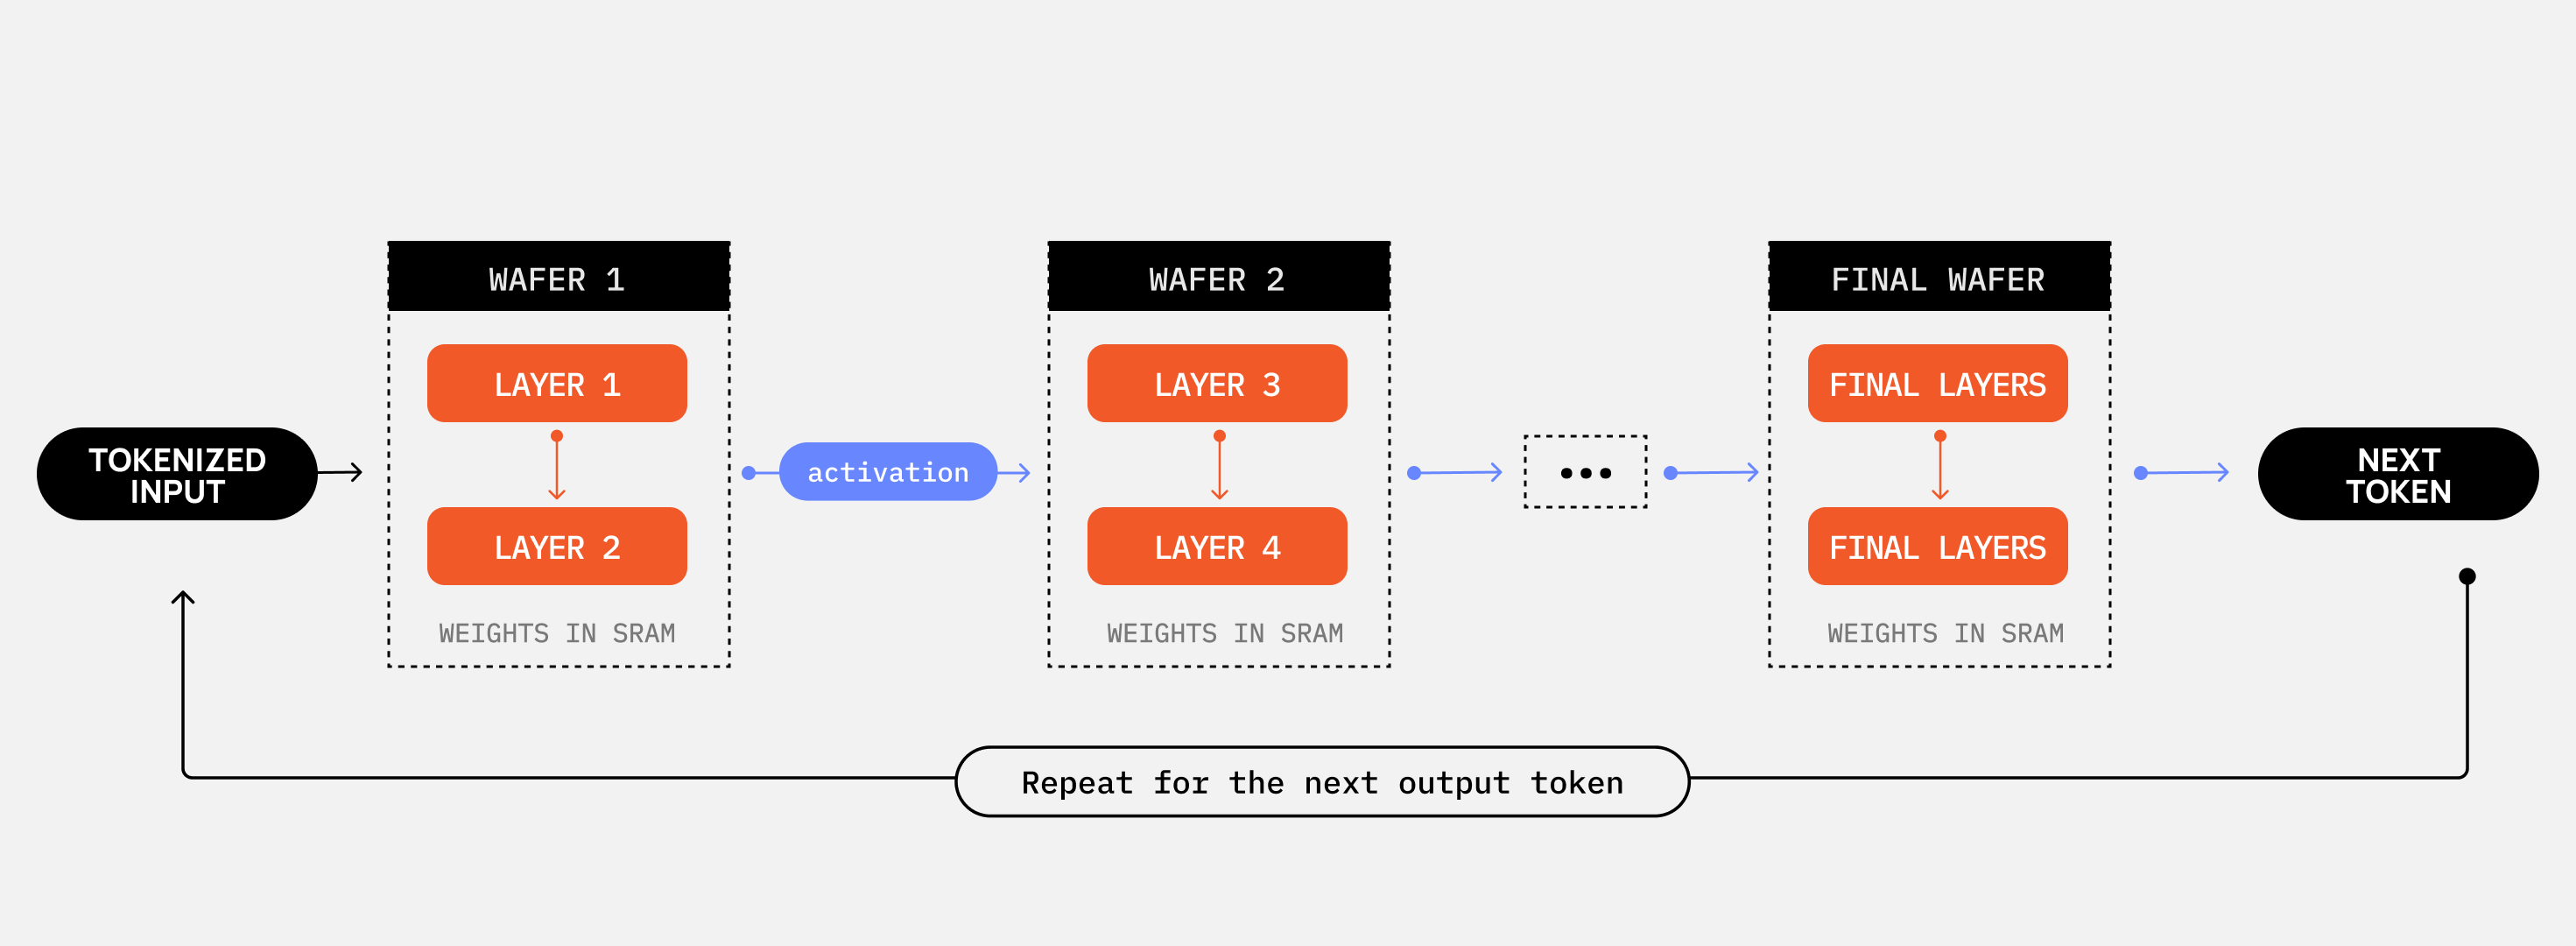
Теперь, когда wafers соединены вместе и модель размещена, каждый wafer можно рассматривать как один этап на конвейере сборки: веса модели для каждого этапа остаются на месте, а промежуточные результаты запроса проходят через этапы слоёв.
Например, Wafer 1 выполняет слои модели 1–2 и отправляет свои activations на wafer 2. Wafer 2 выполняет слои 3–4 и передаёт результаты на Wafer 3, и так далее, пока последний wafer не сгенерирует следующий токен.
#5: Обработка множества запросов
Здесь часто возникает неправильное понимание. Если токен должен пройти через каждый wafer по порядку, то разве каждый wafer не будет простаивать, ожидая своей очереди? Не будет ли система работать с размером batch равным одному?
Нет! Если отправить только один запрос по конвейеру и ждать его завершения перед следующим, это будет неэффективным использованием pipeline. Вместо этого весь pipeline заполнен различными запросами. Так как модель уже разделена на pipeline-этапы, каждый этап может обрабатывать разные запросы одновременно.
Пока этап 3 обрабатывает токен для запроса A, этап 2 обрабатывает один для запроса B, а этап 1 — для запроса C. В примере выше каждый этап представляет собой слой. В production Cerebras использует намного более гранулярные этапы и их намного больше.
Каждый этап может также обрабатывать micro-batch — небольшую группу запросов вместо одного запроса. Поэтому количество запросов в полёте примерно равно количеству этапов, умноженному на размер micro-batch.
Чтобы понять компромисс: меньшие micro-batches делают каждый запрос ещё быстрее, а большие micro-batches увеличивают общую пропускную способность.
#6: Сколько запросов можно обслужить?
Объём встроенной памяти, выделяемой для KV cache, определяет максимальное количество одновременных запросов. Каждый запрос в полёте требует собственного KV cache на каждом wafer с плотным слоем, поэтому размер встроенной памяти устанавливает верхний предел для одновременных запросов. Как объяснено выше, требуется рассчитать KV cache только для плотных слоёв.
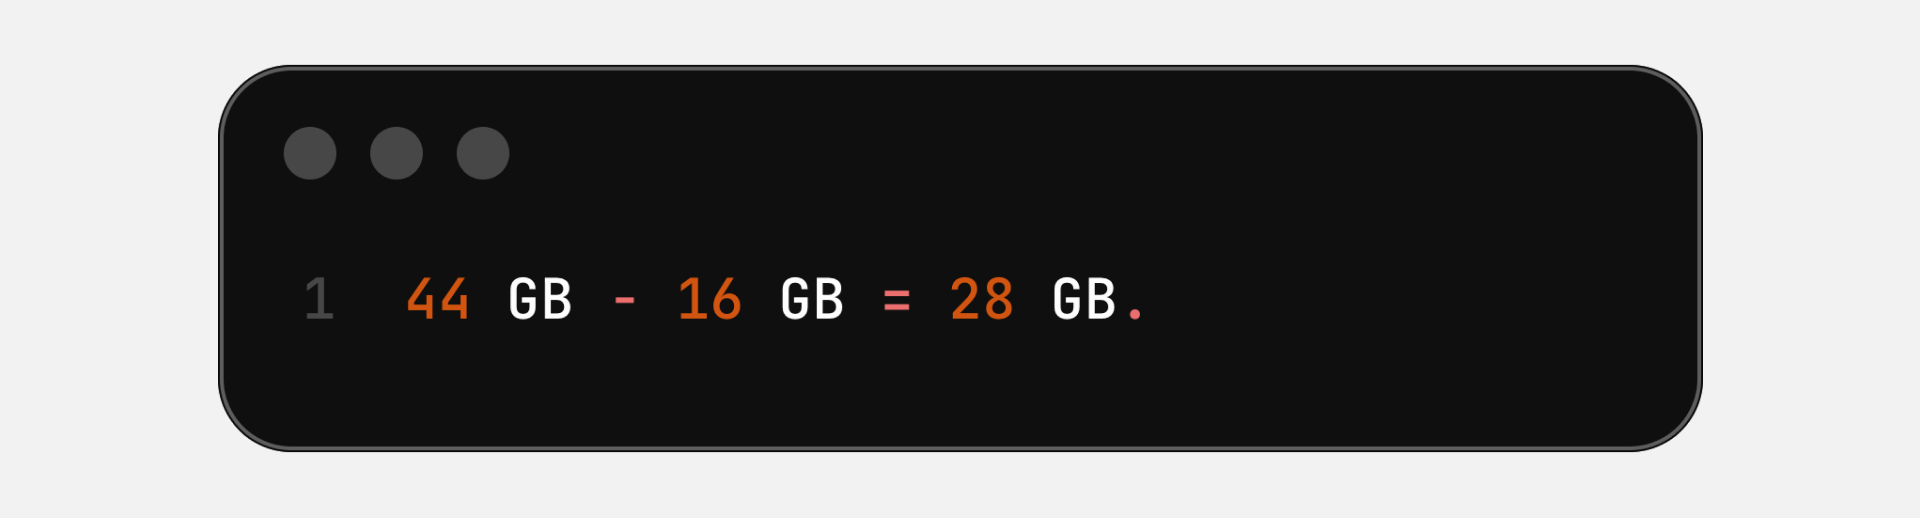
Для каждого 44 ГБ wafer, на котором уже находится один плотный слой, можно рассчитать оставшееся место для KV cache:
Общее хранилище wafer минус размер одного плотного слоя. В этом случае:
Расчёт количества одновременных запросов
Чтобы найти количество одновременных запросов для конкретного отображения модели, сначала рассчитываем, сколько cache занимает один запрос размером 256k:
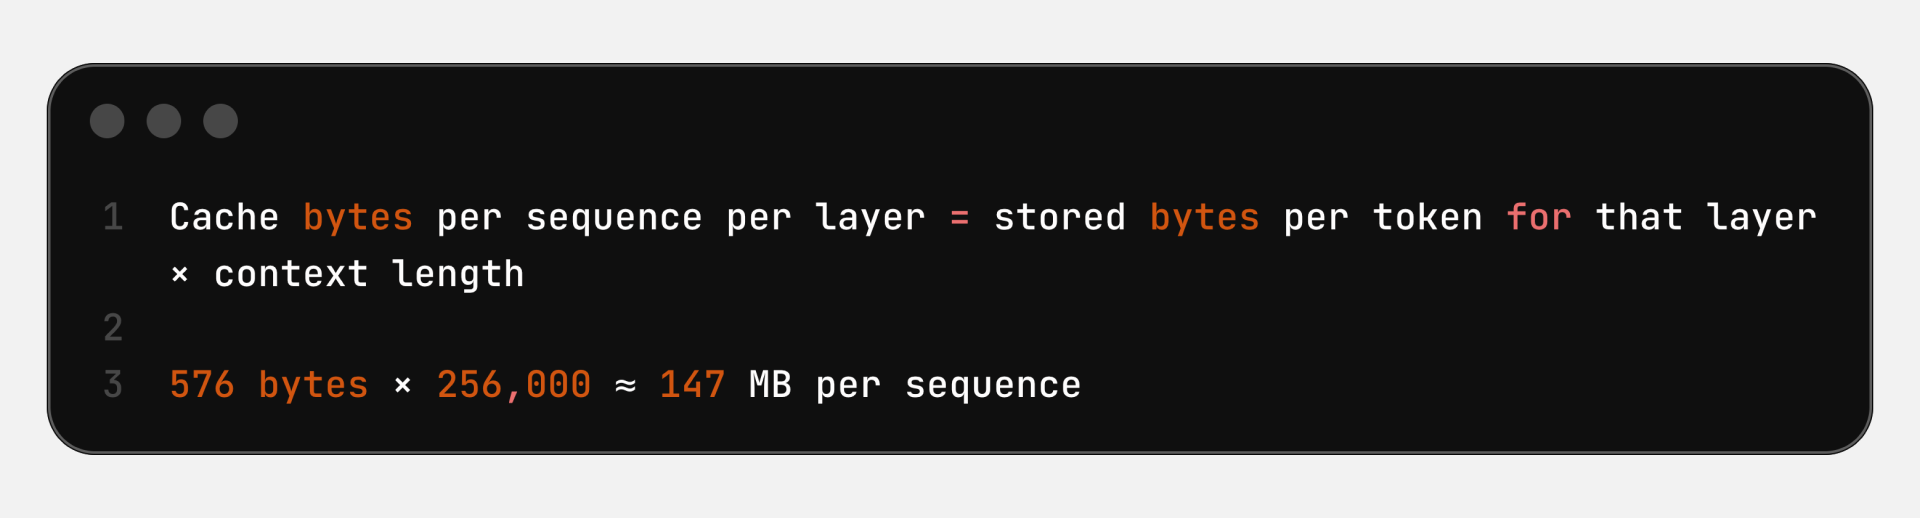
Затем для определения общего числа поддерживаемых одновременных запросов делим:
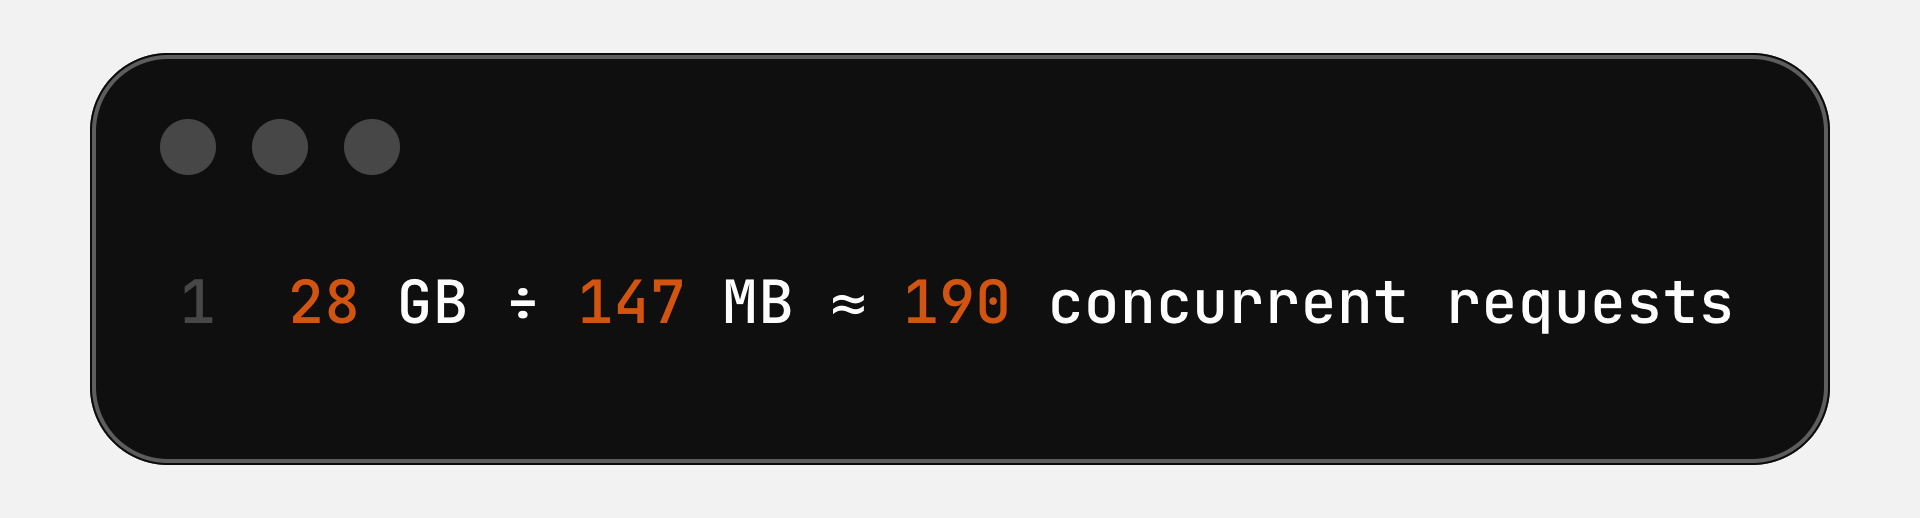
Общее количество одновременных запросов представляет число одновременных запросов, движущихся по pipeline в любой момент времени. В отличие от GPU batch, эти запросы не ждут друг друга — они непрерывно движутся по pipeline.
Конечно, ни concurrency, ни batch size не сказывают вам точно, насколько эффективно работает система инференса. При оценке пропускной способности системы инференса более значимой метрикой является общая пропускная способность токенов на единицу мощности (например, токены в секунду на мегаватт), измеряемая при одной и той же скорости генерации выходных данных.
Масштабирование за пределы 3 триллионов параметров
Этот же подход распространяется на более крупные модели: рассчитываем память, необходимую для весов и состояния запроса, распределяем модель по wafers и соединяем их в pipeline. Каждый дополнительный wafer добавляет вычислительную мощность и встроенную память, позволяя размещать модели, превышающие ёмкость любого отдельного чипа.
Спасибо за внимание! Заинтересованы в развёртывании модели на Cerebras или создании на базе нашего облака инференса?
- Начните работу с нашим бесплатным API: cloud.cerebras.ai
- Свяжитесь с отделом продаж: sales@cerebras.ai
Дизайн: Halley Chang. Благодарим за рецензирование и отзывы Atharva Talpade, Zhenwei Gao, Angela Yeung, Jessica Liu, Joyce Er, Emma Call и Rohan Gupta.