H.264 — стандарт везде
H.264 — стандарт видеокодека. Он повсеместен: интернет-видео, Blu-ray, смартфоны, камеры наблюдения, дроны. Всё использует H.264.
Это замечательный кусок технологии — результат 30+ лет работы с одной целью: снизить пропускную способность, требуемую для передачи видео в полном движении.
С технической точки зрения это весьма интересно. В этом материале разберём ключевые детали на высоком уровне — стараясь не углубляться в изыски. Заметим, что большинство описанных концепций применимы к видеокомпрессии в целом, не только к H.264.
Зачем вообще сжимать?
Несжатый видеофайл содержит массив двумерных буферов с пиксельными данными для каждого кадра. То есть это трёхмерный массив байтов (два пространственных измерения и одно временное). Каждый пиксель занимает 3 байта — по одному на каждый из трёх основных цветов (красный, зелёный и синий).
1080p @ 60 Hz = 1920×1080×60×3 ⇒ ~370 МБ/сек необработанных данных.
С этим практически невозможно работать. 50-гигабайтный Blu-ray диск вместит только ~2 минуты видео. Передавать его куда-либо быстро нельзя. Даже SSD с трудом справляются с такой скоростью прямой записи из оперативной памяти.
Так что сжатие необходимо.
Почему именно H.264?
Хороший вопрос. Но сначала посмотрим кое-что интересное. Вот главная страница Apple:
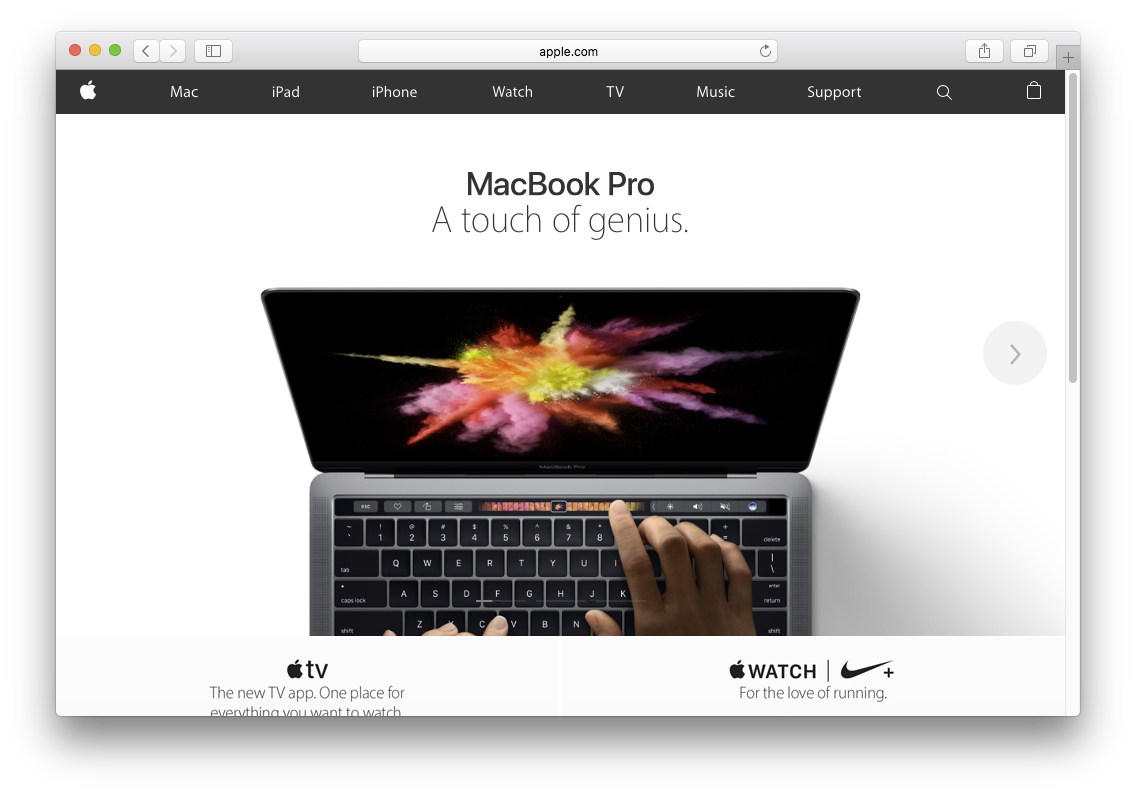
Затем создали два файла:
- PNG снимок экрана главной страницы Apple — 1015 КБ
- 5-секундное видео H.264 @ 60fps того же содержимого — 175 КБ
Видео из 300 кадров занимает 175 КБ, а один кадр PNG — 1015 КБ. Кажется, видеофайл содержит в 300 раз больше данных, но размер файла в 5 раз меньше. Получается, H.264 в 1500 раз эффективнее PNG.
Это возможно? Какой подвох?
Подвохов много
H.264 использует все мыслимые трюки и ещё много немыслимых. Пройдёмся по главным.
Сброс веса
Представь: строишь гоночный автомобиль. Нужна скорость. Первый шаг? Сбросить вес. Машина весит 3000 фунтов — убери всё лишнее. Задние сидения? Геройски выносим. Сабвуфер? Прощайте. Кондиционер? Забываем. Коробка передач? Хм, нет, без неё не обойтись.
Оставляешь только то, что имеет значение.
Этот концепт — выбросить ненужные биты ради экономии места — называется сжатием с потерями (lossy compression). H.264 — это кодек с потерями, он выбрасывает менее важные биты и сохраняет только важные.
PNG — это кодек без потерь (lossless). Ничего не теряется: исходное изображение можно восстановить из PNG бит в бит.
Что означают «важные биты»?
Есть очевидные способы урезать изображения. Может, верхний правый квадрант всегда бесполезен? Занулим эти пиксели и отбросим. Используем 3/4 места. Или обрежем толстую рамку по краям — важное в центре. Всё это можно сделать, но H.264 так не работает.
Что делает H.264?
H.264, как и другие алгоритмы сжатия с потерями, отбрасывает информацию о деталях. Вот сравнение оригинала и изображения после такого отбрасывания:
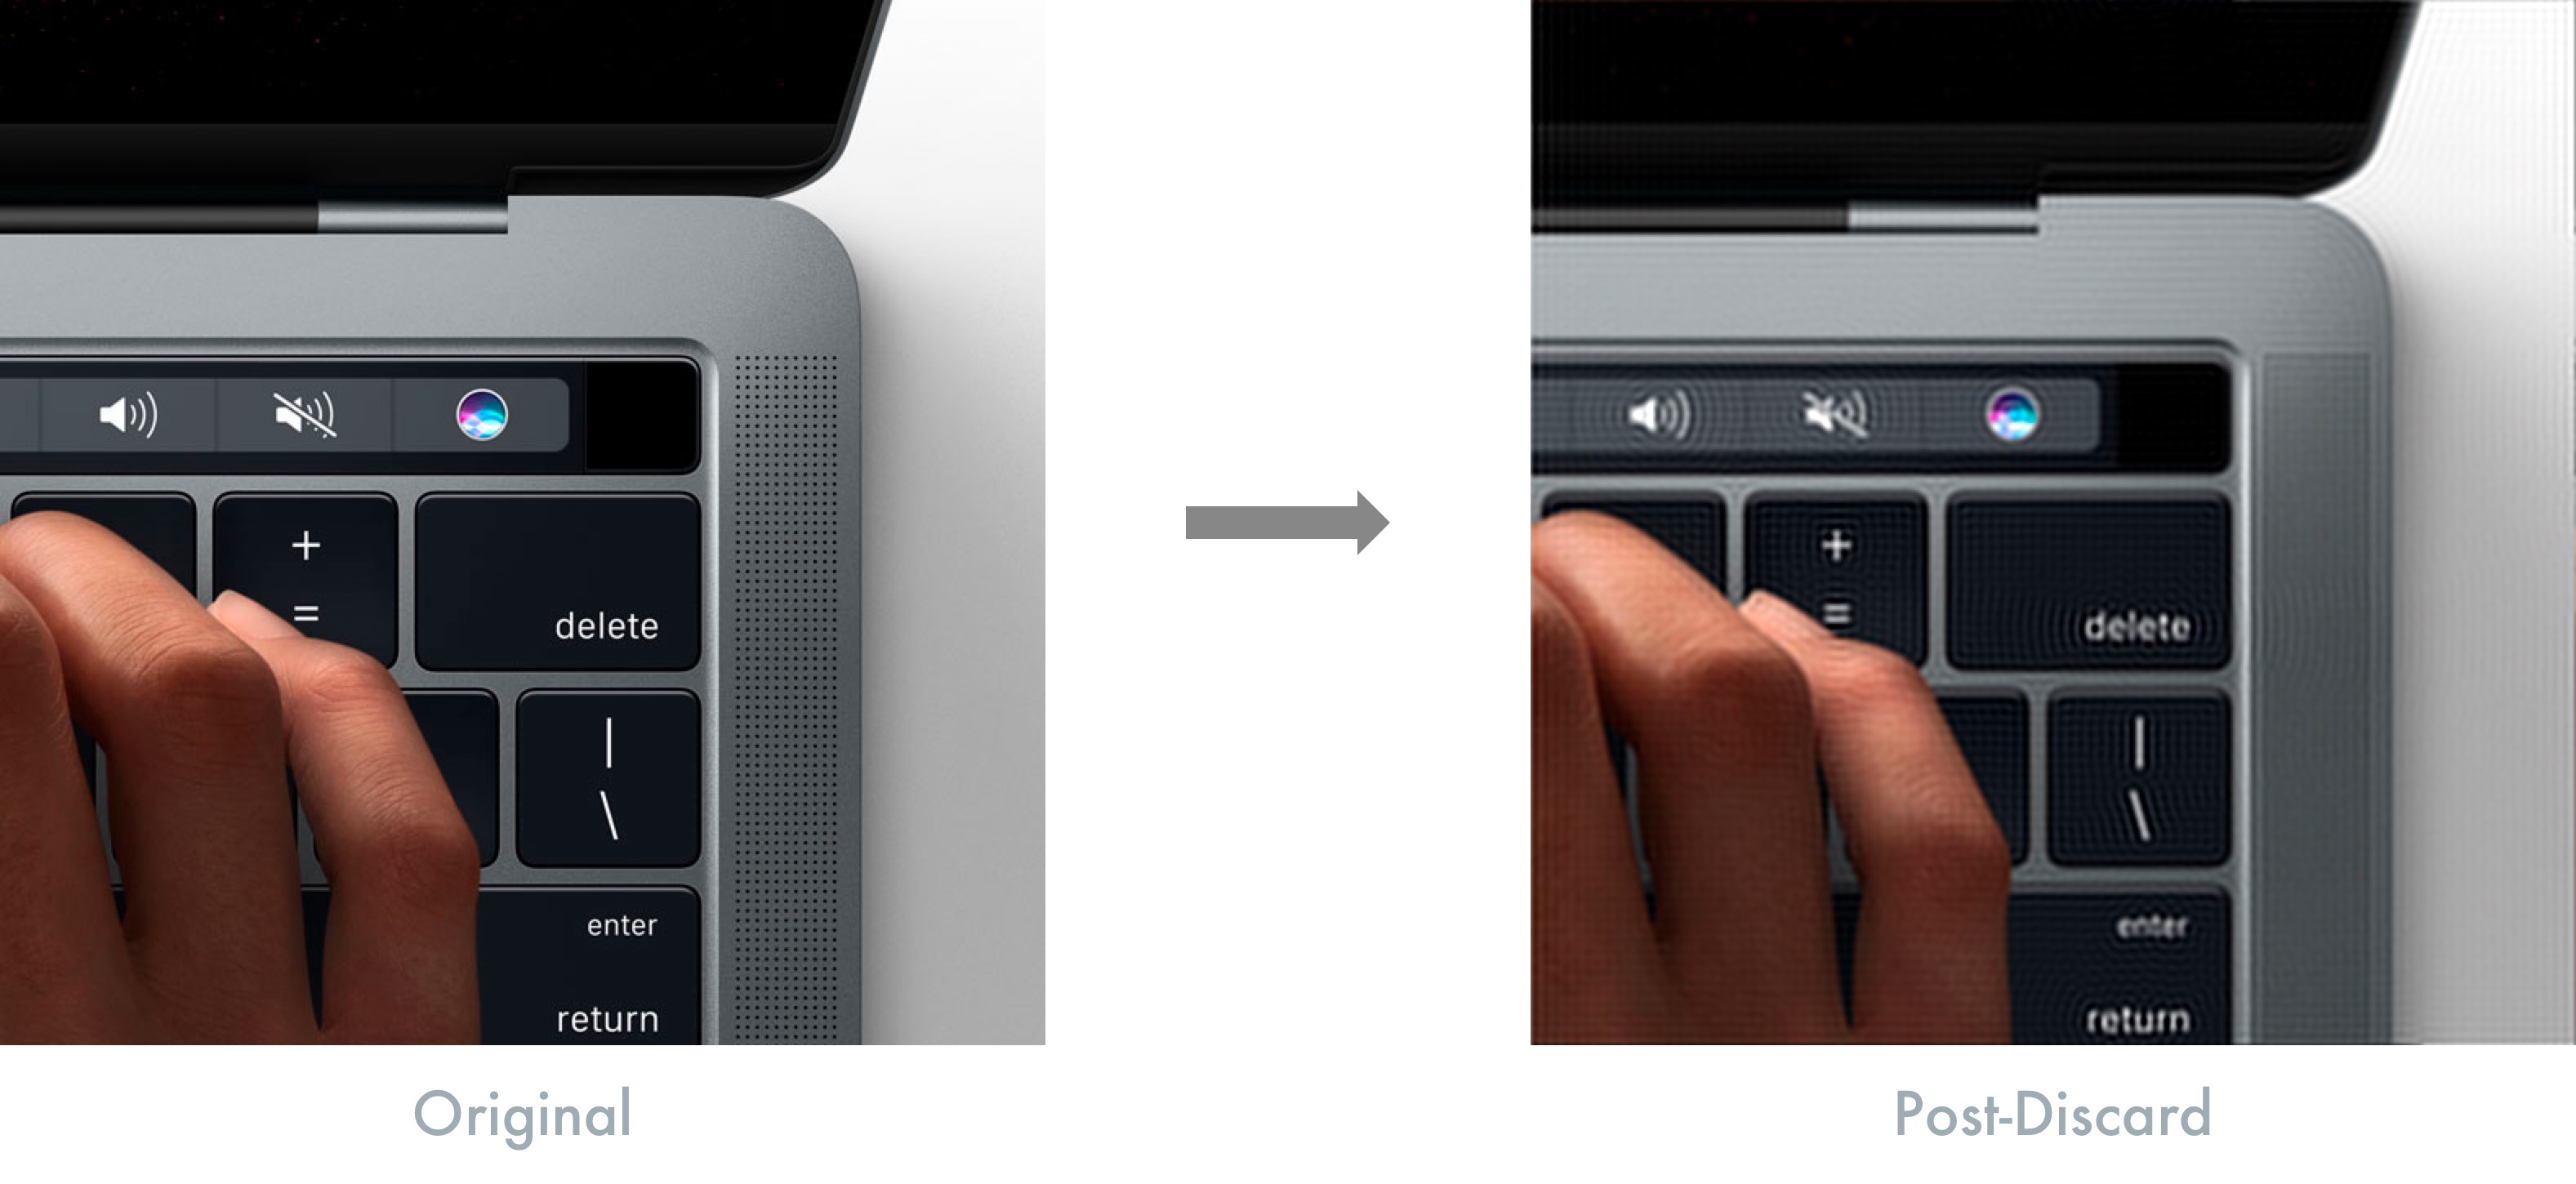
Видишь, в сжатой версии нет дырочек в решётке динамика MacBook Pro? Если не увеличивать масштаб, даже не заметишь разницы. Сжатое изображение весит 7% от оригинала — и это без традиционного сжатия. Наш автомобиль теперь весит всего 200 фунтов!
Как отбросить информацию о деталях?
Нужен краткий урок математики.
Информационная энтропия
Вот мы и добрались до самого интересного! Если ты когда-то изучал теорию информации, ты помнишь информационную энтропию. Это минимальное количество битов, необходимое для представления информации. Заметим: это не просто размер датасета, а именно минимум, который необходим для представления всей информации, содержащейся в датасете.
Например, датасет результата одного подбрасывания монеты требует 1 бита энтропии. Два подбрасывания — 2 бита. Понятно?
Представь странную монету: подбросил 10 раз, и каждый раз выпал орёл. Как бы ты описал эту информацию? Не орёл-орёл-орёл-орёл-орёл-орёл-орёл-орёл-орёл-орёл. Просто: «10 подбросаний, все орлы». Готово! Ты только что сжал данные! Ты преобразовал данные в другое, более короткое представление той же информации. Снизил избыточность данных. Информационная энтропия датасета не изменилась — ты просто переключился между представлениями. Такой кодер называют энтропийным кодером — это универсальный кодек без потерь для любых данных.
Частотная область
Теперь, когда ясна информационная энтропия, переходим к преобразованиям данных. Любые данные можно представить в фундаментальных единицах. В двоичной системе — 0 и 1. В шестнадцатеричной — 16 символов. Легко переходить между системами. Они эквивалентны.
Теперь включим воображение. Представь: ты можешь преобразовать любой датасет, который меняется в пространстве или времени (например, яркость пикселей изображения) в другое координатное пространство. Вместо x-y координат используй частотные: freqX и freqY. Это называется частотной областью. Есть замечательная математическая теорема, которая говорит: такое преобразование можно выполнить для любых данных, и это будет идеальное преобразование без потерь, если freqX и freqY достаточно высокие.
Что такое freqX и freqY?
Это другой набор базовых единиц. Как при переходе от двоичной к шестнадцатеричной — иная фундаментальная единица, мы переходим от привычных x-y к freqX и freqY. Шестнадцатеричное 'A' выглядит иначе, чем двоичное '1010'. Оба означают то же самое, но выглядят по-разному. Вот как выглядит наше изображение в частотной области:
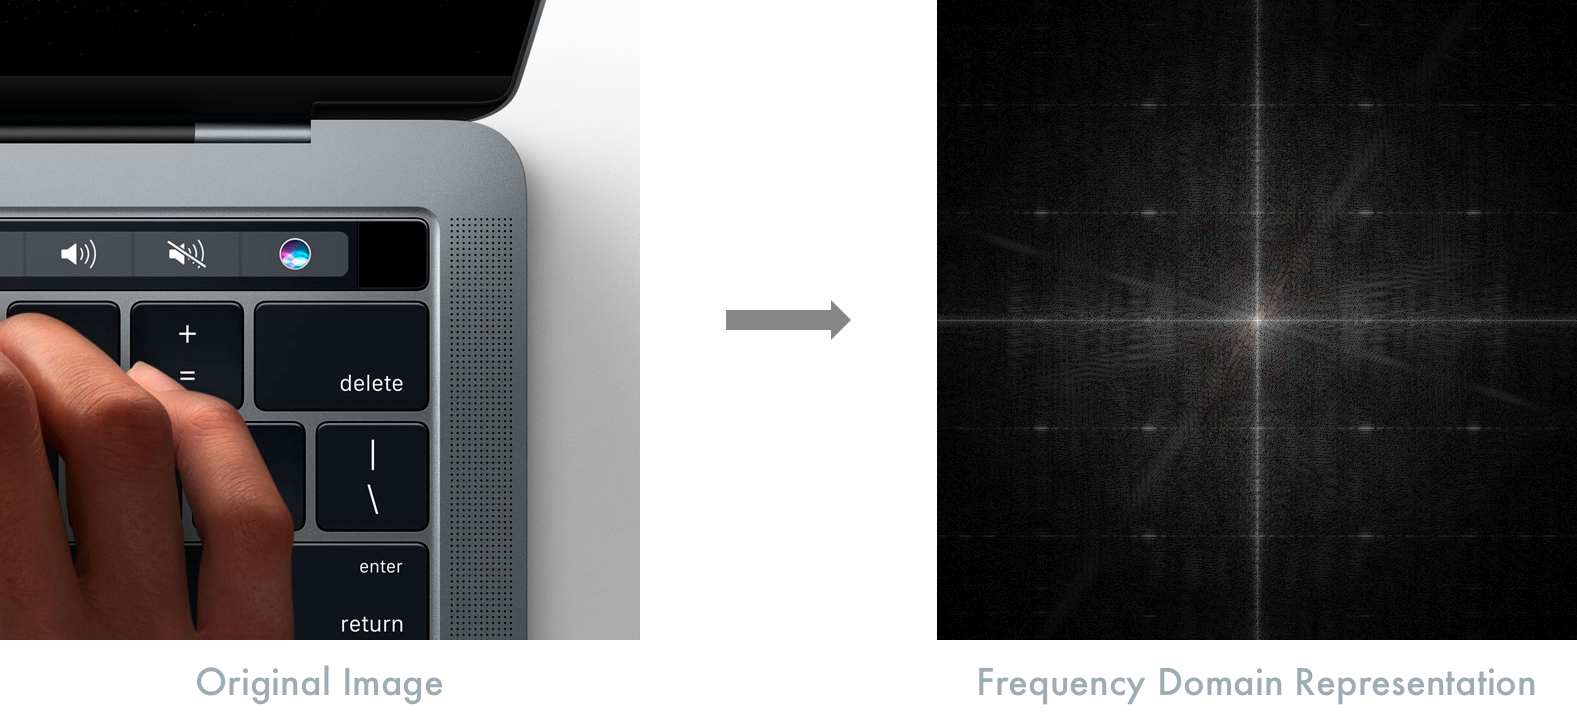
Тонкая решётка динамика MacBook имеет высокое содержание информации в компонентах более высоких частот этого изображения. Тонкие варьирующиеся детали = компоненты высоких частот. Постепенные изменения цвета и яркости (такие как градиенты) — это компоненты низких частот. Промежуточное — в промежутке. Значит: мелкие детали = высокие частоты. Плавные градиенты = низкие частоты. Логично?
В представлении частотной области компоненты низких частот находятся в центре. Компоненты высоких частот — по краям.
Зачем всё это нужно?
Потому что теперь можешь взять изображение в частотной области и замаскировать края — отбросить информацию, содержащую компоненты высоких частот. Если преобразовать обратно в обычные x-y координаты, изображение будет похоже на оригинал, но потеряет мелкие детали. Но теперь оно займёт намного меньше места. Контролируя размер маски, можешь точно настроить, насколько детальным должно быть выходное изображение.
Вот крупный план ноутбука с главной страницы. С применённой круговой маской:
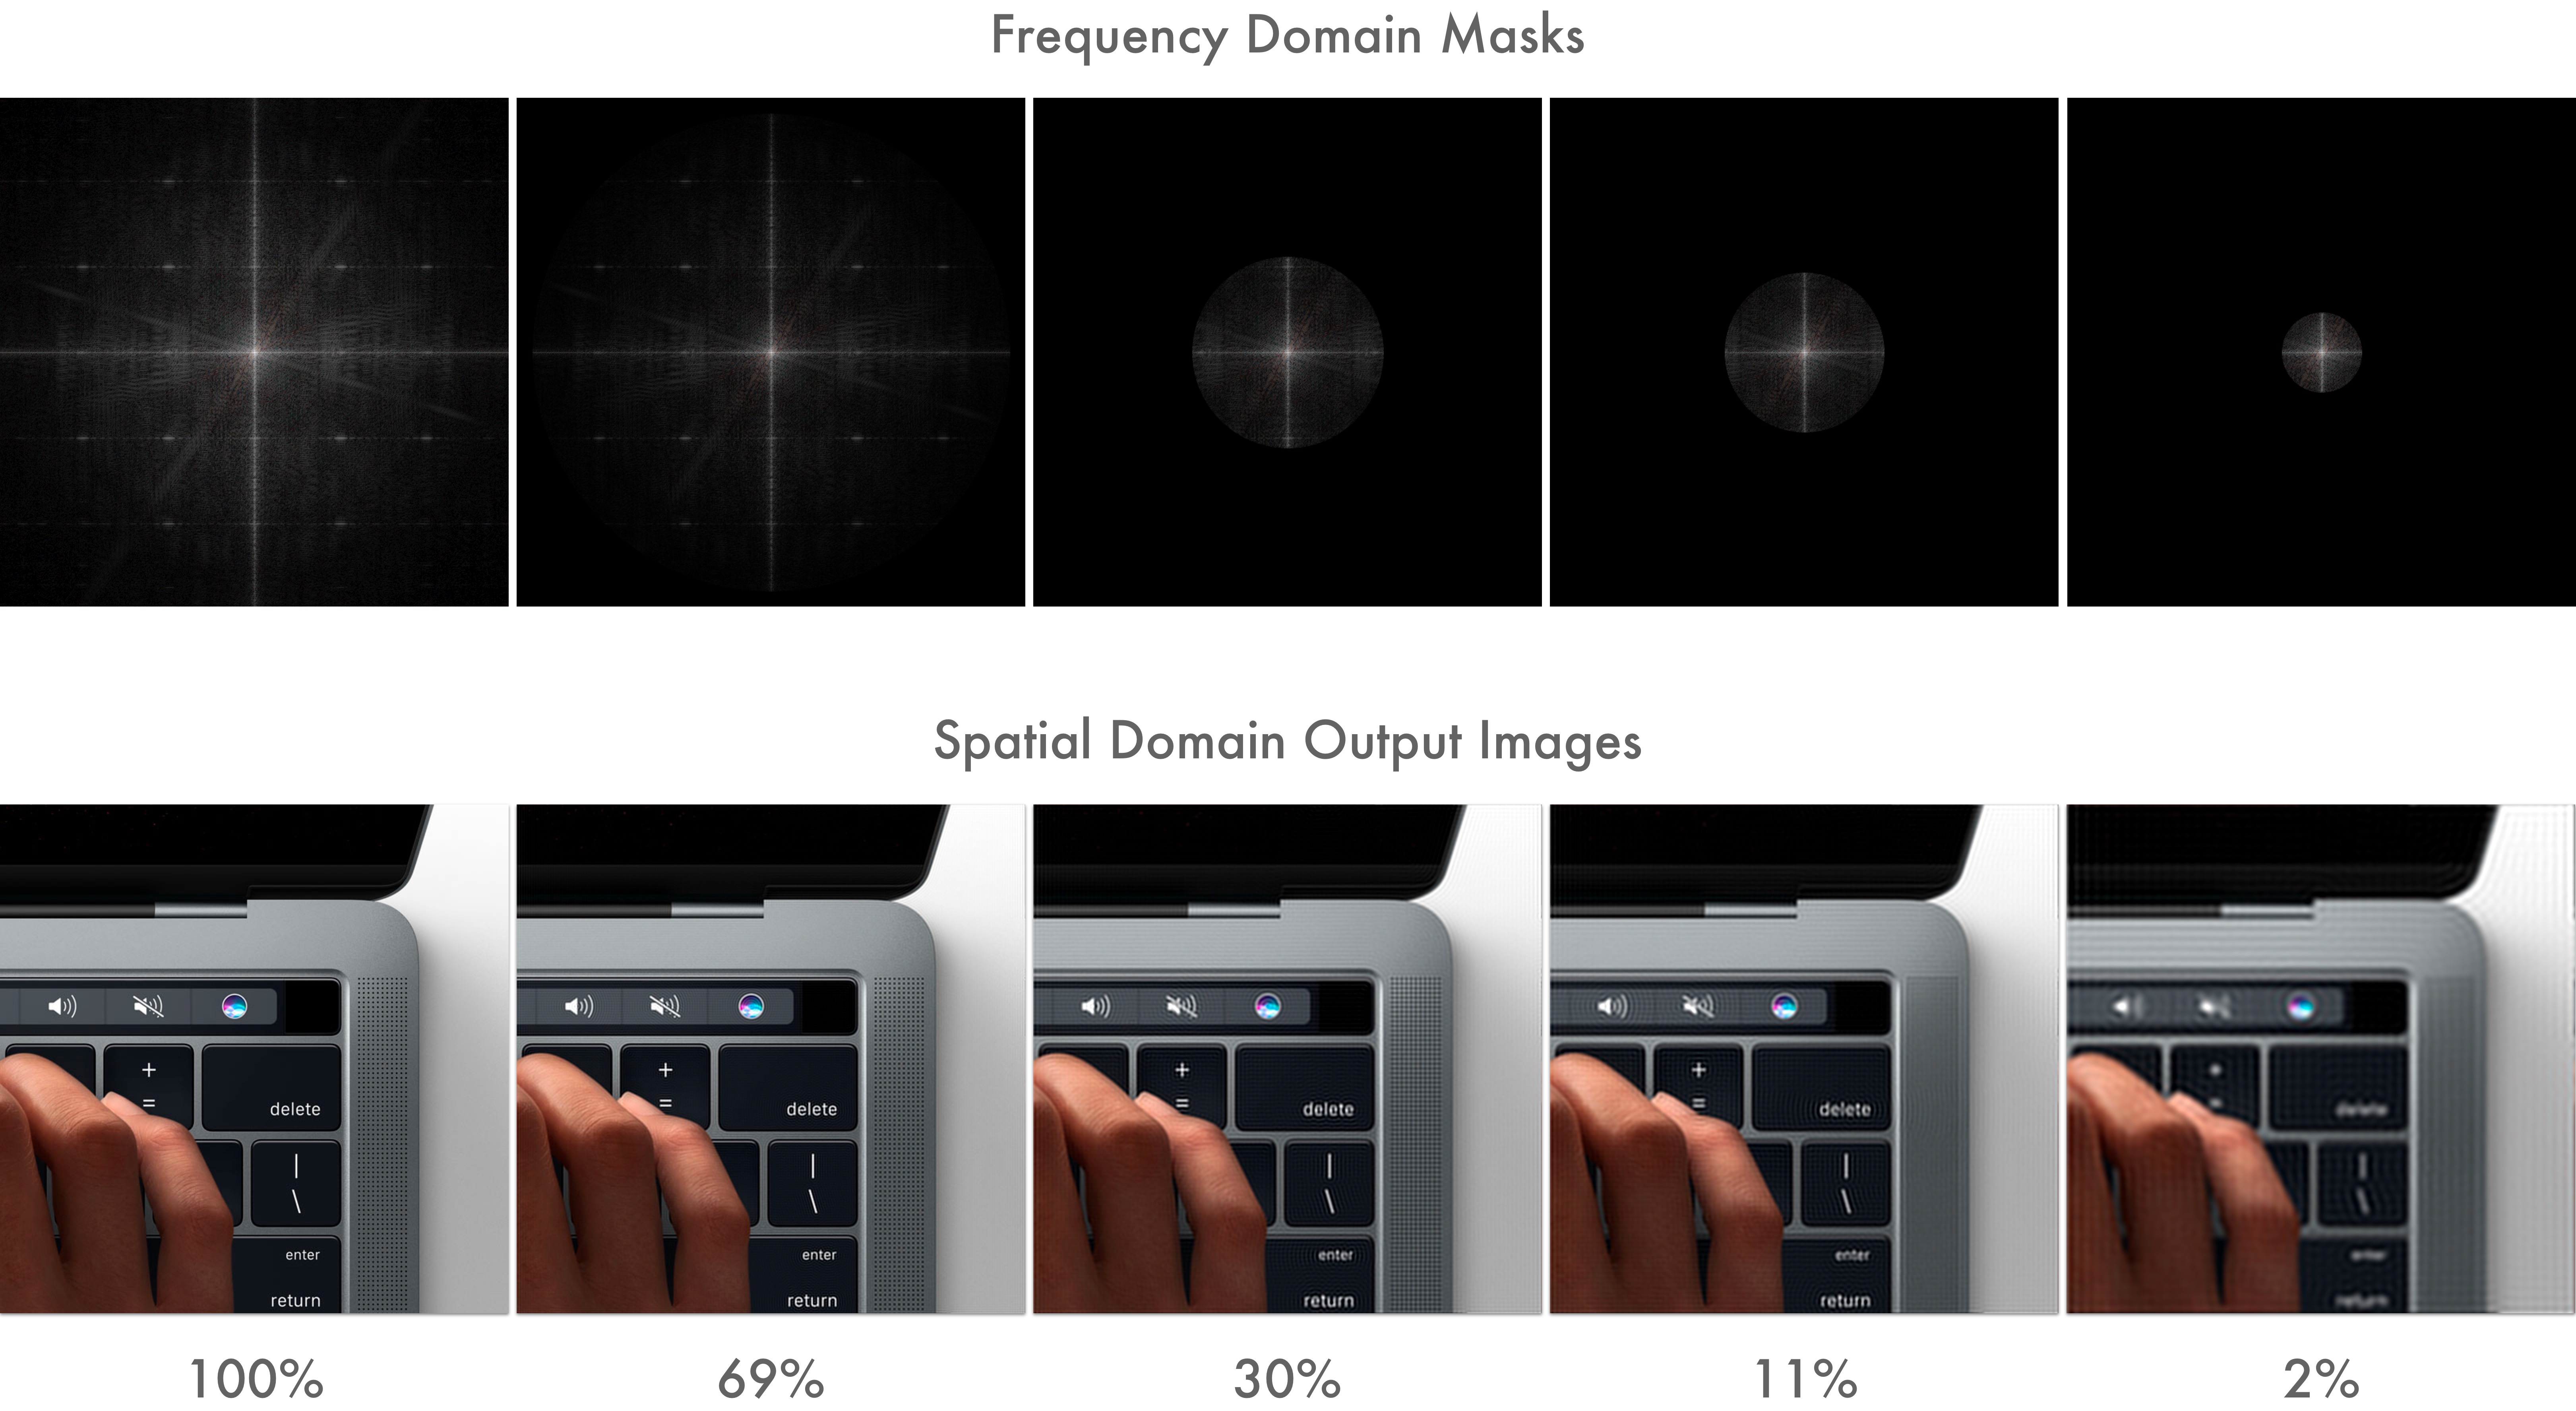
Числа показывают информационную энтропию изображения как доля оригинала. Даже на 2% не заметишь разницу, если не увеличивать масштаб. 2%! Машина теперь весит 60 фунтов!
Это то, как сбрасывают вес. Этот процесс при сжатии с потерями называется квантизацией.
Субсэмплирование цветности
Человеческое зрение плохо различает мелкие детали в цвете. Легко замечает малые изменения яркости, но не цвета. Значит, можно отбросить информацию о цвете и сбросить ещё больше веса.
В телевизионном сигнале RGB данные о цвете преобразуют в Y+Cb+Cr. Y — это люминанция (по сути, чёрно-белая яркость), Cb и Cr — компоненты цветности (цвет). RGB и YCbCr эквивалентны с точки зрения информационной энтропии.
Зачем усложнять? RGB не подходит?
Давно, когда существовало только чёрно-белое ТВ, был только сигнал Y. Когда появились цветные телевизоры, инженеры придумали, как передать RGB цвет вместе с Y. Вместо двух отдельных потоков данных, они мудро решили кодировать информацию о цвете в Cb и Cr и передавать её вместе с Y. Так чёрно-белые ТВ смотрели только Y. Цветные телевизоры дополнительно смотрели на компоненты цветности и внутри преобразовывали в RGB.
Но посмотри на трюк: компонента Y кодируется в полном разрешении, а компоненты C — только в четверти разрешения. Поскольку глаз плохо различает изменения цвета, можно обойтись этим. В результате общую полосу пропускания сокращаешь вдвое с очень небольшой визуальной разницей. Вдвое! Машина теперь весит 30 фунтов!
Этот процесс отбрасывания части информации о цвете называется субсэмплированием цветности. Хотя это не специфично для H.264 и существует десятки лет, используется почти везде.
Это главные способы сброса веса при сжатии с потерями. Кадры теперь крошечные — отбросили большую часть информации о деталях и половину информации о цвете.
Что дальше?
Да! Сброс веса — только первый этап. Пока рассматривали только пространственные области внутри одного кадра. Пора исследовать временное сжатие — смотреть на группы кадров через время.
Компенсация движения
H.264 — это стандарт сжатия с компенсацией движения.
Компенсация движения? Что это?
Представь теннисный матч. Камера закреплена под определённым углом. Единственное, что движется, — мяч туда-сюда. Как бы ты кодировал эту информацию? Стандартно, верно? Трёхмерный массив пикселей: два измерения в пространстве и одно во времени.
Нет. Зачем? Большую часть изображения видишь же все одинаково. Корт, сетка, публика — всё статично. Единственное действие — мяч движется. А что если иметь один статичный образ всего в фоне и один движущийся образ только мяча? Не сэкономишь ли огромное количество места? Видишь, к чему это ведёт?
H.264 делает именно это. Разбивает изображение на макроблоки — обычно блоки 16×16 пикселей для оценки движения. Кодирует один статичный образ, обычно называемый I-кадром (Intra frame). Это полный кадр со всеми битами, необходимыми для его воспроизведения. Затем последующие кадры — это либо P-кадры (predicted), либо B-кадры (bi-directionally predicted). P-кадры кодируют вектор движения для каждого макроблока от предыдущего кадра. P-кадр должен быть воспроизведён декодером на основе предыдущих кадров. Начинает с последнего I-кадра в потоке видео и затем проходит по каждому последующему кадру — суммируя дельты векторов движения до текущего кадра.
B-кадры ещё интереснее: предсказание происходит двусторонне, и из прошлых, и из будущих кадров. Теперь понимаешь, почему видео Apple домашней страницы так хорошо сжимается. Потому что это просто три I-кадра, в которых макроблоки панорамируются вокруг.
Когда смотришь видео на YouTube и пропускаешь несколько последних секунд диалога, щёлкаешь назад. Замечал, что оно не сразу начинает воспроизводиться с выбранного момента? Делает паузу, потом играет. Кадры уже буферизованы из сети — ты их только что смотрел, так почему пауза?
Это бесит. Почему?
Когда просишь декодер прыгнуть на произвольный кадр, он должен пересчитать всё — начиная с ближайших I-кадров и суммируя дельты векторов движения к твоему кадру. Это вычислительно затратно, отсюда краткая пауза. Надеюсь, теперь будешь менее раздосадован, понимая, что декодер действительно работает, а не просто сидит и раздражает тебя.
Так как кодируешь только дельты векторов движения, эта методика крайне эффективна по занимаемому месту для любого видео с движением, в обмен на вычислительные затраты.
Теперь охватили и пространственное, и временное сжатие! Уже сэкономили кучу места на квантизации. Субсэмплирование цветности ещё вдвое снизило требуемое место. Кроме того, компенсация движения хранит только 3 реальных кадра из ~300, которые были в видео.
Выглядит хорошо. Что дальше?
Теперь завершаем и закрываем сделку. Используем традиционный энтропийный кодер без потерь. Почему бы и нет? Просто добавляем это поверх для верности.
Энтропийный кодер
I-кадры после операций с потерями содержат избыточную информацию. Векторы движения для каждого макроблока в P и B-кадрах имеют целые группы с одинаковыми значениями — несколько макроблоков движутся на одинаковое расстояние, когда изображение панорамируется в нашем тестовом видео.
Энтропийный кодер позаботится об этой избыточности. И поскольку это универсальный кодек без потерь, не нужно волноваться о компромиссах. Все данные, которые входят, можно восстановить.
И готово! В своей сути вот как работают видеокодеки вроде H.264. Это его трюки.
Любопытно, сколько весит машина теперь?
Оригинальное видео было захвачено с необычным разрешением 1232×1154. Применяя математику:
5 сек @ 60 fps = 1232×1154×60×3×5 ⇒ 1,2 ГБ
Сжатое видео ⇒ 175 КБ
Если применить такое же соотношение к автомобилю в 3000 фунтов, получишь 0,4 фунта финального веса. 6,5 унций!
Да, это магия!
Очевидно, огромно упрощаю несколько десятилетий интенсивных исследований в этой области. Если хочешь узнать больше, страница Wikipedia весьма описательна.