Короткий ответ
Luna обнаружила 69 проверенных багов на 50 pull request'ах. Astra обнаружила 92. Luna стоила $0,20, Astra — $5,66. Luna ошибалась чаще: 24 из её 93 находок не прошли проверку, против 4 из 96 у Astra, и нашла 9 из 24 security-багов, где Astra нашла 19.
Вывод: Luna подходит для обнаружения ошибок в логике по такой цене, но её не стоит использовать самостоятельно для ревью кода аутентификации или прав доступа.
Как проводили тест
Методология повторяет предыдущее сравнение Astra с Sol, чтобы результаты были сопоставимы.
Pull request'ы — это 50 публичных бенчмарк-PR из организации AI-Code-Review-Evals: по 10 из Cal.com, Sentry, Discourse, Keycloak и Grafana. Каждый содержит дефекты, добавленные намеренно для тестирования.
Luna и Astra получили одинаковый промпт на одинаковых diff'ах. Промпт просит находить ошибки корректности, безопасности, конкурентности, работы с ресурсами и обработки ошибок — исключая стиль, наименование и документацию. Обе модели вернули структурированные находки.
Проверка работает так же, как раньше. На каждый pull request находки от Astra, Sol, Luna и публичные комментарии Entelligence рецензента объединяются в один анонимизированный список. GPT-6 Astra и GPT-5.6 Sol независимо судят этот список по diff'у, группируя дубликаты и решая, является ли каждая проблема реальным багом. Баг считается проверенным, только если оба судьи согласны. Они совпали в 91% находок, и 143 уникальных бага прошли обе проверки.
Добавление Luna-находок изменило пул, который видели судьи, поэтому всё пересчитали. Проверенный счёт Astra перешёл с 91 в предыдущем посте на 92 здесь, Sol — со 107 на 108. Astra также является одним из двух судей, что может его слегка преимущество. Раздел об ограничениях это закрывает.
Результаты
GPT-5.6 Luna | GPT-6 Astra | |
|---|---|---|
Проверенные баги | 69 | 92 |
Всего находок | 93 | 96 |
Точность | 74% | 96% |
Общая стоимость, 50 PR | $0,20 | $5,66 |
Стоимость за 1 проверенный баг | $0,0030 | $0,061 |
Среднее время на ревью | 23 сек | 36 сек |
Среднее выходных токенов на ревью | 2 104 | 688 |
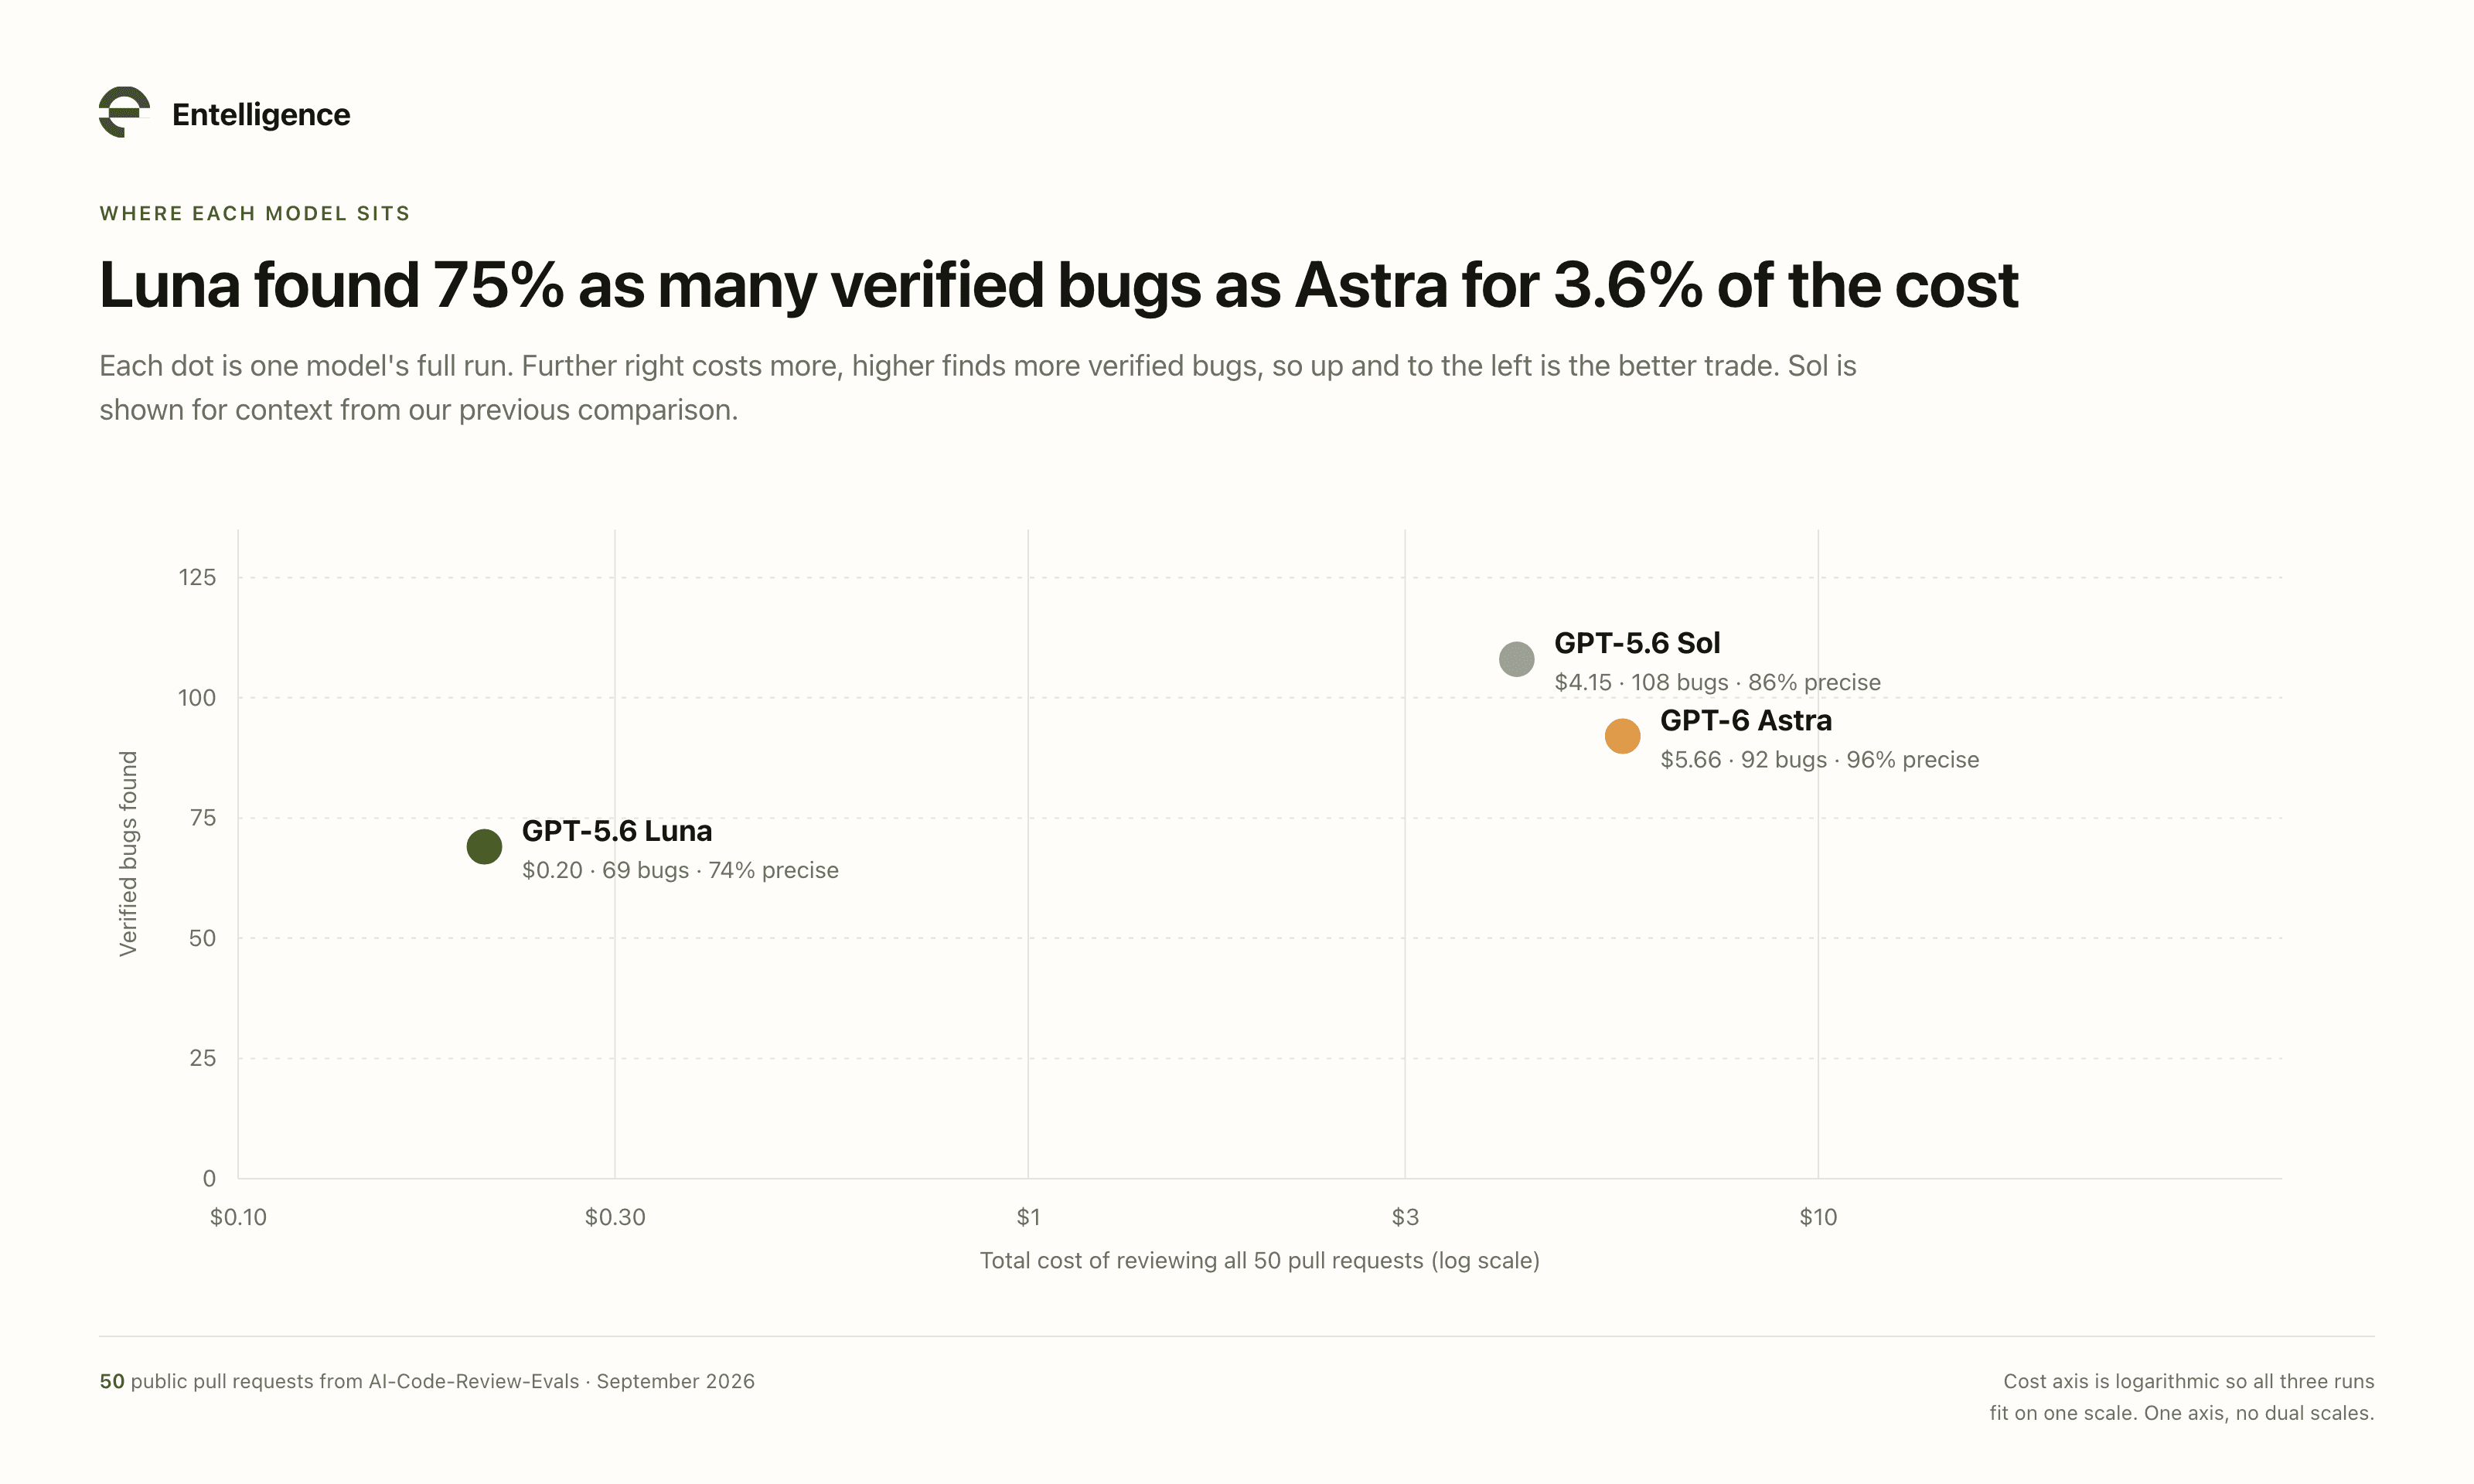
Luna обнаружила 75% от количества проверенных багов Astra за 3,6% денег. На один проверенный баг Astra стоила 20 раз больше.
Luna выдала в 3,1 раза больше выходных токенов на ревью, но всё равно обошлась намного дешевле, потому что цена выходных токенов у неё в 42 раза ниже. Также была быстрее: 23 секунды на ревью против 36.
Команда разработчиков почувствует разрыв в точности в первую очередь. Примерно каждый четвёртый комментарий Luna был неправильным, тогда как Astra ошиблась 4 раза из 96. Разработчики, которые уже быстро просматривают AI-ревью, будут просматривать его ещё быстрее, когда четверть комментариев — это шум.
Где Luna отстаёт
Читатели предыдущего поста просили разбить результаты по кодовой базе и типу бага, потому что общий счёт может скрывать модель, которая хорошо работает на одном репозитории и плохо на другом. На этих данных разбивка показывает, откуда берутся потерянные Luna баги.
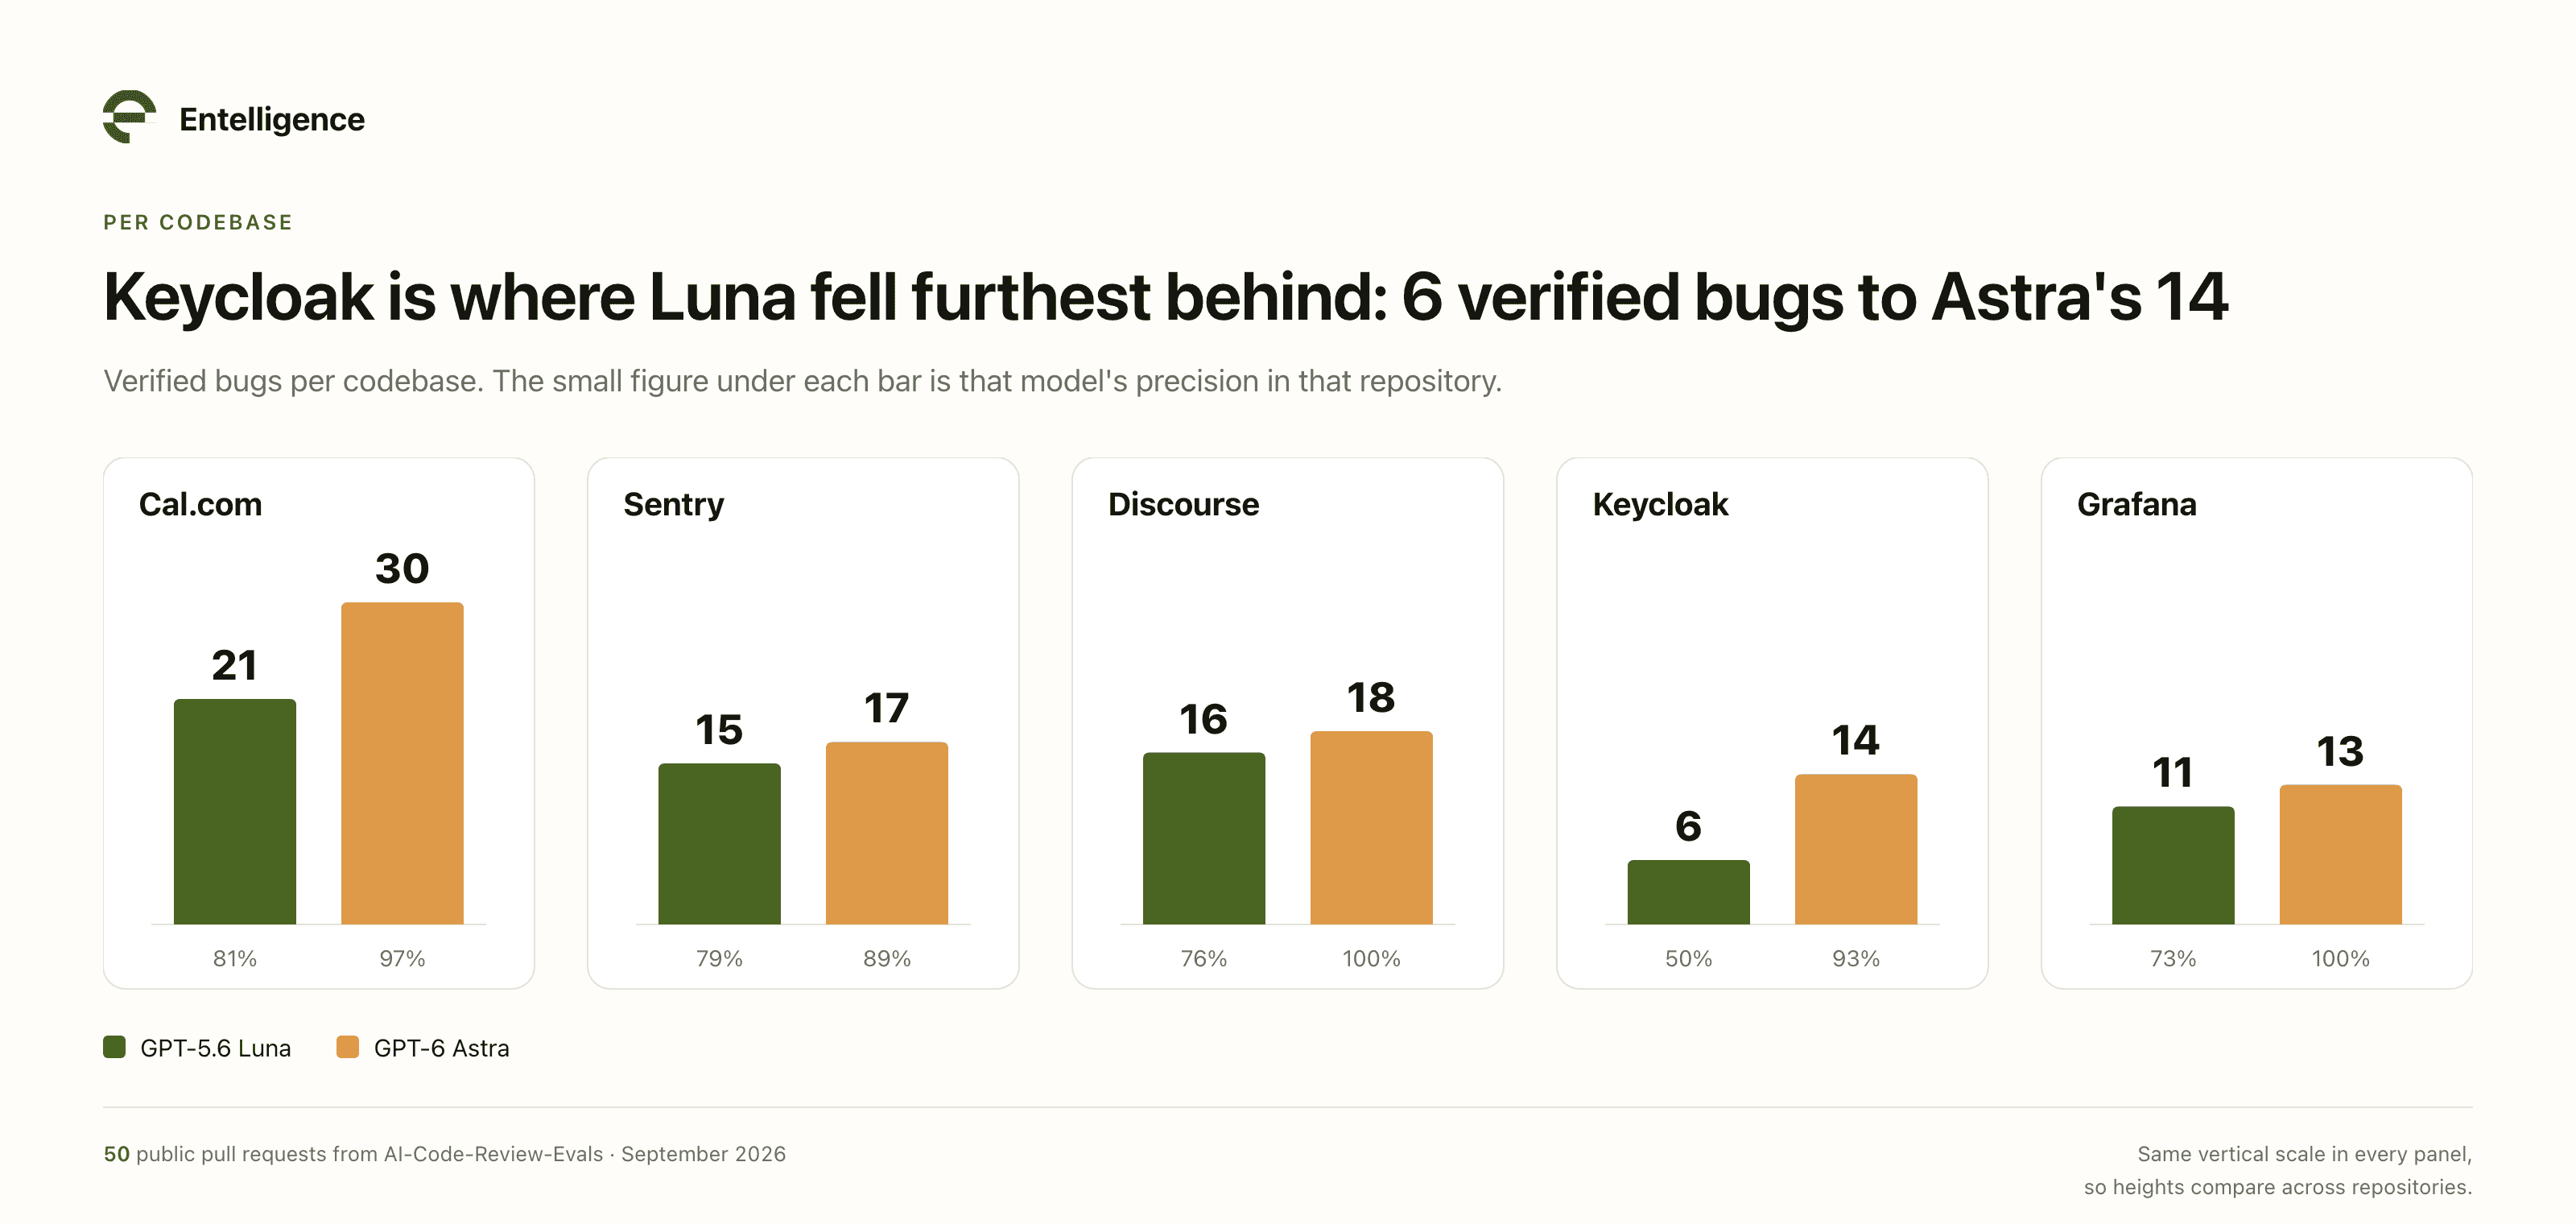
В Sentry, Discourse и Grafana Luna пришла в пределах двух проверенных багов от Astra. Cal.com показал больший разрыв: 21 против 30. Keycloak показал самый большой: Luna нашла 6 проверенных багов против 14 у Astra, и только 50% её находок в Keycloak прошли проверку против 93% у Astra.
Keycloak — это сервер управления идентификацией и доступом, и большинство его бенчмарк-PR меняют логику аутентификации и прав. Разбивка по классам багов указывает туда же.
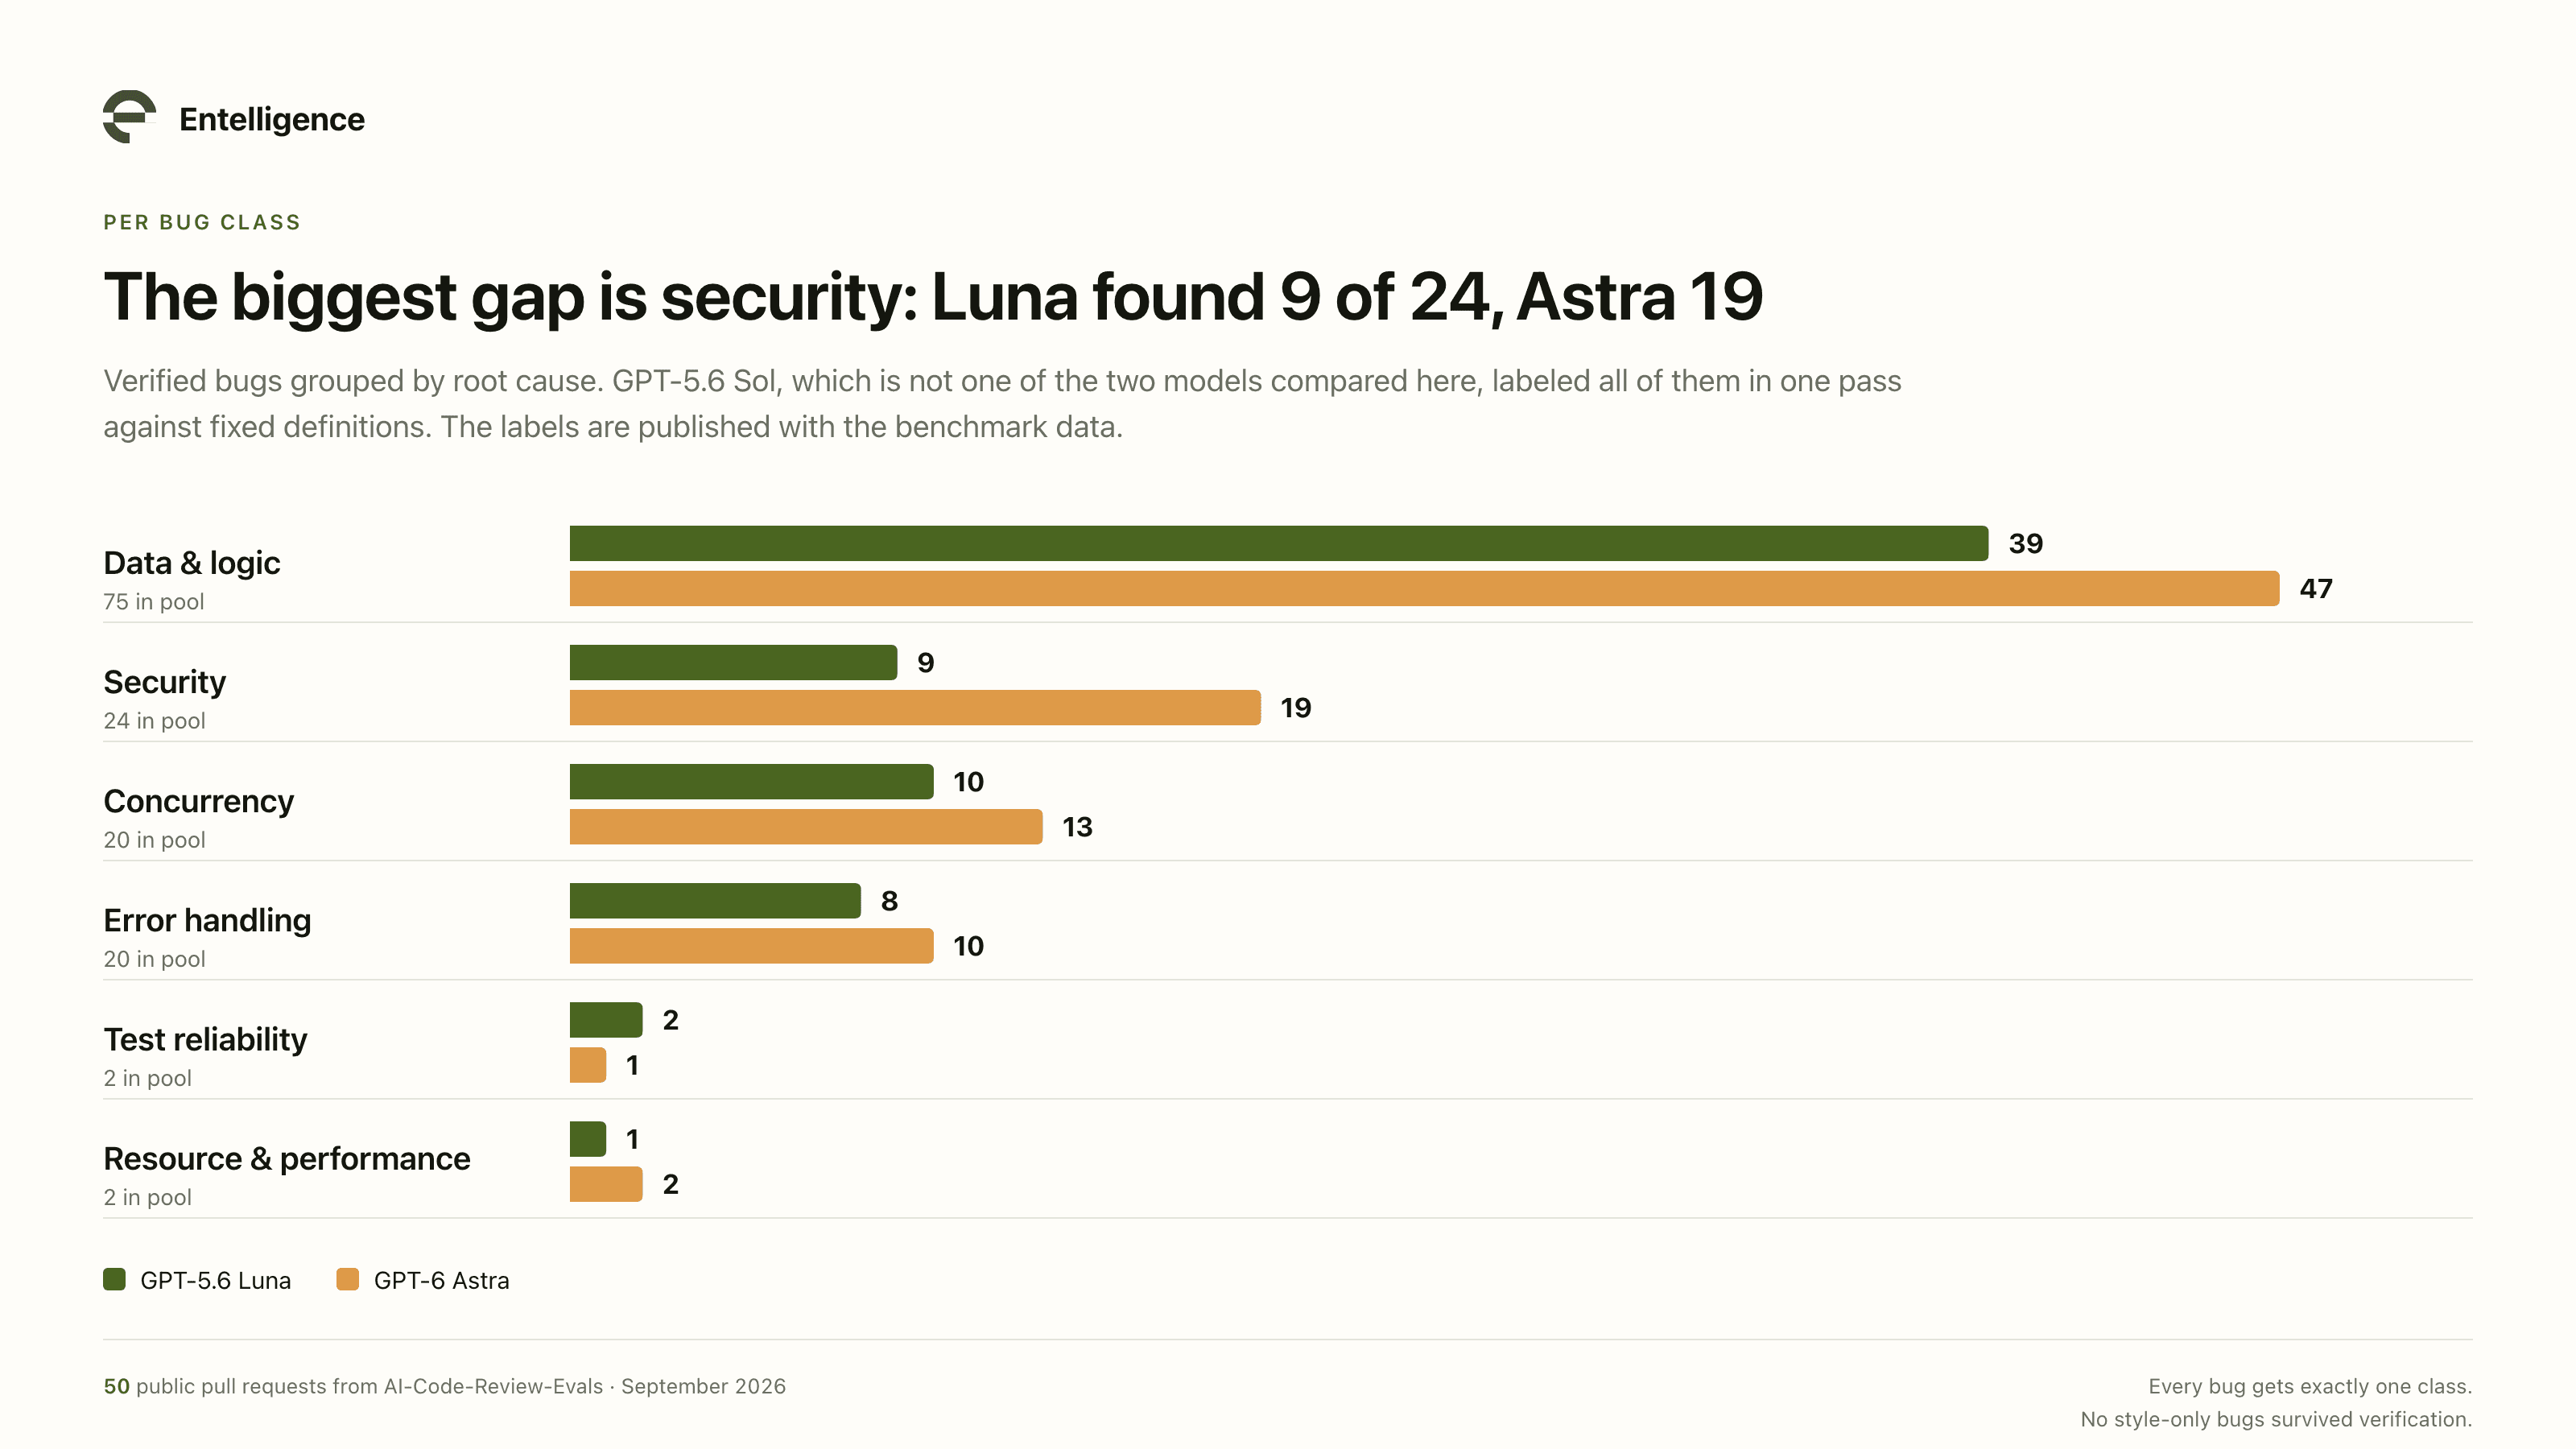
Каждый проверенный баг был размечен по корневой причине. GPT-5.6 Sol (не один из двух сравниваемых моделей) разметил все 143 бага в одном проходе по письменным определениям. Разметки зафиксированы вместе с данными бенчмарка, так что каждый может их проверить.
На багах данных и логики — самой большой группе — Luna нашла 39 против 47 у Astra. На конкурентности нашла 10 против 13. На security Luna нашла 9 из 24, Astra — 19.
Два Keycloak-бага, которые Astra поймала, а Luna нет:
Коды восстановления с федерацией никогда не отмечались как использованные, поэтому код восстановления можно было использовать несколько раз.
Глобальное разрешение просмотра переопределяло запреты, установленные на отдельных клиентах.
Ни то, ни другое не выглядит неправильно на одной строке. Увидеть их можно только, поняв, что модель разрешений позволяет после изменения. Дешёвая модель хорошо справляется с большей частью этого бенчмарка и плохо — с этими двумя. Coding agents сталкиваются с тем же разделением, и Model Router принимает это решение на задачу, поднимая на более мощную модель, когда работа это требует.
Что Luna находит, чего Astra упускает
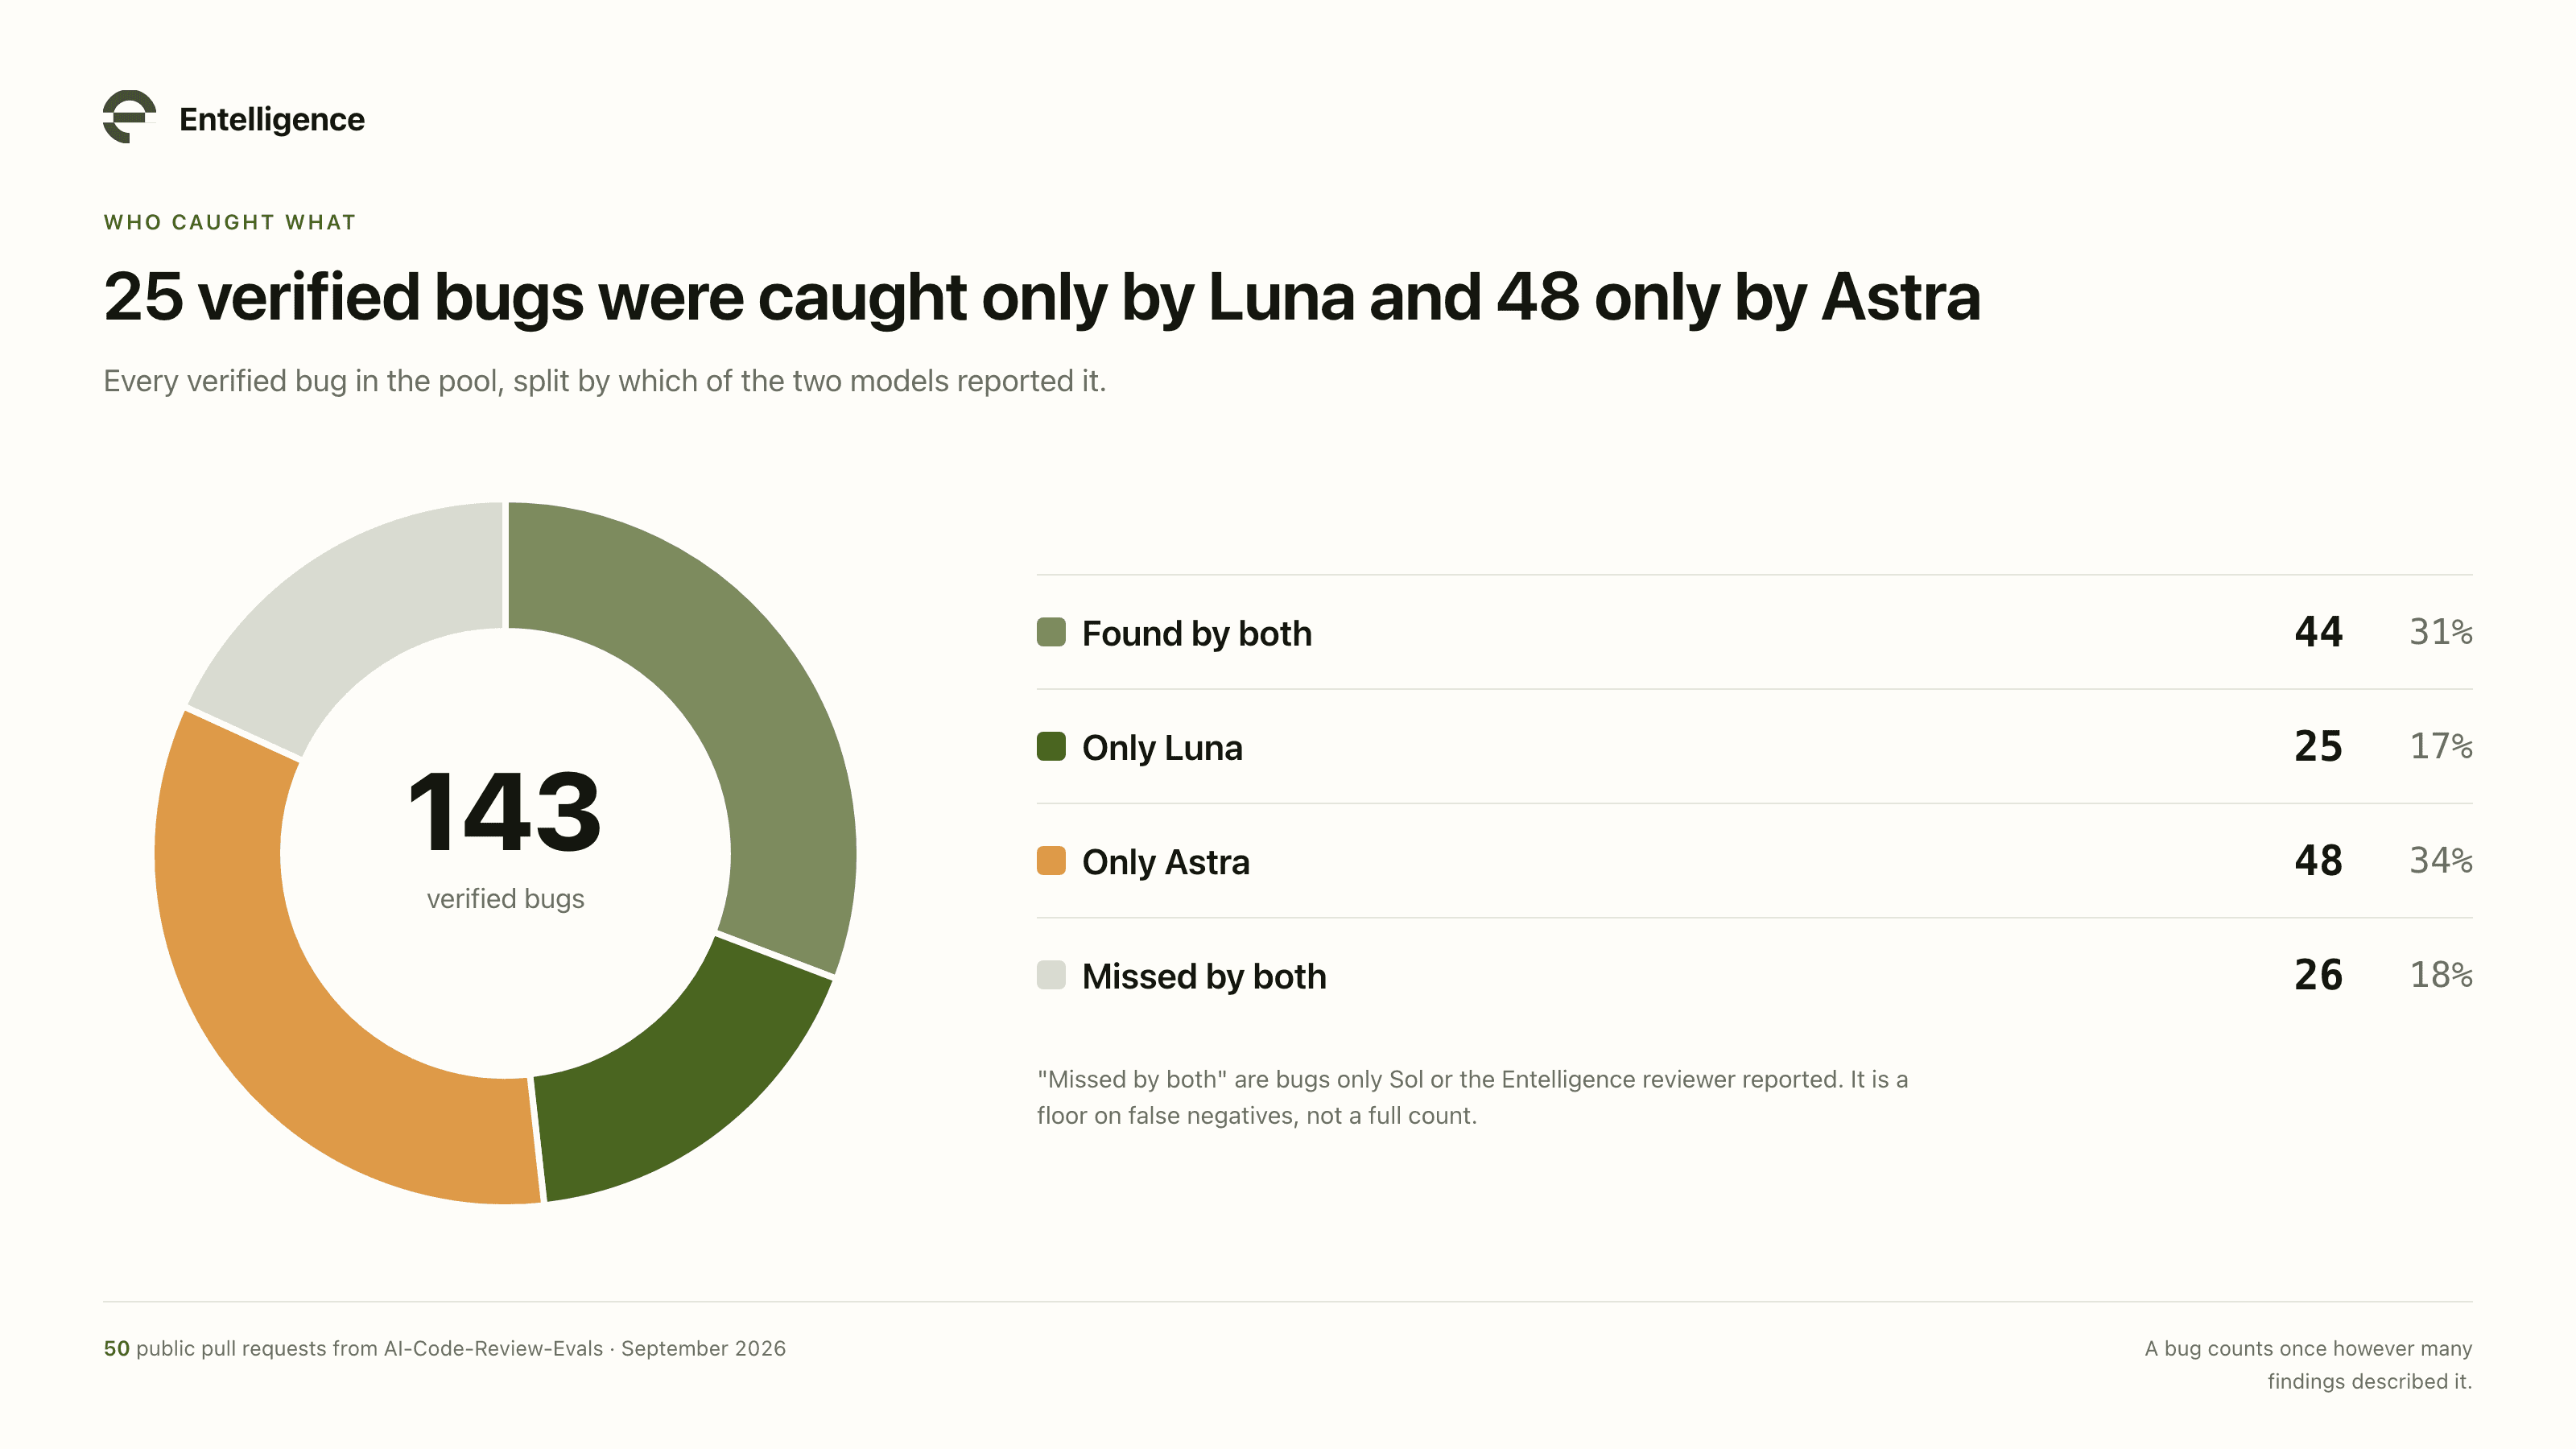
Luna также нашла баги, которые упустила Astra. Из 143 проверенных багов 44 найдены обеими моделями, 48 только Astra, 25 только Luna.
Из 25 Luna-only багов 16 — это баги данных и логики и 4 — баги конкурентности. В Discourse повторный запрос отписки продолжал понижать уровень уведомлений пользователя. В Sentry баг конкурентности заменял нездоровые рабочие потоки без остановки старых.
Запуск обеих моделей на каждом pull request нашёл бы 117 из 143 проверенных багов (82%) за $5,86 всего. Это Luna $0,20 сверху Astra $5,66, за 25 дополнительных проверенных багов.
Что просили проверить читатели
Модели просто вспомнили исправления?
Один читатель указал, что эти репозитории публичны, и исправления для бенчмарк-багов могут быть в их истории. Модель, обученная после того, как исправления попали в ветку, может вспоминать патч, который уже видела. Предложенный тест — разбить pull request'ы по дате и посмотреть, держится ли рейтинг на изменениях, сделанных после дня cutoff каждой модели.
Мы не можем запустить такой разбор на этом бенчмарке. Мы вытащили дату коммита для каждого PR, и они варьируются от 2013 до 25 июля 2025. 20 из них от 2025, и ни один недостаточно свеж, чтобы упасть после cutoff'а любой модели. Группа пост-cutoff была бы пуста.
Риск меньше, чем звучит, потому что дефекты были добавлены к этим PR'ам специально для бенчмарка, поэтому точный баг в каждом diff'е — это не коммит, на котором модель могла учиться. Окружающий код старый и публичный, хотя, и модель, которая знает, как выглядит правильная версия, имеет преимущество. Правильное тестирование нужно pull request'ы новее моделей, и этот бенчмарк их не может дать.
Модели находят одни и те же баги дважды?
Другой читатель просил перезапустить несколько PR'ов с идентичными настройками. Выбрали два PR'а на кодовую базу и запустили каждую модель ещё два раза.
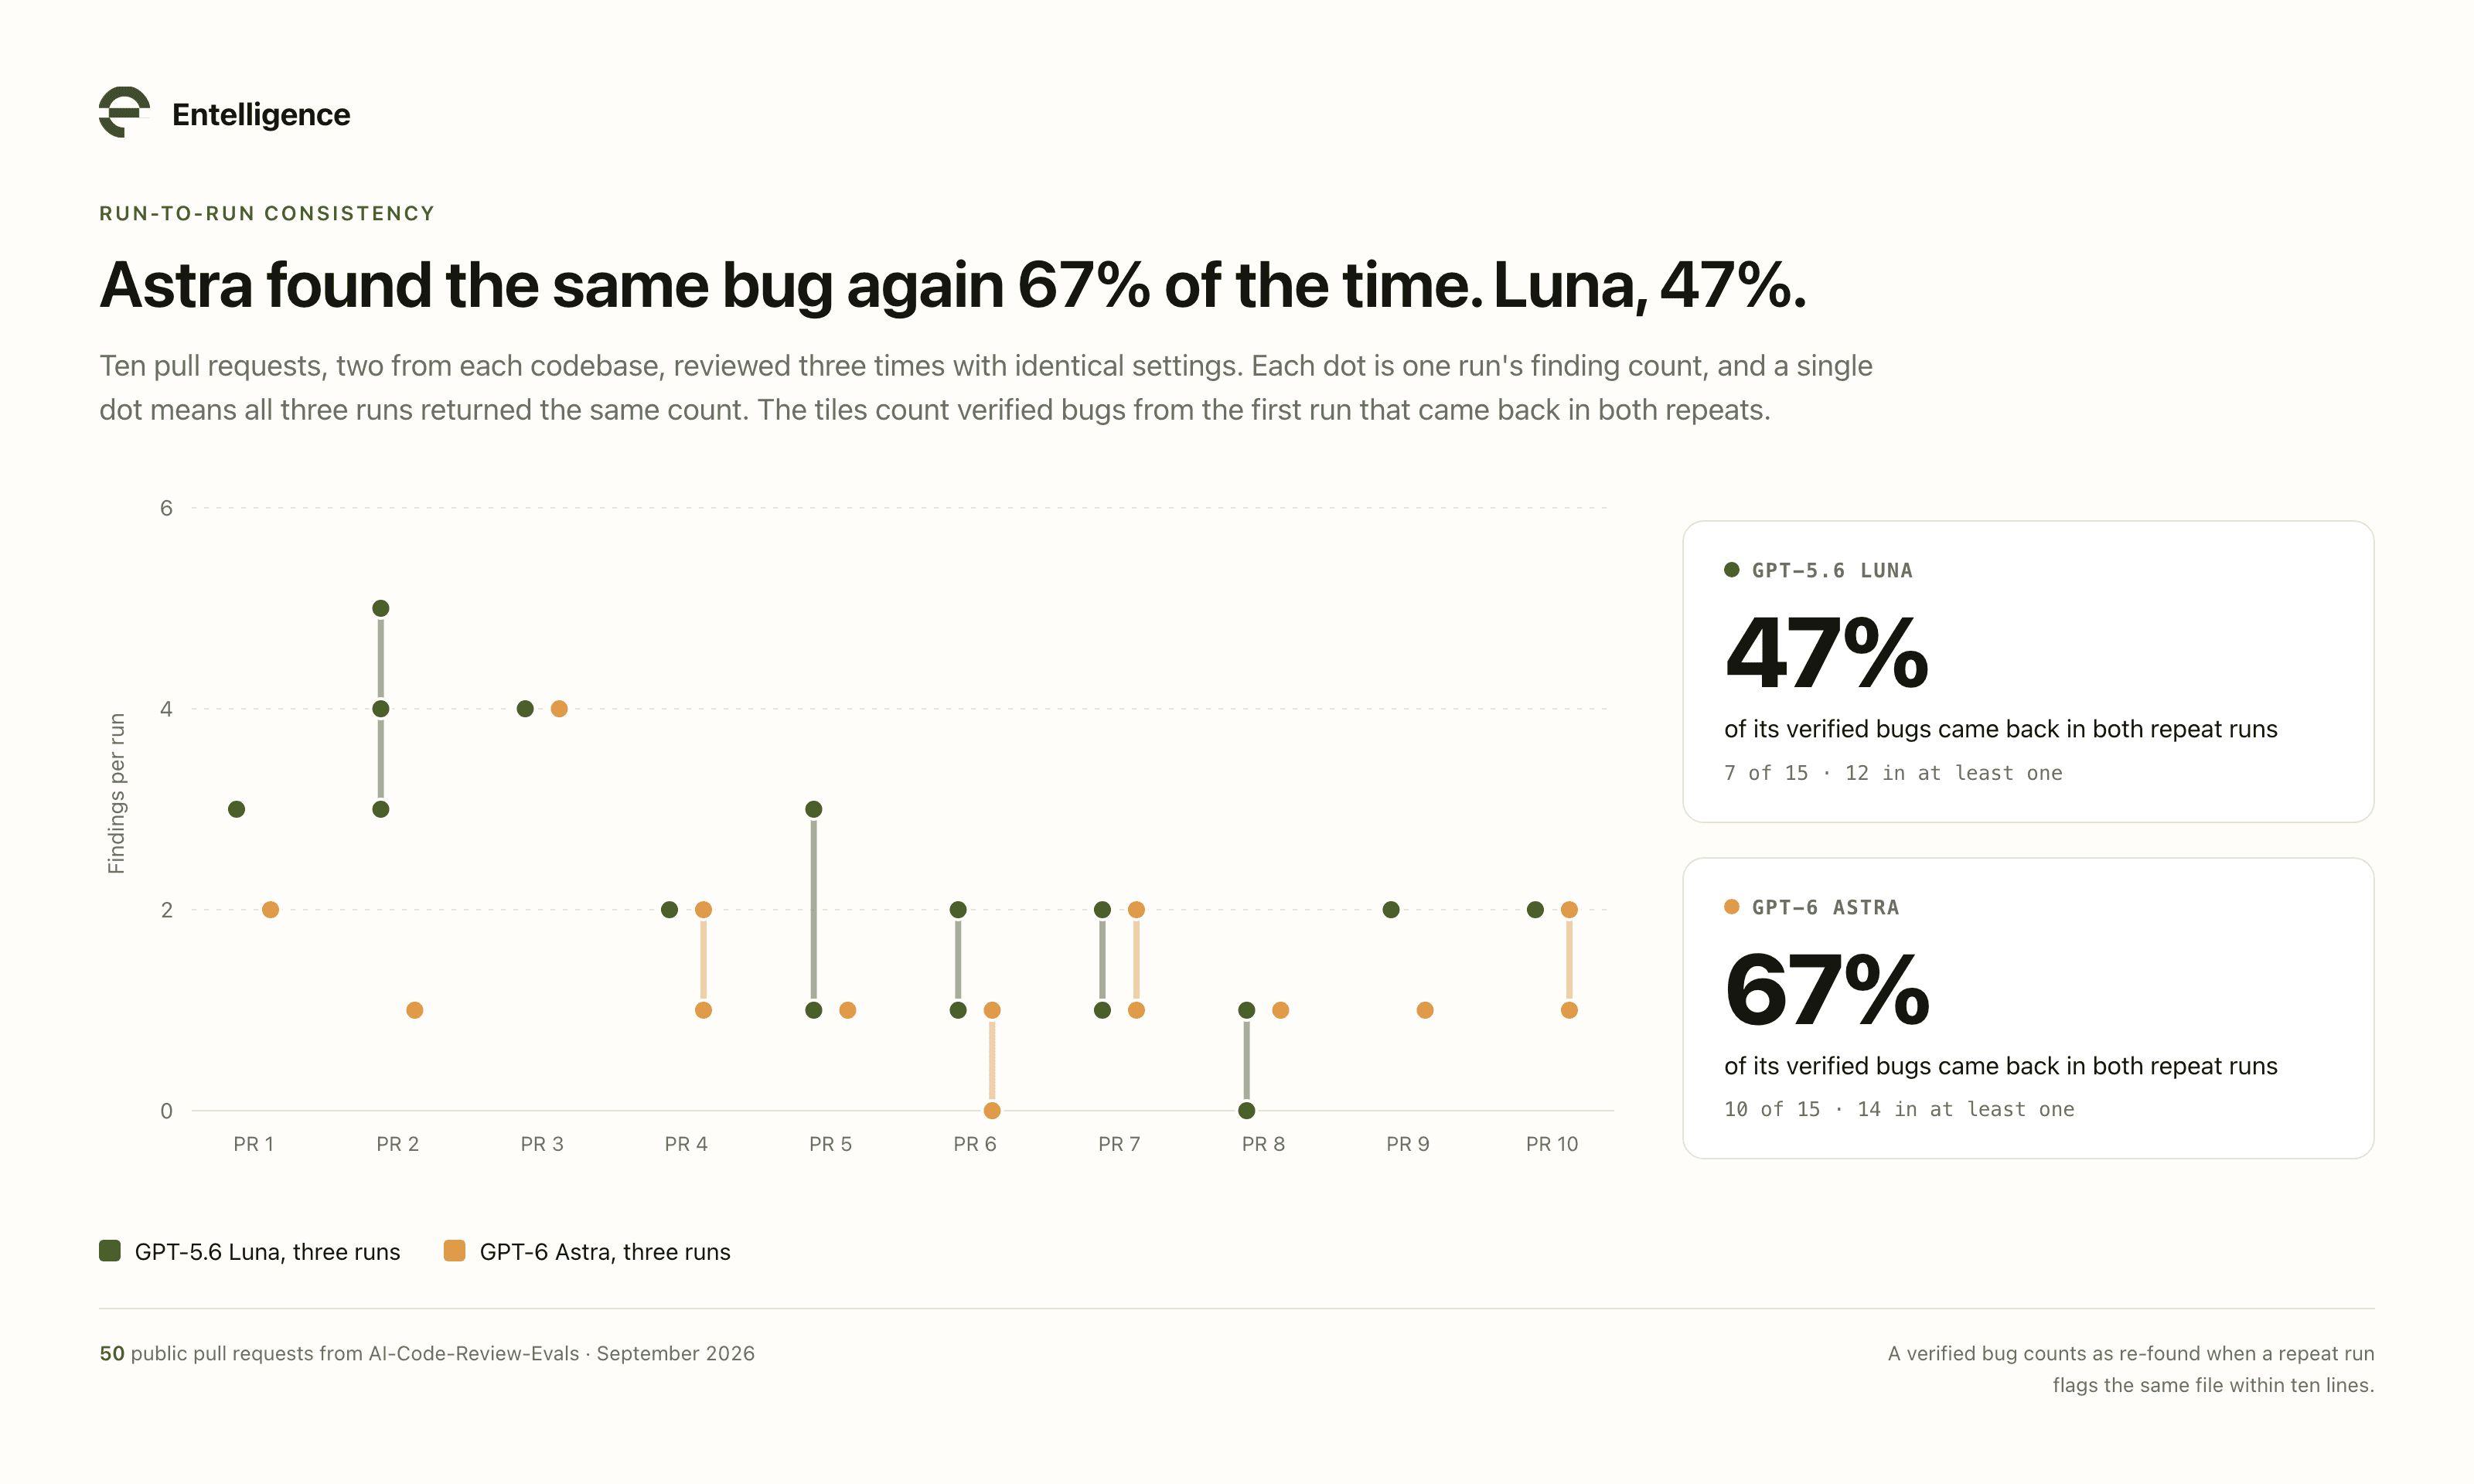
Из первого прогона Astra получила 15 проверенных багов на этих 10 PR'ах. 10 вернулись в обоих повторах и 14 хотя бы в одном. Luna тоже получила 15. 7 вернулись в обоих повторах и 12 хотя бы в одном.
Выборка маленькая, так что воспринимайте это как приблизительно. Модель, которая находит баг в одном прогоне, может его пропустить в следующем, что применимо к каждому однопрогонному числу в этом посте, и Luna делала это чаще, чем Astra.
Что с багами, которые никто не отметил?
Третий запрос был отслеживать ложные отрицания, то есть реальные баги, которые обе модели пропустили. Измерение этого нужно полный список багов в каждом PR, который бенчмарк не публикует.
Можем дать нижнюю границу. 26 проверенных багов пропустили обе Luna и Astra и поймали только Sol или публичный рецензент Entelligence. Два из них — security-баги Discourse из предыдущего поста: проверка происхождения postMessage, которая использовала совпадение подстроки, и удалённая загрузка, которая следовала редиректам мимо списка разрешённых хостов. Истинное число пропущенных багов выше, потому что баги, которые ни один рецензент не отметил, никогда не входят в пул.
Ограничения этого сравнения
Кроме 10 повторённых PR'ов, каждая модель рецензировала каждый PR один раз, и повторные прогоны показывают, что результаты движутся между прогонами.
Astra является и участником, и одним из двух судей. Требование согласия Sol снижает предвзятость без её устранения.
Каждый PR предшествует cutoff'ам обеих моделей, поэтому разбор по датам, который читатели просили, здесь невозможен.
Обе модели видели только diff. У них не было истории репозитория, графика вызовов или production-данных.
Проверенные счёты — это нижняя граница на присутствующие баги, и бенчмарк не имеет полного списка багов для измерения против.
Что diff не говорит модели
На этом бенчмарке дешёвая модель хорошо справилась с большинством изменений и плохо — с кодом аутентификации и прав. Diff один не говорит модели, какой вид изменения она рецензирует.
Знание того, что файл лежит на пути авторизации, что функция вызывается из потока логина, или что похожее изменение вызвало инцидент в последнем квартале — определяет, насколько тщательно должно быть рецензировано изменение. Entelligence code review рецензирует pull request'ы с контекстом полного репозитория и подаёт production-поведение в последующие рецензии, что информация, которую diff-only модель теряет.
Для coding agents Entelligence Model Router отправляет рутинные шаги на дешёвые модели и сложные на более мощные. Наше предыдущее сравнение Terminal-Bench освещает, как это сыграло на задачах agent'ов.
Запуск этого на вашем коде
Собрать 30–50 объединённых pull request'ов из ваших репозиториев, которые позже потребовали исправления.
Запустить дешёвую модель и дорогую модель с одинаковым промптом.
Проверить находки судьёй, который не является одной из двух моделей, или оба судья и человек проверят выборку.
Разбить результаты по репозиторию и по классу бага, так как среднее скрывает слабые места.
Перезапустить пару PR'ов, чтобы увидеть, насколько движутся результаты.
Сравнить стоимость на проверенный баг, и отдельно посмотреть классы, где упущение дорого стоит.
Часто задаваемые вопросы
GPT-5.6 Luna достаточна для ревью кода?
Для bagов общей корректности пришла близко к Astra на этом бенчмарке. Luna нашла 39 багов данных и логики против 47 у Astra за небольшую часть стоимости. Для кода, чувствительного к безопасности, отстала хорошо, найдя 9 из 24 security-багов против 19 у Astra.
Насколько Luna дешевле Astra на ревью?
На этих pull request'ах ревью Luna стоило $0,0041, ревью Astra стоило $0,113 — примерно в 28 раз дешевле. На проверенный баг Luna стоила $0,0030, Astra $0,061.
Luna шумнее, чем Astra?
Да. 74% находок Luna прошли проверку против 96% у Astra, то есть примерно каждый четвёртый комментарий Luna не выдержал.
Запускать обе модели?
Запуск обеих нашёл 117 из 143 проверенных багов за $5,86 на 50 pull request'ов против 92 только у Astra. Стоит ли дополнительный шум для дополнительных багов — зависит от того, как ваша команда обращается с комментариями ревью.
Я могу это воспроизвести?
Да. Pull request'ы публичны, и промпты, сырые выходы моделей, вердикты судей, разметки классов багов, повторные прогоны и скрипты подсчёта зафиксированы вместе с этой статьёй.
Итоговое резюме
Luna нашла три четверти проверенных багов Astra за менее чем 4% стоимости. Отстала дальше всего на коде аутентификации и прав, где пропущенный баг имеет тенденцию стоить больше всего. Схема, которая рецензирует большинство изменений дёшево и даёт чувствительным к безопасности больше внимания, может использовать этот компромисс, но должна знать, какие изменения какие.