Быстрое преобразование Фурье — один из самых важных алгоритмов в цифровой обработке сигналов. FFT позволяет быстро извлекать частотное содержание сигналов и анализировать различные полосы спектра.
Основы преобразования Фурье
Преобразование Фурье вычисляет энергию в каждой полосе частот через простое скалярное произведение. Если x — массив образцов длины n, а f — частота, то количество частотного содержания можно вычислить по формуле:
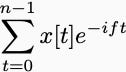
Для цифровых сигналов достаточно вычислить n скалярных произведений — по одному для каждого кратного частоте 2π/n. Наивный подход требует n умножений и сложений для каждой частоты, что в целом дает n² операций.
Быстрое преобразование Фурье — это остроумная рекурсивная процедура, разработанная Джеймсом Кули и Джоном Тьюки в 1965 году. Основная идея: FFT длины n вычисляется путем перестановки входного вектора, вычисления двух FFT длины n/2 на переставленных компонентах и затем переобработки выходов с помощью простых арифметических операций. Перестановки и переобработка требуют линейного числа операций. Повторяя эту процедуру log₂(n) раз, получаем полное дискретное преобразование Фурье менее чем за 5n log₂ n операций.
Для конкретики: когда n = 1000, n² = 1 000 000, а 5 × n log n ≈ 50 000 — это 20-кратное ускорение. При n = 1 000 000 ускорение 10 000-кратное. Такие улучшения могут быть решающими при обработке сигналов.
После изобретения FFT исследователи искали еще более быстрые варианты. Логичный вопрос: насколько быстро можно? Интуитивно, нужно минимум n операций, так как требуется n шагов хотя бы для вывода результата. FFT медленнее этого предела на множитель 5 log₂(n), а для триллиона элементов это 200. Можно ли уменьшить этот префактор?
Заявление OpenAI
OpenAI недавно выпустил огромный поток математических статей, среди которых — заявление о более быстром преобразовании Фурье. Основной результат из их файла "main.pdf":
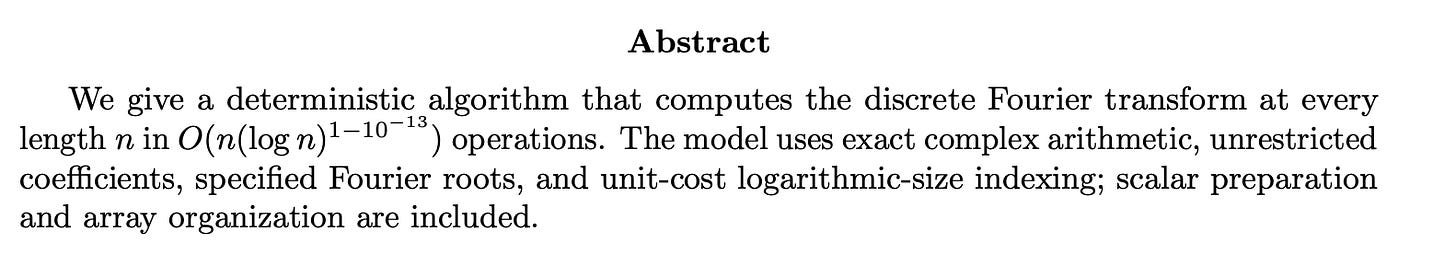
На первый взгляд, член log(n) немного меньше, чем в стандартном FFT. Заинтересовался ли я чтением этой статьи? Конечно, нет. Никто в OpenAI тоже её не читал, так почему я должен? Я сделал то же, что любой математик — скормил результат обратно машине и провел информационный поиск через чатбот, чтобы извлечь ключевые факты. Антропоморфно говоря: спросил ChatGPT, что оно думает о собственном выводе. Вот как мы занимаемся исследованиями сейчас. Какой мир.
К сожалению, более быстрого преобразования Фурье я не нашел. Вместо этого обнаружился гной, развивающийся в прикладной математической теории, когда формализм настолько отрывается от реальности, что «прорыв» становится всего лишь артефактом неспособности математиков правильно определить правила своей игры на естественном языке.
Проблема О-нотации
Нотация «большое О» настолько скомпрометирована, что стала бессмысленной. Вспомним определение, которое произвело на меня впечатление на первом курсе. Алгоритм имеет время выполнения T(n) = O(F(n)), если существуют целое число N и константа C такие что:
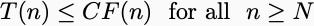
То есть число операций, которое алгоритм действительно выполняет, ограничено сверху некоторой константой, умноженной на удобную функцию F(n), при условии достаточно большого n. Обычно F(n) — что-то знакомое и интерпретируемое, например полином или экспонента. Нотация описывает асимптотический темп роста времени вычисления. Все константы считаются эквивалентными.
О-нотация полезна для ленивой бухгалтерии алгоритмов, но позволяет невероятной логической лени. Если нам нужен практически быстрый FFT, нам нужен алгоритм, требующий менее 50n операций при разумных n. Но O(n) не значит 50n. Это может означать 10⁸⁰n. Такой алгоритм считается «линейным временем». Алгоритм, требующий n + 10⁸⁰, тоже считается линейным. Алгоритм, имеющий гарантии линейного времени только при n > 10⁸⁰, тоже линейный. 10⁸⁰ приблизительно равно числу атомов во Вселенной. Поэтому Ричард Липтон и Кен Реган называют алгоритмы с неправдоподобно большими скрытыми константами галактическими алгоритмами.
Алгоритм FFT от OpenAI определенно галактический. Оцененные значения C составляли 10¹⁰⁰ при N = 10¹². Поэтому даже при n = 10¹⁰⁰ классический FFT Кули—Тьюки—Гаусса был бы в 10⁹⁹ раз быстрее.
Почему же этот новый результат FFT интересен? Заметим: в О-нотации он технически асимптотически быстрее алгоритма Кули—Тьюки, потому что:
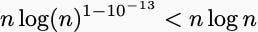
Безусловно. Но учитывая константы, алгоритм работает быстрее только при невозможно больших n. Примерно нужно:
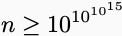
Что бы ни означало это число.
Галактические алгоритмы и реальность
Липтон и Реган утверждают, что галактические алгоритмы полезны, так как стимулируют исследования. Когда доказано, что асимптотическое время возможно, можно потратить время на поиск алгоритма, практически достигающего этого доказуемого времени. Может быть, можно отправить на это рои AI-агентов. Как скажешь. Возможно, получится практический алгоритм, но я не знаю ни одного легитимного примера, когда это произошло. Я особенно скептичен здесь, потому что модель «вычисления», используемая OpenAI, совершенно не похожа на реальный компьютер.
«Модель использует точную комплексную арифметику». Это означает, что можно хранить и умножать комплексные числа с произвольной точностью. Более того, алгоритм требует умножения комплексных чисел, величины которых растут суперполиномиально с n. Если хранить эти числа как биты, требование к памяти было бы экспоненциально по длине входа. Это предполагает, что можно умножить такие произвольно большие комплексные числа за одну операцию. У нас нет компьютеров, которые могут это делать. Так что даже если теорема в main.pdf «верна» (никто не знает, и мне это безразлично), она фактически не решает проблему, которую мы ставили, ища быстрее FFT.
Для знакомых с теоретическим анализом FFT не удивительно, что нужна абсурдная модель вычислений для преодоления предела скорости FFT. В 1973 году Жак Моргенштерн доказал, что не получится быстрее чем за ½n log n, если потребовать ограниченную величину комплексных коэффициентов. Всё должно было закончиться! Но не закончилось. Люди сказали, что ограничение Моргенштерна на коэффициенты слишком строго. Сорок лет спустя Ниp Айлон показал, что FFT невозможно вычислить быстрее чем за n log n без серьёзных численных нестабильностей. Это тоже оказалось слишком ограничивающим, похоже.
Этот новый результат OpenAI — не математический прорыв, а странность плохого умения компьютерщиков формализировать спецификации проектов. «Теоретическое» определение компьютера очень далеко от компьютеров, которые мы действительно строим. «Более быстрое» преобразование Фурье — всего лишь пример того, как теория отрывается от исходного вопроса настолько, что «открытая проблема» становится просто академическим статусным головоломкой. Решение подобно тому, что происходит, когда направить потоки вычислительных ботов на невозможные задачи и обнаружить, что они занимаются незаконным взломом.
Больше проблем в репозитории OpenAI
Множество других «больших» результатов в этом хранилище слюны OpenAI можно критиковать так же. Например, одним из результатов был галактический алгоритм умножения двух матриц за O(n²·²⁵) операций. Конструкция, использованная в статье, даже не позволяет оценить константу, скрывающуюся под О. Это может быть бесконечность, вычисляемая только божественной музыкой сфер.
Однако, будь эти работы написаны намного лучше, они попали бы в самые престижные издания по теории компьютерных наук (то есть рецензируемые материалы конференций STOC или FOCS). Статья об умножении матриц наверняка выиграла бы премии. Но ни одно из них не имеет отношения к компьютерам!
Это потому, что теория компьютерных наук культурно активно препятствует запуску алгоритмов на компьютере. Приемлемо писать статьи для теоретических конференций, утверждая, что алгоритм существует, не выписав его. Теория компьютерных наук стала формой математики, которая не касается компьютеров, и предлагает мало награды за влияние вне этих математических занятий. Я объяснил это другу, который заметил, что «теория» имеет трансдисциплинарное значение — «скрываться в безвестности собственного изобретения».
Машины и наши худшие привычки
AI очень хорош в автоматизации наших худших тенденций. Это усиливает скрытые культурные практики, которые никому не нравятся, но от которых никто не может разумно отклониться. Эксплуатирует окаменелые традиции, резистентные к коллективному действию. В этом ключе AI теперь может писать бесполезные теоретические статьи. Но, возможно, в абсурдности отвратительной свалки доказательств OpenAI мы все сможем посмотреть вверх и осознать вместе, что пора подумать о чём-то другом.