Ember-1: половина токенов, такие же ответы
Ember-1 — новая специализированная модель от Fireworks Research, которая доставляет качество Kimi K3 при использовании на 40% меньше токенов. Построенная на базе Kimi K3, она научилась устранять ненужные рассуждения, сохраняя полезную часть цепочки мышления. Проверку прошла на внешних бенчмарках, живых A/B тестах с клиентами и собственных задачах кодирования и агентов — качество устояло везде. Ember-1 доступна уже сегодня и начинает серию специализированных моделей от Fireworks, которые формируются на основе того, что нужно разработчикам. Это лишь начало того, что возможно создать с помощью платформы Fireworks Training.
Как Fireworks Research создала Ember-1
От пользователей слышали просьбу: нужны возможности кодирования K3 при меньшей стоимости, потому что её длинные цепочки рассуждений делают автоматизированное кодирование дорогим в масштабе. Снижение уровня рассуждений K3 не решало проблему — более низкие параметры приводили к потере качества. Чтобы сохранить качество и сократить токены, модель нужно было научить рассуждать эффективнее, а это требовало обучения.
Это потребовало серьёзных исследований. Команда провела более 50 экспериментов обучения и более 200 оценок, разработав по пути новые алгоритмы обучения для сокращения цепочек рассуждений без потери точности. Всё это было сделано на Fireworks Serverless Training. Поскольку не нужно было разворачивать и управлять GPU, удалось запускать эксперименты сразу же после появления идеи, платить только за использованное время и пройти путь от исследования к запуску за долю обычного времени и стоимости.
Обучение проводилось на широком наборе задач, чтобы экономия токенов применялась ко многим workload'ам. Затем Ember-1 проверили на Specialized Intelligence Index, открытых бенчмарках и живом production трафике, чтобы подтвердить меньшее использование токенов без снижения качества. Ember-1 — собственная модель Fireworks и первая в серии моделей от Fireworks Research.
Проблема: reasoning-модели рассуждают слишком много
Модели для рассуждений, как Kimi K3, тратят большинство генерируемых токенов, иногда более 90%, на внутренние рассуждения, а не на сам ответ. Такая структура дорога для отдельного запроса, но становится намного хуже в многоходовых агентских workload'ах. На каждом ходу вся предыдущая цепочка рассуждений воспроизводится заново для модели, так что контекст растёт примерно квадратично с числом ходов. Длинные цепочки рассуждений с ранних ходов переполучаются (и перечитываются в счёте) на каждом последующем вызове.
Всё ли это рассуждение действительно необходимо? Эксперименты показали нет. Рассуждения, которые генерирует Kimi K3, намного длиннее, чем требует задача, и лишнее можно удалить, не касаясь ответа. Вот так и создалась Ember-1 — экономная версия Kimi K3, построенная на основе специализированного интеллекта.
От наблюдения к premium-модели
Не все рассуждения K3 впустую. Часть из них — саморефлексия: переосмысление предположения, ответ на обратную связь или отслеживание результата до более раннего решения помогает модели восстановиться после ошибок. Возможность в сохранении такой способности при одновременном снижении ненужных рассуждений и избежании непродуктивных циклов. Предположение: обучение на задачах и обратной связи окружения может научить модель рассуждать эффективнее, сохраняя возможности.
Для агентских задач это обучение распространяется на всё взаимодействие. Модель исследует возможные действия, включает новые наблюдения и уточняет своё рассуждение по мере развития. Обратная связь связывает решения с их последствиями, поощряя полезное переосмысление на протяжении всей задачи.
Эти идеи воплотились в тренировочном наборе данных, охватывающем математику, кодирование, следование инструкциям, диалоги, поиск, использование инструментов и программную инженерию, включая как отдельные задачи, так и расширенные взаимодействия для обучения адаптации к наблюдениям и результатам. Обратная связь по задачам направляет планирование и обучение в процессе, с акцентом на сохранение возможностей в этом диапазоне сценариев.
Результаты на открытых бенчмарках и живых A/B тестах подтверждают направление: в семи бенчмарках и двух production трафиках клиентов рассуждения Kimi K3 удалось сократить на 35–50% без потери точности. Интернализованное поведение также показывает сдержанное использование токенов при неудачных попытках, сокращая продолжительное непродуктивное рассуждение.
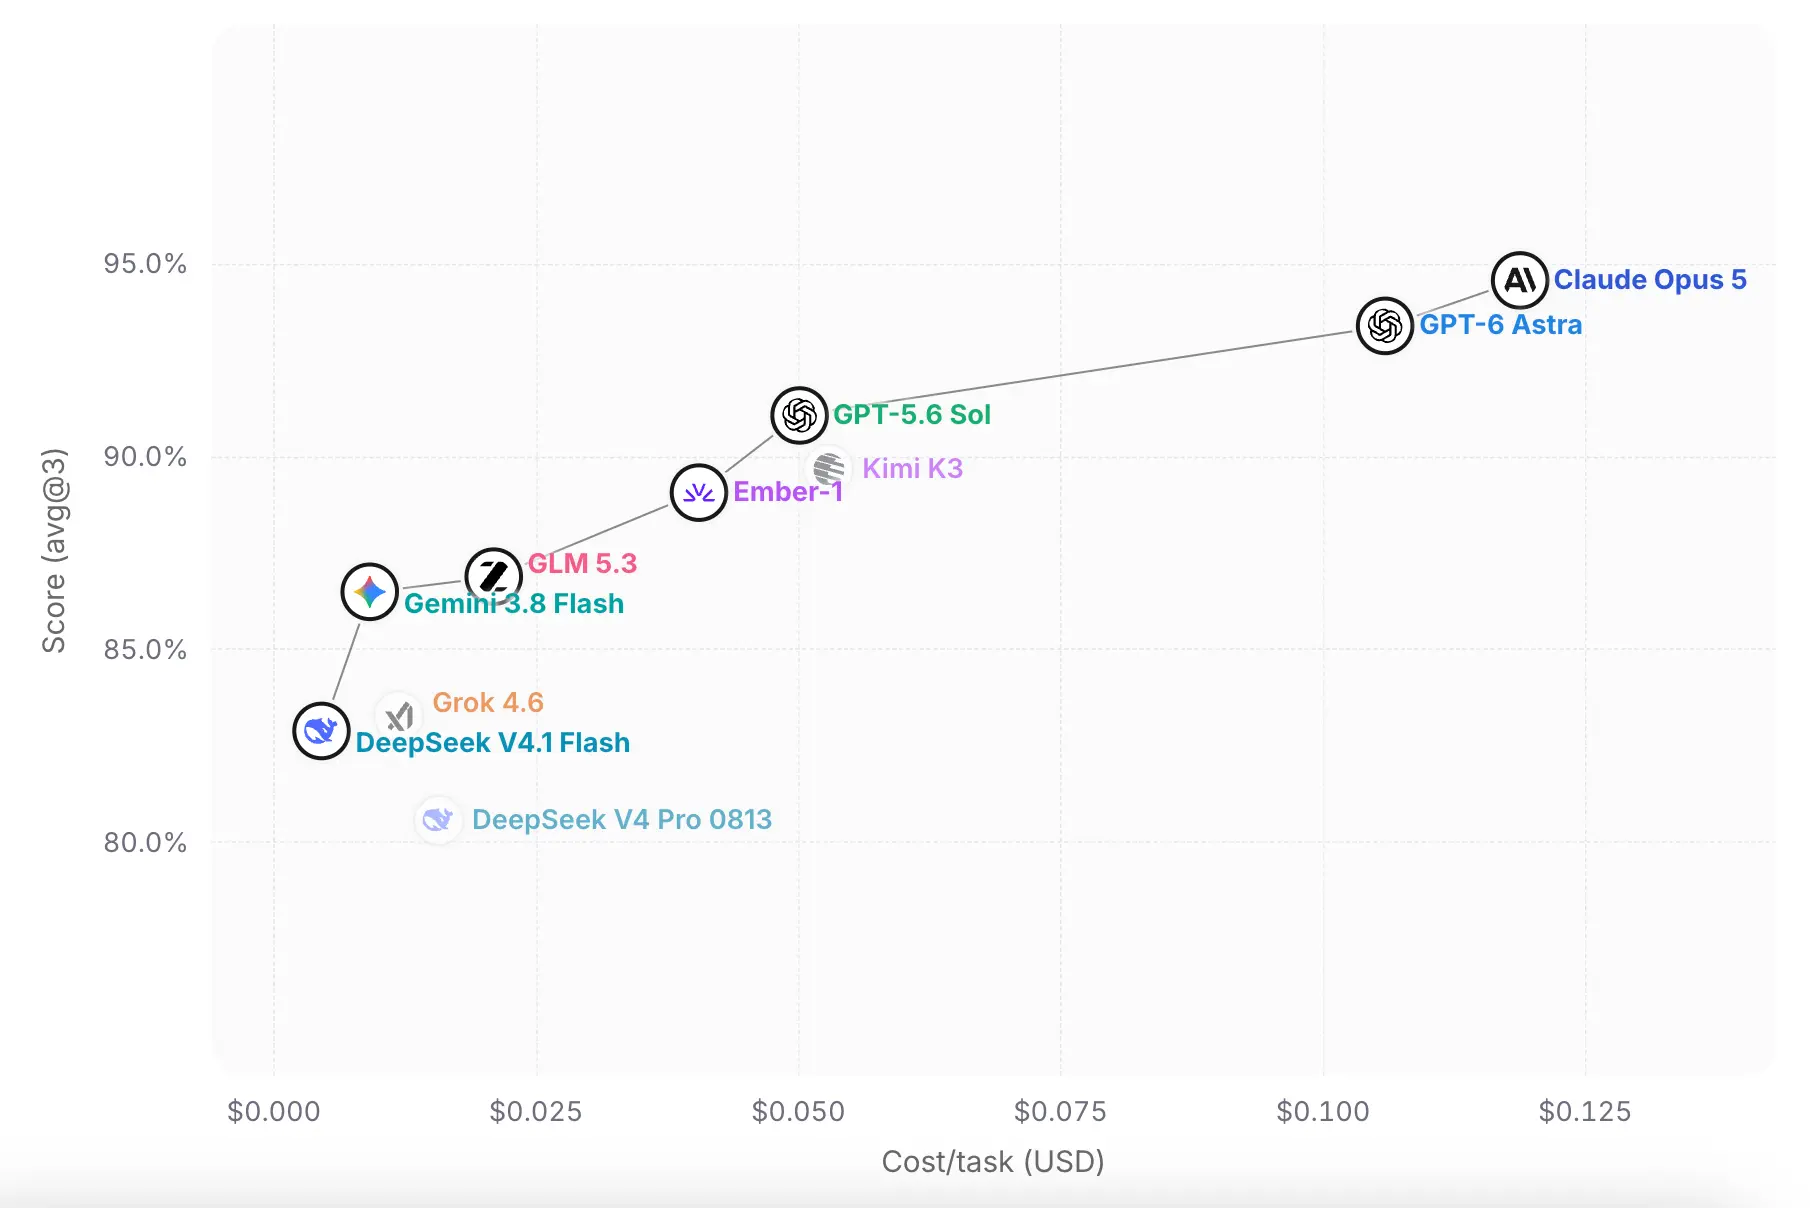
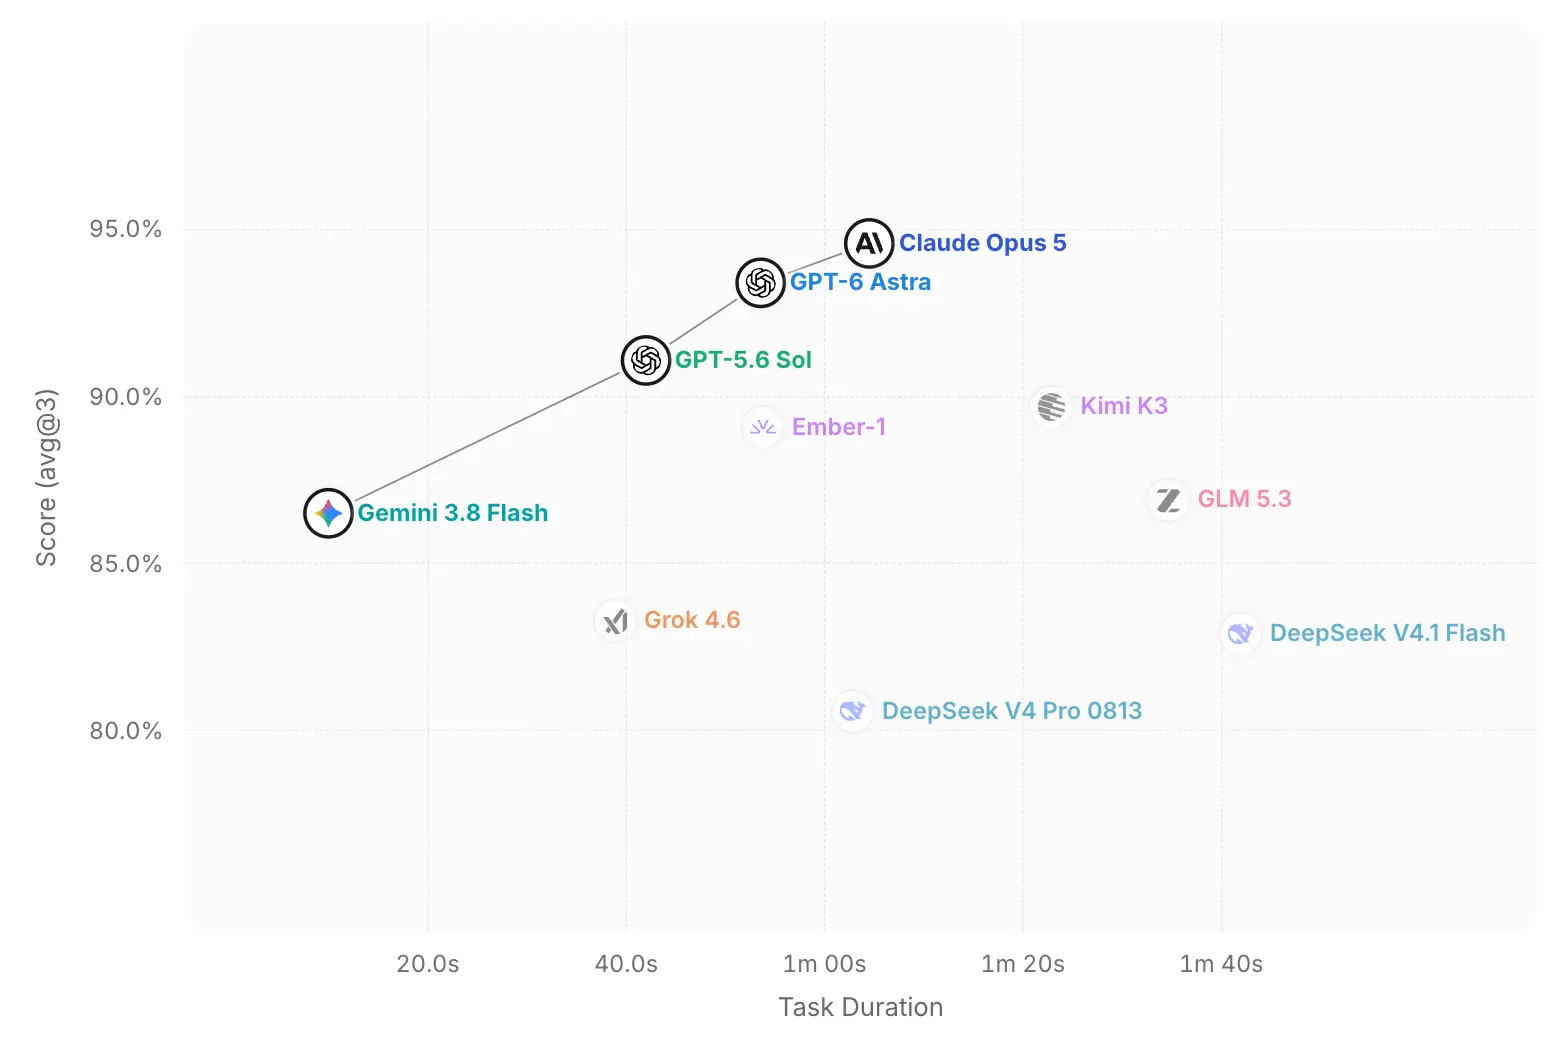
Specialized Intelligence Index: Ember-1 устанавливает границу Парето для Bedside Bench
На этой неделе была представлена Specialized Intelligence Index (SII) для оценки открытых, закрытых и специализированных моделей на реальных задачах, созданных экспертами отрасли.
Ember-1 была оценена на Bedside Bench от Doximity — врачами проверенном бенчмарке, охватывающем 500 клинических случаев в 10 специализированных категориях.
Результат? Ember-1 установила новую границу Парето для Bedside Bench среди открытых и закрытых моделей, включая GPT-5.6 Sol, GPT-6 Astra и Claude Opus 5 по параметру стоимость/задача.
Оценка Парето на дополнительных промышленных бенчмарках
Ember-1 также оценили на границе качество-vs-стоимость на других промышленных бенчмарках. Стоимость для каждого бенчмарка рассчитана с использованием открытого API прайсинга Kimi K3 (несохранённый ввод $3/M токенов, сохранённый ввод $0.30/M, вывод $15/M) и нанесена на график в сравнении с процентом успеха для трёх вариантов: K3 на низком уровне рассуждений, K3 на высоком уровне рассуждений, K3 на максимальном уровне рассуждений (по умолчанию) и Ember-1. На каждом бенчмарке с более чем 50 тестовыми примерами Ember-1 находится на границе Парето или рядом с ней, соответствуя качеству K3-max при дроби стоимости и строго доминируя K3-low. Также проанализирована GPT-6 Astra, Claude Opus-5 и GLM 5.3, и выявлено, что Ember-1 является лидером на границе Парето.
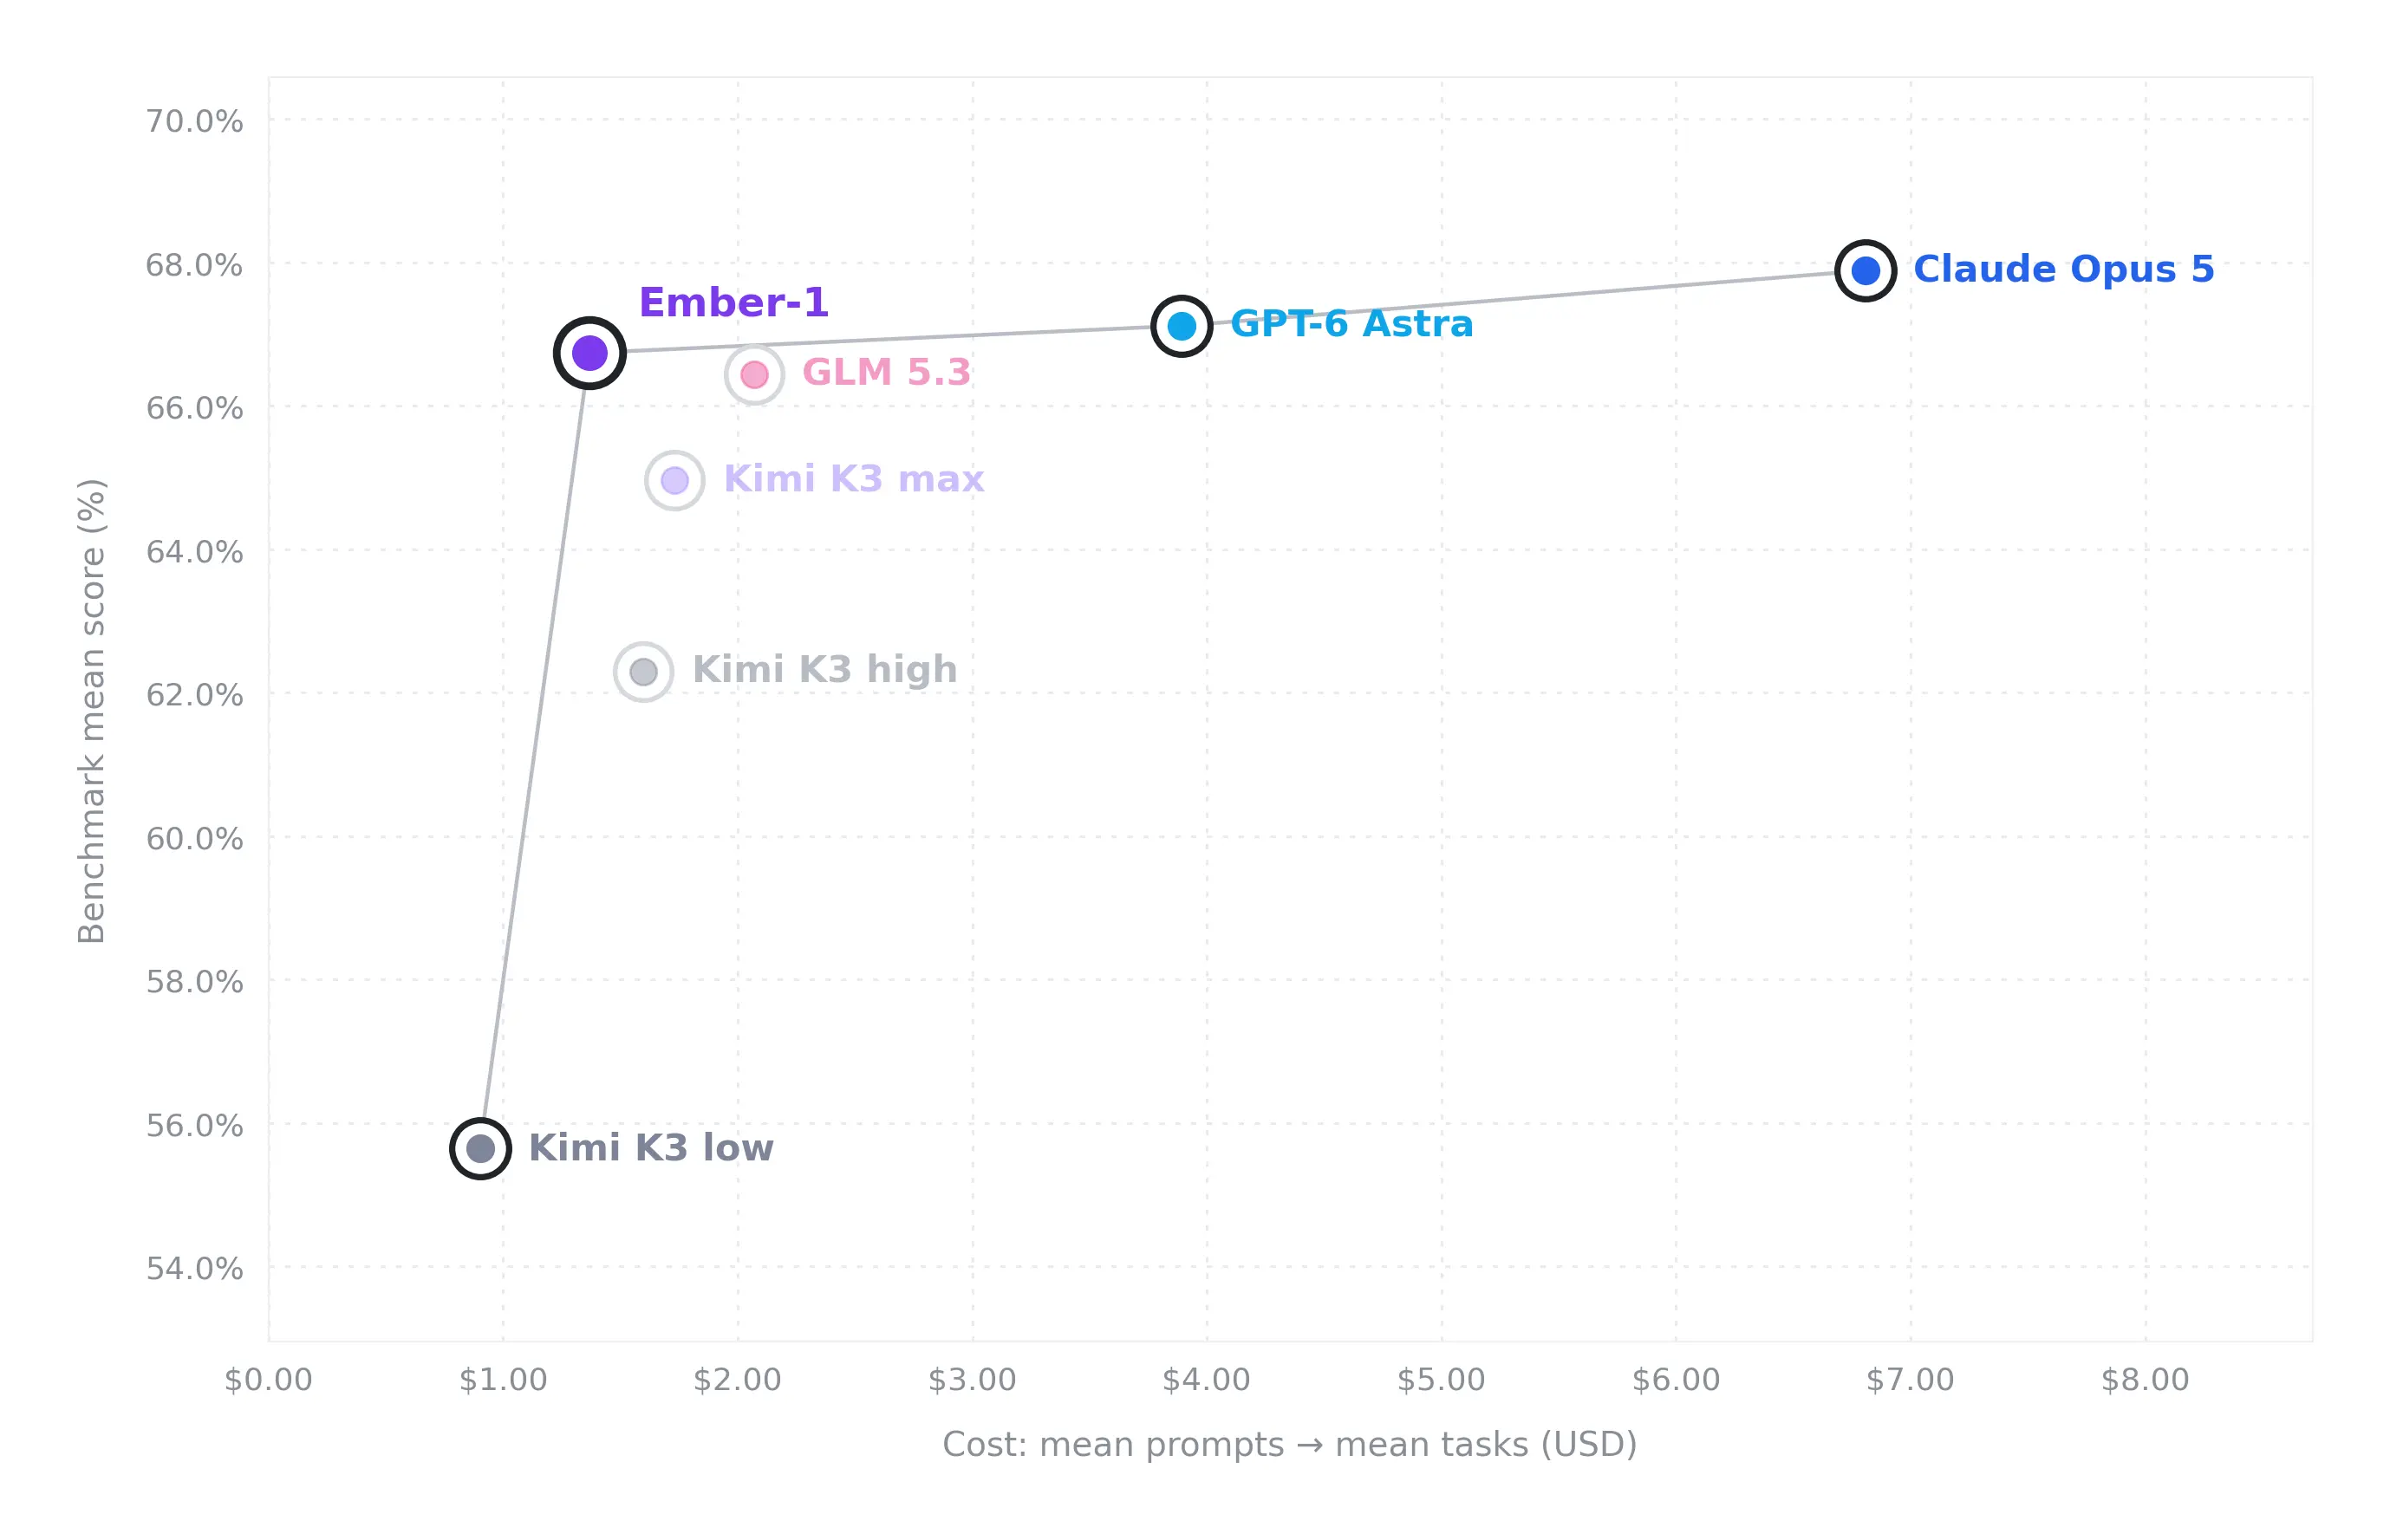
Детальнее рассмотрели результаты прямого сравнения Ember-1 с оригинальной K3:
| N | K3 Low | K3 High | K3 max | Ember-1 | Ember-1 vs. K3 Max | |
|---|---|---|---|---|---|---|
| Terminal Bench 2.1 | 89 |
76.4% |
77.6% |
80.9% |
82.0% |
-51.9% / -23.1 USD |
| SWE-bench Verified | 500 |
80.4% |
86.0% |
93.2% |
92.2% |
-15.5% / -68.1 USD |
| SWE-Interact | 75 |
6.7% |
13.3% |
21.3% |
20.0% |
-32.5% / -60.8 USD |
| DeepSWE 1.1 | 113 |
55.8% |
62.8% |
66.4% |
75.2% |
-23.7% / -126.9 USD |
| τ-2 Bench Airline | 50 |
64% |
64% |
64% |
66% |
-5.9% / -0.3 USD |
Наиболее экономичный способ запуска K3 теперь — не думать меньше, а запустить Ember-1, модель, которая научилась думать эффективно.
Валидация клиентов: живые A/B тесты
Бенчмарки рассказывают далеко не всё. Как и в результатах Specialized Intelligence Index, хотелось протестировать модель на более реальных workload'ах и production трафике. Настоящий тест часто — удержится ли модель на production трафике, в продуктах, на которые полагаются пользователи.
Провели живые A/B тесты с двумя клиентами на их production кодировочных workload'ах. В обоих случаях Ember-1 показала впечатляющую экономию токенов, примерно на 35% меньше токенов за задачу при сопоставимом качестве. Большинство метрик downstream продуктов сохранились или улучшились, включая завершённость задачи, оценки успеха и уровни отказов, всё движется в правильном направлении при существенно меньшей стоимости токенов. После A/B тестов один клиент уже запустил Ember-1 в live production с планами масштабировать её до полной замены базовой модели.
| Показатель | Шаги | Вывод токенов | Сокращение reasoning токенов | Общее сокращение токенов | |
|---|---|---|---|---|---|
| Kimi K3 | 0.751 |
23.8 |
49.3K |
- |
- |
| Ember-1 | 0.753 |
21.4 |
29.9K |
71.3% |
39% |
Внутренняя валидация: собственные разработчики не заметили
Большая часть внутреннего трафика кодирования/совместной работы Fireworks использует собственный inference сервис. До того как модель увидел кто-то из клиентов, Ember-1 запустили внутри и позволили собственным разработчикам использовать её для повседневной кодировочной работы, включая vibe тестирование в масштабе на реальных задачах.
Результат, которым больше всего гордятся: никаких новостей. Отсутствие новостей — хороший знак. Разработчики продолжали свои кодировочные workload'ы, даже не заметив переключение, при этом потребляя существенно меньше токенов. Для модели, чей весь value proposition — «те же ответы, но меньше токенов», невидимый rollout на внутреннем трафике — сильнейший возможный сигнал.
Что дальше
Ember-1 разворачивается как вариант serving наряду с базовой моделью Kimi K3 как preview release для исследования на Serverless. Чтобы поддерживать быстро растущую экосистему open-source, запускаются research releases, дающие разработчикам двухнедельный серверless доступ к новым research моделям, становящимся постоянными на основе спроса сообщества. Для агентского кодирования и других workload'ов, где reasoning токены составляют большую часть стоимости, доставляет такое же качество примерно при половине стоимости токенов.
Fireworks Research продолжит расширять границы эффективности моделей, внося специализированный интеллект в дополнительные Ember модели, позволяя развёртывать наиболее экономичные модели и снижать расход токенов. Эффективность токенов становится темой Fireworks.
Чтобы пойти с Ember-1 ещё дальше и оптимизировать для своего use case, также запускается поддержка обучения для Ember-1, позволяющая предприятиям создавать кастомизированные, токен-эффективные модели, адаптированные к их нуждам со своими данными. Будущее открытых моделей — специализированные модели, обученные на вашем конкретном workload'е.
Пробуешь Ember-1 на своих workload'ах? Очень хочется услышать о твоём опыте, отметь нас в X (@FireworksAI_HQ) и поделись тем, что ты создаёшь!