EmbeddingGemma 2: открытая легковесная мультимодальная модель встраивания
EmbeddingGemma впервые представили в прошлом году как легковесный вариант для высококачественного встраивания текста, помогающий приложениям организовывать, искать и связывать информацию прямо на потребительском оборудовании. Ответ разработчиков превзошёл все ожидания: более 20 млн загрузок, и создатели использовали его для работы более умных локальных поисковых инструментов и приватных конвейеров retrieval augmented generation (RAG).
Сегодня запускается EmbeddingGemma 2, расширяющая возможности за рамки текста — объединяя код, изображения, видео и аудио в единое пространство встраивания. Построенная на архитектуре Gemma 4 и выпущенная под коммерчески свободной лицензией Apache 2.0, EmbeddingGemma 2 имеет 740 млн параметров, что делает её оптимальной для локального вывода. Она может найти конкретный видеофрагмент из голосовой заметки или искать в часах аудиозаписей по текстовому запросу — всё обрабатывается одной нативно мультимодальной моделью.
Лучшая производительность в своем классе для кода, видения и аудио
Построенная на той же технологии, что и модели Gemini Embedding, EmbeddingGemma 2 предлагает:
- Лидирующие результаты для своего размера: Показывает ведущие баллы среди мультимодальных встраивателей менее 1B параметров по бенчмаркам MTEB (Massive Text Embedding Benchmark) Code и MAEB (Massive Audio Embedding Benchmark), при этом сравнивается или превосходит множество более крупных моделей по текстовым, визуальным и аудиозадачам.
- Модульная архитектура: Требует всего 270M параметров для работы только с текстом, с опциональными энкодерами видения (170M) и аудио (300M) для полной мультимодальной поддержки.
- Эффективна по памяти: Использует Matryoshka Representation Learning (MRL), позволяя разработчикам динамически обрезать векторы выхода с 768 до 512, 256 или 128 размерностей. Это обеспечивает вплоть до 6x сокращение хранилища для локальных векторных БД и использования памяти.
- Оптимизирована для локального выполнения: Работает эффективно в жёстких условиях ресурсов. С квантизацией на Google Pixel 11 Pro EmbeddingGemma 2 требует всего ~191MB активной оперативной памяти для весов только текста и ~567MB для полной мультимодальной модели.
- Готова к расширенному контексту: Имеет окно контекста 8K токенов (в 4 раза больше, чем EmbeddingGemma 1), позволяя обрабатывать до 5.5 минут аудио, 29 изображений, 58 видеокадров или их чередующихся комбинаций прямо на локальном оборудовании.
EmbeddingGemma 2 сохраняет сильную многоязычную текстовую производительность EmbeddingGemma, одновременно обеспечивая значительное улучшение на 9.92 пункта по производительности кода (в MTEB Code, с 68.76 до 78.68), что делает её хорошо подходящей для локального индексирования кодовой базы, семантического поиска кода и поиска при работе кодирующих агентов. По изображениям, видео, документам и аудио она устанавливает новый стандарт качества-на-параметр для моделей менее 1B и даже превосходит некоторые специализированные модели, в два раза превышающие её размер.
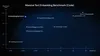
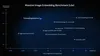
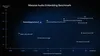
Полные метрики оценки и информацию о модели найдёте в карточке модели EmbeddingGemma 2.
Семантический поиск, маршрутизация и поиск информации — полностью на устройстве
EmbeddingGemma 2 привносит мощные возможности прямо в граничное оборудование. Генерирование встраиваний локально помогает обеспечить приватность данных, снижает задержку конвейера и позволяет разработчикам создавать кросс-модальный поиск и поиск информации, работающие полностью офлайн.
В сочетании с генеративными моделями, такими как Gemma 4, EmbeddingGemma 2 позволяет использовать локальные RAG-конвейеры, понимающие сложные мультимодальные данные. Поскольку EmbeddingGemma 2 построена на Gemma 4 и использует её текстовый токенизатор и аудиоэнкодер, разработчики могут запускать обе модели вместе в едином конвейере с уменьшенным общим объёмом используемой памяти.
Используйте текст или изображение для поиска лучших совпадений в вашей медиатеке на основе семантического сходства. Попробуйте в Google AI Edge Gallery — Instant Media Search.
Находите конкретные моменты в видео, используя текстовые или аудиозапросы. Попробуйте в Google AI Edge Gallery — Video Moments Finder.
Сочетайте EmbeddingGemma 2 для локального поиска файлов с Gemma 4 для контекстного рассуждения. Попробуйте в приложении Google AI Edge Foresight.
Создавайте механизмы принятия решений в реальном времени, используя мультимодальный контекст для классификации, маршрутизации и предсказательных возможностей через MediaPipe Decision Task API.
Чтобы узнать, как создавать системы локального поиска и RAG с помощью LiteRT, прочитайте пост в блоге Google AI Edge.
Начните работу с EmbeddingGemma 2
Мы тесно сотрудничали со следующими партнёрами, чтобы обеспечить немедленную работу EmbeddingGemma 2 там, где вы разрабатываете:
- Загрузите модели: Найдите веса моделей на Hugging Face и Kaggle, а доступность на Gemini Enterprise Agent Platform Model Garden скоро появится. Посетите LiteRT Community на Hugging Face для моделей, оптимизированных для локального использования.
- Развёртывание на устройстве: Разрабатывайте кросс-платформенные приложения с помощью Google AI Edge MediaPipe для готовых к использованию встраивания, поиска и задач принятия решений или LiteRT для пользовательской интеграции моделей. Разрабатывайте для браузера с transformers.js или WebGPU.
- Используйте свои любимые инструменты разработки: Развёртывайте модель эффективно с помощью transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama и LMStudio. Сохраняйте ваши векторы встраивания с помощью Qdrant.
- Дообучение: Следуйте руководству от Unsloth по дообучению EmbeddingGemma 2 для ваших случаев использования.
Исследуйте наше руководство для разработчиков, документацию и руководства по выводу и дообучению.