Аннотация
- Представлен первый метод нулевого порядка, конкурентоспособный с backprop при предварительном обучении трансформеров языковых моделей. Dust возмущает активации (возмущение узлов) независимо на каждом токене, так что каждый токен — это виртуальный член популяции, и один прямой проход оценивает их все параллельно.
- Dust хорошо аппроксимирует backprop при большой популяции (т. е. при существенно большем объёме вычислений) и в некоторых сценариях даже превосходит его. Это намекает на то, что в режиме избытка вычислений можно обойти ограничения backprop.
- Dust на несколько порядков эффективнее методов поиска в пространстве весов. Начиная с 1M токенов, Dust примерно в $10^3$–$10^4$ раз эффективнее реализации EGGROLL на трансформерах — современного метода эволюционных стратегий.
- Общепринято считается, что методы нулевого порядка не масштабируются на большие сети. Однако выяснилось, что большие модели эффективнее по популяции, а не менее: модель с 243M параметров превосходит модель в 120 раз меньше при большинстве размеров популяции.
- Градиентные оценки Dust лучше выравниваются с gradients backprop по мере роста популяции и остаются хорошо выравнены на всех масштабах, вплоть до 1B токенов, что обнадёживает для масштабирования.
Введение
Глубокое обучение было построено вокруг backprop — единственного известного алгоритма приписания ответственности, способного обучать современные нейронные сети, включая языковые модели на базе трансформеров. Backprop требует дифференцируемости и вычисляет градиенты первого порядка, и архитектуры, оптимизаторы и аппаратное обеспечение для глубокого обучения эволюционировали вокруг этого ограничения.
Однако по мере увеличения объёма доступных вычислений может быть предпочтительнее использовать более универсальные и грубые алгоритмы обучения, основанные на поиске, вместо индуктивных смещений вроде дифференцируемости и backprop. Горькое правило показывает, что универсальные методы, масштабирующиеся с вычислениями, в конечном счёте побеждают, а AlphaGo Zero — очевидный пример. Загрузка AlphaGo данными человека помогла сети обучаться быстрее на начальном этапе, но при большом объёме вычислений чисто self-play сеть её обогнала. Аналогично дифференцируемость и backprop могут быть хорошими индуктивными смещениями в режиме малых вычислений, где они делают обучение эффективным, но в режиме больших вычислений они ограничивают пространство работающих архитектур. Даже в пределах одной архитектуры методы на основе градиентов не исследуют ландшафт ошибок оптимально. Это может объяснить, почему современные нейронные сети требуют массивных объёмов данных для обобщения. Более гибкий алгоритм приписания ответственности, основанный на поиске, вероятно, важный шаг к намного лучшему обобщению.
В этой работе авторы ставят цель заменить backprop алгоритмом обучения, основанным гораздо больше на грубых вычислениях и гораздо меньше на аналитической структуре. Они называют его Dust. Это алгоритм оптимизации нулевого порядка, который возмущает активации, награждает каждое возмущение снижением ошибки и усредняет награжденные возмущения по популяции для оценки градиента. Традиционные методы эволюционных стратегий, возмущающие веса, такие как EGGROLL, масштабируются с размером популяции, но масштабирование дорого, потому что каждый член должен быть материализован и оценен. Dust убирает оба эти расходы, используя концепцию виртуальной популяции: членов не материализируют, избегая пространства весов, вместо этого возмущают активации, как в возмущении узлов. Это делается независимо на каждом токене, так что каждый токен — это член, и один прямой проход оценивает их все параллельно.
Активации — это более интересное пространство для поиска, чем веса. Механистическая интерпретируемость показала, что рассуждение, вербализуемое или нет, живёт в активациях, что означает, что этот подход может превратить обучение в поиск в скрытом рассуждении. Затем метод сочетает возмущение активаций с очень универсальным правилом приписания ответственности, которое присваивает разные токен-уровневые награды разным типам слоёв в блоке трансформера. Эти два смещения, наряду с несколькими деталями реализации и мерами эффективности, такими как избежание помех между возмущёнными модулями, составляют весь алгоритм.
Основные вклады:
- Представлен первый метод нулевого порядка, конкурентоспособный с backprop при предварительном обучении трансформеров. При больших популяциях Dust превосходит backprop в нескольких сценариях, что предполагает, что в режиме избытка вычислений можно превзойти backprop.
- Dust на несколько порядков эффективнее ES в пространстве весов. Начиная с 1M токенов, он примерно в $10^3$–$10^4$ раз эффективнее реализации EGGROLL на трансформерах на основе экстраполяций.
- Вопреки общепринятому мнению, большие модели часто эффективнее по популяции, а не менее, и могут использовать большие популяции. Это даёт новый взгляд на переполнение параметров как на большее пространство поиска с потенциально лучшей геометрией.
- Градиентные оценки Dust лучше выравниваются с backprop по мере роста популяции, и это выравнивание сохраняется на всех масштабах, вплоть до 1B токенов, что обнадёживает для масштабирования.
Цель этой работы — заложить основы алгоритма приписания ответственности на основе поиска, конкурентоспособного с backprop на самой сложной задаче, которую удалось придумать: предварительное обучение трансформеров. Авторы не пытаются сделать его достаточно вычислительно эффективным для замены backprop сегодня. Они также не обучают новые типы нейронных сетей, которые это делает доступными, такие как сети с внешней программой в цикле или трансформеры в цикле на много шагов, которые backpropagation through time с трудом обучает. Оба остаются на будущее.
Метод
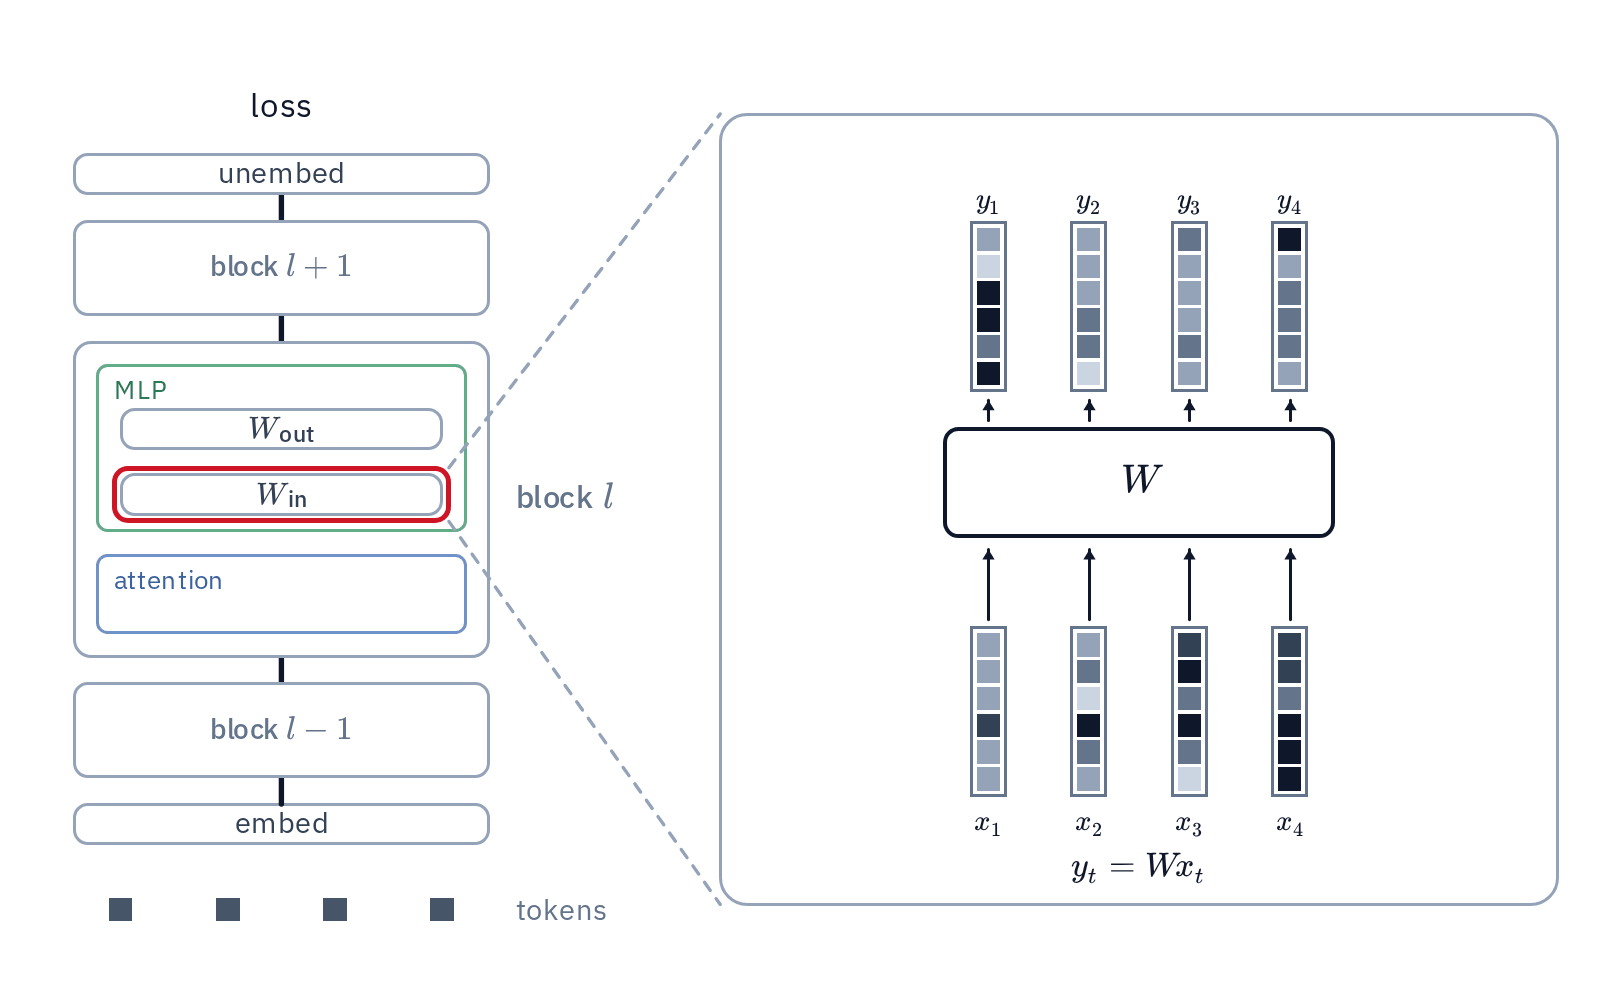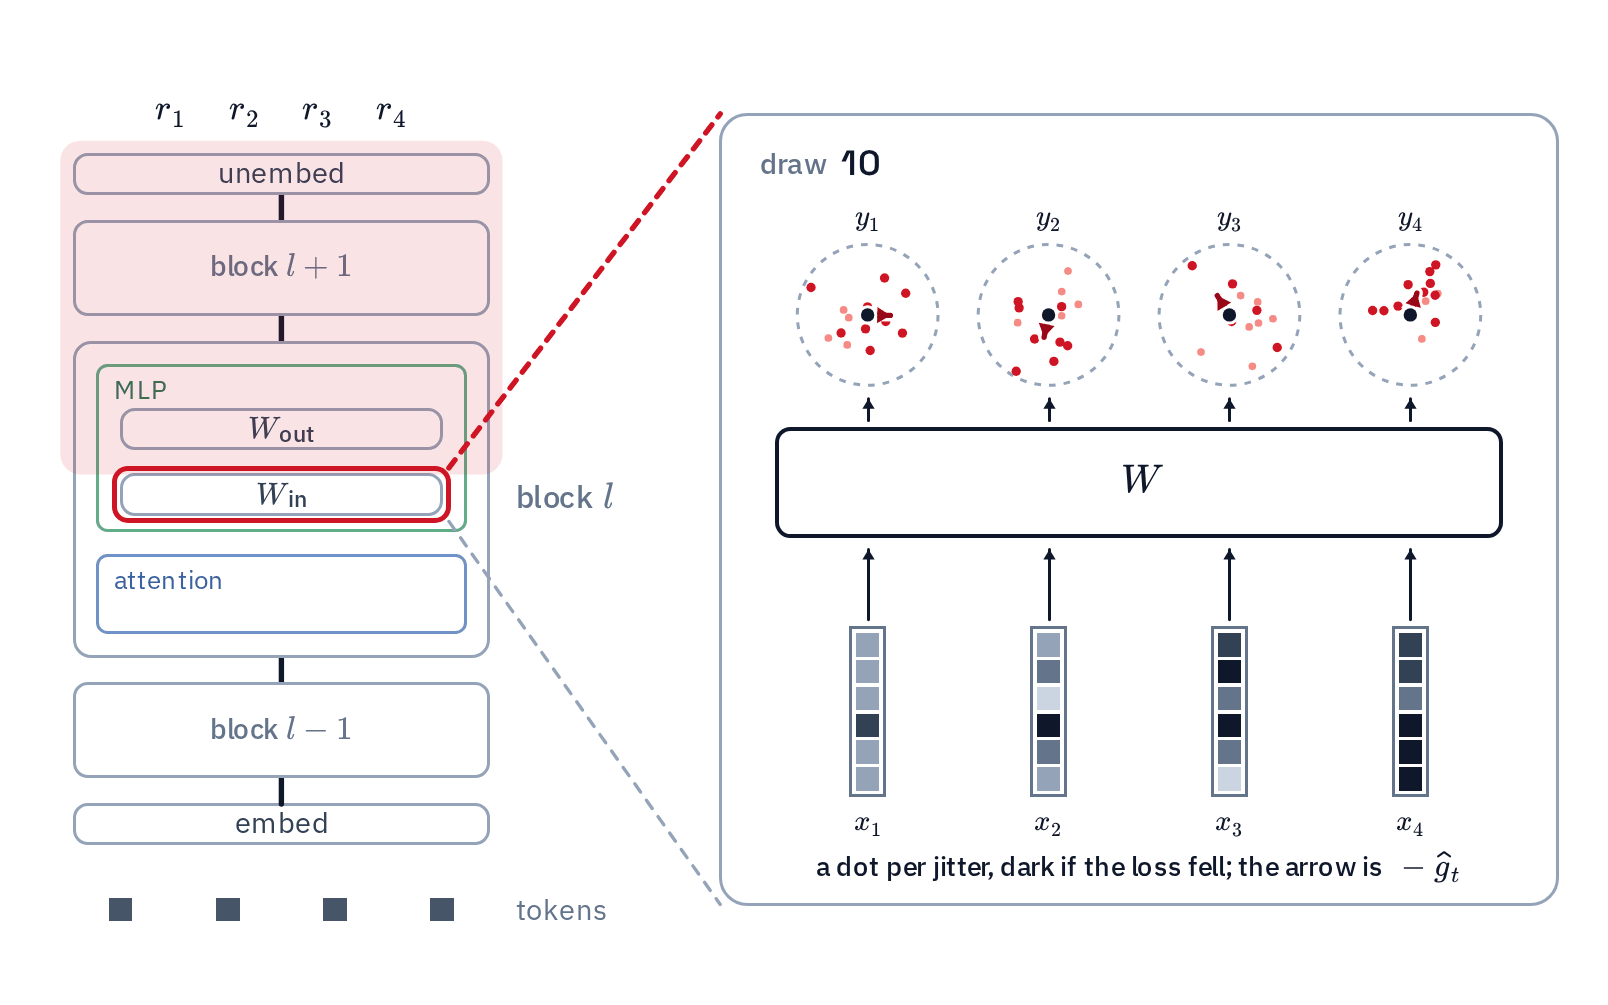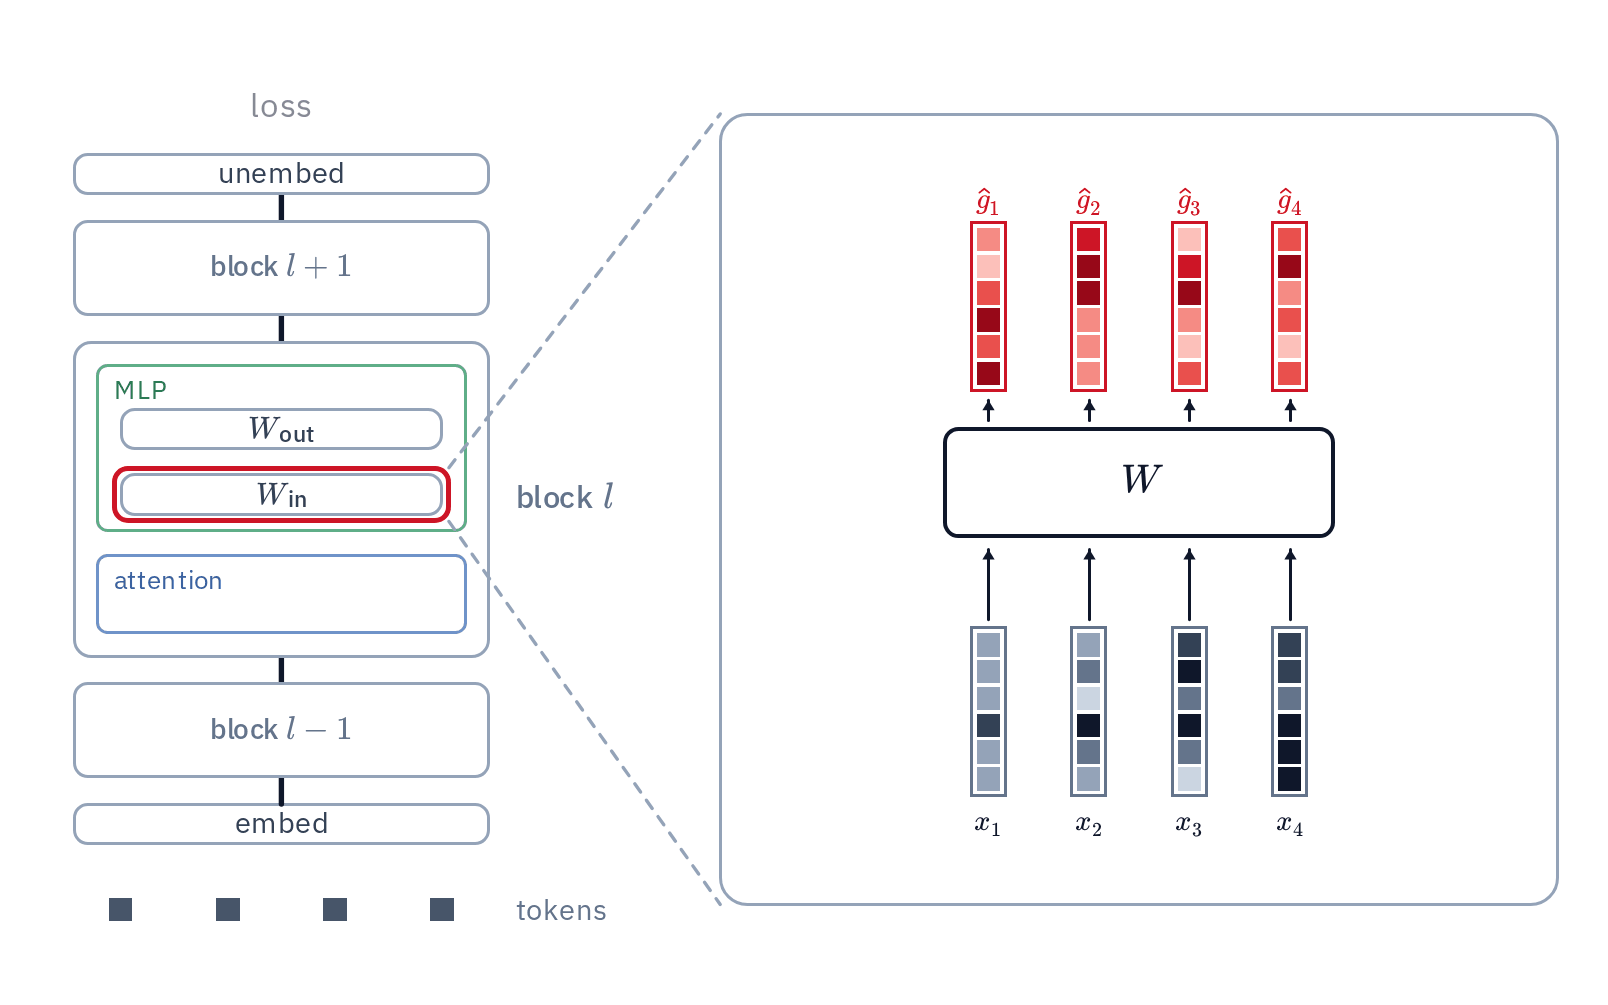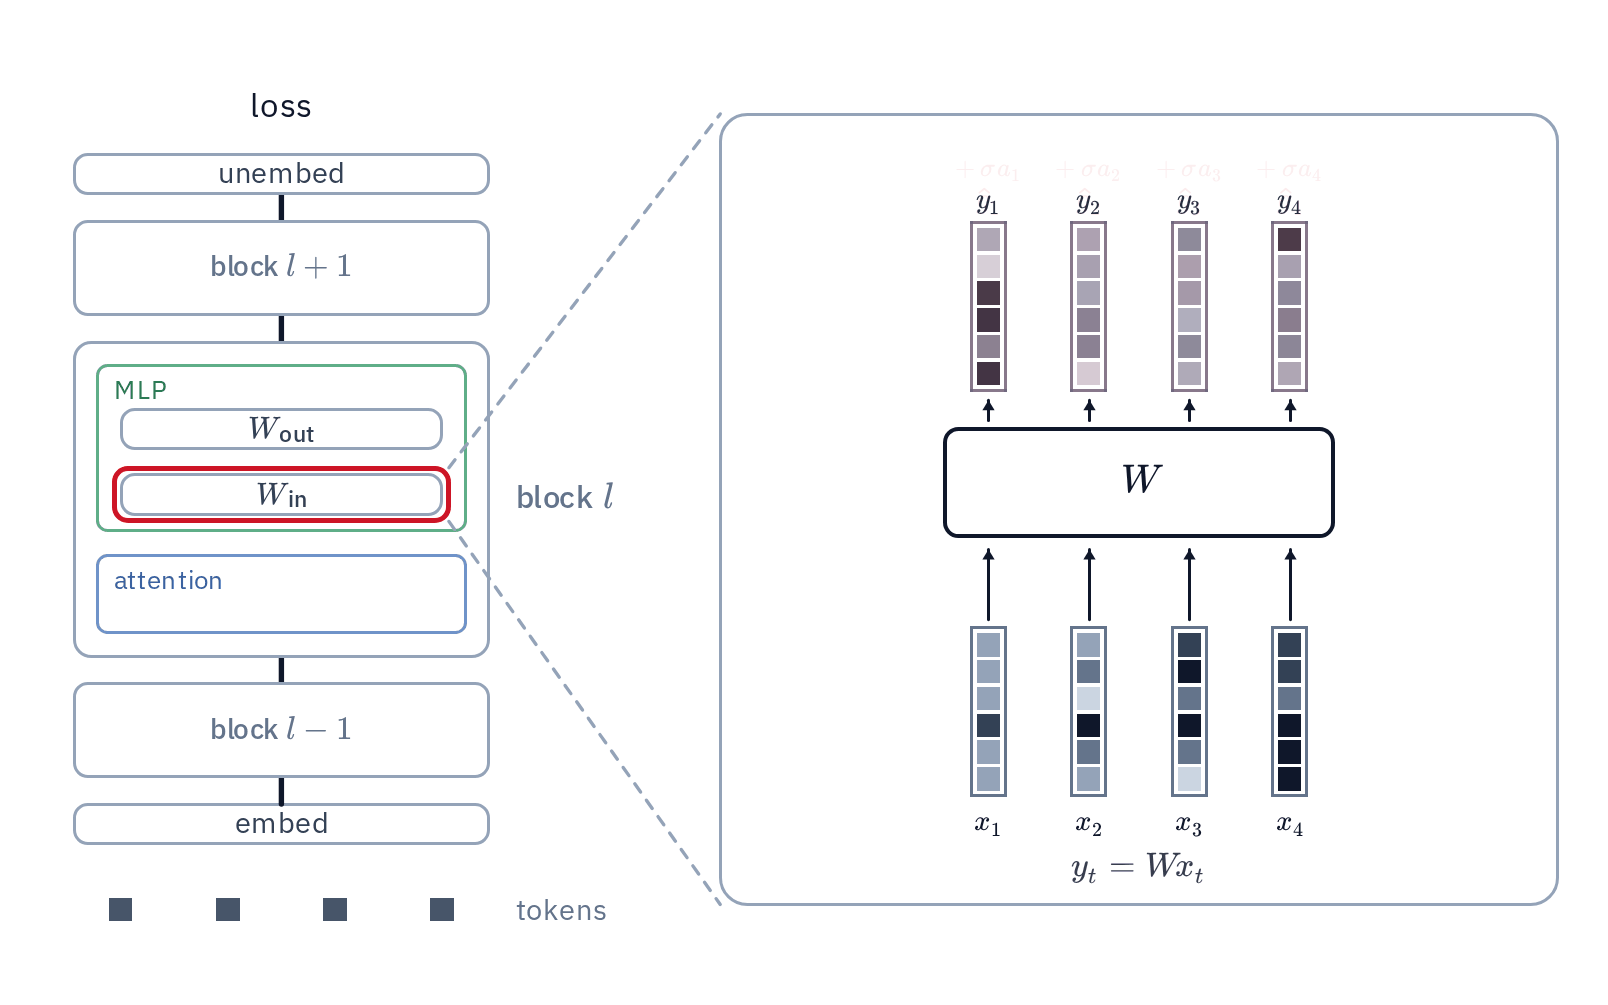
Dust работает следующим образом: добавляют гауссов шум на выход каждого линейного слоя, независимо на каждом токене, запускают прямой проход и награждают каждый шум токена на основе изменения ошибки в этом токене. Усредненный по draws награжденный шум — это оценённая ошибка на выходе слоя, а его внешнее произведение со входом слоя — градиент веса. Внутренние части attention получают вариант: они кредитуются через оценённую ошибку на выходе attention через текущие и будущие токены, вместо напрямую потерь токенов. Ключевая интуиция: в то время как ES в пространстве весов оценивает одного члена популяции за прямой проход, здесь оценивают одного за токен, параллельно, и член материализуется добавлением шума в скрытое состояние, что дёшево. На современном трансформере один прямой проход поэтому оценивает популяцию по крайней мере на три порядка величины больше, чем ES в пространстве весов. Ниже описаны детали каждого компонента.
Возмущение в пространстве активаций
Узкое место эволюционных стратегий — размер популяции. Каждый член требует своего возмущённого копии весов и своего прямого прохода. EGGROLL делает копии дешёвыми с помощью низкоранговых возмущений, но каждый член — это всё ещё один элемент последовательности в батче, поэтому популяция ограничена количеством прямых проходов, которые можно себе позволить. Dust возмущает активации вместо этого, независимо на каждом токене. На этом токене сеть ведёт себя так, как если бы низкоранговое возмущение было применено к весам слоя, производящего активации, без того чтобы возмущение когда-либо материализовалось в весах. Это называется виртуальной популяцией. Последовательность в трансформере имеет несколько тысяч токенов, поэтому один прямой проход оценивает несколько тысяч членов на последовательность вместо одного. Каждый вес в модели обучается этим способом кроме $2L$ скаляров остаточного смешивания, которые обучаются обычным ES в пространстве весов.
Добавление шума к активациям вместо весов — это возмущение узлов, и обычный аргумент для этого — размерность. Выход слоя имеет $d_{\mathrm{out}}$ записей, а его веса имеют $d_{\mathrm{out}} \times d_{\mathrm{in}}$, поэтому шум активации живёт в намного меньшем пространстве. Наивно, аргумент размерности не держится для трансформеров с большими активациями через много токенов. Шум на одной последовательности — это тензор $T \times d_{\mathrm{out}}$, который имеет по крайней мере столько же записей, что и матрица весов, как только $T \ge d_{\mathrm{in}}$. Однако с независимыми по-токеновыми возмущениями и наградами, то, что даёт возмущение активаций — это новая эффективная популяция вдоль оси токена, которая ортогональна оси батча, на которую уже полагается EGGROLL.
Приписание ответственности
Для линейного слоя $y_t = W x_t$ возмущают его выход на всех токенах, $y_t \to y_t + \sigma a_t$ с $a_t \sim \mathcal{N}(0, I)$ и $\sigma$ масштаб шума, и запускают прямой проход. На каждом токене $s$ вычисляют центрированное снижение ошибки $c_s = \tilde{\ell}_s - \ell_s$, где $\ell_s$ — возмущённая ошибка, а $\tilde{\ell}_s$ — средняя возмущённая ошибка на этом токене через draws, оценённые вместе в одном батчированном прямом проходе. Награда за возмущение на токене $t$ — это снижение ошибки в $t$ и, с decay $\gamma$, снижения ошибки на токенах после, которые возмущение также достигает через attention:
$$r_t = \sum_{s \ge t} \gamma^{\,s-t} c_s$$
При $\gamma = 0$ возмущение награждается только собственным токеном. Оставляют в настройке раздела ниже решение, какие слои видят будущие токены. Одно независимое возмущение всех токенов — это draw, а популяция — это $K$ draws. Усреднённый по draws награжденный шум
$$\hat g_t = -\frac{1}{K\sigma}\sum_{i=1}^{K} r_t^{(i)} a_t^{(i)}$$
— это оценённая ошибка на выходе слоя, и его внешнее произведение со входом слоя, который прямой проход уже вычислил, суммированное по токенам, — это градиент веса:
$$\widehat{G}_W = \sum_t \hat g_t\, x_t^\top$$
Backprop образует то же внешнее произведение с тем же входом. Единственная разница — что backprop получает ошибку на выходе из цепного правила, а Dust получает её из популяции. Для слоя embedding $x_t$ — это one-hot, поэтому внешнее произведение — это scatter-add $\hat g_t$ в строку токена.
При неограниченной популяции оценка выше — это весь метод, и каждое возмущение может войти в один прямой проход. Награжденный шум каждого draw — это градиент плюс ошибка без предпочтительного направления. Через draws градиент складывается линейно, а ошибки складываются как квадратный корень, поэтому их отношение падает по мере роста популяции и помехи исчезают в пределе.
Помехи и настройка
При доступной популяции основная стоимость — помехи: возмущают много слоёв на много токенов в одном прямом проходе, поэтому изменение ошибки, награждающее возмущение одного токена, также подхватывает эффект каждого другого возмущения в этом проходе. Помехи уменьшают тремя способами. Во-первых, разные типы слоёв возмущают в отдельных прямых проходах, каждый с собственным масштабом шума, и каждый блок получает свои проходы. Эти проходы дешевле полных, потому что чистый прямой проход кеширован, и draw для блока $l$ только перезапускает блоки от $l$ дальше. Во-вторых, внутренности attention (query, key, value, gate, value embedding) возмущают отдельно. Потери токенов едва регистрируют их возмущения, поэтому они награждаются через выход attention вместо этого, как описано ниже. В-третьих, заголовок языкового моделирования возмущают прямо на кешированных logits, переоценивая только cross-entropy и только часть словаря на draw, что стоит малую часть прямого прохода и позволяет заголовку запускать намного большую популяцию.
Для внутренностей attention переоценивают только выход attention их блока с возмущением, из кешированных чистых активаций. Оценивают возмущения, используя выравнивание с оценённымиattention output gradients:
$$c_s = -\langle \hat g_s, \Delta o_s \rangle$$
где $\Delta o_s$ — изменение, которое возмущение производит в выходе attention на токене $s$, а $\hat g_s$ — оценённая ошибка этого выхода. Награда — это уравнение выше с этими оценками, вычисленная на head, вместо снижений ошибок.
Гиперпараметры — масштаб шума каждого типа слоя, decay кредита внутренностей attention и доля популяции каждого слоя — могут быть настроены двумя способами. Один — это grid search, который обучает с каждой настройкой на малый бюджет токенов и держит настройку, которая понижает ошибку больше всего. Это надёжно, но дорого. Другой — это grid search, который максимизирует косинус между оценкой и градиентом backprop на одном батче, что не требует обучения вообще. Больший косинус на одном батче не всегда понижает ошибку после обучения, поэтому косинус выбирает кандидатов, а обучение решает. В любом случае настройка — в основном одноразовая стоимость, так как найденные ею настройки в основном обобщаются через бюджеты токенов и размеры популяции, с одним исключением. При наибольшей популяции на 10M и 20M токенов, более медленный decay кредита и сдвиг draws в сторону attention всё ещё помогают. Следовательно, этот поиск восстанавливает общие принципы метода, а не настройки для одного прохода. Как ожидается, все слои не требуют кредитов из будущих токенов кроме keys, values, gates и value embeddings, которые читаются поздними токенами, которые к ним обращаются, и получают $\gamma$ близко к одному.
Предварительное обучение без обратного прохода
Настройка
Обучают трансформеры в стиле GPT на FineWeb с tokenizer BPE 4096-токена, батчем 16k токенов (8 последовательностей 2048 токенов), один epoch, и SGD с momentum при постоянной learning rate. Базовая модель имеет 8 слоёв и width 512. Каждый метод получает один протокол и три seed за ячейку, и настраивается отдельно на каждый бюджет токенов и популяцию. Dust и backprop разделяют один momentum и learning-rate grid; EGGROLL реализуют с той же архитектурой трансформера (названной EGGROLL-Transformer) и он настраивается над собственным grid шага, momentum, масштаба шума и формирования fitness. Валидация и тест — held-out наборы 544 последовательностей каждый. Отчитывают test loss в best validation checkpoint.
Популяцию считают в draws для Dust и в прямых проходах батча для EGGROLL. Draw — это одно возмущение активаций через все токены выбранных слоёв, вознаграждённое потерями токенов, и популяция $K$ — это количество draws на update. Draw немного дешевле, чем прямой проход, потому что чистый прямой проход кеширован, и draw, который возмущает блок $l$, перезапускает только блоки от $l$ дальше. $K$ оставляет draws заголовка и внутренностей attention, которые — малая часть FLOPs update. Вместе, из популяции 256 вверх Dust использует меньше вычислений, чем EGGROLL при той же популяции, так что сравнение снисходительно к EGGROLL.
Основные результаты
Проводят sweep бюджета токенов от 100k до 20M через популяции от 64 до 16k, с backprop настроенным на том же grid на каждом бюджете. На 100k и 1M токенов Dust заканчивается ниже backprop, от несколько сотен draws на 100k и от тысячи на 1M. На 10M и 20M токенов, промежуток с backprop сжимается с популяцией. На 10M лестница выравнялась и её подобранный предел приземляется чуть выше backprop. На 20M лестница ещё падает на 16k draws. Его power law подгонка кладёт предел на 4.431 (95% интервал 3.89 к 4.58), ниже backprop's 4.633, но с лестницей ещё падающей подгонка слабо ограничена, поэтому это читается как свидетельство, что промежуток продолжает закрываться с популяцией, а не как измеренный предел.
ES в пространстве весов намного менее эффективен. С 256 разами популяции, EGGROLL на 16k всё ещё не достигает Dust на 64 draws. Он приходит в пределах 0.02 на 100k токенов и остаётся 0.4 к 0.6 выше на 1M, 10M и 20M. Лестница EGGROLL всё ещё падает крутым на 16k, поэтому она бы продолжала совершенствоваться с большей популяцией, но продолжение лестницы кладёт то, что ему требуется, чтобы совпадать с наименьшей популяцией Dust при несколько тысячах к примерно $10^4$ раз той популяции.
Dust под Adam
В то время как фокус в основном на SGD для остальной статьи, повторяют лестницу 1M токена с Adam на всех трёх методах, переналаживая learning rates backprop, собственные гиперпараметры Dust и шаг EGGROLL, momentum и fitness shaping на каждой популяции. Интересно, EGGROLL получает почти ничего от Adam и его настроенная Adam лестница приземляется в пределах 0.01 её SGD лестницы на каждой популяции. Однако Adam улучшает и Dust, и backprop и оставляет форму лестницы похожей на раньше. Dust закрывает на backprop с большой популяцией и интервал на её предел сидит ниже backprop. Поэтому оценка Dust уже работает с современными оптимизаторами, даже хотя современные оптимизаторы были оптимизированы для градиентов backprop. Подозревают, что coevolution оптимизаторов с Dust может привести к дальнейшим выигрышам и оставляют это на будущее.
Поиск в высокомерном пространстве
Переполнение параметров
Общепринятый взгляд — что методы нулевого порядка не могут обучать большие сети. Прямой проход возвращает один скаляр, поэтому дисперсия оценки градиента растёт с числом возмущённых измерений, и с ней растёт популяция, требуемая для полезного update. Авторы тестируют это напрямую, обучая четыре размера, 2M, 7M, 38M и 243M параметров (диапазон $120\times$ в количестве параметров), при фиксированных 10M токенов через sweep популяции. Делают два поразительных наблюдения, которые оспаривают общепринятое мнение.
- Большие модели часто эффективнее по популяции, а не менее. На каждой популяции от 256 вверх ошибка падает от 2M к 7M к 38M параметрам, и 243M модель только немного хуже. Даже на наименьшей популяции, которую тестируют, модель $120\times$ больше делает примерно то же самое, и лучше на каждой другой популяции. До точки, большая модель выигрывает больше от своего размера, чем теряет на дисперсии. Что наблюдают, однако, — что промежуток к backprop при той же популяции и размере модели растёт с размером модели, но едва заметно, особенно при больших размерах популяции.
- Большие модели продолжают совершенствоваться с популяцией, где маленькие выравниваются. Маленькие модели насыщаются раньше, в то время как большие модели продолжают совершенствоваться с большими размерами популяции. Мимо 1k draws 38M и 243M модели получают примерно 30% больше, чем 2M и 7M, и никакое количество популяции не делает крошечную модель конкурентной.
Правильный способ думать о размере модели — следовательно, как о размере и геометрии пространства поиска. Большая модель имеет большее пространство для поиска, что позволяет ей применять большую популяцию, и потенциально лучше-обусловленную геометрию ландшафта ошибок, что может быть почему поиск эффективнее даже при маленьких популяциях.
Появление градиентов, подобных backprop
Измеряют косинус между оценённым и backprop градиентом на одном батче, на тип слоя и на слой, на backprop-обученных checkpoints, охватывающих два порядка величины в токенах, т. е. от 10M к 1B токенов, с популяцией растущей от 64 к 128k прямых проходов на шаг. Косинус растёт с популяцией для каждого типа слоя на каждом этапе обучения, и two-parameter закон
$$\cos(K) = \frac{c_{\max}}{\sqrt{1 + c/K}}$$
подгоняет каждый тип слоя с RMSE ниже 0.06, с $c_{\max}$ потолком и $c$ популяцией, на которой слой достигает $c_{\max}/\sqrt{2}$. Полезные градиенты появляются из самой большой популяции, ничего о цепном правиле не встроено в него, только лёгкая настройка гиперпараметров для максимизации сходства косинуса, как описано выше. Важно, косинусы держатся через большинство слоёв по мере роста количества токенов, что обнадёживает для масштабирования. Раздел ниже показывает, что популяция, требуемая для совпадения и превышения backprop, растёт с токенами. Однако косинус остаётся плоским через два порядка величины в токенах при больших популяциях, что означает, что при достаточно большой популяции возможно, что это требование больше не растёт с большим числом токенов. Кроме того, факт, что градиенты Dust приближаются к backprop's, но не сходятся к ним точно — на самом деле хорошее свойство. Оценка указывает в похожем направлении без бытия backprop's градиентом, что ведёт к другой траектории оптимизации, и в экспериментах эта траектория может быть даже лучше, чем backprop's.
Заключение
С 1986 года backprop — алгоритм, который обучает нейронные сети, и архитектуры, оптимизаторы и аппаратное обеспечение, которое имеем, были построены вокруг него. По мере того как вычисления становятся более изобильными, думают, что намного лучшие альтернативы возможны. Dust — алгоритм, который резко улучшает существующие ES алгоритмы и хорошо аппроксимирует backprop при предварительном обучении трансформеров, даже превосходя его с большим количеством вычислений.
Есть много интересных открытых вопросов. Первый — может ли, и как, Dust найти лучшие направления, чем градиент первого порядка backprop, неявно исследуя ландшафт ошибок, подхватывая кривизну высшего порядка, которая тянет поиск к плоским регионам. Есть намеки, что может, потому что при больших популяциях он иногда заканчивается ниже backprop, но механизм не ясен. Второй — что Dust открывает пространство поиска архитектур, потому что не требует, чтобы сеть была end-to-end дифференцируемой, и может делать лучше, где backprop известен, что борется, как рекуррентное или циклическое вычисление, обученное backpropagation через время. Третий — вычислительная эффективность, которая не была фокусом этой статьи. Нужно иметь порядки величины больше вычислительной эффективности, прежде чем Dust становится практической альтернативой backprop при текущих уровнях вычислений.
Связанная работа
Ранняя работа по предварительному обучению нулевого порядка языковых моделей исследовала трудность обучения трансформеров с нуля с возмущениями весов. Их позднейший метод, KronZO, использует компактные возмущения со структурой Kronecker и выборочные направленные updates для улучшения предварительного обучения при снижении использования памяти. EGGROLL делает большие популяции возмущений весов эффективными на GPU через структуру низкого ранга. Dust вместо этого ищет над активациями и использует награды для каждого токена, чтобы извлечь больше кредита из каждого прямого прохода.
Для fine tuning, MeZO показал, что языковые модели могут быть адаптированы только с прямыми проходами и использованием памяти близко к inference. Evolution Strategies at Scale демонстрирует fine tuning всех параметров с ES в языковых моделях с миллиардами параметров. Neural Thickets находит полезных экспертов по задачам, случайно возмущая предварительно обученные веса, выбирая лучших кандидатов и объединяя их предсказания. Эти результаты показывают, сколько поиска может достичь вокруг предварительно обученной модели. Эксперименты авторов обращаются к изучению самих представлений через предварительное обучение с нуля.
Возмущения активации авторов строятся на возмущении узлов. GEMINI инъецировал шум в первый скрытый слой и восстанавливал оценки градиентов по слоям через итеративную инверсию матриц. Zoop использует выходные возмущения для fine tuning языковой модели, преобразуя оценённые выходные градиенты в параметр updates с локальными производными. Scaling Forward Gradient with Local Losses объединяет возмущения активации и локальные потери с forward mode automatic differentiation, чтобы снизить дисперсию оценки. Forward gradients с несколькими касательными также используют forward mode differentiation, объединяя несколько направленных производных через ортогональную проекцию, чтобы улучшить оценки градиентов.
Отдельная линия работы заменяет глобальный backward pass локальными learning dynamics: PC-ALM Sakana AI распространяет кредит через локальные dynamics predictive coding и множители Lagrange. Использует локальные производные и оценивается на задачах классификации изображений. Dust оценивает кредит из forward возмущений во время transformer pretraining, объединяя награды для каждого токена с локальными целями для выходов attention.