DuckDB как сервер
DuckDB был встроенной базой данных с первого дня. В DuckDB 1.5.3, выпущенной в мае, появился протокол Quack, позволяющий запускать DuckDB в традиционной архитектуре клиент-сервер, вместе с расширением quack, которое реализует собственный протокол DuckDB, позволяя любому процессу DuckDB служить своими базами данных.
Quack и CONNECT
DuckDB 2.0.0 поставляется с полированной версией протокола Quack с существенными улучшениями производительности и стабильности. Он также вводит новый оператор CONNECT, который позволяет подключать и переключаться на удалённую базу данных в одной команде для лучшего удобства использования:
Сервер DuckDB
CALL quack_serve(
    token = 'my_token'
);

CREATE TABLE events
    (date DATE, name VARCHAR);

INSERT INTO events VALUES
    ('2027-04-07',
     'DuckCon #8');
Клиент DuckDB
ATTACH 'quack:localhost'
    AS qk (TOKEN 'my_token');

CONNECT qk;
SELECT * FROM events;

┌────────────┬────────────┐
│    date    │    name    │
│    date    │  varchar   │
├────────────┼────────────┤
│ 2027-04-07 │ DuckCon #8 │
└────────────┴────────────┘
Для простоты в этом примере сервер и клиент работают на одной машине. По умолчанию сервер слушает только на localhost. Чтобы принимать соединения с других машин, держите сервер на localhost и поставьте его за обратный прокси с TLS. Опция allow_other_hostname, которая открывает сервер напрямую, предназначена только для тестирования.
Оператор CONNECT не ограничен Quack: он направляет сеанс на любую удалённую базу данных, поддерживающую его, включая PostgreSQL и MySQL. Для них новый оптимизатор удалённой отправки отправляет запросы прямо на удалённый сервер вместо того, чтобы вытягивать таблицы по сети.
Quack в CLI
CLI также имеет сокращения для настройки пары клиент-сервер Quack: новые аргументы -serve и -connect запускают сервер Quack или подключаются к нему прямо из командной строки:
Производительность
Асинхронный ввод-вывод
DuckDB 2.0 вводит асинхронный ввод-вывод для чтения файлов Parquet и CSV. Слой ввода-вывода теперь масштабируется независимо от слоя обработки запросов, выполняя чтения в фоновом режиме и поддерживая несколько запросов в полёте. Это означает гораздо больше параллелизма для удалённого чтения и значительно более быстрые запросы к объектному хранилищу, такому как s3://.
Дизайн подробно описан в отдельной статье блога. В ней показана пропускная способность сети во время выполнения запроса с асинхронным вводом-выводом и без него:
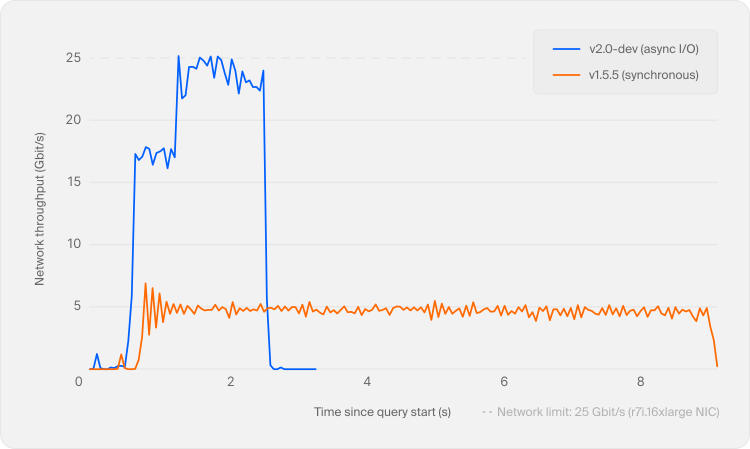
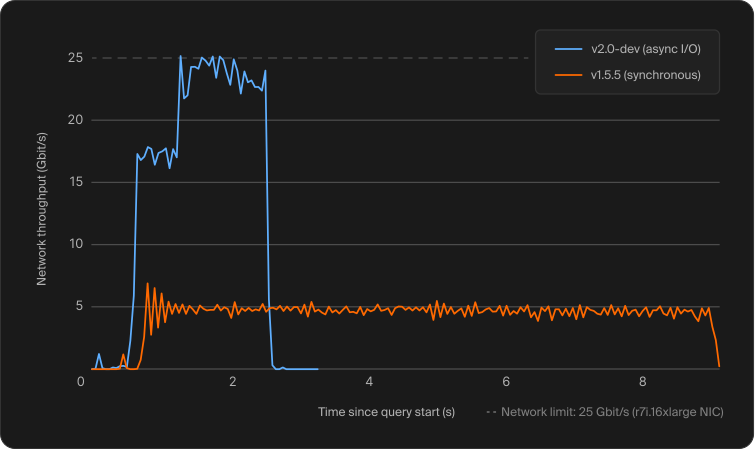 Пропускная способность сети. Лучше — более высокое использование и короче время выполнения.
Тип VARIANT становится гражданином первого класса
Тип VARIANT сохраняет полуструктурированные, схема-менее данные, такие как JSON, при сохранении производительности столбцовой обработки. Вы можете думать об этом как о JSON на стероидах: столбец VARIANT может хранить по-разному сформированные данные в каждой строке, но в отличие от JSON это не текстовый формат.
DuckDB 1.5 уже вводил VARIANT, но DuckDB 2.0 полностью его интегрирует. DuckDB 2.0 обнаруживает общую структуру в данных и "шредит" её, поэтому она хорошо сжимается и быстро выполняется. Конвейер работает от начала до конца, от расшредённого выполнения прямо из хранилища к расшредённому чтению и записи VARIANT для Parquet, поддерживаемому семейством функций variant_*. Например:
CREATE TABLE events (payload VARIANT);
INSERT INTO events
VALUES
    ('{"user": {"id": 42, "tags": ["a", "b"]}}'::JSON::VARIANT),
    ('{"event": "click", "x": 10, "y": 20}'::JSON::VARIANT);

SELECT variant_type(payload), variant_keys(payload)
FROM events;
┌───────────────────────┬───────────────────────┐
│ variant_type(payload) │ variant_keys(payload) │
│        varchar        │       varchar[]       │
├───────────────────────┼───────────────────────┤
│ OBJECT                │ [user]                │
│ OBJECT                │ [event, x, y]        │
└───────────────────────┴───────────────────────┘
Режим агента в CLI
Агенты кодирования, такие как Claude Code, Codex и Cursor, всё чаще управляют DuckDB CLI от имени пользователей. CLI версии 2.0 обнаруживает, когда его запускает агент, и переключается в режим агента: выводит компактные таблицы в Markdown вместо предварённых окон, чётко говорит, когда результат был усечен, останавливает длительные запросы рано и сообщает об ошибках как JSON.
Долгие SQL-запросы сообщают ожидаемую стоимость перед выполнением, чтобы агент мог решить, ждать ли. В экспериментах на TPC-H режим агента сократил объём вывода DuckDB, который модель должна была прочитать, на 59%. Вы можете включить его для ручного тестирования, используя флаг -agent, или указать агенту выключить его с помощью флага -no-agent.
Расширяемость
Совершенно новый SQL-парсер
DuckDB всегда использовал парсер, основанный на парсере PostgreSQL. В версии 2.0 наш собственный современный, расширяемый парсер на основе PEG, который дебютировал как опциональная функция в DuckDB 1.5, становится по умолчанию. Расширения теперь могут подключаться к самой грамматике (идея, которую мы впервые исследовали в нашей работе о расширяемых парсерах во время выполнения), поэтому ожидайте расширений, которые раскрывают совершенно новый синтаксис SQL. Сообщения об ошибках теперь содержат точные места в исходном коде. Подробности см. в документации PEG-парсера. Новый парсер разработан так, чтобы быть совместимым со старым, поэтому вы не должны заметить переключение. Если заметите — отправьте проблему. Тем временем вы можете переключиться обратно на старый парсер, используя расширение legacy_parser, выполнив SET enable_legacy_parser = true;.
Старый парсер служил DuckDB со времени его первого коммита в 2018 году. Его грамматика была сгенерирована с помощью YACC/Bison, которая создаёт парсер LALR(1), поэтому по мере роста DuckSQL даже небольшие дополнения могли столкнуться с существующими правилами и вызвать конфликты shift/reduce или reduce/reduce. Грамматика PEG избегает этого, попробовав альтернативы в порядке их написания, поэтому добавление синтаксиса больше не рискует нарушить не связанные правила. Python сам перешёл на парсер на основе PEG в версии 3.9 для той же гибкости.
Напишите расширения один раз и размещайте их сами
DuckDB 2.0 поставляется с переработанным C API v2, который значительно мощнее своего предшественника и раскрывает компоненты, такие как файловые системы и функции таблиц, расширениям. Перед тем как отметить его как стабильный, мы хотели бы протестировать его в полевых условиях, поэтому попробуйте и отправьте нам отзыв!
Вы также можете зарегистрировать и размещать собственные доверенные хранилища расширений, поэтому организация может размещать и подписывать собственные расширения и иметь их установку и загрузку точно так же, как встроенные:
SET allow_extension_repositories = 'allowed';

CREATE EXTENSION REPOSITORY my_repo
    WITH PREFIX 'https://extensions.example.org';

INSTALL AND LOAD my_ext FROM my_repo;
Хранилище — это имя, префикс URL и один или несколько открытых ключей RSA, которые доверяют подписывать расширения, предоставляемые из него. Префикс может указывать на всё, что может читать DuckDB: локальный путь, https, s3, что угодно. Во время CREATE DuckDB получает открытые ключи хранилища и закрепляет их в определении хранилища, печатая отпечаток SHA-256 каждого ключа, чтобы вы могли сравнить его с опубликованным вне пределов сети.
Эта функция всё ещё находится в разработке и её синтаксис может измениться в будущих выпусках. Более подробную информацию см. на странице Extension Repositories.
Обновления основных расширений
Основные расширения DuckDB также поставляются с несколькими новыми функциями, исправлениями и оптимизациями производительности. Их слишком много, чтобы перечислить их все здесь, поэтому мы выделим только несколько из них и будем рассказывать о них в отдельных статьях блога в ближайшие недели:
- Мы выпустили DuckLake 1.1, включающий новую спецификацию и справочную реализацию.
- Расширение Iceberg стремится стать полнофункциональной реализацией. К этому добавляются опции REST каталога
ATTACH, которые получают местоположение таблицы из её пространства имён или загружают метаданные таблицы из файлаmetadata-location, возвращённого каталогом. Дополнительные опции контролируют префикс URL и разделитель пространства имён. - Расширение Delta может создавать таблицы Delta с
CREATE TABLE(включая разбиение и свойства таблицы Delta), поддерживает путешествие во времени и улучшает поддержкуVARIANT.
Функции SQL
Триггеры
DuckDB 2.0 поставляется с триггерами: оператор CREATE TRIGGER с триггерами BEFORE и AFTER, FOR EACH ROW и FOR EACH STATEMENT, таблицами переходов через REFERENCING OLD/NEW TABLE, несколькими триггерами на событие, RETURNING на триггеров таблицах и DROP TRIGGER. Классический случай использования — таблицы аудита, где триггер записывает, что изменилось в ответ на изменение таблицы. Некоторые комбинации, такие как триггеры BEFORE ... FOR EACH ROW и UPDATE ... FOR EACH ROW, пока не поддерживаются; см. ограничения.
CREATE TRIGGER trg_audit
    AFTER UPDATE ON target
    REFERENCING
        OLD TABLE AS o
        NEW TABLE AS n
    FOR EACH STATEMENT
        INSERT INTO audit
        SELECT n.id, o.val, n.val
        FROM o JOIN n ON o.id = n.id;
Триггеры также могут поддерживать материализованные представления инкрементно! Например, чтобы отслеживать средний возраст людей по национальности в таблице age_statistics, вы можете использовать два триггера — один для вставки и другой для удаления операций — и сохранить сумму и количество рядом со средним.
Для подробностей нажмите здесь.
CREATE TABLE people (name VARCHAR, nationality VARCHAR, age INTEGER);
CREATE TABLE age_statistics (
    nationality VARCHAR PRIMARY KEY,
    sum_age INTEGER,
    num_people INTEGER,
    average_age DOUBLE
);
При вставке мы агрегируем новые строки по национальности и объединяем их в age_statistics, добавляя строку для каждой новой национальности:
CREATE TRIGGER people_insert
    AFTER INSERT ON people
    REFERENCING NEW TABLE AS n
    FOR EACH STATEMENT
        MERGE INTO age_statistics s
        USING (
            SELECT nationality, sum(age) AS sum_age, count(*) AS num_people
            FROM n
            GROUP BY nationality
        ) d
        ON s.nationality = d.nationality
        WHEN MATCHED THEN UPDATE SET
            sum_age = s.sum_age + d.sum_age,
            num_people = s.num_people + d.num_people,
            average_age = (s.sum_age + d.sum_age) / (s.num_people + d.num_people)
        WHEN NOT MATCHED THEN INSERT
            VALUES (d.nationality, d.sum_age, d.num_people, d.sum_age / d.num_people);
При удалении мы вычитаем удалённые строки и удаляем национальность, когда последний человек её покидает:
CREATE TRIGGER people_delete
    AFTER DELETE ON people
    REFERENCING OLD TABLE AS o
    FOR EACH STATEMENT
        MERGE INTO age_statistics s
        USING (
            SELECT nationality, sum(age) AS sum_age, count(*) AS num_people
            FROM o
            GROUP BY nationality
        ) d
        ON s.nationality = d.nationality
        WHEN MATCHED AND s.num_people = d.num_people THEN DELETE
        WHEN MATCHED THEN UPDATE SET
            sum_age = s.sum_age - d.sum_age,
            num_people = s.num_people - d.num_people,
            average_age = (s.sum_age - d.sum_age) / (s.num_people - d.num_people);
Давайте посмотрим на людей, приходящих и уходящих:
INSERT INTO people VALUES
    ('Alice', 'US', 34), ('Bram', 'NL', 27), ('Csilla', 'HU', 45),
    ('Dave', 'US', 58), ('Eva', 'NL', 19), ('Femke', 'NL', 41);
FROM age_statistics ORDER BY nationality;
┌─────────────┬─────────┬────────────┬─────────────┐
│ nationality │ sum_age │ num_people │ average_age │
│   varchar   │  int32  │   int32    │   double    │
├─────────────┼─────────┼────────────┼─────────────┤
│ HU          │      45 │          1 │        45.0 │
│ NL          │      87 │          3 │        29.0 │
│ US          │      92 │          2 │        46.0 │
└─────────────┴─────────┴────────────┴─────────────┘
DELETE FROM people WHERE name = 'Alice';
DELETE FROM people WHERE nationality = 'HU';
FROM age_statistics ORDER BY nationality;
┌─────────────┬─────────┬────────────┬─────────────┐
│ nationality │ sum_age │ num_people │ average_age │
│   varchar   │  int32  │   int32    │   double    │
├─────────────┼─────────┼────────────┼─────────────┤
│ NL          │      87 │          3 │        29.0 │
│ US          │      58 │          1 │        58.0 │
└─────────────┴─────────┴────────────┴─────────────┘
Триггеры приближают нас к материализованным представлениям, долгосрочному элементу в разделе "Будущая работа" нашей дорожной карты.
Дополнения SQL диалекта
Как всегда, дружественный SQL диалект DuckDB продолжает расти. Несколько фаворитов из этого цикла выпусков:
- Сокращение
$variableпозволяет вам писать$xв большинстве мест, где разрешено выражение, вместоgetvariable('x'). - Изменяющие данные CTE позволяют использовать
INSERT,UPDATE,DELETEиCOPYкак шаги конвейера. - Соединения
NEARESTпревращают поиск сходства top-k в предложение соединения, удобное для рабочих нагрузок вектора и встраивания. - Вложенные схемы позволяют схемам внутри схем, например,
CREATE SCHEMA finance.reports. - Функции мутации JSON
json_set,json_insert,json_replaceиjson_removeвозвращают изменённые копии документов JSON (см. также нашу статью блога о JSON-патчах).
Есть ещё: DuckDB 2.0.0 поддерживает стандартный SQL FETCH FIRST и позволяет UNNEST в предложении GROUP BY. Он также обеспечивает хорошо определённую семантику для MERGE и UPDATE ... FROM в случаях, когда совпадают несколько строк.
Миграция на 2.0
DuckDB 2.0 поставляется с небольшим набором критических изменений. Для большинства пользователей обновление понятно, но сложные развертывания, запускающие много процессов DuckDB, требуют больше внимания. Формат хранилища является наиболее вероятным источником проблем: версии DuckDB до 2.0 не могут читать файлы баз данных, созданные DuckDB 2.0. DuckDB 2.0 может по-прежнему читать и записывать существующие файлы баз данных, и они остаются читаемыми старыми версиями. Мы рекомендуем тестировать 2.0.0 на теневой системе перед переключением производства. И если ваша рабочая нагрузка критична, вы можете подождать первого выпуска патча, выходящего в ноябре.
Для полной информации см. руководство по миграции.
Внутренние элементы и амортизация
Требования к компилятору
После долгого времени на C++11 DuckDB 2.0 теперь требует компилятор C++17.
Мы также переключились на Clang как компилятор по умолчанию для наших выпусков. На Linux и macOS DuckDB и его основные расширения собраны с Clang. На Windows CLI создан с Clang, в то время как большинство основных расширений всё ещё построены с MSVC. Мы можем переместить больше сборок Windows на Clang в будущем, но это требует дальнейших изменений.
Часовые пояса, календари и сортировки без ICU
Временные метки, учитывающие часовой пояс, календари и сортировки всегда были powered ICU библиотекой. В версии 2.0 библиотека ICU полностью ушла: расширение icu теперь реализует часовые пояса, календари и сортировки самостоятельно, с данными часовых поясов построенными непосредственно из базы данных IANA и сжатыми примерно до 45 кБ.
Всё продолжает работать точно так же, как раньше, и собственная реализация также быстрее. Если вы найдёте какие-либо проблемы, пожалуйста, дайте нам знать!
Амортизация
Синтаксис Lambda
Старый синтаксис однострочной стрелки (x -> x + 1) теперь отключён по умолчанию. Используйте вместо этого синтаксис в стиле Python:
SELECT list_transform([1, 2, 3], lambda x: x + 1);
Вы можете временно повторно включить старый синтаксис с помощью SET lambda_syntax = 'enable_single_arrow';. Оба флага и синтаксис однострочной стрелки будут полностью удалены в v2.1.
Сборки амальгамации
Сборка амальгамации, которая объединяет весь исходный код DuckDB в один заголовок и один исходный файл, теперь устарела. Амальгамация выросла слишком большой, чтобы быть реально полезной в большинстве случаев.
Постепенное снятие macOS x86_64
Мы постепенно выводим osx_amd64 из списка полностью поддерживаемых платформ. Пока DuckDB и основные расширения всё ещё собираются и поддерживаются, но расширения сообщества больше не собираются для этой платформы. DuckDB 2.1 прекратит поддержку osx_amd64.
Итоговое резюме
Это были несколько основных моментов, но в этом выпуске есть и многие другие функции и улучшения. С DuckDB 1.5 прошло почти 20 000 коммитов от многих участников, доставив меньшие функции, а также улучшения производительности и удобства использования. Полные примечания к выпуску можно найти на GitHub.
Мы хотели бы поблагодарить нашу сообщество за подробные отчеты об ошибках и отзывы, которые направили этот выпуск, и особую благодарность нашим участникам!