DuckDB как сервер
С самого начала DuckDB работал как встроенная база данных. В версии 1.5.3, выпущенной в мае, представили Quack protocol для традиционной архитектуры клиент-сервер, а также quack расширение, которое реализует собственный протокол DuckDB. Теперь любой DuckDB процесс может служить сервером для своих баз данных.
Quack и оператор CONNECT
DuckDB 2.0.0 поставляется с отполированной версией Quack protocol с существенными улучшениями производительности и стабильности. Также представлен новый оператор CONNECT, позволяющий подключиться и переключиться на удалённую базу данных одной командой:
DuckDB сервер
CALL quack_serve(
    token = 'my_token'
);

CREATE TABLE events
    (date DATE, name VARCHAR);

INSERT INTO events VALUES
    ('2027-04-07',
     'DuckCon #8');
DuckDB клиент
ATTACH 'quack:localhost'
    AS qk (TOKEN 'my_token');

CONNECT qk;
SELECT * FROM events;

┌────────────┬────────────┐
│    date    │    name    │
│    date    │  varchar   │
├────────────┼────────────┤
│ 2027-04-07 │ DuckCon #8 │
└────────────┴────────────┘
Для простоты пример запускает сервер и клиент на одной машине. По умолчанию сервер прослушивает только localhost. Чтобы принимать подключения с других машин, держите сервер на localhost и размещайте его за TLS-терминирующим обратным прокси. Опция allow_other_hostname, открывающая прямой доступ к серверу, предназначена только для тестирования.
Оператор CONNECT не ограничен Quack: он подключает сеанс к любой удалённой базе данных, включая PostgreSQL и MySQL. Для них новый оптимизатор remote pushdown отправляет запросы напрямую на удалённый сервер вместо загрузки таблиц по сети.
Quack в CLI
CLI также получил ярлыки для настройки пары клиента и сервера Quack: новые аргументы -serve и -connect запускают Quack сервер или подключаются к нему прямо из командной строки:
CLI сервер
duckdb -serve
CREATE TABLE t AS
      SELECT 42 AS x;
CLI клиент
duckdb -connect
FROM t;

┌───────┐
│   x   │
│ int32 │
├───────┤
│    42 │
└───────┘
Производительность
Асинхронное I/O
DuckDB 2.0 вводит асинхронное I/O для чтения файлов Parquet и CSV. Слой I/O теперь масштабируется независимо от слоя обработки запросов, выполняя чтение в фоне и сохраняя несколько запросов в полёте. Это означает гораздо больше параллелизма для удалённого чтения и значительно более быстрые запросы к хранилищам объектов, таким как s3://.
Дизайн был подробно описан в отдельной статье блога. В той статье показана пропускная способность сети при выполнении запроса с асинхронным и без асинхронного I/O:
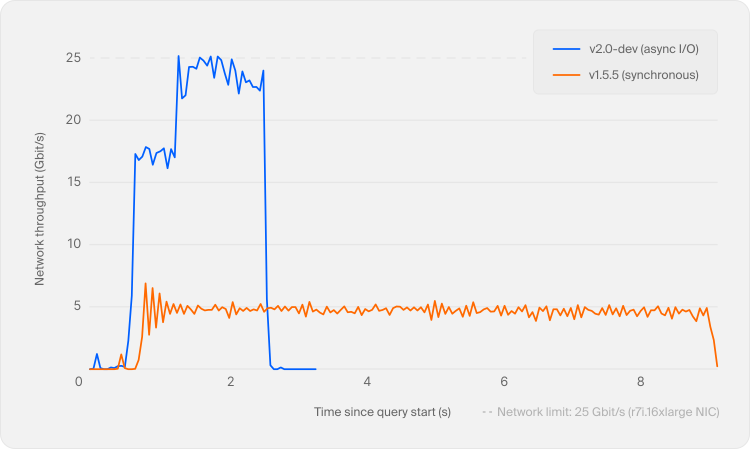
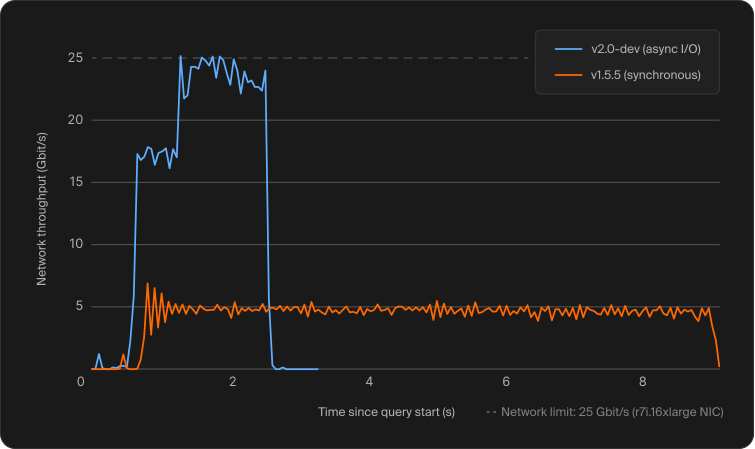
Пропускная способность сети. Выше — лучше как высокая утилизация, так и меньшее время выполнения.
Тип VARIANT становится гражданином первого класса
Тип VARIANT хранит полуструктурированные данные без схемы, такие как JSON, сохраняя при этом производительность колончатого выполнения. Это можно рассматривать как JSON на стероидах: столбец VARIANT может хранить данные разной структуры в каждой строке, но в отличие от JSON это не текстовый формат.
DuckDB 1.5 уже представил VARIANT, но DuckDB 2.0 полностью интегрирует его. DuckDB 2.0 обнаруживает общую структуру в данных и «shredding» её, поэтому она хорошо сжимается и быстро выполняется. Конвейер работает сквозь всё — от shredded выполнения прямо из хранилища к чтению и записи shredded VARIANT для Parquet, поддерживаемых семейством функций variant_*. Например:
CREATE TABLE events (payload VARIANT);
INSERT INTO events
VALUES
    ('{"user": {"id": 42, "tags": ["a", "b"]}}'::JSON::VARIANT),
    ('{"event": "click", "x": 10, "y": 20}'::JSON::VARIANT);

SELECT variant_type(payload), variant_keys(payload)
FROM events;
┌───────────────────────┬───────────────────────┐
│ variant_type(payload) │ variant_keys(payload) │
│        varchar        │       varchar[]       │
├───────────────────────┼───────────────────────┤
│ OBJECT                │ [user]                │
│ OBJECT                │ [event, x, y]        │
└───────────────────────┴───────────────────────┘
Agent Mode в CLI
Coding-агенты, такие как Claude Code, Codex и Cursor, всё чаще управляют DuckDB CLI от имени пользователей. CLI версии 2.0 обнаруживает, когда его запущен агент, и переходит в режим agent mode: выводит компактные таблицы Markdown вместо отступленных блоков, чётко говорит, когда результат был обрезан, останавливает запросы с заиканием рано и сообщает об ошибках в виде JSON.
Долгоживущие SQL запросы сообщают ожидаемую стоимость перед выполнением, чтобы агент мог решить, ждать ли. В экспериментах на TPC-H режим agent mode сократил объём выходных данных DuckDB, которые модель должна была прочитать, на 59%. Можно включить его для ручного тестирования, используя флаг -agent, или поручить агенту отключить его с помощью флага -no-agent.
Расширяемость
Совершенно новый SQL парсер
DuckDB всегда использовал парсер, полученный из PostgreSQL. В версии 2.0 собственный современный, расширяемый парсер на основе PEG, который дебютировал как опциональная функция в DuckDB 1.5, становится стандартом. Расширения теперь могут подключаться к самой грамматике (идея, которую впервые исследовали в работе по runtime-extensible parsers), поэтому ожидайте расширений, открывающих совершенно новый SQL синтаксис. Сообщения об ошибках теперь содержат точные местоположения в исходном коде. Подробно см. в документации PEG парсера. Новый парсер разработан для совместимости со старым, поэтому вы не должны заметить переключение. Если заметите — создайте issue. А пока можно вернуться к старому парсеру, используя расширение legacy_parser, запустив SET enable_legacy_parser = true;.
Старый парсер служил DuckDB с первого коммита в 2018 году. Его грамматика была сгенерирована с помощью YACC/Bison, который выпускает LALR(1) парсер, поэтому по мере роста DuckSQL даже небольшие добавления могли конфликтовать с существующими правилами и вызывать ошибки shift/reduce или reduce/reduce. Грамматика PEG избегает этого, пробуя альтернативы в порядке их написания, поэтому добавление синтаксиса больше не рискует сломать несвязанные правила. Python сам перешёл на парсер на основе PEG в версии 3.9 для такой же гибкости.
Пишите расширения один раз и размещайте их сами
DuckDB 2.0 поставляется с переделанным C API v2, который намного мощнее своего предшественника и открывает компоненты, такие как файловые системы и табличные функции, для расширений. Прежде чем отметить его как стабильный, хотелось бы протестировать его в боевых условиях, поэтому пожалуйста попробуйте и отправьте свой отзыв!
Вы также можете регистрировать и размещать свои собственные доверенные хранилища расширений, поэтому организация может размещать, подписывать свои расширения и иметь их установку и загрузку так же, как встроенные:
SET allow_extension_repositories = 'allowed';

CREATE EXTENSION REPOSITORY my_repo
    WITH PREFIX 'https://extensions.example.org';

INSTALL AND LOAD my_ext FROM my_repo;
Хранилище — это имя, префикс URL и одна или несколько RSA открытых ключей, которые доверяют для подписи расширений, поступающих от него. Префикс может указывать на всё, что DuckDB может читать: локальный путь, https, s3, неважно. При создании DuckDB загружает открытые ключи хранилища и закрепляет их в определении хранилища, печатая хэш SHA-256 каждого ключа, чтобы вы могли сравнить его с одним, опубликованным вне полосы.
Эта функция ещё работается и её синтаксис может измениться в будущих релизах. Подробно см. на странице Extension Repositories.
Обновления основных расширений
Основные расширения DuckDB также поставляются с несколькими новыми функциями, исправлениями и оптимизациями производительности. Их слишком много, чтобы перечислить все, поэтому выделю лишь несколько и расскажу о них подробнее в отдельных статьях блога в ближайшие недели:
- Выпустили DuckLake 1.1 с новой спецификацией и эталонной реализацией.
- Расширение Iceberg стремится стать полнофункциональной реализацией. Для этого добавил опции REST catalog
ATTACH, которые получают расположение таблицы из её пространства имён или загружают метаданные таблицы из файлаmetadata-location, возвращённого каталогом. Дополнительные опции управляют префиксом URL и разделителем пространства имён. - Расширение Delta может создавать таблицы Delta с помощью
CREATE TABLE(включая partitioning и свойства таблицы Delta), поддерживает time travel и улучшает поддержкуVARIANT.
SQL функции
Triggers
DuckDB 2.0 поставляется с триггерами: оператор CREATE TRIGGER с триггерами BEFORE и AFTER, FOR EACH ROW и FOR EACH STATEMENT, переходные таблицы через REFERENCING OLD/NEW TABLE, несколько триггеров на событие, RETURNING на сработавших таблицах и DROP TRIGGER. Классический вариант использования — таблицы аудита, где триггер записывает то, что изменилось в ответ на модификацию таблицы. Некоторые комбинации, такие как BEFORE ... FOR EACH ROW и UPDATE ... FOR EACH ROW триггеры, пока не поддерживаются; см. ограничения.
CREATE TRIGGER trg_audit
    AFTER UPDATE ON target
    REFERENCING
        OLD TABLE AS o
        NEW TABLE AS n
    FOR EACH STATEMENT
        INSERT INTO audit
        SELECT n.id, o.val, n.val
        FROM o JOIN n ON o.id = n.id;
Триггеры также могут поддерживать материализованные представления инкрементально! Например, чтобы отслеживать средний возраст людей по национальности в таблице age_statistics, можно использовать два триггера — один для операций вставки, другой для удаления — и хранить сумму и количество вместе со средним значением.
Для подробностей кликните сюда.
CREATE TABLE people (name VARCHAR, nationality VARCHAR, age INTEGER);
CREATE TABLE age_statistics (
    nationality VARCHAR PRIMARY KEY,
    sum_age INTEGER,
    num_people INTEGER,
    average_age DOUBLE
);
При вставке агрегируем новые строки по национальности и сливаем их в age_statistics, добавляя строку для каждой новой национальности:
CREATE TRIGGER people_insert
    AFTER INSERT ON people
    REFERENCING NEW TABLE AS n
    FOR EACH STATEMENT
        MERGE INTO age_statistics s
        USING (
            SELECT nationality, sum(age) AS sum_age, count(*) AS num_people
            FROM n
            GROUP BY nationality
        ) d
        ON s.nationality = d.nationality
        WHEN MATCHED THEN UPDATE SET
            sum_age = s.sum_age + d.sum_age,
            num_people = s.num_people + d.num_people,
            average_age = (s.sum_age + d.sum_age) / (s.num_people + d.num_people)
        WHEN NOT MATCHED THEN INSERT
            VALUES (d.nationality, d.sum_age, d.num_people, d.sum_age / d.num_people);
При удалении вычитаем удалённые строки и удаляем национальность после ухода последнего человека:
CREATE TRIGGER people_delete
    AFTER DELETE ON people
    REFERENCING OLD TABLE AS o
    FOR EACH STATEMENT
        MERGE INTO age_statistics s
        USING (
            SELECT nationality, sum(age) AS sum_age, count(*) AS num_people
            FROM o
            GROUP BY nationality
        ) d
        ON s.nationality = d.nationality
        WHEN MATCHED AND s.num_people = d.num_people THEN DELETE
        WHEN MATCHED THEN UPDATE SET
            sum_age = s.sum_age - d.sum_age,
            num_people = s.num_people - d.num_people,
            average_age = (s.sum_age - d.sum_age) / (s.num_people - d.num_people);
Посмотрим, как люди приходят и уходят:
INSERT INTO people VALUES
    ('Alice', 'US', 34), ('Bram', 'NL', 27), ('Csilla', 'HU', 45),
    ('Dave', 'US', 58), ('Eva', 'NL', 19), ('Femke', 'NL', 41);
FROM age_statistics ORDER BY nationality;
┌─────────────┬─────────┬────────────┬─────────────┐
│ nationality │ sum_age │ num_people │ average_age │
│   varchar   │  int32  │   int32    │   double    │
├─────────────┼─────────┼────────────┼─────────────┤
│ HU          │      45 │          1 │        45.0 │
│ NL          │      87 │          3 │        29.0 │
│ US          │      92 │          2 │        46.0 │
└─────────────┴─────────┴────────────┴─────────────┘
DELETE FROM people WHERE name = 'Alice';
DELETE FROM people WHERE nationality = 'HU';
FROM age_statistics ORDER BY nationality;
┌─────────────┬─────────┬────────────┬─────────────┐
│ nationality │ sum_age │ num_people │ average_age │
│   varchar   │  int32  │   int32    │   double    │
├─────────────┼─────────┼────────────┼─────────────┤
│ NL          │      87 │          3 │        29.0 │
│ US          │      58 │          1 │        58.0 │
└─────────────┴─────────┴────────────┴─────────────┘
Триггеры приближают нас на шаг к материализованным представлениям, которые долгое время находились в разделе «Future Work» дорожной карты.
Добавления SQL диалекта
Как всегда, дружелюбный SQL диалект DuckDB продолжает расти. Несколько любимчиков из этого цикла релиза:
- Сокращение
$variableпозволяет писать$xв большинстве мест, где разрешено выражение, вместоgetvariable('x'). - Data-modifying CTEs позволяют использовать
INSERT,UPDATE,DELETEиCOPYкак шаги конвейера. - Соединения
NEARESTпревращают поиск топ-k схожести в предложение соединения, удобно для векторных и embedding рабочих нагрузок. - Вложенные схемы позволяют схемы внутри схем, например
CREATE SCHEMA finance.reports. - JSON функции мутации
json_set,json_insert,json_replaceиjson_removeвозвращают модифицированные копии документов JSON (см. также статью блога о JSON патчах).
Ещё больше: DuckDB 2.0.0 поддерживает SQL-стандартный FETCH FIRST и позволяет UNNEST в предложении GROUP BY. Также гарантирует хорошо определённую семантику для MERGE и UPDATE ... FROM в случаях, когда несколько строк совпадают.
Миграция на 2.0
DuckDB 2.0 поставляется с небольшим набором ломающих изменений. Для большинства пользователей обновление несложно, но сложные развёртывания, запускающие много процессов DuckDB, требуют большего внимания. Формат хранилища — наиболее вероятный источник проблем: версии DuckDB ранее 2.0 не могут читать файлы баз данных, созданные DuckDB 2.0. DuckDB 2.0 по-прежнему может читать и писать существующие файлы базы данных, и они остаются читаемыми старыми версиями. Рекомендуется протестировать 2.0.0 на резервной системе перед переключением на production. И если рабочая нагрузка критична для миссии, можно подождать первого патча, выходящего в ноябре.
Полные подробности см. в руководстве по миграции.
Внутренние изменения и deprecations
Требования к компилятору
После долгого использования C++11, DuckDB 2.0 теперь требует компилятор C++17.
Также переключились на Clang как компилятор по умолчанию для сборок релизов. На Linux и macOS DuckDB и его основные расширения собираются с помощью Clang. На Windows CLI собирается с помощью Clang, а большинство основных расширений всё ещё собираются с MSVC. В будущем может переместить больше сборок Windows на Clang, но это требует дальнейших изменений.
Часовые пояса, календари и сортировки без ICU
Временные метки с учётом часового пояса, календари и сортировки всегда использовали библиотеку ICU. В версии 2.0 библиотека ICU полностью удалена: расширение icu теперь реализует часовые пояса, календари и сортировки самостоятельно, с данными часовых поясов, встроенными непосредственно из базы данных IANA и сжатыми примерно до 45 кБ.
Всё продолжает работать ровно как раньше, и нативная реализация также быстрее. Если обнаружите проблемы, пожалуйста сообщите!
Deprecations
Синтаксис Lambda
Старый синтаксис однострелочной лямбды (x -> x + 1) теперь отключён по умолчанию. Используйте синтаксис в стиле Python вместо этого:
SELECT list_transform([1, 2, 3], lambda x: x + 1);
Можно временно повторно включить старый синтаксис с помощью SET lambda_syntax = 'enable_single_arrow';. И флаг, и синтаксис однострелки будут полностью удалены в v2.1.
Сборки Amalgamation
Сборка amalgamation, которая объединяет весь исходный код DuckDB в один заголовок и один исходный файл, теперь устарела. Amalgamation вырос слишком, чтобы быть реально полезным в большинстве случаев.
Постепенный отказ от macOS x86_64
Постепенно отказываем от osx_amd64 из списка полностью поддерживаемых платформ. На данный момент DuckDB и основные расширения по-прежнему собираются и поддерживаются, но расширения сообщества больше не собираются для этой платформы. DuckDB 2.1 прекратит поддержку osx_amd64.
Итоги
Это были лишь некоторые основные моменты, но в этом релизе гораздо больше функций и улучшений. С момента DuckDB 1.5 было почти 20 000 коммитов от многих разработчиков, в том числе меньшие функции и улучшения производительности и удобства использования. Полные заметки о релизе можно найти на GitHub.
Благодарны сообществу за подробные отчёты об ошибках и обратную связь, которые привели к этому релизу, и особая благодарность нашим разработчикам!