Проблема
До внедрения кэша каждое открытие файла требовало полного обхода пути. Процесс выглядел так:
- Получить путь к файлу.
- Пройти вверх по пути через dentry структуры.
- На каждом уровне проверить, существует ли политика доступа для этого пути.
- Объединить результаты, чтобы получить финальную политику и принять решение (allow/deny).
Подход работает, но если один и тот же файл открывается несколько раз или несколько файлов из одного поддерева обращаются последовательно, приходится повторять все эти шаги для каждого файла.
Например, в PostgreSQL при ограничении доступа только к /var/lib/postgres политика может выглядеть так:
policies:
  - executable: "filepath = /usr/lib/postgresql/16/bin/postgres"
    can_access_dirs:
      - "/var/lib/postgres:read"
PostgreSQL обращается к файлам в /var/lib/postgres/data/base/123, /var/lib/postgres/data/base/234 и /var/lib/postgres/data/base/345. Приходится проходить весь путь dentry структур для каждого обращения — крайне неэффективно. Далее в этом материале такой обход будет называться "slow path".
Что хранится в кэше?
Решение было использовать кэш, но нужно было убедиться, что он не станет тяжелым и безопасным в переиспользовании.
Изначально рассматривался вариант с dentry структурами, но они — это указатели, а указатели нельзя хранить в eBPF map. Можно было бы сохранять содержимое dentry в структуре и использовать её как ключ, но структура получилась бы громоздкой.
Выбрали inode-ориентированный кэш. Ключ кэша состоит из трёх полей: ID пространства имён mount, ID монтирования и номер inode.
Нельзя кэшировать inode в одиночку, потому что номера inode уникальны только в пределах конкретного дерева монтирования (если политика охватывает несколько деревьев, номера могут совпадать). ID монтирования идентифицирует, через какое смонтированное дерево наблюдался файл. ID пространства имён mount предотвращает использование кэшированных записей в других namespace.
Значение кэша состоит из двух частей: access_index и состояния кэша. Политики хранятся в виде битовых масок для экономии места, а access_index — это позиция бита для политики пути (https://nathannaveen.dev/posts/optimizing-ebpf-policies-for-speed-and-space/).
Кэш с ключами и значениями выглядит примерно так:
#define INODE_POLICY_CACHE_NO_POLICY 0
#define INODE_POLICY_CACHE_ACCESS_INDEX 1
#define INODE_POLICY_CACHE_GLOBAL_READ_ONLY 2
#define INODE_POLICY_CACHE_ACCESS_INDEX_AND_GLOBAL_RO 3

struct inode_cache_key {
    u64 mntns_id;
    u64 mount_id;
    u64 inode;
};

struct inode_policy_cache_value {
    u32 access_index;
    u8 state;
};

struct {
    __uint(type, BPF_MAP_TYPE_LRU_HASH);
    __uint(max_entries, 10000);
    __type(key, struct inode_cache_key);
    __type(value, struct inode_policy_cache_value);
} bomfather_inode_policy_cache SEC(".maps");
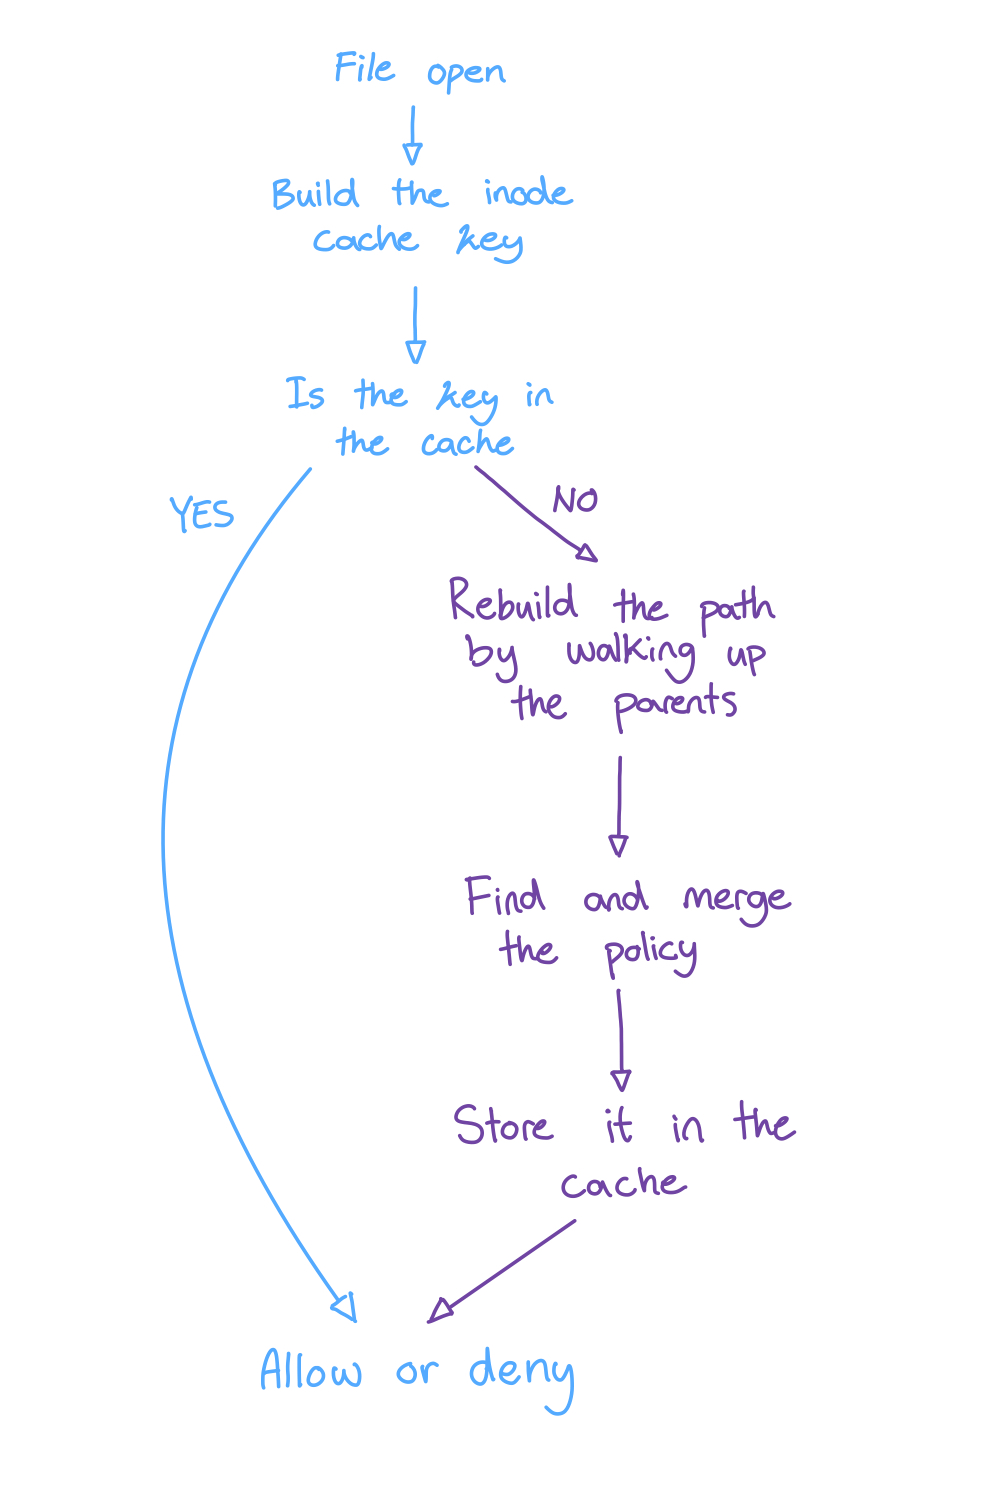
С кэшем процесс выглядит так:
- Построить ключ кэша.
- Найти ключ в LRU hash map.
- При попадании в кэш — применить политику на основе кэшированного результата.
- При промахе — пройти slow path, сохранить результат в кэше.
Результаты производительности
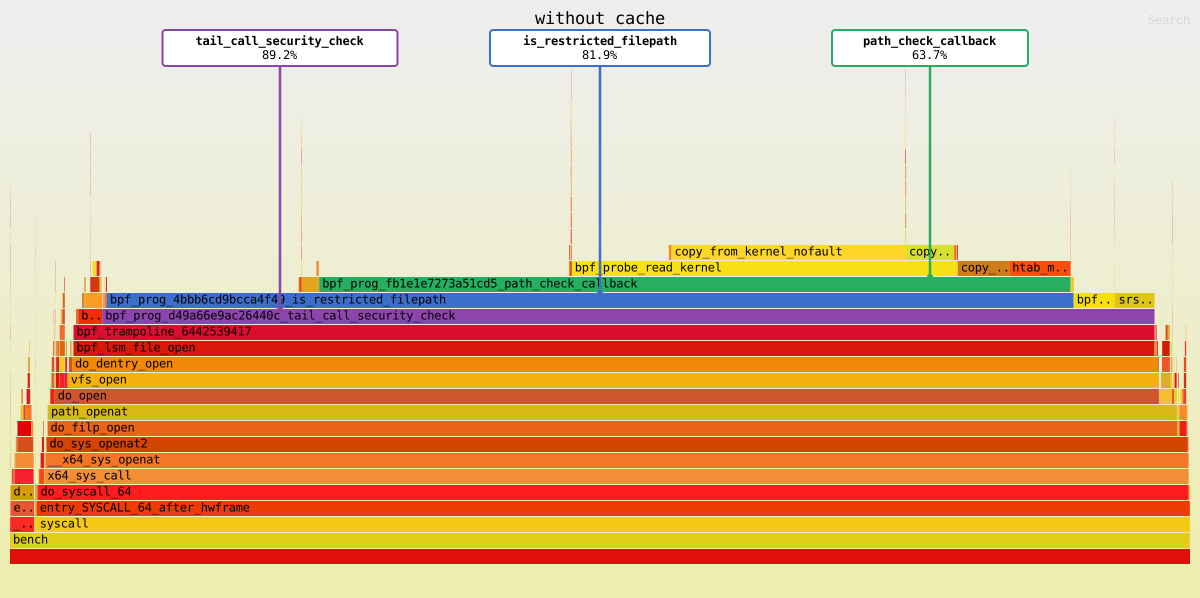
В тестах производительности было открыто один и тот же файл 200 000 раз. Кэш снизил kernel cycles с 28 млрд до 3,03 млрд. Без кэша tail_call_security_check появлялся в стэке в 89,2% случаев, is_restricted_filepath — в 81,9%, path_check_callback — в 63,7%.
На графиках пламени видно, что при наличии кэша затраты на обход пути практически исчезают после первого обращения. Например, is_restricted_filepath и path_check_callback сокращаются примерно до 0,02% — настолько мало, что практически не видны на графике.
До (без кэша):
После (с кэшем):
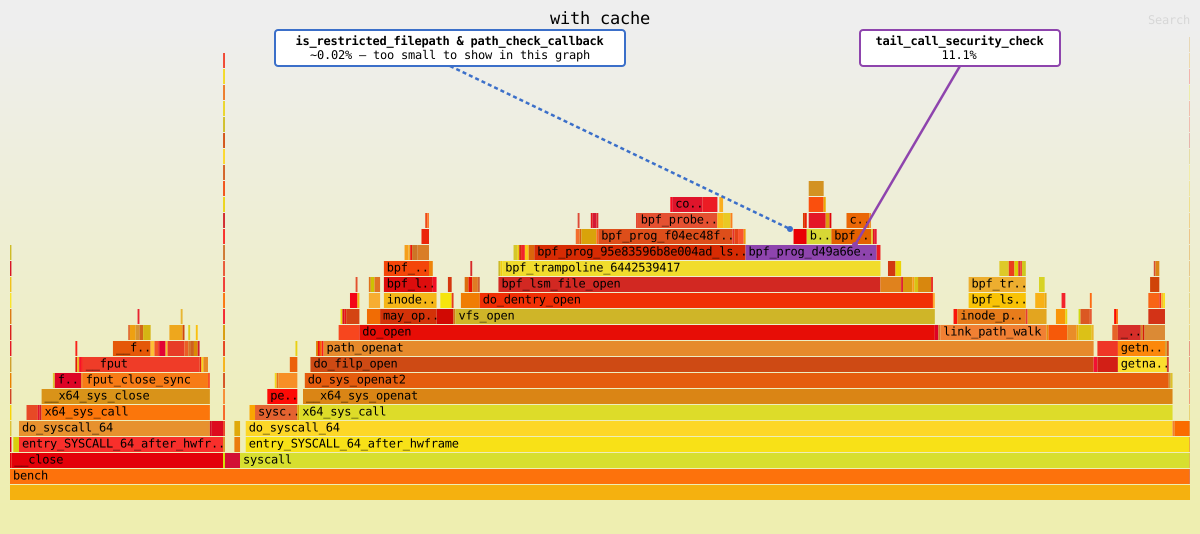
Профилирование kernel CPU проводилось с помощью perf с событием cycles:k. Это измеряет kernel side CPU затраты при открытии файла.
Граничные случаи
При использовании кэша нужно учитывать, что несколько путей могут указывать на один inode. Hardlinks — самый очевидный пример; при hardlink двум разным путям соответствует один inode. Это большая проблема, потому что точность результатов важнее производительности кэша.
Решение скорее обходное, чем полное. Inode имеют счётчик ссылок (i_nlink), показывающий, сколько путей указывает на inode. Можно прочитать его и, если значение больше 1, не использовать запись из кэша, вернувшись к slow path:
if (BPF_CORE_READ_INTO(&nlink, inode, i_nlink)) {
    return false;
}

if (nlink != 1) {
    inode_cache_stats_inc(INODE_CACHE_STATS_SKIPS_NLINK);
    return false;
}
Это компромисс — теряется часть охвата кэша, но точность кэша важнее всего.
Итоги
Это была интересная работа, потому что пришлось перебрать несколько идей для кэша, прежде чем найти оптимальное решение.
Кроме того, кэш полностью внутренний, поэтому пользователям не нужно менять политики для ускорения agent — всё работает прозрачно.