Как LLM, модели рассуждений и агенты связаны между собой
Модель рассуждений — это, по сути, улучшенная версия обычного LLM, в которую добавлено дополнительное постобучение через обучение с подкреплением с проверяемыми вознаграждениями (и опционально методы масштабирования на этапе вывода) для решения более сложных задач. Классически модели рассуждений разрабатываются для математики и кода, но возможности могут обобщаться и на другие предметные области.
Модель рассуждений функционирует в качестве ядра внутри架构 агента, где сама架构 агента — это программное обеспечение или фреймворк инструментов вокруг LLM/модели рассуждений для решения еще более сложных задач (крупные задачи кодирования, бронирование путешествий и другие задачи персональных помощников). Архитектура занимается сложным управлением контекстом и предоставлением LLM доступа к инструментам.
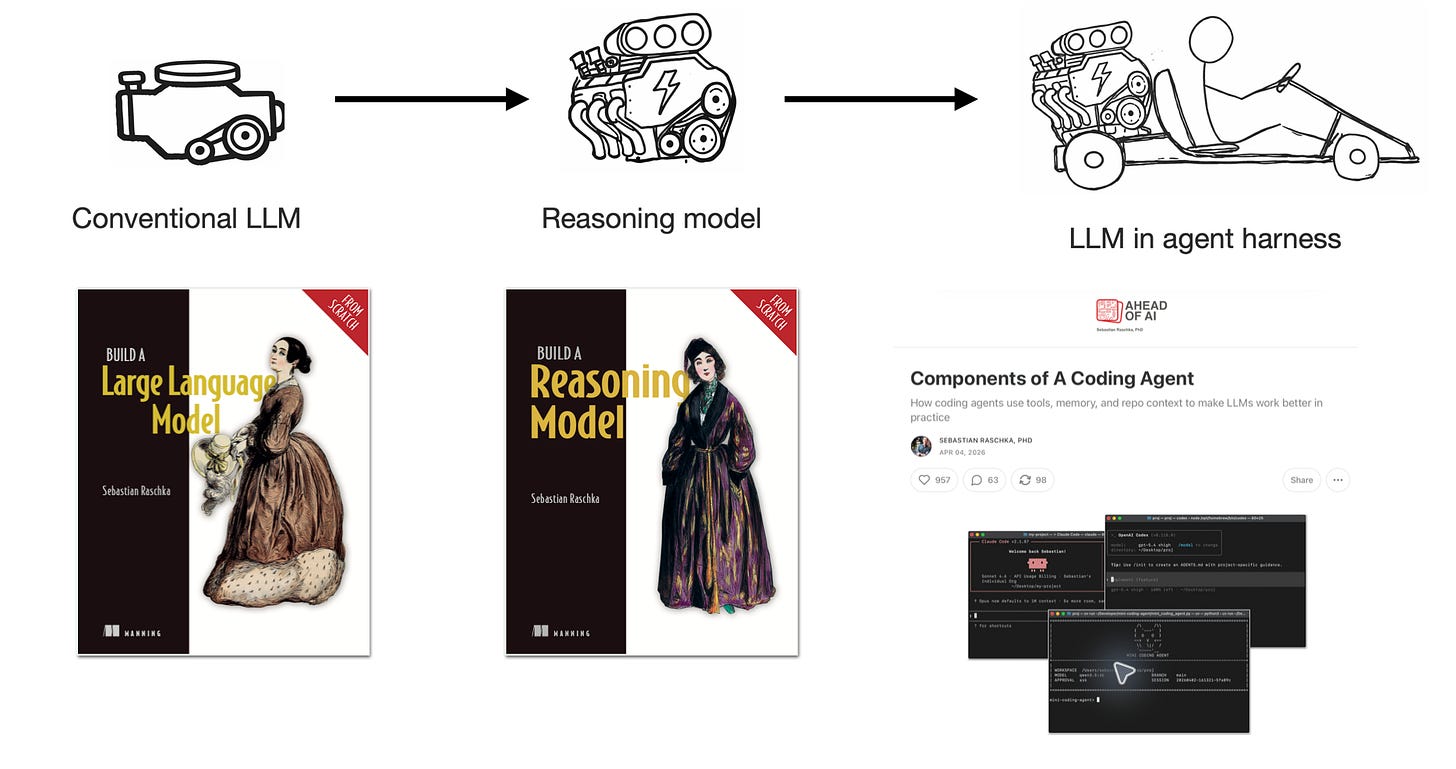
Рисунок 1: Аналогия двигателя для обычных LLM, моделей рассуждений и архитектур агентов. Рисунок из статьи Components of a Coding Agent.
В этой аналогии, представленной на рисунке выше, модель — это двигатель, а архитектура агента добавляет механизмы, которые позволяют использовать его в различных целях (как улучшение простого интерфейса чатбота). Агент может использовать как обычный LLM, так и модель рассуждений, но последние являются более типичным выбором, так как обладают большей производительностью. (Как упоминалось выше, большинство современных LLM — это модели рассуждений с настраиваемыми уровнями затрат на размышление.)
Итак, суть в том, что модели рассуждений как «двигатель» остаются важной частью понимания современных агентов на основе LLM.
Ресурсы, сопровождающие эти темы:
Книга Build a Large Language Model (From Scratch) и видеолекции
Книга Build A Reasoning Model (From Scratch) (Manning) (и видеолекции ниже)
Статья Components of a Coding Agent на Substack
Видеолекции ниже сосредоточены на разработке модели рассуждений, которая может питать такую систему.
Область охвата и требования
Видеолекции о разработке с нуля сосредоточены на небольшой предтренированной модели Qwen3, где методы рассуждений реализуются с нуля на Python и PyTorch. Начало с предтренированной модели позволяет сосредоточиться на интересной части: оценке, масштабировании на этапе вывода, обучении с подкреплением и дистилляции.
Что касается требований, рекомендуется быть уверенным в Python и PyTorch. Материалы о разработке с нуля разработаны как самостоятельный контент, поэтому предыдущий материал из курса Build A Large Language Model (From Scratch) рекомендуется, но не является строго необходимым.
С точки зрения вычислительных ресурсов, ранние примеры генерации текста и оценки можно обрабатывать на CPU. Для более поздних экспериментов, особенно обучения, GPU делает работу намного более практичной. Первое видео охватывает настройку и дополнительные рекомендации; репозиторий также включает рекомендации по оборудованию и окружению.
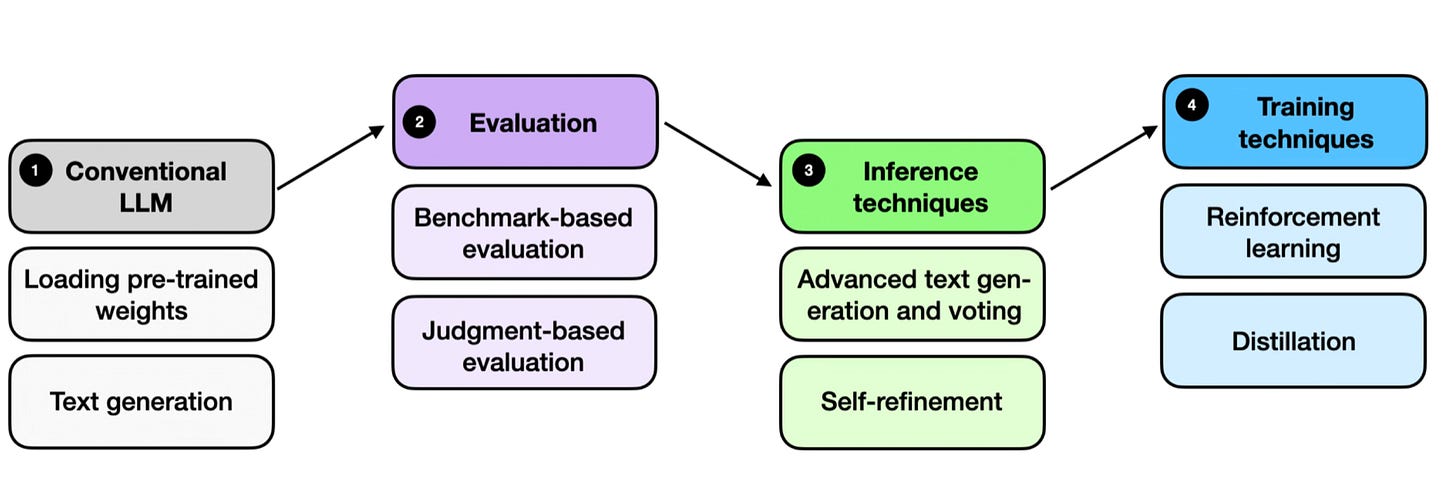
Рисунок 2: Обзор тем, охватываемых в видеокурсе.
Сопровождающая книга
Эти видеолекции сопровождают книгу Build a Reasoning Model (From Scratch). Если предпочитаете прочитать объяснения в большей деталности и в собственном темпе, поработать над упражнениями и так далее, рекомендуется книга как сопровождение.
Для наиболее углубленного опыта обучения предлагается следующий подход: прочитайте главу, поработайте через её код вместе с соответствующей видеолекцией, затем решите упражнения.
Книга доступна от Manning и Amazon, и печатное издание в цвете!
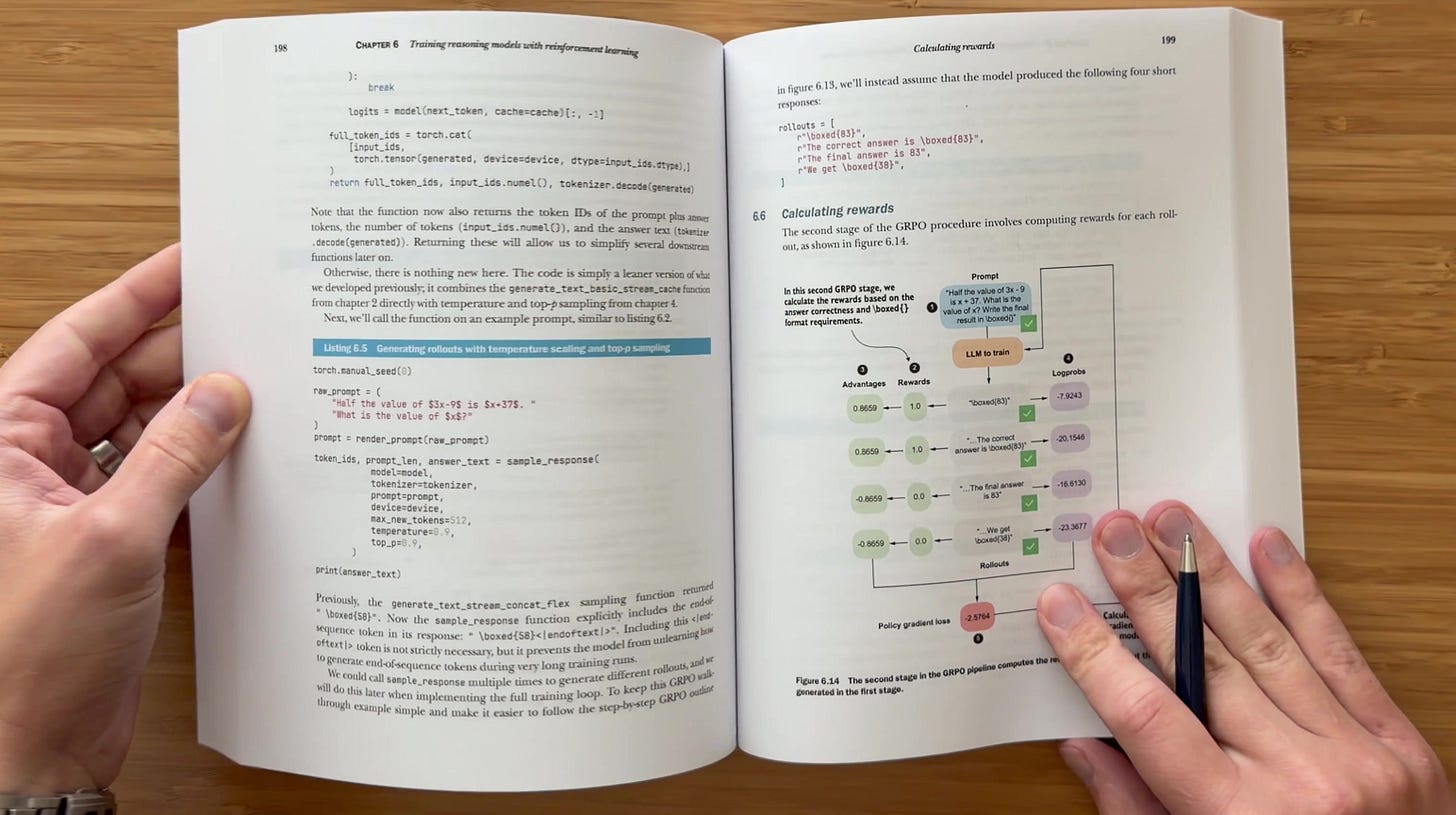
Рисунок 3: Случайный отрывок из печатной книги Build a Reasoning Model (From Scratch).
Спасибо всем, кто приобрел копию или порекомендовал её друзьям. Ваша поддержка помогает продолжить создание этих материалов.
Видеолекции
Перед началом основных видеолекций: для более краткого, концептуального обзора также рекомендуется курс AI Reasoning Models на LinkedIn Learning (он должен быть доступен бесплатно 24 часа при доступе по ссылке, что не требует подписки LinkedIn Premium).
Курс занимает около 90 минут и объясняет, как работают модели рассуждений, охватывая основные идеи масштабирования на этапе вывода, обучения с подкреплением и дистилляции. Это хороший необязательный предпросмотр, если хотите понять основные идеи без полной реализации ниже.
Вот восемь основных видеолекций.
1. Мотивация и настройка кода
Первое видео начинается с объяснения связи между обычными LLM, моделями рассуждений и архитектурами агентов. Далее, основной темой видео является настройка среды кодирования. Включает установку зависимостей Python и PyTorch (с uv) и другое. Также обсуждаются выбор оборудования и распространённые проблемы настройки.
Охватываемые темы
Связь между обычными LLM, моделями рассуждений и архитектурами агентов
О преимуществах обучения через реализацию кода
Область охвата этой серии видео
Установка зависимостей Python
Выбор оборудования и проверка поддержки CUDA или Apple Silicon
Использование удаленного GPU с VS Code и устранение проблем окружения
Смотреть видео 1 · Инструкции по настройке
2. Загрузка базовой модели, генерация текста и KV кеширование
Перед добавлением методов рассуждений в предстоящих видеолекциях нужна работающая базовая модель. Вместо обучения с нуля, что было бы отдельной книгой (см. Build A Large Language Model (From Scratch)), начинаем с предтренированной модели.
Загружаем предтренированные веса модели Qwen3 0.6B. Затем реализуем процесс генерации текста через генератор потоковой текста и добавляем KV кеширование и компиляцию модели для повышения эффективности генерации текста.
Эти реализации дают нам базовую линию и компоненты базы, которые будут оценены и улучшены в следующих видеолекциях.
Охватываемые темы
Кодирование текста в токены и декодирование обратно в текст
Загрузка весов Qwen3 и загрузка модели на выбранное вычислительное устройство
Обзор форм тензоров, логитов и прогнозов следующего токена
Реализация жадного декодирования и потоковой генерации текста
Обработка токенов конца последовательности и измерение скорости генерации
Добавление KV кеша для переиспользования ключей и значений внимания
Комбинирование KV кеширования с
torch.compileи сравнение производительности оборудования
Смотреть видео 2 · Код главы 2
3. Построение верификатора для оценки и обучения с подкреплением
На этой лекции пошагово строим математический верификатор ответов, от извлечения ответа до нормализации и проверки математической эквивалентности. Затем используем его для оценки модели на MATH-500.
Используем этот верификатор для оценки производительности базовой модели на наборе данных MATH-500.
Однако верификатор имеет и вторую роль дальше в серии: обеспечение сигнала вознаграждения для обучения с подкреплением с проверяемыми вознаграждениями (RLVR).
Охватываемые темы
Введение в верификаторы и как они вписываются в методы оценки LLM (другие методы охватываются в приложении книги)
Переиспользование проверки ответов как сигнала вознаграждения для RLVR (подробнее в главе 6)
Поток верификатора, включая извлечение финальных ответов, нормализацию ответов и проверку математической эквивалентности
Построение классификатора ответов и цикла оценки для MATH-500
Сравнение базовых и моделей рассуждений на MATH-500
Смотреть видео 3 · Код главы 3
4. Масштабирование на этапе вывода: sampling и self-consistency
Теперь изучаем способы улучшения ответов, сохраняя веса модели фиксированными. Но перед реализацией специфических техник масштабирования вывода, сначала реализуем методы для генерации разнообразных ответов из одного запроса (это стандартная практика в собственных LLM чатботах, таких как ChatGPT).
Конкретно реализуем масштабирование температуры, мультиномиальный sampling и фильтрацию top-p для генерации разнообразных ответов. Затем комбинируем несколько ответов через self-consistency, используя голосование большинством по их финальным ответам.
Также изучаем компромисс между точностью ответа и дополнительными вычислениями, необходимыми для генерации большего количества кандидатов.
Охватываемые темы
Сравнение того, как дополнительные вычисления улучшают производительность модели во время обучения и во время вывода
Нежное введение в масштабирование вывода через цепочку рассуждений
Реализация масштабирования температуры и мультиномиального sampling для генерации разнообразных ответов
Добавление фильтрации top-p для контроля качества разнообразных ответов
Комбинирование ответов кандидатов через self-consistency, одну из самых популярных техник масштабирования вывода
Оценка точности MATH-500 относительно стоимости дополнительных вычислений вывода
Смотреть видео 4 · Код главы 4
5. Масштабирование на этапе вывода: scoring и self-refinement
Опираясь на предыдущее видео, реализуем функции scoring для сравнения нескольких ответов, сгенерированных из одного запроса. Также можно использовать эти методы scoring для разрешения ничьих в self-consistency (охватываемые в предыдущей лекции).
Методы scoring, охватываемые здесь, включают вычисление логарифмических вероятностей токенов и последовательностей (это также будет актуально в следующих главах обучения с подкреплением). Затем реализуем цикл self-refinement, в котором модель критикует ответ и пытается его переделать.
Оценка позволяет проверить, насколько полезны эти дополнительные шаги для нашей модели.
Охватываемые темы
Использование функций scoring для сравнения нескольких ответов и разрешения ничьих
Реализация простого эвристического scorer'а
Вычисление вероятностей токенов и правдоподобия последовательностей (также актуально для следующих лекций)
Использование логарифмических вероятностей для улучшенной численной стабильности
Построение цикла self-refinement для генерации критик и пересмотренных ответов
Оценка self-refinement на MATH-500
Смотреть видео 5 · Код главы 5
6. Обучение с подкреплением: реализация GRPO для RLVR
На этой лекции переходим к реализации техники обучения, называемой Reinforcement Learning with Verifiable Rewards (RLVR). Сначала реализуем упрощённую версию Group Relative Policy Optimization (GRPO), генерируем группы ответов, оцениваем их нашим верификатором и используем их относительные вознаграждения для обновления весов модели во время обучения.
Охватываемые темы
Генерация цепочек рассуждений и понимание взаимосвязи между длиной ответов и способностями решения проблем
Обсуждение и сравнение двух важных методов постобучения LLM: Reinforcement Learning with Human Feedback (RLHF) и Reinforcement Learning with Verifiable Rewards (RLVR)
Преобразование оценок верификатора в вознаграждения и относительные преимущества
Вычисление логарифмических вероятностей последовательностей и упрощённой потери GRPO
Сборка цикла обучения с логированием и сохранением контрольных точек
Оценка контрольных точек и проверка стабильности обучения и потребностей в памяти
Смотреть видео 6 · Код главы 6
7. Обучение с подкреплением: отслеживание, clipped policy ratios и KL термины
Теперь, когда реализовали цикл обучения в предыдущей лекции, можем пересмотреть его и проанализировать запуски обучения более детально.
Конкретно, это видео добавляет больше метрик обучения для проверки и анализа, включая статистику энтропии и преимуществ, clipped policy ratios, значения KL loss term и форматированные вознаграждения.
Затем пересматриваем логи обучения и результаты оценки, чтобы понять, что эти добавления делают и помогают ли добавления, такие как clipped policy ratios и KL loss terms.
Охватываемые темы
Запуск более длительных экспериментов обучения и интерпретация их логов
Отслеживание преимуществ и энтропии для понимания поведения обучения
Реализация clipping в потере политики и анализ его эффектов
Добавление KL loss term и обсуждение reward hacking
Понимание ограничений упрощённой KL формулировки
Реализация format rewards и их обусловленность правильностью ответа
Сравнение контрольных точек на MATH-500 и исследование дальнейшего исследования GRPO
Смотреть видео 7 · Код главы 7
8. Дистилляция модели рассуждений
Наконец, изучаем ещё один способ обучения небольшой модели рассуждений, то есть обучение на ответах, сгенерированных более мощной (и большей) учительской моделью. Обсуждаем различные формы дистилляции, подготавливаем данные рассуждений и реализуем цикл обучения под наблюдением.
Завершаем эту лекцию и курс оценкой дистиллированной модели на MATH-500 и сравнением результатов. Это завершает серию альтернативой для разработки способностей рассуждений через обучение с подкреплением.
Охватываемые темы
Сравнение различных комбинаций и подходов к дистилляции, включая мягкую и жёсткую дистилляцию, and on-policy and off-policy дистилляцию
Создание и сбор ответов, сгенерированных учителем, для набора данных MATH (используя DeepSeek R1)
Подготовка набора данных дистилляции, включая токенизацию и разбиение train/validation/test
Вычисление логарифмических вероятностей токенов ответов и понимание потери cross-entropy
Реализация обучения под наблюдением и отслеживание потерь обучения и валидации
Оценка контрольных точек на MATH-500 и сравнение результатов дистилляции
Смотреть видео 8 · Код главы 8
Заключительные слова
При просмотре этих лекций поощряется время от времени ставить на паузу и попробовать небольшой собственный эксперимент, если что-то интересное приходит в голову.
Например, чувствуйте себя свободно менять параметры sampling, проверять несколько неудачных ответов или пробовать вариации различных идей, похожие на предложения в упражнениях.
Если хотите полный письменный разбор, рисунки и упражнения вместе с видео, можно найти Build a Reasoning Model (From Scratch) на Manning и Amazon.
Спасибо за чтение и поддержку Ahead of AI. Беру короткий перерыв для восстановления и жду вернуться со следующим раундом статей об исследованиях LLM в следующем месяце.
А пока — приятного просмотра и творчества!