Возможности модели
Beam разработана с особым упором на кодирование и агентные задачи. Модель продвигает границу открытых моделей на Западе и конкурентна с более крупными открытыми моделями вроде GLM 5.2, приближаясь к Qwen 3.8-Max по кодированию и агентным задачам. Там, где передовые открытые модели вроде Kimi K3 остаются впереди по абсолютной производительности, преимущество Beam — эффективность на этапе инференса.
На приведённой ниже таблице показана производительность Beam по кодированию, агентным задачам, рассуждениям и тестам STEM. NR обозначает результаты, которые не были опубликованы.
| Тест | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 44.4 | NR | NR | 44.0 | 61.0 | 68.0 | 51.0 | 74.2 |
| SWE Bench Pro v2-Hard | 77.2 | 56.9 | NR | NR | 84.3 | 88.2 | NR | NR |
| SWE Bench Pro v1 | 65.5 | 54.3 | 46.4 | 62.1 | NR | NR | 67.7 | NR |
| Terminal Bench v2.1 | 80.1 | 63.8 | 56.4 | 81.0 | 88.2 | 88.3 | 86.6 | 90.6 |
| SWE Atlas Codebase QnA | 34.6 | NR | NR | NR | 61.0 | 68.0 | NR | NR |
| SWEBench Multilingual | 78.0 | NR | 67.7 | NR | NR | NR | NR | NR |
| SWEBench Verified | 80.9 | 77.6 | 70.7 | NR | NR | NR | NR | NR |
| Тест | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| AIME 2026 | 97.8 | 97.1 | NR | 99.2 | NR | NR | NR | NR |
| HLE no tools | 36.2 | 29.7 | 26.7 | 40.5 | 42.3 | 46.9 | 43.6 | 39.1 |
| SciCode | 49.7 | 46.1 | 44.6 | NR | 59.0 | 58.7 | 52.1 | 52.0 |
| CriPT AA | 16.3 | 5.4 | 3.1 | 20.9 | 19.1 | 23.4 | 20.0 | 14.3 |
| GPQA Diamond | 90.5 | 87.2 | 87 | 91.2 | 91.7 | 93.5 | 92.6 | 90.9 |
| Тест | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| AutomationBench public | 37.0 | NR | NR | 26.2 | 48.2 | 46.7 | 39.8 | 54.8 |
| MCP Atlas | 78.7 | 76.0 | 63.1 | 77.8 | 84.2 | 82.3 | 84.5 | NR |
| tau3 banking | 38.0 | 25.0 | 22.6 | 37.1 | NR | 37.1 | 55.2 | NR |
| BrowseComp w/ context management | 77.4 | 77.1 | 44.4 | NR | NR | 91.2 | NR | NR |
| DeepSearchQA w/context management | 80.1 | NR | NR | NR | NR | 95.0 | NR | NR |
| Тест | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|---|
| AA-LCR | 79.3 | 77.3 | 79.3 | 78.3 | 79.7 | 88.7 | 80.3 | 84.0 |
| LongBench v2 | 65.5 | NR | 61.9 | 64.0 | NR | NR | 66.3 | NR |
| IFBench | 79.7 | 79.8 | 81.7 | 73.3 | NR | NR | 82.8 | NR |
| AA Omniscience (index) - public split only | 13.0 | 14.2 | 8.6 | NR | 22.6 | NR | NR | 6.6 |
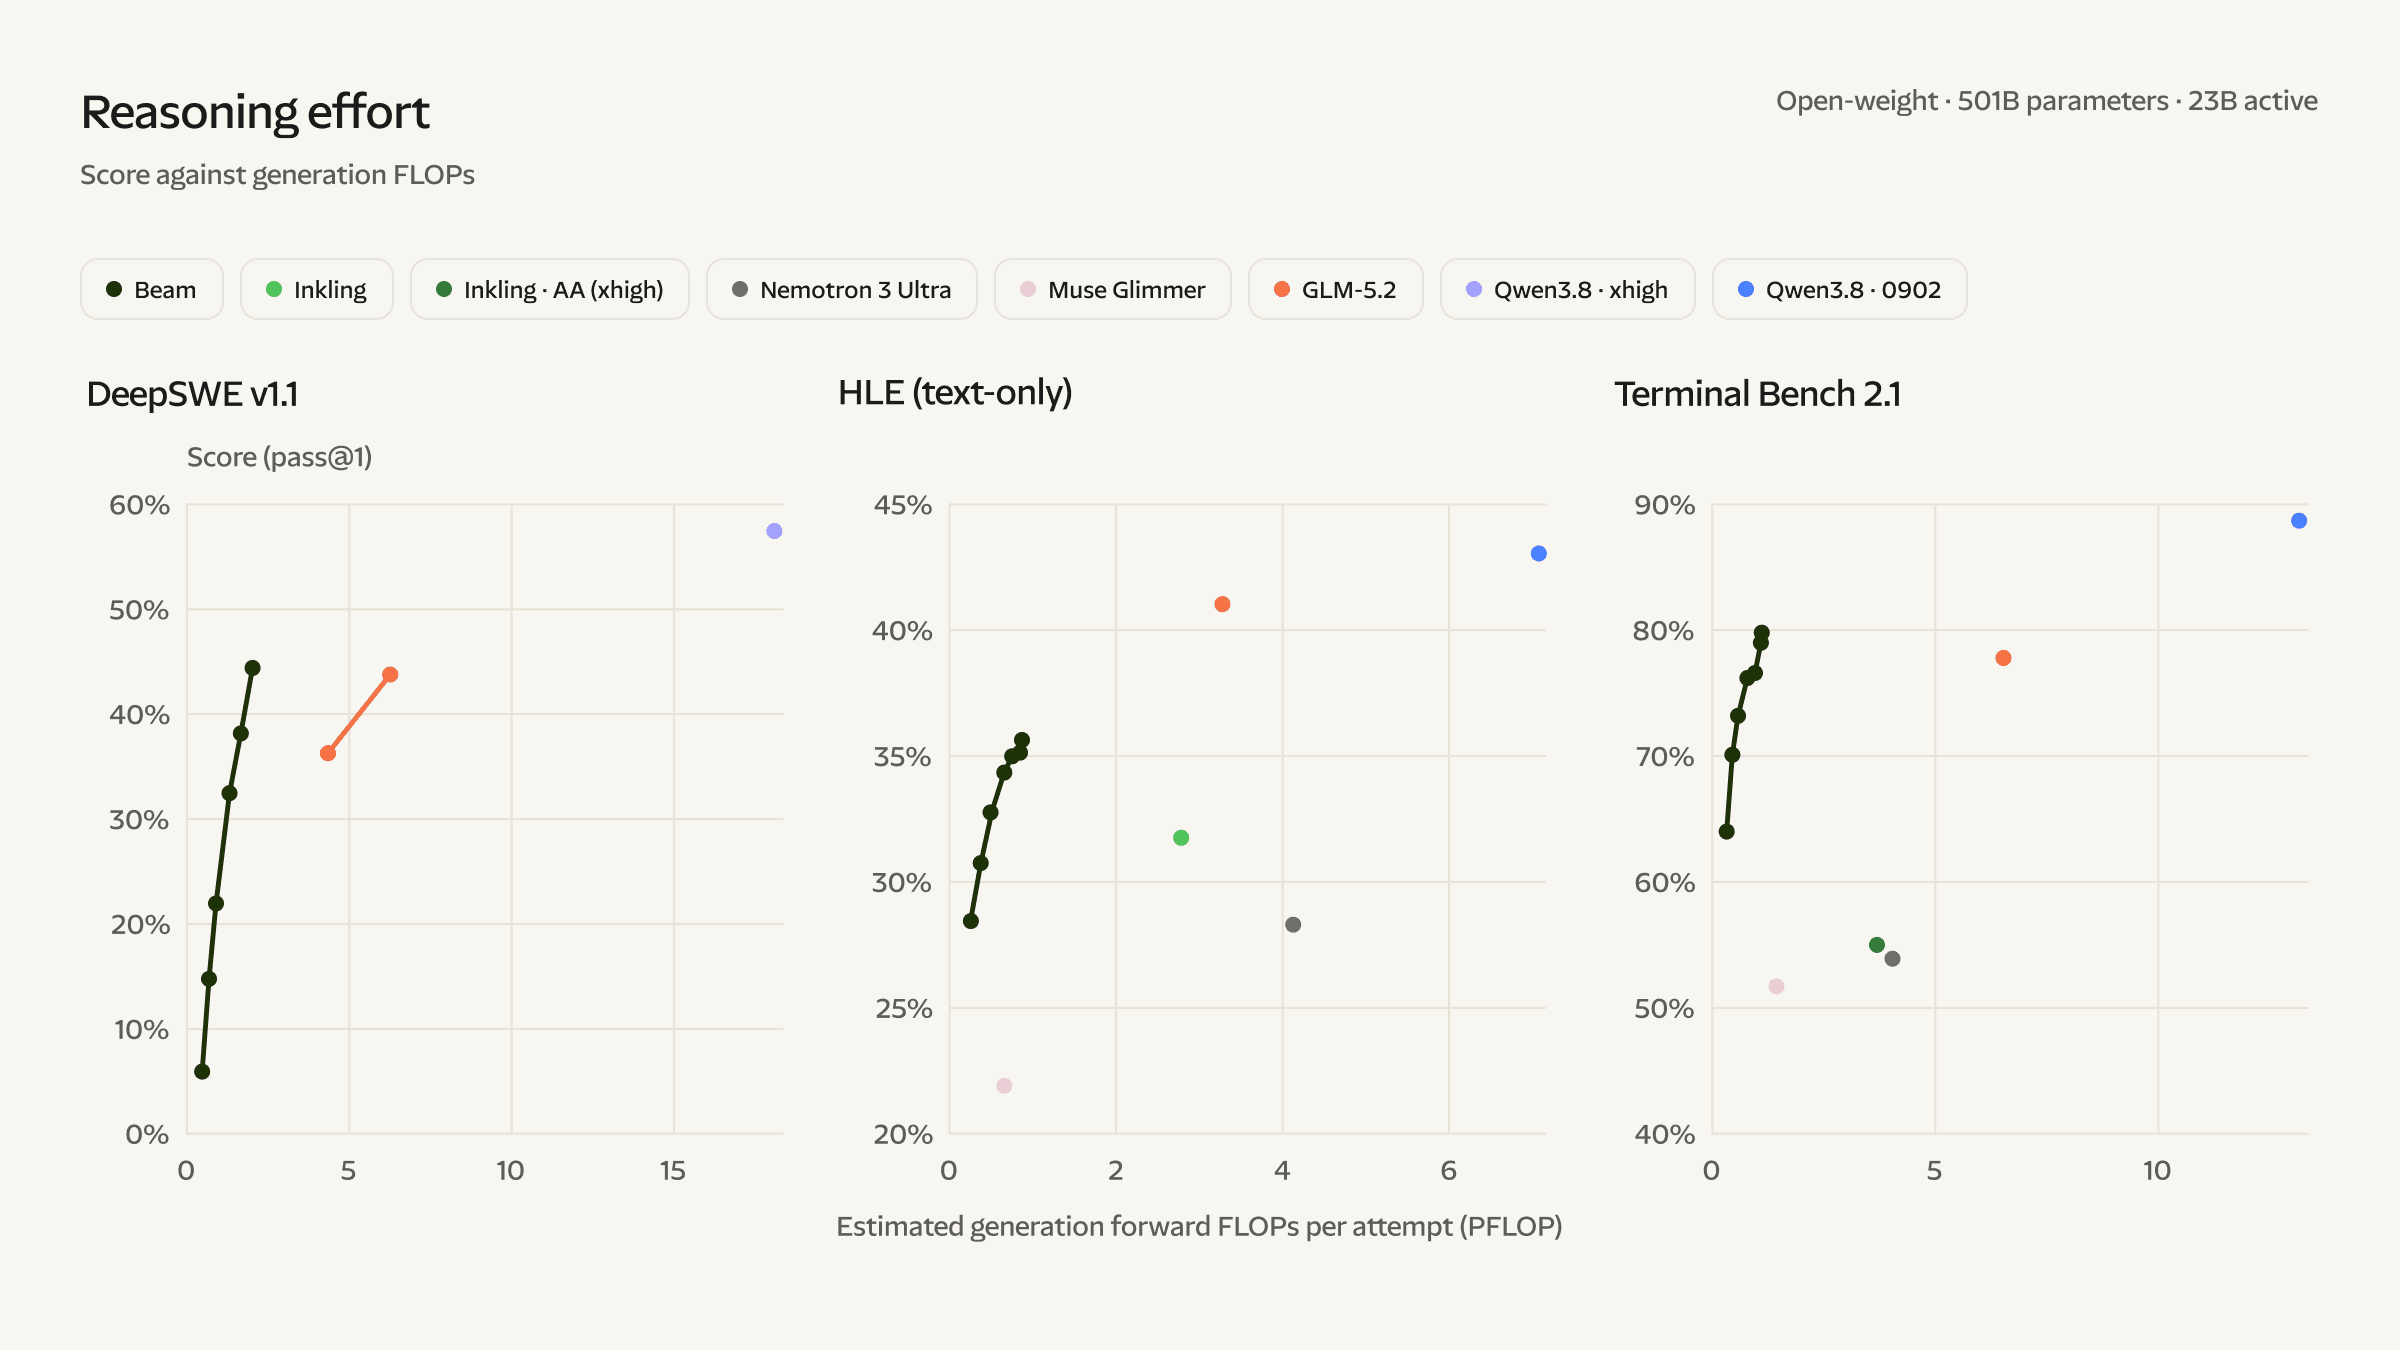
Beam сочетает способности кодирования и агентные возможности с высокоэффективным рассуждением. На продвинутых тестах рассуждений модель показывает результаты, сравнимые с GLM-5.2, но использует при этом в 3–4 раза меньше вычислений инференса. Выигрыш в эффективности ещё более заметен при сравнении с моделями в семействе 2T+ параметров вроде Qwen 3.8-Max, требующими значительно больше вычислений на токен.
Эти результаты переводятся в большую «интеллектуальность на токен», обеспечивая сильные способности модели при более низкой стоимости — именно то, что нужно для использования в корпоративных задачах кодирования и агентных рабочих нагрузок.
Обучение с подкреплением высокой сложности
Beam разработана с фокусом на обучение с подкреплением как на центральную ось масштабирования, инвестируя в науку RL, данные и инфраструктуру, чтобы преобразовать больше вычислений в более сильные способности. Масштабирование RL позволяет более обширное исследование стратегий решения проблем, а более длинные rollout'ы поддерживают многошаговое рассуждение, использование инструментов и адаптацию к обратной связи окружения.
Для масштабирования обучения с подкреплением развёрнуто 10.5K NVIDIA GB300 GPU на четыре недели, генерирующих более 100 миллионов rollout'ов с максимальной длиной контекста 256K токенов. Обучение и оценка использовали примерно 1.3 миллиарда песочниц. Для управления run'ом такого масштаба привлечено один миллион высокачественных кодирования, агентных и STEM окружений. Это один из крупнейших масштабов RL run'ов, проведённых открытой лабораторией. На всём наборе оценок способности продолжали улучшаться по мере увеличения RL вычислений, без признаков плато.
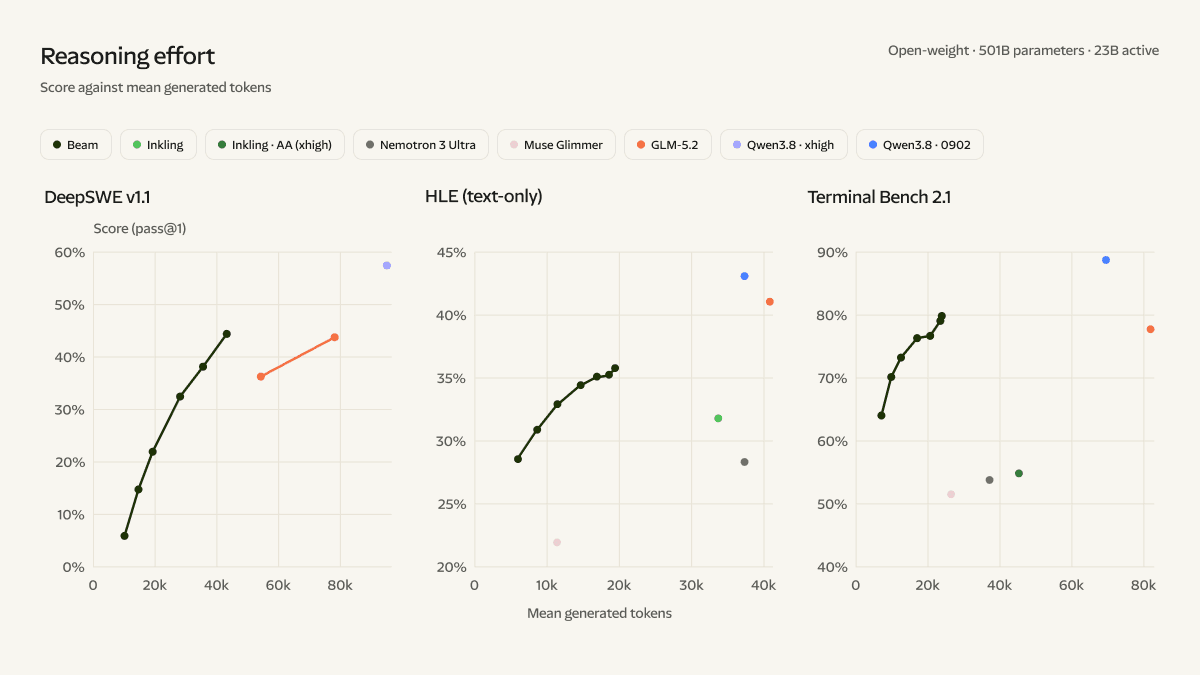
Beam обучена с использованием асинхронных градиентов политики. На таких масштабах устаревание политики становится серьёзным источником нестабильности для этих методов. Длительные rollout'ы содержат токены, генерированные несколькими контрольными точками модели, при этом более ранние токены становятся всё более устаревшими относительно текущей политики. Численное несовпадение между обучающей и инфернс-ными движками усугубляет эту проблему.
Разработаны новые алгоритмы для поддержания стабильного обучения при этих условиях, систематически снижая несовпадение между обучением и инферснсом по всему pipeline'у. Эти авансы позволяют полностью асинхронное RL в масштабе, остающееся стабильным даже при обучении на взаимодействиях, генерированных более суток назад.
Обучение эффективному рассуждению
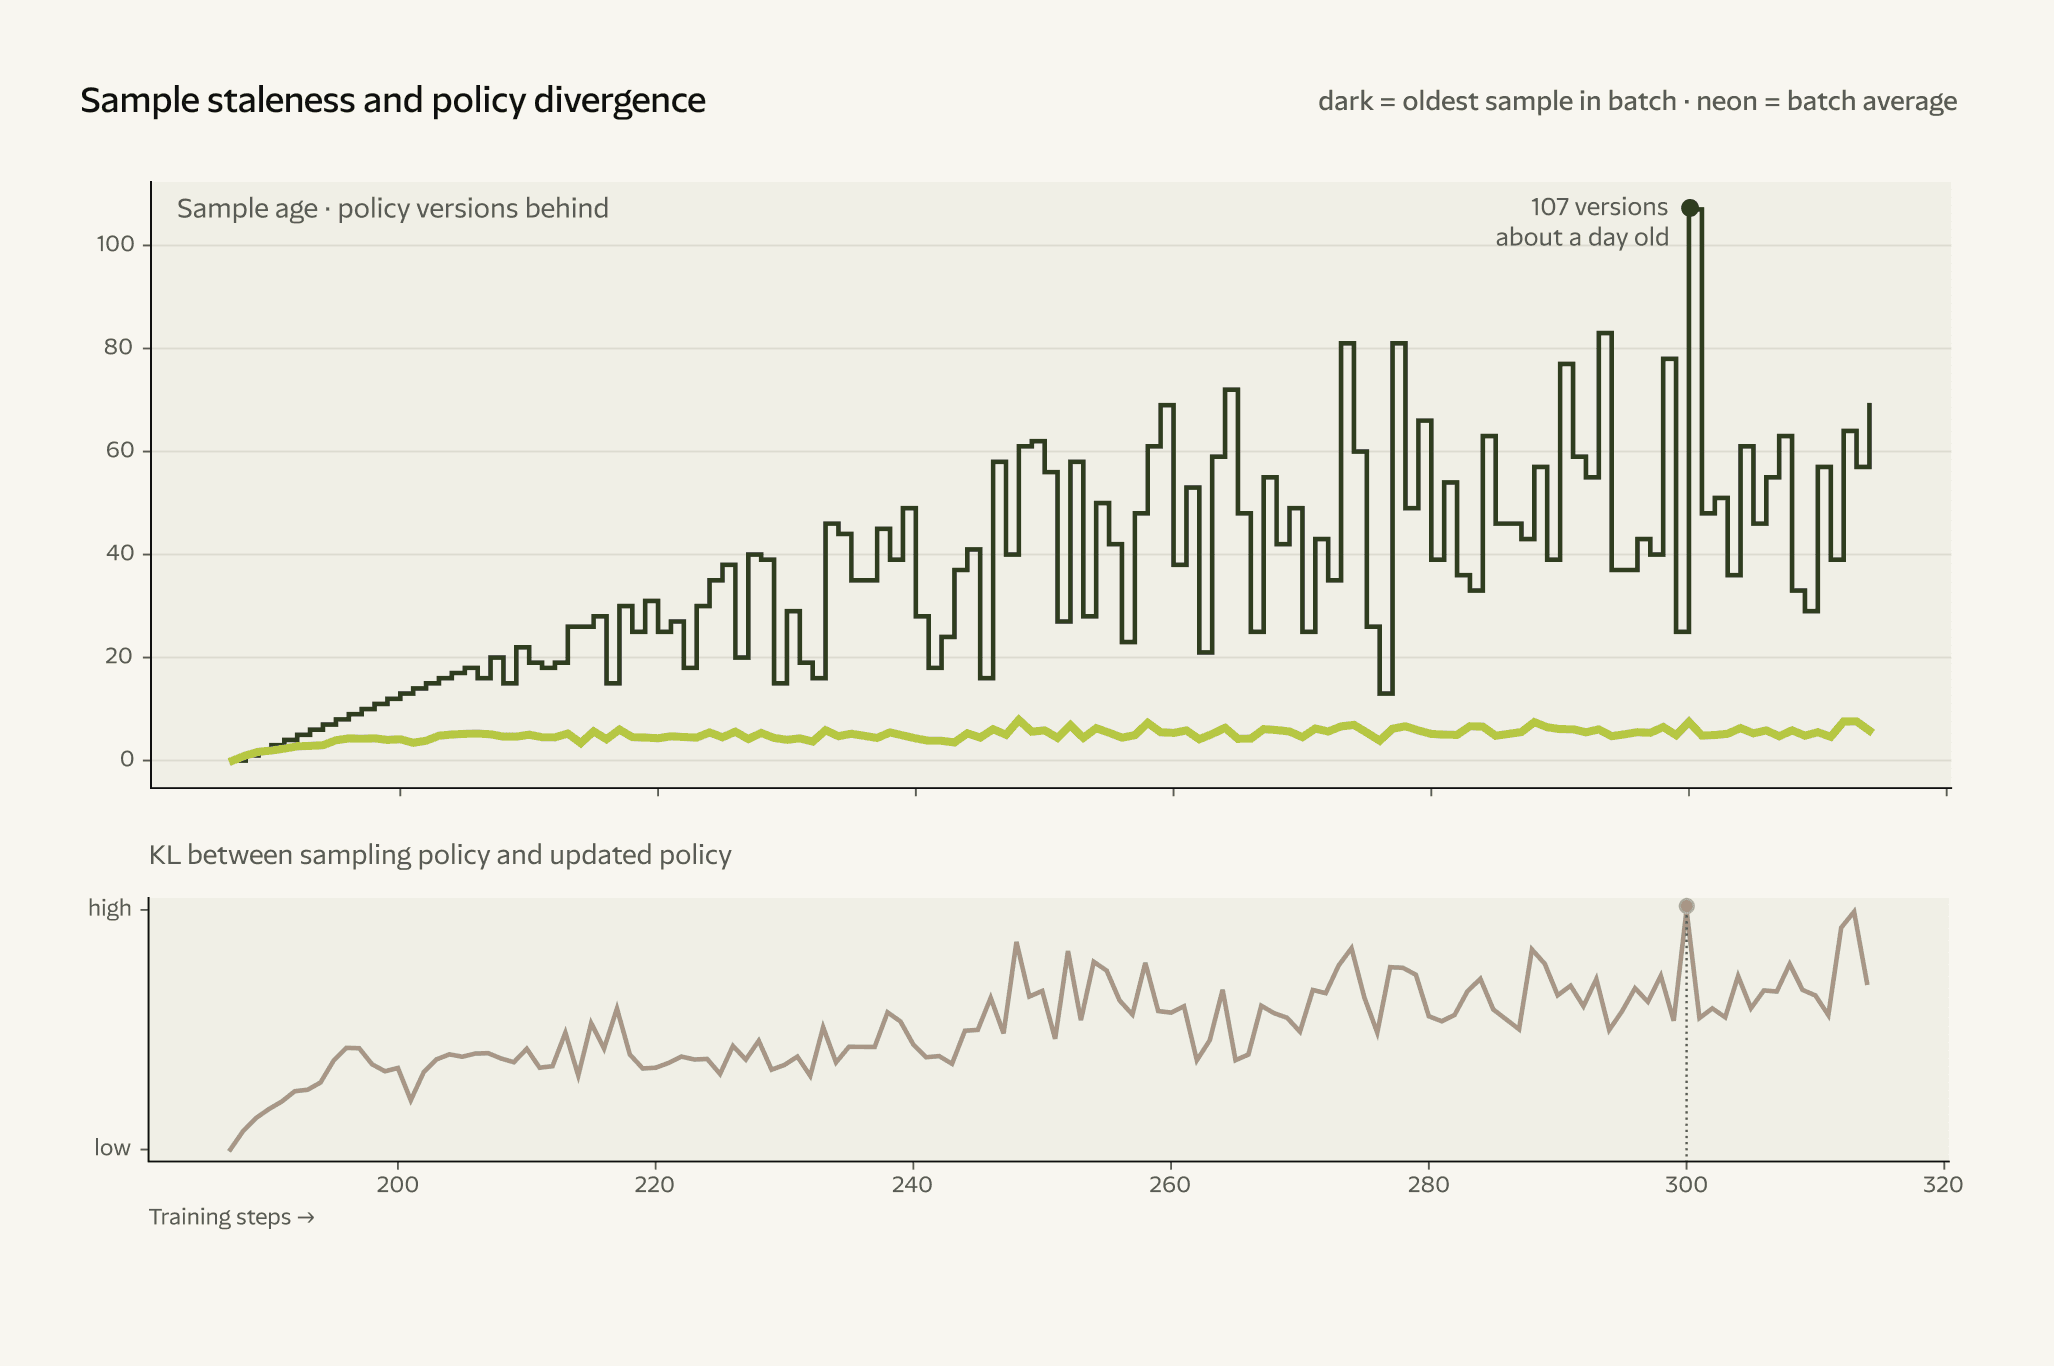
Beam обучена с управляемой штрафом за длину, вознаграждающей успешные решения и отбивающей ненужные токены. На ранних этапах RL производительность улучшалась даже при снижении длины завершения: модель научилась эффективнее решать задачи с меньшим рассуждением. Позже, по мере развития более сильных агентных способностей, длины завершения снова выросли, но эти дополнительные токены поддержали дальнейшие улучшения в производительности. На всём протяжении обучения RL улучшал компромисс между способностью и использованием токенов.
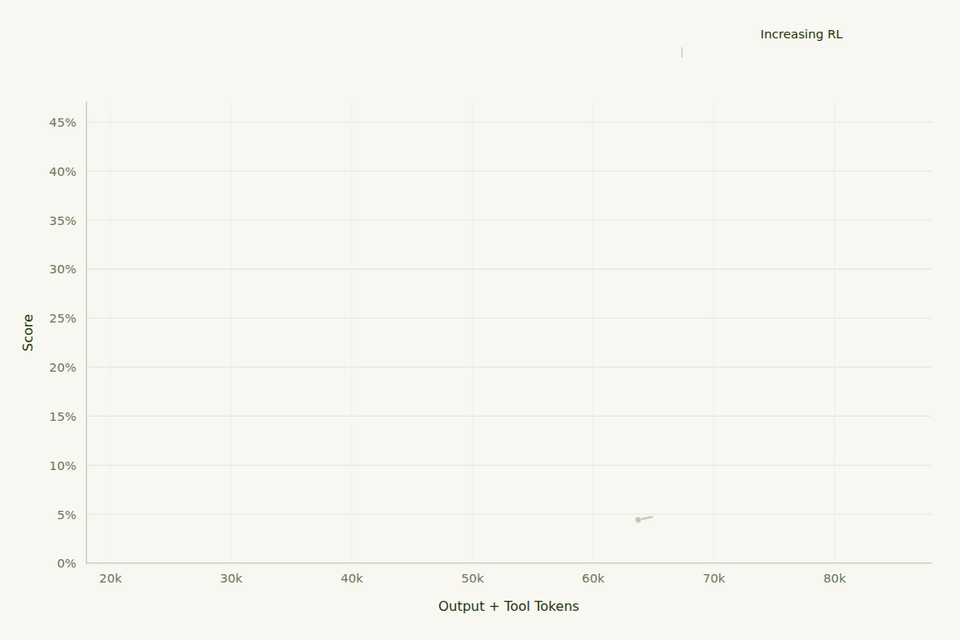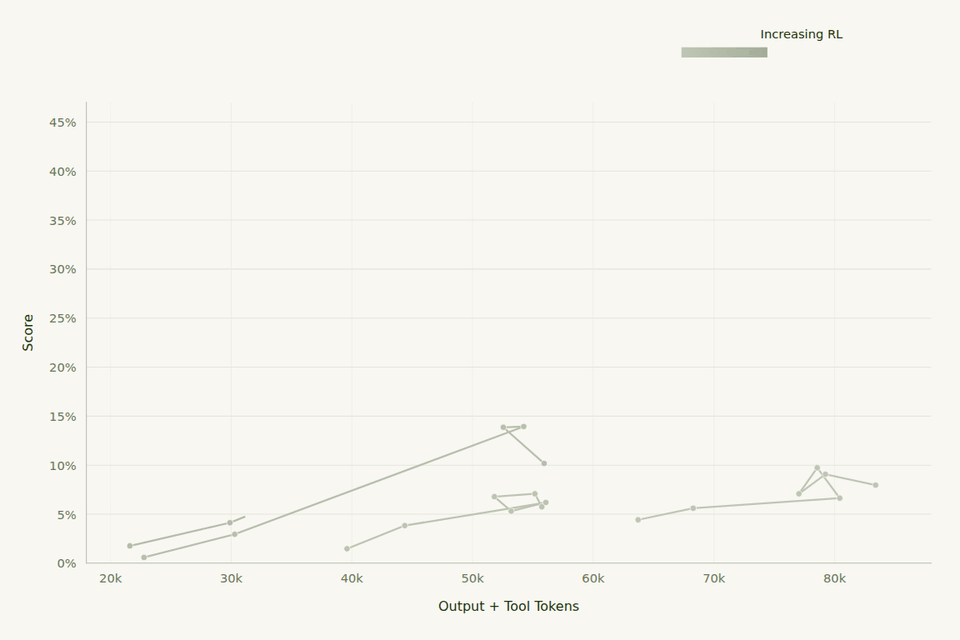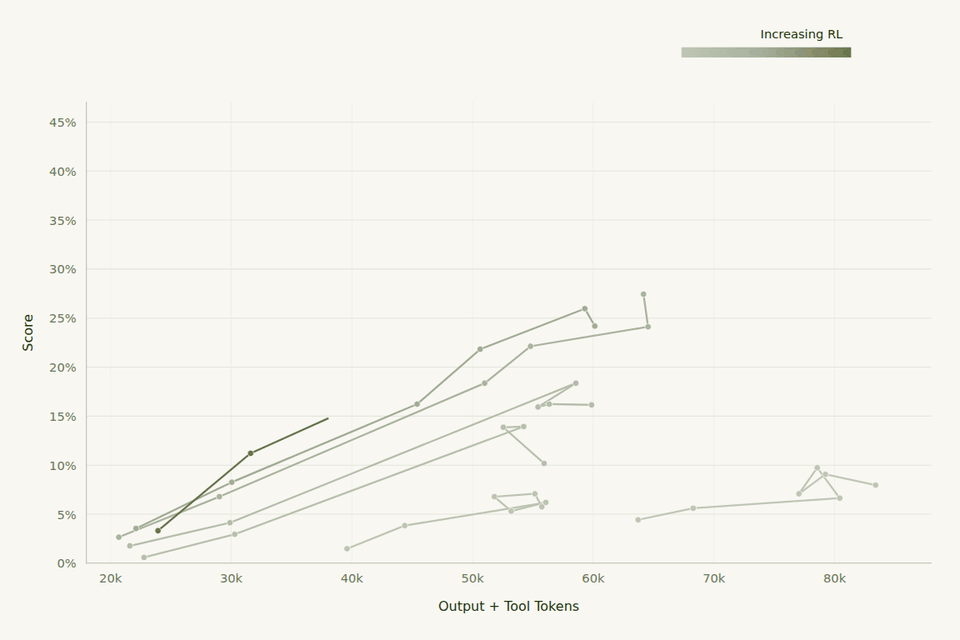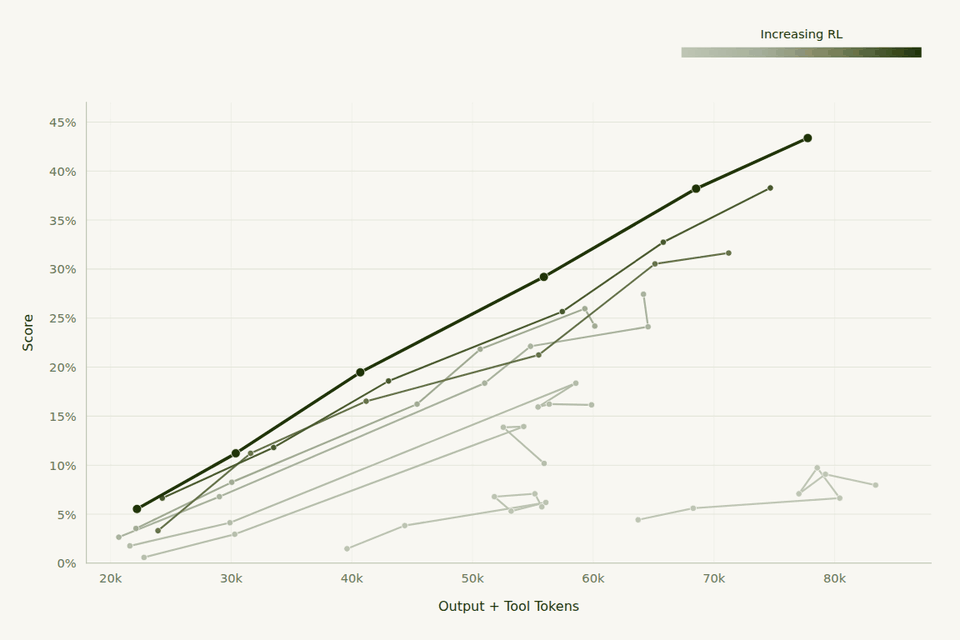
Пользователи могут управлять этим компромиссом через параметр усилия рассуждения Beam: низкие настройки благоприятствуют более коротким ответам, высокие позволяют более длинное рассуждение для повышения производительности на сложных задачах. Это даёт пользователям гибкость в выборе усилия рассуждения в соответствии с задачей и бюджетом вычислений.
Как поведение обобщается с RL
RL обучение Beam разработано так, чтобы развивать рассуждение и агентные способности, обобщающиеся за пределы обучающих задач. Во время фазы обучения на задачах рассуждения, инженерии и терминала наблюдались последовательные улучшения в просмотре несмотря на отсутствие задач просмотра в RL смеси. Это предполагает, что Beam училась более широким агентным способностям, обобщающимся через доменов. При получении доступа в интернет органически научилась искать и запрашивать другие большие языковые модели, а также использовать OCR API для чтения документов.
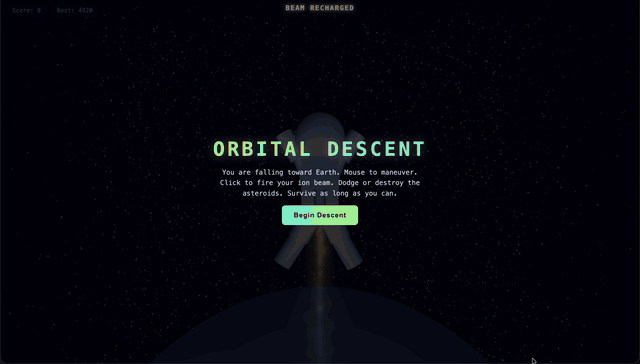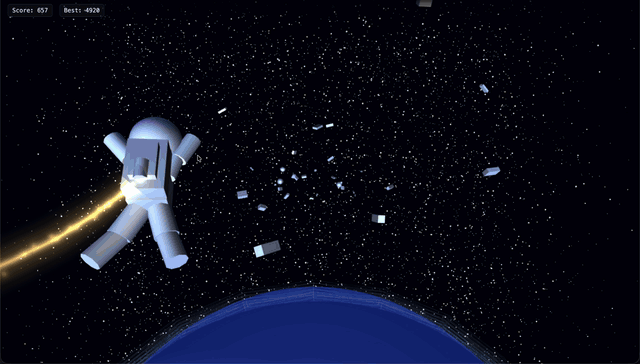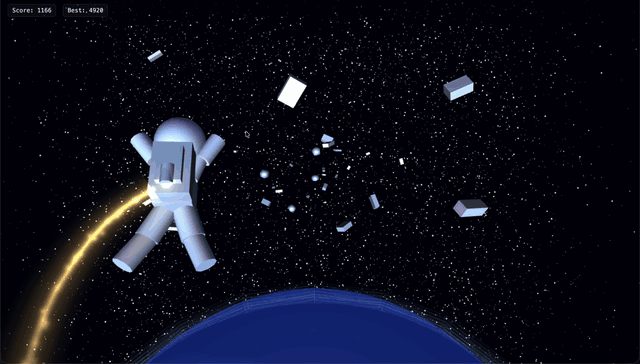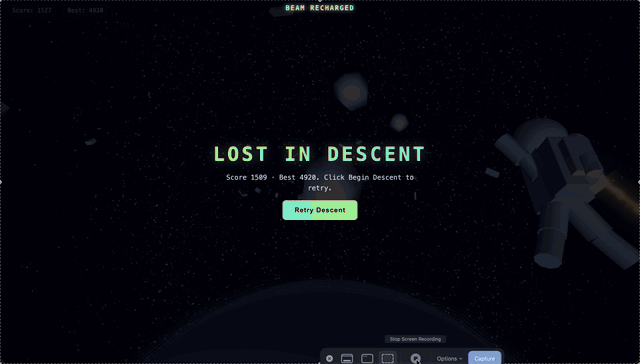
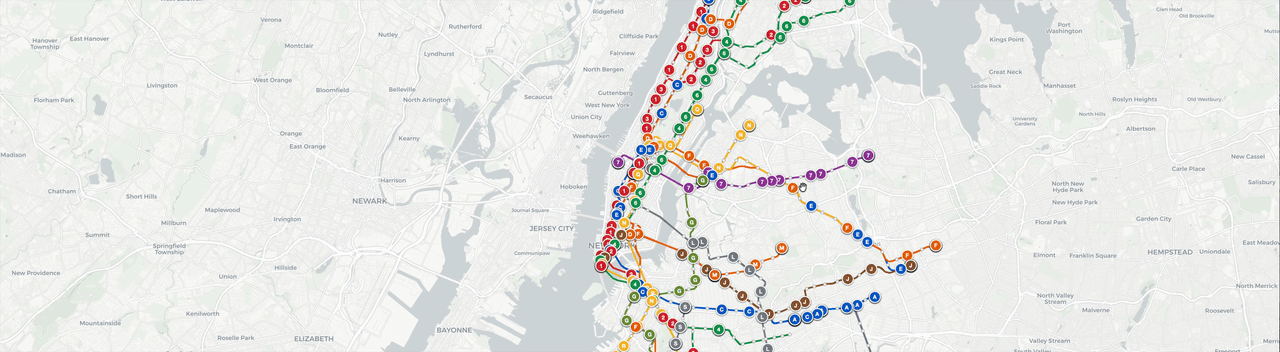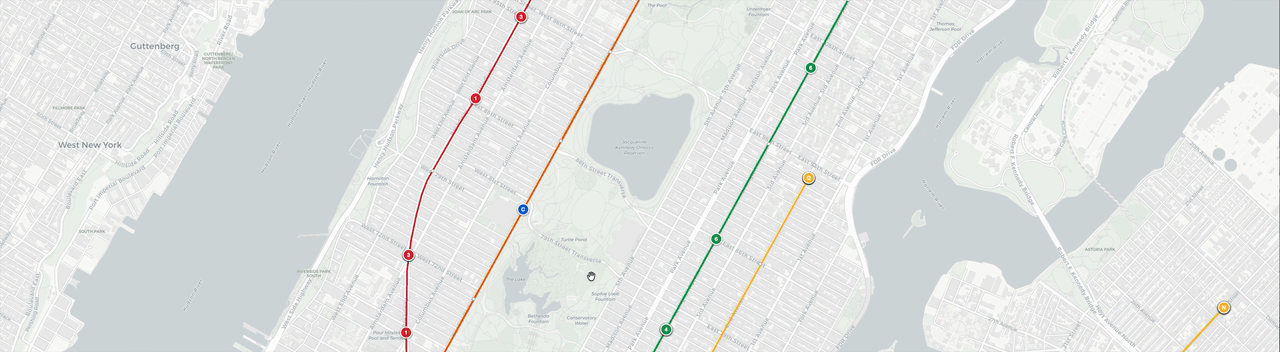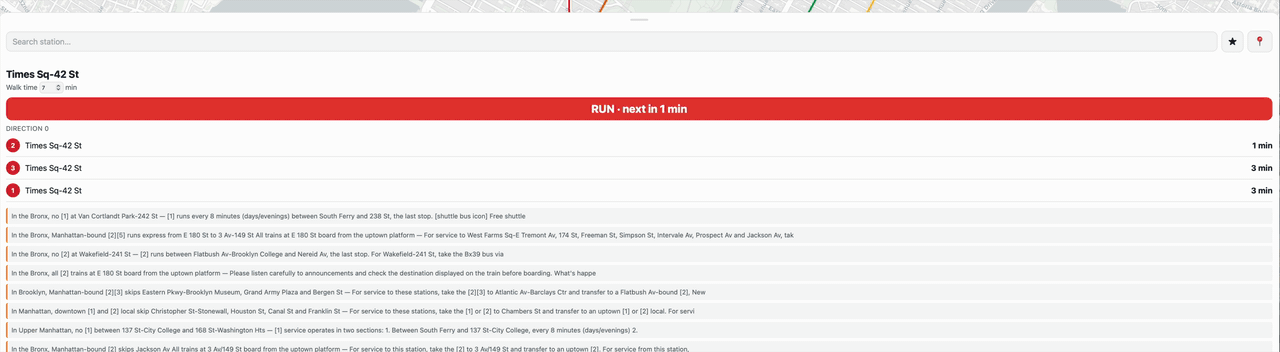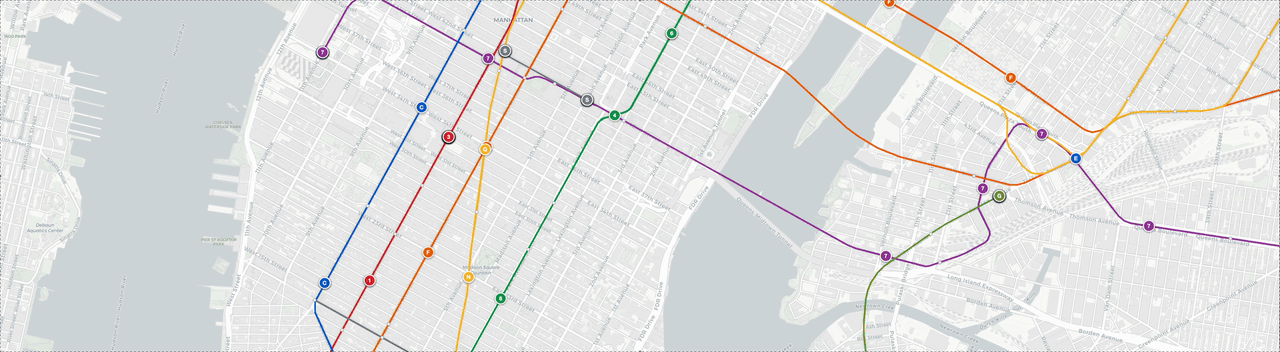
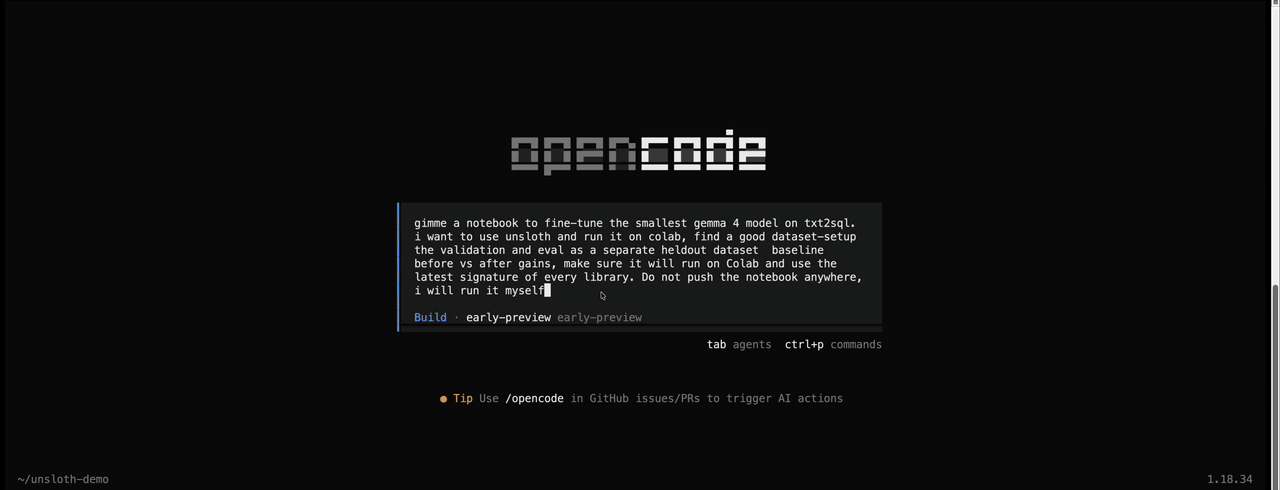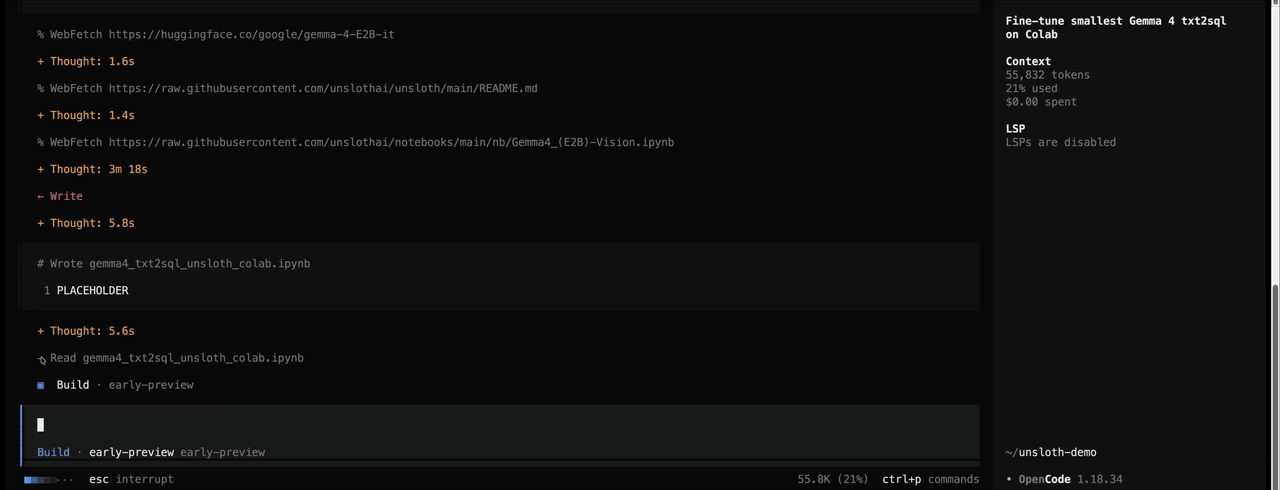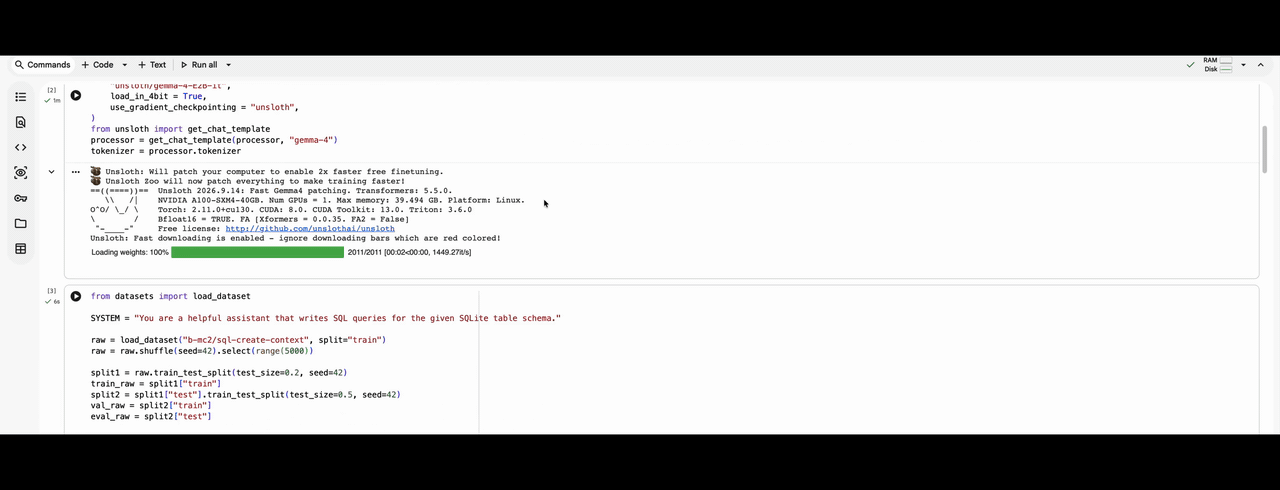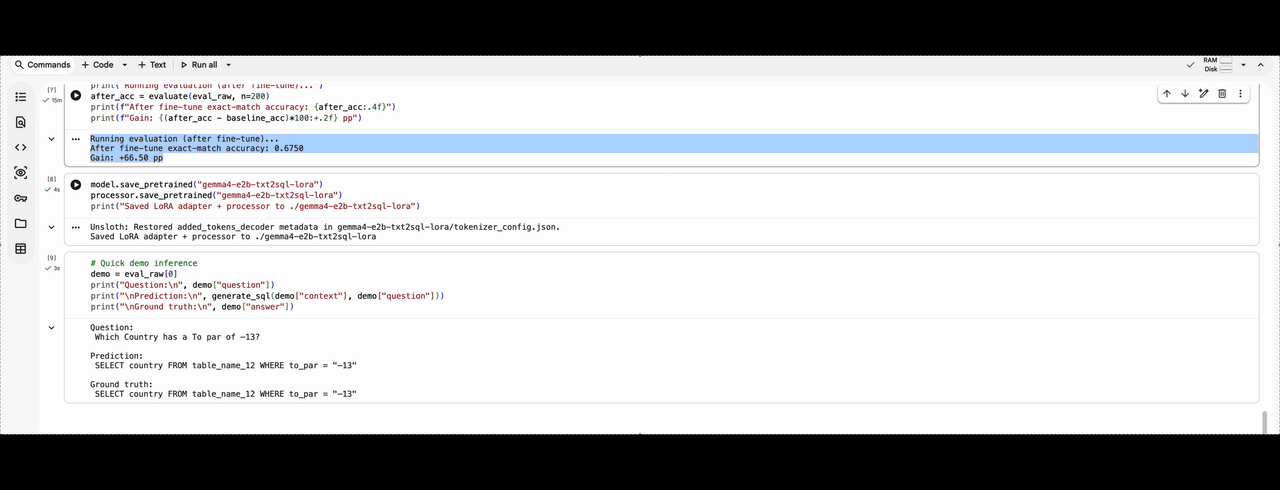
Демонстрации ниже показывают применение Beam этих способностей по исследованию, разработке приложений, игровым задачам и ML workflow'ам. Примеры варьируются от построения live NYC subway dashboard с использованием открытых данных до создания интерактивных приложений и подготовки ноутбуков для fine-tuning моделей. Хотя Beam работает только с текстом, она может работать с информацией из других модальностей когда те представлены как текст. На другом примере out-of-distribution домена Beam также создала ноутбук fine-tuning'а для самой новой и малейшей модели Gemma-4 на задаче Text2SQL.
Вместе эти демонстрации показывают широту задач, которые Beam может решать, комбинируя рассуждение, кодирование и использование инструментов. Каждый пример включает начальный запрос и результирующий вывод, вместе с релевантной установкой и итерациями пользователя.
Масштабирование сред обучения с подкреплением
Frontier-масштабное обучение с подкреплением требует большой объём сложных, высококачественных задач. Построена база почти один миллион сред, в основном через pipeline'ы синтетических данных, дополненные собственными данными поставщиков и open-source источниками.
Полагались сильно на итеративный процесс кураторства. Сначала синтезировали или привлекали среды в широком наборе доменов, включающих инженерию ПО, работу с терминалом, конкурентное кодирование, STEM, веб-поиск, использование инструментов и общую интеллектуальную работу. Во-вторых, сильно фильтровали задачи по сложности (гарантируя что они ни постоянно разрешимы, ни невозможны для модели) и качеству (например, не недоуточненные, не вводящие в заблуждение, не угадываемые, не hackaбельные, или иначе поломаны или шумны). В-третьих, тестировали задачи через RL, что позволило идентифицировать дальнейшие проблемы качества или сложности и информировать следующей итерацией sourcing'а и фильтрации.
На всём протяжении разработки Beam обнаружили что компромиссы в качестве данных привели к плато способностей и другим проблемам обучения. Систематические улучшения качества задач были существенны для поддержания выигрыша способностей на всём run'е, завершившемся без признаков насыщения.
Frontier RL инфраструктура
Высокосложное агентное RL требует генерирования rollout'ов, исполнения инструментов, оценки исходов и обновления модели в масштабе. Построена асинхронная платформа позволяющая этим процессам работать независимо при координировании потока опыта и обновлений модели.
Во время обучения Beam поддерживали в среднем 110K одновременных rollout'ов. Семь способностей сделали это практичным:
Полностью асинхронное исполнение: Агенты генерируют rollout'ы в то время как тренер обучается и публикует новые версии модели. Каждый токен помечается версией её произведшей, позволяя алгоритму обучения учитывать устаревание политики когда завершённые rollout'ы текут в обучение.
Гибкое распределение вычислений: Корректировались баланс между инферснсом и обучением по мере эволюции нагрузки, работая при соотношениях GPU инференса к тренингу от 3.9:1 до 5.4:1. Изменяли размер тренера через пять конфигураций GPU сетки в одной обучающей lineage без потери состояния обучения.
Быстрые обновления модели: Новые веса достигали инференс флота в median'е примерно 12 секунд. Иерархичное распределение передаёт веса через rack'и над RoCE, потом разделяет их локально через NVLink. По сравнению с каждой репликой напрямую pulling'ом весов, это снизило cross-rack трафик на 75% и сделало fleet-wide adoption новых весов в 2.2× быстрее.
Устойчивость к отказам инференса: Во время run'а 71 инференс incident обработаны без terminating обучающей job. Инференс ёмкость восстанавливалась в median'е восьми минут, с потеряной ёмкостью учитывающей всего 0.02% elapsed serving GPU-minutes.
Окружения в масштабе: Поддерживали вплоть до 170K одновременных песочниц во время run'а. На платформе обработали более один миллион запросов создания песочницы, охватывающих более 20 кластеров, два облака и четыре региона. 90% новых песочниц были готовы менее чем в 10 секунд.
Эффективная packing'а тренера: Динамическая packing'а держала обучающие батчи в среднем на 99.99% полными, держа пропускную способность на GPU тренера в пределах 1.5% по мере роста средней длины rollout'а почти на 70%.
Observability и целостность награды: Per-token записи позволили численные consistency checks между тренингом и инферснсом в каждом шаге. Независимые судьи повторно скринировали passing решения для verifier exploits, в то время как replayable записи сделали награды и их использование в обучении inspectable'ными.
Вместе эти способности позволили тренировать на более длинных взаимодействиях и более требовательных окружениях при поддержании пропускной способности, восстановлении от отказов и проверке целостности процесса обучения.
Pretraining как основание для рассуждения
Обучение с подкреплением стоит на основе прочной базовой модели. Для облегчения рассуждения обеспечили что основание Beam имело богатое знание в кодирующих доменах, врождённые агентные способности которые могли быть увеличены, и стабильную MoE динамику оптимизации.
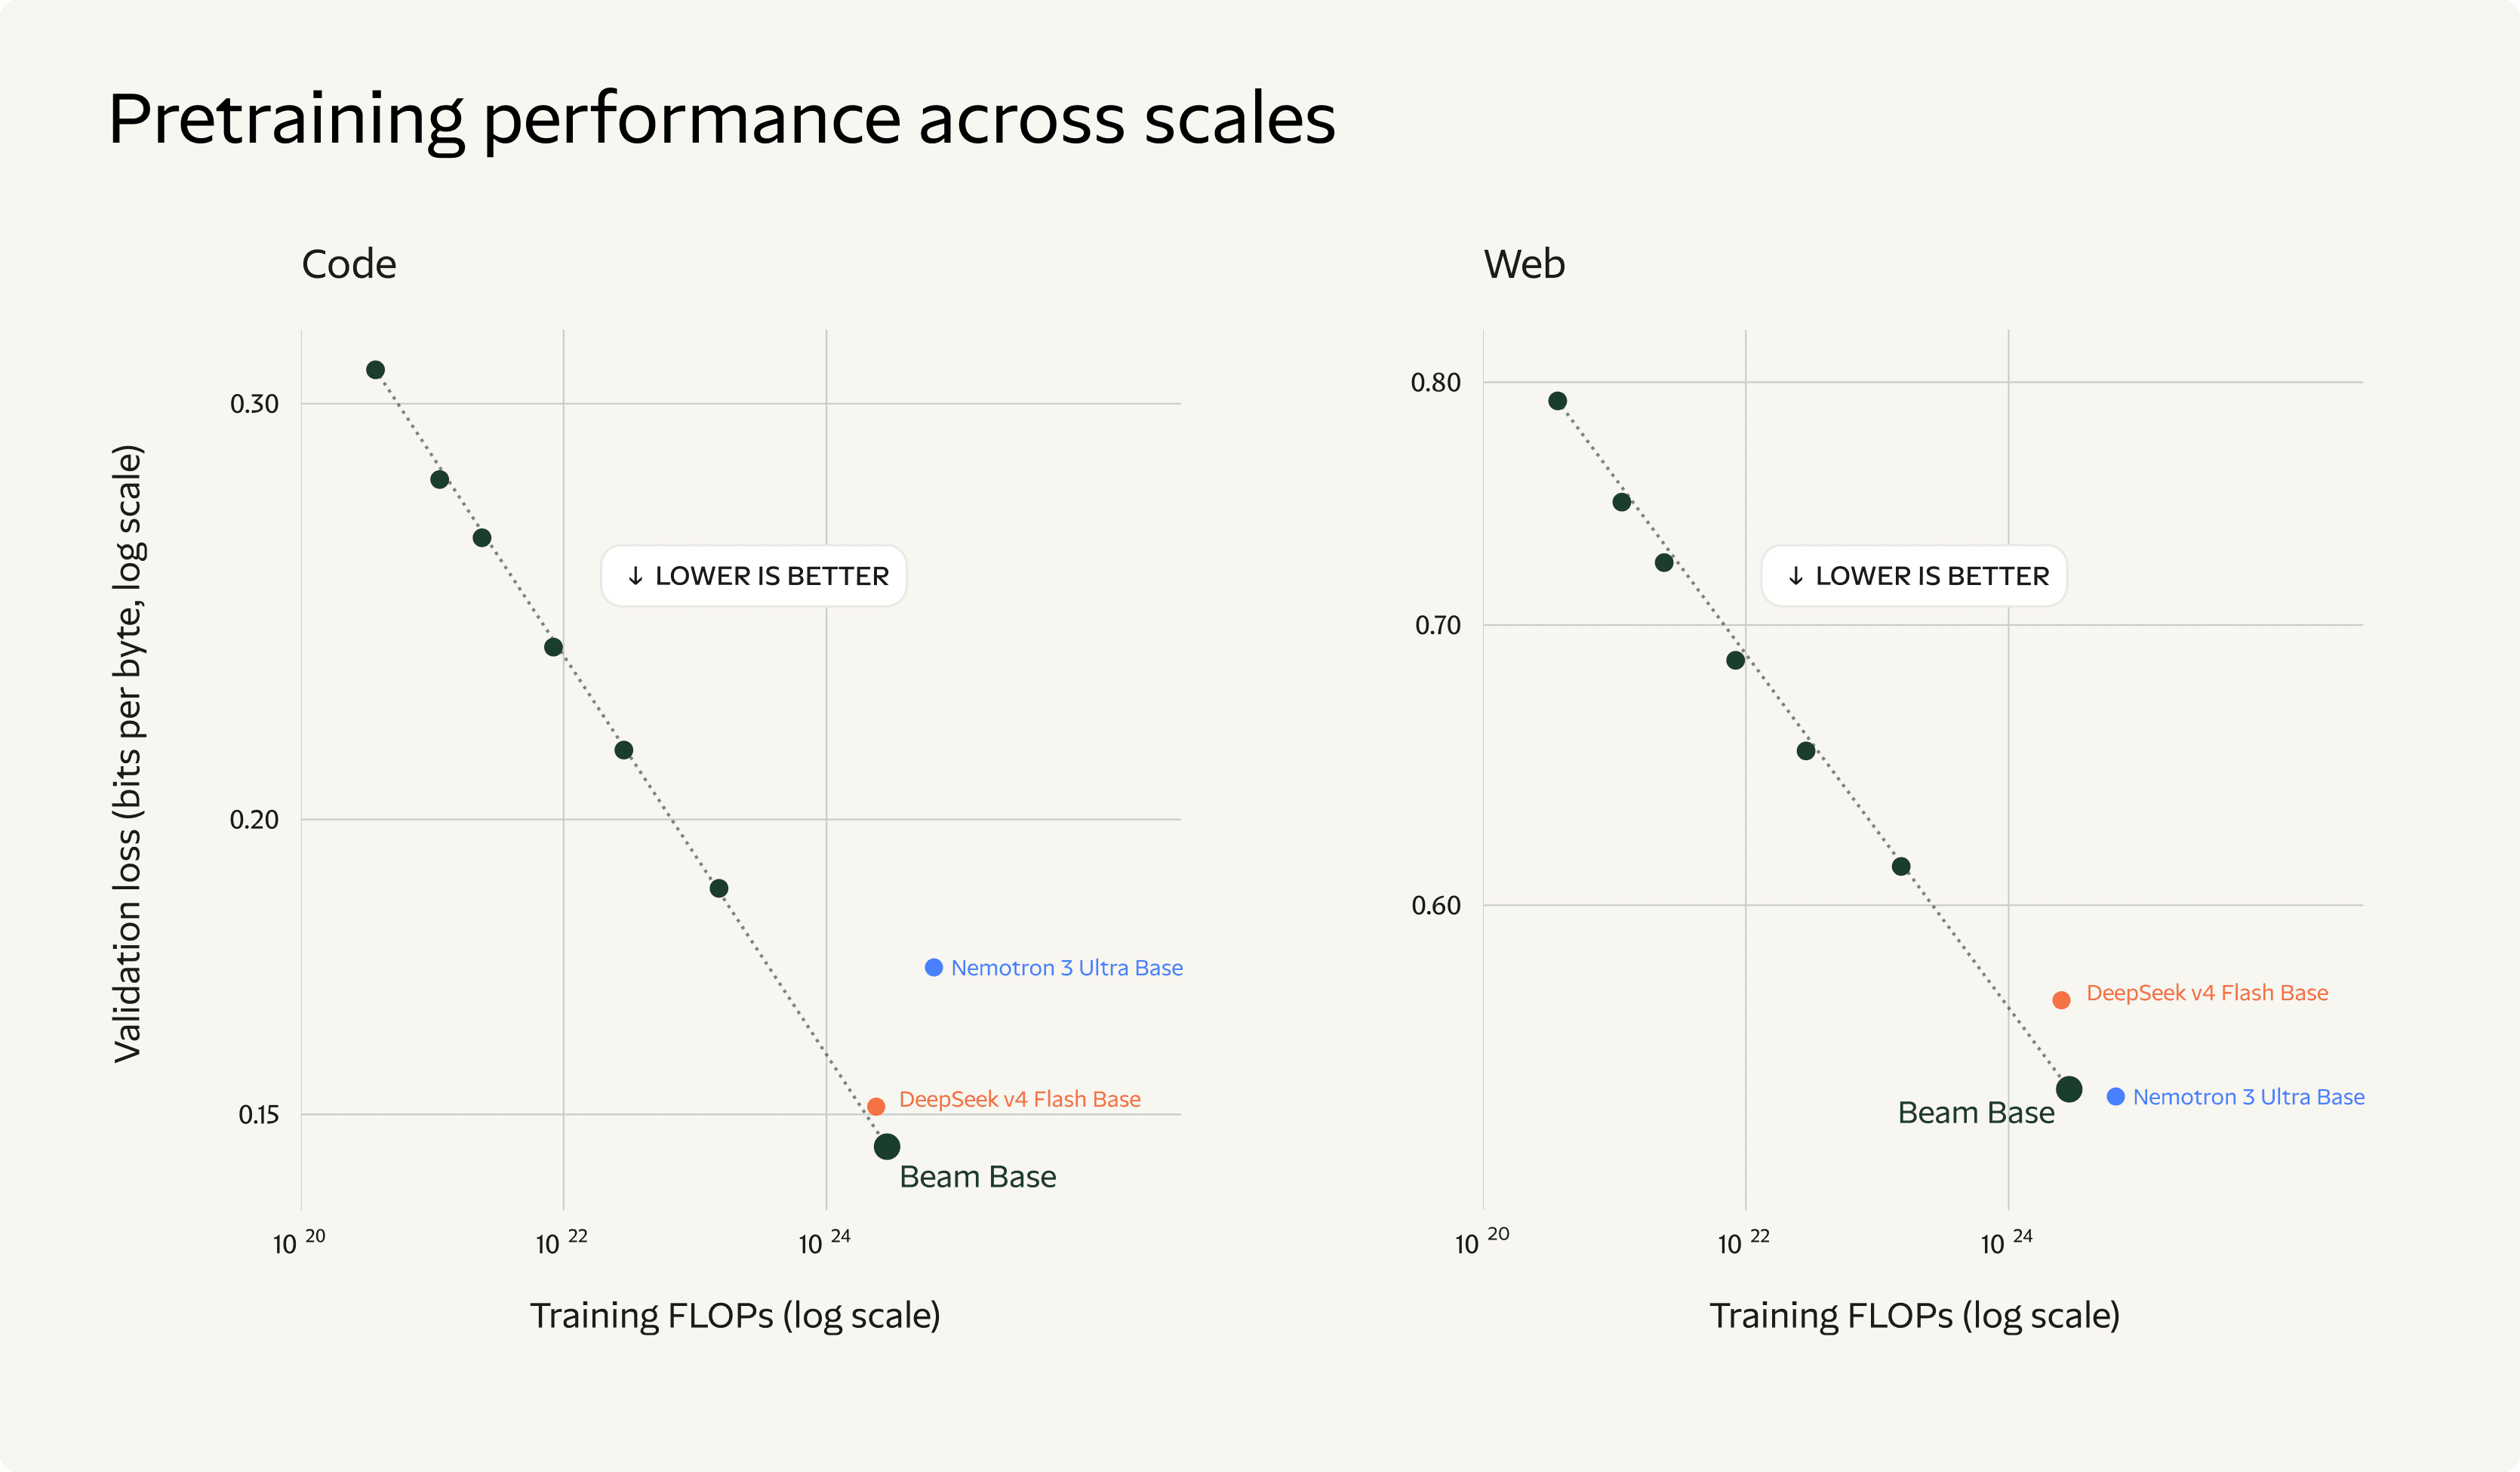
Во время разработки Beam pretrainировали series из итеративно больших моделей для установления и верификации нашей scaling recipe. Делая их производительность predictable'ной требовала тщательно проектировать model tiers'ы, курировать диверсные in-house code и web validation sets, и агрессивно decontaminate все обучающие данные против них. Scaling held; final Beam Base совпадает с его predicted производительностью, и также совпадает или outperforms accessible similar-sized open-source базовые модели.
Стабильная и сбалансированная MoE оптимизация
Архитектура Beam и recipe оптимизации подчёркивает numerically здоровое основание для sustained downstream RL. Комбинирует interleaved локальное и глобальное внимание, fine-grained routed experts'ов, контролируемый residual stream, и множественные формы load balancing'а для обеспечения стабильного, сбалансированного expert использования и healthy signal propagation через residuals.
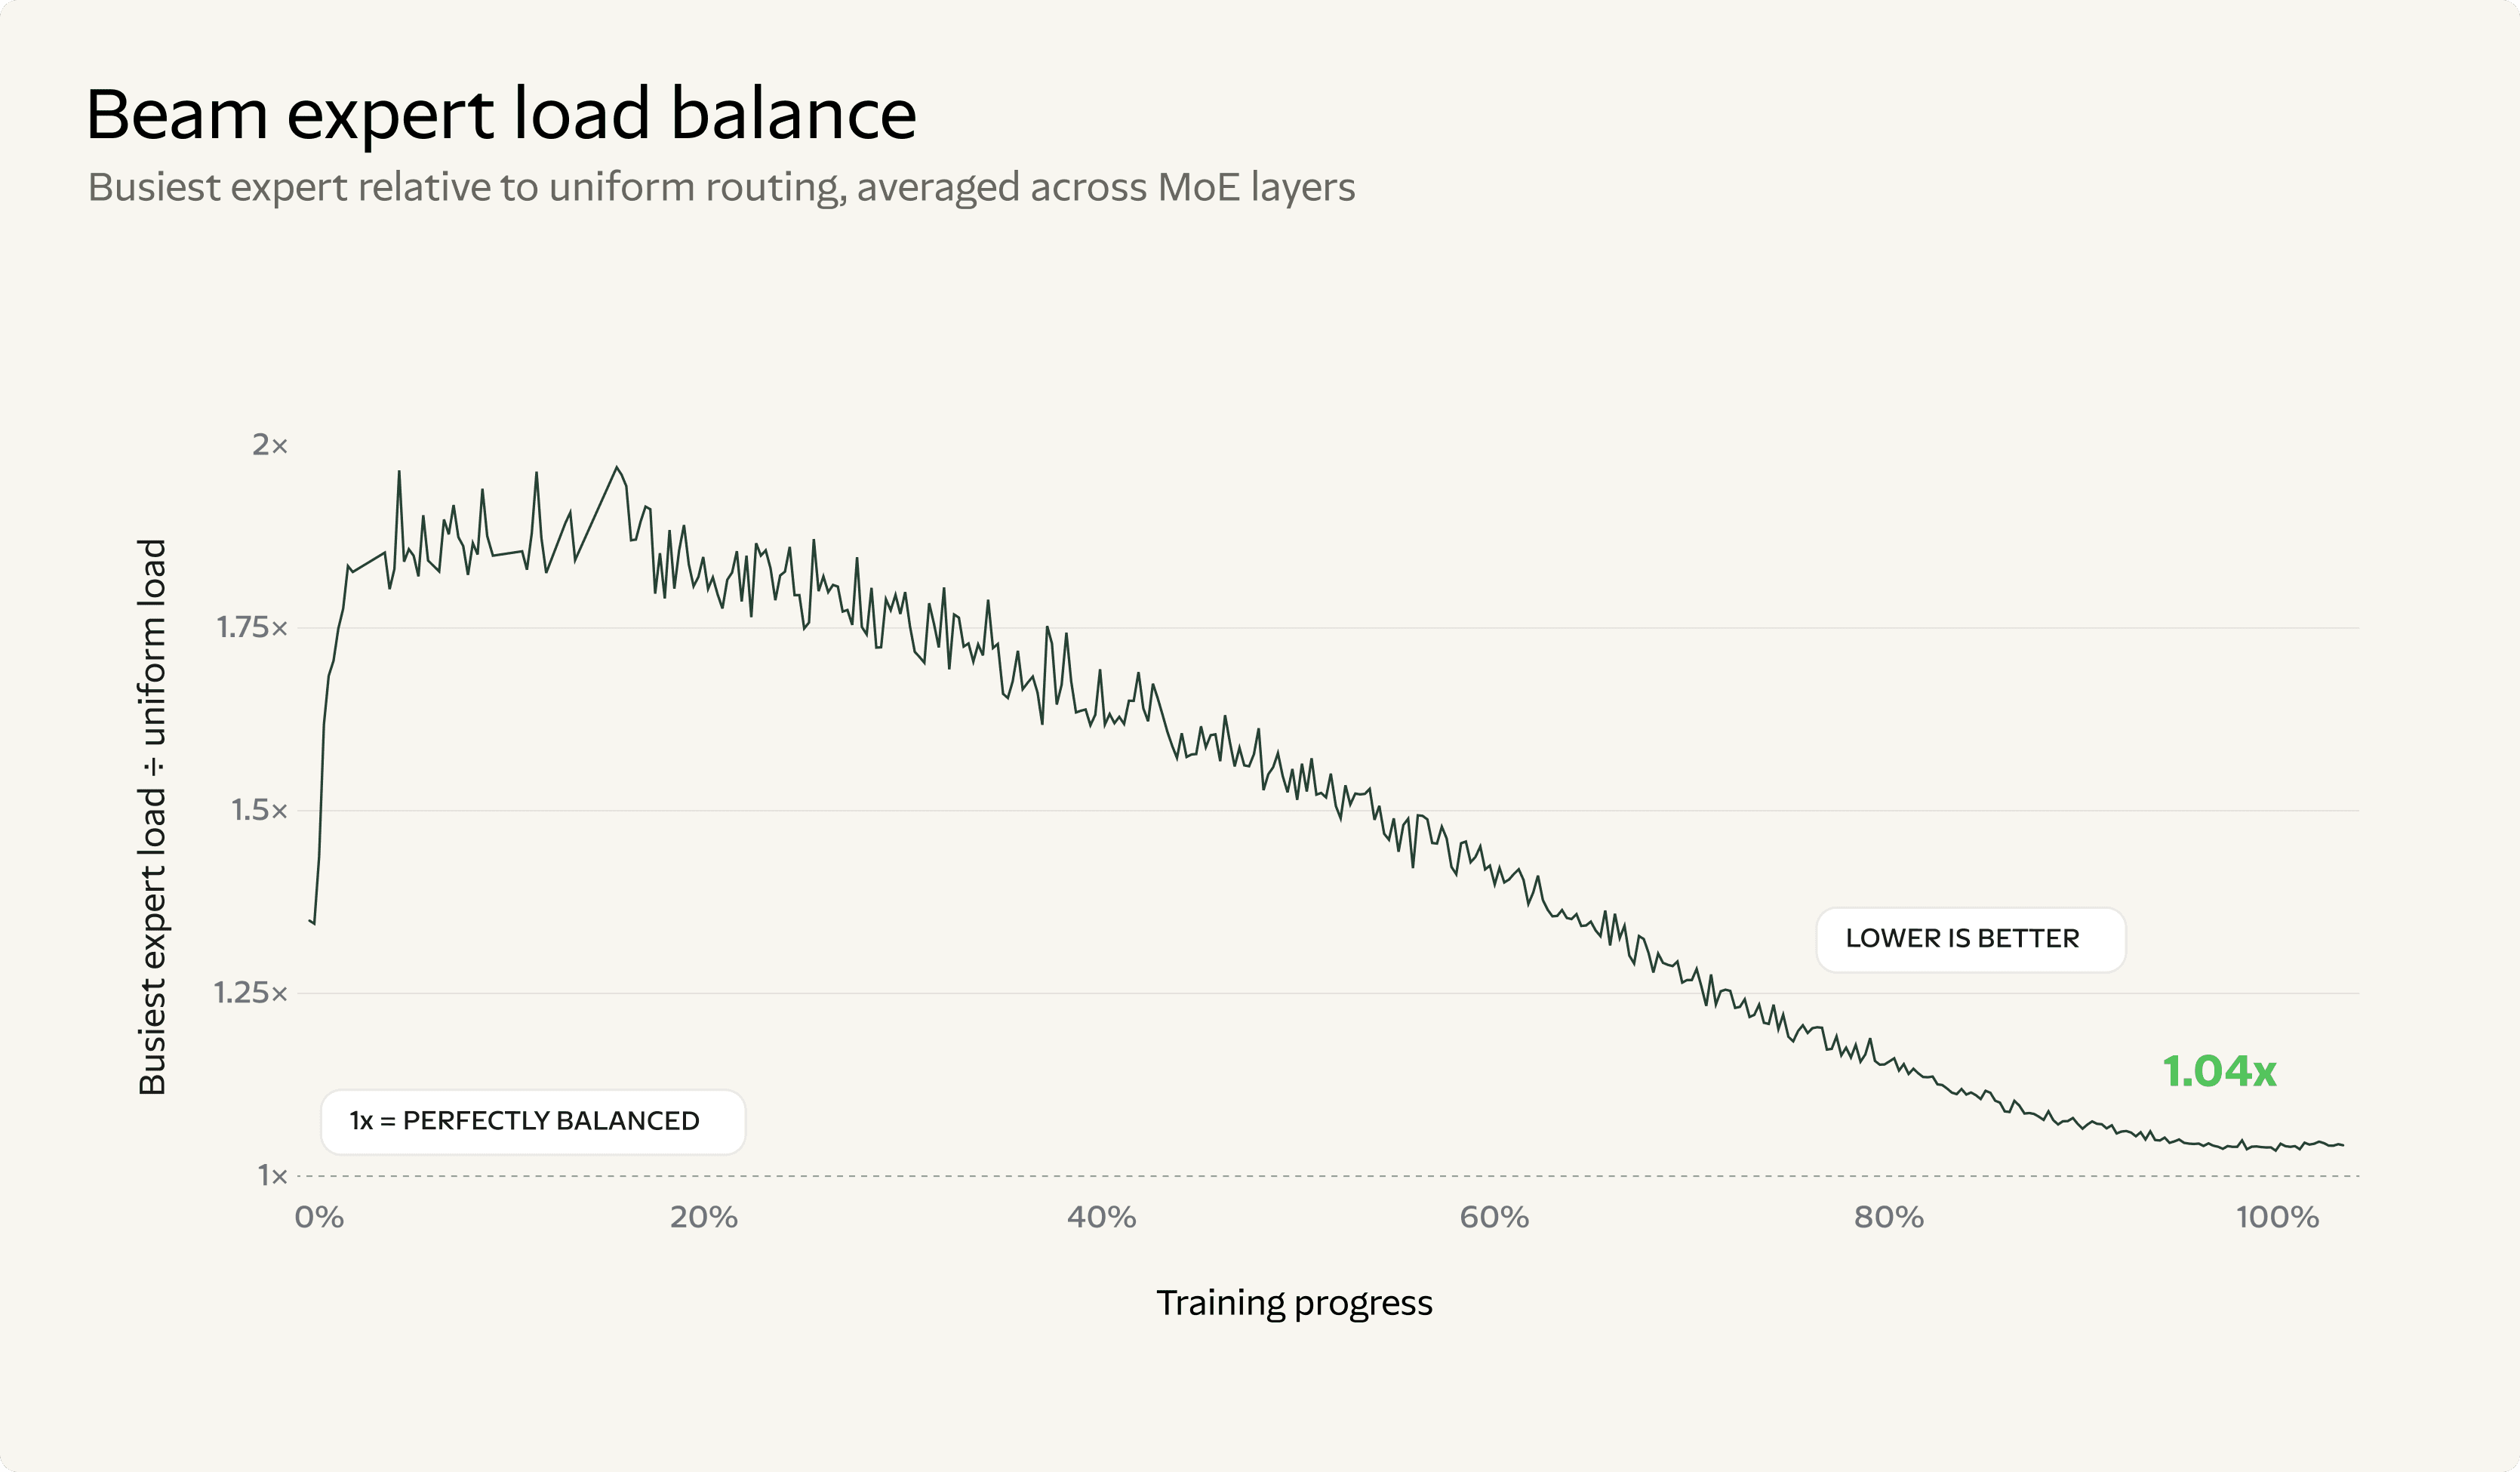
Для expert использования, построили на auxiliary-loss-free load balancing'е, представляя cosine decay expert-bias обновлений для снижения routing perturbation'ов позже в обучении. Sequence-level balancing дополнительно поощряет сбалансированное expert использование на данных вне pretraining распределения, preparing модель для changing распределения downstream RL. В результате final pretrained база имеет почти-perfect uniform использование, обеспечивая все experts могут быть использованы для learned рассуждения.
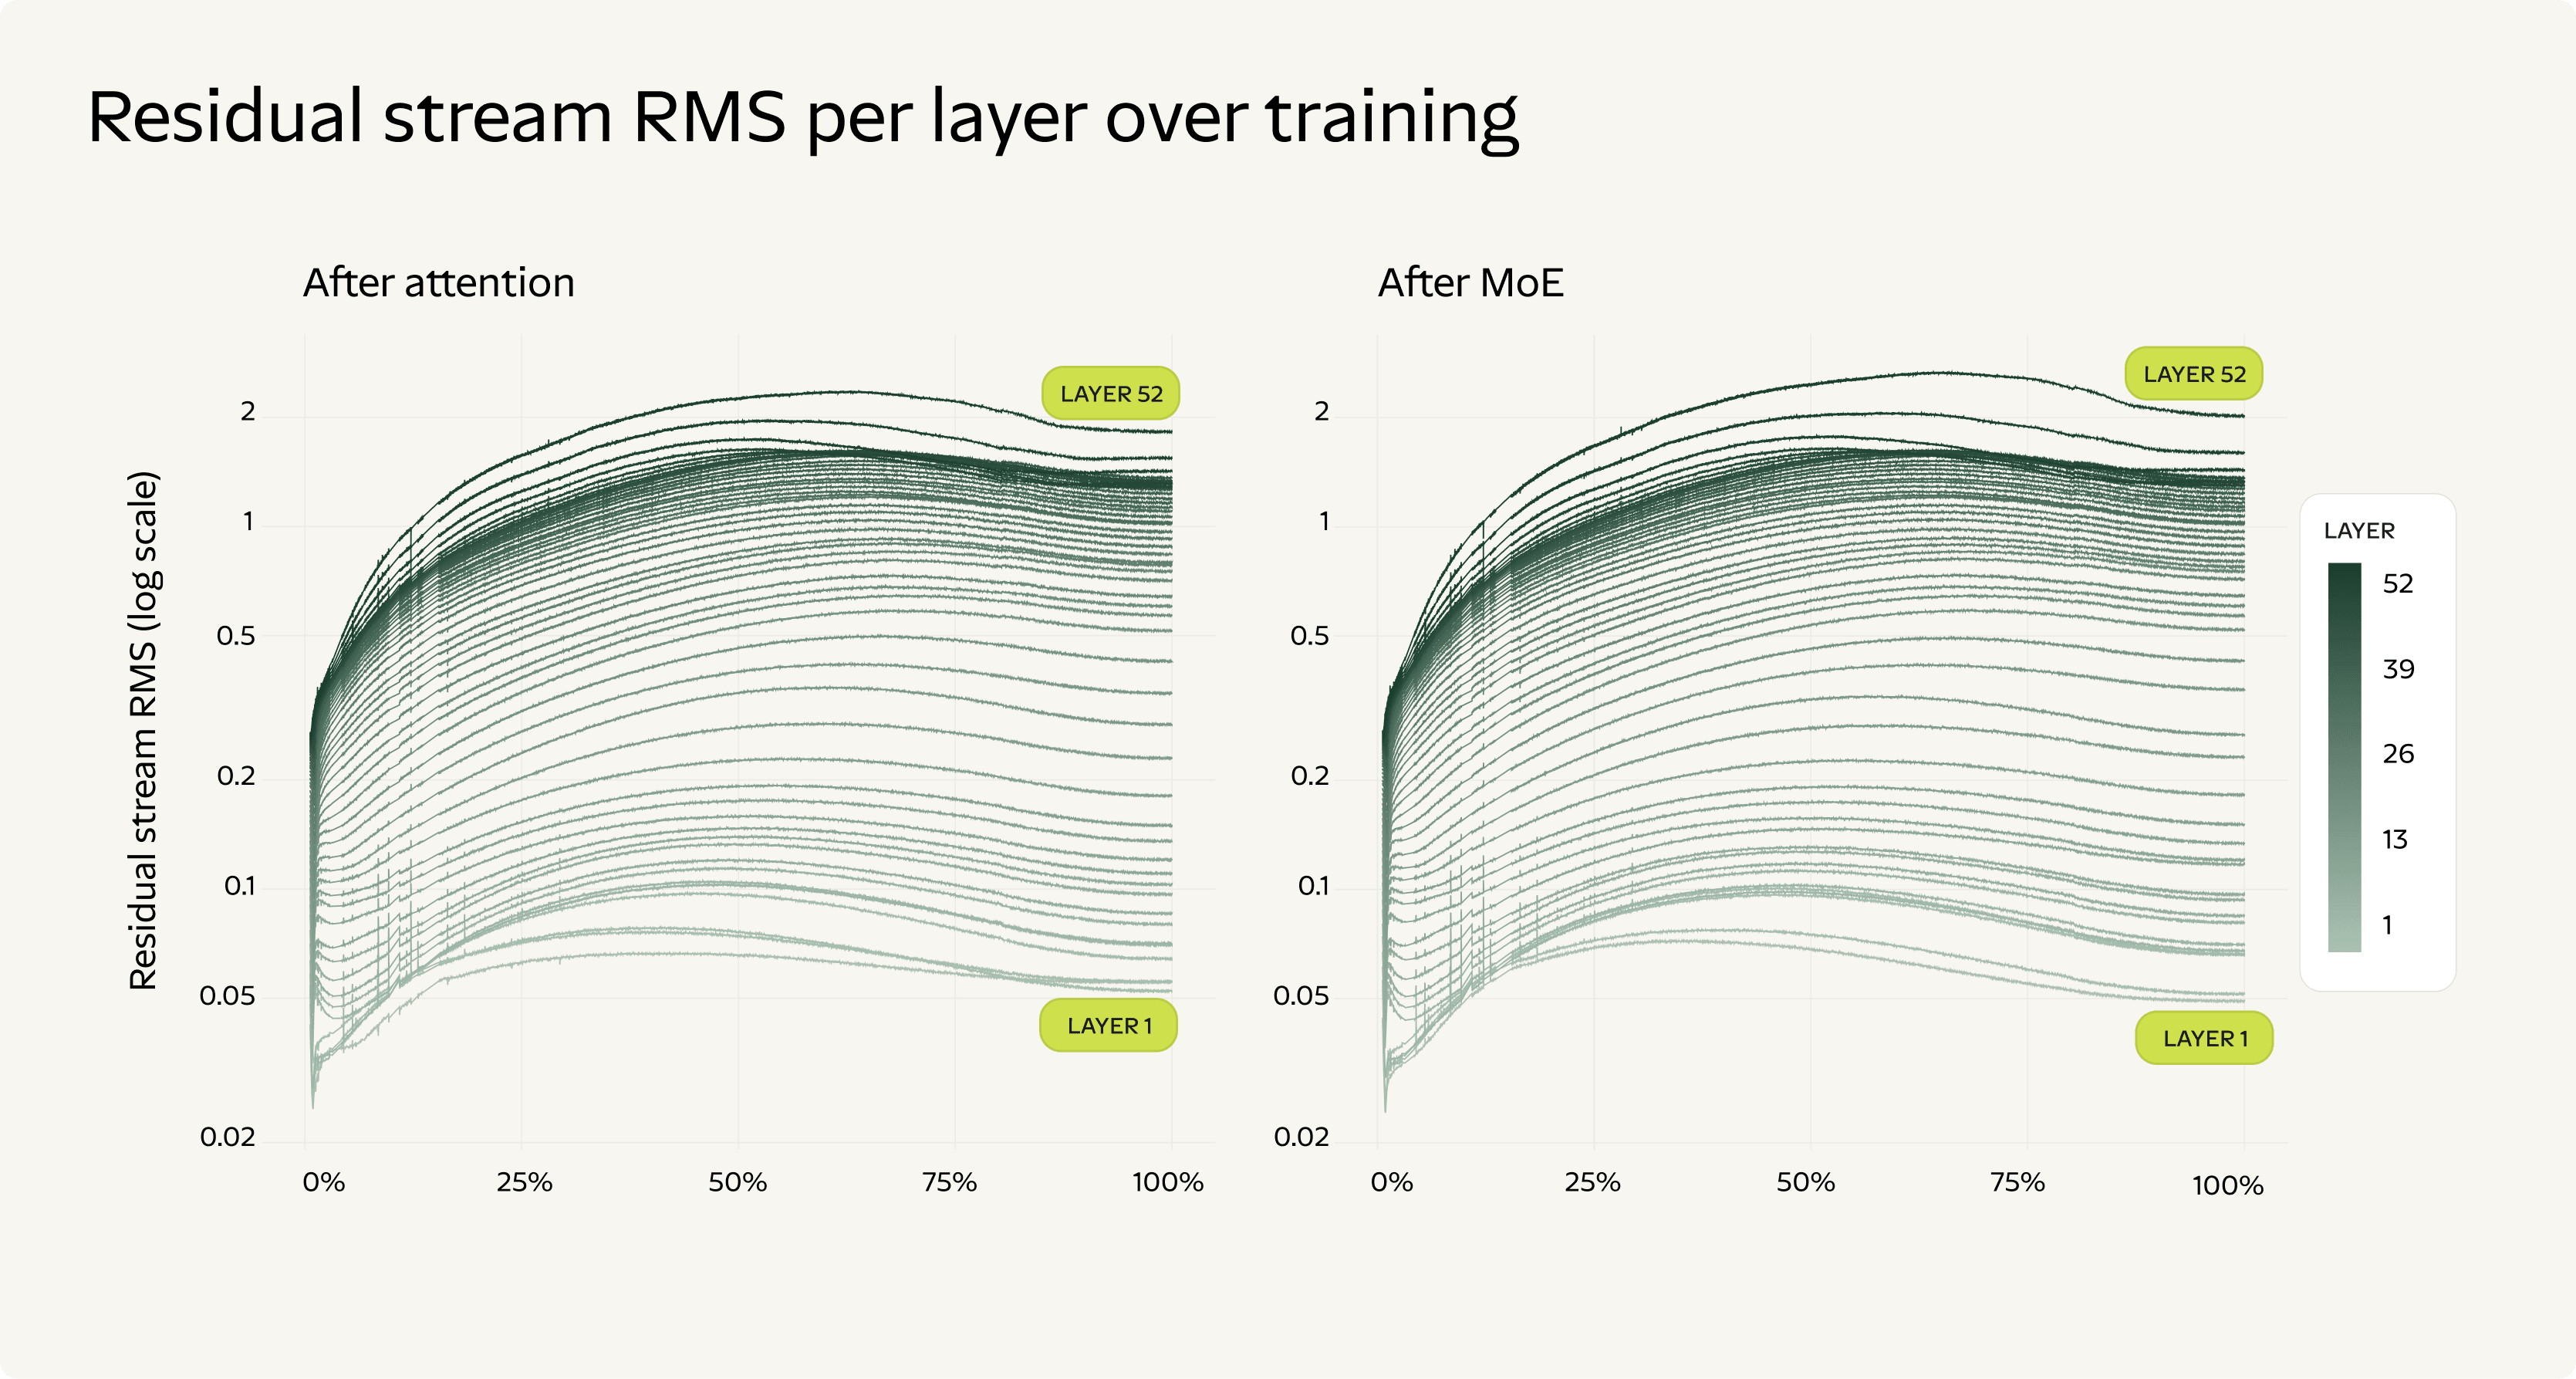
Для residual stream, разработали depth-based scaling подход который counteract'ит activation growth когда sublayer выводы accumulate'ся, помогая держать residual norm'ы стабильными по мере增加 глубины модели. Комбинировано с SandwichNorm, elementwise внимание gating'ом и FP32 residual accumulation'ом — которое уменьшает rounding error при добавлении малых обновлений потоку — этот recipe контролирует activation growth и outlier'ов, thereby обеспечивая healthy signal propagation через все layer'ы Beam. Эта стабильность persists через pretraining'е, reinforcement обучение и alignment'е.
Безопасность и выравнивание
Инвестировали в безопасность и выравнивание Beam параллельно с development'ом. Использовали red-teaming'е и alignment training'е методы для обеспечения что модель responsible и helpful.
Путь вперёд
Beam в финальных этапах red-teaming'а и оценок. Можно зарегистрироваться здесь для раннего доступа к модели. Выпустим веса, technical report, model card и developer artifacts позже в этом месяце.