Драма дистилляции
Еженедельно Anthropic выпускает новые статьи о том, как китайские лаборатории дистиллируют их модели, приводя доводы об угрозе человечеству и прочее. Это выгодно для них — создаёт основу для последующего юридического и нормативного ограничения этих моделей.
Но эра беспечной дистилляции явно закончилась.
И даже больше того. Новая игра — это внедрение достижений китайских лабораторий. Намеренно говорю «внедрение» вместо более желчного «краж», которым любит пользоваться Anthropic.
Потому что в отличие от западных компаний, китайцы практически отдают свои наработки на всеобщее благо.
Другая игра
Последний прорыв, бесстыдно позаимствованный без упоминания авторства — это прорывная оптимизация KV-кэша, которой DeepSeek щедро поделился с миром.
Это ошеломляющая оптимизация, которая сократила объём KV-кэша для определённых случаев использования с длинным контекстом сессии, таких как кодирование, на фактор примерно 437x в сравнении с DeepSeek-V1.
Они первыми выпустили архитектуру MLA, которая сжала кэш примерно на 15x, затем последовали «Compressed Sparse Attention» и «Heavily Compressed Attention». Последний DeepSeek-V4.1-Flash идёт ещё дальше с CSA2, перекрёстным переиспользованием кэша между слоями, архитектурой кодировщика-декодировщика и FP4-кэшированием, доведя глобальный KV-кэш до 890 байт на токен.
Почему это важно? Потому что при обслуживании моделей с длинным контекстом одна из крупнейших затрат — это VRAM, необходимый для размещения этого кэша в памяти GPU.
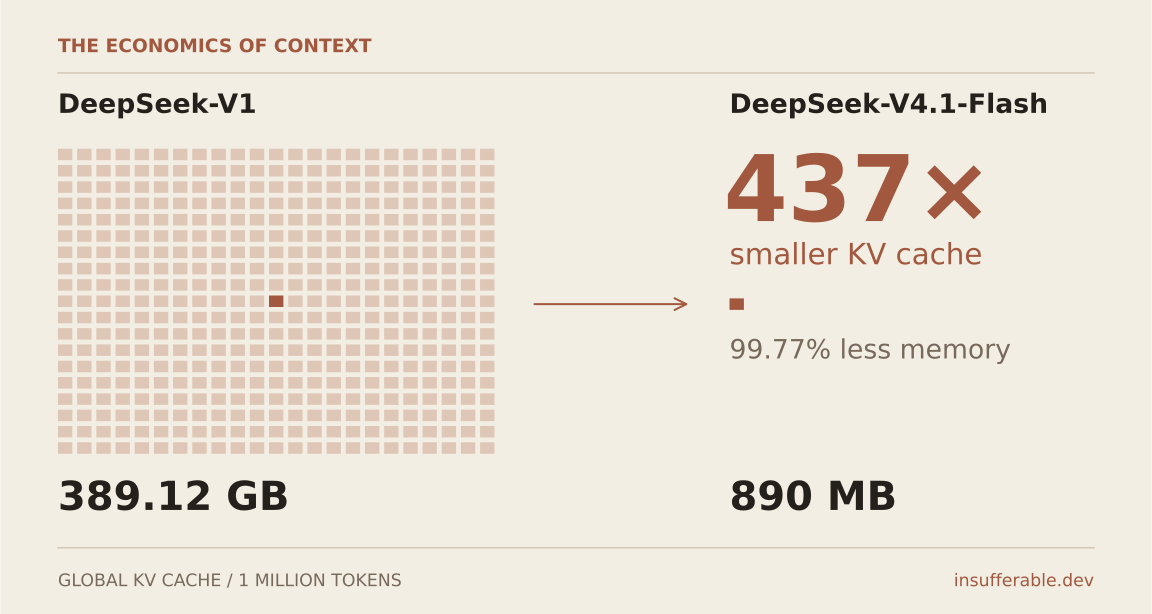
Вот график, показывающий, насколько всё это безумно:
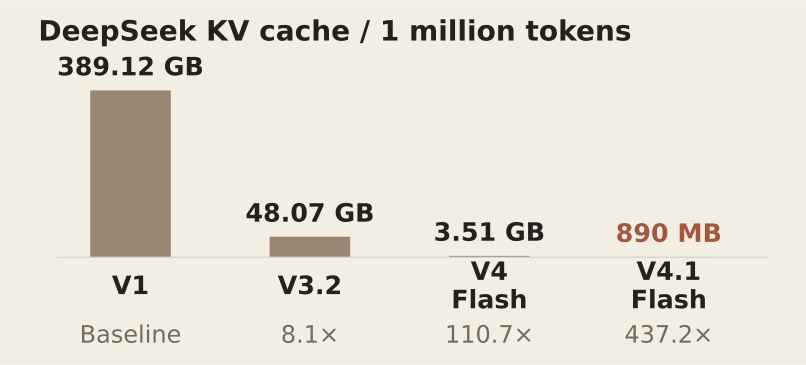
Следуя за деньгами кэша
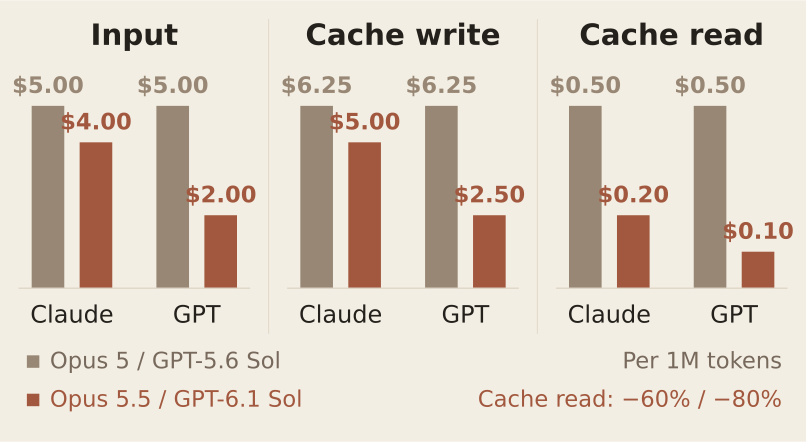
Сравните это со стоимостью того же уровня примерно два месяца назад. Все цены ниже — за 1 миллион токенов:
Очень тихая благодарность
Всё это должно означать, что западные AI-компании теперь чрезвычайно прибыльны по маржам инференса.
Ограничения на доступ к передовым GPU заставили китайские лаборатории сделать оптимизацию производительности главной целью, и это видно в результатах.
Не знаю, почему они свободно отдали такой прорыв, но они это сделали, и на этот раз как Anthropic, так и OpenAI выпустили модели, которые по сути являются первоклассными и используют эти оптимизации.
Похоже, они немного смущены копированием. Отсюда молчаливые выпуски без большого предварительного анонса как Claude Opus 5.5, так и GPT-6.1 Sol.
Отзывы пользователей о производительности были отличными, и качество кажется не намного отстающим от их флагманских моделей (Claude Fable 5.1 и GPT-6 Astra).
Стоимость чтения из кэша — это доказательство внедрения. Она резко упала: Opus 5.5 снизил цены на кэширование при чтении на 60% в сравнении с Opus 5, в то время как GPT-6.1 Sol снизил их на 80% в сравнении с поздней июльской ценой GPT-5.6 Sol.
Итак, китайские лаборатории подали спасательный круг западным убыточным лабораториям, и я совершенно не понимаю, почему.