ИИ-программирование сделало CI узким местом — мы переделали наш конвейер
В начале года в Linear обнаружилась проблема: CTO Tuomas назначил задачу — CI стоит слишком дорого и работает медленно. Агенты на основе ИИ ускорили разработку экспоненциально, но валидация изменений не поспевает с той же скоростью. Каждый pull request всё ещё проходит через CI, поэтому по мере ускорения разработки CI становится узким местом, увеличивая затраты на инфраструктуру и заставляя разработчиков и агентов дольше ждать обратной связи.
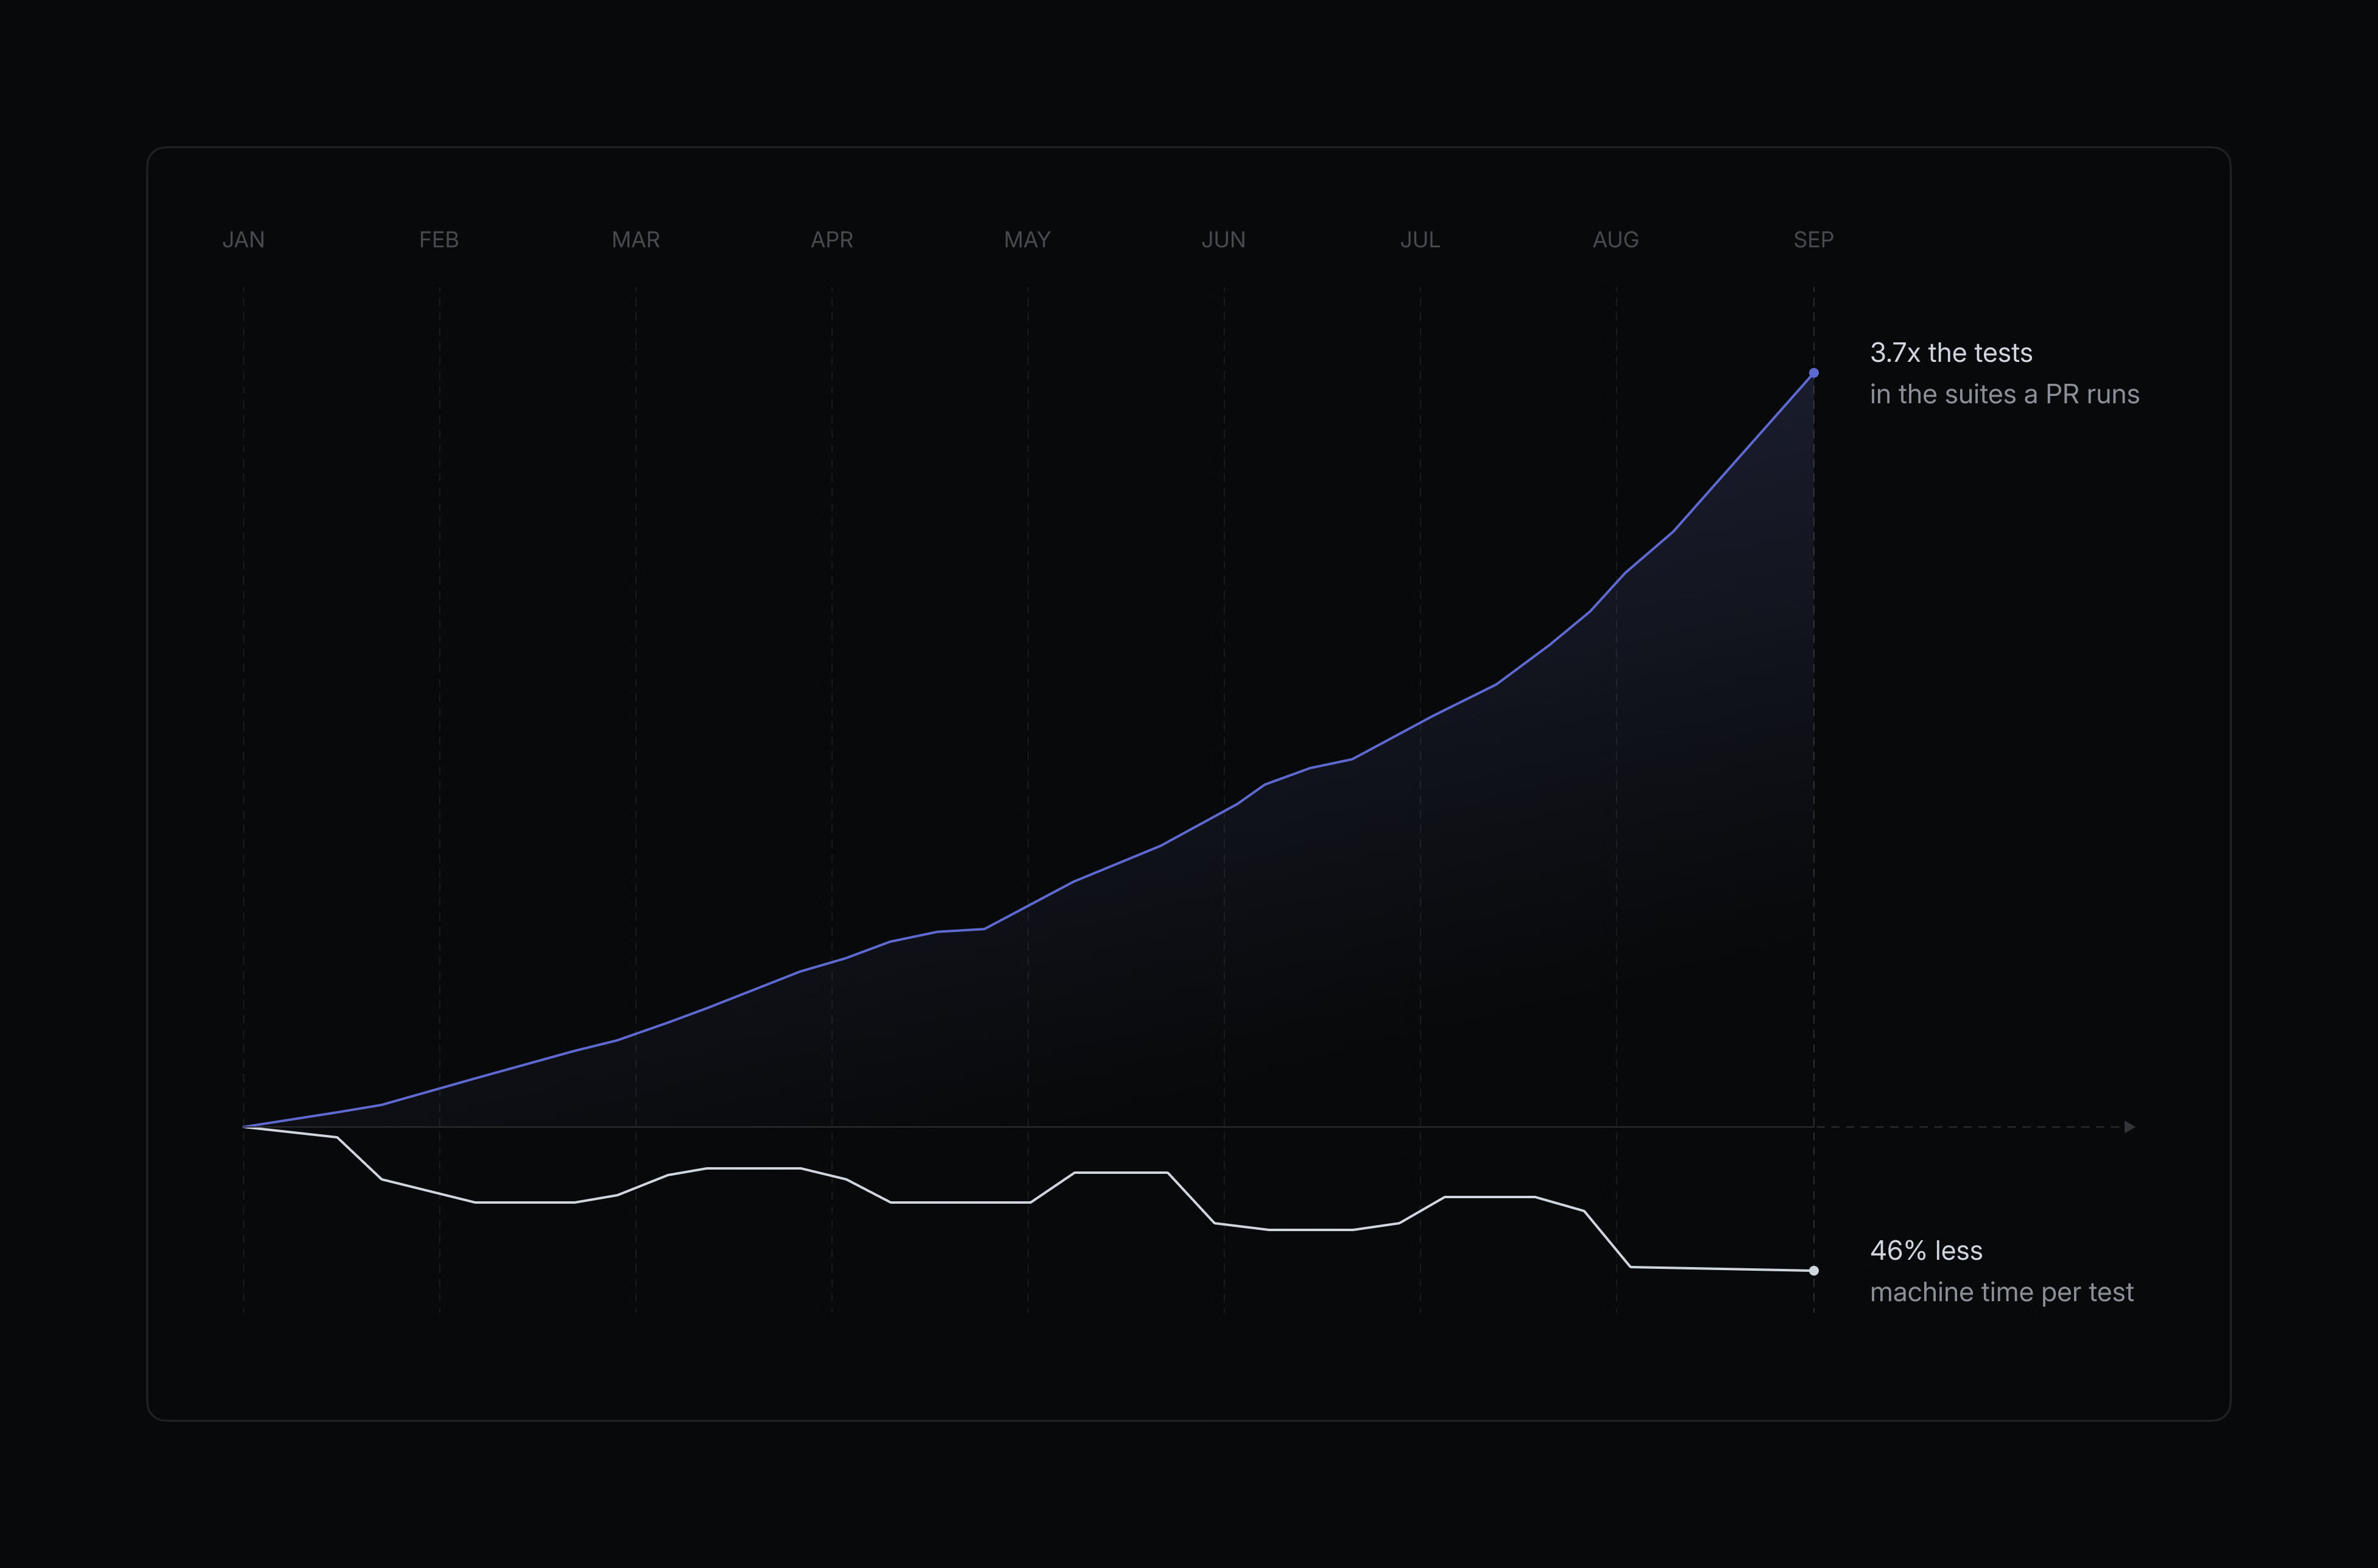
Цель была амбициозной: оптимизировать время ожидания PR в CI и снизить потребление машинного времени. Несмотря на то что набор тестов увеличился почти в четыре раза с начала года, удалось сократить время ожидания pull request с более чем 6 минут до чуть более 5, одновременно снизив машинное время на тест примерно вдвое.
Работа велась по четырём направлениям:
- Обновили инфраструктуру и инструментарий
- Оптимизировали задачи, которые блокируют другую работу
- Снизили повторяющуюся настройку окружения
- Сделали выполнение тестов более эффективным
Кодовая база Linear написана преимущественно на TypeScript, но большинство этих оптимизаций применимы к другим языкам и цепочкам инструментов.
Обновили инфраструктуру и инструментарий
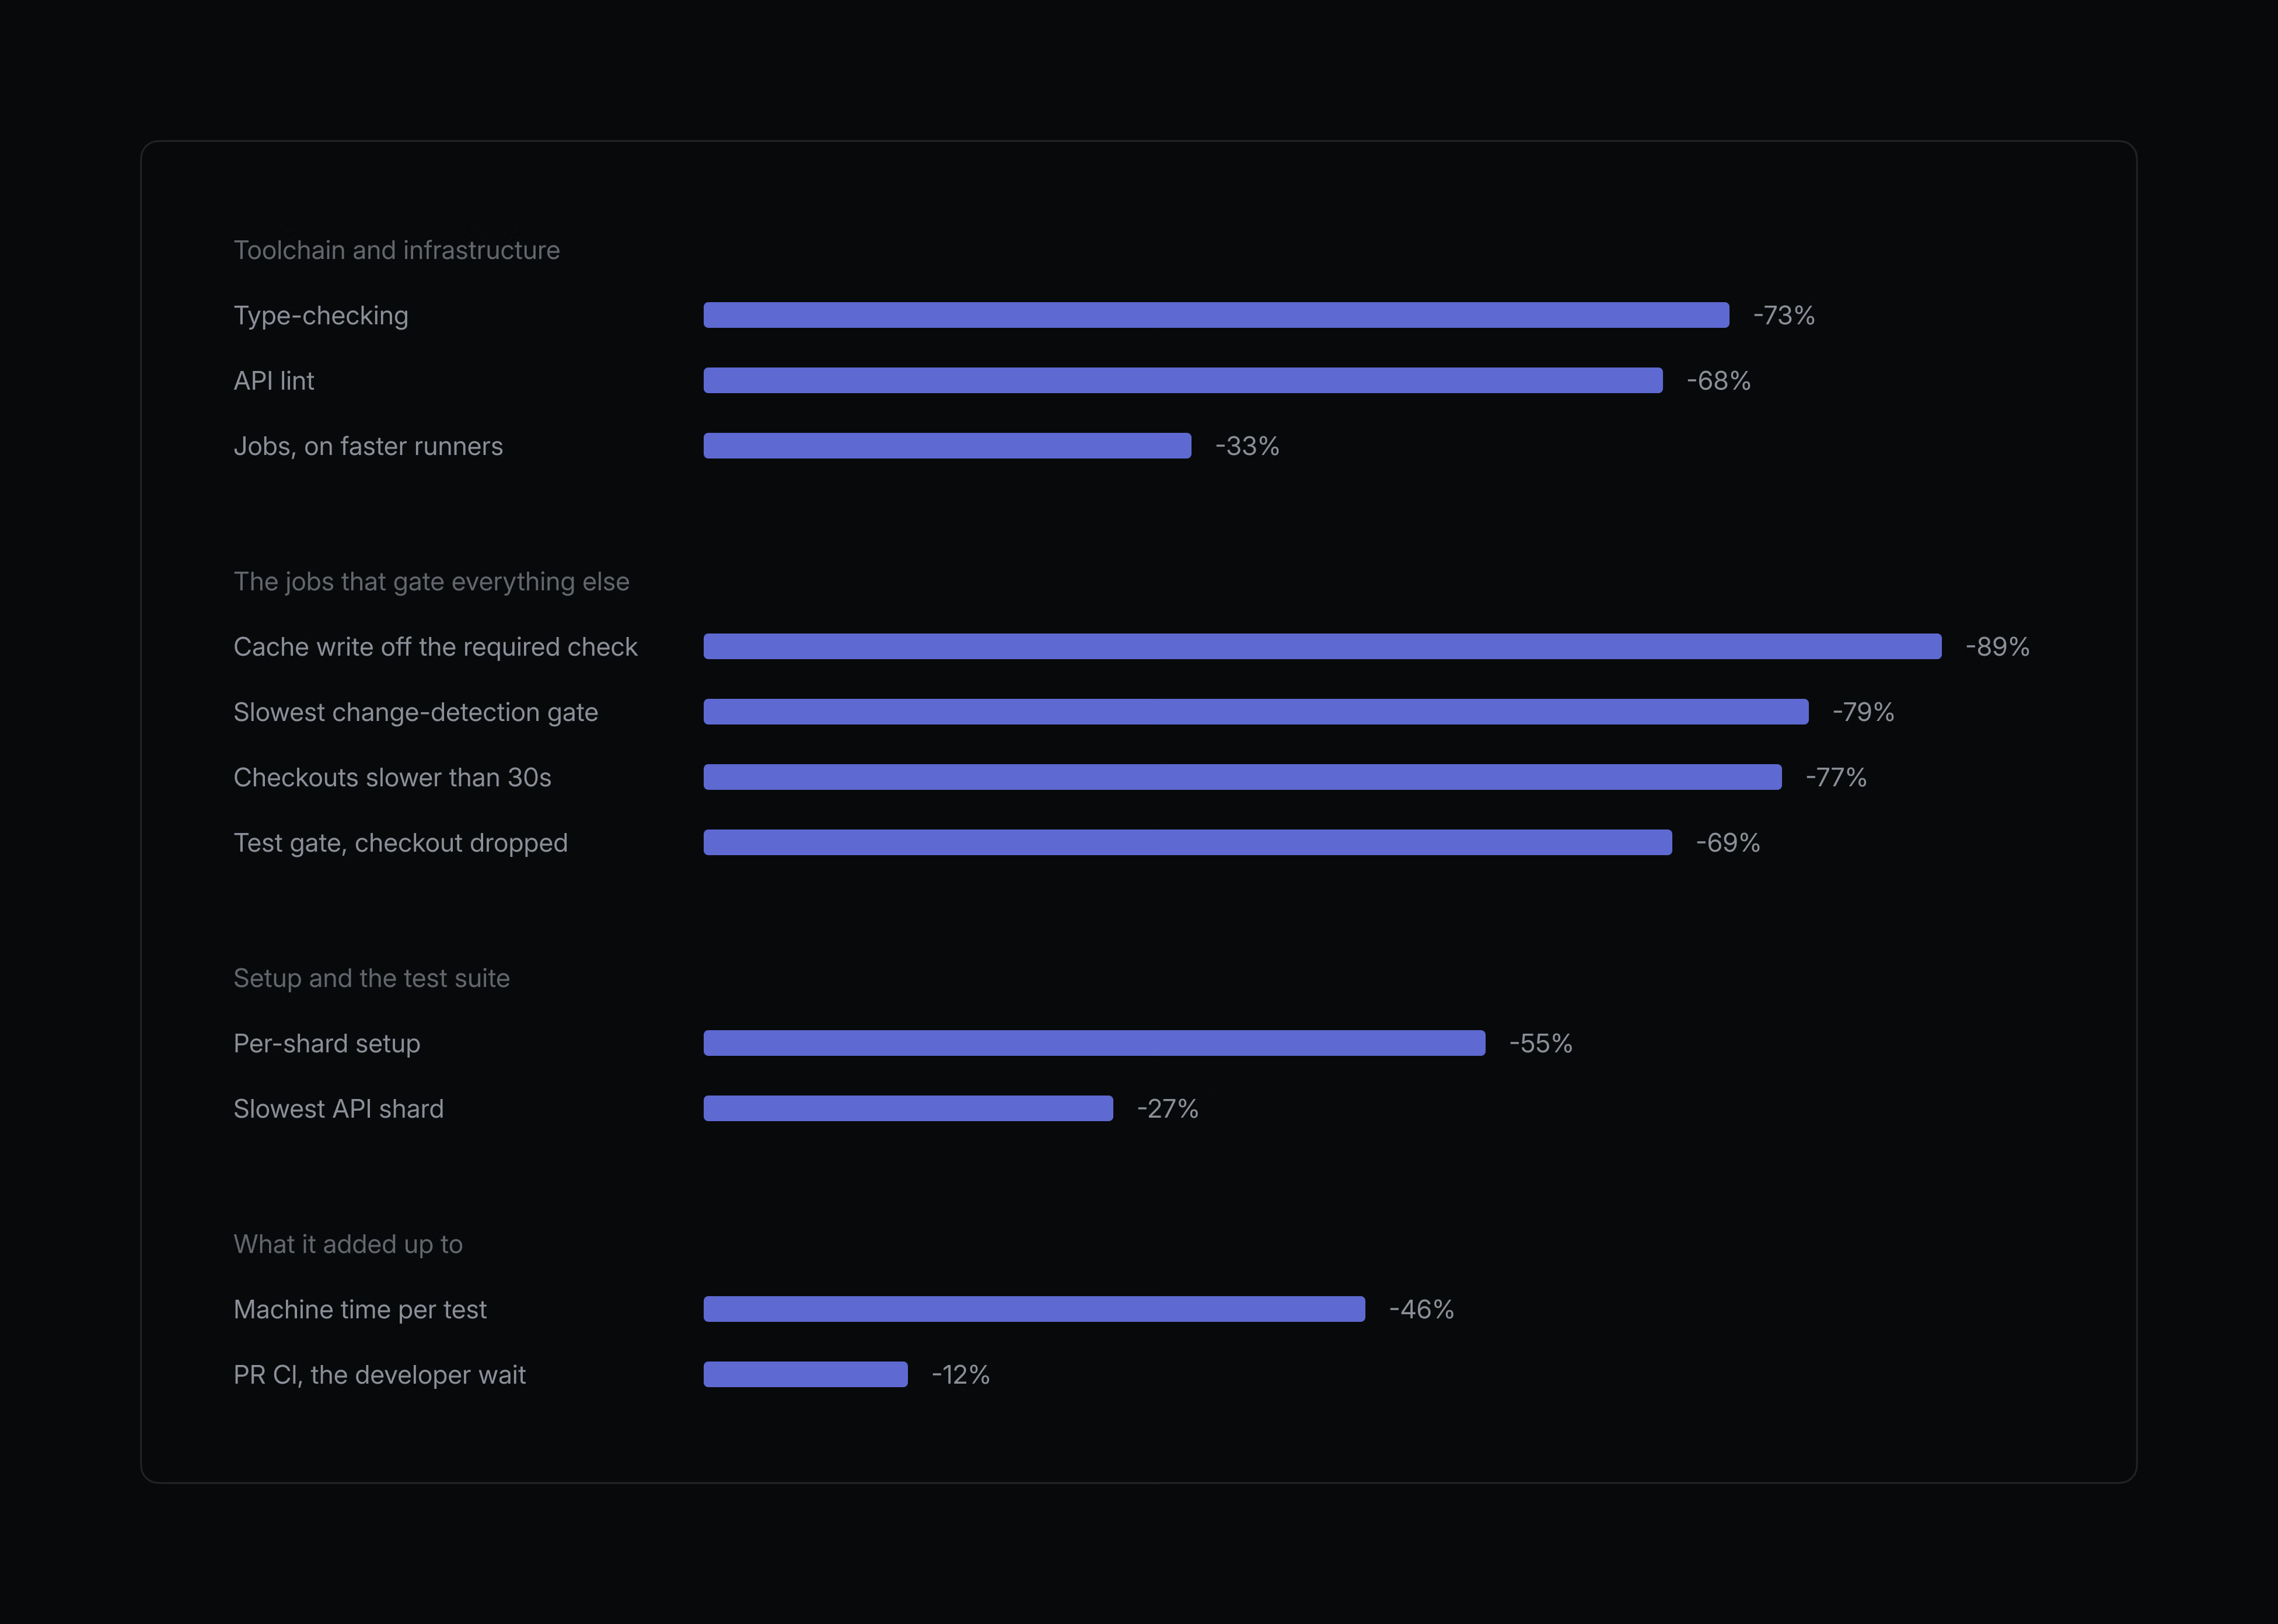
Первые улучшения почти не потребовали оптимизации самого CI. Переместив рабочие нагрузки с GitHub Actions на сторонних провайдеров с более быстрыми процессорами, высокопроизводительным хранилищем и лучшей инфраструктурой кеша, получили более быстрые машины для запуска того же конвейера. При прямом сравнении двух дней до и после переноса задачи выполнялись в среднем на 34% быстрее, а некоторые рабочие нагрузки вроде tsc убыстрились на 52%.
Отдельно модернизация инструментария тоже дала результат. Переход на tsgo, нативный компилятор TypeScript, сократил еженедельный медиан проверки tsc на 73% — достаточно, чтобы узкое место уже не было на этапе проверки типов.
Линтинг без проверки типов
Линтинг был следующей целью оптимизации. Несколько собственных правил линтера зависели от информации типов TypeScript — либо для ограничений, либо для автоисправления. Это означало, что каждый проход линтера должен был построить полный граф типов перед применением этих правил, превращая линтинг в одну из самых памятезатратных задач в CI.
Правила переписали, используя статический анализ абстрактного синтаксического дерева вместо информации типов — определяя функциоподобные конструкции и паттерны охраны без информации о типах. Это позволило ESLint полностью избежать TypeScript, снизив время линтинга API на 68%, а линтинга полного репозитория на 55%. Использование памяти также существенно снизилось.
Избавление от зависимости на информацию типов также облегчило последующий переход на Oxlint, потому что правила, работающие чисто с синтаксисом, легко портируются. Сам Oxlint дополнительно снизил количество runner-minutes, потраченных на линтинг.
Оптимизировали задачи, которые блокируют другую работу
С более быстрой инфраструктурой и индивидуальными проверками работали с CI как с системой. Это обратило внимание на маленькие задачи, которые стояли впереди всего остального. Каждый запуск начинается с проверки, какие пути изменил PR и прошли ли тесты уже для тех же входных данных. На эти проверки кладут ограничения на уровне задач, чтобы пропущенная работа никогда не зарезервировала runner, но это также ставит их прямо на критический путь. Ни один из восьми шардов API-тестов не может начать, пока они не завершатся, поэтому даже небольшие задержки диспропорционально важны.
Загружали только то, что нужно каждой задаче
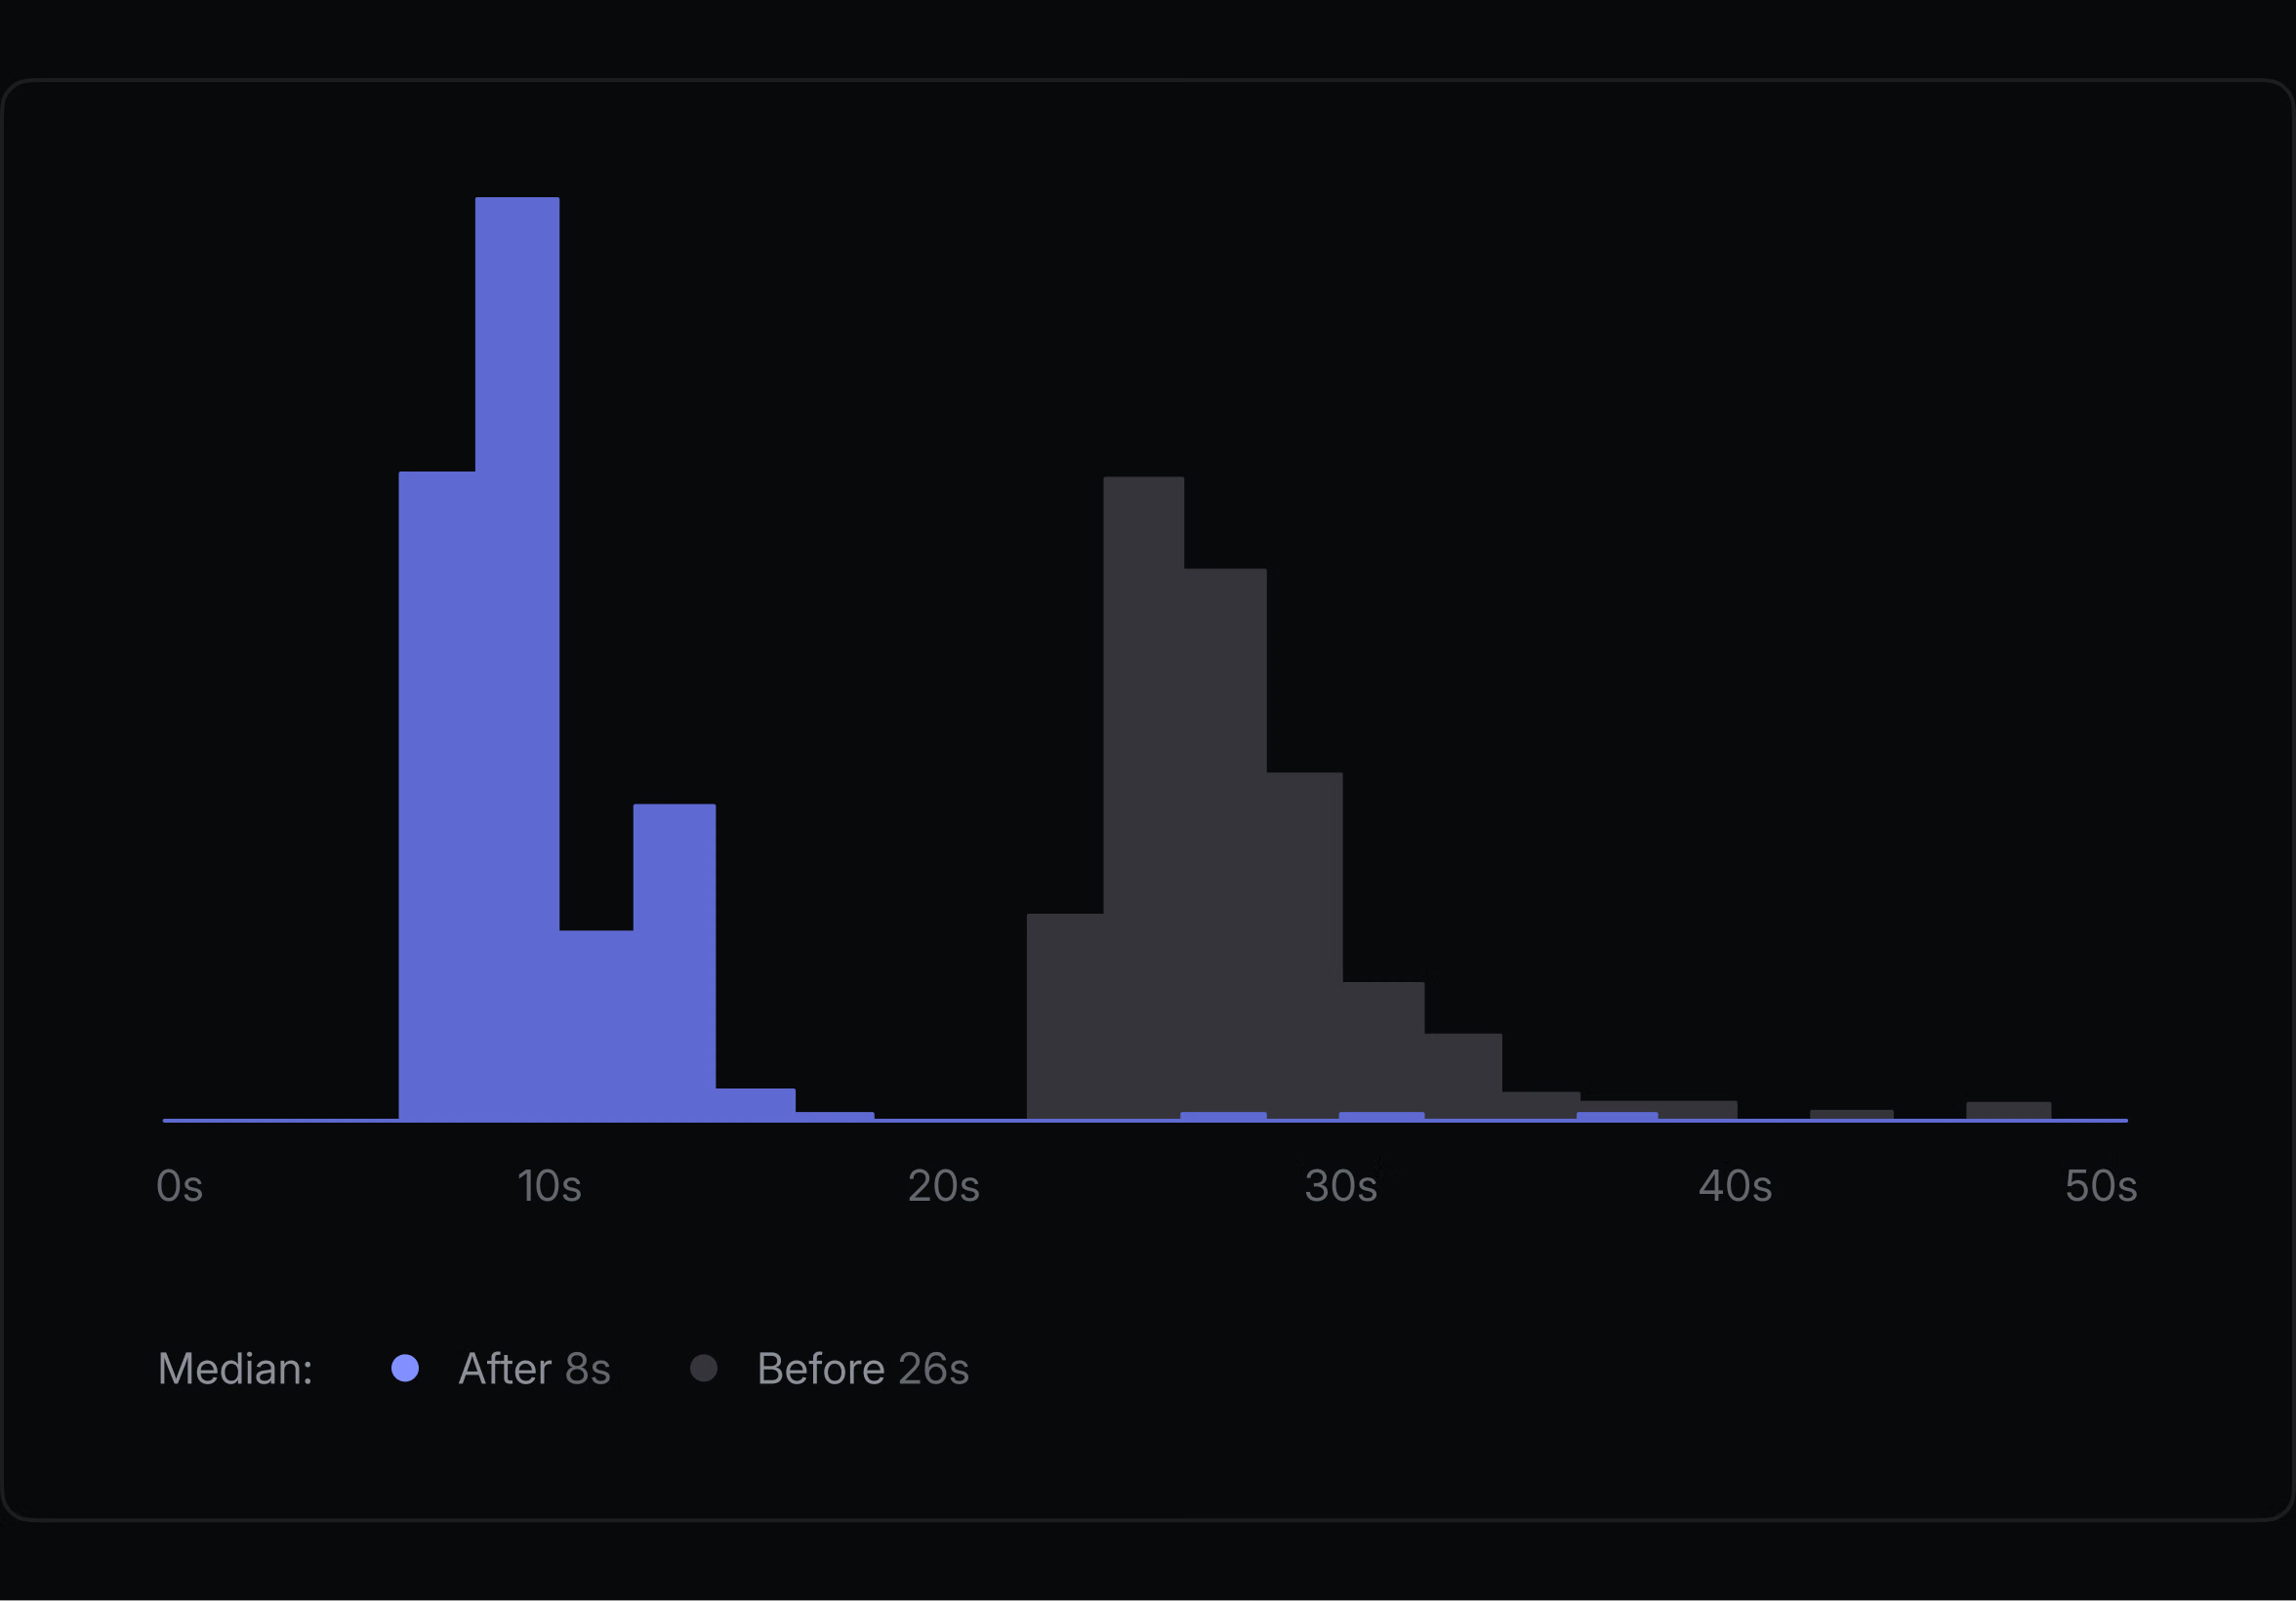
Несколько рабочих процессов начинаются с задачи определения изменений, которая решает, что запускается дальше. Например, проверяет, содержит ли diff миграцию базы данных, и выводит сигнал для планирования соответствующих проверок CI БД. Эти задачи проверяли всё рабочее дерево, хотя нуждались только в небольшом подмножестве. Ограничили глубину fetch, что сократило медленнейшие из этих проверок с 94 секунд до 20, и полностью убрали checkout из задач, которые никогда не нуждались в рабочем дереве, сократив время с 27 секунд до 7. Для событий push commit и merge-queue, где приходится diff-ить пути, обнаружили, что разреженный, blobless checkout с ограниченной историей достаточен, сэкономив ещё около 11 секунд.
Сделали checkout более устойчивым
После переключения инфраструктуры провайдера времена checkout (с actions/checkout) в задачах увеличились и иногда зависали. Потому что сторонние runners расположены вне сети GitHub, они полагаются на прямую IP-ссылку для подключения к GitHub. Провайдер связал зависания с перебоями на этой ссылке. Несколько рабочих процессов начинаются с checkout, поэтому остановленная загрузка могла задержать весь CI-запуск.
Для устойчивости к нестабильности сети заменили actions/checkout собственным составным action, который повторяет попытки с экспоненциальной задержкой, устанавливает GIT_HTTP_LOW_SPEED_LIMIT и GIT_HTTP_LOW_SPEED_TIME, чтобы остановленное соединение прерывалось примерно через 30 секунд вместо зависания, и использует кеш checkout, который хранит постоянное зеркало git на закреплённом диске. Результат — значительно меньше запусков, где критичная для пути задача простаивает в ожидании завершения checkout.
Минимизировали то, что на критическом пути
Не каждая задача на критическом пути должна была там быть. Маркеры кеша писали как часть финальной проверки перед слиянием, что означало, что pull request мог ждать в очереди слияния даже после того, как тесты прошли. Переместили эту запись в задачу, которая запускается после завершения шардов тестов, но ничего не блокирует, сэкономив 42 секунды на критическом пути слияния для каждого API pull request и записи merge-queue.
Вместе эти изменения убрали примерно минуту из требуемой проверки для API pull request при промахах кеша, а также сократили запуски runners.
Снизили повторяющуюся настройку окружения
Затем обратили внимание на затраты на setup, повторяющиеся в каждой задаче: запуск runner, установку пакетов и подготовку зависимостей сборки. Эта накладная расходов означает, что задача, которая выполняет только несколько секунд полезной работы, может в итоге потребить целые минуты машинного времени. Вот несколько шагов, которые предприняли:
Предустановили общие зависимости в образ CI
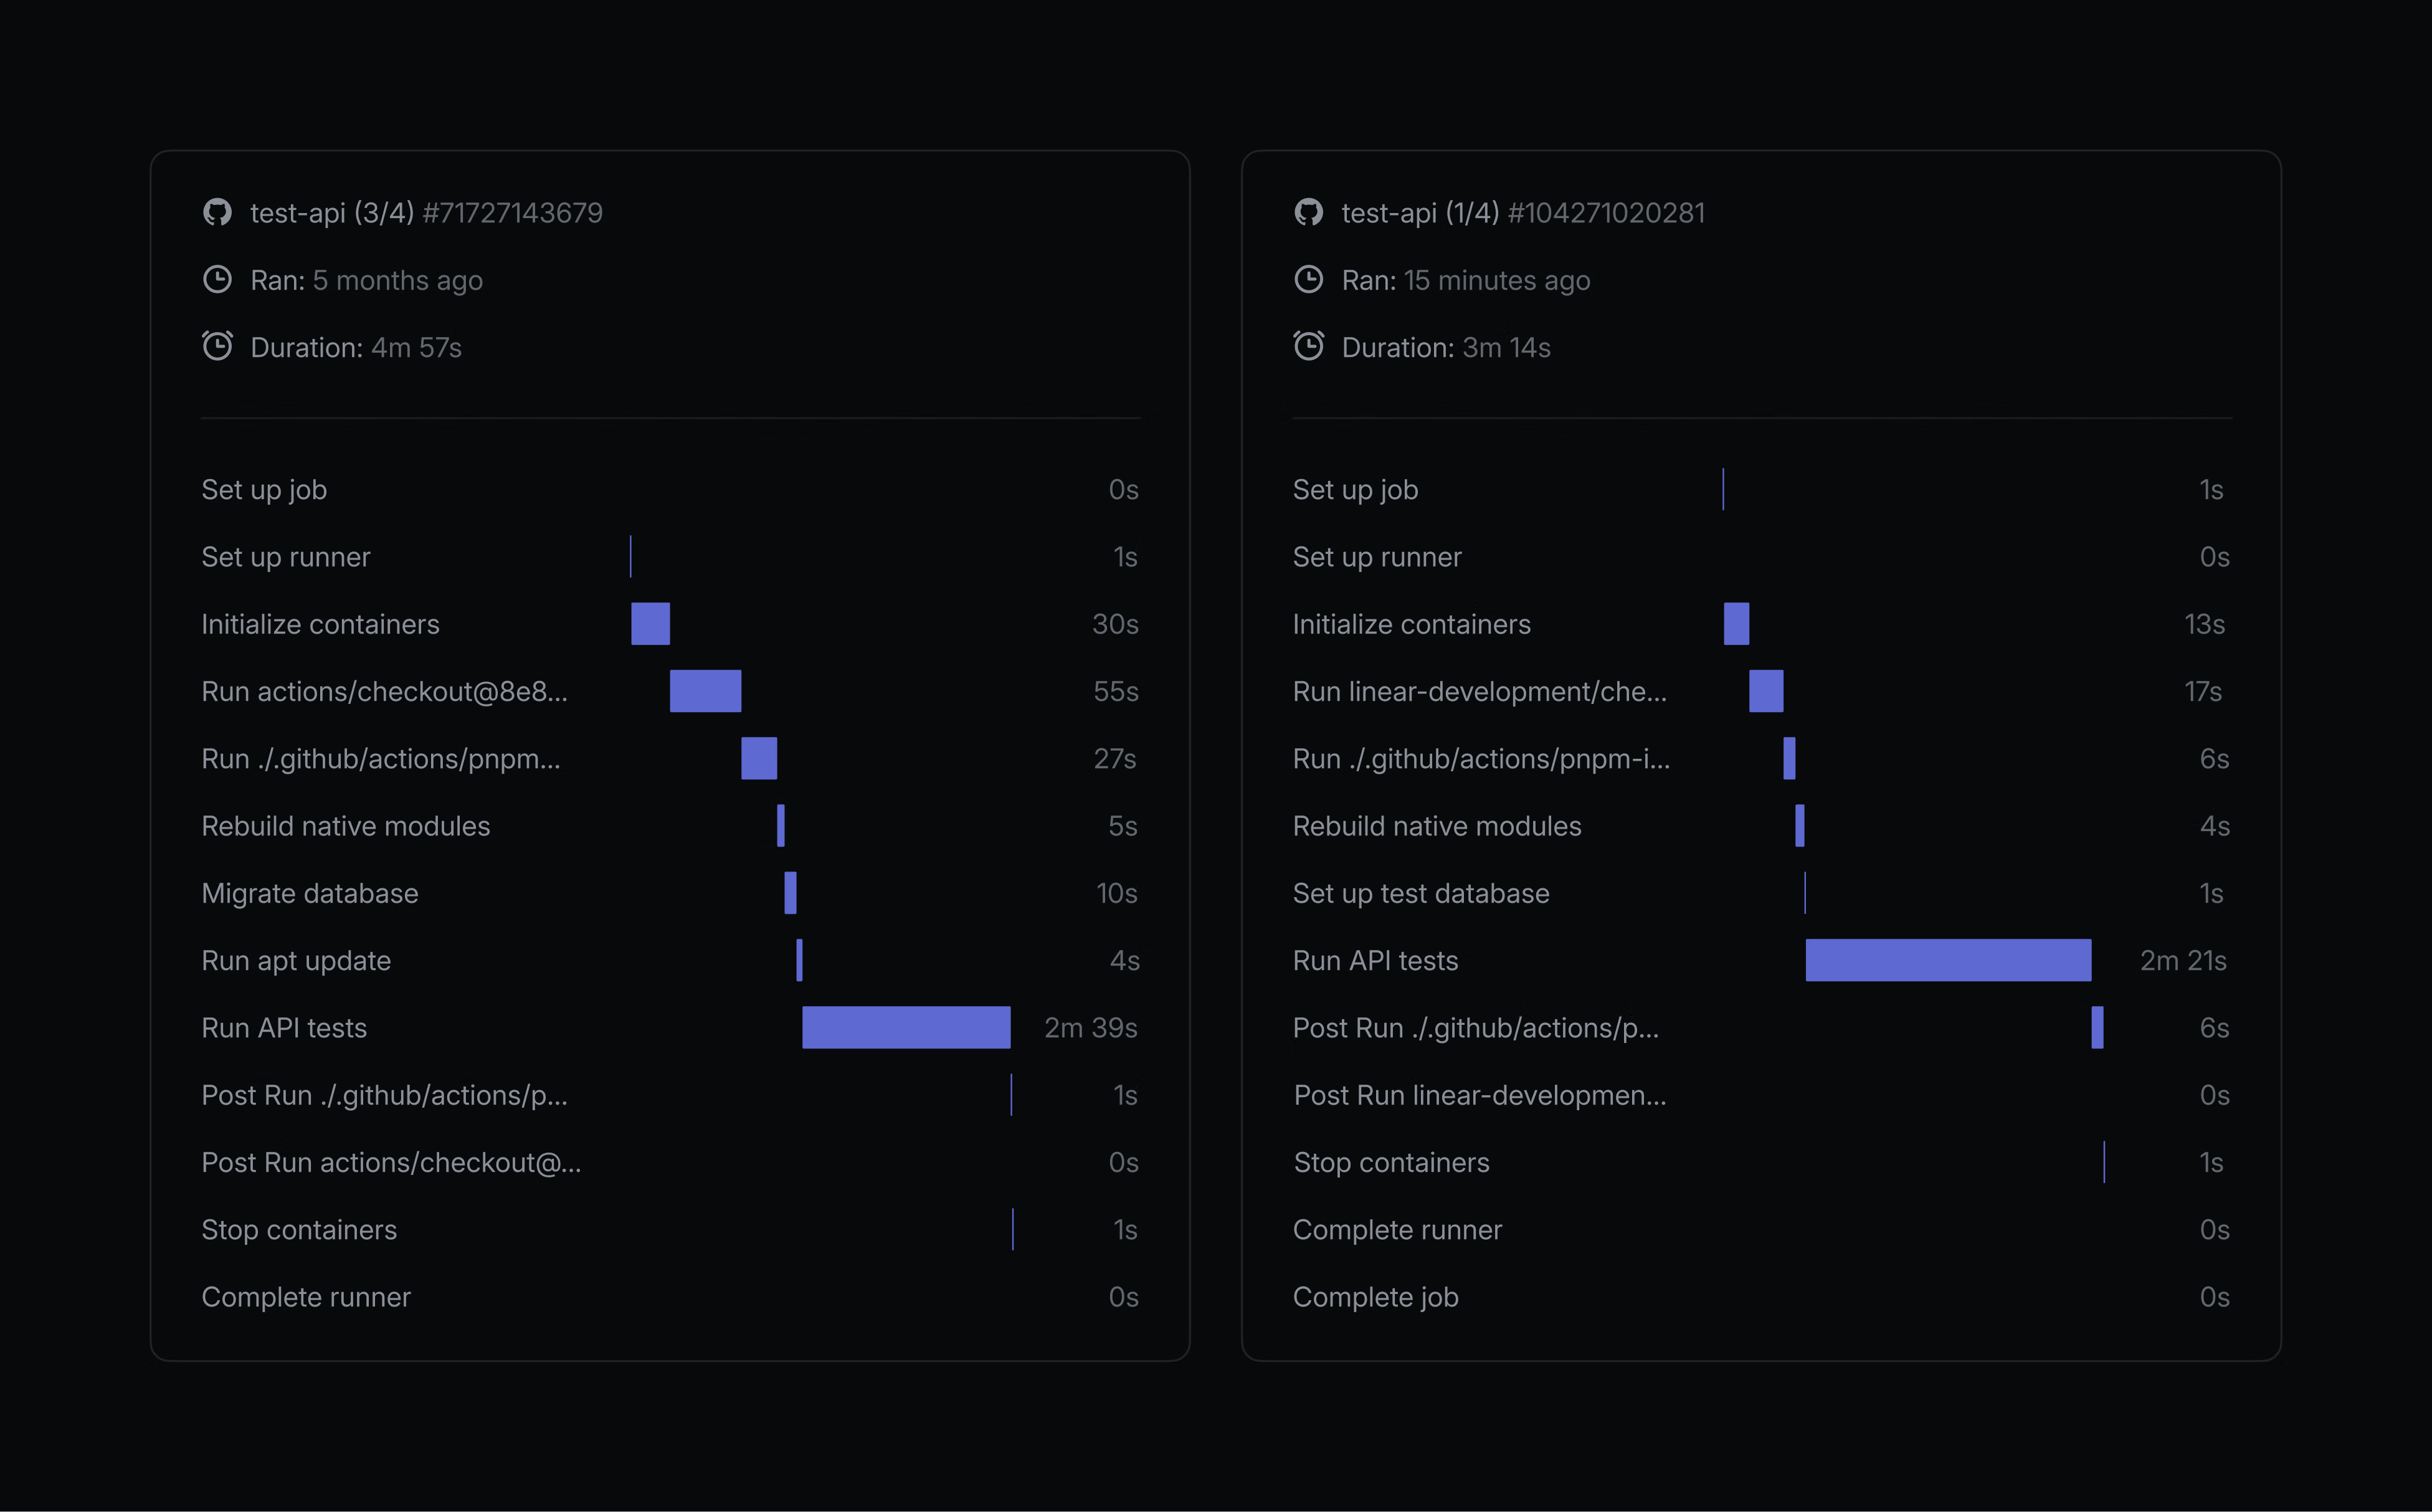
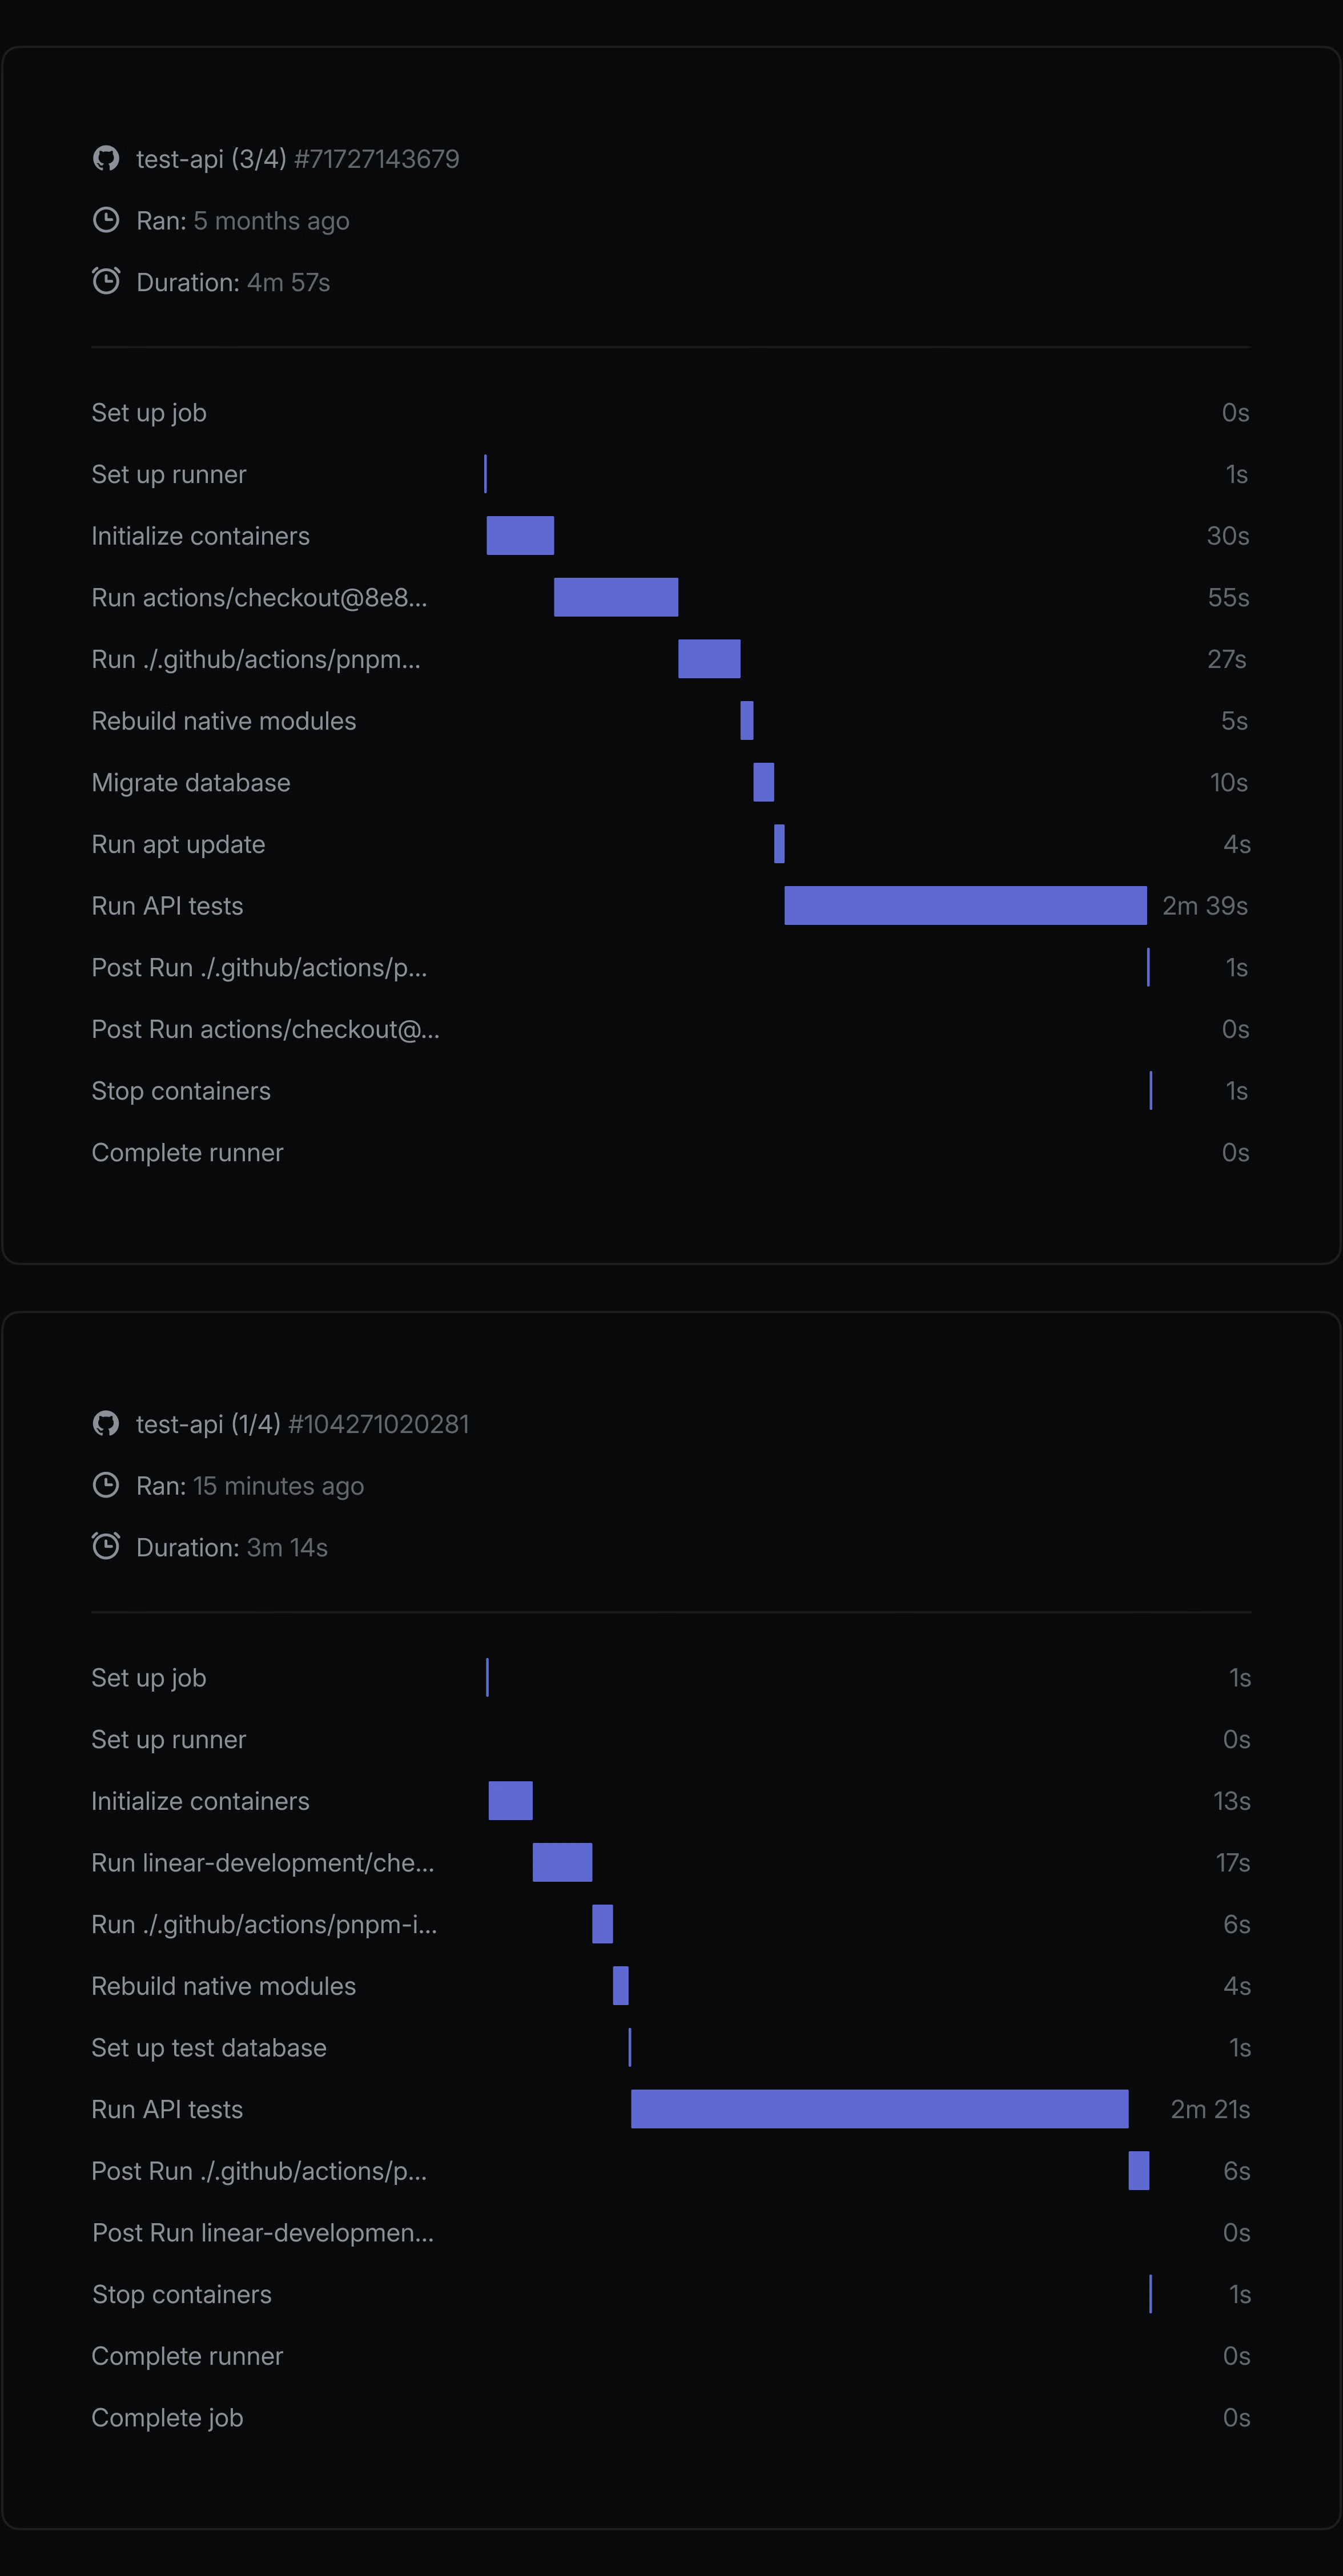
Каждый из шардов API-тестов тратил 7-8 секунд на установку одного и того же клиента Postgres через apt при каждом запуске. Переместили его в небольшой CI базовый образ, содержащий Node и клиент, чтобы каждый шард мог начать из окружения, готового к работе. Позже добавили требуемые заголовки нативной сборки в образ после обнаружения, что их загрузка во время setup иногда могла зависнуть, сократив tail.
Устанавливали только зависимости, нужные каждой задаче
Кодовая база Linear — это монорепо, управляемый как рабочее пространство pnpm. Рабочий процесс API-тестов устанавливал всё рабочее пространство, хотя нуждался только в пакете API и его зависимостях. Ограничение установки пакетом API сократило время pnpm install с 44-73 секунд до 16-18 секунд. Применили тот же подход к смежным задачам API, которые устанавливали полный репозиторий и загружали кеш зависимостей, который более поздние запуски почти никогда не использовали.
Не кешировали, когда быстрее пересчитать
Также тестировали кеширование node_modules и обнаружили, что пересчёт был быстрее. Ключ кеша зависел от часто меняющегося файла блокировки, и даже при попадании в кеш требовалось около 28 секунд на восстановление, в сравнении примерно с 7,5 секундами для отфильтрованной установки. Кеш добавлял время на сохранение и вариативность без видимого преимущества.
Вместе эти три изменения снизили время setup на шард примерно на 44%, с 110-140 секунд до 67-73 секунд.
Кроме того, были другие формы повторяющейся настройки, которые можно было вообще избежать.
Избегали повторного воспроизведения неизменённой настройки
Некоторая работа setup нуждается в повторении только, когда меняются её входные данные. Контейнеры API, например, проигрывали полную историю миграции БД при каждом запуске, даже когда PR не изменил схему. Для таких случаев переключились на загрузку сгенерированного снимка схемы и файла bootstrap вместо этого, сократив setup БД с примерно 12 секунд до 1-2 секунд на контейнер.
Батчили короткие проверки в меньше задач
Семь независимых проверок каждая запускала runner, проверяла репозиторий и устанавливала зависимости перед выполнением лишь несколько секунд полезной работы. Объединили их в две задачи, а затем запускали семь задач конкурентно внутри них. Это сократило количество раз, когда платили одинаковые накладные расходы setup, с семи до двух. На основе использования в июне изменение сэкономило примерно 87 000 runner-minutes в месяц, что эквивалентно 11,8% от общего использования CI.
Сделали выполнение тестов более эффективным
С фиксированной стоимостью каждого шарда теста снизившейся, могли позволить себе более агрессивный параллелизм API набора. Это был самый большой и один из наиболее часто выполняемых частей рабочего процесса, поэтому улучшения там оказали непропорциональное воздействие на время слияния.
Балансировали работу так, как её видит test runner
Vitest, test runner, используемый для TypeScript тестовых наборов, распределяет работу по файлам, а не по длительности отдельных тестов. Это означало, что несколько необычно больших тестовых файлов могли доминировать на шарде и фактически блокировать завершение всего набора, даже когда другие шарды завершились намного раньше.
Разбили те большие файлы на меньшие, более сфокусированные файлы, сохраняя структуру тестов, а затем оценили разные конфигурации шардов и runners. Уже перешли с трёх на четыре шарда ранее в году; переход на восемь ускорил критичную задачу примерно на 19% и сделал её дешевле на 19% в начальном бенчмарке. Через неделю после изменения самый медленный шард упал с 5,25 минут до 4,33 минут.
Делили состояние модуля только с правилами строгой изоляции
Vitest обычно изолирует каждый тестовый файл, что для нас означало пересборку графа entity, GraphQL и декоратора в каждом шарде теста. Добавили opt-in vitest проект с isolate: false, позволяя безопасным файлам делить реестр модулей внутри каждого worker.
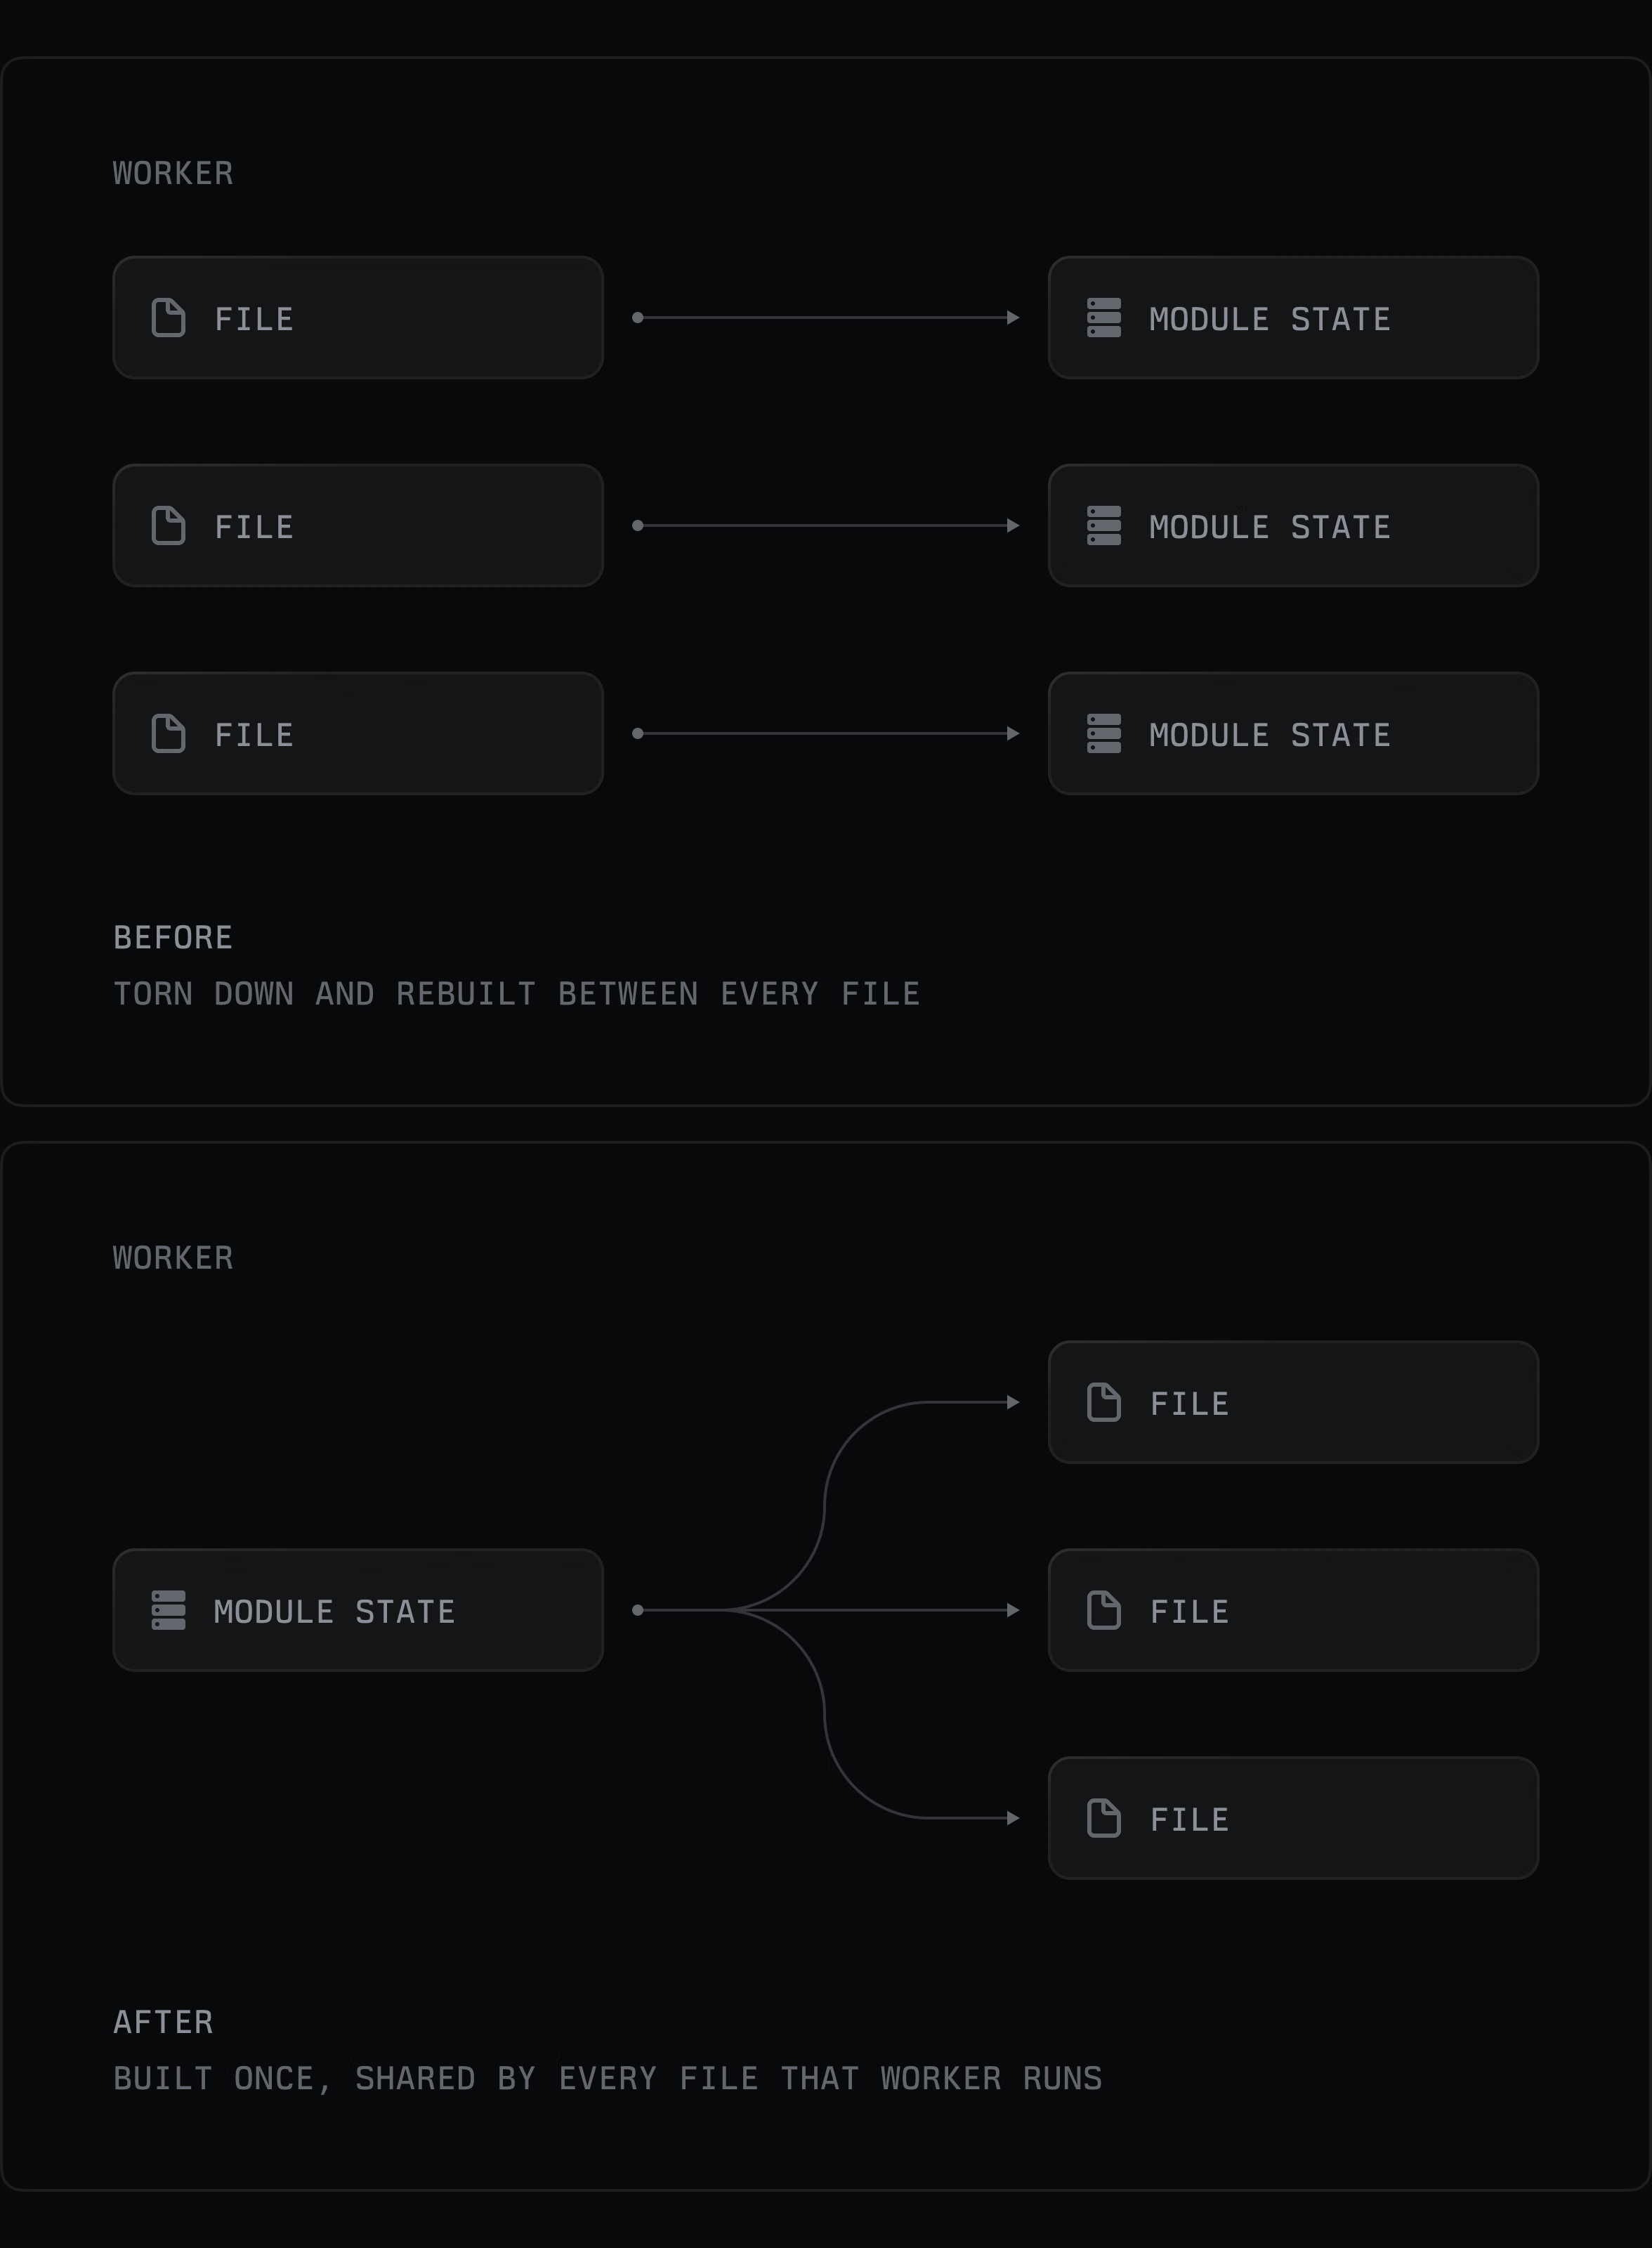
Это было крупнейшим улучшением производительности в одном изменении, стоящим примерно 17% ежемесячной экономии при объёме работ. Самый медленный шард упал примерно с 300-379 секунд до около 195 секунд, в то время как общее время API-шарда runner упало с около 32,8 до 22 минут за запуск.
Это была также оптимизация с наибольшим риском корректности. Сделали приемлемость явной с opt-in комментарием на каждом файле и добавили необходимый teardown для разделённого состояния. Несколько файлов использовали поддельные таймеры или разделённое состояние так, что невозможно было безопасно распутать, поэтому оставили их в изолированном проекте. И потому что агенты теперь пишут большинство тестов, обновили соответствующие agent skills, чтобы учесть эту opt-in производительности, поэтому генерируемые тесты по умолчанию следуют тем же ограничениям.
Шардинг ограничен накладной расходов setup
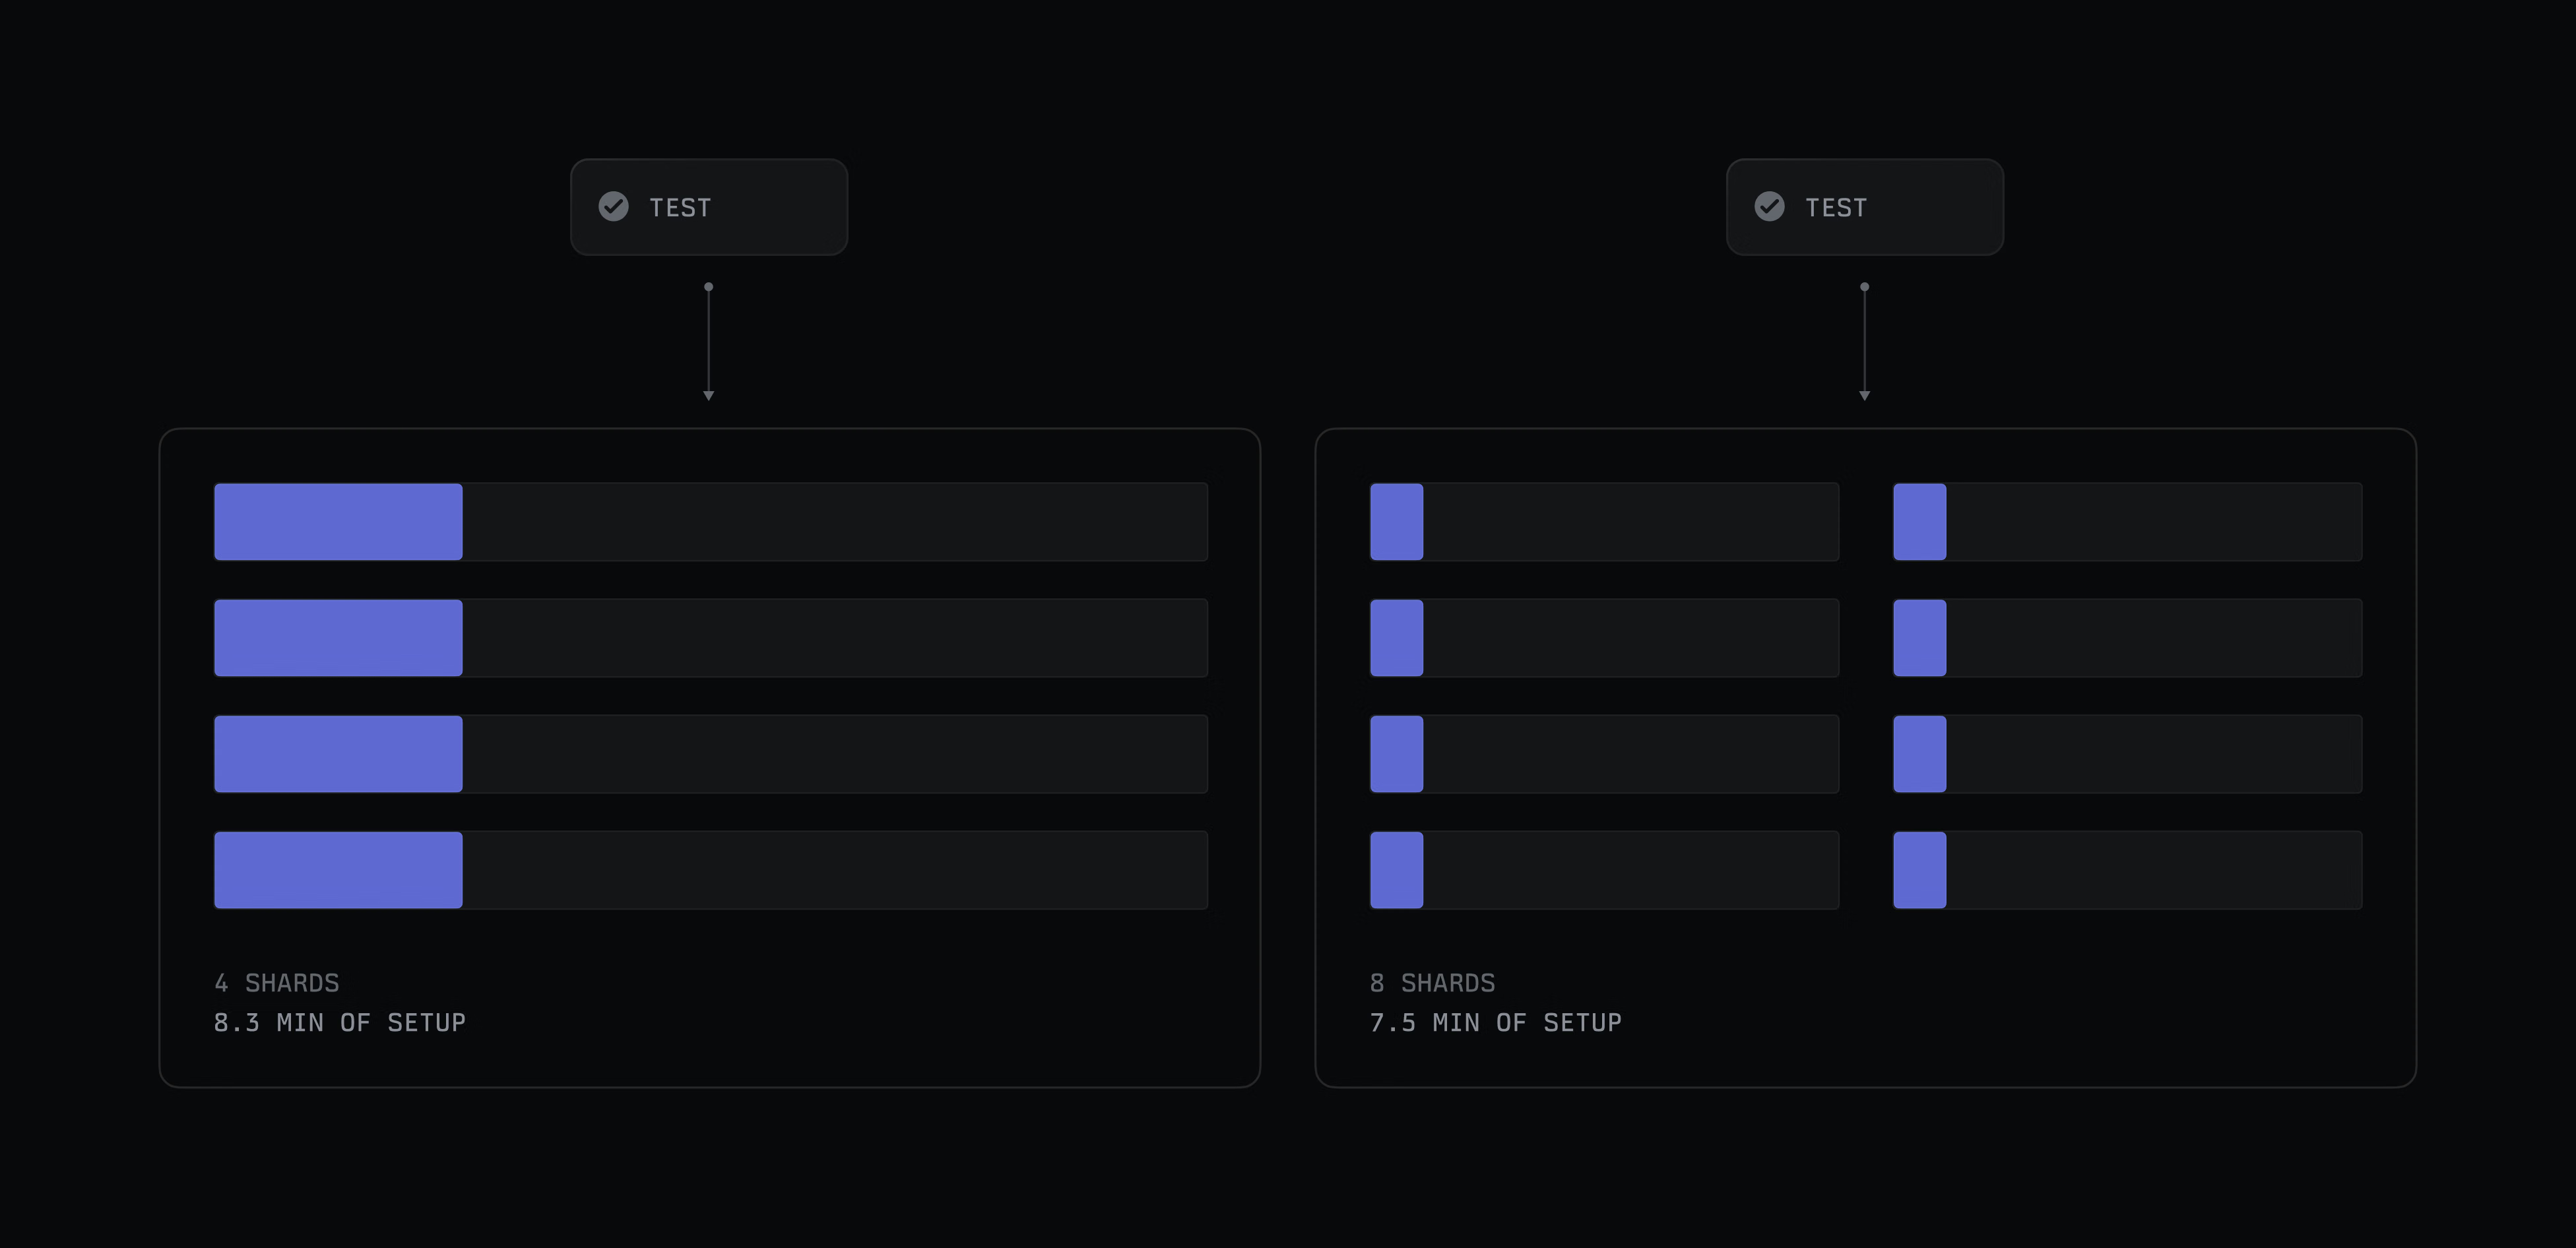
Дополнительный шардинг имеет смысл только, когда фиксированная стоимость на шард низка, потому что удвоение количества шардов также удваивает время рабочего процесса на setup. Оптимизации setup, упомянутые ранее, — вот что сделало восемь шардов практичными. При 110-140 секундах на шард восемь шардов потратили бы 15-19 минут машинного времени только на setup, больше чем сами тесты. Setup теперь около 40 секунд, поэтому восемь шардов тратят меньше общего времени setup, чем четыре раньше, параллелизируя тесты вдвое дальше.
Улучшения, которые усиливают друг друга в системе
Если бы не предпринимали целенаправленных усилий по улучшению CI в начале года, сегодняшний набор тестов занимал бы примерно 11 минут, близко к двойному тому, что разработчики ждут сейчас. И работа не заканчивается здесь. Ясно, что кодовая база будет продолжать расти; добавляют примерно 2000 тестов в неделю. Поддержание быстрой работы CI по мере этого будет постоянным усилием, большей частью используя то, что выучили в этом процессе, для новых узких мест.