Всё это просто RAG
Каждый плагин памяти на рынке работает по одной схеме:
- Пройти по сессиям диалогов
- Сгенерировать осколки «воспоминаний»
- Загрузить в RAG-базу
- На каждом запросе вытащить топ-5 и вставить в контекст
- Нужно больше? Дать агенту инструмент для поиска в RAG
Вот вся архитектура. Некоторые инструменты более изощрённы: позволяют агенту искать по прошлым диалогам слово в слово, или реализуют многоуровневую память (краткосрочная/долгосрочная). Добавляют фоновые демоны для пересмотра, слияния, дедупликации воспоминаний. «Мечтателей», которые переписывают память ночью. Непрерывное сжатие контекста. Переранжирование. И так далее.
Каждый плагин пытается добавить новые сжигающие токены «фичи», чтобы починить одну и ту же порочную архитектуру снизу. Вот почему ни один из них не работает надёжно.
Проблема с восстановлением информации
Все эти плагины памяти страдают от одного и того же набора проблем.
- Воспоминания всплывают по схожести. Поиск по похожести ранжирует, насколько близко два осколка находятся в пространстве эмбеддингов. И всё. Неясно, какой из них правильный, актуальный или какой информации не хватает.
- Воспоминания хранятся без контекста. RAG-осколок может содержать столько-то. Всё остальное теряется: окружение, мотивация, уроки, среда и прочее.
- Прошлое считается истиной. Все эти плагины полагаются на восстановление: поиск по диалогам или базе векторов. Но кодовая база меняется каждый день — насколько точны все 500 осколков про аутентификацию?
- Агент не может искать то, что не знает. Даже если дать агенту инструмент поиска, откуда он будет знать, когда его использовать? Агент не знает, что он не знает.
- Хранилище невозможно аудировать. В SQLite 10 000 эмбеддингов. Какие воспоминания существуют? Какие устарели? Какие никогда не вытаскивались? Какие неправильные и скрытно влияют на поведение агента?
Это только пять из множества проблем, которые плагины памяти пытаются решить и не решают, потому что все предполагают одно и то же:
Агенты забывают — вот проблема. Решение — помнить. Помнить лучше — значит, захватывать больше, индексировать лучше, вытаскивать умнее.
Вся их логика вращается вокруг захвата и восстановления прошлого. Но так никто больше знания не обрабатывает. Никто не пересматривает встречу от 3 года назад, чтобы вспомнить ограничения вокруг фичи. Люди записывают информацию и потом пользуются этими записями.
Точно так же решение — это НЕ дать агенту инструмент поиска, чтобы он перетасовывал 10 миллионов токенов диалогов, собирая осколки того, что произошло.
Решение — это память на основе документов.
Документация вместо восстановления
Люди уже давно понимали, что агентам нужен контекст. Поэтому они создали файлы AGENTS.md — чтобы агент не прыгал в кодовую базу вслепую. Это работает. Но часто этот единственный файл — это ВСЯ документация проекта.
Одного файла недостаточно. Агенту нужен целый мозг — структурированное рабочее пространство, где он может записывать инструкции, спеки, решения, исследования, индексы — всё, без просьб. Инструкции, как работает процесс code review. Спеки, что обсуждалось с пользователем. Исследования в незнакомые библиотеки или API.
Когда агент работает, он читает файлы из своего мозга, чтобы получить актуальный и полный контекст. Когда работа закончена, агент обновляет устаревшее, добавляет новые документы, пока полная картина ещё в памяти. Так цикл агента меняется с запрос → сборка → забывание на запрос → консультация → сборка → обновление. Память из RAG-базы, которую приклеивают к агенту, становится рабочим пространством, которое можно читать, обновлять и даже делить с командой.
Проверка на практике
Эту проблему заметили более года назад, когда начали программировать с AI. Было нужно, чтобы агент помнил работу между сессиями, поэтому создали папку internal/, где просили агента всё записывать: спеки, планы, индексы. Дали указание агенту всегда читать нужные документы перед работой и обновлять их потом.
Эти первобытные инструкции медленно трансформировались в формальную систему, а потом в плагин Operator Memory, который используется регулярно во всех проектах.
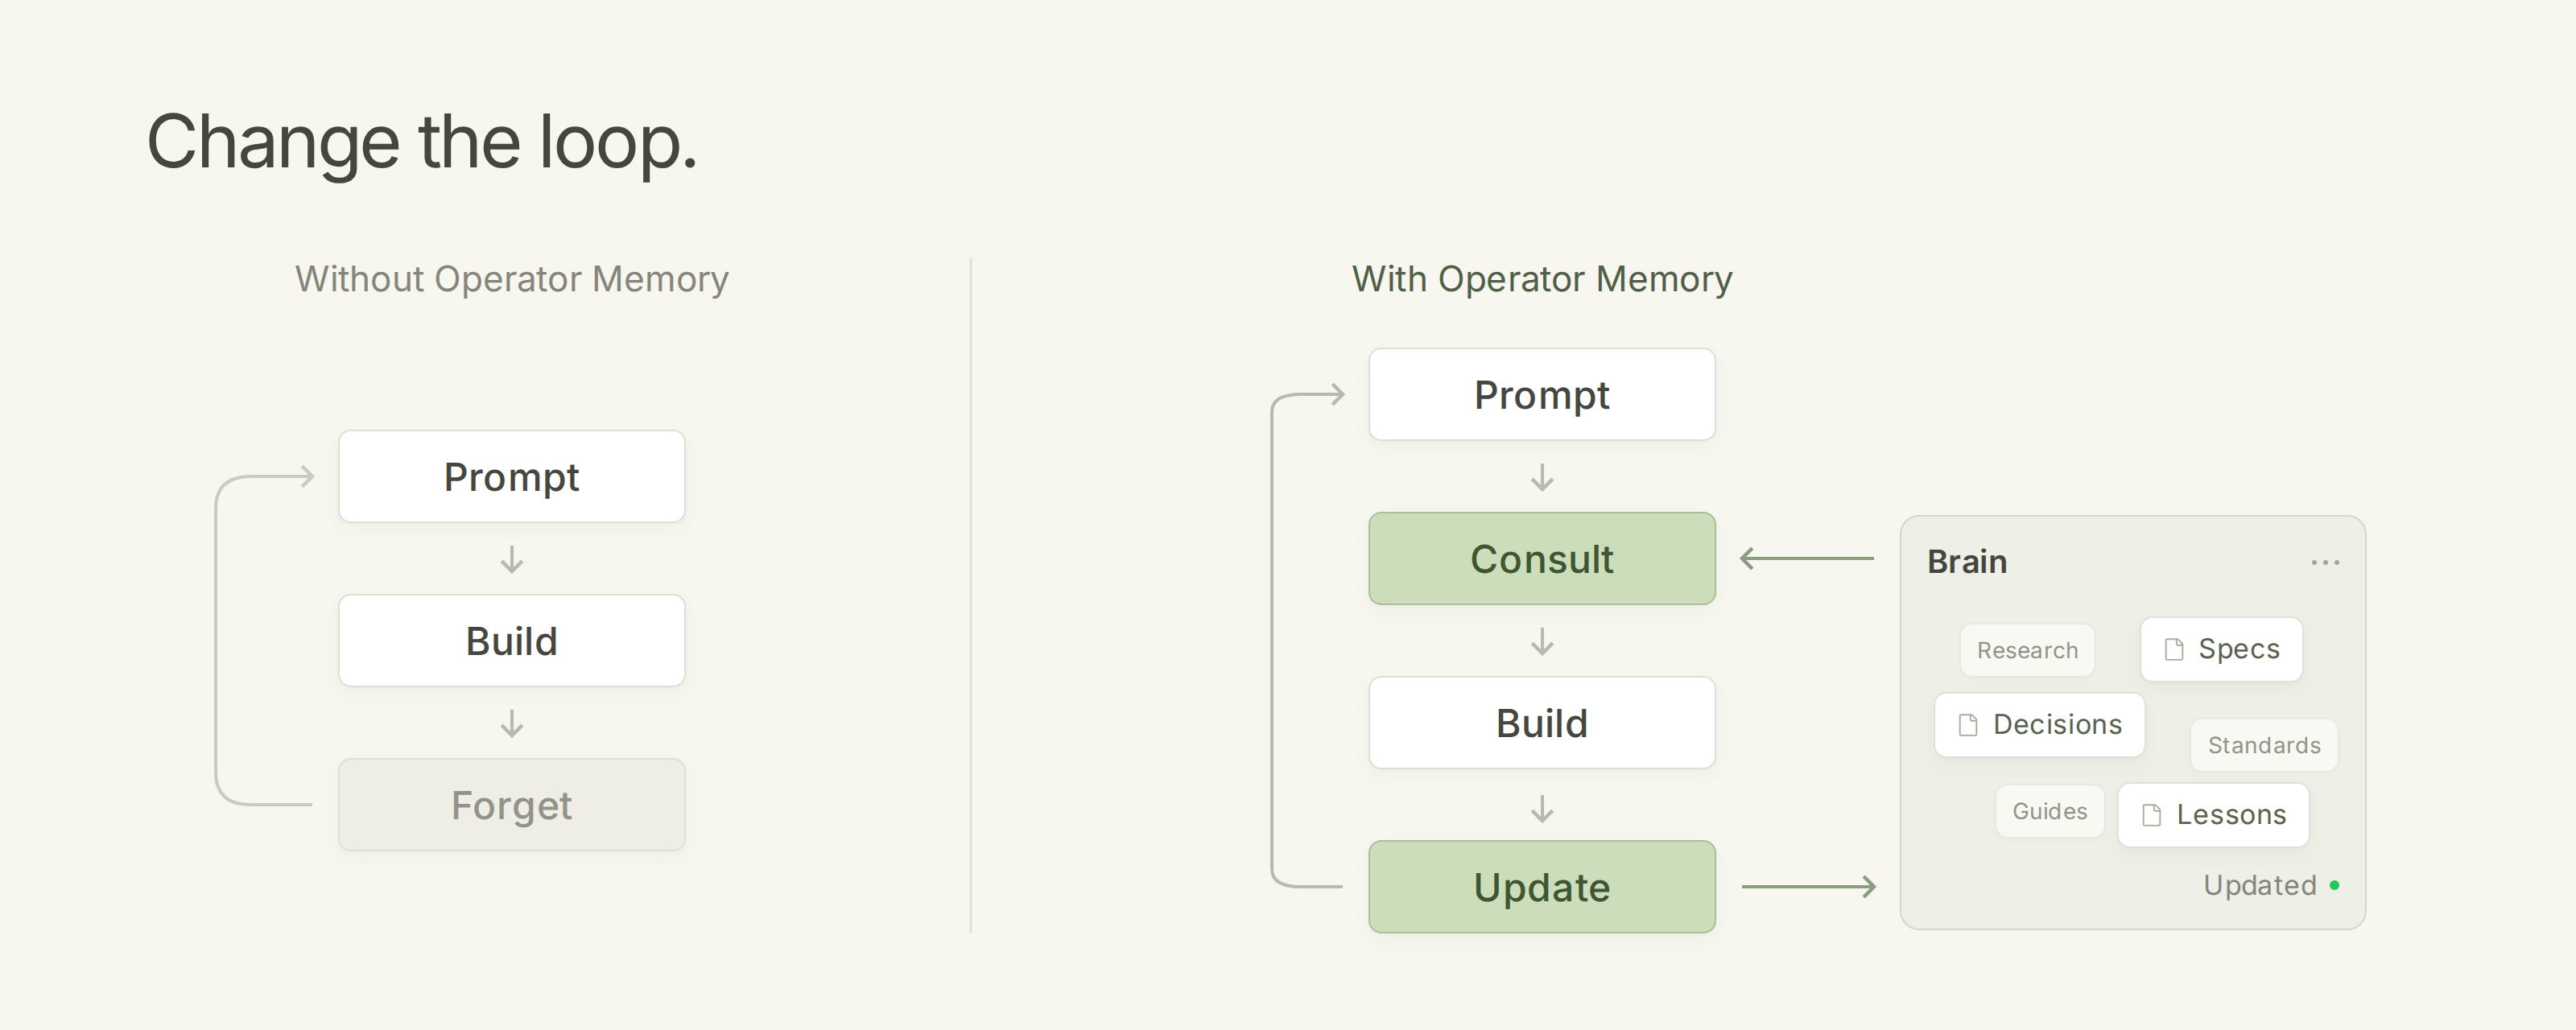
Operator Memory предоставляет память на основе документов по описанной выше модели. Агент получает Markdown-мозг, где может сохранять важные знания: инструкции, спеки, исследования, индексы. Перед работой агент всегда консультирует мозг по актуальным документам. После работы обновляет мозг: пересматривает устаревшее, добавляет недостающее.
Никаких векторных баз. Никаких эмбеддингов. Никаких суммаризаторов, кураторов, обновляющих демонов, мечтателей или других сжигающих токены фоновых процессов. Никаких чёрных ящиков с поиском.
В Operator всё — обычный Markdown-документ, который можно читать, обновлять, коммитить и делить с командой. Эта система используется более года. Попробовать можно бесплатно, это open source: https://github.com/aerovato/operator-memory