Артикли: письменная форма vs произнесение
В английском языке существует неопределённый артикль a, который ставится перед словом. Например, a raccoon. Но для некоторых слов используется an. Например, an apple.
При процедурном создании текста (скажем, в видеоигре или генераторе квестов) нужна функция, которая определяет правильный артикль: a_or_an("apple"). Кажется, это просто — проверим первую букву на гласную. Но такой подход даст неправильный результат: an unicorn вместо a unicorn.
Настоящее правило основано не на письменном виде слова (какой буквой оно начинается), а на произнесении (какой звук на слух). Слово <unicorn> начинается с гласной буквы (<u>), но с согласного звука (в cmudict — Y, в IPA — /j/). Слово <hour> начинается с согласной буквы (<h>), но с гласного звука (в cmudict — AW, в IPA — /aʊ/).
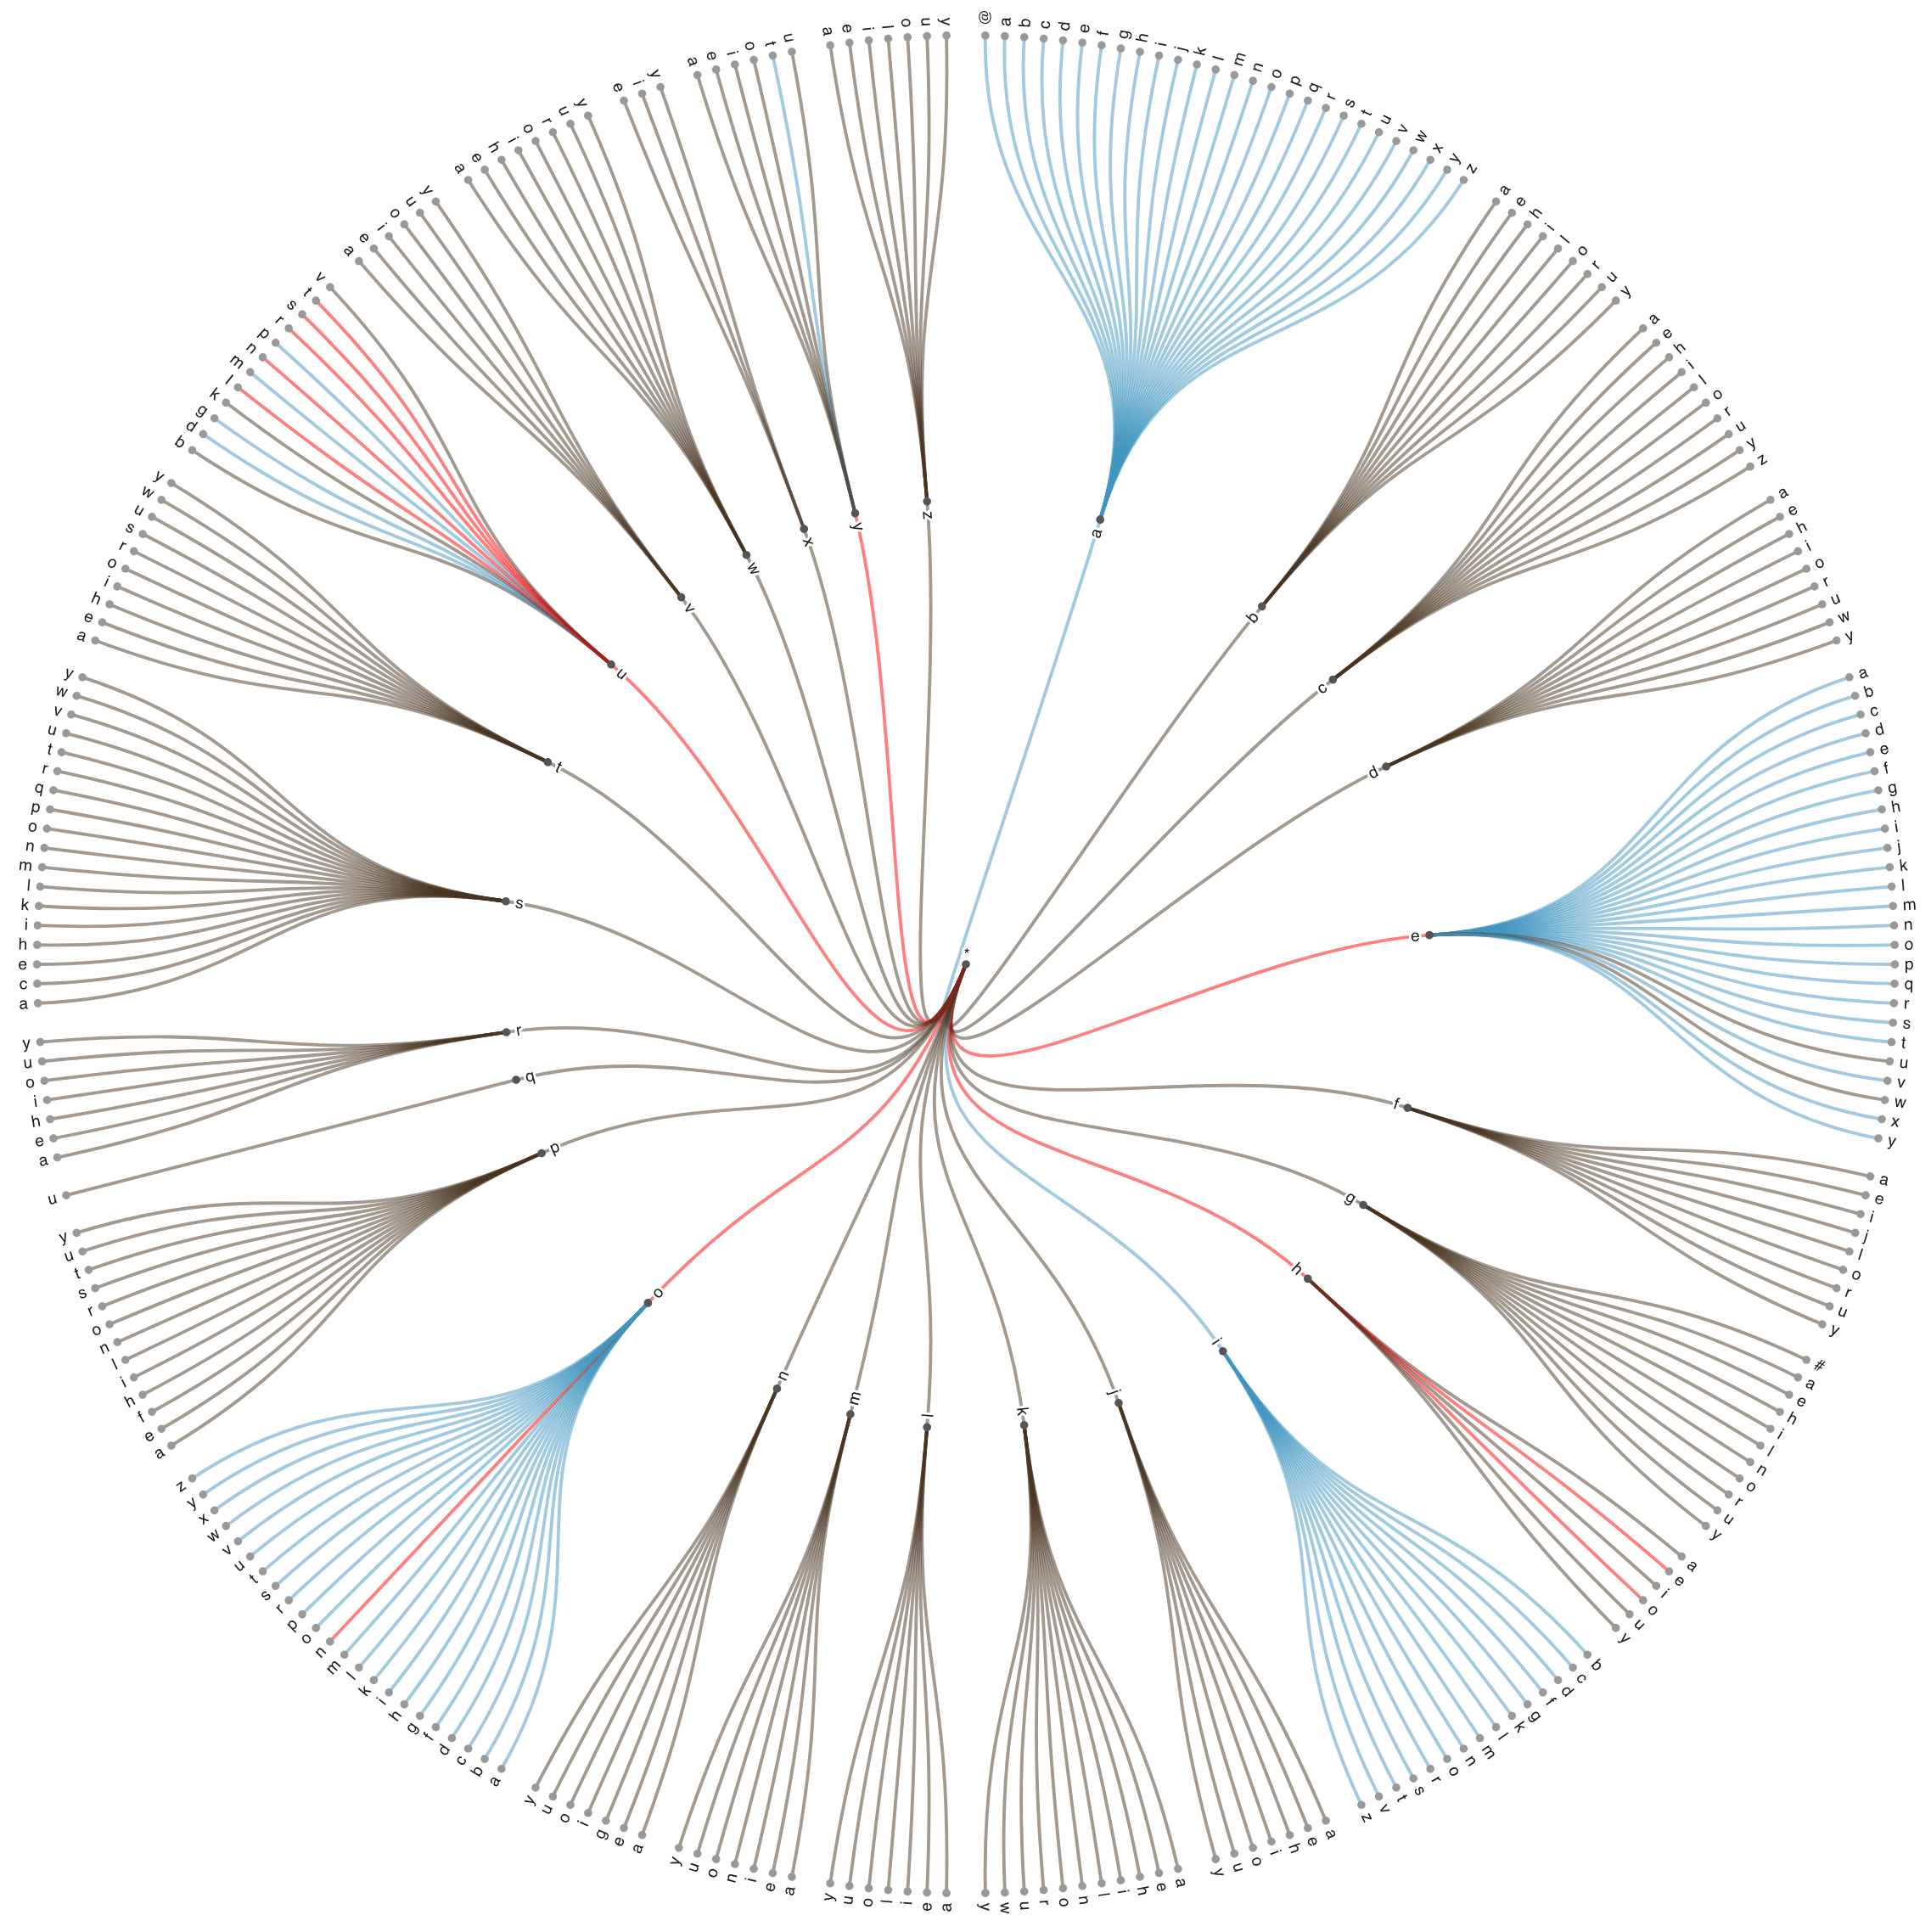
Разработчик решил проверить, как часто встречаются такие исключения и можно ли их сгруппировать, поэтому потратил день на анализ данных и создание визуализаций. Результаты оказались неожиданными: из 32 455 слов в списке исключения требовались всего для 129 слов.
Стоит отметить замечание от автора:
Я не использовал LLM для написания этого кода, но задним числом понимаю, что стоило бы. Это одноразовый код для ответа на вопрос — ему не нужна чистота или переиспользуемость, только корректность. Я потратил бы больше времени на оптимизацию алгоритма построения trie и меньше на парсинг cmudict и переучивание d3.js.