Цифры в начале
Edge-функция запускается перед сайтом на каждом входящем запросе. Время её выполнения — это время, которое ждёт пользователь, поэтому даже миллисекунды здесь имеют значение.
Для «тёплого» вызова — маршрутизация на compute-ноду, запуск MicroVM, выполнение функции, передача заголовков ответа — требуется:
- ~5–6 мс при медиане (p50), снизилось с 25–40 мс на старой инфраструктуре
- На 47,4% быстрее вызовы на уровне p99
- 99,998% доступность
- В 5 раз быстрее доставка логов edge-функций
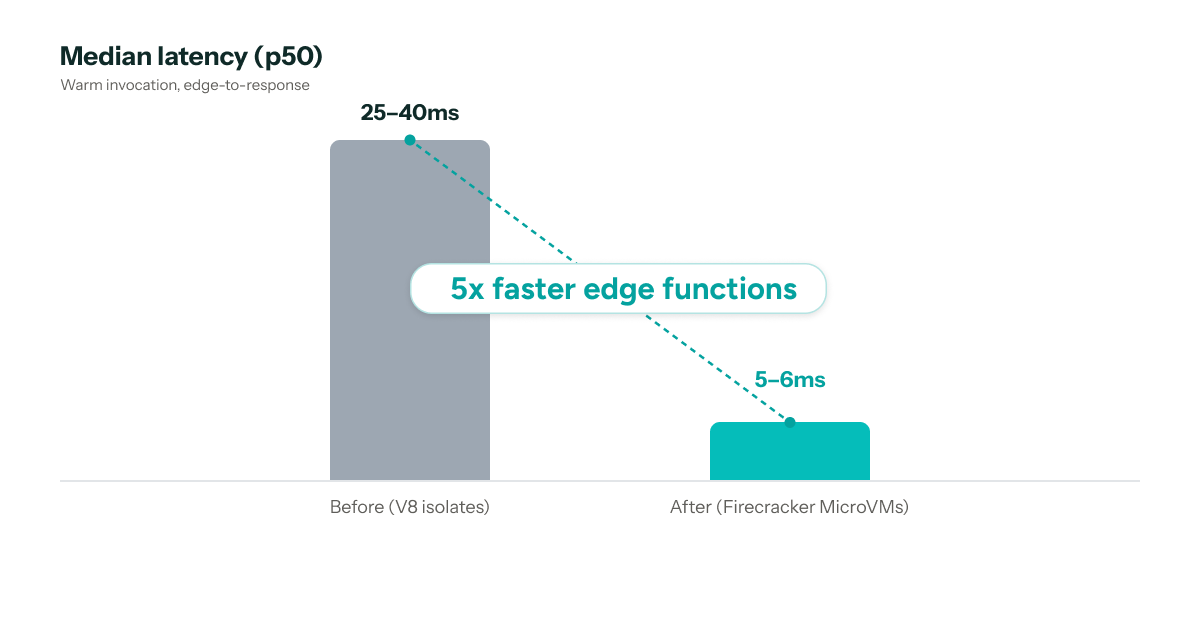
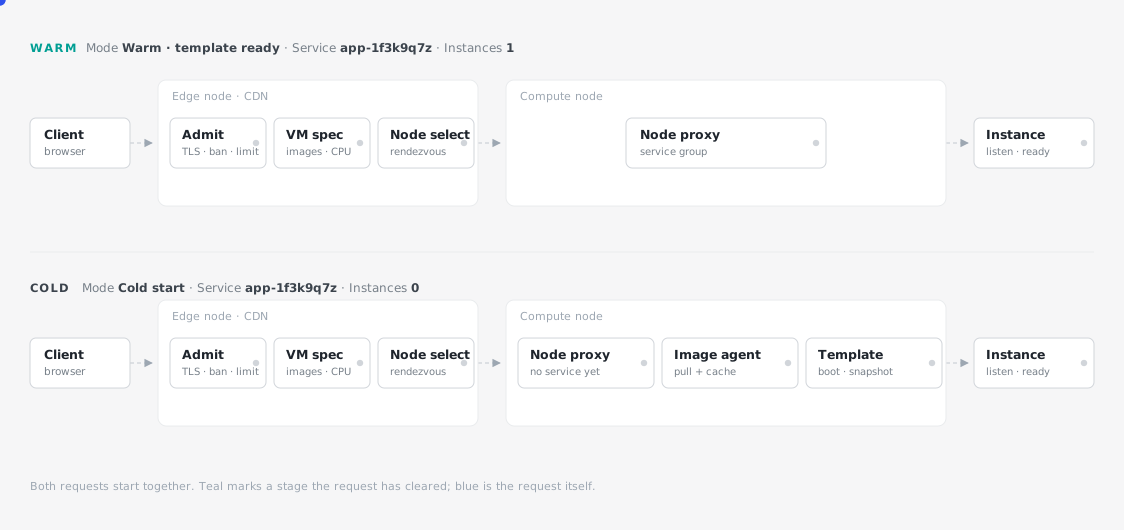
Стоит отметить и «холодные» вызовы. Когда запрос поступает в регион, где ещё не было compute-ноды, нужно сначала загрузить нужные образы. Это происходит примерно в 1,2% вызовов и занимает в среднем около 9 мс.
Что происходит во время запроса
Путь одного запроса: он приходит на edge-ноду, преобразуется в спецификацию, маршрутизируется на compute-ноду и передаётся MicroVM, которая может уже существовать (теплый вызов) или быть созданной впервые (холодный вызов).
Запрос приходит на edge-ноду
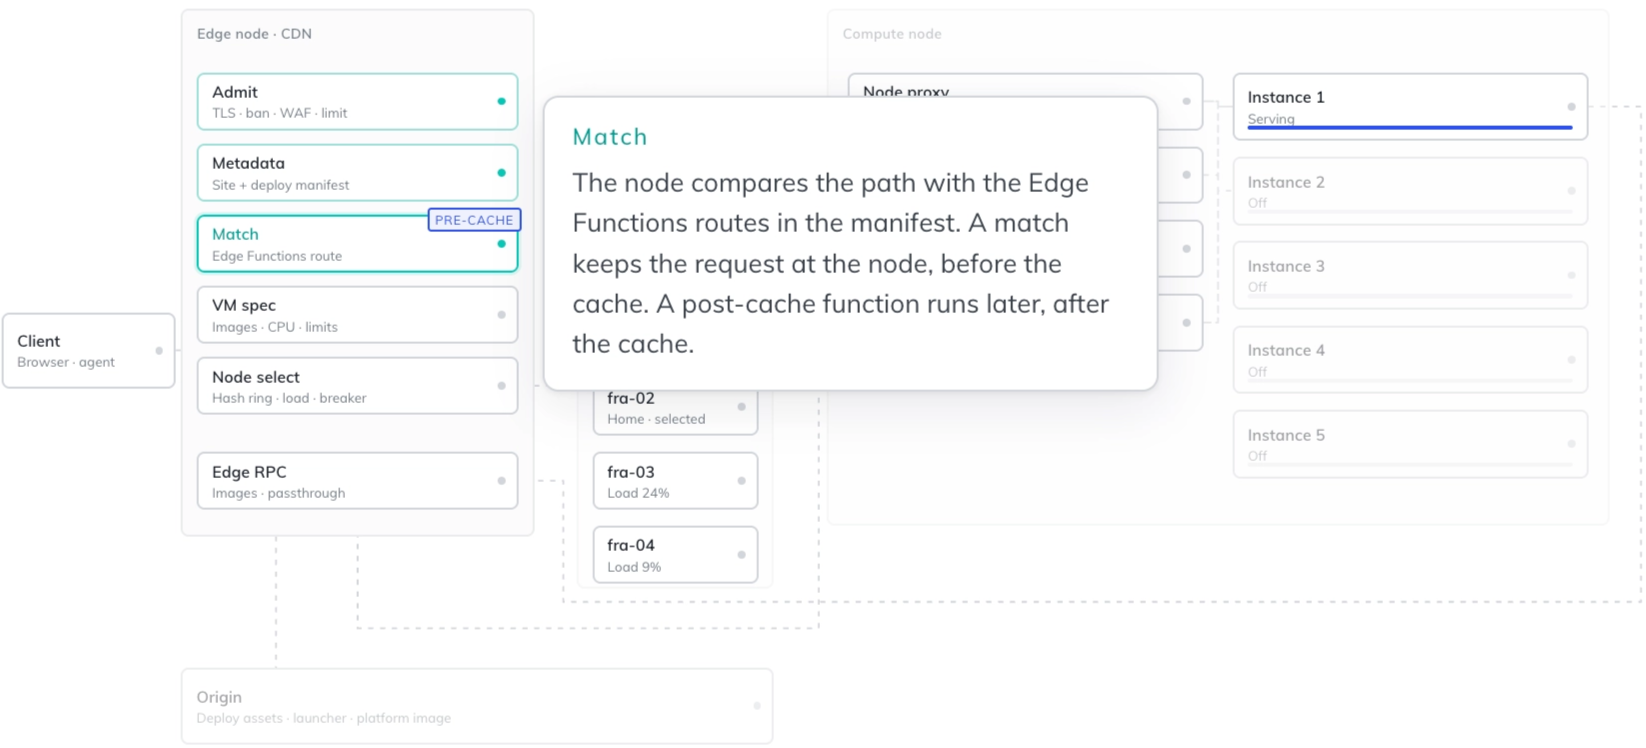
Каждый запрос попадает на ближайшую к клиенту edge-ноду Netlify. Нода завершает TLS-соединение и проверяет путь запроса против маршрутов Edge Functions для данного deploy.
Если ничего не совпадает, запрос идёт дальше в кэш и на origin как обычно. Если маршрут найден, это была раньше точка, где запрос покидал сеть Netlify. На старой инфраструктуре он уходил в интернет, выполнялась edge-функция, и результат возвращался. Теперь запрос пересылается на compute-ноду внутри сети.
Создание сервиса Edge Function
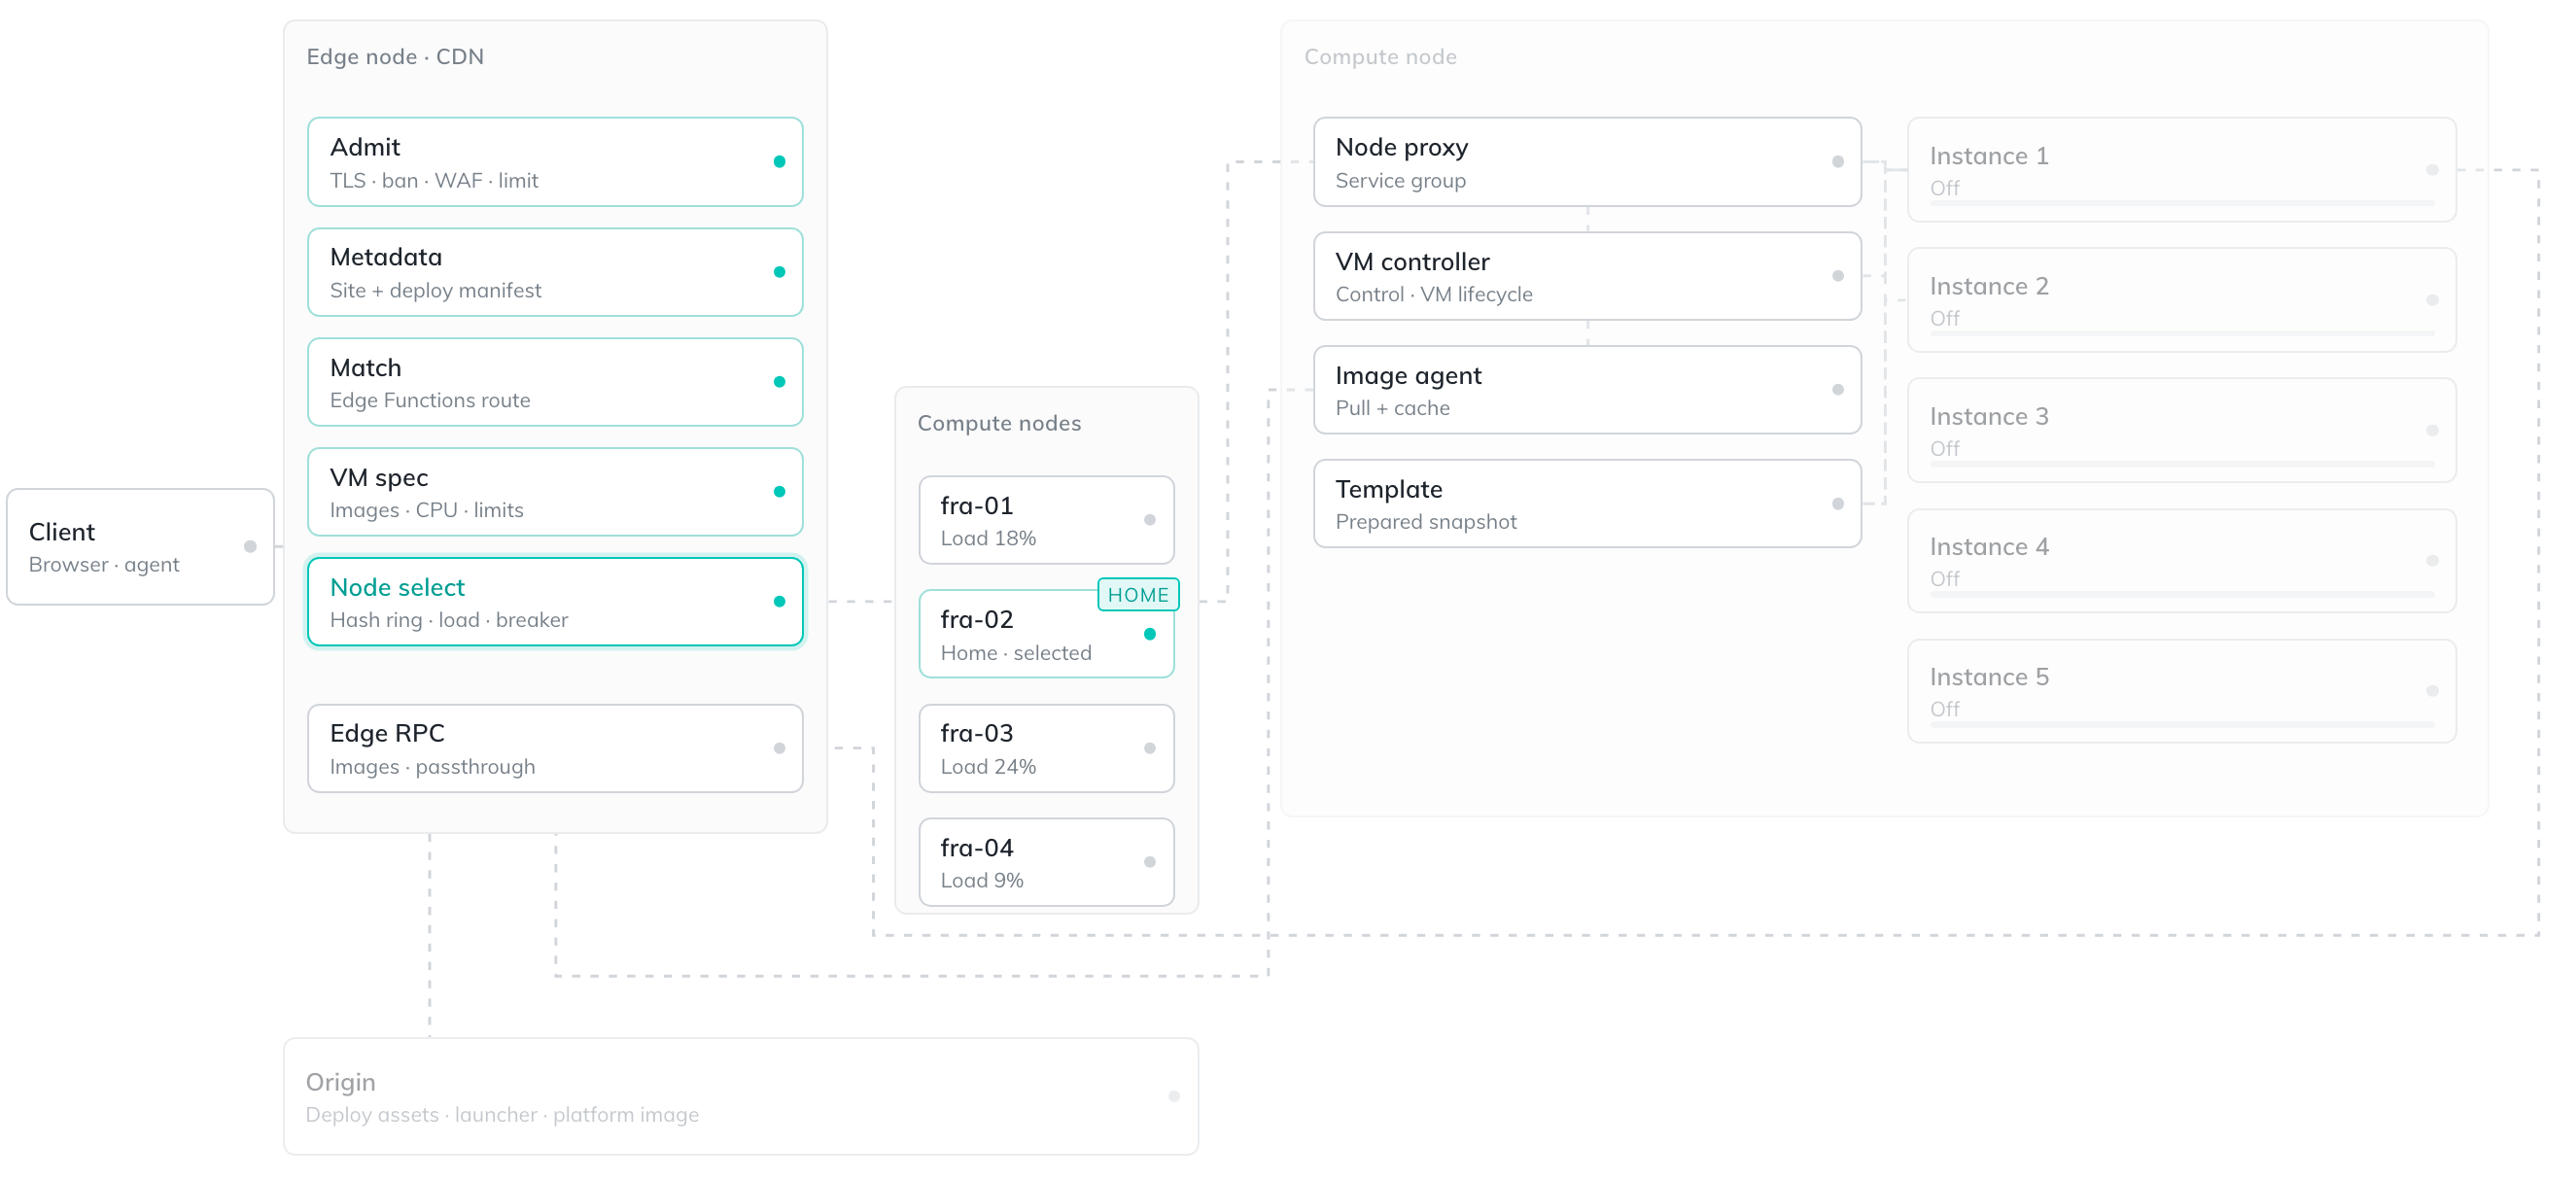
Когда compute-нода получает запрос со спецификацией машины и ID сервиса, она сначала проверяет, существует ли сервис с таким ID. Если существует — передаёт запрос в сервис, чтобы тот отправил его в MicroVM. Сервис позволяет связать несколько MicroVM с одним сайтом и настроить параметры масштабирования. Например, каждый сервис настроен так, чтобы MicroVM обрабатывала только фиксированное количество запросов перед выключением — это предотвращает неограниченный запуск VMs. Те же параметры используются, чтобы заранее запустить новую MicroVM в ожидании выключения текущей.
Если сервис edge-функций сайта на compute-ноде не существует, он создаётся, и проверяется, есть ли все образы из спецификации на диске. Если каких-то не хватает, они загружаются с edge-ноды и записываются на диск. Это означает, что образы edge-функций загружаются только в те регионы, где они получают трафик.
Edge-нода пишет спецификацию
Перед тем как запрос уходит куда-то, edge-нода пишет спецификацию машины, которая будет запускать функцию. Спецификация определяет три образа: runtime, платформенный образ Netlify и образ edge-функции. Также устанавливаются лимиты CPU, памяти и соединений.
Спецификация идёт с запросом на каждом шаге. Её хеш и информация о сайте вычисляются для получения ID сервиса. Это обеспечивает изоляцию: два deploy с разным кодом или переменными окружения — это разные сервисы, которые никогда не делят MicroVM.
Эта изоляция особенно важна для предотвращения определённых сбоев. Потенциально скомпрометированный deploy работает в отдельной MicroVM, и даже если ему удастся выбраться из runtime, он не может повредить других клиентов или саму compute-слой. V8 isolates, несмотря на название, не обеспечивают такой уровень изоляции.
Выбор compute-ноды для edge-функции
В каждом регионе есть группа compute-нод. Edge-нода выбирает одну для сервиса, используя rendezvous hashing: один и тот же сервис всегда попадает на одну ноду, что держит MicroVM в «тёплом» состоянии, и код уже находится на диске и в кэше. Эта «липкость» даёт стратегию кэширования. Если равномерно распределить запросы по всему парку нод, получится больше холодных стартов.
Важно помнить, что отправка всех запросов функции на одну compute-ноду — это быстрый путь, но и способ создать горячую точку, где одна занятая функция конкурирует за ресурсы со всем остальным на машине. Если сервис берёт большую часть регионального трафика и прикреплён к одной ноде, он насытит ноду в ущерб другим сервисам.
Баланс достигается ослаблением «липкости». После определённого порога сервис распределяется по срезу нод. Это позволяет поглотить внезапный скачок трафика одного клиента без влияния на другие сервисы, которые хешировались на ту же ноду.
Наконец, как только нода выбрана, она загружает код функции. Compute-нода, которая раньше обслуживала функцию, уже имеет его. Нода, видящая функцию впервые, загружает её один раз и кэширует — только первый запрос платит эту цену.
Запуск MicroVM
Каждая функция работает в собственной Firecracker MicroVM. Они создаются за меньше миллисекунды и стартуют примерно за 2 мс на уровне p99, потому что VM загружает урезанную окружение Linux, а не полную операционную систему. Файлы edge-функции монтируются как несжатый EROFS-образ и затем отображаются в памяти, поэтому VM читает только те части bundle, которые фактически использует, вместо загрузки всего.
Когда MicroVM загружается и JavaScript-сервер начинает слушать на порту, делается снимок MicroVM. Когда edge-функция не вызывается, MicroVMs масштабируются до нуля вместо простоя. При следующем вызове новая MicroVM запускается из этого снимка. Снимок отображён в памяти, поэтому VM может начать выполняться, не дожидаясь загрузки всего снимка обратно в память.
Жизненный цикл VM — загрузка, снимок, восстановление и масштабирование до нуля — это работа продукта Unikraft. Мы тесно сотрудничали с ними на протяжении миграции, чтобы убедиться, что это выдерживает наш объём запросов и паттерны трафика.
Выполнение и обработка ответов
После нескольких лет работы над этим проектом мы уже накопили опыт, который применили для максимизации производительности и возможности отладки. В масштабе мы столкнулись со всеми видами проблем — от нехватки портов на виртуальных коммутаторах до DNS (мы были удивлены, но не всегда был DNS).
На этот раз мы убедились, что compute-ноды запускают локальные DNS-резолверы. Также расширили метрики, которые собираем — записываем время загрузки, время до первого открытого порта, время до начала пользовательского кода. Также есть несколько circuit breaker, которые гарантируют быструю переадресацию и вывод compute-нод из строя.
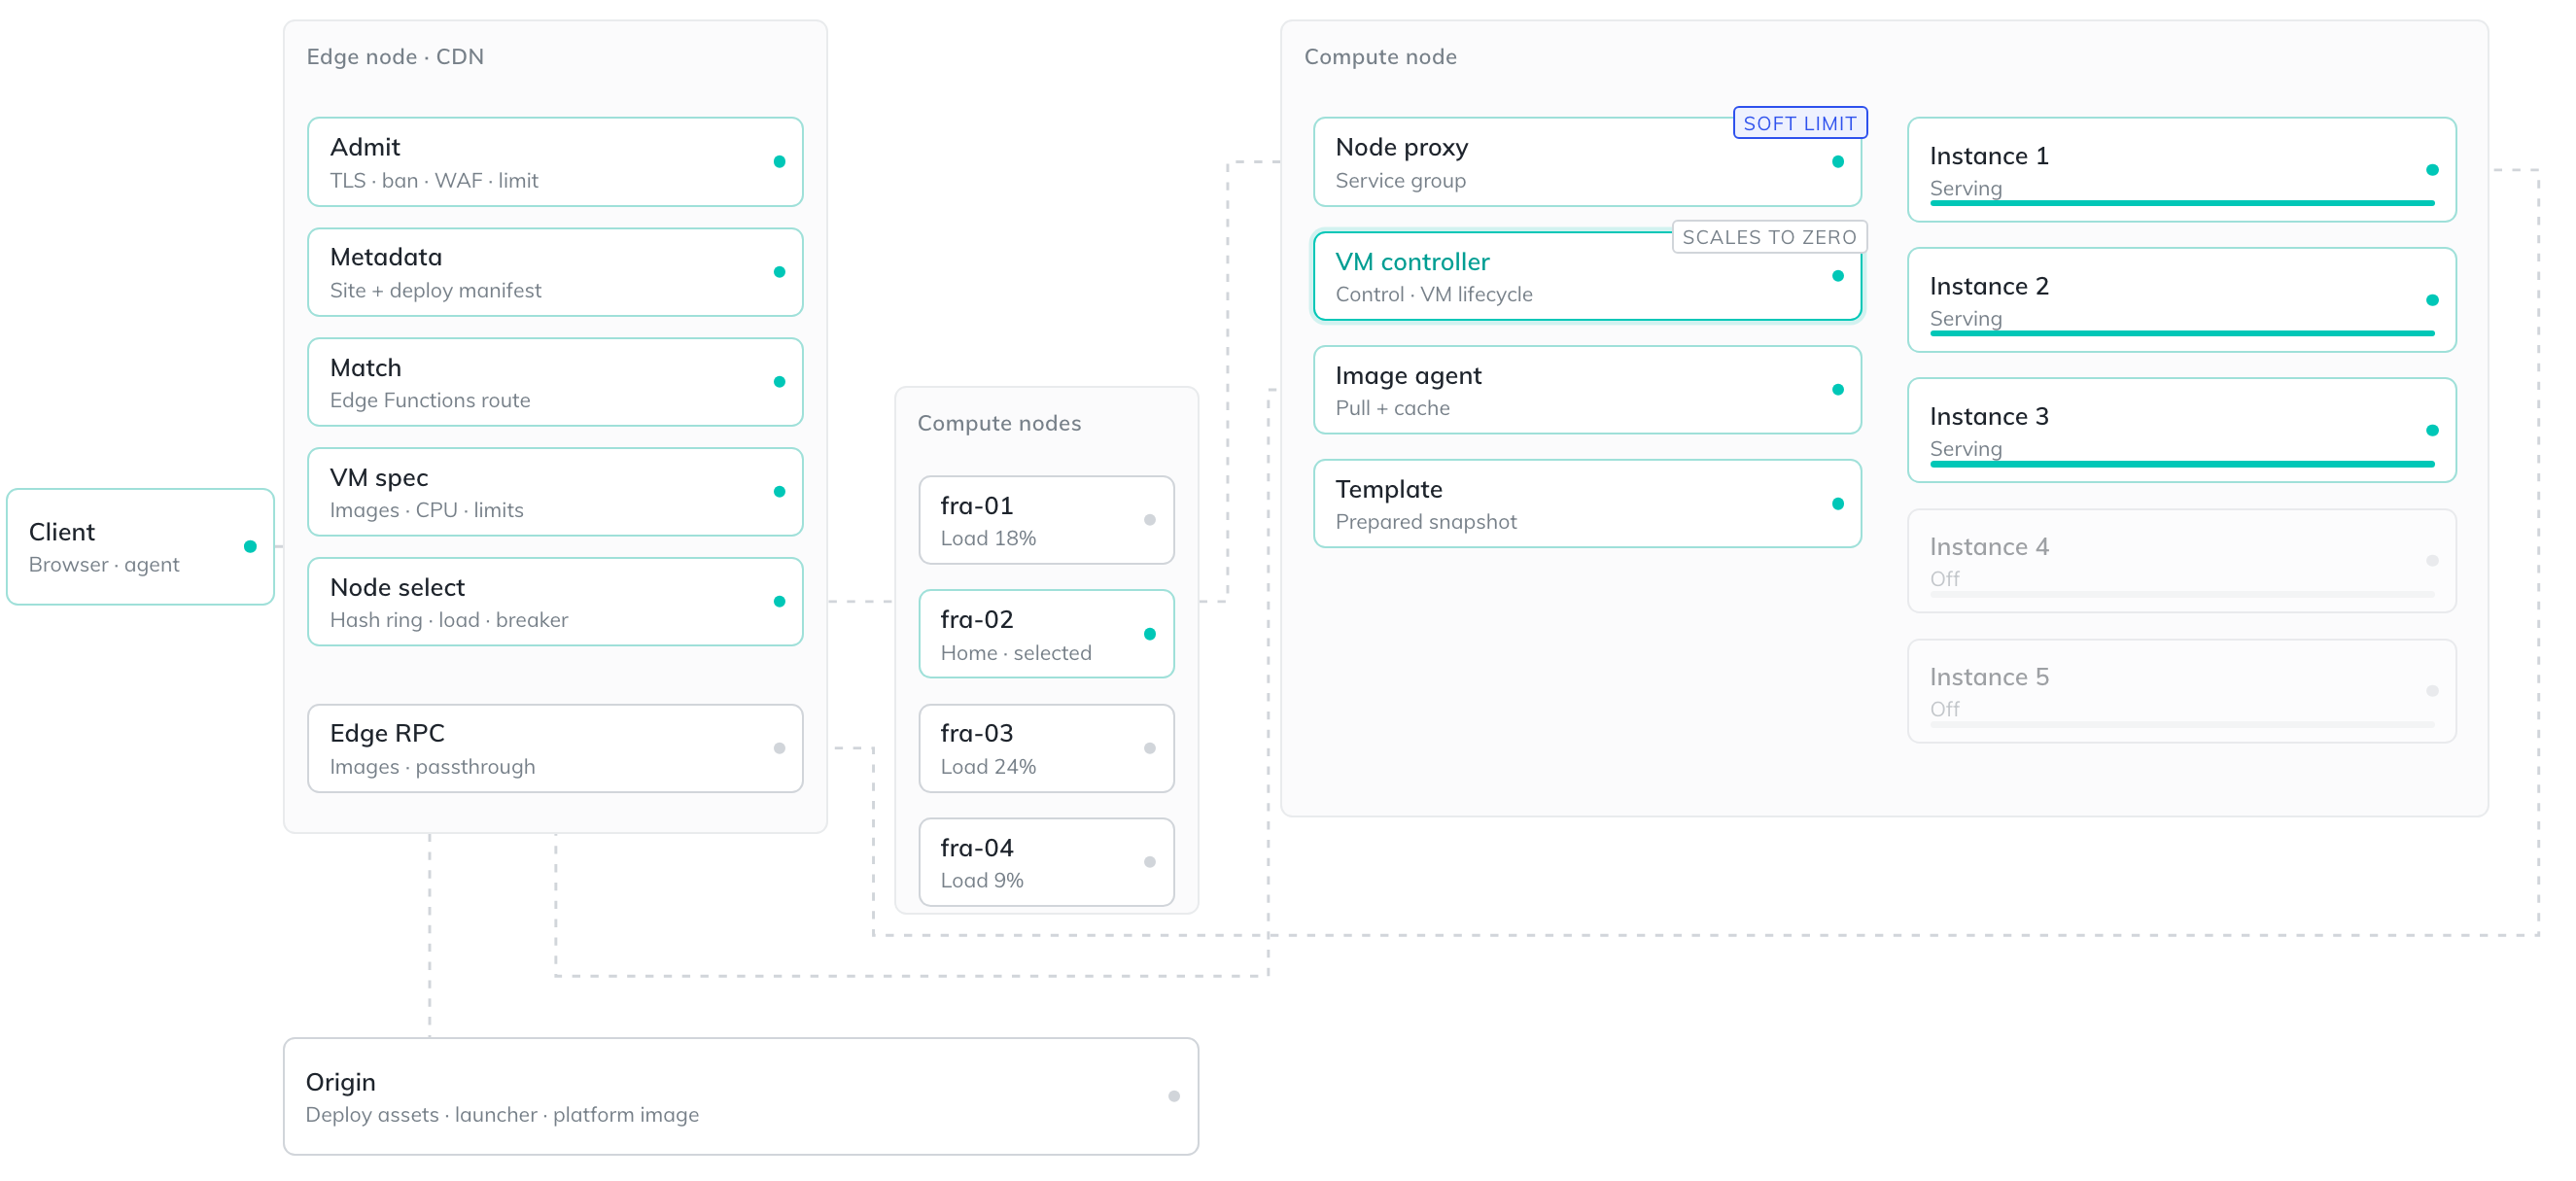
Вот весь путь, и на тёплом экземпляре он занимает примерно 6 мс. Всё это остаётся внутри нашей сети, и мы контролируем весь цикл запроса. Всё происходит между приходом запроса и отправкой ответа.
Проектирование устойчивой compute-инфраструктуры
Когда строишь систему, как описанная выше, оптимизируешь два фактора одновременно: пользовательский опыт и устойчивость развёртывания. Нужна возможность быстро развёртывать изменения, но и быстро откатываться.
Compute-ноды собраны из базового образа, опубликованного Unikraft, и устанавливают набор пакетов. Они собраны отдельно от edge-нод по нескольким причинам: это держит edge-ноды лёгкими и быстрыми, позволяет использовать разные типы экземпляров для compute-нод, и позволяет масштабировать их независимо.
Плоскость управления отслеживает, какие compute-ноды существуют и какие здоровы, а edge-ноды опрашивают её на предмет этого списка. Она также управляет развёртыванием — новый парк запускается наряду с работающим, масштабируется до его размера и берёт трафик только после проверки здоровья.
Построение compute-инфраструктуры требовало тесного сотрудничества с командой Unikraft. На протяжении миграции мы работали с ними над проверкой корректности, обработкой больших объёмов запросов и построением возможностей, специфичных для нашей платформы.
Уже в продакшене
Работа по перестройке edge compute-архитектуры — это больше, чем просто ускорение. Это более быстрый фундамент, на который можно продолжать строить и которым мы полностью управляем. Лучшее в этом то, что она уже обслуживает production-трафик сегодня, при той же цене, без шагов миграции и без необходимости что-то менять в проектах.
Запуск compute самостоятельно означает, что потолок Edge Functions теперь зависит от нас. Три направления, которые раньше были невозможны, теперь реальны:
- Поддержка npm-пакетов вышла из бета. npm-пакеты уже работают в edge-функциях, но в бета-версии, с ограничениями на нативные бинарники и импорт файлов во время выполнения. Реальная VM с реальной файловой системой устраняет большинство этих причин.
- Возможность пересмотра лимитов операций. Документированные лимиты 50 мс CPU на запрос, 512 МБ памяти и 20 МБ сжатого кода пришли из модели выполнения на базе isolate.
- Compute внутри собственной сети. Всё, что зависит от контроля над сетевым путём вместо обращения к третьей стороне через интернет, теперь становится чем-то, что мы можем построить.
Здесь мы не останавливаемся. Лимиты и шероховатости, которых мы раньше не могли коснуться, — это то, над чем мы работаем сейчас. Следите за новостями.